原理
Beam Search(束搜索)是一种在序列生成任务中常用的搜索算法,用于在每一步生成时平衡计算效率和结果质量文字。
主要作用:
- 减少搜索空间(相对于贪心搜索而言)
- 在序列生成(如机器翻译、文本生成、语音识别)时,如果每一步都保留所有可能的候选词(穷举搜索),计算量将指数增长。
- Beam Search 在每一步只保留 top-k(k 称为 beam size)个最有可能的候选序列,大幅降低计算负担。
- 近似最优解
- 它并不是穷举所有路径(那样保证全局最优,但计算不可行),而是用局部贪心扩展结合一定宽度搜索,得到一个接近最优的序列。
- 平衡生成质量与速度
- Beam Size 越小,速度越快,但可能错过更好的序列。
- Beam Size 越大,质量通常更好(更接近穷举搜索),但计算越慢。
工作流程
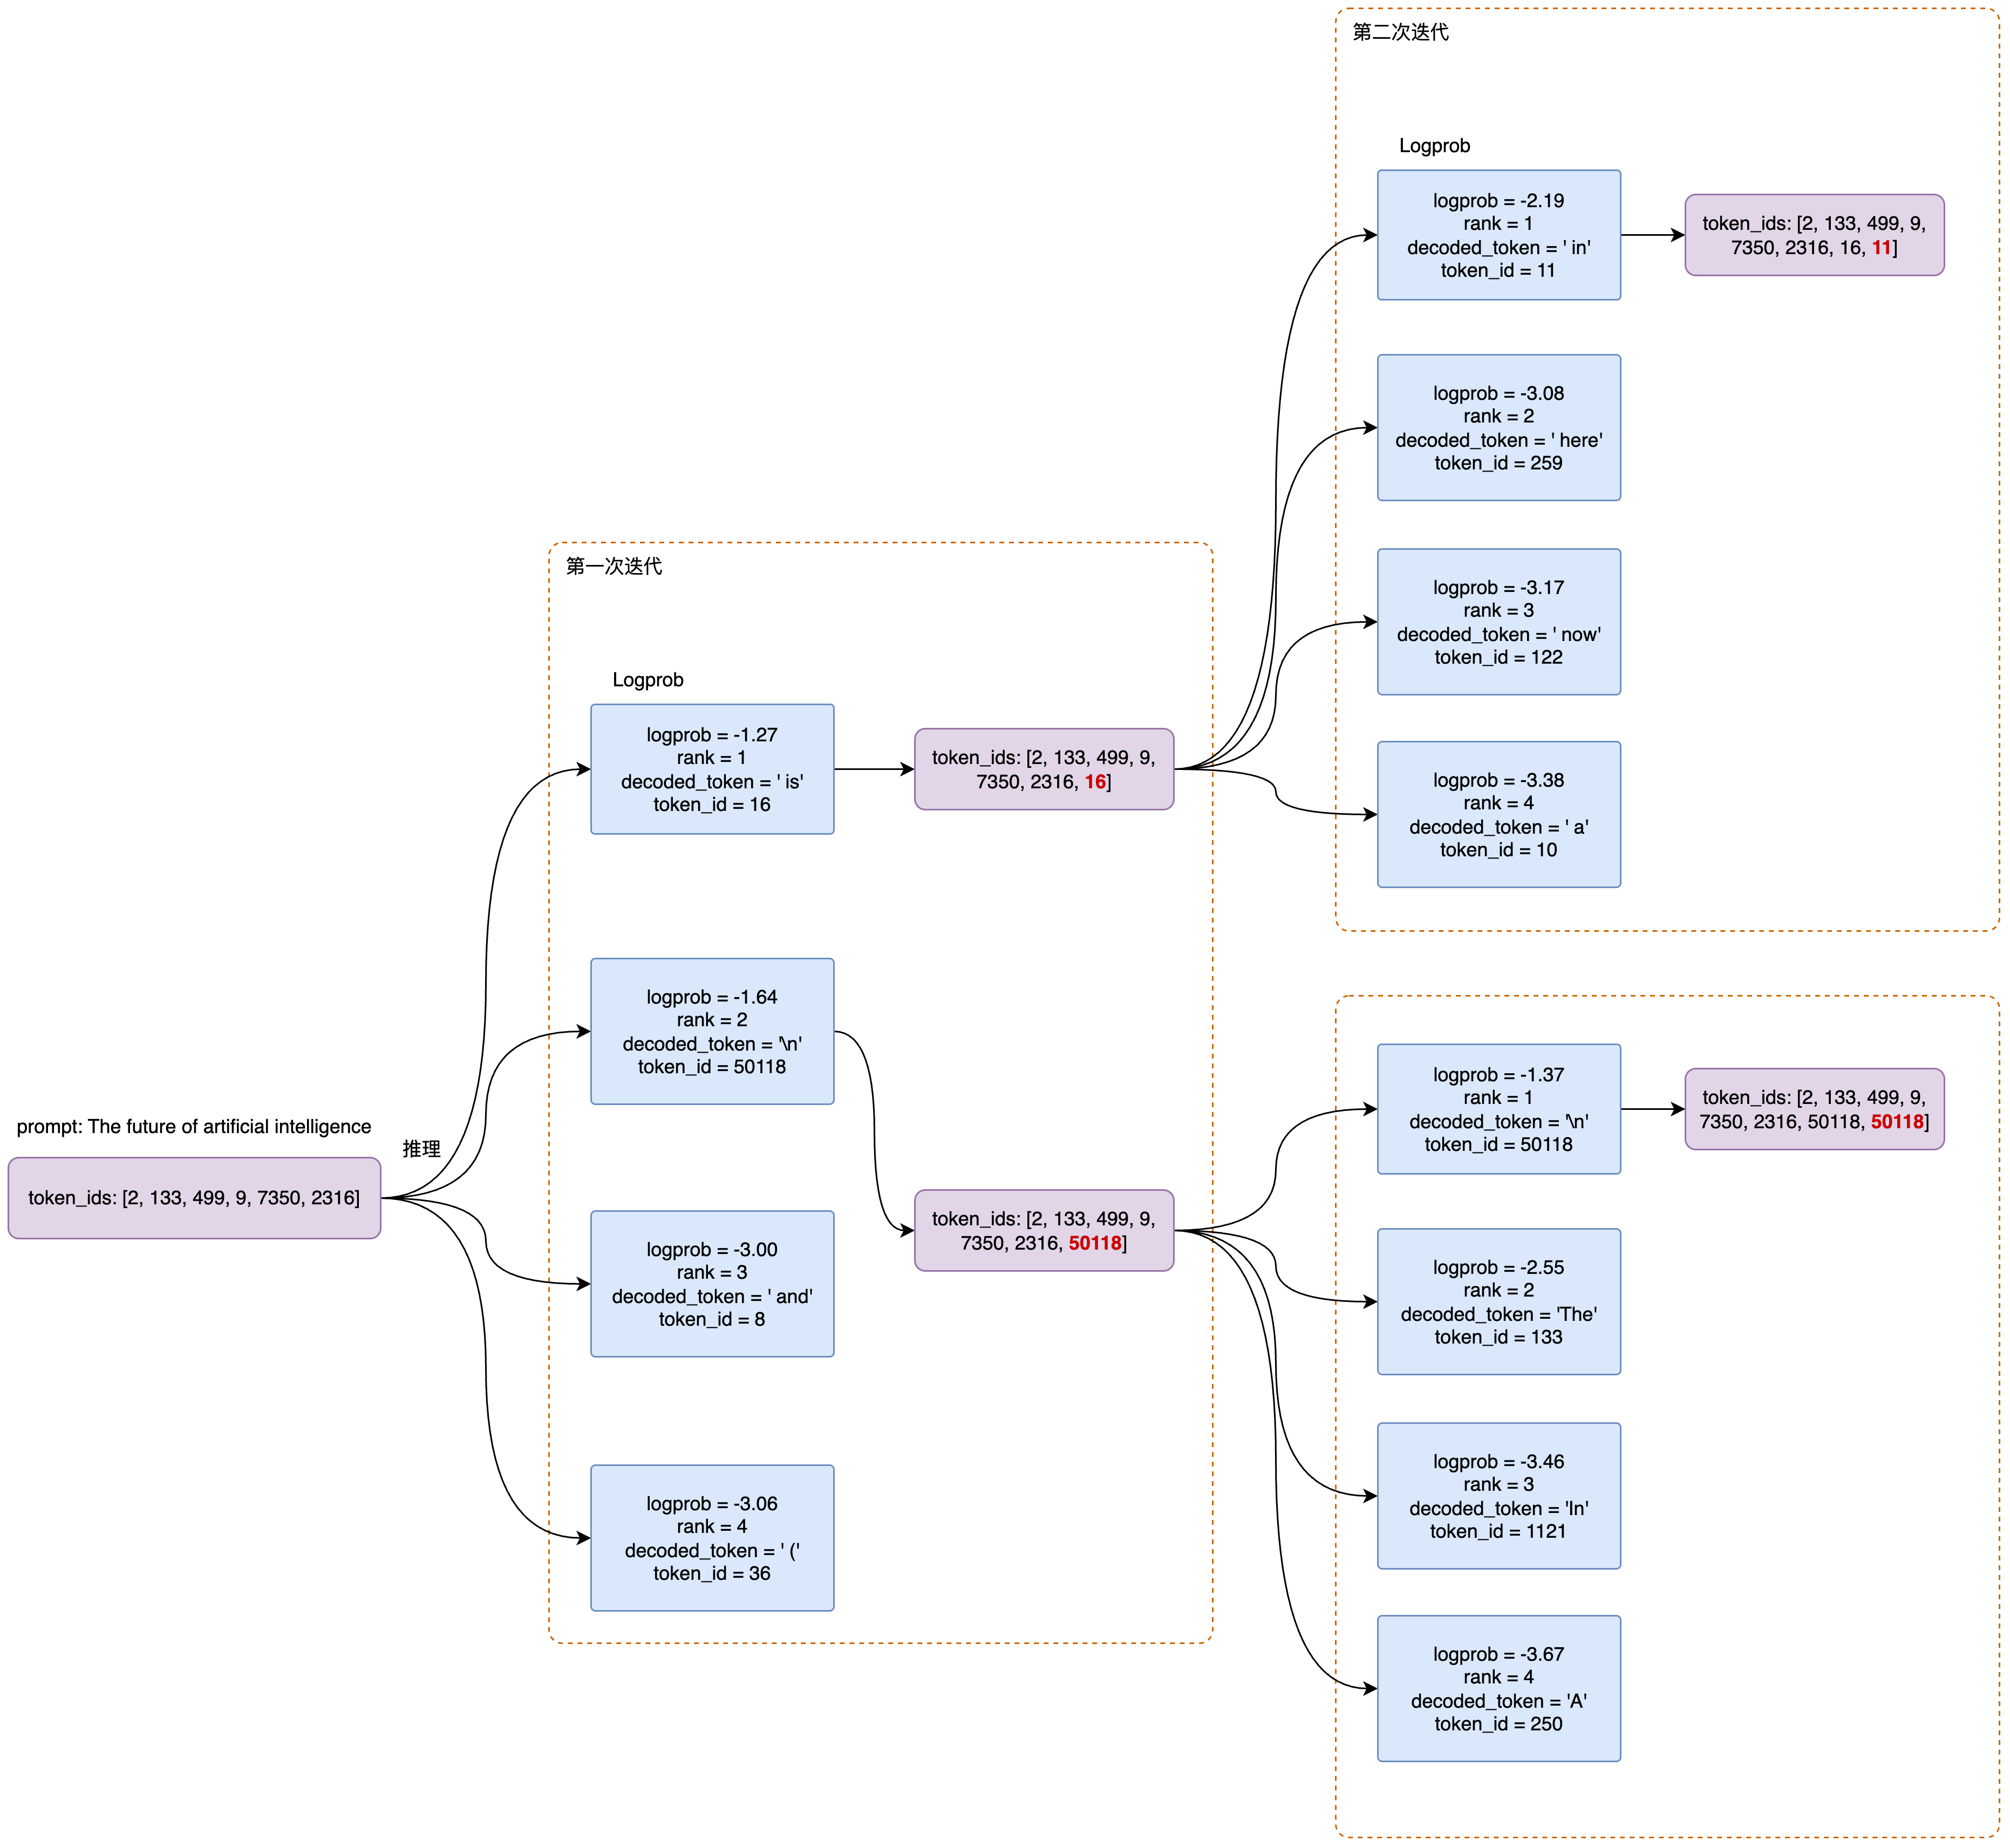
假设 beam_size = 2,生成句子:
- 从起始符开始,第一步模型输出每个词的概率,保留概率最高的 2 个词(如 A, B)。
- 对于这 2 个候选词,分别预测下一个词的概率,这时会得到 2 × V 种可能(V 是词表大小)。
- 从这 2 × V 个候选序列(长度为 2)中,选择总概率(或对数概率之和)最高的 2 个继续扩展。
- 重复直到遇到结束符,最后从 beam 中选择分数最高的序列输出。
vLLM 实现
beamsearch 可视化:https://huggingface.co/spaces/m-ric/beam_search_visualizer
python
if __name__ == '__main__':
    llm = LLM(model="facebook/opt-125m")
    params = BeamSearchParams(beam_width=2, max_tokens=50)
    prompts = [
        TextPrompt(prompt="The future of artificial intelligence")
    ]
    outputs = llm.beam_search(prompts, params)

    for output in outputs:
        generated_text = output.sequences[0].text
        print(f"Generated text: {generated_text!r}")
参数含义:
max_tokens: 迭代次数:for range(max_token)
beam_width: 束宽度。有下面两个作用:
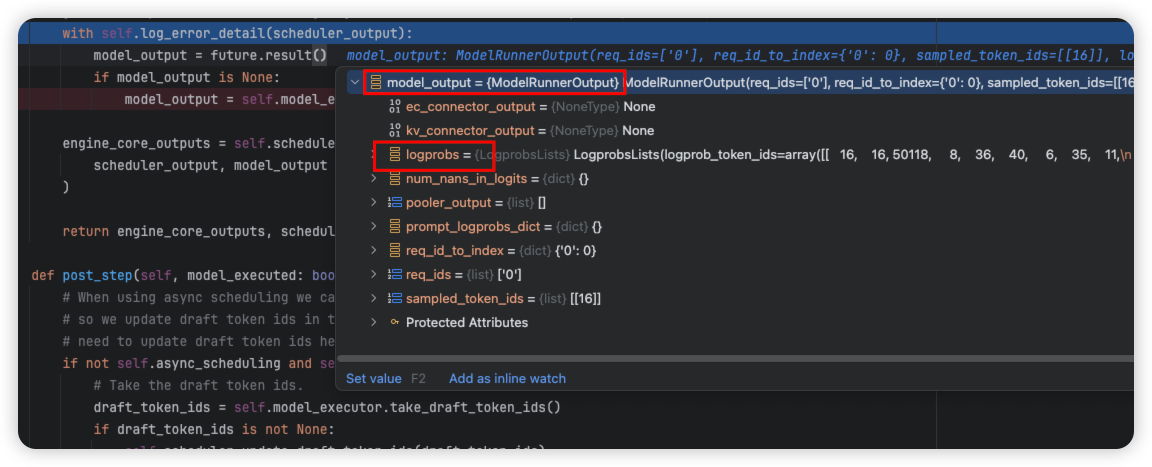
针对每个输入,限制模型推理保留 top 2*beam_width 的 token;
控制每次迭代需要参与推理的 token 数量;
自回归阶段 promot = "`The future of artificial intelligence`"
| item | prefill | decode |
|---|---|---|
| input_ids (token_id) | 2, 133, 499, 9, 7350, 2316, 0, 0 | 13 |
| positions | 0, 1, 2, 3, 4, 5, 0, 0 | |
| logits_indices | 5 | 0 |
| hidden_states | = model_output = tensor(8, 768) | = model_output = tensor(1, 768) |
| sample_hidden_states | = hidden_stateslogits_indices = tensor(1, 768) | = hidden_stateslogits_indices = tensor(1, 768) |
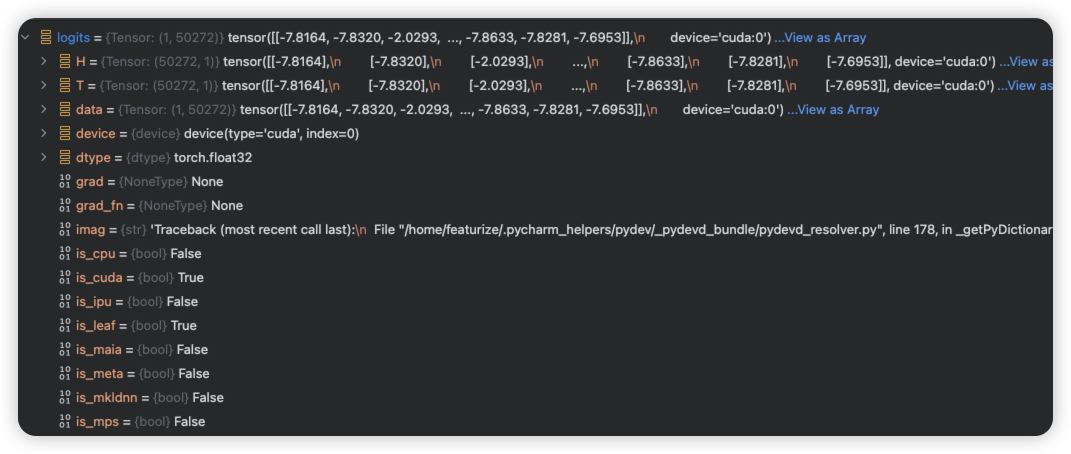
| logits | tensor(1, 50257) | tensor(1, 50257) |
GPUModelRunner._update_states()更新后的状态(input_batches)会被 _prepare_inputs 函数使用(更新 input_ids),以创建模型所需的GPU张量输入。这是GPU模型运行器中状态管理和输入准备的关键连接点。
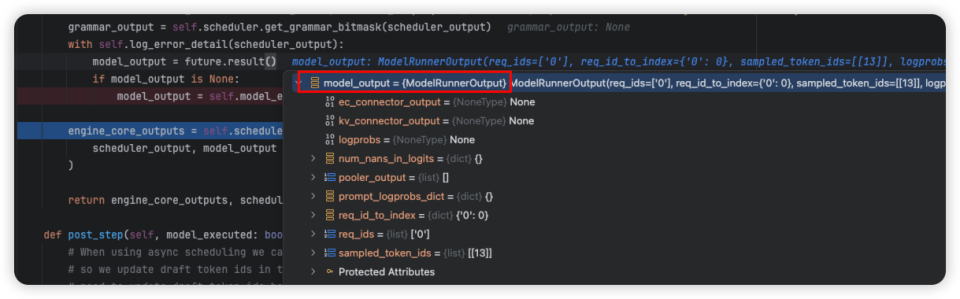
未使用 beam_search : sampling_metadata.max_num_logprobs = None
使用 beam_search: sampling_metadata.max_num_logprobs = 10