一份 38,732,752 字节、100,545 行 x 20 列的 Excel,把"预览有点慢"变成了一个可以拆开的性能问题。
另一个反馈更隐蔽:OFD 内容已经显示出来,却会从右侧再闪进来一次。PDF 的问题则是每次点击缩放,正在看的页面会跳走。
截至 2026-08-12,仓库 API 为 1,955 Star,GitHub 页面进入了 2K 的显示节点。比这个数字更值得记录的,是上面三个失败现场都进入了修复和浏览器回归。下面不列功能清单,只复盘它们分别教会了我什么。
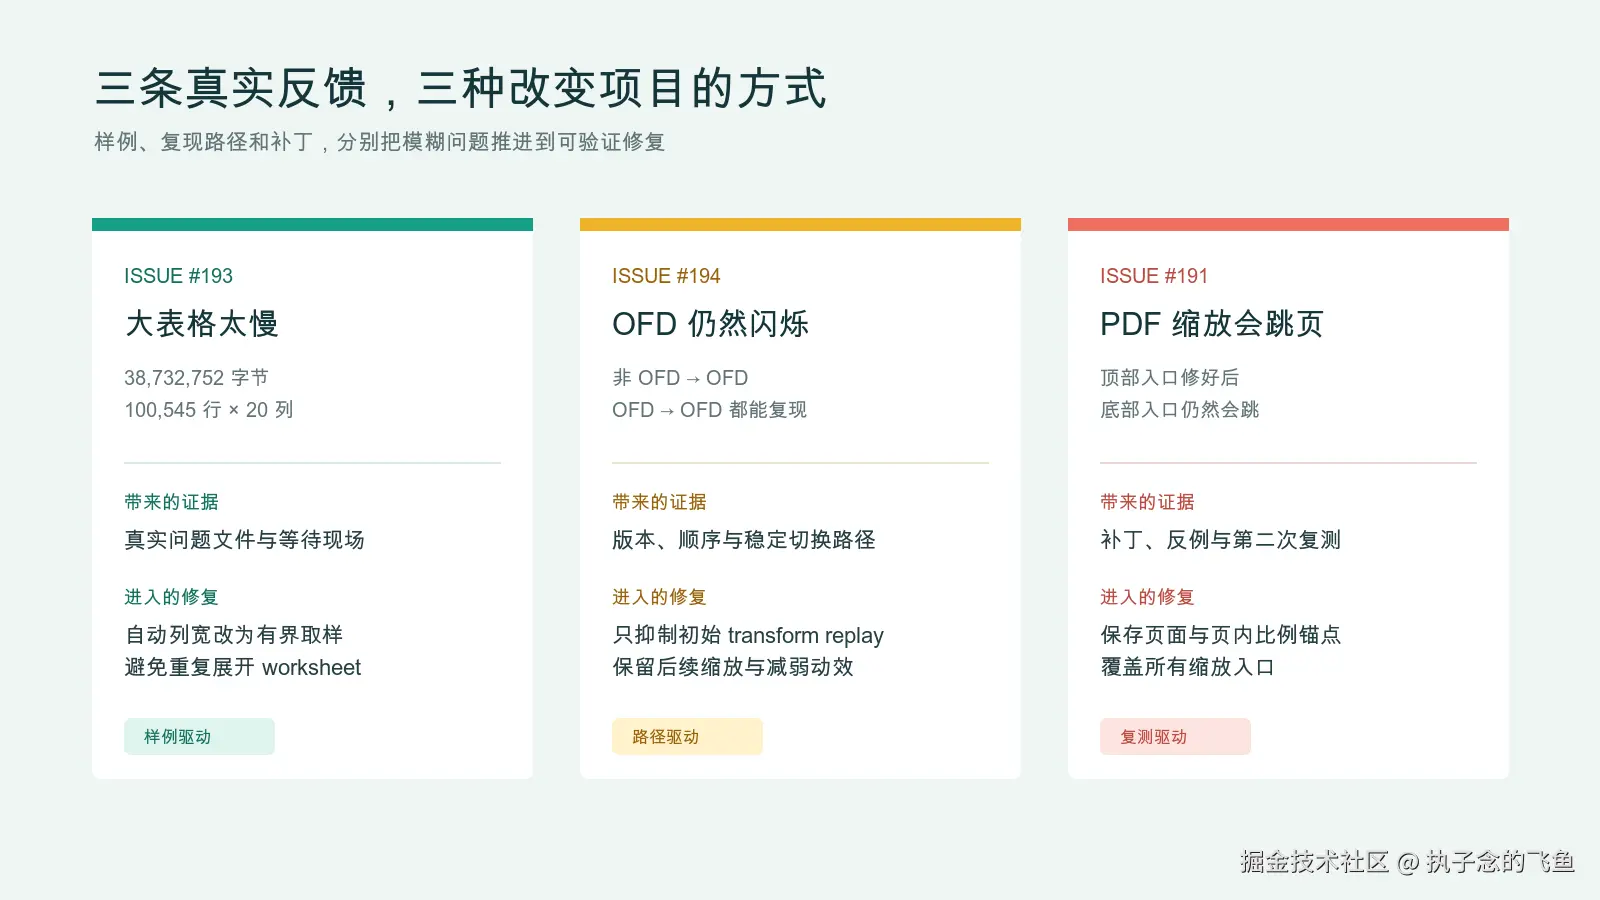
1. 大表格慢,先找无上限的工作
十万行 Excel 能打开,不等于首屏路径合理。排查后发现,自动列宽为了找出每列最宽的内容,会反复扫描整张表。行数越大,这个看似不起眼的兜底越可能成为主要成本。
修复没有简单关闭自动列宽,因为没有显式列宽的业务表仍然需要可读结果。实际做法是把测量改成有界取样:小表全量测量,大表把固定预算分散到最多 8 个窗口,每个窗口最多 128 行,总测量单元格不超过 100,000。
ts
const MAX_SAMPLE_CELLS = 100_000
const MAX_WINDOWS = 8
const MAX_ROWS_PER_WINDOW = 128

function rowsPerWindow(totalColumns: number) {
  return Math.max(1, Math.min(
    MAX_ROWS_PER_WINDOW,
    Math.floor(MAX_SAMPLE_CELLS / totalColumns / MAX_WINDOWS)
  ))
}
关键不是这三个常量,而是把"扫描量"从随文件行数增长,改成有明确上限。做浏览器大文件解析时,我现在会优先搜这些路径:全量遍历、重复解压、完整字符串展开、布局测量和隐式排序。
2. OFD 闪烁不是解析错误,而是初始状态被播放了
OFD 的页面节点先插入 DOM,再补上居中和缩放的 transform。如果页面从一开始就带 transition: transform,浏览器会把 none -> translateX(-50%) scale(1) 当成一次动画。于是内容明明加载完成,却像从右边又打开了一遍。
修复需要区分两种状态:初次布局不播放,用户后续缩放继续保留过渡。
css
.ofd-page { transition: none; }
.ofd-page.ofd-page--zoom-ready {
  transition: transform 160ms ease;
}

@media (prefers-reduced-motion: reduce) {
  .ofd-page.ofd-page--zoom-ready { transition: none; }
}
页面完成初次定位后再增加 ofd-page--zoom-ready。这比直接删掉所有动画更准确,也保留了减少动效偏好。
3. PDF 缩放要保存页内位置,而不只是 scrollTop
缩放前后页面高度会变化,直接恢复旧的 scrollTop 没有稳定语义。更可靠的锚点由两部分组成:当前页码,以及视口顶部在该页内部的比例。
ts
type PageAnchor = { page: number; inPageRatio: number }

const inPageRatio = (container.scrollTop - pageTop) / pageHeight
const anchor: PageAnchor = {
  page: currentPage,
  inPageRatio: Math.max(0, Math.min(1, inPageRatio))
}

// 缩放并完成布局后
container.scrollTop = nextPageTop + anchor.inPageRatio * nextPageHeight
第一次补丁只覆盖顶部工具栏,复测又发现底部悬浮工具栏仍会跳。最终回归因此必须覆盖单次放大、连续放大、反向缩小和所有缩放入口。
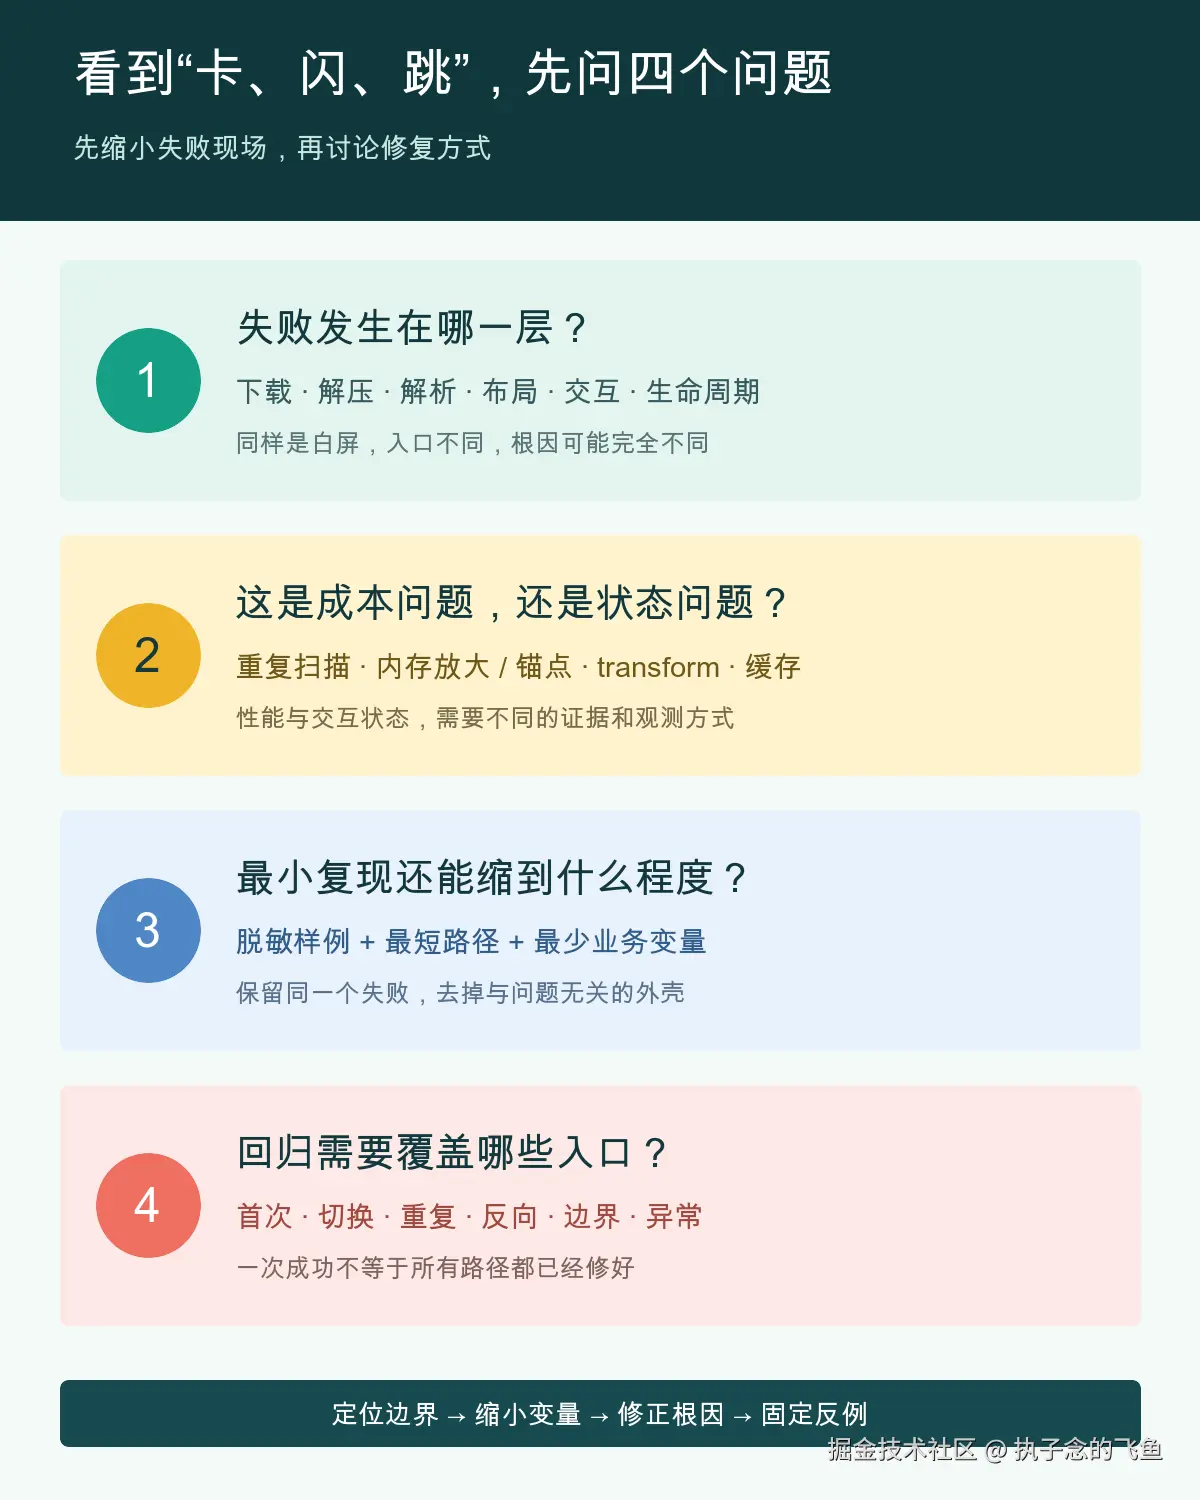
回归不是"页面能出来"
这三个问题分别需要三种验收:
- 大表格要滚到末行,核对行缓存和控制台错误,不能只等首屏出现。
- OFD 要覆盖非 OFD -> OFD 与 OFD -> OFD,观察初次布局和后续缩放。
- PDF 要在多个缩放入口连续操作,确认页码和页内位置都保持。
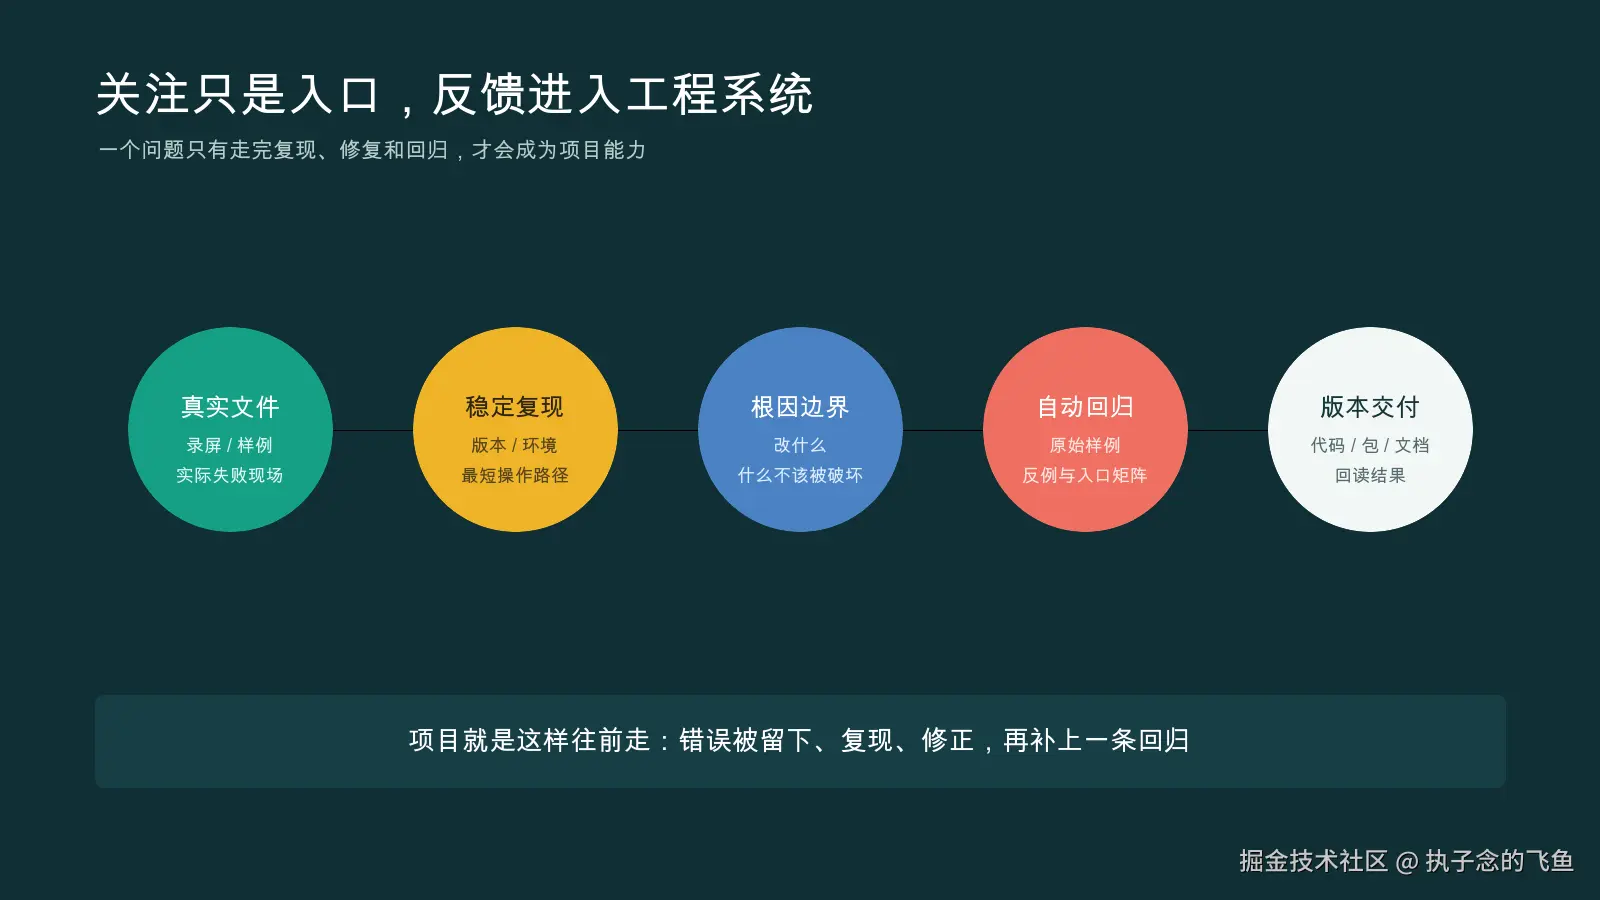
2K 不是质量证书
File Viewer 仍然是只读预览器,不是 Office 或 CAD 编辑器。极端大文件、严格分页一致、复杂宏与嵌入对象、专业审图等场景,服务端转码、在线服务或桌面工具可能更合适。
仓库里也仍有真实问题在排队。进入 2K 显示节点,只说明项目被更多人看见,不说明所有文件和环境都已经可靠。维护者真正能做的,还是把每个失败现场缩小、修正,再固定成下一次不会轻易倒退的回归。
本文涉及的实现、Issue 与回归脚本都可以在 File Viewer 仓库 中查看。