本地大模型部署完全指南:Ollama / vLLM / llama.cpp / MLX 四大引擎横评与选型实战
数据说明 :本文的安装命令、特性、硬件支持全部来自各项目官方 README(2026 年 9 月版本),关键论断标注了出处。不写没验证过的性能数字。
适合谁:想在自己机器或公司服务器上跑开源模型,但被 Ollama、llama.cpp、vLLM、MLX 这些名词绕晕的人。
一、先看结论
-
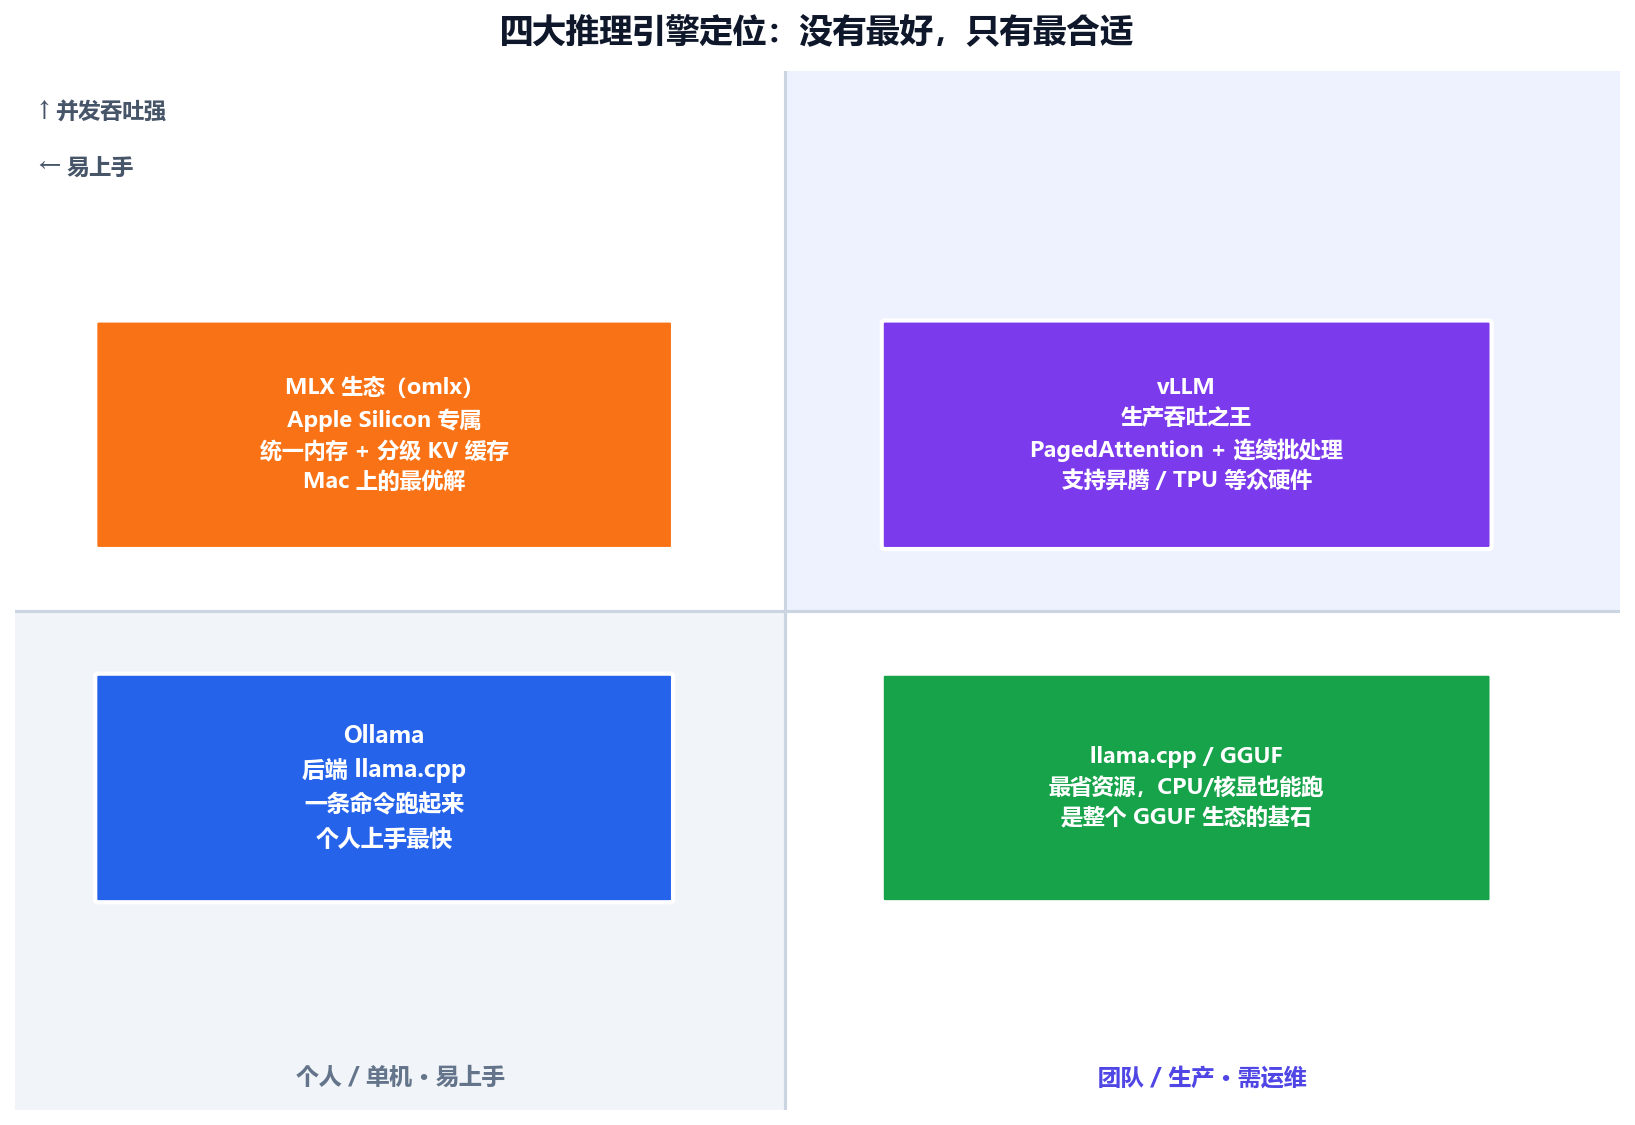
四个引擎不是竞争关系,是四个不同的层次:llama.cpp 是地基(GGUF 格式和底层算子),Ollama 和 LM Studio 是地基上的"精装修"(易用性),vLLM 是生产车间(吞吐),MLX 是 Apple Silicon 的专属高速通道。
-
个人用户无脑选 Ollama :一条命令跑起来,REST API 现成,还有
ollama launch claude这种一条命令把它接进主流编码 Agent 的新玩法。 -
要扛并发、上生产,只有 vLLM 一个答案:PagedAttention、连续批处理、分离式 prefill/decode,且官方支持 NVIDIA / AMD / Intel GPU、华为昇腾、TPU 等一大票硬件。
-
Mac 用户直接进 MLX 生态:统一内存架构是 Intel/NVIDIA 路线比不了的,omlx 这类项目已经把服务化做得很成熟。
四大引擎横评表
| 引擎 | 定位 | 底层 | API | 适合谁 |
|---|---|---|---|---|
| Ollama | 一条命令跑模型 | llama.cpp | REST API(:11434) | 个人、开发调试 |
| llama.cpp | 地基与极限压缩 | 自研(GGUF) | llama-server(OpenAI 兼容) | 低配硬件、嵌入式、造轮子的人 |
| vLLM | 生产级高吞吐 | 自研内核(PagedAttention) | OpenAI 兼容 + Anthropic API + gRPC | 团队服务、生产环境 |
| MLX / omlx | Apple Silicon 专属 | Apple MLX | OpenAI + Anthropic 兼容(:8000) | Mac 用户 |
二、部署前,先想清楚三个问题
很多人部署失败的根因不是技术,是没想清楚需求。回答这三个问题,你的选型就已经完成 80%:
问题一:给谁用?
- 只给自己调试/学习 → Ollama,十分钟解决战斗;
- 给团队共用 → 必须考虑并发,直接看 vLLM;
- 给客户/生产 → vLLM + 监控 + 量化压测。
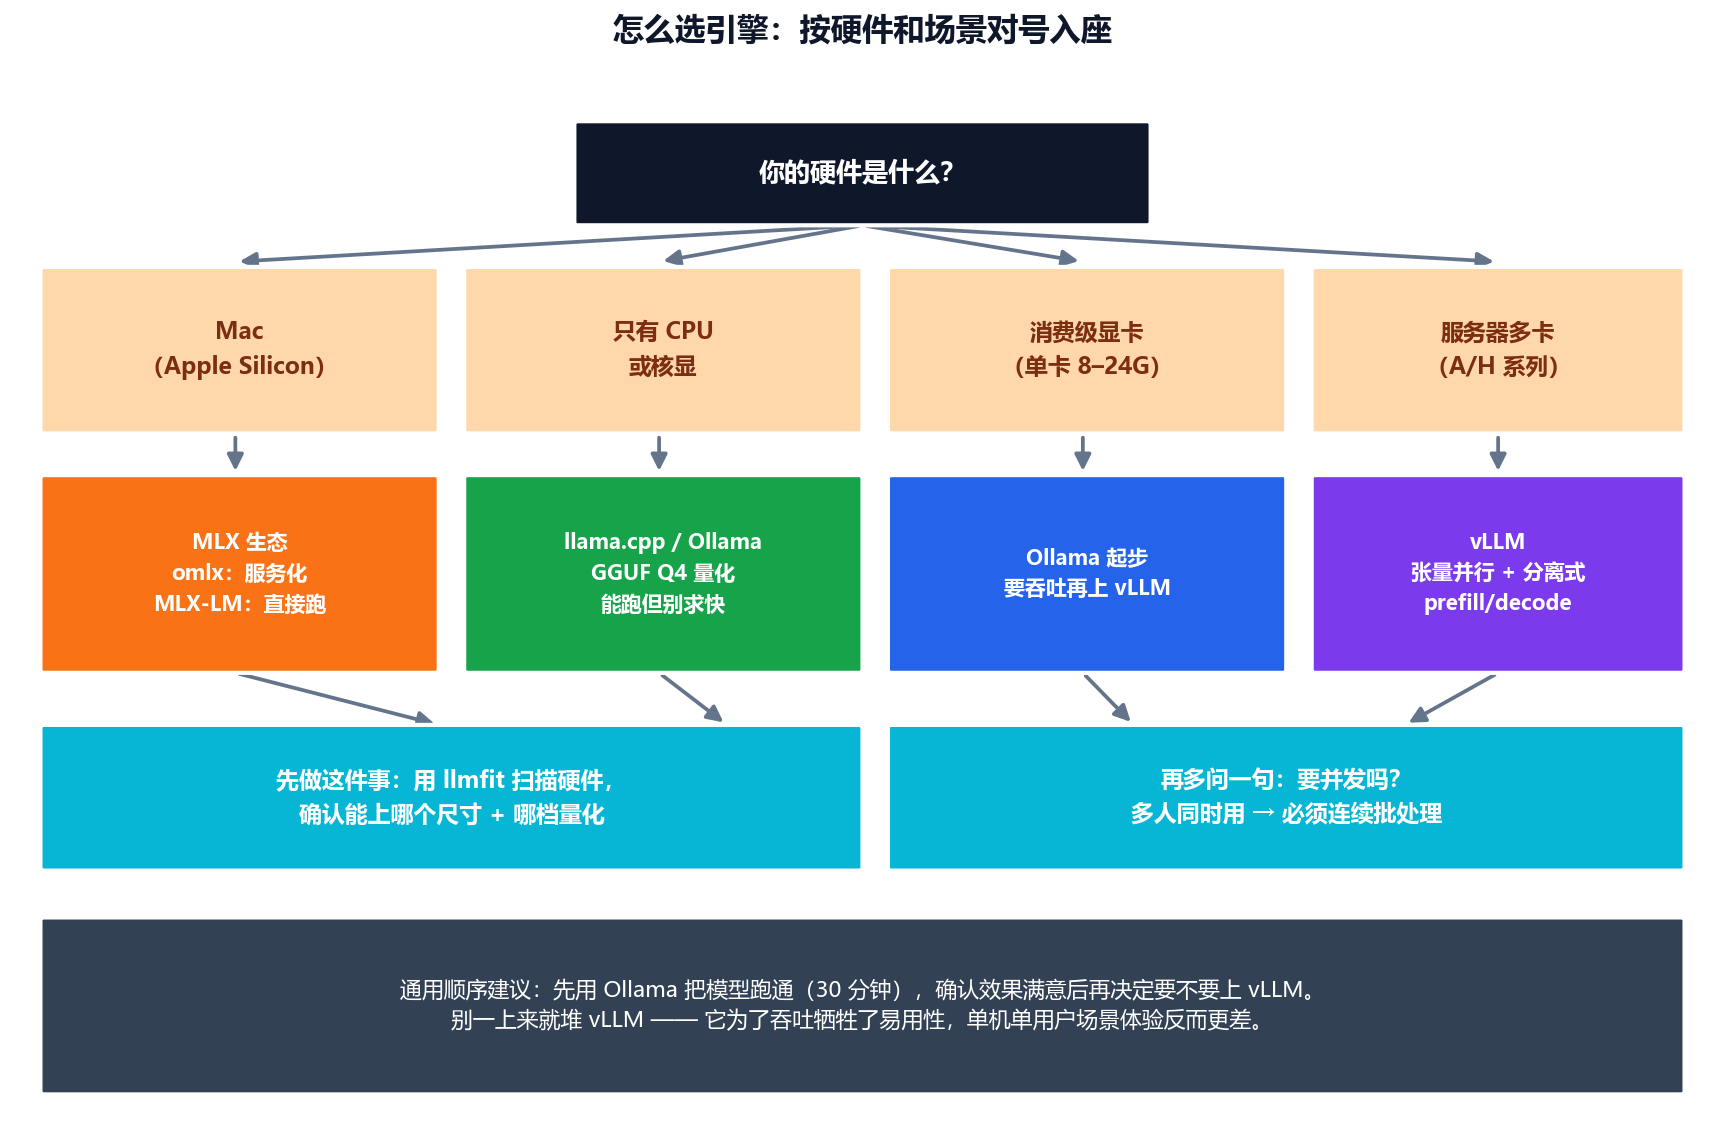
问题二:硬件是什么?
- Mac(M1--M5)→ MLX 生态,统一内存跑大模型是 Mac 独有优势;
- 纯 CPU 或核显 → llama.cpp + GGUF 量化,能跑但别期待速度;
- 单卡 8--24G 消费卡 → 7B--32B 的 Q4 量化是甜点区;
- 多卡服务器 → vLLM 张量并行。
问题三:要不要并发?
这是最容易被忽略的问题。单人对话和十人同时用,是两个完全不同的工程问题。Ollama 对并发场景并不擅长------它的强项是"简单",不是"吞吐"。
三、四大引擎逐个拆
3.1 Ollama ------ 十分钟跑起来的第一选择
后端:llama.cpp(Georgi Gerganov 创立的项目)
Ollama 自己不实现推理,它的价值是把 llama.cpp 包成一个人人可用的产品:模型库、版本管理、API、一键集成。
安装(三个平台都是一条命令):
bash
# macOS / Linux
curl -fsSL https://ollama.com/install.sh | sh

# Windows PowerShell
irm https://ollama.com/install.ps1 | iex
也有官方 Docker 镜像 ollama/ollama。
跑起来:
bash
ollama run gemma4 # 自动下载并进入对话模型列表在 ollama.com/library,一条命令拉取。
API 直接可用(默认端口 11434):
bash
curl http://localhost:11434/api/chat -d '{
  "model": "gemma4",
  "messages": [{"role": "user", "content": "Why is the sky blue?"}],
  "stream": false
}'
Python / JS 都有官方 SDK:
bash
pip install ollama     # Python
npm i ollama           # JavaScript
2026 年最值得注意的新玩法:ollama launch。官方现在支持一条命令把本地模型直接接进主流 Agent:
bash
ollama launch claude      # 接入 Claude Code
ollama launch openclaw    # 变成 WhatsApp/Telegram/Slack 里的个人助手
支持的集成包括 Claude Code、Codex、Copilot CLI、DeepSeek Harness、Droid、OpenCode、OpenClaw。这意味着你可以用本地模型驱动编码 Agent------数据不出本机,也没有按 token 计费。
自定义模型用 Modelfile(改系统提示、温度、上下文长度):
dockerfile
FROM gemma4
SYSTEM "你是一个严谨的中文技术文档助手"
PARAMETER temperature 0.3
bash
ollama create mymodel -f Modelfile它的边界也要清楚:Ollama 擅长"单机、少并发、快速上手"。多人同时高负载使用时,吞吐和调度都不是它的设计目标------这时候请看 vLLM。
3.2 llama.cpp ------ 一切的地基
Ollama 的后端就是它,但 llama.cpp 本身值得单独认识:
- GGUF 格式的创立者与维护者。你现在下载的几乎所有本地模型文件,十有八九是 GGUF;
- 量化技术(k-quants 家族的 Q4_K_M、Q5_K_M 等)让 7B 模型能塞进 4--5GB 内存;
- 后端覆盖极广:CPU、Apple Metal、CUDA、Vulkan、ROCm......没有 GPU 也能跑;
- 自带
llama-server,提供 OpenAI 兼容接口。
什么时候直接用它而不是 Ollama:内存极限紧张、要在树莓派/NAS 这类设备上跑、或者需要精细控制每一个推理参数。否则,Ollama 是更省心的壳。
3.3 vLLM ------ 生产环境的事实标准
起源:UC Berkeley Sky Computing Lab,2000+ 贡献者共建
vLLM 的定位和 Ollama 完全不同:它从第一天起就是为高吞吐服务设计的。
安装(官方推荐用 uv):
bash
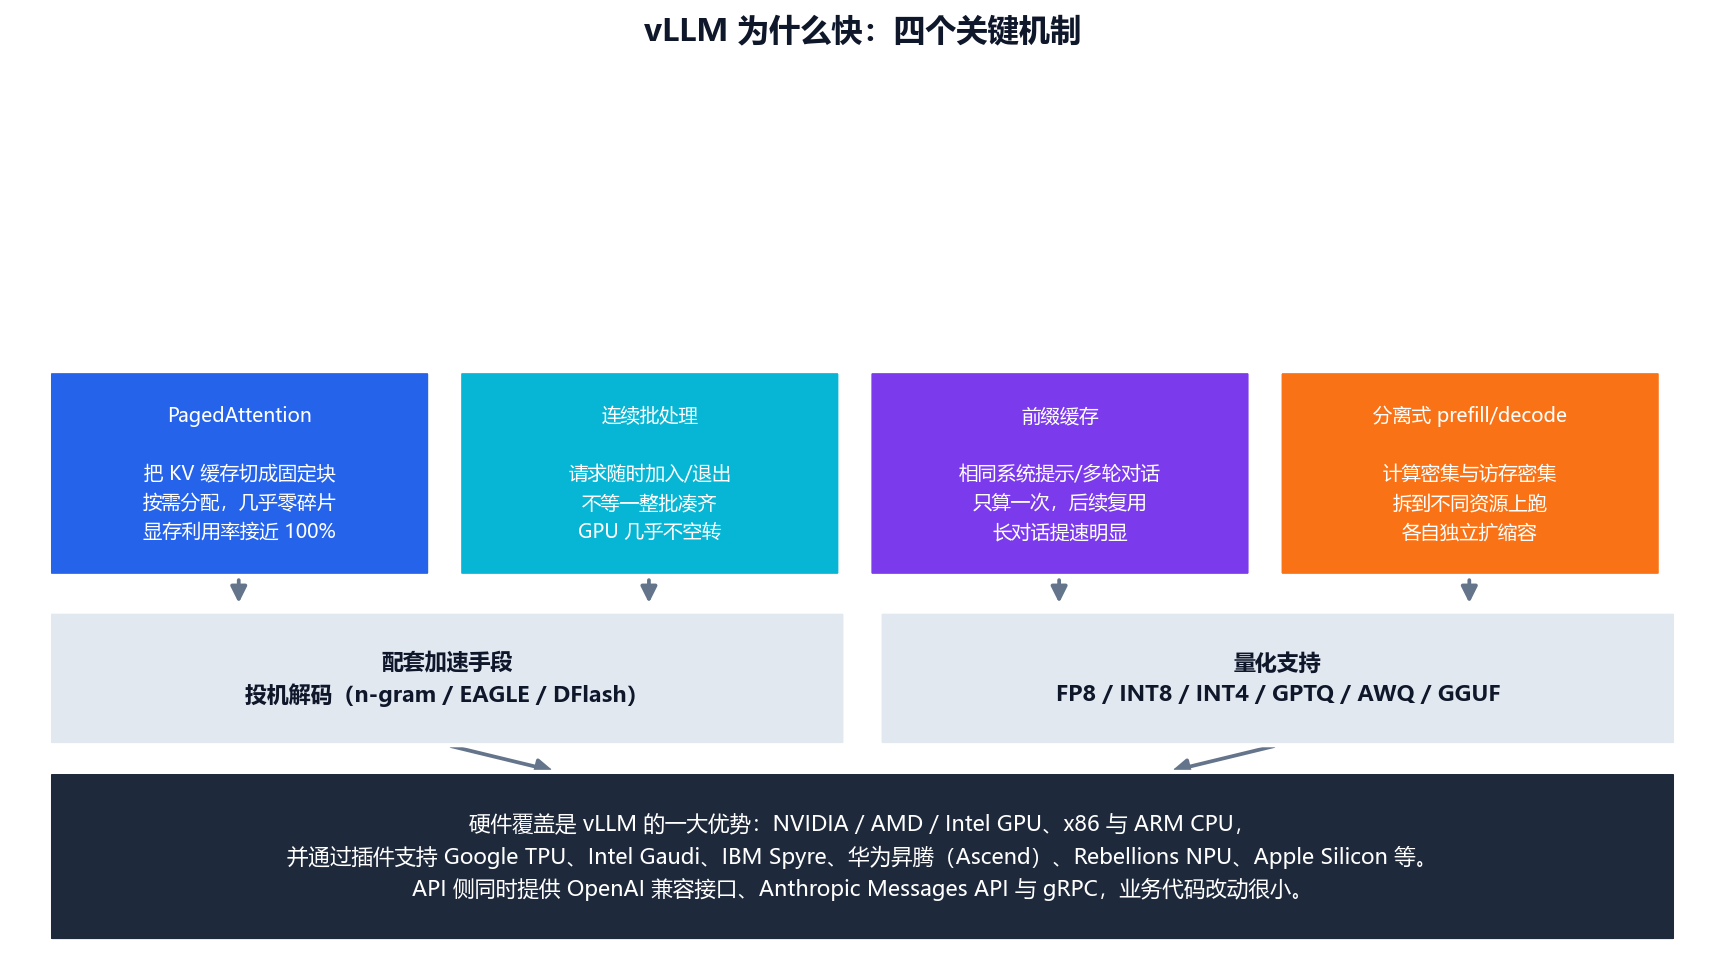
uv pip install vllm为什么它快,四个机制(下一节展开):
- PagedAttention:把 KV 缓存像操作系统管内存页一样分块管理,显存利用率逼近 100%(这是它的成名作,论文发在 SOSP 2023);
- 连续批处理 + chunked prefill:请求随到随处理,GPU 不空转;
- 前缀缓存:相同系统提示、多轮对话的公共前缀只算一次;
- 分离式 prefill/decode:把计算密集和访存密集两个阶段拆开部署,各自独立扩缩容。
它支持的硬件清单值得逐条看(官方 README 原文):
- 原生:NVIDIA GPU、AMD GPU、Intel GPU、x86 / ARM / PowerPC CPU;
- 插件:Google TPU、Intel Gaudi、IBM Spyre、华为昇腾(Ascend)、Rebellions NPU、Apple Silicon、MetaX GPU。
对国产化环境来说,vLLM 官方支持华为昇腾这一点非常关键------NPU 生态不用从零造轮子。
API 兼容性也做得最全 :OpenAI 兼容接口、Anthropic Messages API、gRPC 三种都有。这意味着客户端代码几乎不用改。
其他硬实力:200+ 模型架构(含 MoE、混合注意力、多模态、embedding)、multi-LoRA、结构化输出(xgrammar)、投机解码(n-gram / EAGLE / DFlash)、张量/流水线/数据/专家/上下文五种并行。
什么时候不该用它 :单机单人使用。vLLM 的复杂度是为吞吐付的成本,一个人聊天用 Ollama 体验更好。先用 Ollama 验证模型效果,再决定要不要上 vLLM,是我建议的标准顺序。
3.4 MLX / omlx ------ Mac 用户的专属通道
Apple Silicon 的统一内存让 CPU 和 GPU 共享同一块大内存,跑大模型天然占优。MLX 是 Apple 官方的机器学习框架,围绕它的生态在 2026 年已经成熟:
- MLX-LM:命令行直接跑和训练;
- omlx(21.7k★):把推理做成正式服务------OpenAI 和 Anthropic 双兼容 API、Web 管理面板、菜单栏 App。
omlx 有两个值得单独说的设计:
- 分级 KV 缓存:热数据在内存、冷数据落 SSD(safetensors 格式),服务重启后前缀缓存仍然可复用。对"隔天接着问同一个项目"的工作流是质变;
- 原生自定义 kernel :GLM-5.2 等模型的融合 prefill 内核实测 845 tok/s vs 约 29 tok/s(M3 Ultra,官方数据) 。但注意:普通 pip 安装不会编译这些内核,且会静默回退到慢路径 ------必须用官方 dmg,或装完整 Xcode 后用
brew install jundot/omlx/omlx --HEAD --with-custom-kernel。
Mac 上的标准组合:omlx 做服务 + llama.cpp 兜底特殊需求。
3.5 顺带两个常被问到的
- SGLang:同样主打高吞吐,RadixAttention 前缀缓存和结构化输出是强项,和 vLLM 属于同赛道竞品,团队有相关经验可以对比测试;
- LM Studio:闭源但免费的桌面 GUI,点鼠标就能跑模型,适合完全不想碰命令行的人;做开发集成时它的本地 API 也兼容 OpenAI 格式。
四、量化怎么选:一张表说清
模型文件动辄几十 G,量化的本质是"用一点精度换大量显存"。常用选择:
| 量化 | 格式 | 体积(以 7B 为例) | 建议 |
|---|---|---|---|
| Q4_K_M | GGUF | 约 4--5 GB | 个人首选,质量损失小 |
| Q5_K_M / Q6_K | GGUF | 约 5--6 GB | 内存充裕就升一档 |
| AWQ / GPTQ | vLLM 常用 | 约 4--6 GB | 服务端部署常用 |
| INT8 / FP8 | vLLM 原生 | 约 7--15 GB | 精度要求高的生产场景 |
| MXFP4 / NVFP4 | 新一代 4-bit | 极低 | 新硬件上的前沿选择 |
经验法则 :优先保证模型参数规模,其次才是量化档位。跑得动 32B 的 Q4,几乎总是好于 14B 的 Q8。
动手前,用上篇推荐的 llmfit 扫一遍硬件,它会直接告诉你显存能装下哪个尺寸、哪档量化,还会给出预计速度。
五、三条实战路线
路线 A:个人学习 / 本地开发(半小时搞定)
bash
# 1. 装 Ollama
curl -fsSL https://ollama.com/install.sh | sh

# 2. 先用 llmfit 确认能跑什么
llmfit

# 3. 拉模型开聊
ollama run gemma4

# 4. 需要接编码 Agent 时
ollama launch claude
路线 B:团队内部服务(Mac 机房或单台服务器)
- Mac 环境:omlx 起服务(
omlx serve --model-dir ~/models),OpenAI 兼容接口直接给同事的工具链用; - Linux + 单卡:Ollama 起步,2--5 人轻度共用够用;并发明显上升再迁 vLLM。
路线 C:生产环境
- vLLM 起服务(OpenAI 兼容接口 + Anthropic Messages API 都有,业务侧改动小);
- 按并发压力决定是否开启分离式 prefill/decode 与张量并行;
- 量化选 AWQ / GPTQ / FP8,上线前用真实流量压测;
- 别忘了安全:用 AI-Infra-Guard 扫一遍服务暴露面(它内置了 vLLM、Ollama 等 146 个 AI 组件的指纹与 2000+ CVE 规则)。
六、避坑清单(都是高频问题)
- Mac 上模型"莫名很慢" :先检查 omlx 的原生内核有没有编译成功------缺了会静默回退到慢路径,官方实测差距可达 30 倍,且没有任何报错。
- 以为 Ollama 能扛并发:它的强项是简单,不是吞吐。多人重度使用请上 vLLM。
- 显存只算模型本体:KV 缓存随上下文长度和并发数增长,长上下文 + 多并发时显存需求远超模型文件大小。这也是 PagedAttention 存在的意义。
- 量化档位无脑拉满:Q8 不一定比 Q4 好------参数规模更大的 Q4 模型,通常强于同显存下能塞下的更小模型的 Q8。
- 服务直接暴露公网:无论 Ollama 还是 vLLM,默认都没有认证体系。要么绑内网,要么自己加网关认证。
七、我的三个判断
-
推理引擎正在"分层固化":llama.cpp 守地基、Ollama 守易用性、vLLM 守吞吐、MLX 守 Apple Silicon------每层都已有事实标准,新项目想入场必须找新的缝(比如 omlx 切中的"Mac 服务化 + KV 缓存落盘")。
-
"本地模型 + 编码 Agent"会快速发展 。
ollama launch claude这种一条命令的组合方式,正在把"数据不出本机的 AI 编程"变成普通人的选项。 -
硬件中立性越来越重要。vLLM 官方支持清单里华为昇腾、TPU、Gaudi 并列出现------异构算力时代,绑定单一硬件生态的风险会越来越高。
如果这篇帮你理清了选型思路,点个赞、收个藏。
资料来源:Ollama、vLLM、llama.cpp、omlx 官方 README 与文档(2026-09);PagedAttention 论文 arXiv:2309.06180(SOSP 2023)。