目录
- 引言
- 本节目标
- [准备:给 AI 装上「微搭技能」](#准备:给 AI 装上「微搭技能」)
- 步骤一:先看清楚------「行」和「树」是两种东西
-
- [1.1 数据库里:部门是一行一行的](#1.1 数据库里:部门是一行一行的)
- [1.2 树组件要的:一层套一层的 JSON](#1.2 树组件要的:一层套一层的 JSON)
- [步骤二:认识树组件 WdTree](#步骤二:认识树组件 WdTree)
-
- [2.1 节点的三个必备 key](#2.1 节点的三个必备 key)
- [2.2 组件的几个关键属性(在右侧属性面板配置)](#2.2 组件的几个关键属性(在右侧属性面板配置))
- [2.3 运行时能读到的信息(下一篇用,先混个脸熟)](#2.3 运行时能读到的信息(下一篇用,先混个脸熟))
- [步骤三:写自定义方法 loadDeptTree](#步骤三:写自定义方法 loadDeptTree)
-
- [3.1 查数据:wedaGetRecordsV2](#3.1 查数据:wedaGetRecordsV2)
- [3.2 行转树:Map 两遍法(重点)](#3.2 行转树:Map 两遍法(重点))
- 步骤四:建页面变量,接住树数据
- 步骤五:把树组件绑到变量上
- 步骤六:让页面打开时自动加载
- 常见问题排查
- 本节成果
- 下一篇预告
引言
上一篇,我们建好了部门数据模型 ct_dept,也搭建了「左树右详情」的页面布局。
但你现在预览页面会发现:左边的树还是组件自带的示例数据(什么行政中心、营销中心),跟我们自己的部门没有半点关系。页面只是个空壳。
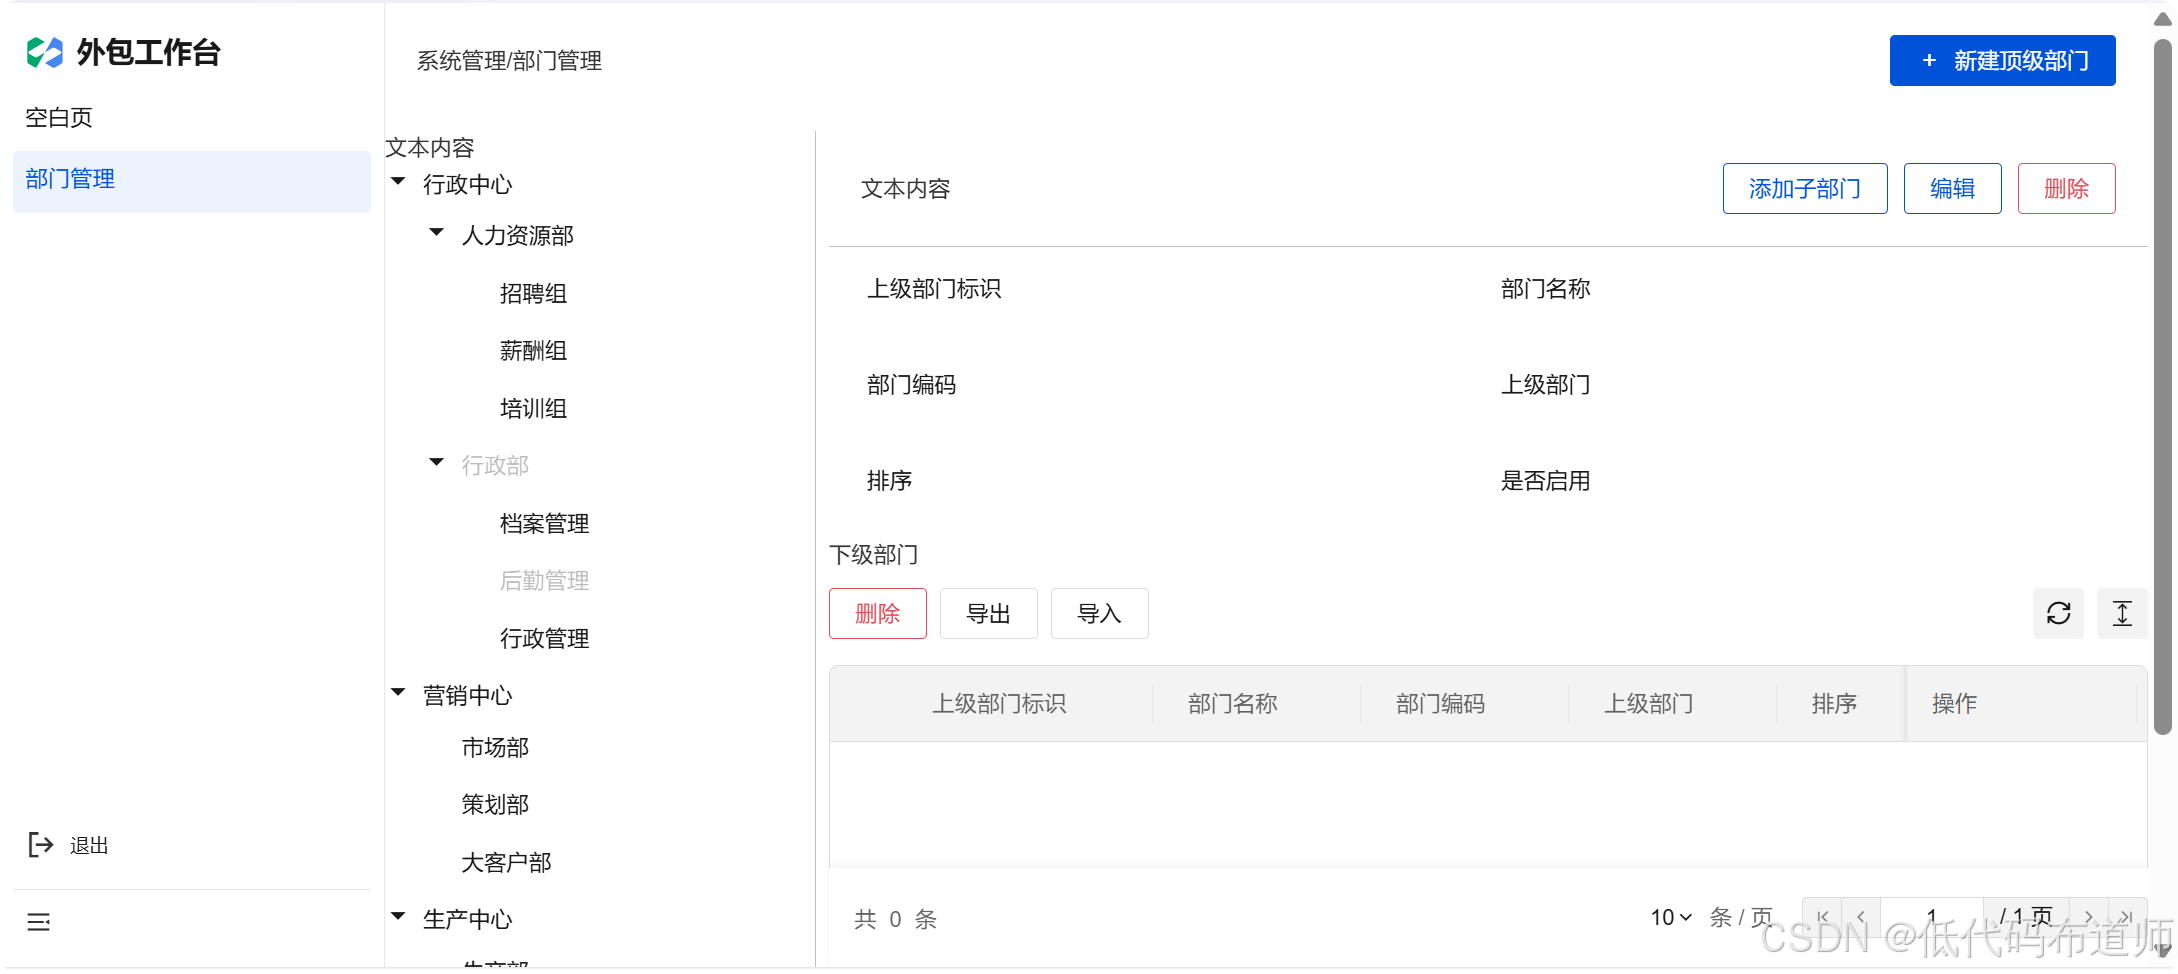
这一篇,我们就让这棵树「活」过来------把 ct_dept 表里的部门,真实地加载到树组件上。
做完后你会看到:
- 页面一打开,树里显示的就是你在数据模型里录入的部门;
- 有上下级的部门,会正确地嵌套、缩进、展开;
这件事看起来只是「查个数据、塞给组件」,但中间藏着一个所有树形功能都会遇到的核心问题:
数据库里存的是一行一行的「扁平数据」,而树组件要的是一层套一层的「嵌套数据」。
怎么把「行」变成「树」?------这是本篇的重点。
本节目标
今天完成 4 件事:
- 给 AI 助手装上两个「微搭技能」,让它写出来的代码符合微搭的规矩;
- 搞懂树组件
WdTree要什么格式的数据; - 写一个自定义方法:查部门 → 行转树 → 塞进组件;
- 让页面打开时自动执行这个方法。
完成后,部门管理页的左半边就彻底能用了。
准备:给 AI 装上「微搭技能」
我们后面大量的业务逻辑,都是用自然语言指挥 AI 生成的。但 AI 默认并不完全清楚微搭的 API 细节------比如查数据该调哪个方法、树组件的数据要什么 key。
所以我们先准备两份「AI 专用手册」(技能包):
| 技能 | 管什么 | 什么时候派上用场 |
|---|---|---|
weda-custom-method |
自定义方法怎么写 :查数据用 $w.cloud.callDataSource、统一的 try/catch 骨架、成功失败怎么提示 |
写按钮事件、页面加载逻辑、表单提交 |
weda-component-api |
组件有哪些属性和方法 :比如树组件的数据放在 data、选中值在 treeInfo.checked |
要操作页面上某个组件时 |
安装方式:把这两个技能文件夹放到 AI 工具能识别的技能目录(本项目里是 技能/ 目录),然后让agent安装这两个技能。你可以理解为:
weda-custom-method告诉 AI:微搭的代码长什么样;weda-component-api告诉 AI:页面上的组件能怎么操作。
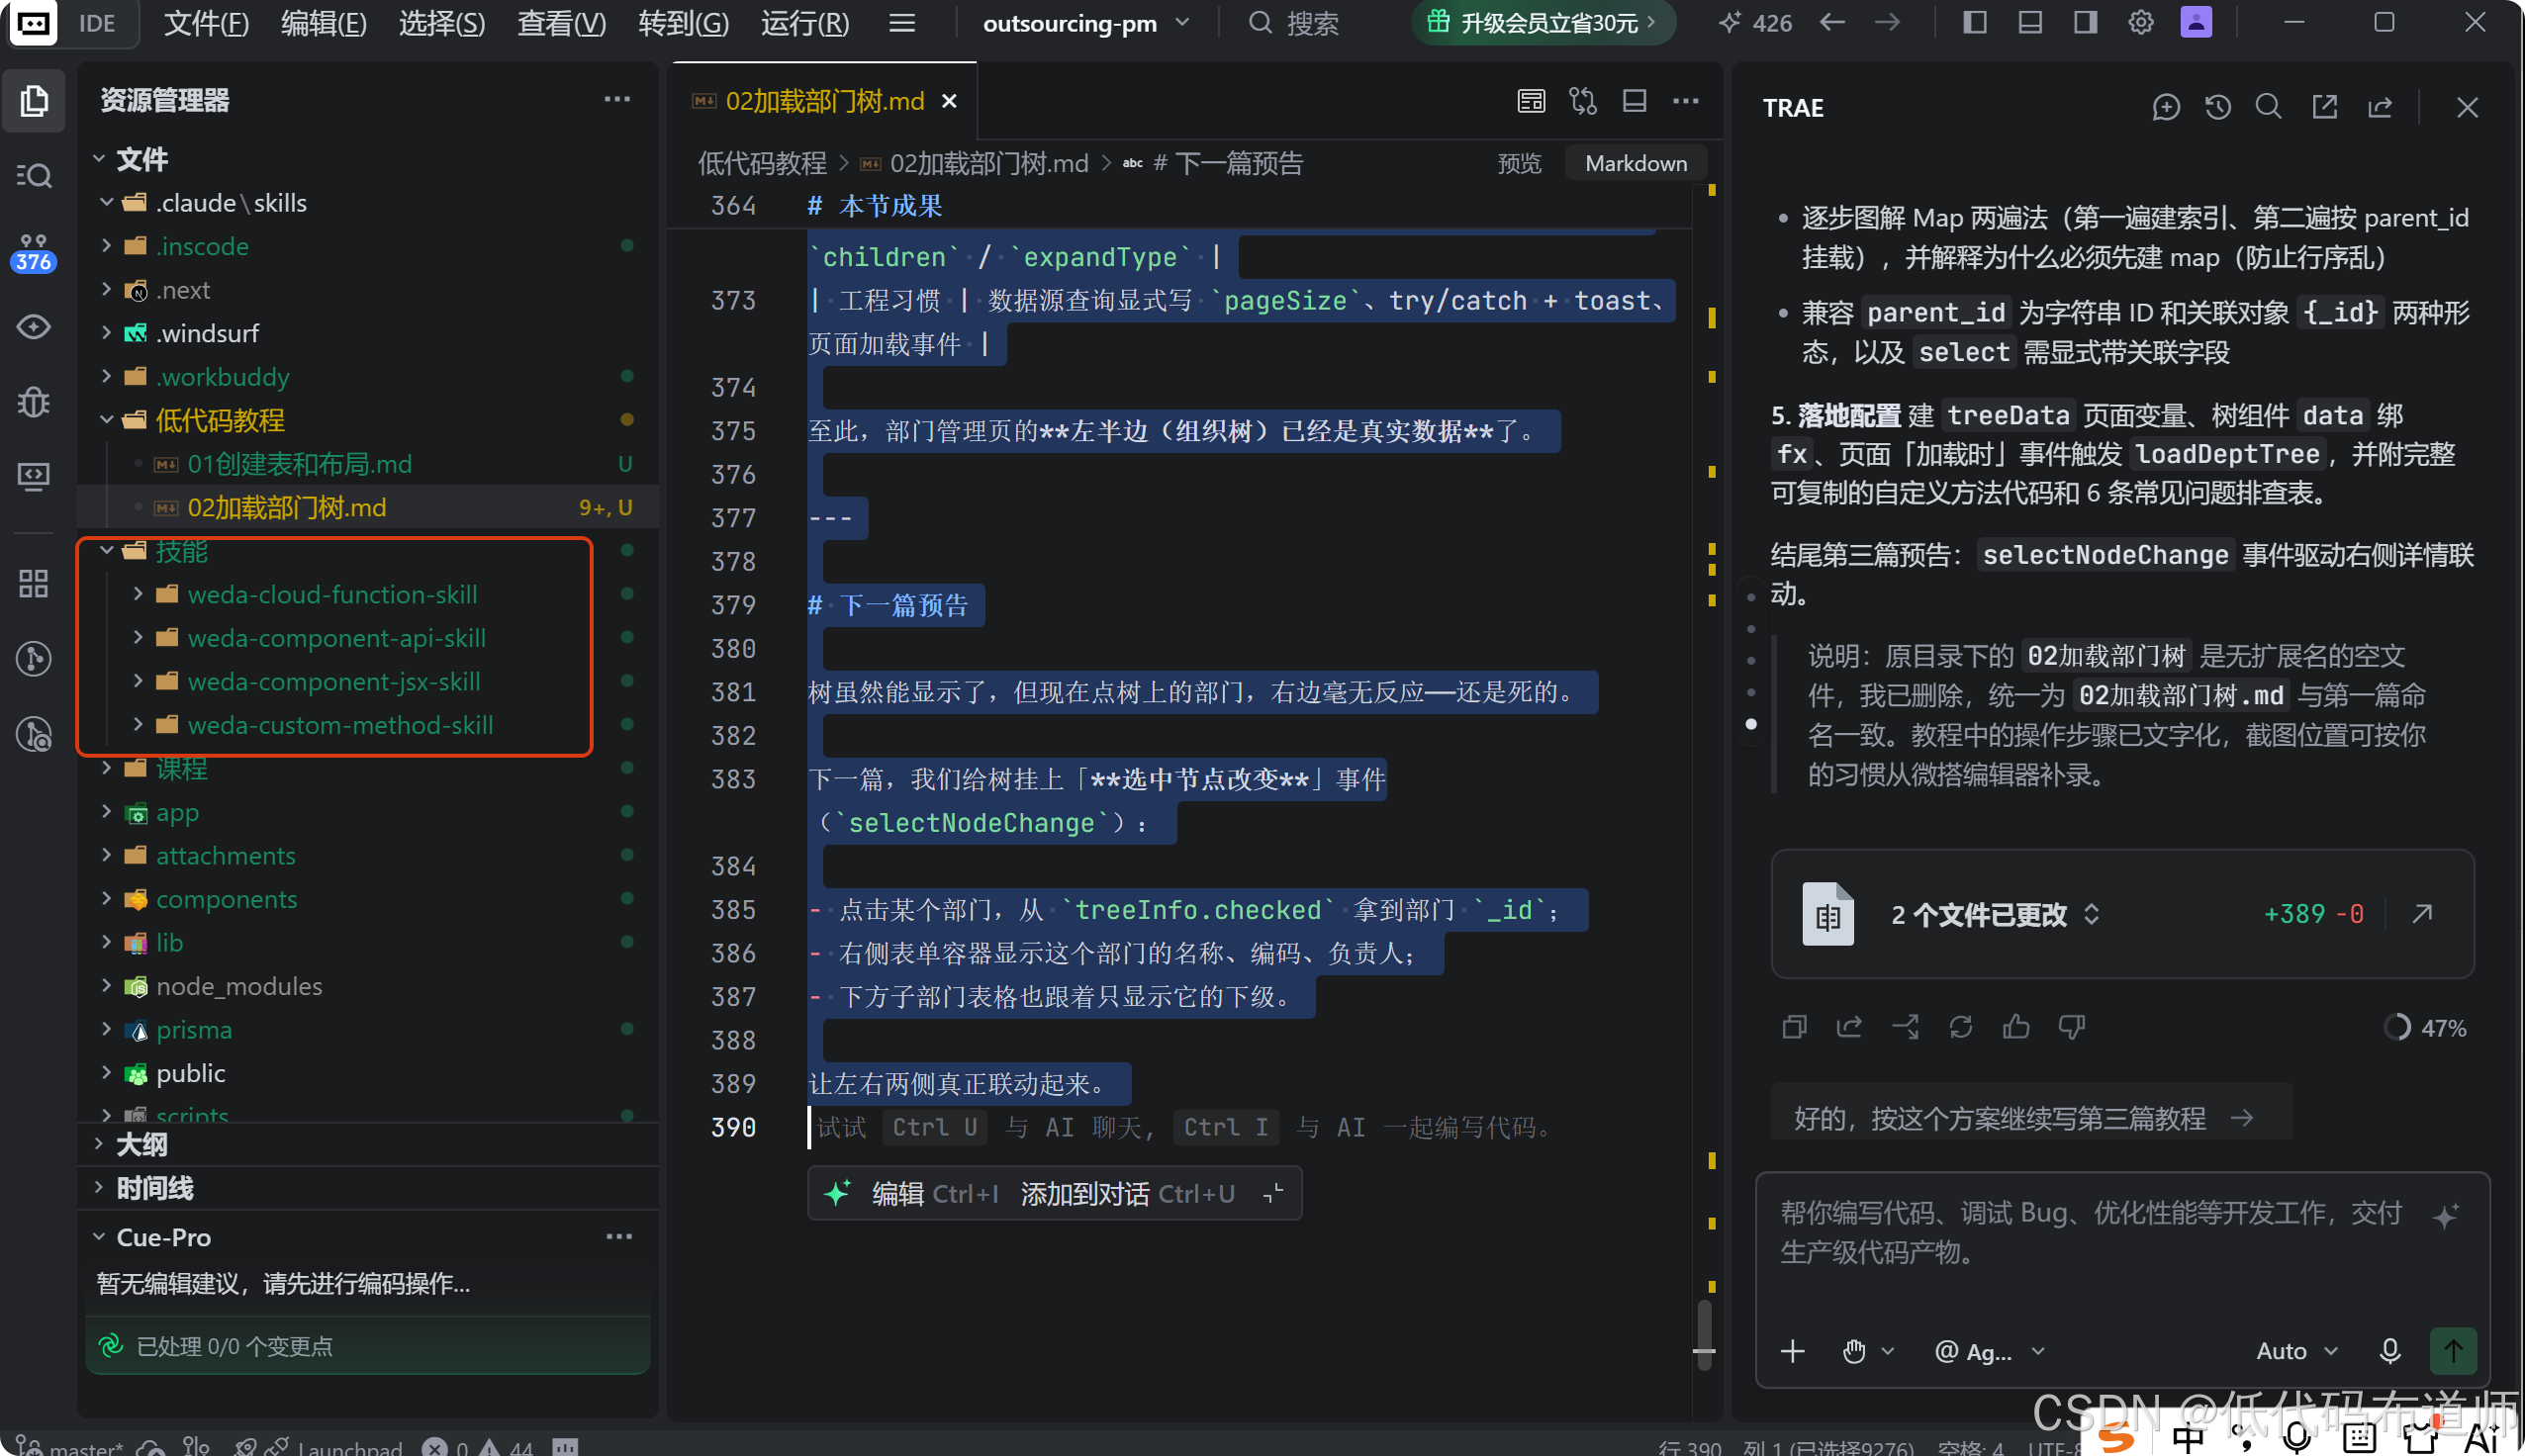
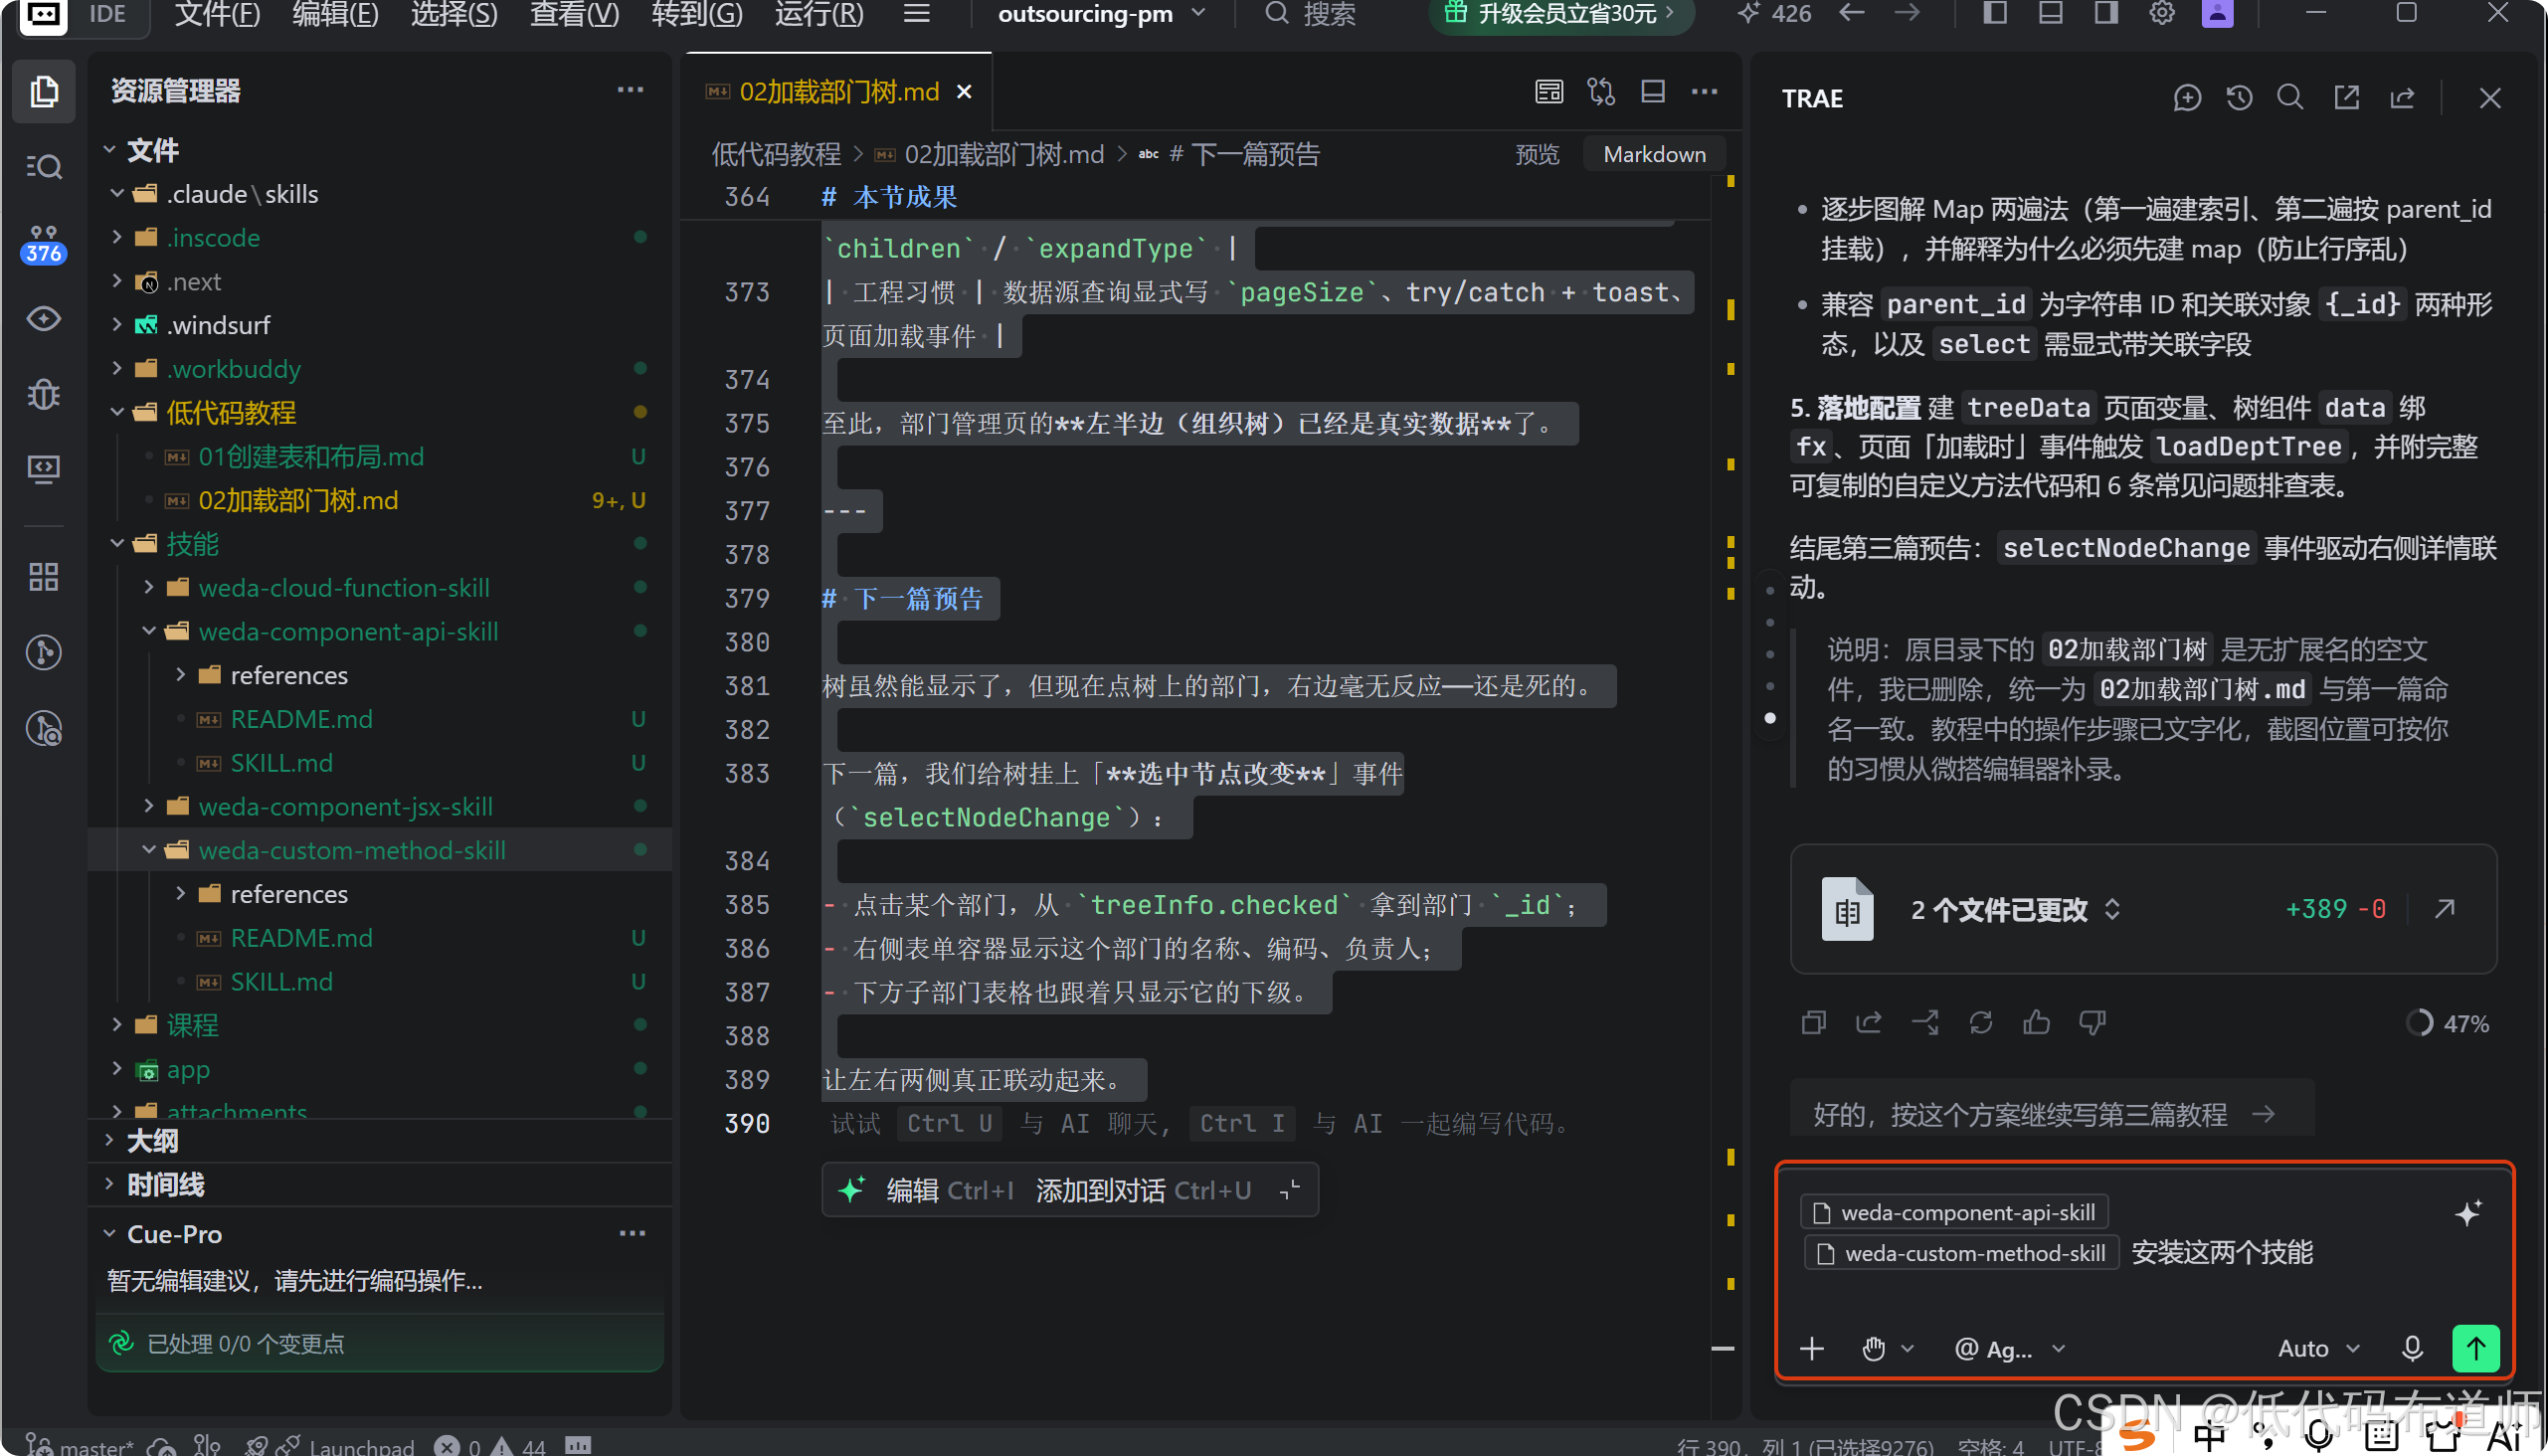
安装方法,将文件夹拖入到agent对话窗口,提示词为安装这两个技能
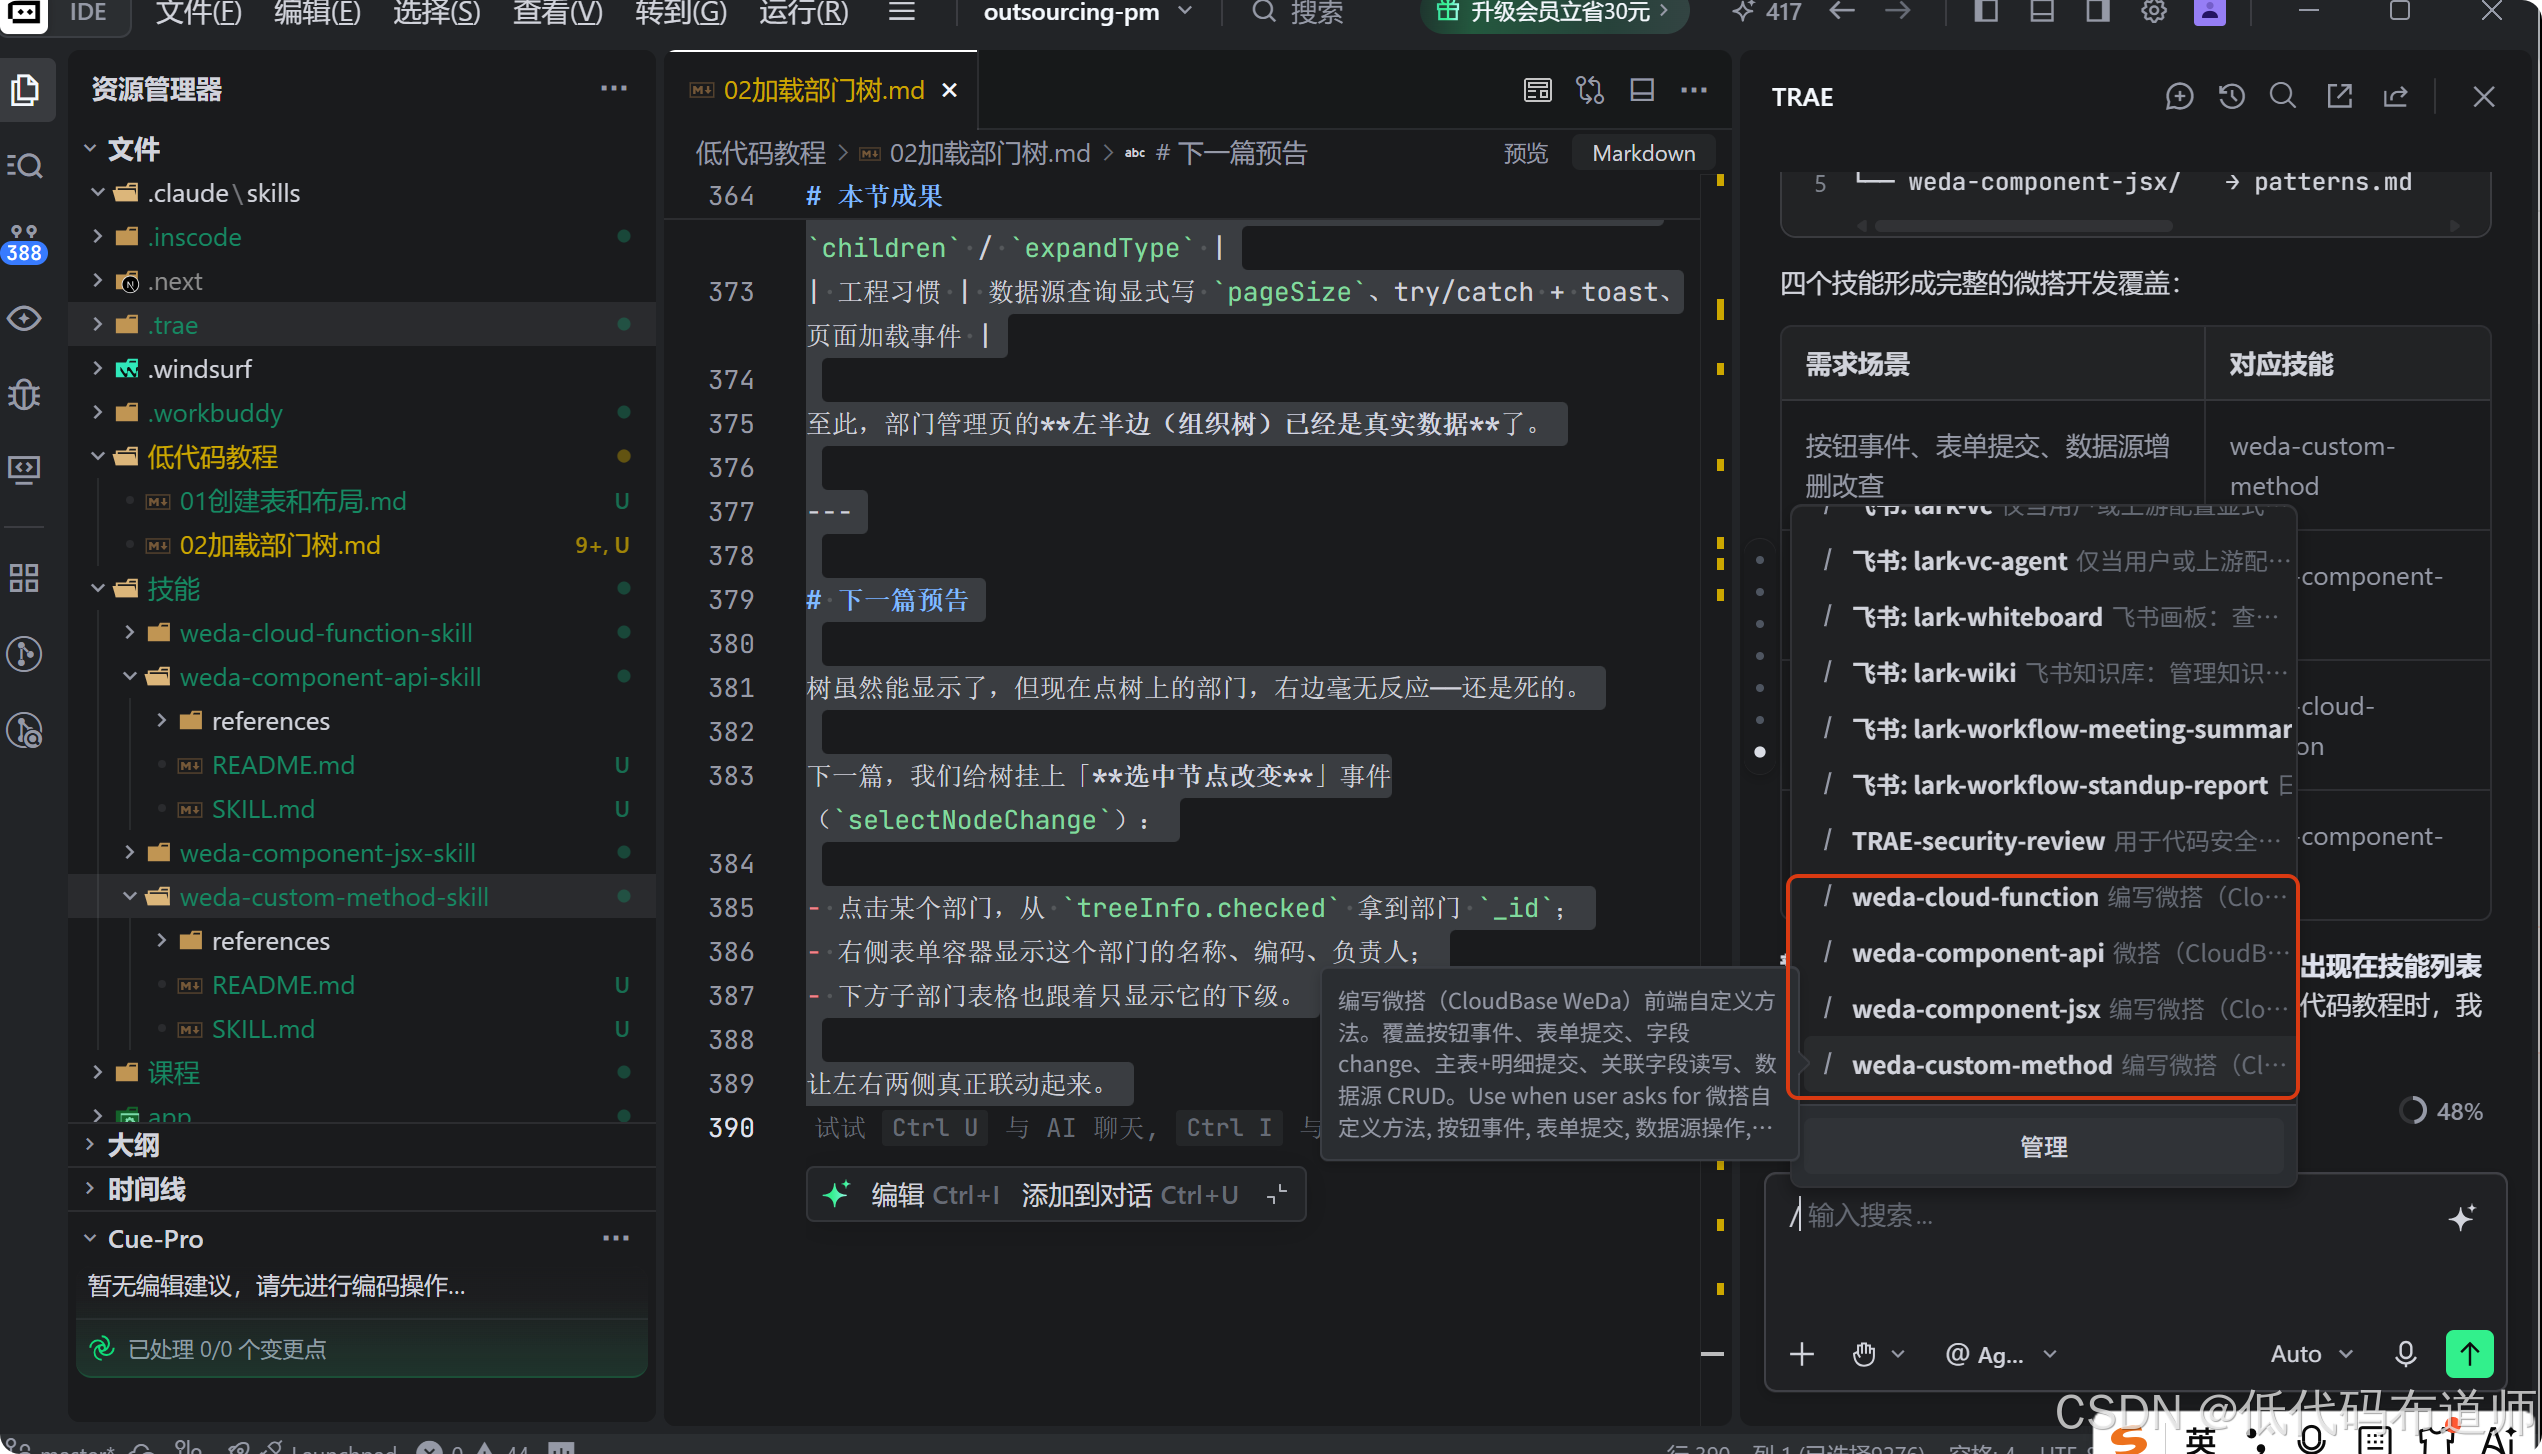
安装完毕后下一次你就可以用斜杠来调用技能
这一篇,我们就会同时用到这两份手册里的知识。
步骤一:先看清楚------「行」和「树」是两种东西
1.1 数据库里:部门是一行一行的
回忆上一篇,我们在 ct_dept 表里录的数据,长这样(完全平级,谁也不套谁):
_id |
name(名称) | parent_id(上级) | sort |
|---|---|---|---|
| d01 | 总部 | (空) | 10 |
| d02 | 销售部 | d01 | 10 |
| d03 | 交付中心 | d01 | 20 |
| d04 | 研发部 | d03 | 10 |
| d05 | 测试部 | d03 | 20 |
这是企业软件里最经典的树形存法:每行只记自己的上级是谁 (parent_id),不存完整层级。好处是改上级、加下级都简单。
1.2 树组件要的:一层套一层的 JSON
而树组件 WdTree 根本不认这种平表。它要的是一个嵌套数组,每个节点必须长这样:
json
[
  {
    "label": "总部",
    "value": "d01",
    "children": [
      { "label": "销售部", "value": "d02" },
      {
        "label": "交付中心",
        "value": "d03",
        "children": [
          { "label": "研发部", "value": "d04" },
          { "label": "测试部", "value": "d05" }
        ]
      }
    ]
  }
]
对比一下两者的差别:
| 数据库里的「行」 | 树组件要的「节点」 | |
|---|---|---|
| 结构 | 平级,靠 parent_id 指上级 |
嵌套,靠 children 装下级 |
| 名称字段 | name |
必须叫 label |
| 唯一标识 | _id |
必须叫 value |
| 适合 | 存储、条件查询 | 一次性渲染成树 |
所以我们的任务链路非常清晰:
text
ct_dept 表(平的行)
      │  ① 查出来
      ▼
  rows 行数组
      │  ② 行转树(本篇核心)
      ▼
 嵌套 JSON(label/value/children)
      │  ③ 赋给树组件的 data
      ▼
   页面上的组织树
千万别直接把查出来的行塞给树 ------字段名是
name/_id而不是label/value,组件会渲染出一片空白,而且不会报明显的错,特别难排查。
步骤二:认识树组件 WdTree
官方文档:https://docs.cloudbase.net/lowcode/components/wedaUI/src/docs/compsdocs/show/WdTree
WdTree(中文名就叫「树」)专门用来展示组织架构、分类这种多层级数据。我们只需要先记住下面几个点。
2.1 节点的三个必备 key
| key | 作用 | 我们用什么填 |
|---|---|---|
label |
节点上显示的文字 | 部门名称 name |
value |
节点的唯一标识,选中/展开都靠它 | 部门记录的 _id |
children |
子节点数组 | 拼出来的下级部门 |
另外还有可选的 disabled(设为 true 可禁用某节点),本篇用不到。
2.2 组件的几个关键属性(在右侧属性面板配置)
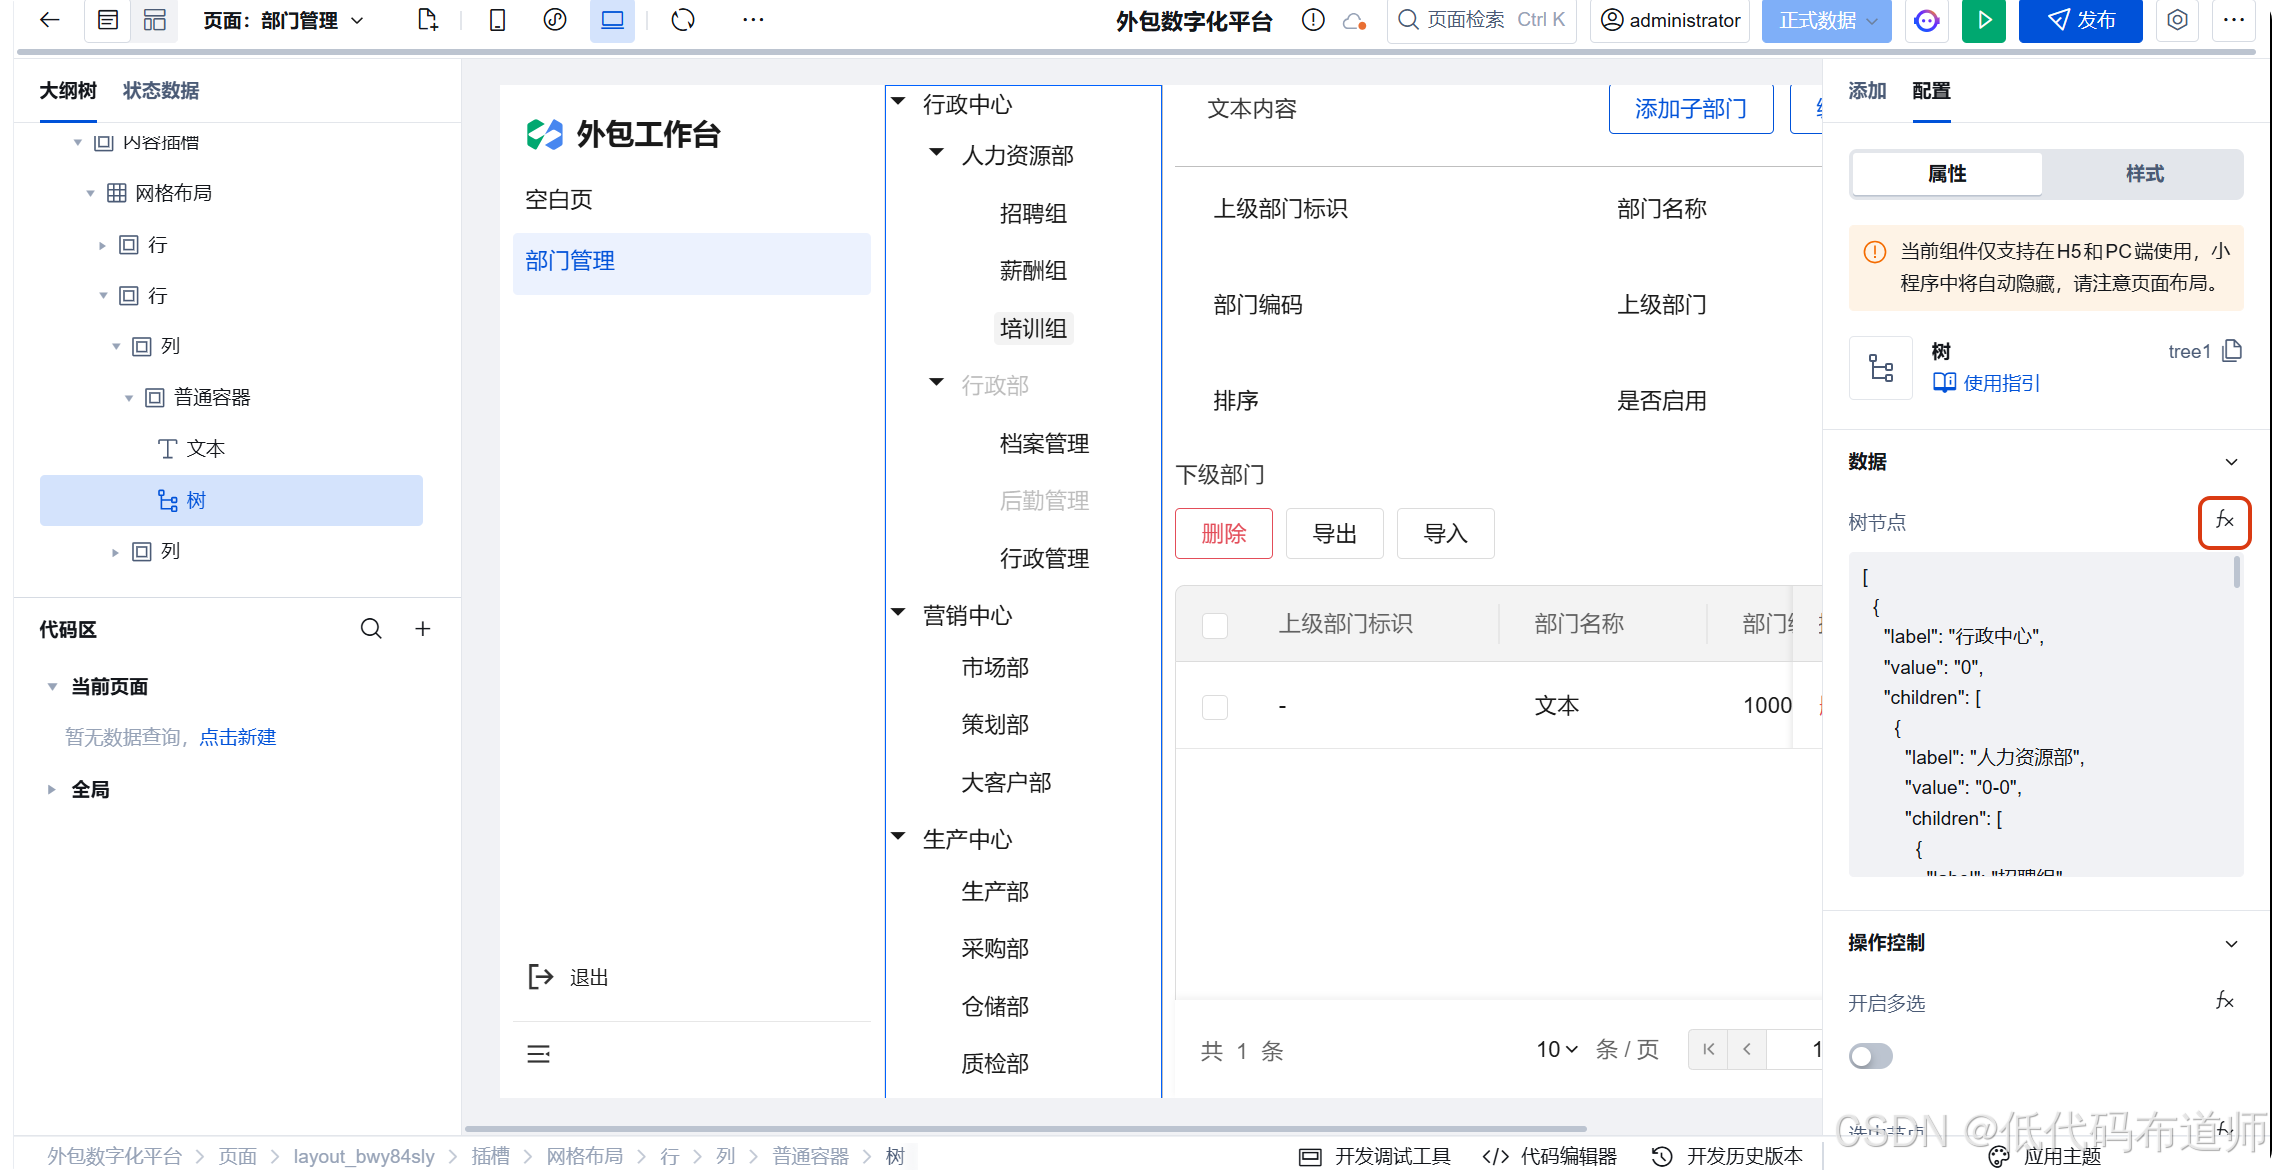
| 属性名 | 标识 | 本篇怎么配 |
|---|---|---|
| 树节点 | data |
点右侧 fx 按钮,绑定页面变量(后面细讲) |
| 开启多选 | checkable |
部门树是单选导航,保持关闭 |
| 节点展开方式 | expandType |
选「展开所有节点」,否则默认只显示根 |
| 展开的节点 | expandCustom |
展开方式选「自定义」时才用,填 value 数组 |
| 显示节点连接线 | line |
建议开启,层级更清楚 |
2.3 运行时能读到的信息(下一篇用,先混个脸熟)
用户在树上点了哪个节点,可以从 treeInfo 读到:
javascript
$w.tree1.treeInfo.checked[0] // 当前选中节点的 value(部门 _id)这一篇先不处理点击,只负责把树显示出来。
步骤三:写自定义方法 loadDeptTree
在微搭编辑器左侧代码区,新建一个自定义方法(JS 方法),命名为 loadDeptTree。
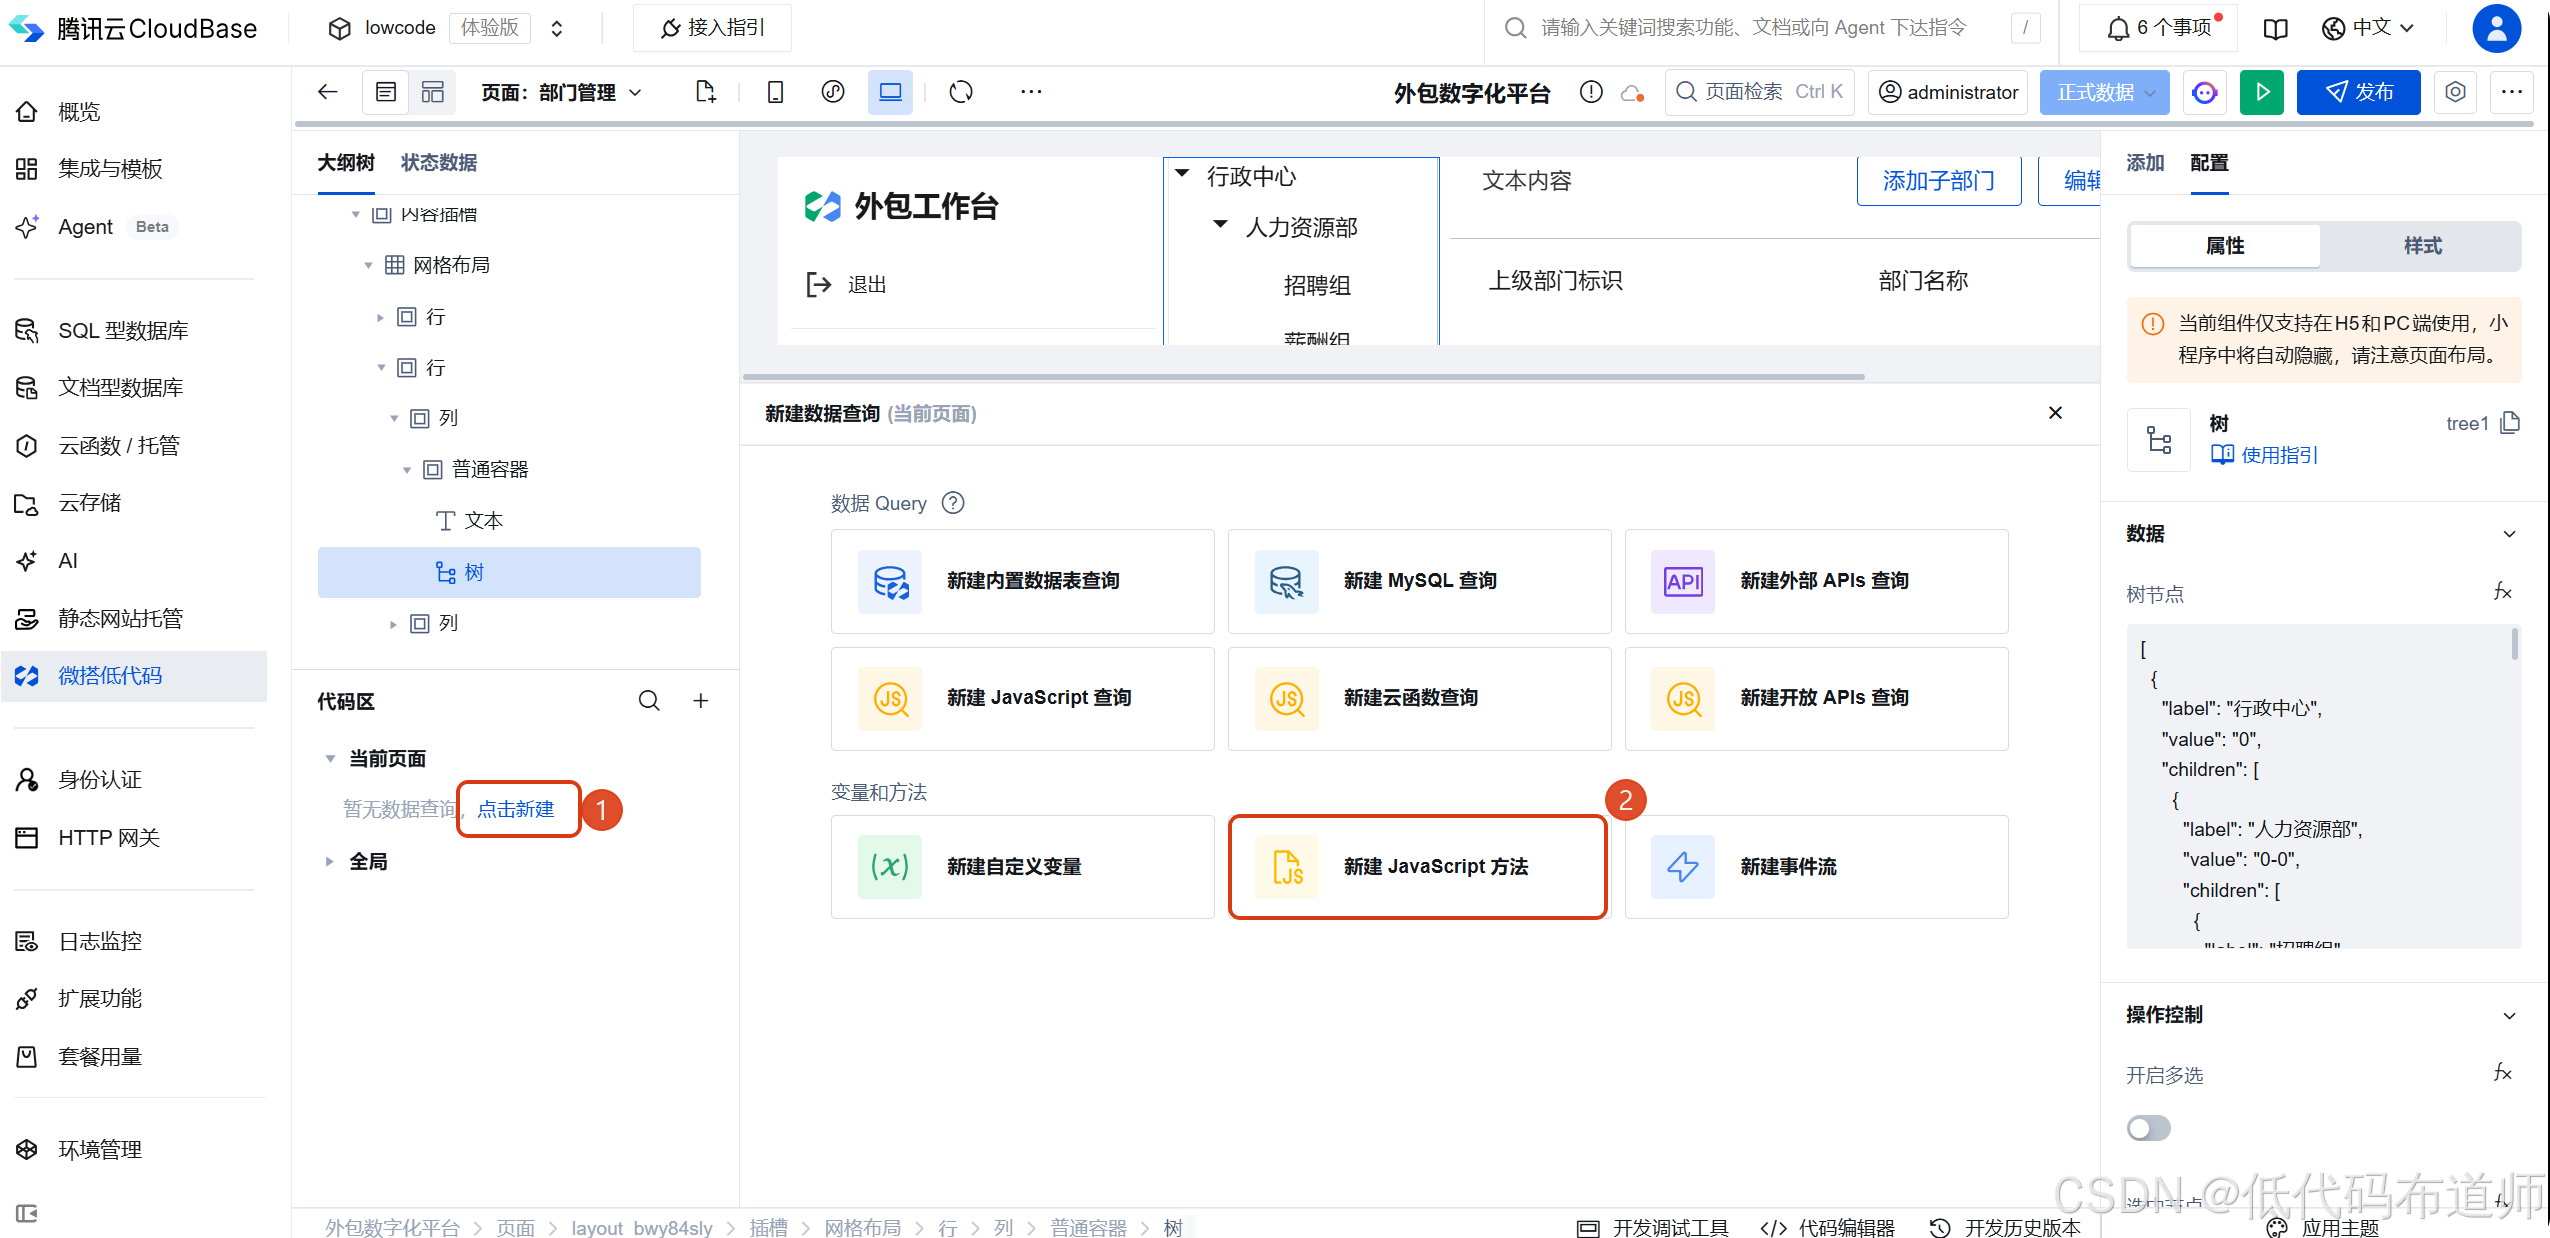
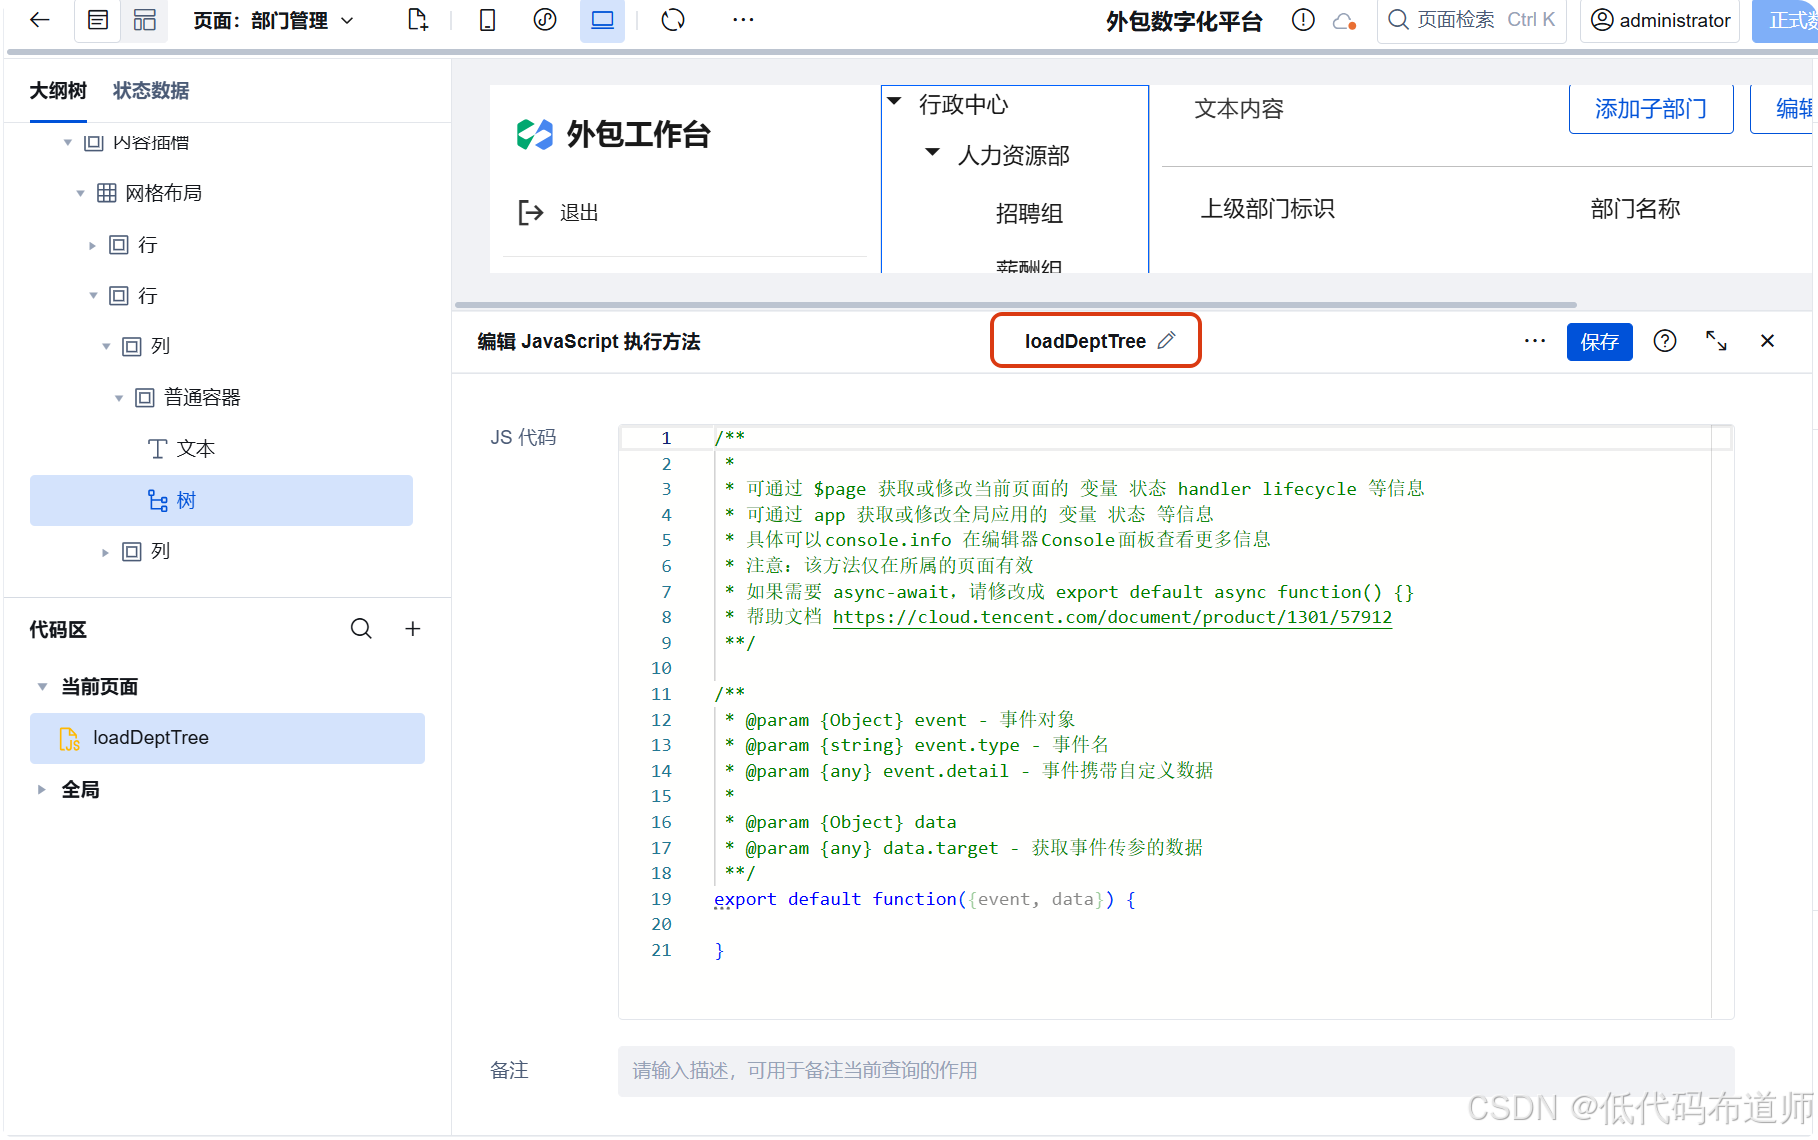
在代码编辑器中输入如下代码:
javascript
/**
 * 加载部门树
 * 查 ct_dept 全部启用部门 → 扁平行转嵌套树 → 写入页面变量 treeData
 * 绑定时机:页面「加载时」事件
 */
export default async function ({ event, data }) {
  try {
    $w.utils.showLoading({ title: '加载中', mask: true });

    // ========== 第一段:查(把平的行查出来) ==========
    const result = await $w.cloud.callDataSource({
      dataSourceName: 'ct_dept', // 数据模型的「标识」,不是显示名
      methodName: 'wedaGetRecordsV2',
      params: {
        filter: {
          where: { status: { $eq: '1' } }, // 只加载启用的部门
        },
        select: { $master: true }, // 返回主表全部字段
        pageSize: 200,             // 单次最多 200 条,必须显式写(默认只给 10 条!)
        pageNumber: 1,
        orderBy: [{ sort: 'asc' }],
      },
    });

    const rows = result?.records || [];
    if (rows.length === 0) {
      $w.page.dataset.state.treeData = []; // 一条部门都没有时给空树
      return;
    }

    // ========== 第二段:转(行 → 树,本篇核心) ==========
    // ------ 第一遍:给每个部门造一个节点,收进 map,key 是部门 _id ------
    const nodeMap = {};
    rows.forEach((row) => {
      nodeMap[row._id] = {
        label: row.name, // 树组件要求显示名必须叫 label
        value: row._id,  // 唯一标识必须叫 value
        children: [],    // 先统一放空数组,第二遍再往里挂下级
      };
    });

    // ------ 第二遍:按 parent_id,把每个节点挂到它上级的 children 里 ------
    const tree = [];
    rows.forEach((row) => {
      const node = nodeMap[row._id];
      // 兼容两种存法:上级直接存 ID(字符串)/ 存关联对象({ _id })
      const parentId = row.parent_id?._id || row.parent_id;

      if (parentId && nodeMap[parentId]) {
        nodeMap[parentId].children.push(node); // 有上级 → 挂进上级的 children
      } else {
        tree.push(node); // 没上级(或上级被停用、不在本次结果里)→ 作为根节点
      }
    });

    // ========== 第三段:塞(写入页面变量,组件通过 fx 绑定它) ==========
    $w.page.dataset.state.treeData = tree;
  } catch (error) {
    console.error('加载部门树失败:', error);
    $w.utils.showToast({
      title: error?.message || '部门树加载失败',
      icon: 'error',
      duration: 2000,
    });
  } finally {
    $w.utils.hideLoading();
  }
}
下面把这段代码里的两个关键知识点讲透。
3.1 查数据:wedaGetRecordsV2
这是微搭数据源「查多条」的标准方法,有两个坑必须提醒:
pageSize一定显式写。默认只返回 10 条------你建了 15 个部门,树上永远只显示一部分,还以为是拼树代码写错了。单次上限 200 条,对部门来说绰绰有余。dataSourceName填模型标识ct_dept,不是你在界面上起的中文显示名。
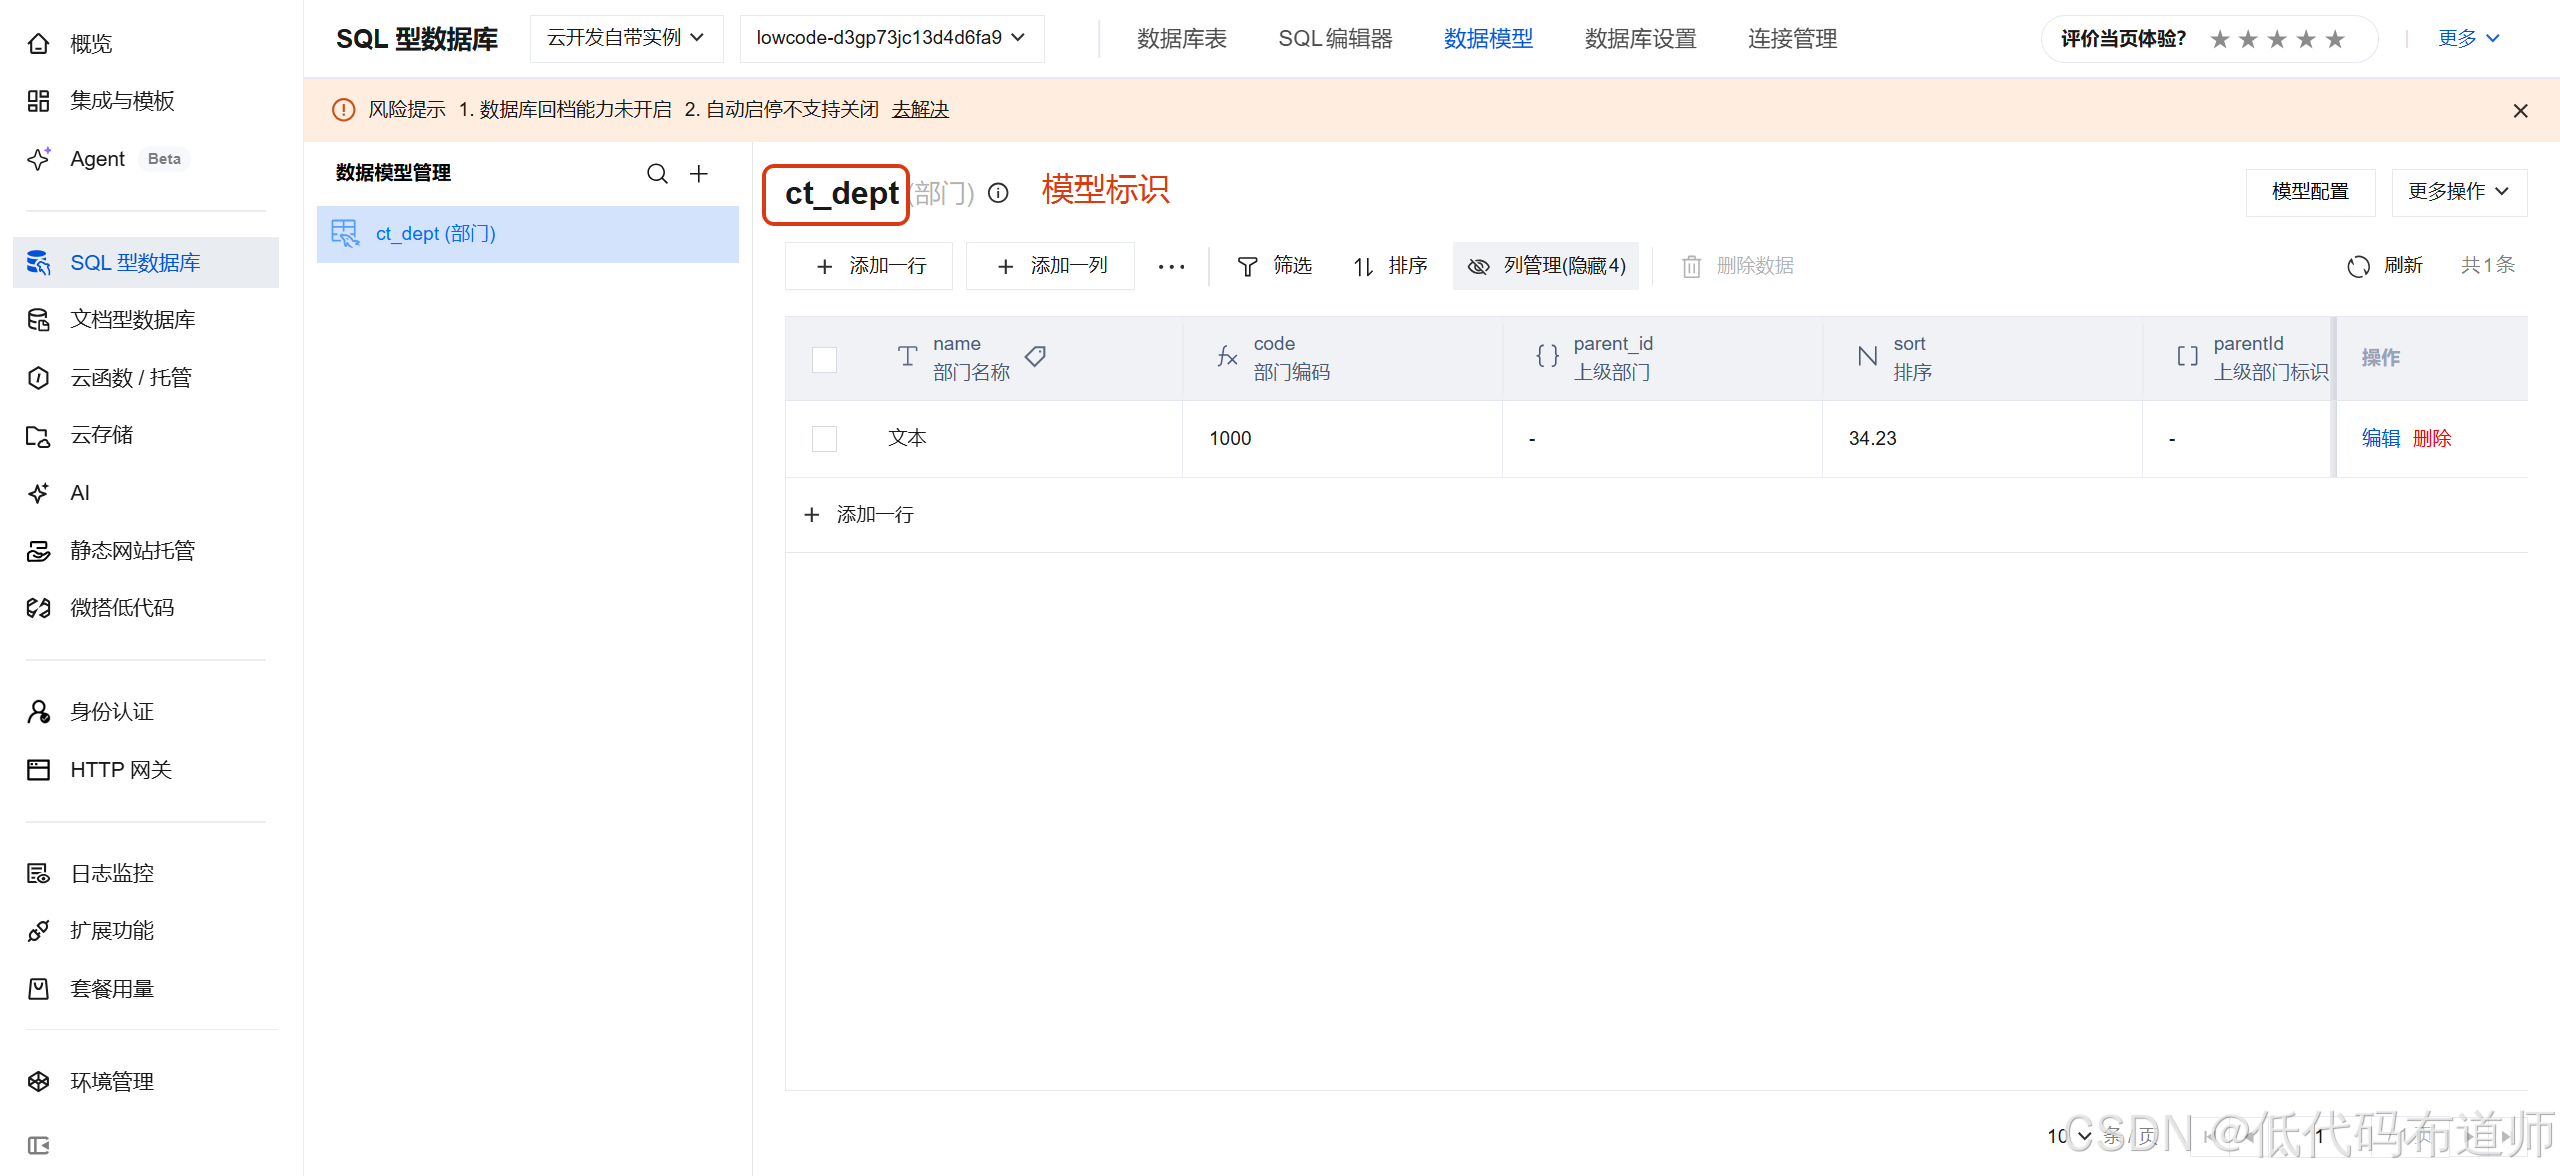
3.2 行转树:Map 两遍法(重点)
这是本篇最值钱的一段逻辑,所有树形加载(部门、分类、物料分组)都是同一个套路。
第一遍:建索引。 遍历所有行,每行造一个 { label, value, children: [] } 节点,放进一个以 _id 为 key 的「字典」nodeMap 里:
text
nodeMap = {
  d01: { label:'总部',   value:'d01', children:[] },
  d02: { label:'销售部', value:'d02', children:[] },
  d03: { label:'交付中心', value:'d03', children:[] },
  d04: { label:'研发部', value:'d04', children:[] },
  d05: { label:'测试部', value:'d05', children:[] },
}
第二遍:挂载。 再遍历一次,看每一行的 parent_id:
- 研发部(d04)的上级是 d03,而
nodeMap['d03']一定存在(第一遍已经全部建好),于是把研发部节点push进交付中心的children; - 总部(d01)没有上级,放进根数组
tree。
走完第二遍,嵌套关系就自然形成了:
text
tree = [ 总部 ]
          └─ children: [ 销售部, 交付中心 ]
                                  └─ children: [ 研发部, 测试部 ]
为什么要先全部建进 map,再挂载? 因为查询结果的顺序是不确定的------万一「研发部」这行排在「交付中心」前面,挂载时它的上级还没出生。有了 map 做索引,无论行的顺序怎么乱,第二遍都能找到上级。整个算法每个部门只处理两次,性能也好。
对照看原型是怎么做的:我们外包平台原型(Next.js 版)里用的是「递归过滤」------每遇到一个部门,就把全部部门过滤一遍找它的孩子,再递归往下:
typescriptfunction buildTree(rows, parentId = null) { return rows .filter((row) => row.parentId === parentId) .map((row) => ({ id: row.id, name: row.name, children: buildTree(rows, row.id), // 递归找下级 })); }两种写法结果完全一样。递归写法直观,但每个节点都要全表扫描一次;Map 两遍法在前端自定义方法里更简洁、也不怕数据乱序,所以本篇用它。
parent_id 的两种形态 也要注意:如果上一篇你把「上级部门」建成了普通文本字段,它直接就是上级 ID;如果建成了关联字段 ,查回来会是个对象 { _id: 'd03' }。代码里 row.parent_id?._id || row.parent_id 这一句两种情况都兼容。若是关联字段,还要在查询参数里把它显式带回来:
javascript
select: { $master: true, parent_id: true },步骤四:建页面变量,接住树数据
自定义方法里我们把结果写到了 $w.page.dataset.state.treeData,这个变量需要先在编辑器里创建:
在代码区点击+,在右侧面板点击新建自定义变量
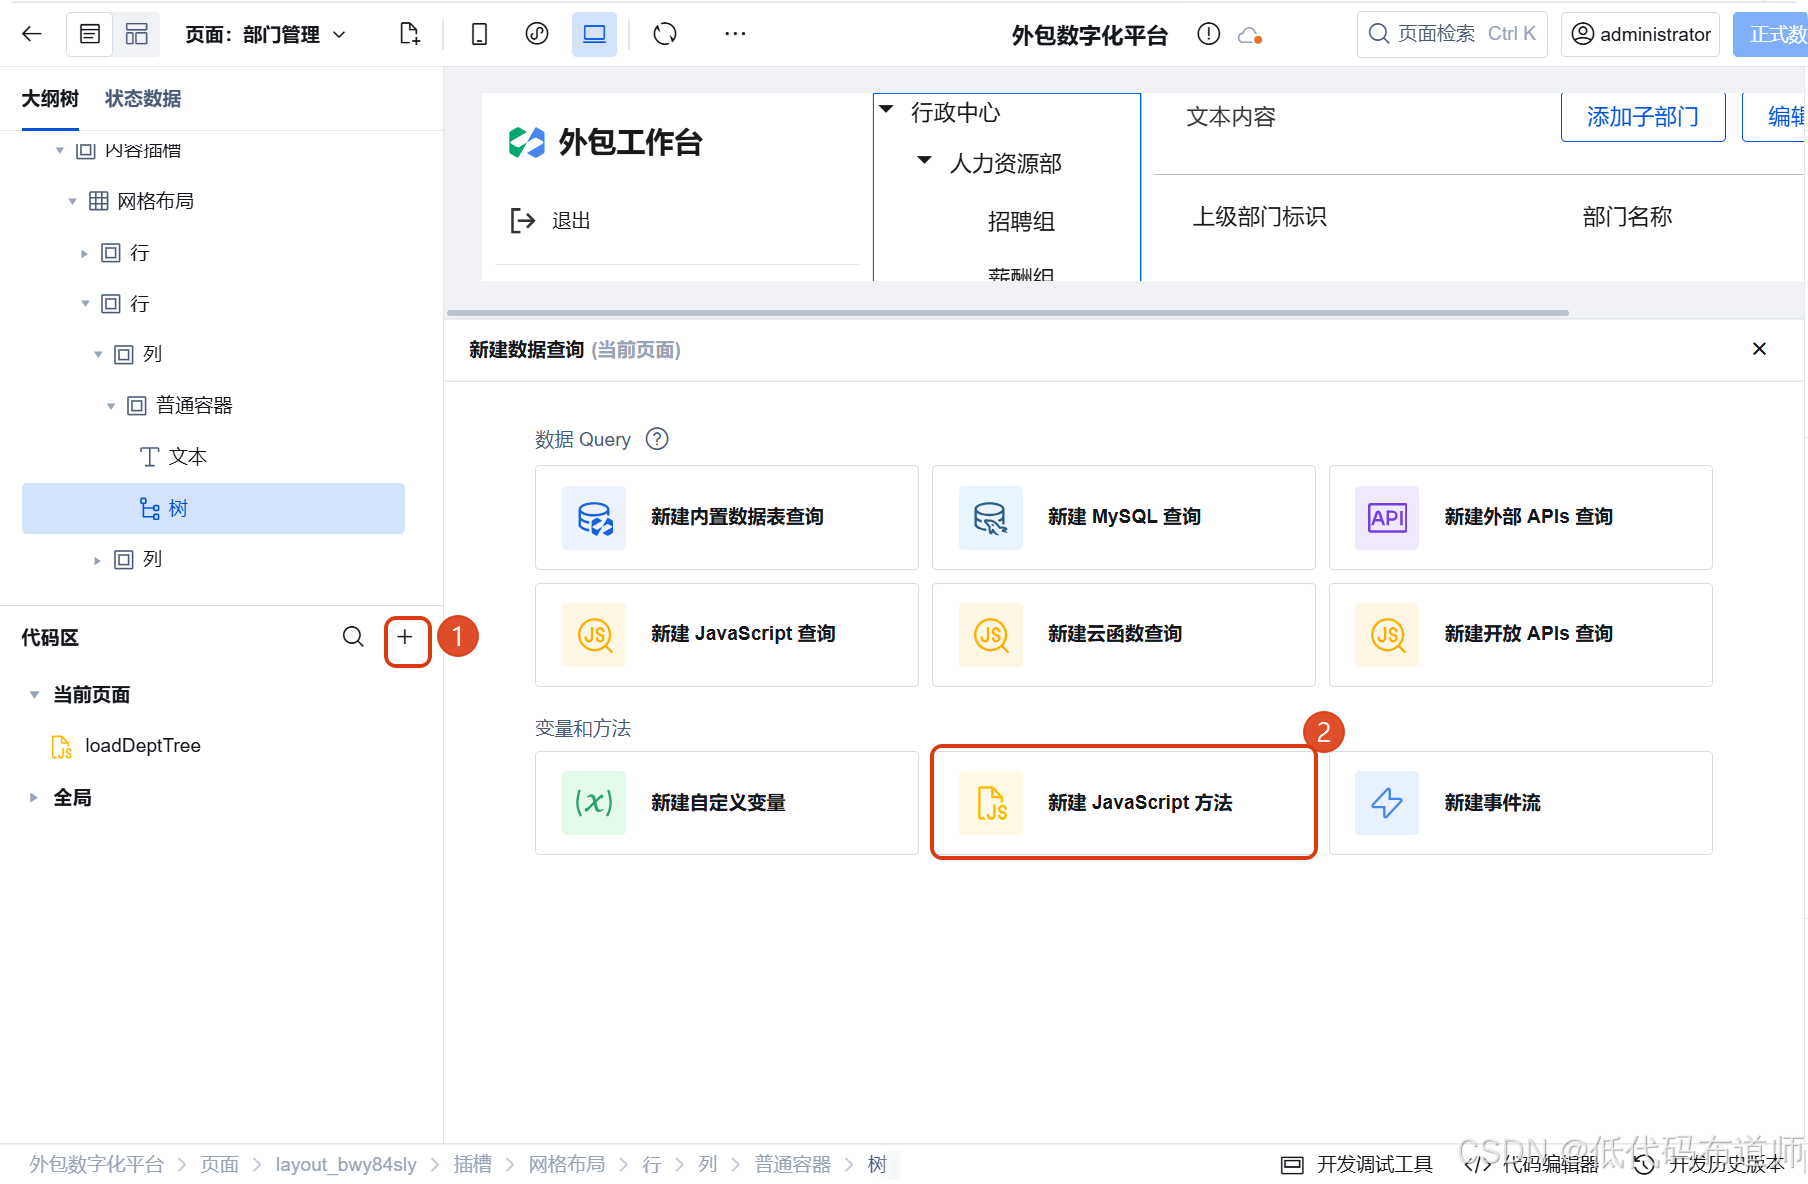
变量名填 treeData(和代码里完全一致)
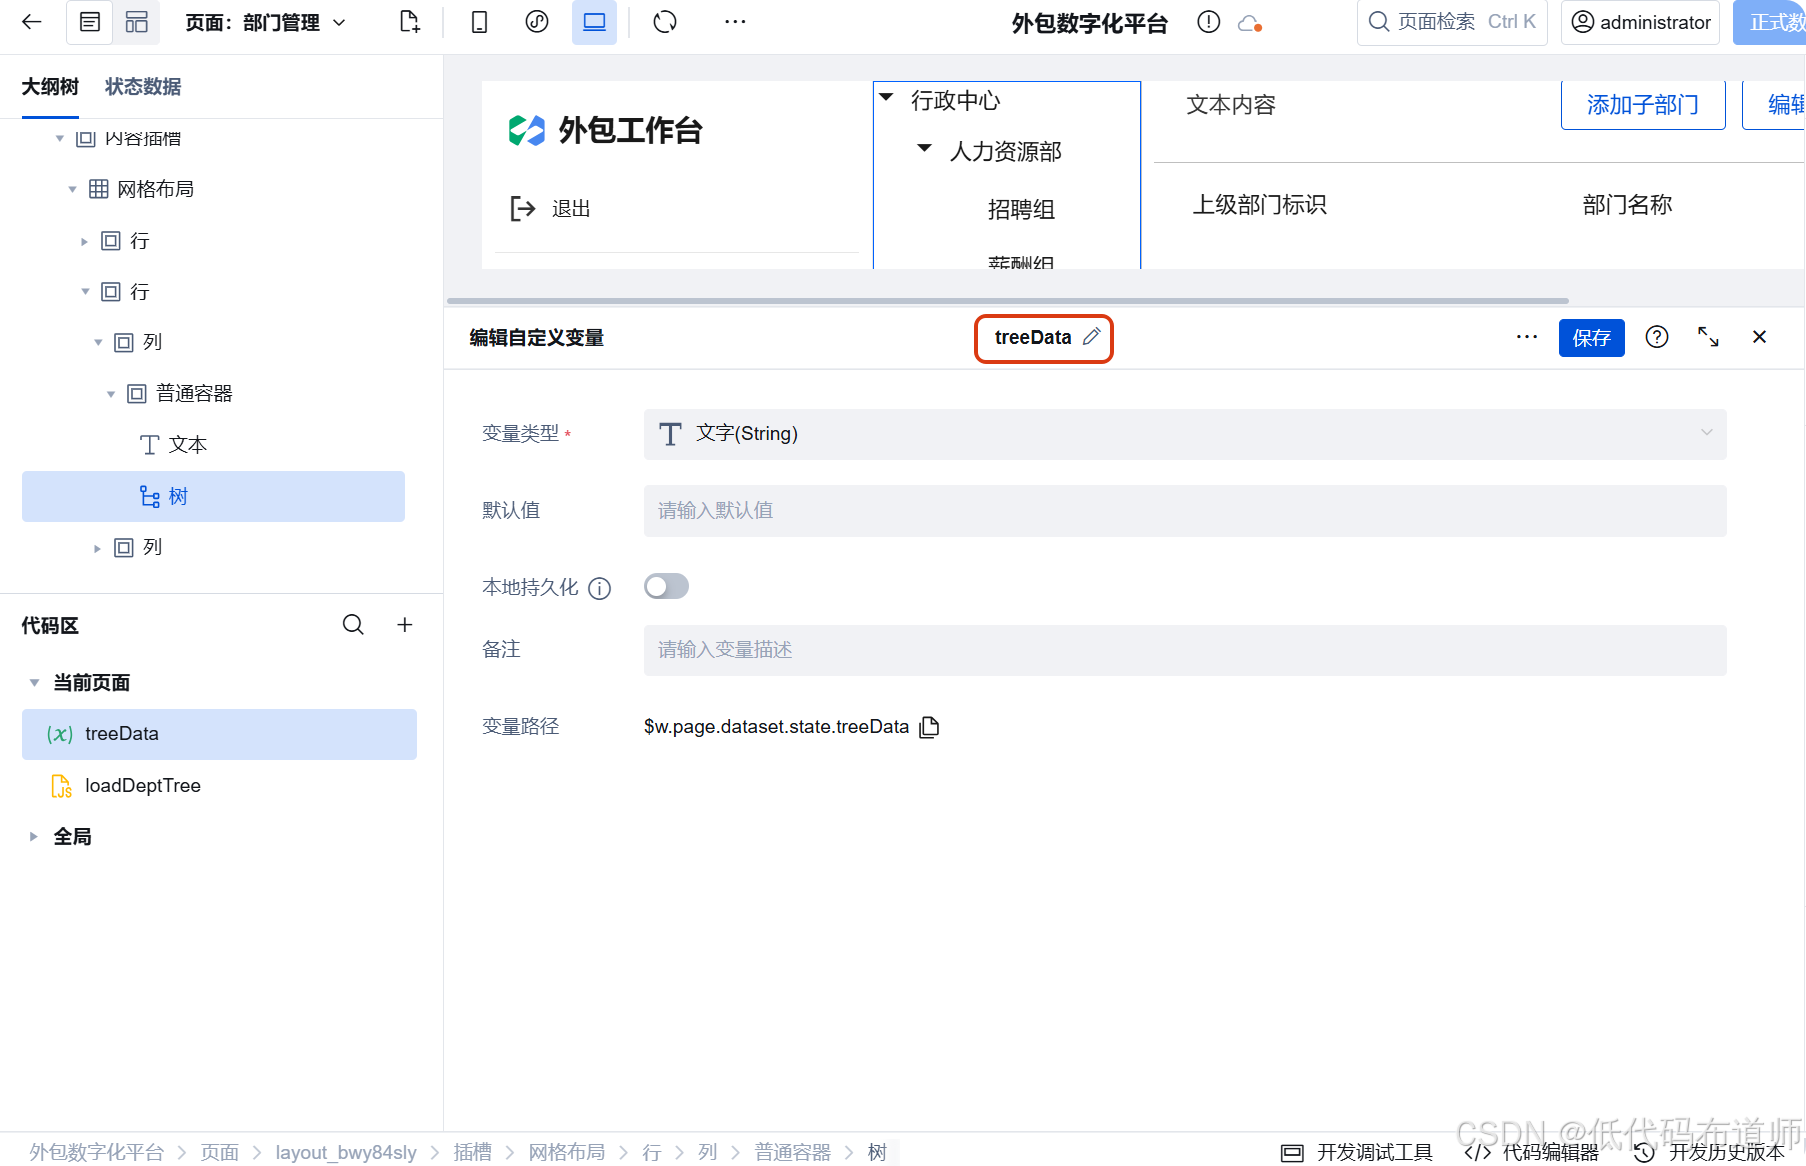
类型选「数组」,初始值设为空数组
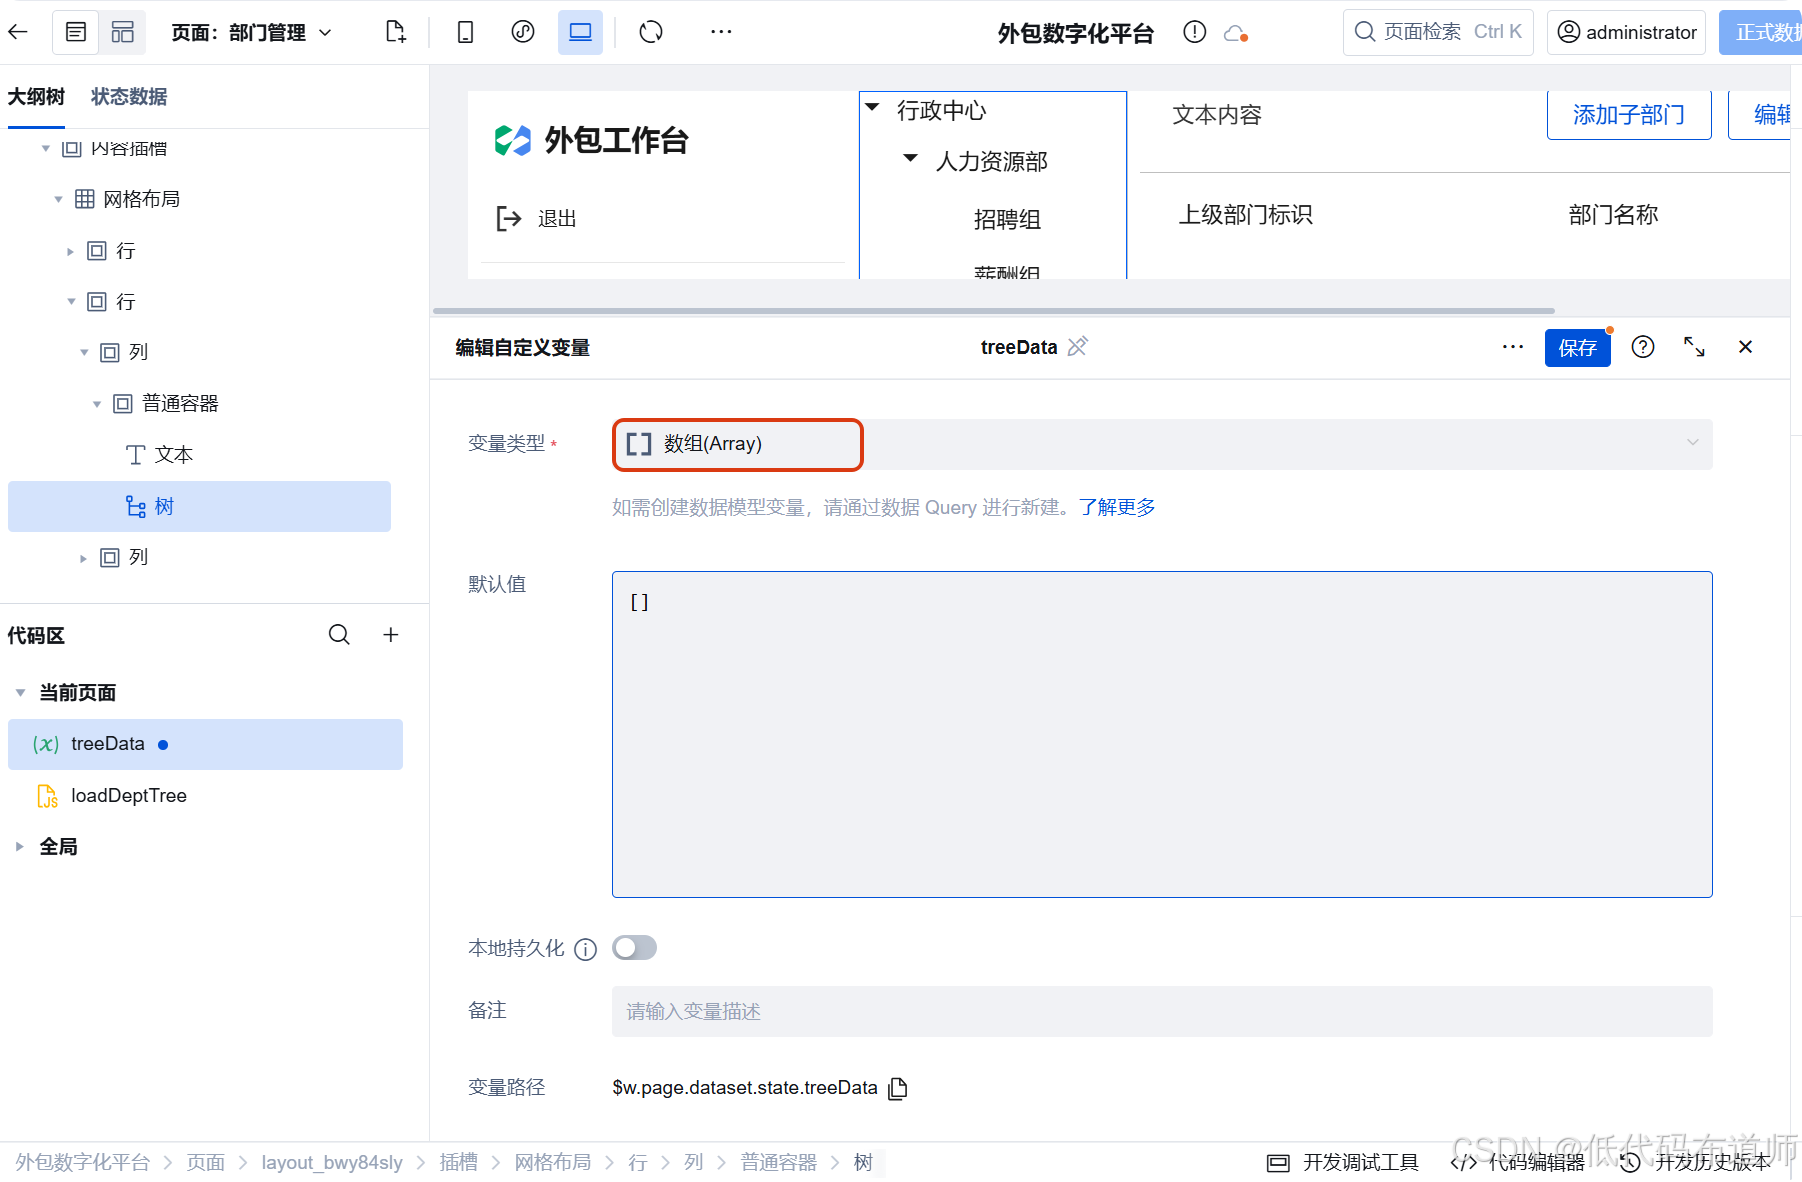
步骤五:把树组件绑到变量上
选中树组件,找到属性「树节点 」(标识 data),点击右侧的 fx 按钮,打开表达式编辑器
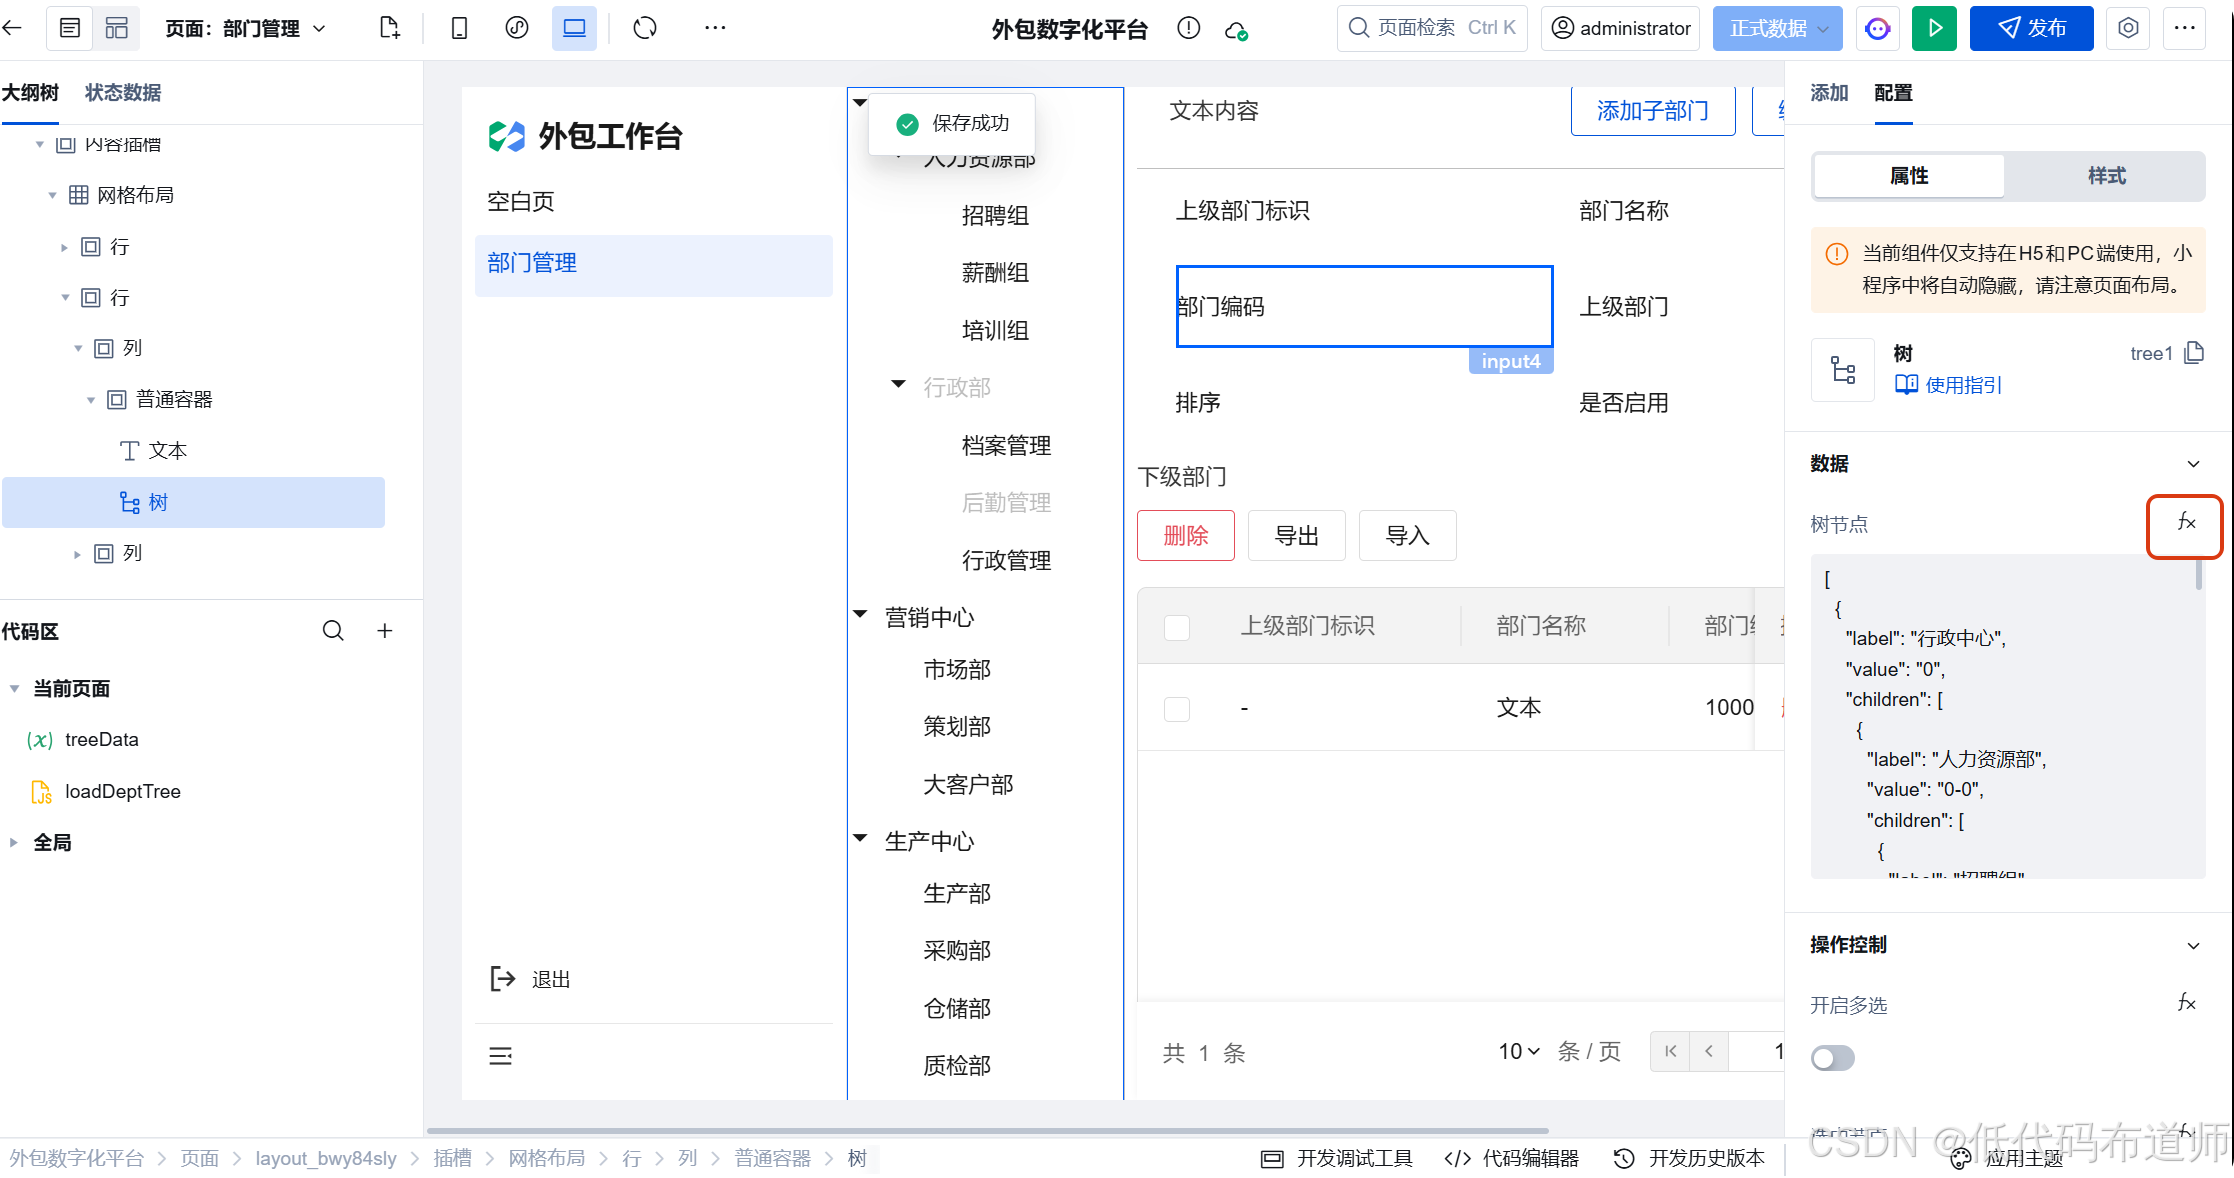
绑定表达式:
javascript
$w.page.dataset.state.treeData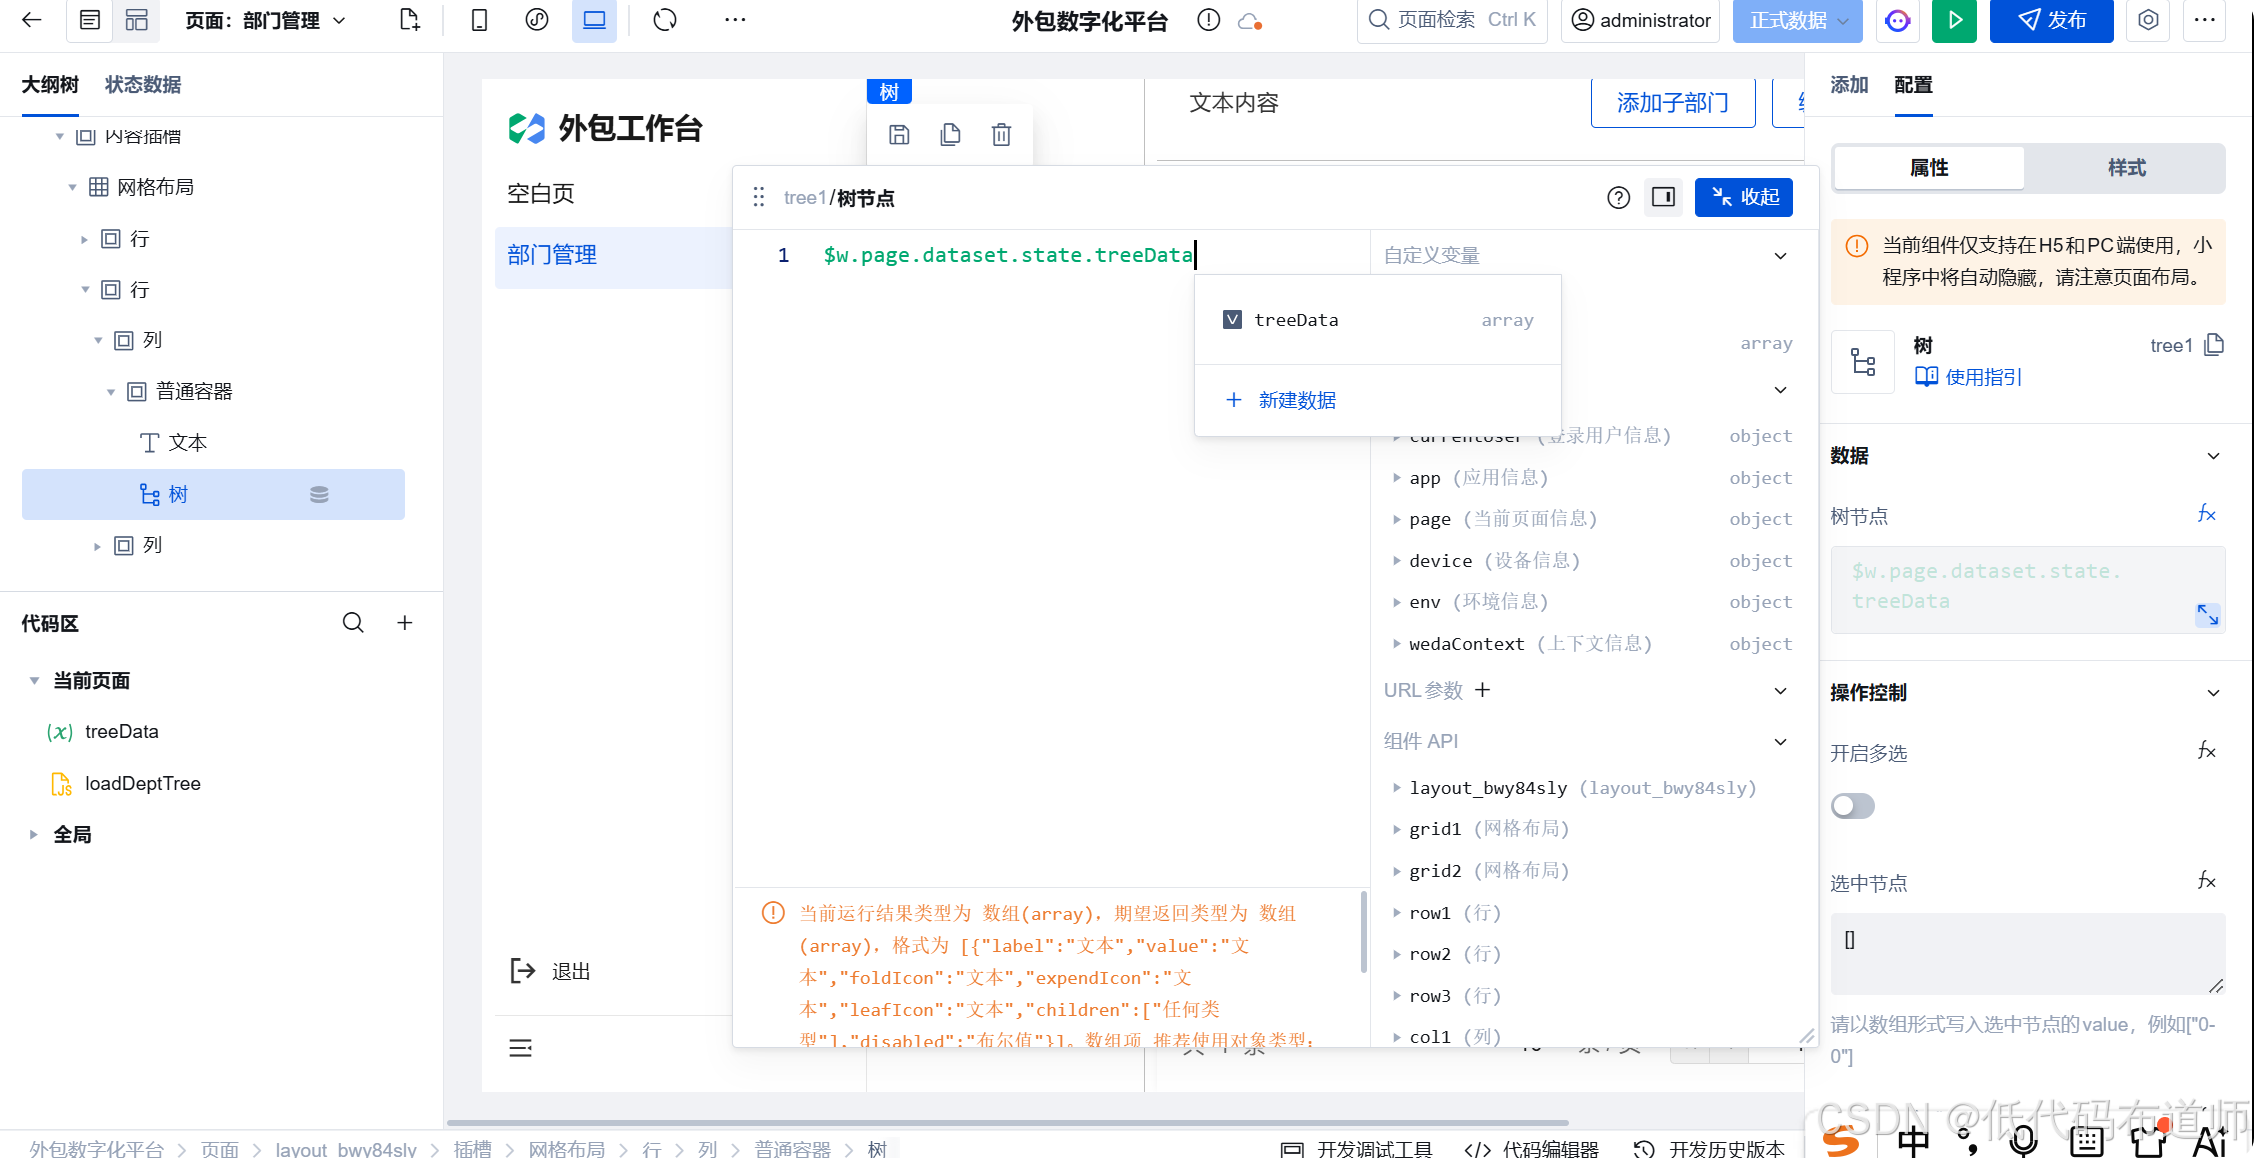
这样组件和数据就接上了:方法往变量里写 → 组件通过 fx 读变量 → 自动渲染。这是微搭里最常用的数据流模式,后面表格、详情都这么玩。
步骤六:让页面打开时自动加载
最后一步,告诉页面「一加载就执行 loadDeptTree」:
在大纲树点选最外层的页面 节点
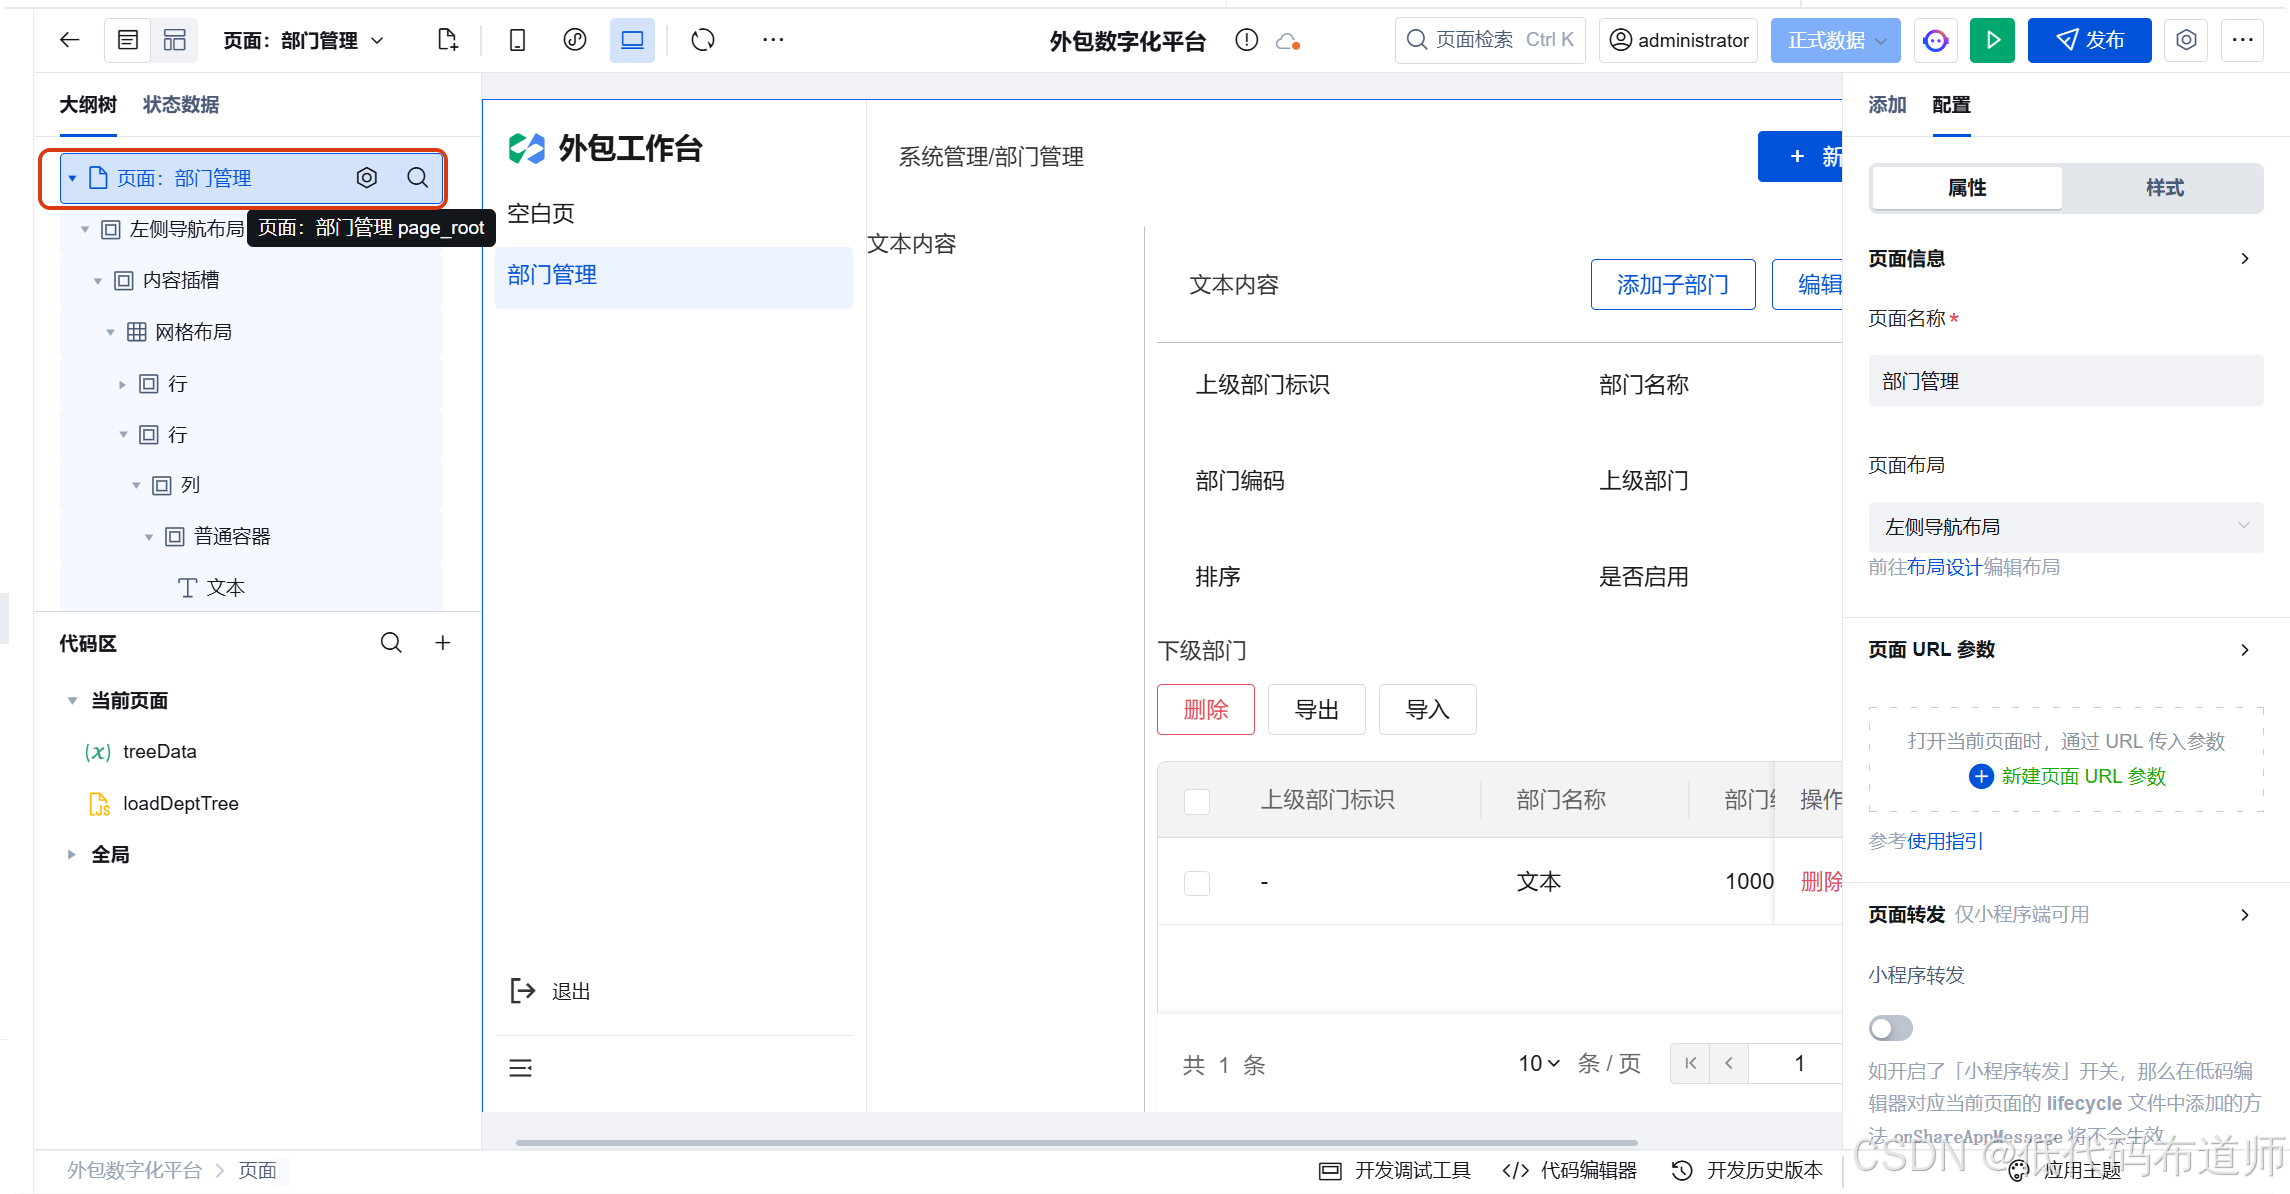
右侧下拉到「事件 」面板;
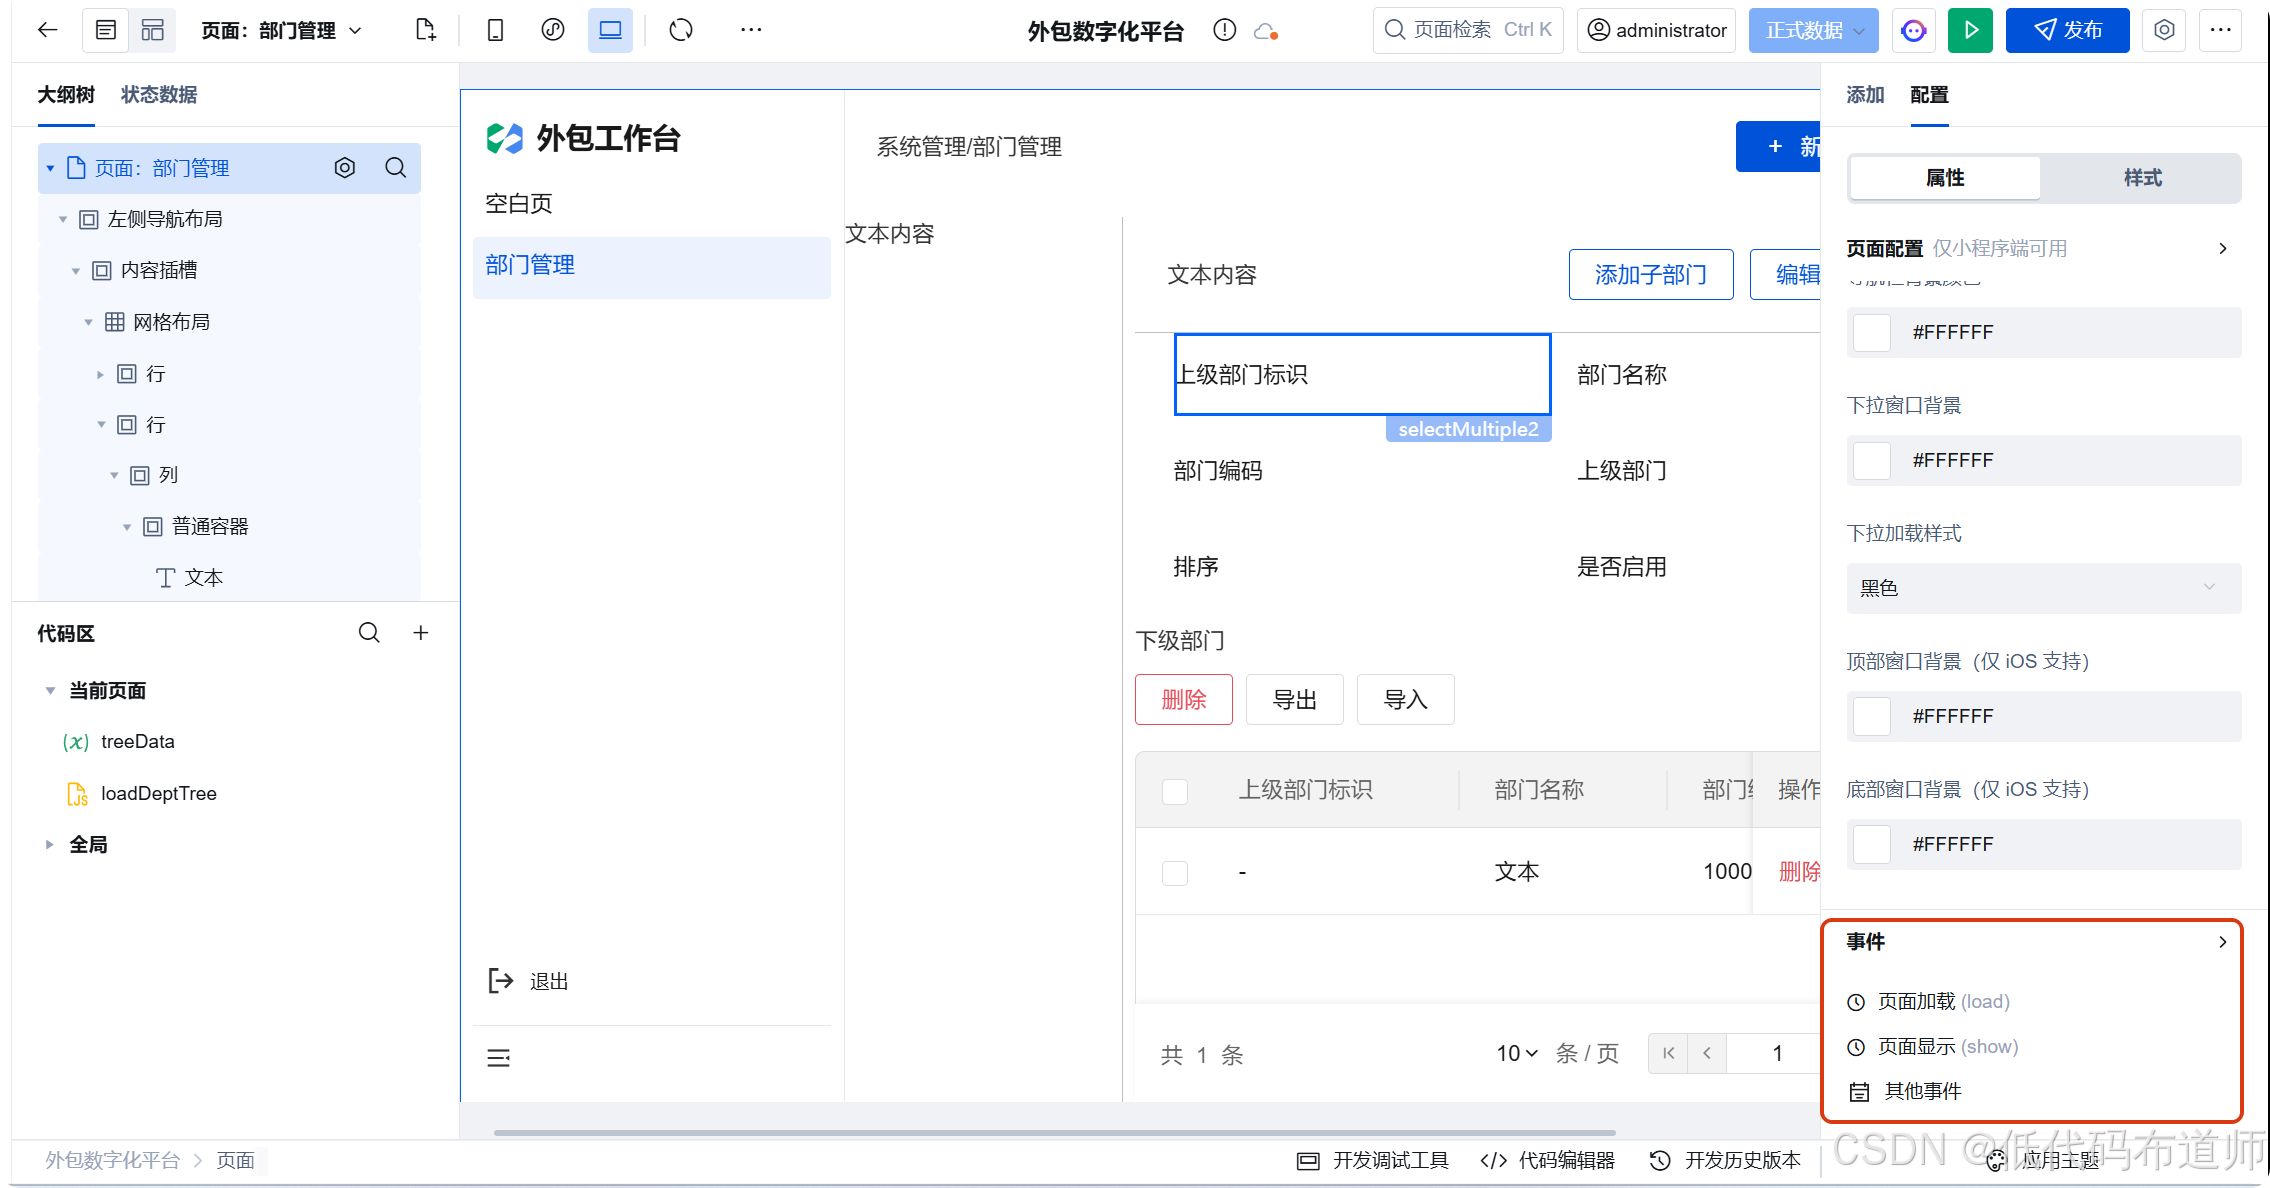
找到「加载时 」(页面生命周期事件),新增动作 → 调用自定义方法 → 选择 loadDeptTree。
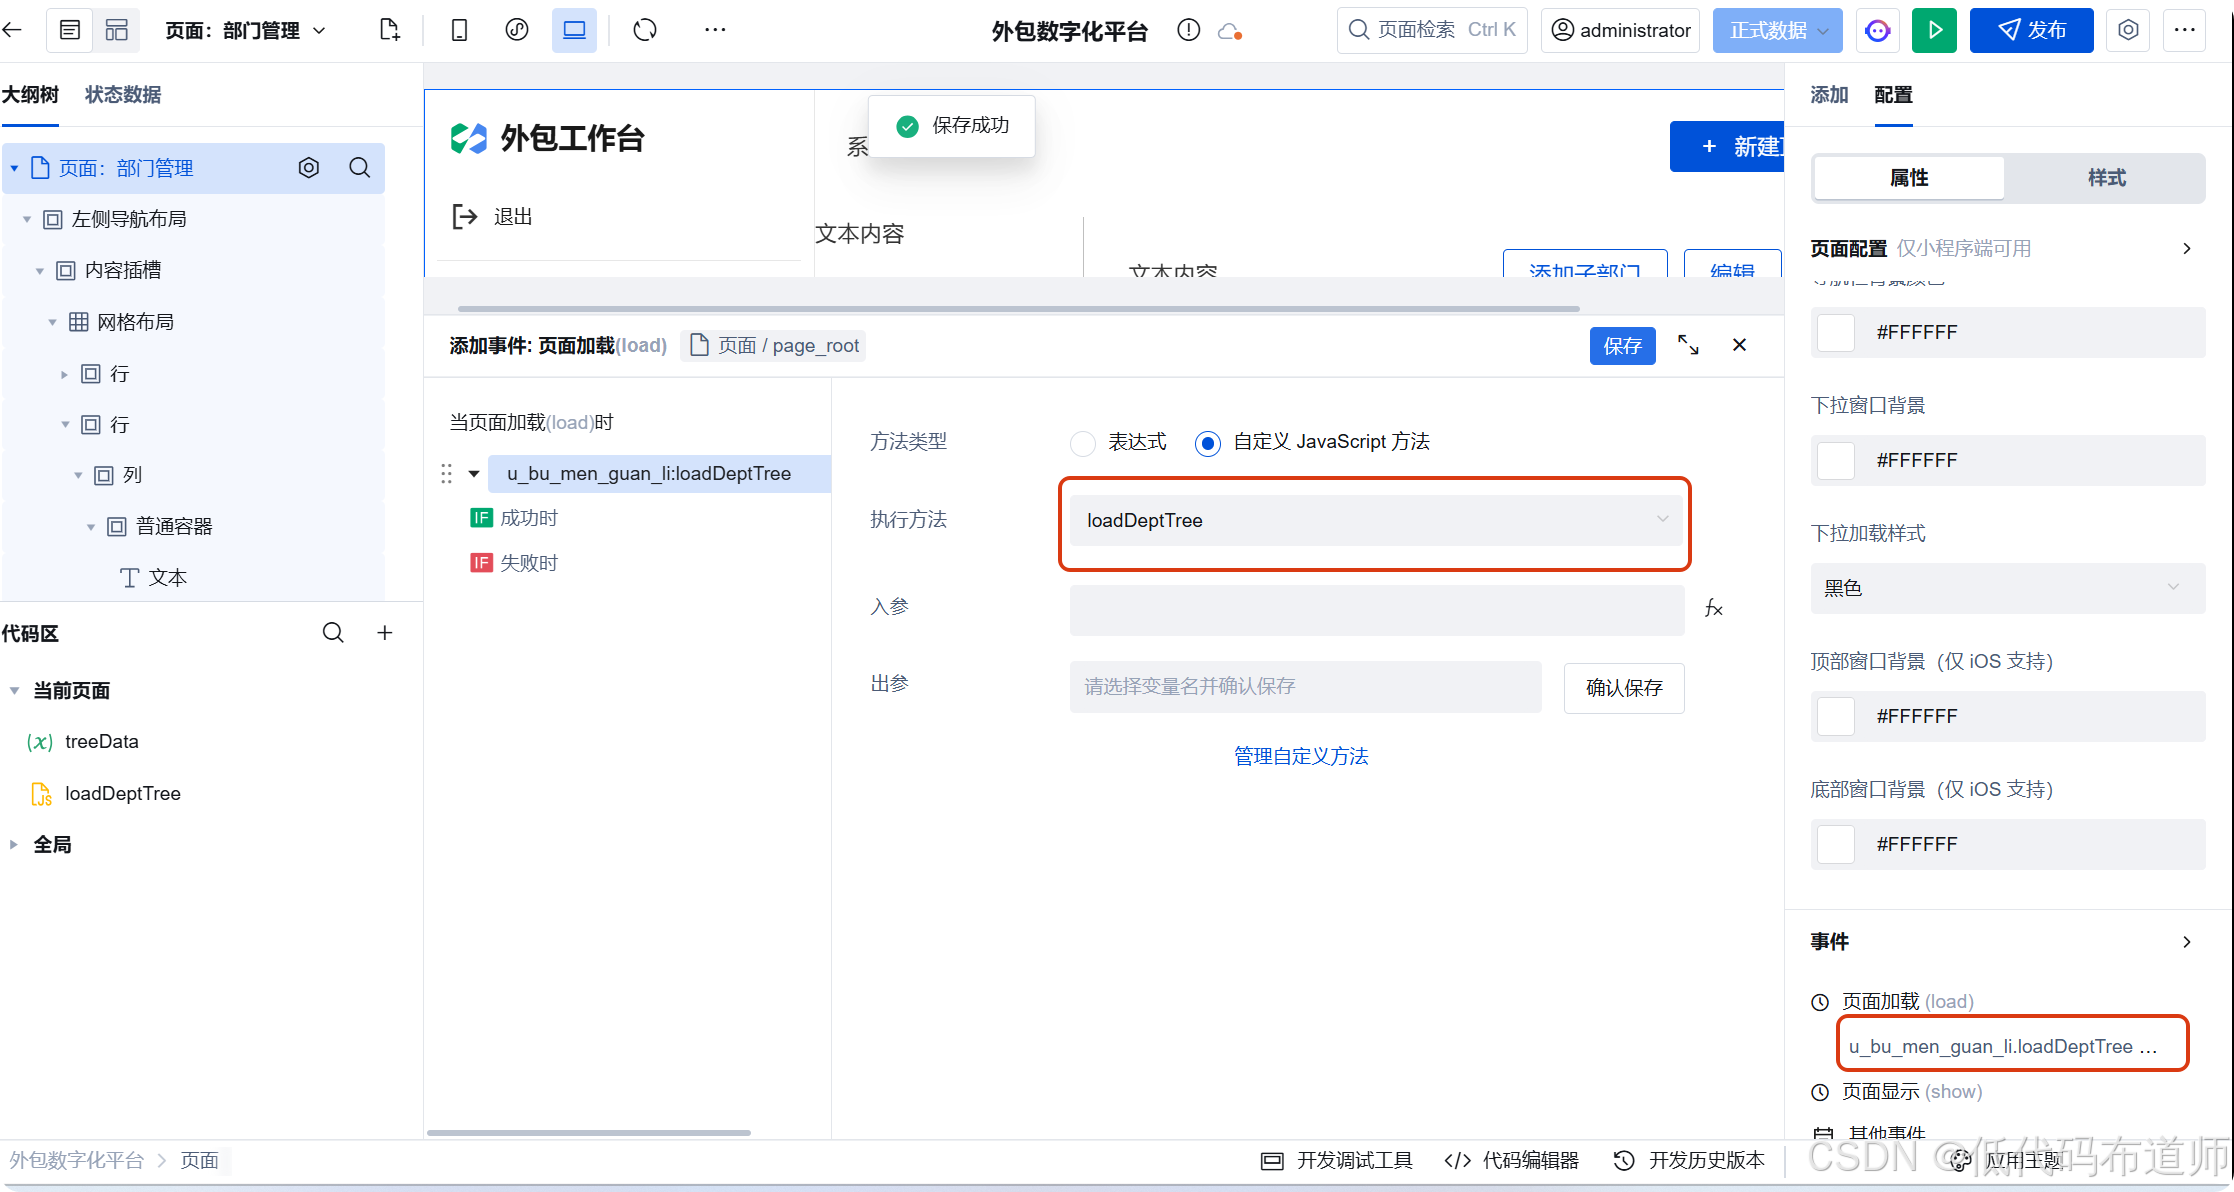
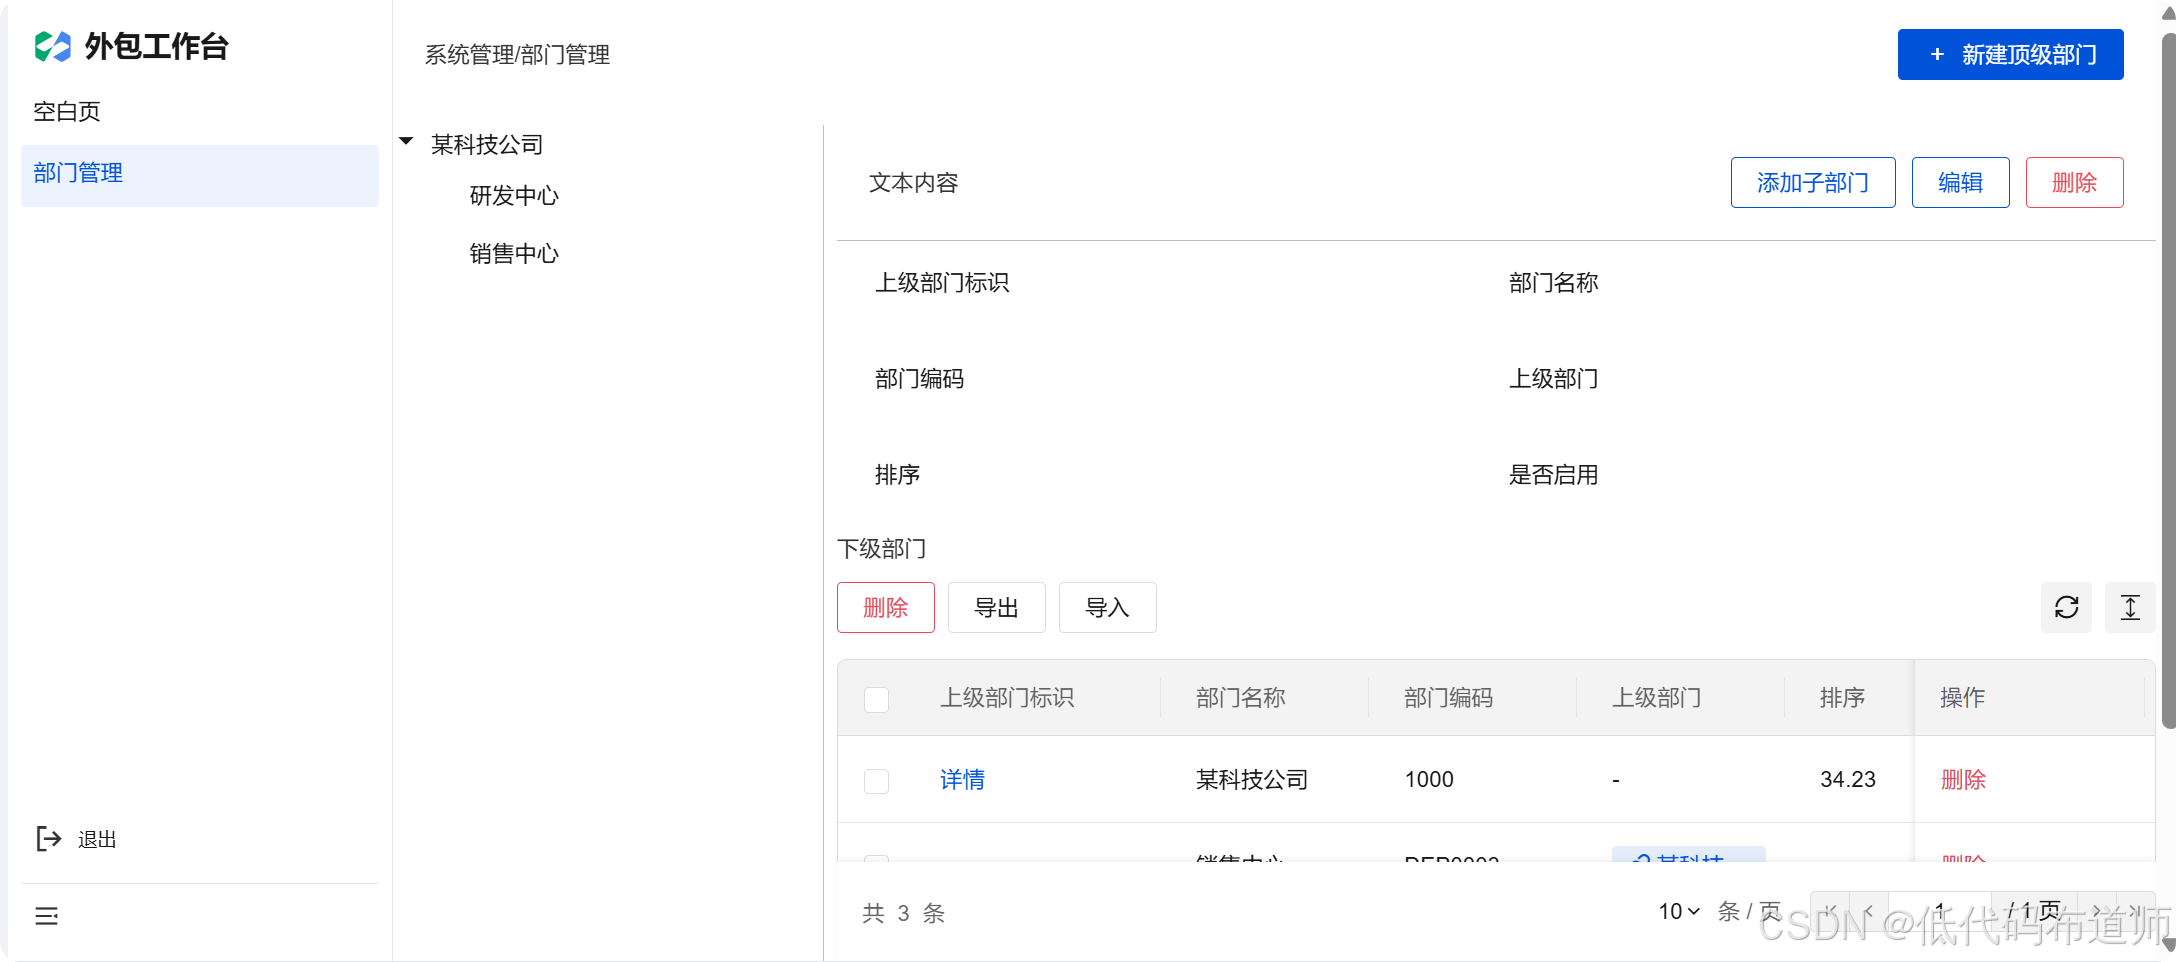
保存,点右上角「预览」。如果数据模型里已经录了总部、销售部、交付中心这些部门,树上就会按层级显示出来。
常见问题排查
| 现象 | 原因与处理 |
|---|---|
| 树一片空白,也不报错 | 90% 是字段名不对:节点 key 必须是小写的 label/value/children,不能直接用行里的 name/_id |
| 只显示根节点,下级没展开 | 展开方式停留在默认值,改成「展开所有节点」 |
| 所有部门都平铺在最外层 | parent_id 没取到值。关联字段要用 row.parent_id._id,并在 select 里显式带上该字段 |
| 部门总是少几个 | pageSize 没写,默认只返回 10 条;显式设为 200 |
| 明明有数据却显示空树 | 检查数据源标识是不是 ct_dept;检查筛选条件是不是把部门过滤光了 |
| 停用的部门也冒出来了 | 确认 where 里带了 status: { $eq: '1' } |
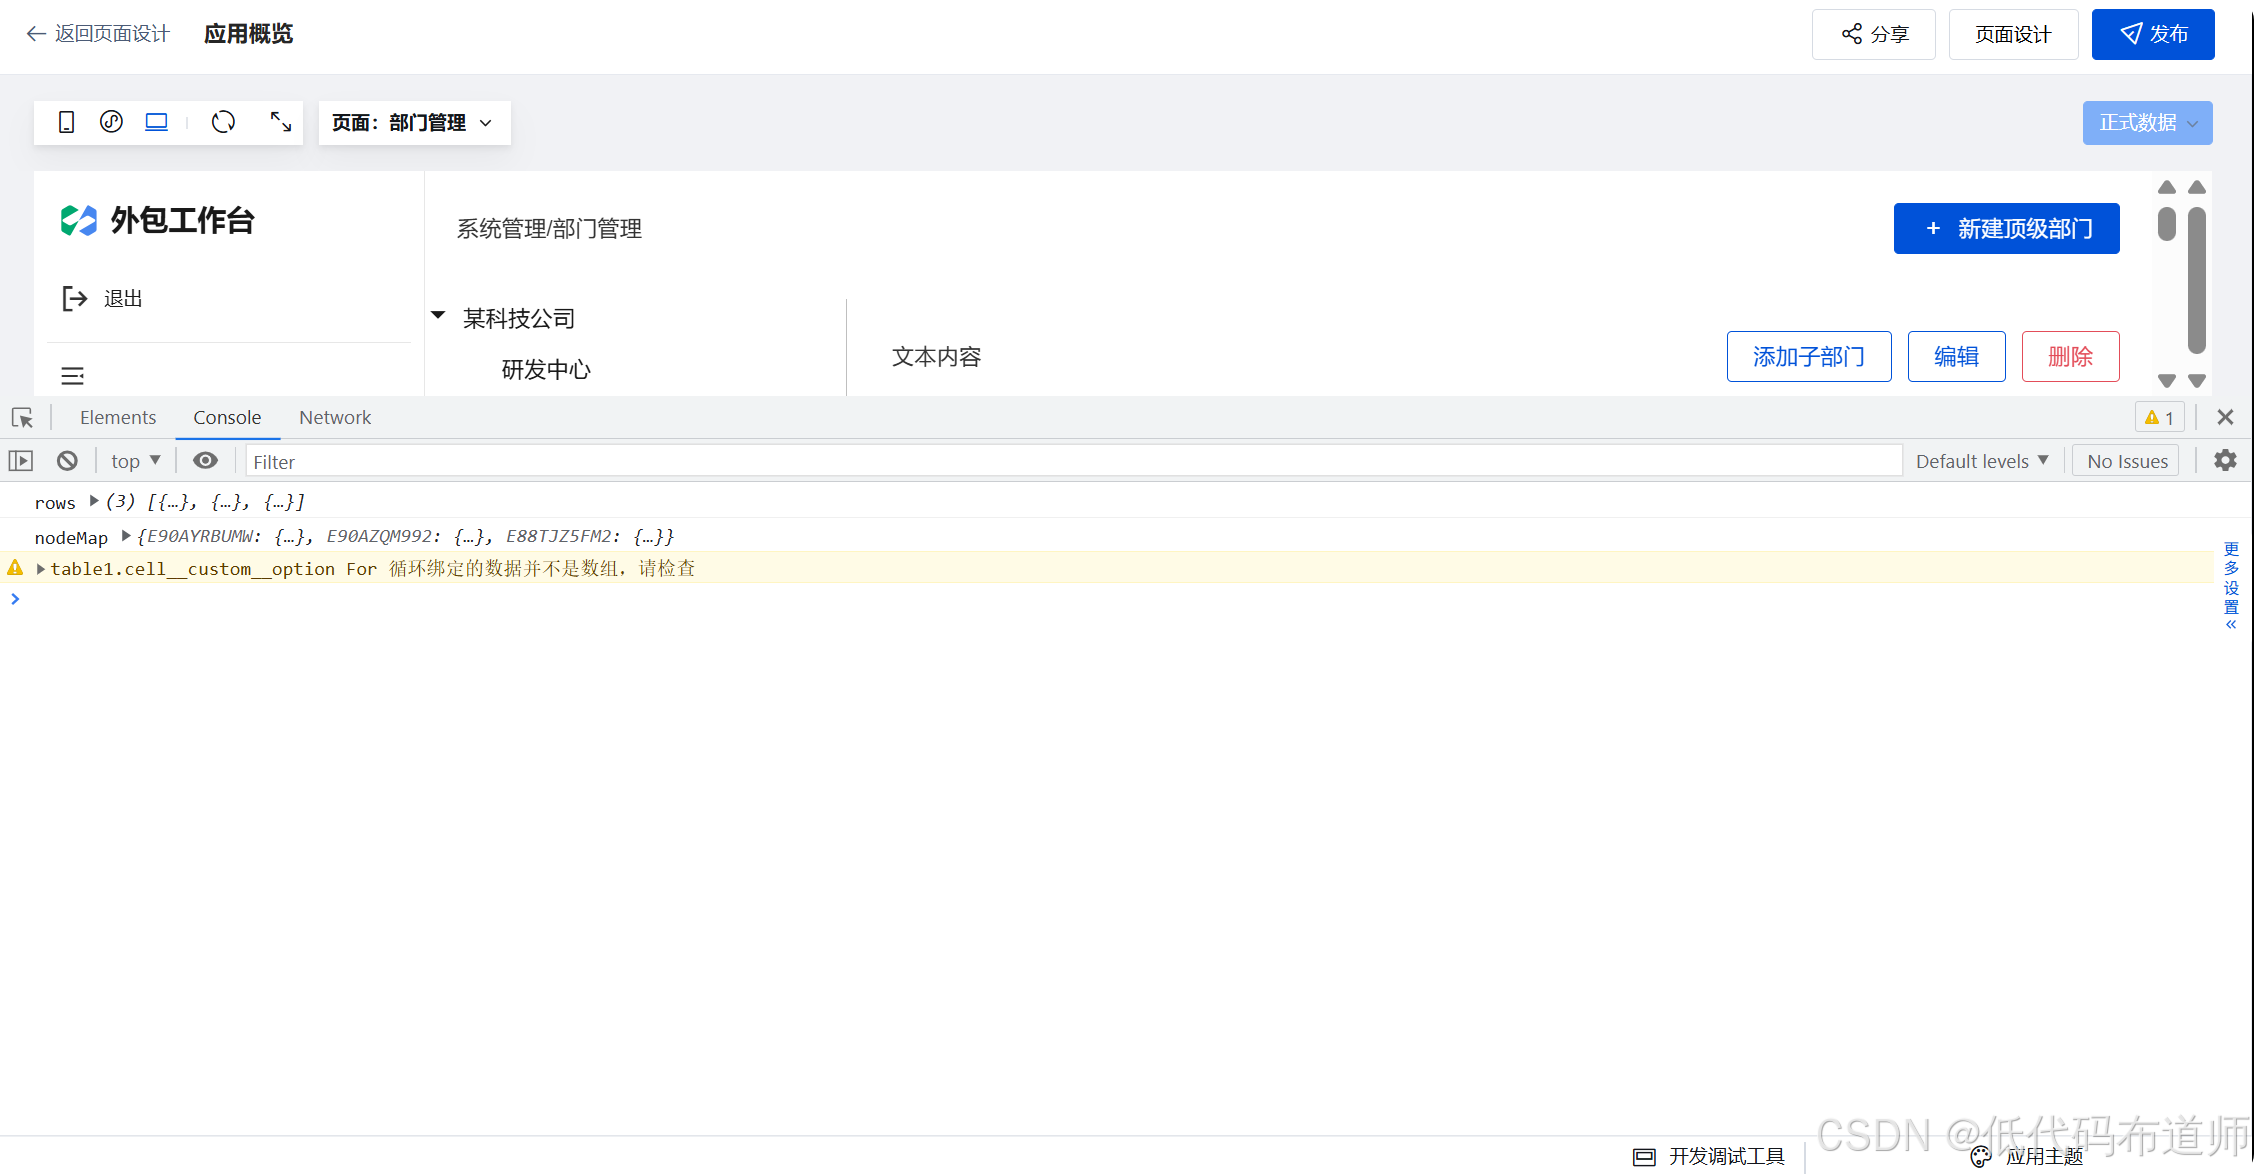
一个调试小技巧:在方法里临时加一句 console.log(rows, tree),预览时打开浏览器控制台,可以分别看到「查回来的行」和「拼好的树」,两层数据一对比,问题立刻定位。
本节成果
今天我们做完了什么?
| 维度 | 成果 |
|---|---|
| 数据链路 | 打通了「ct_dept 表 → 自定义方法 → 页面变量 → 树组件」 |
| 核心能力 | 掌握了扁平行转嵌套树的 Map 两遍法(以后所有树都复用) |
| 组件 | 学会了 WdTree 的 data / label / value / children / expandType |
| 工程习惯 | 数据源查询显式写 pageSize、try/catch + toast、页面加载事件 |
至此,部门管理页的左半边(组织树)已经是真实数据了。
下一篇预告
树虽然能显示了,但现在点树上的部门,右边毫无反应------还是死的。
下一篇,我们给树挂上「选中节点改变 」事件(selectNodeChange):
- 点击某个部门,从
treeInfo.checked拿到部门_id; - 右侧表单容器显示这个部门的名称、编码、负责人;
- 下方子部门表格也跟着只显示它的下级。
让左右两侧真正联动起来。