开篇|一个项目,为什么越来越难只靠一个模型?
真正把 AI 用进项目里之后,我越来越不相信"一个模型从头干到底"这件事。
原因其实很简单:不同模型,真的有不同的长处。
有的擅长复杂逻辑和需求拆解,面对一团模糊的想法,能很快把问题理顺;有的更适合 Coding,写代码、改 Bug、理解项目结构更顺手;还有的在长文本理解、内容整理和表达上明显更稳定。单独看,每一项都不稀奇,但一个完整项目恰恰会同时遇到这些事情。
项目刚开始时,需要把需求想清楚;真正动手之后,要设计架构、写代码、调接口;做到后面,又要处理内容、检查结果、修 Bug、补细节。任务一直在变,对模型能力的要求自然也在变。
这时候,如果硬让同一个模型包办全部工作,就有点像让一个人同时负责产品、开发、测试和内容。不是说做不了,而是很难保证每一件事都做在它最擅长的位置上。
所以现在我更关心的,已经不是: "到底哪个模型最强?" 而是: "这个阶段,到底该用谁?"
问题也正出在这里。
当 DeepSeek、GLM、Kimi、MiniMax 这些模型开始真正进入日常工作流之后,选择变多了,订阅、额度、Key 和工具配置也跟着变多。模型本来是来提高效率的,如果最后却要花大量时间管理模型,多少有点本末倒置。
真正理想的状态,应该不是押注一个万能模型,而是需要什么能力,就调用什么能力。
一、别急着找"最强模型":我先把它们装进同一个模型池
过去我选模型时,习惯先问一句:"现在到底哪个模型最强?"
但真正用得多了之后,这个问题反而越来越没有意义。开发、长文本、逻辑分析、内容处理,本来就是不同类型的任务,与其押注某一个模型,不如先解决另一个更实际的问题:能不能把常用模型集中到一起,需要谁的时候直接切谁?
这也是我开始关注 AiiOnly Token Plan 的原因。
链接直达: maas.aiionly.com/login?invit...
简单来说,Token Plan 是一套面向多模型使用场景的订阅方案。订阅一份套餐后,可以在额度范围内使用多款主流模型,不需要围绕每一家模型分别维护一套订阅体系。
目前 Token Plan 的模型池覆盖了 DeepSeek、GLM、Kimi、MiniMax 几个主流系列,包括 DeepSeek-V4-Pro、DeepSeek-V4-Flash、GLM-5.3、Kimi-K3、Kimi-K2.7-Code、MiniMax-M3 等模型。
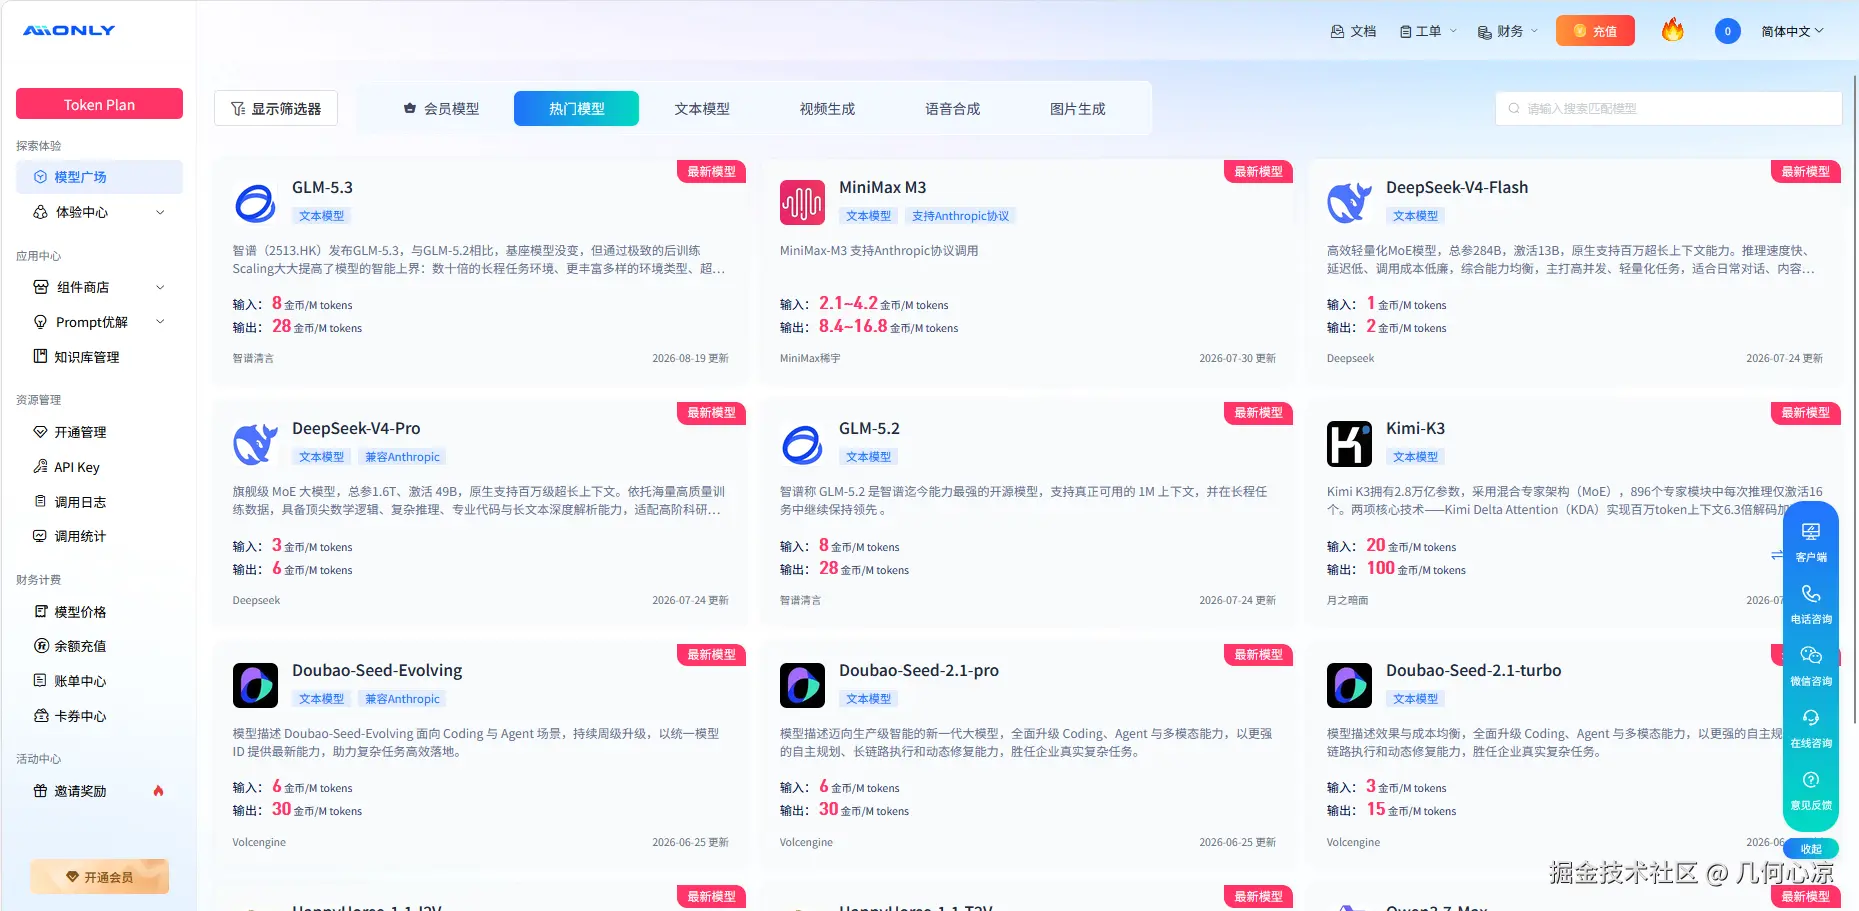
这套模式对我最大的吸引力,并不只是"模型数量多",而是它改变了模型选择的逻辑。
以前如果想同时使用几家模型,往往意味着多个账号、多份额度,甚至不同的接口和配置;而在 Token Plan 里,模型被放进了同一个可调用的资源池。项目做到 Coding 阶段,可以换适合代码任务的模型;进入长文本分析或内容处理,又可以直接选择另一款模型。
不是先选定一个模型,再逼着它完成所有任务,而是先看任务需要什么能力,再决定调用谁。
套餐本身也按照使用强度分成了 Lite、Standard、Pro、Max 四档,目前分别为 29 元、79 元、249 元和 499 元/月。从轻量体验到高频使用都有对应档位,额度则统一以 Credits 管理。
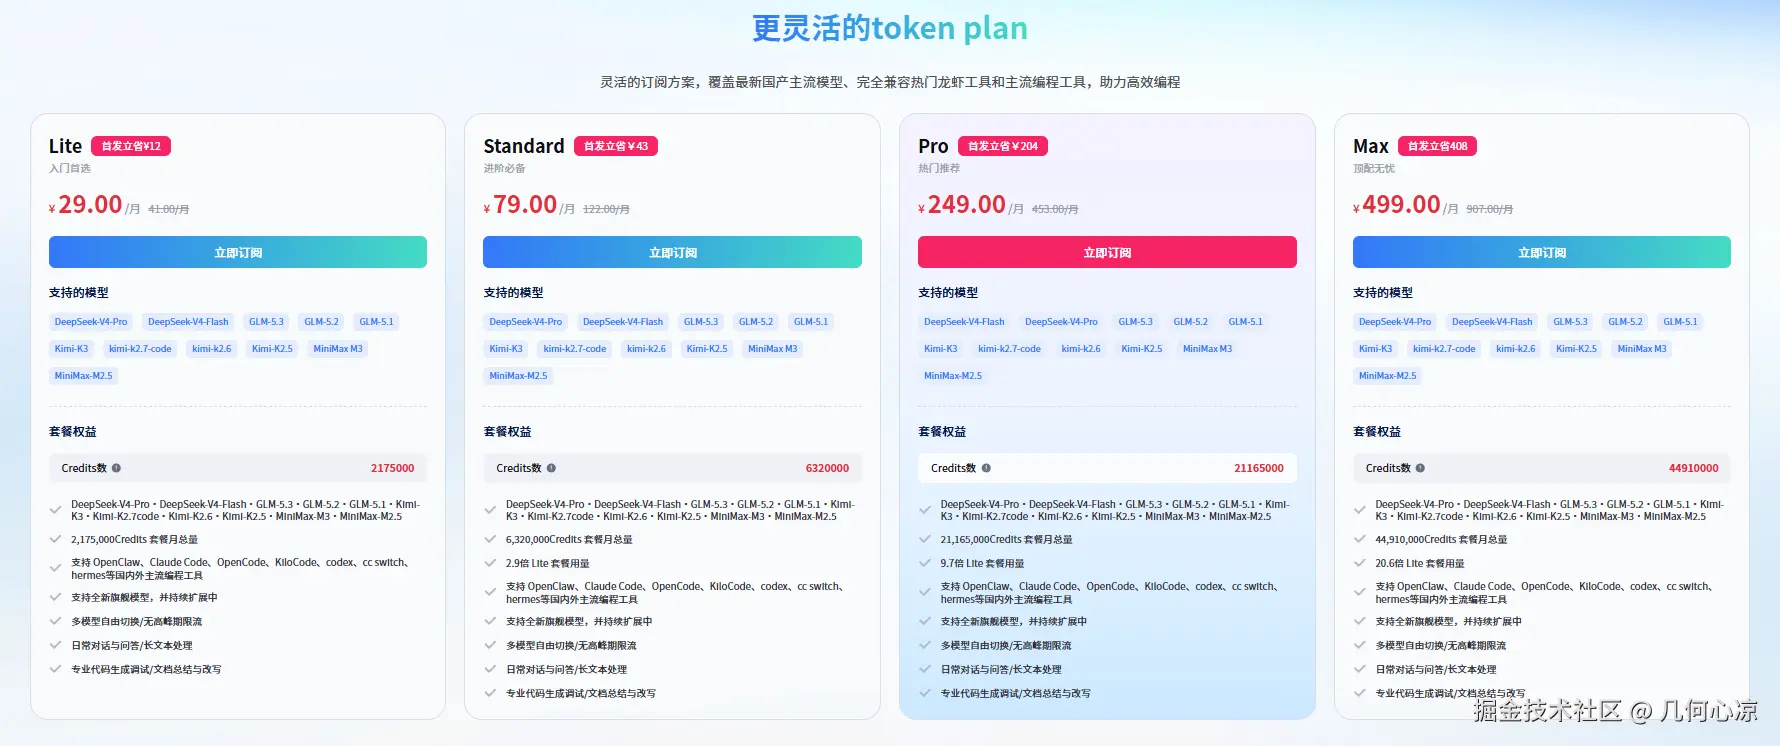
二、从 Token Plan 到 WorkBuddy:让模型真正进入工作流
模型集中到一起之后,下一步才是我更关心的事情:怎么把这些模型真正带进平时干活的工具里。
毕竟对于开发者来说,控制台里能看到多少模型只是基础。真正影响体验的,是写代码、处理文档或者跑一个完整项目时,能不能直接调用,而不是每换一个模型,就重新折腾一遍账号、额度和配置。
Token Plan 的使用链路在这里比较清晰。
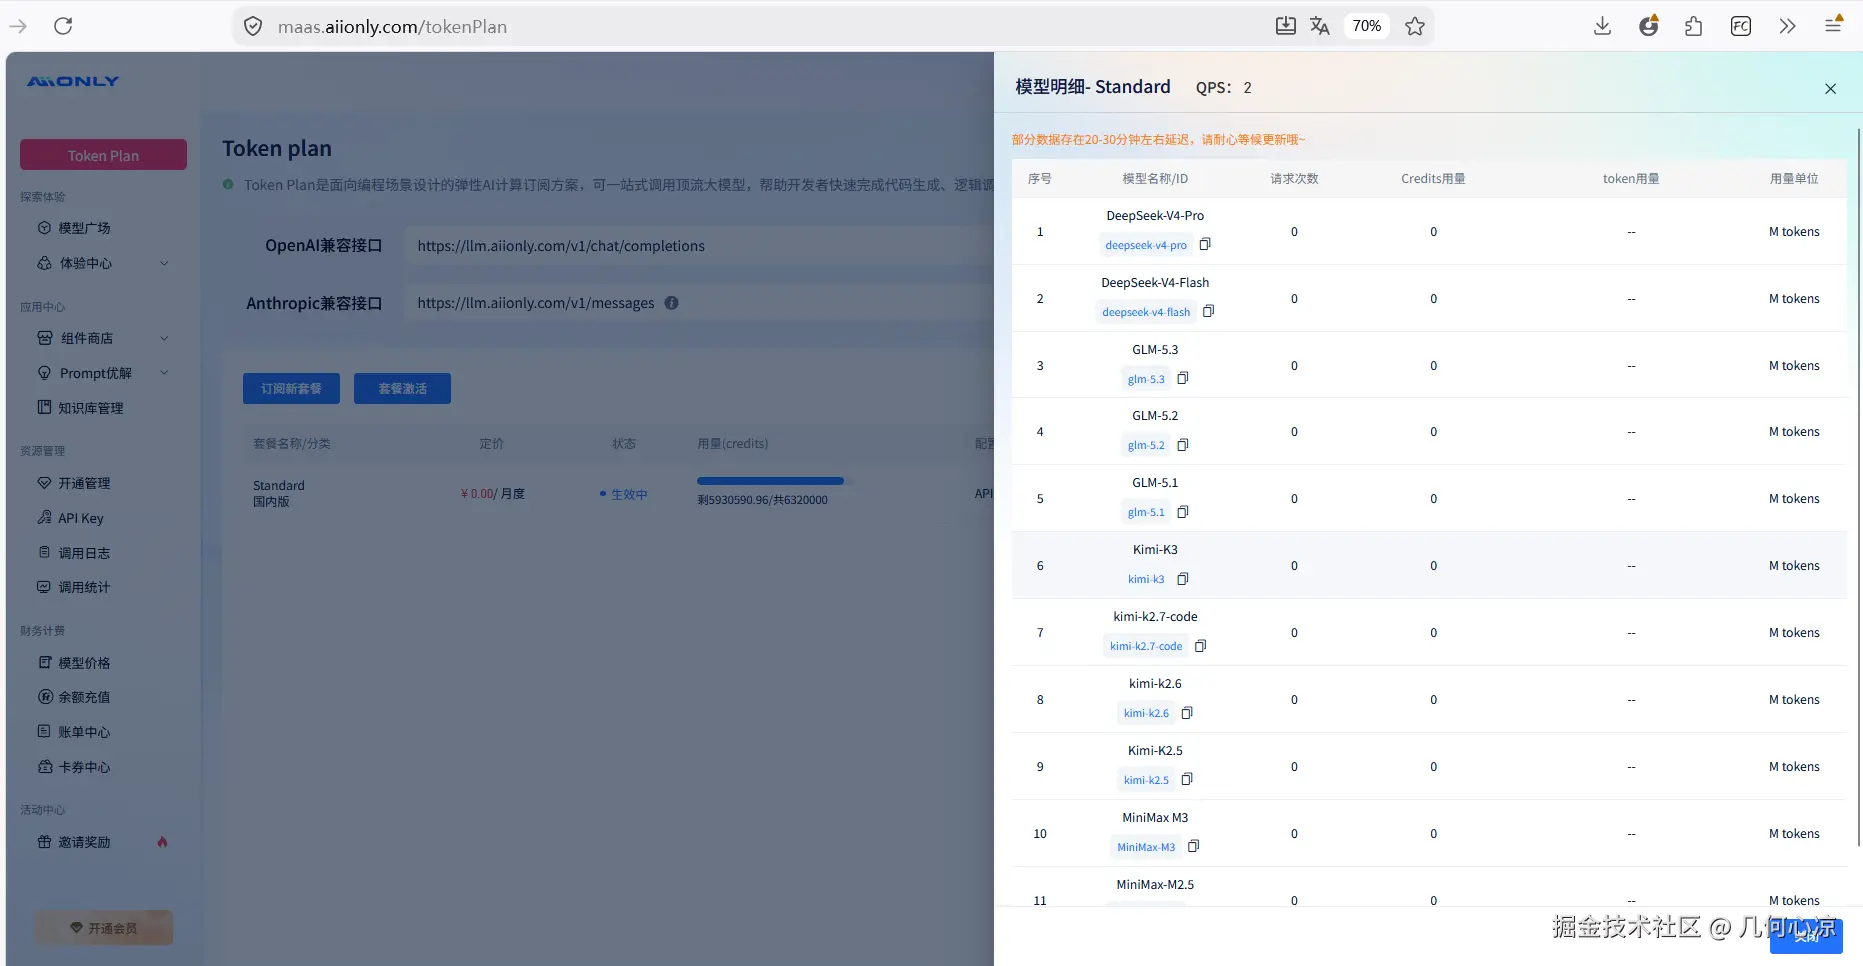
订阅完成后,进入 Token Plan 管理页面,可以继续查看套餐额度、模型使用情况以及对应的 API Key。Token Plan 的 Key 独立管理,同时还能查看不同模型各自的消耗情况,哪款模型用了多少额度,一眼就能看到。
接下来进入 API Key 管理,创建这次工作流要使用的 Key。
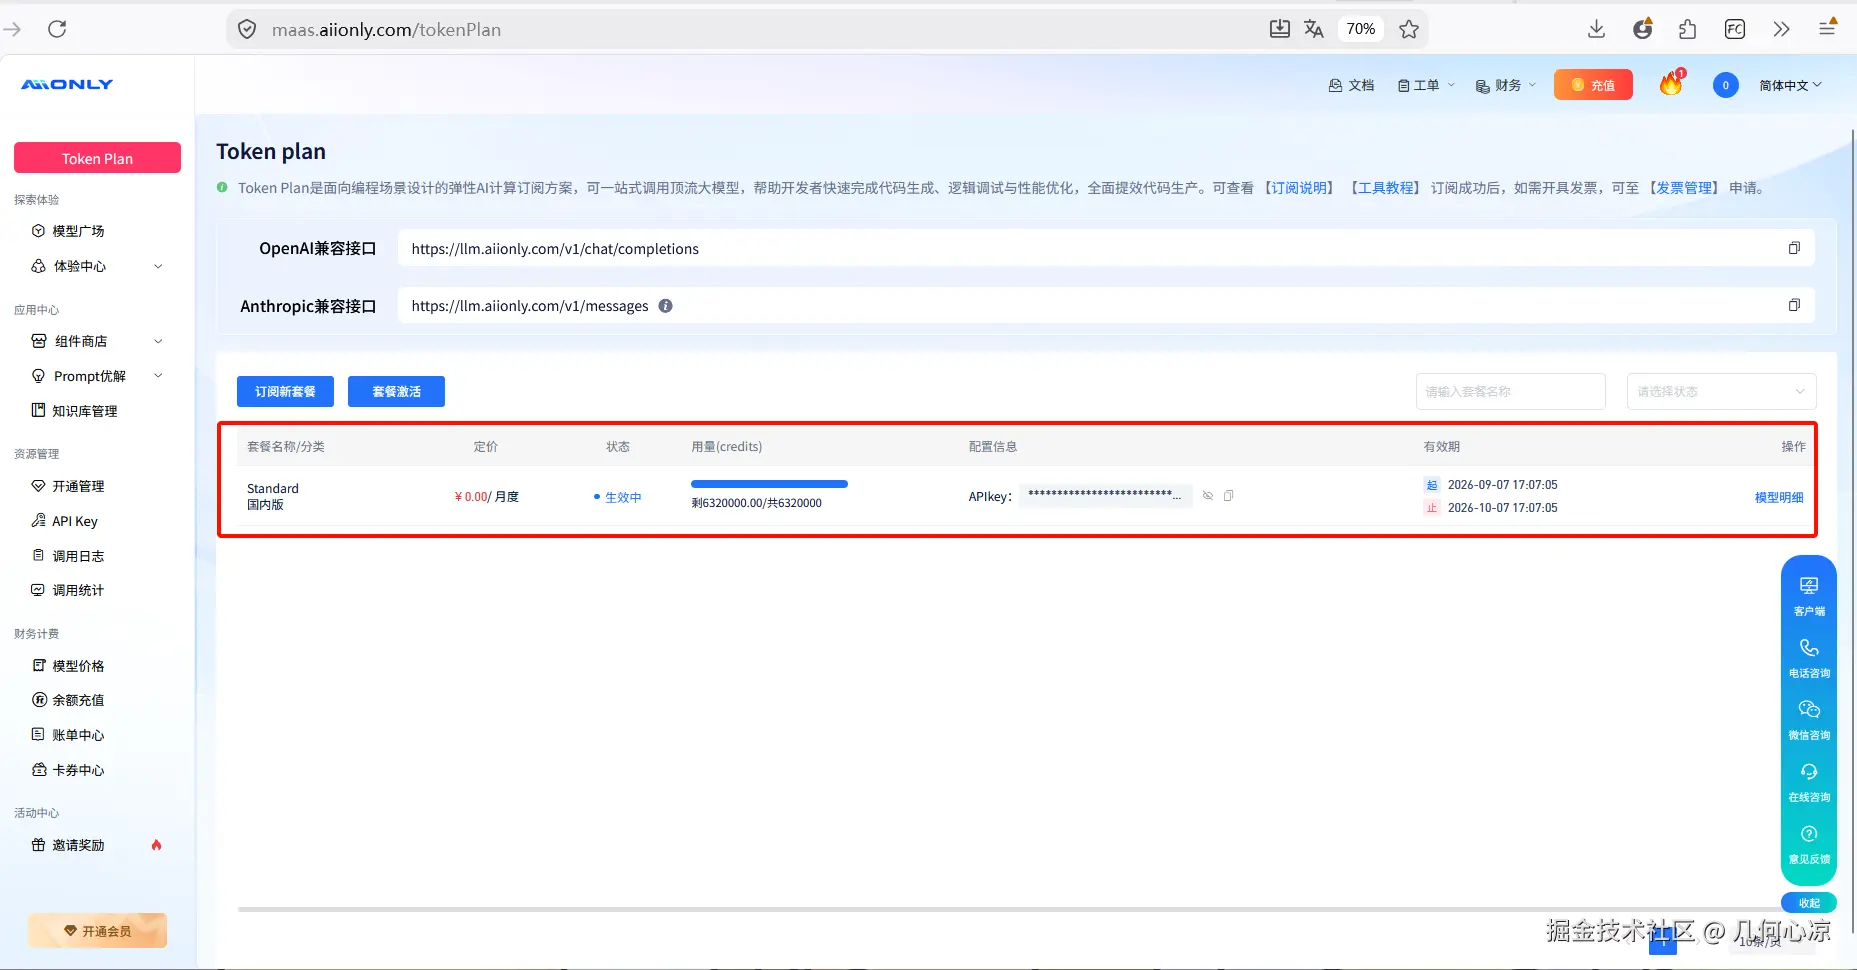
这一步看起来很简单,但也是我觉得 Token Plan 比较舒服的地方:前面订阅的是一整个模型池,到了真正接入工具时,也不用再围绕每一款模型重新准备一套账号体系。
拿到 Key 后,我把它接进这次准备用的 WorkBuddy。这次我走的是比较直接的 API 接入方式,在 WorkBuddy 的模型配置页面中填入 AiiOnly 对应的接口信息和 Token Plan Key,再把后面项目里需要使用的模型添加进去。
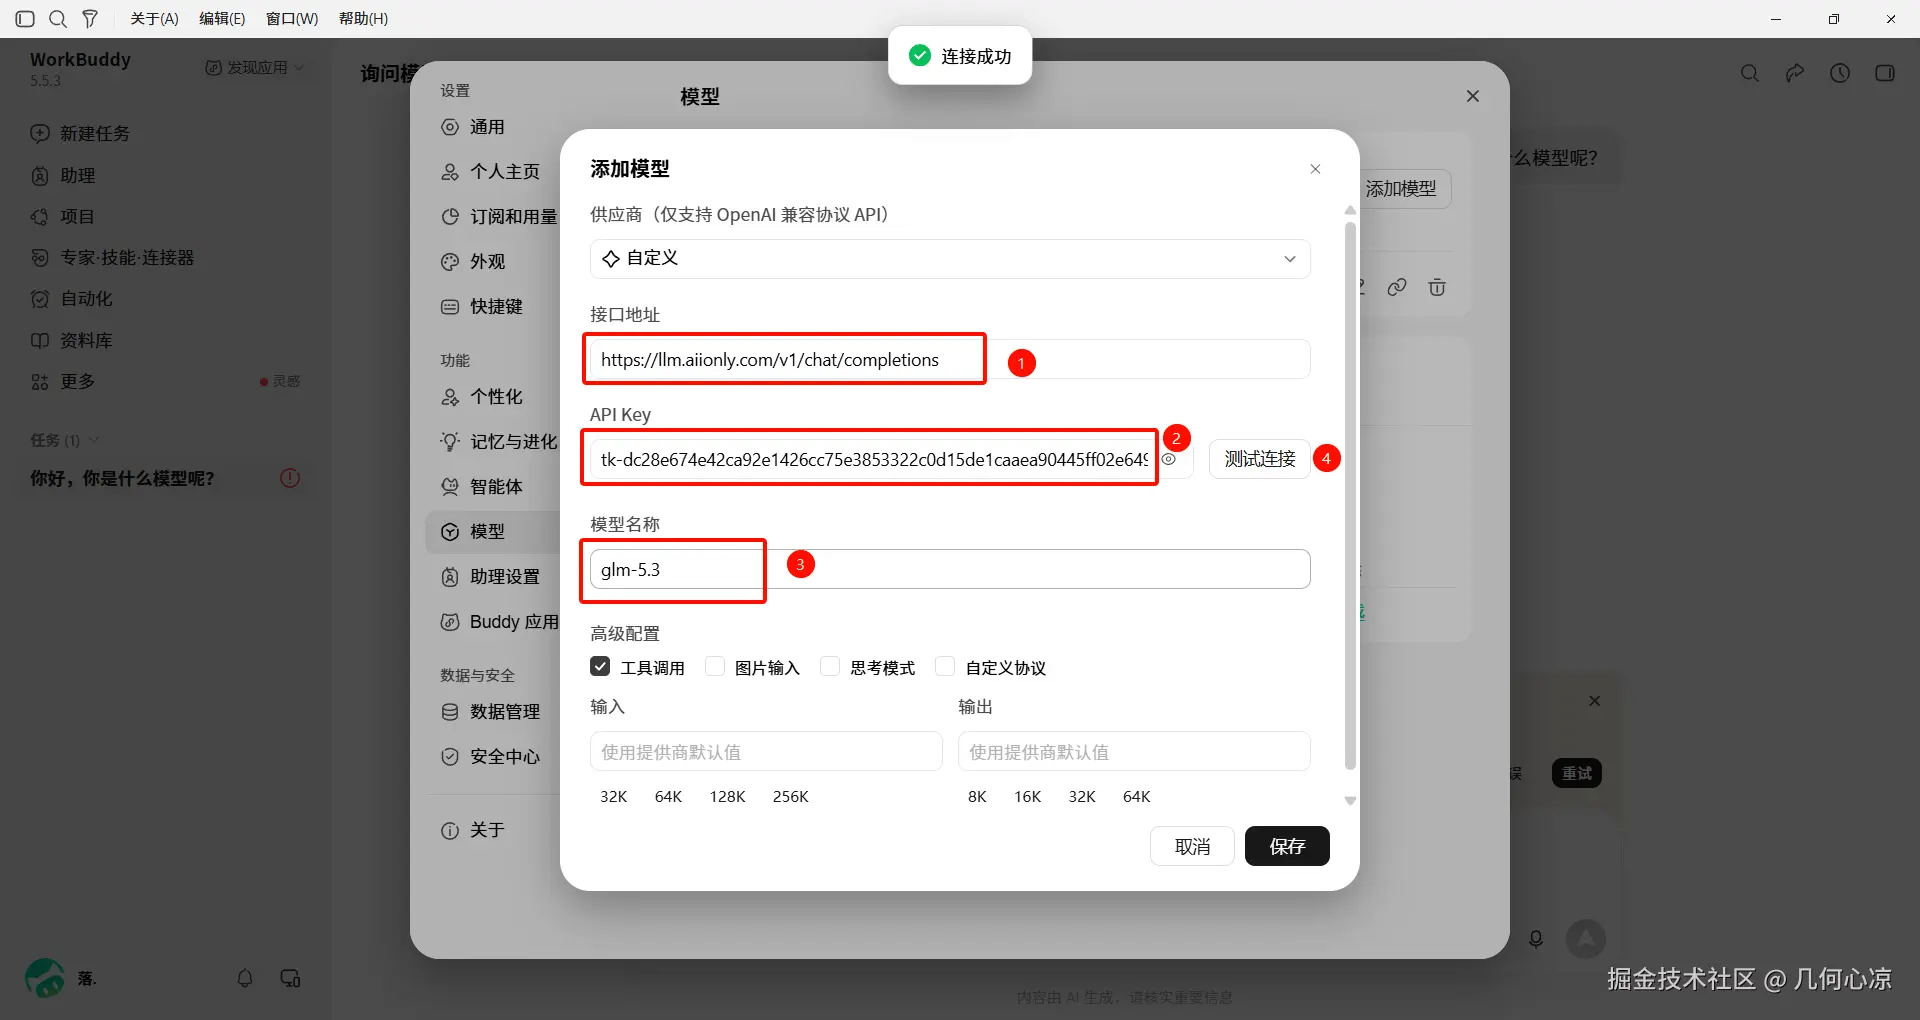
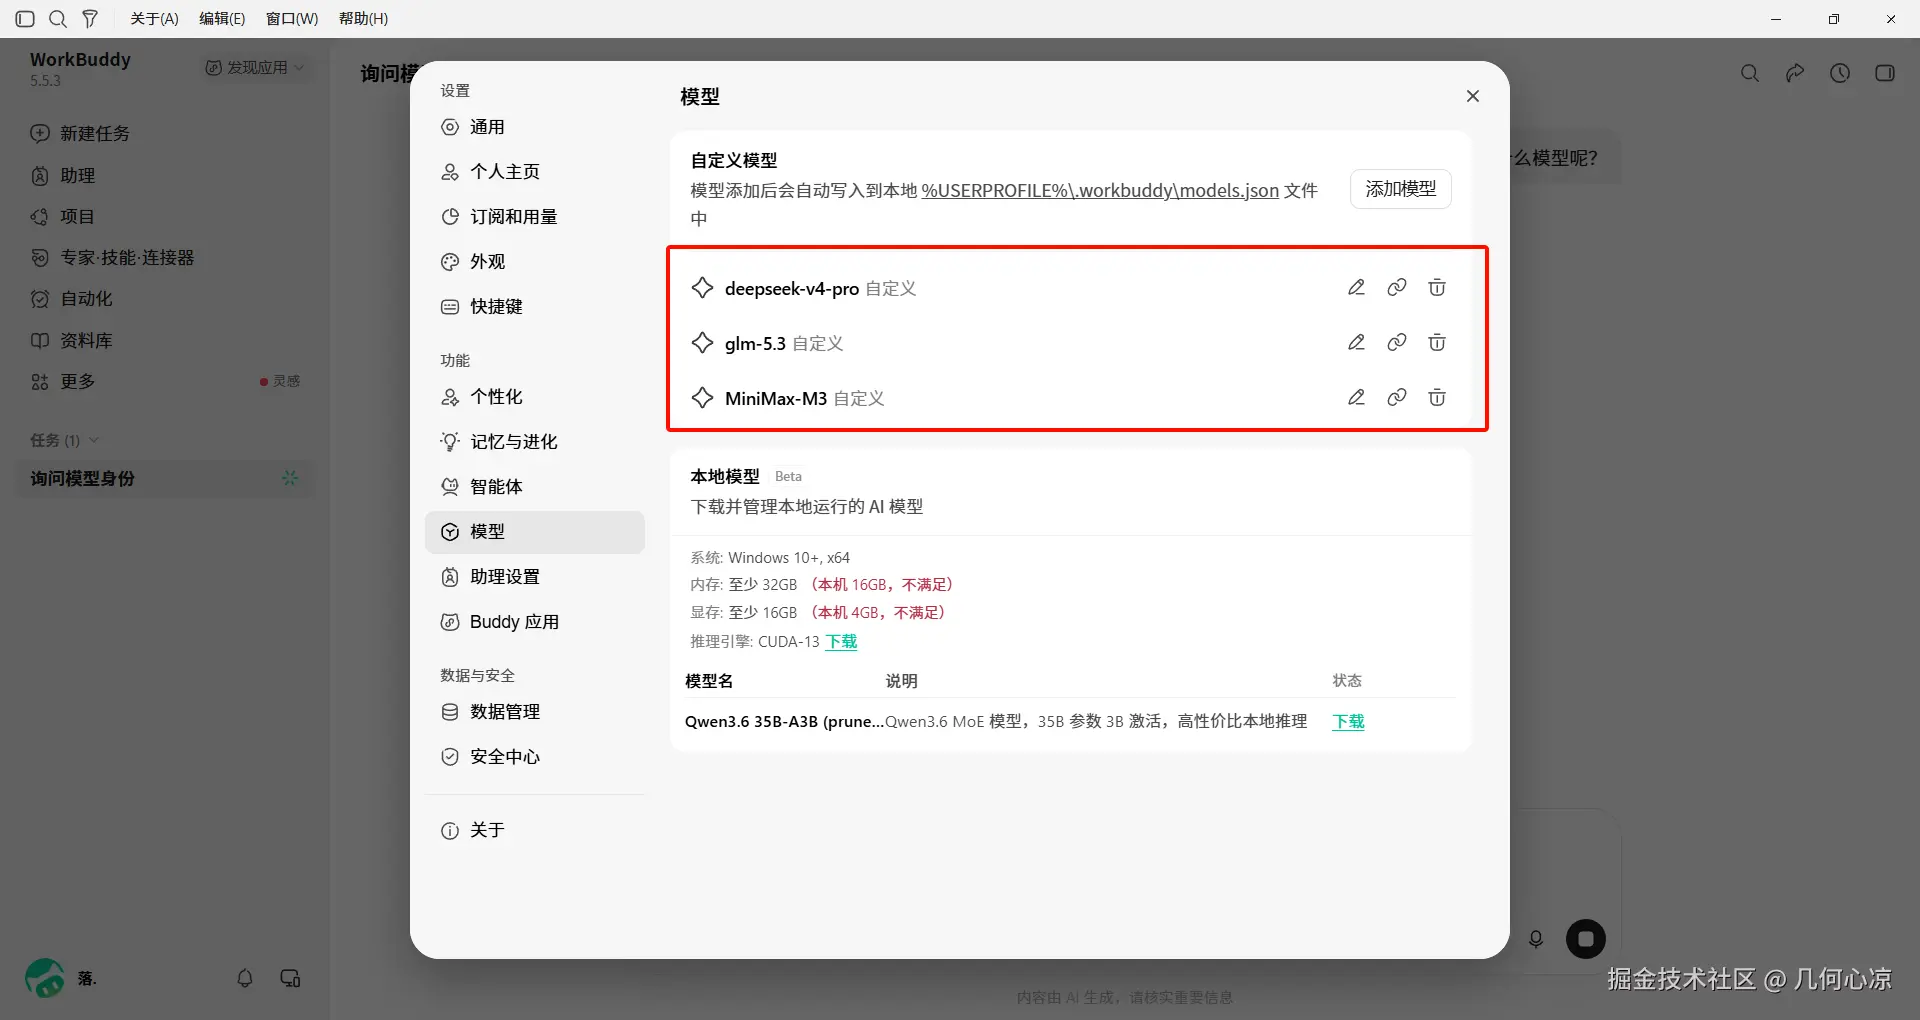
配置完成后,原本分散在不同厂商下面的模型,开始真正出现在同一个工作环境里。
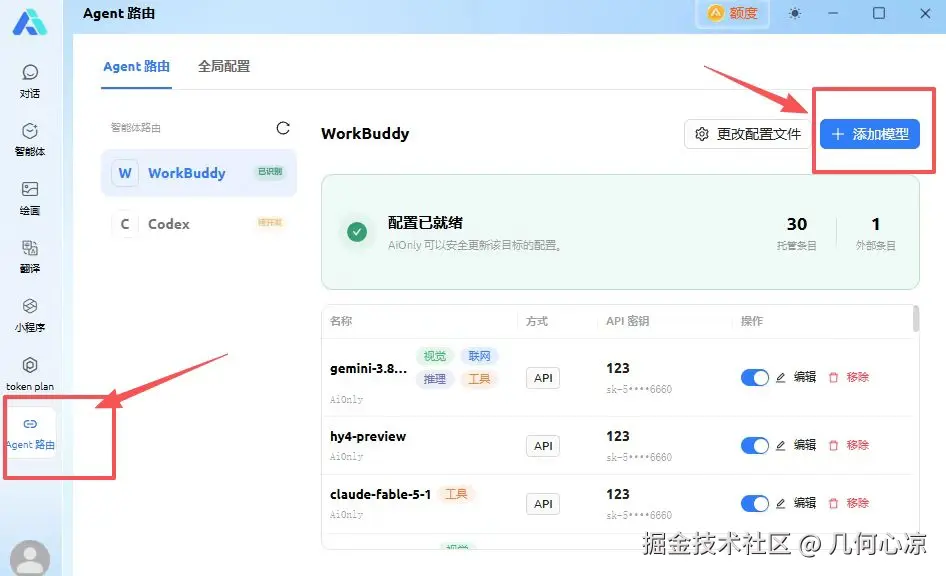
除了前面的 API 接入方式,AiiOnly 和 WorkBuddy 现在还打通了模型路由。在 AiiOnly 客户端进入 Agent 路由 → WorkBuddy ,可以直接选择需要使用的模型并完成配置,不必再到 WorkBuddy 里逐个填写接口和 Key。对于本身就会同时用多款模型的人来说,这种方式显然要省事不少。 AiiOnly 下载地址:aionly.com/download
接着我又选了一款模型跑了一次简单对话,确认请求和返回都正常。
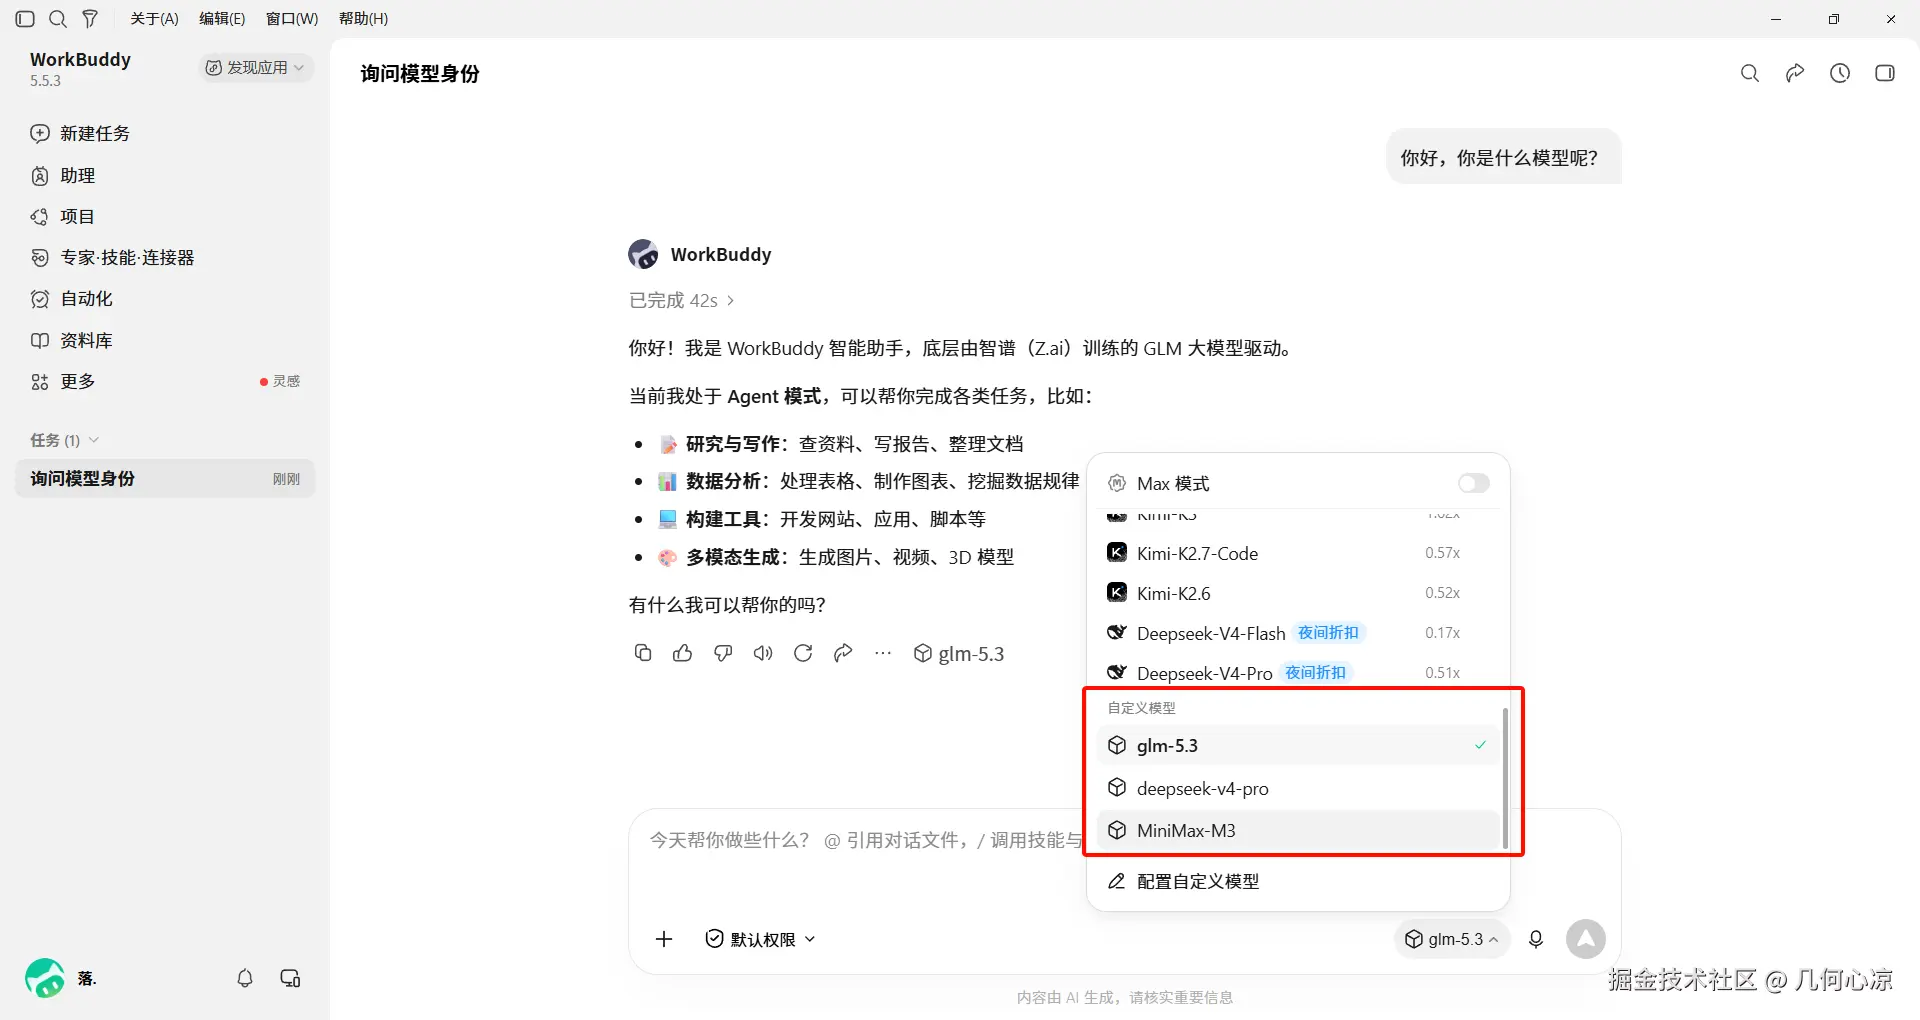
到这里,整条链路其实就很直观了:
Token Plan 订阅 → 获取 API Key → 接入 WorkBuddy → 选择模型 → 正常调用。
而这也是 Token Plan 真正开始体现价值的地方。
以前想同时用几款模型,往往意味着分别管理不同平台;现在,一份订阅背后直接对应一个可以继续接进工作流的模型池。模型可以根据任务去选,工作环境却不需要跟着反复切换。
既然模型已经进来了,下一步自然不能只停留在"问一句、答一句"。
这一次,我准备直接拿一个完整的 **「AI 简历优化助手」**来试试看:产品设计、代码开发、简历分析本身需要的能力就不一样,与其找一个模型全部包办,不如真正把几款模型各自擅长的地方用起来。
三、各取所长:我用多款模型做出「AI 简历优化助手」
三款模型都进了 WorkBuddy 之后,我没有急着做跑分。
因为真到项目里,"谁最强"往往是个伪命题。需求分析、工程开发、长文本处理,本来就是不同类型的问题。与其要求一款模型从头包办,不如先看项目缺什么能力,再从已有的模型池里挑更合适的那一个。
这次我加入的是 DeepSeek-V4-Pro、GLM-5.3 和 MiniMax-M3。三款模型的能力有重叠,但侧重点并不完全相同:有的更适合复杂任务拆解,有的把 Coding 和长程工程作为重点,还有的兼顾长上下文与多模态输入。
正好,我拿一个「AI 简历优化助手」来试试这种思路。
它听起来不复杂,但真要做成一个能用的产品,至少要解决三件事:先把产品想明白,再把代码写出来,最后还得真正读懂简历和岗位 JD。 三类问题放在一起,恰好给了多模型各取所长的空间。
3.1 第一行代码之前,先把"优化什么"想清楚
最开始,我手里的需求只有一句:
做一个 AI 简历优化助手。
如果直接开写,做出一个"上传简历 → 点击优化 → 输出新文本"的页面并不难。真正麻烦的是:到底按照什么标准优化?
同一份简历投后端开发和产品经理,显然不应该得到同样的修改结果。因此第一步,我先把这个模糊想法交给 DeepSeek-V4-Pro,让它暂时不要碰代码,而是从用户场景、核心功能和输出结果几个方向把需求往下拆。
几轮梳理之后,整个产品的关键逐渐落在了 "简历 + 目标 JD" 上。简历告诉系统"候选人有什么",JD 告诉系统"岗位需要什么",AI 真正要做的,是在两者之间找到差距。
于是原本一句简单的"简历优化",被拆成了一条更完整的链路:
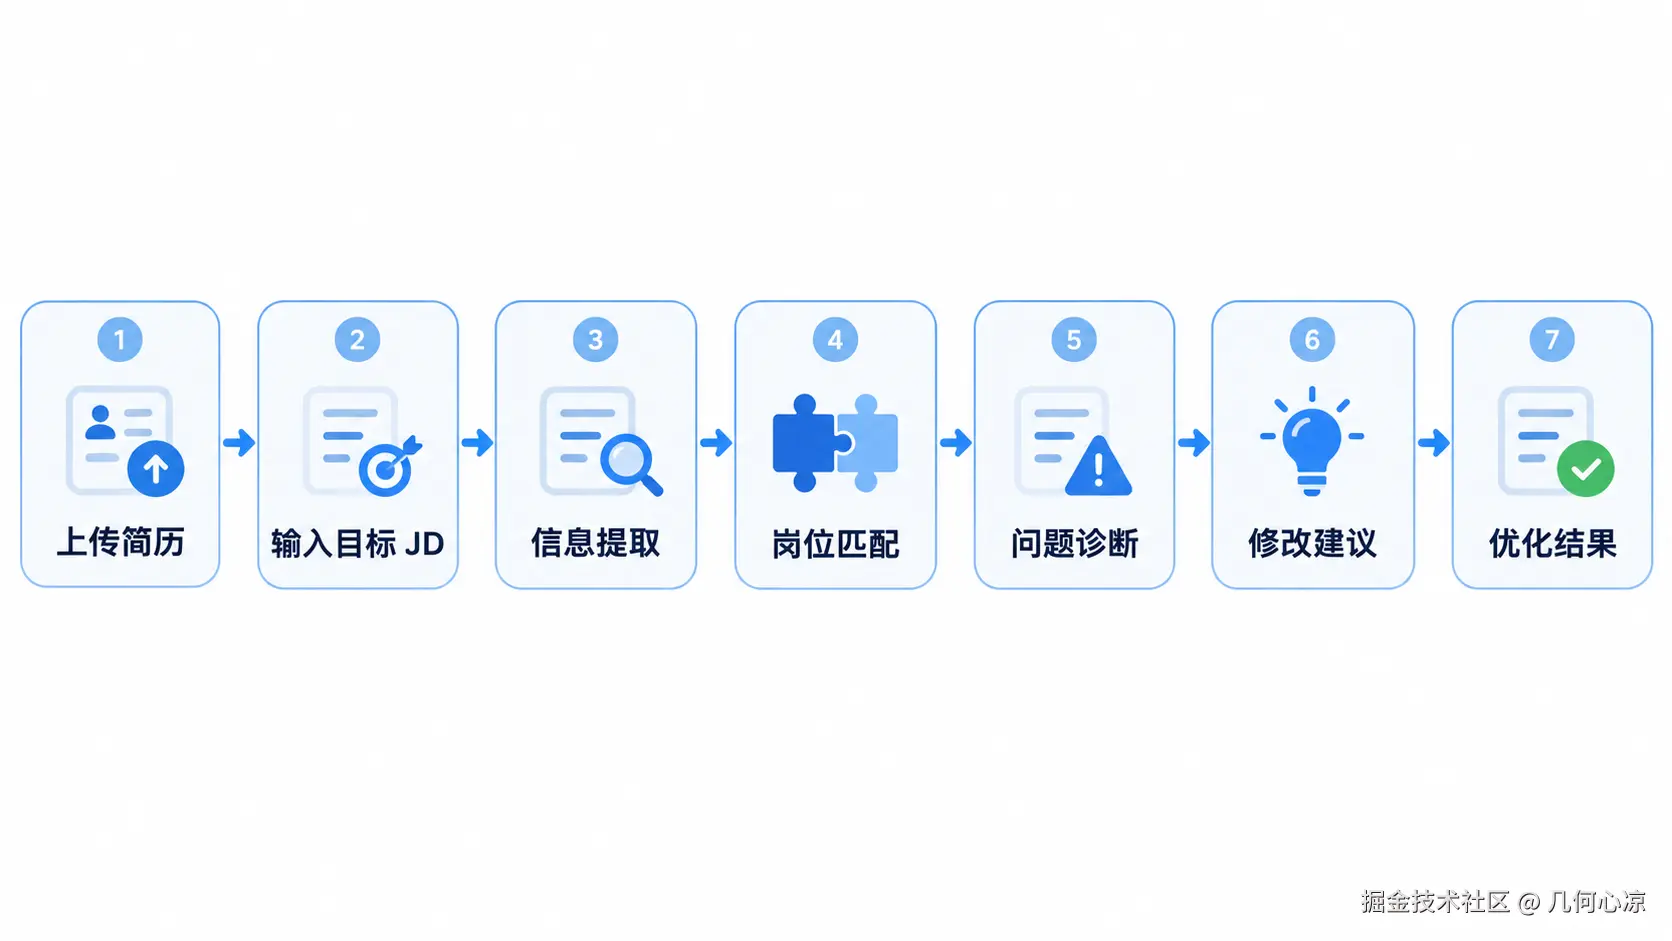
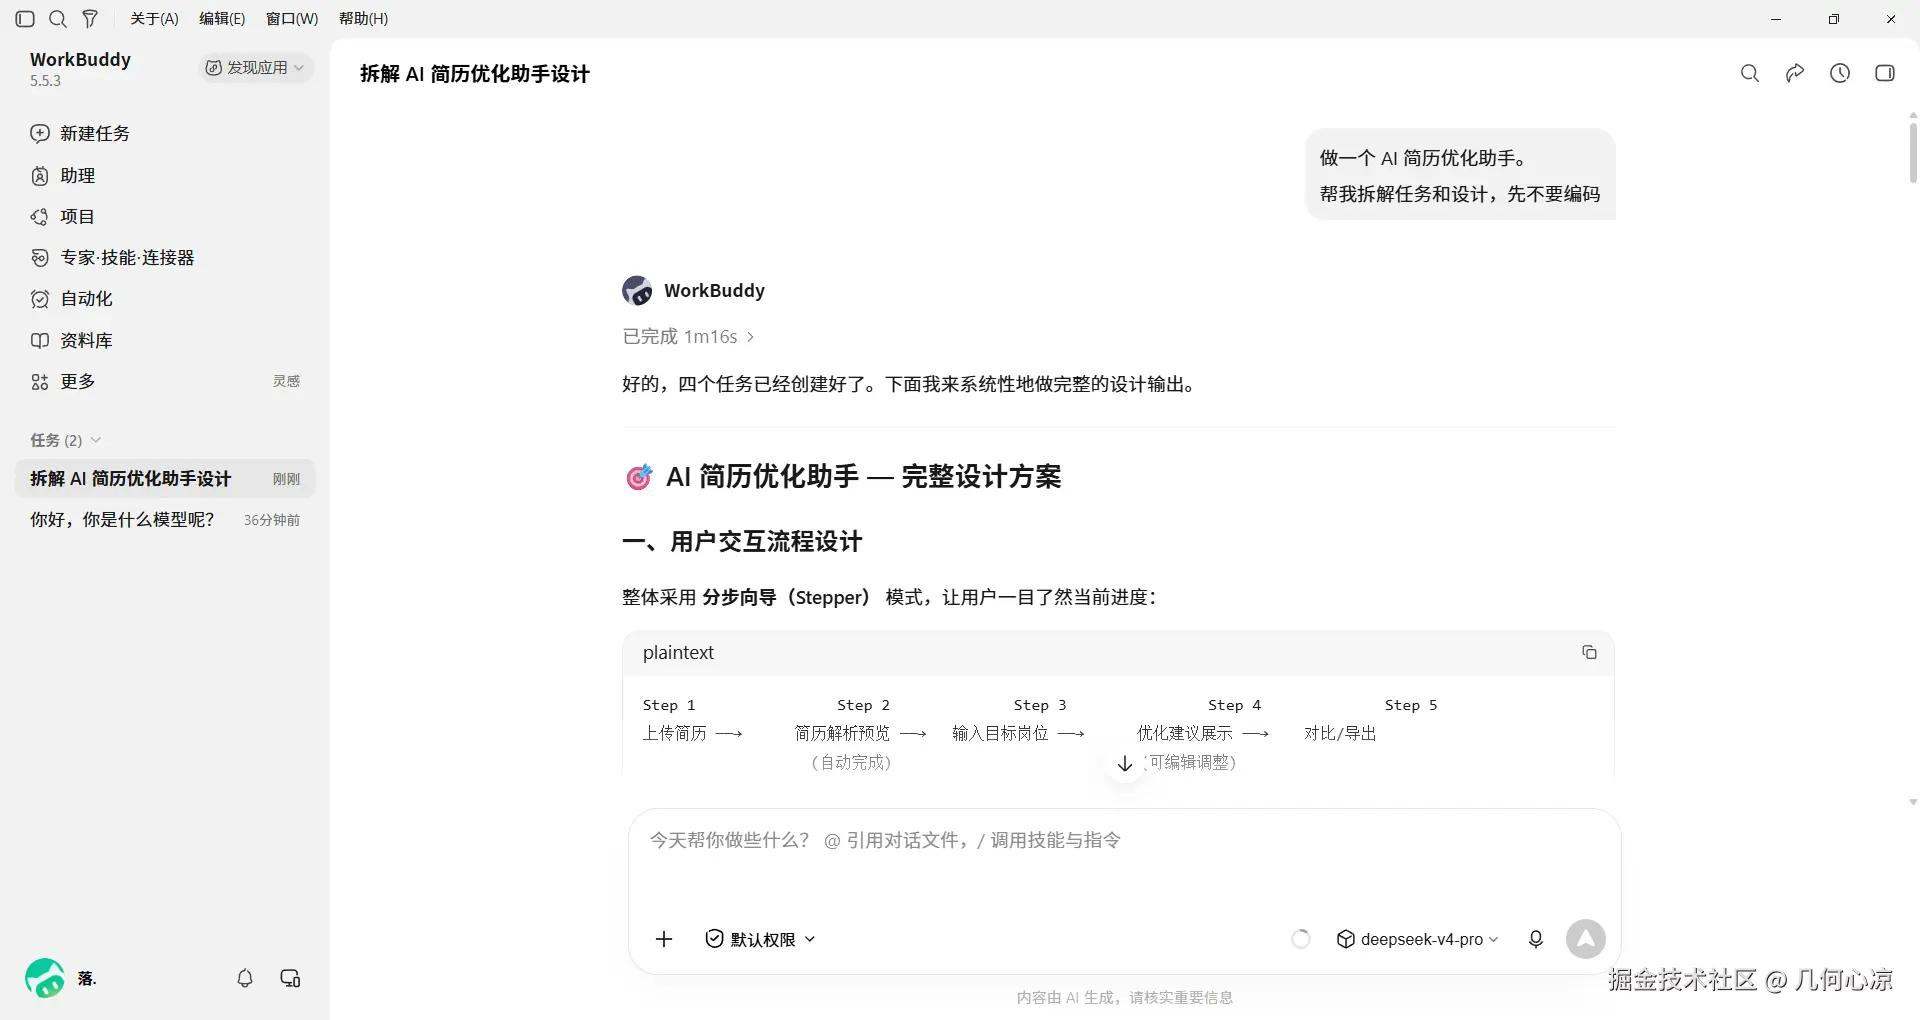
这个阶段反而让我更加确定一件事:AI 写代码越来越快之后,最怕的已经不是"写得慢",而是方向没想清楚就开始狂奔。产品逻辑先钉住,后面的 Coding 才不会变成不断推翻重来的返工。
3.2 产品逻辑定了,GLM-5.3 开始解决工程问题
需求清楚以后,问题马上从"做什么"变成了"怎么做"。
页面怎么组织、简历文件怎么处理、JD 怎么输入、分析状态怎么展示、结果页如何呈现,以及后面的模型调用如何接进来,这些已经是实打实的工程任务。
于是我把主要的开发工作放到了 GLM-5.3 上。
这一次不再是一句模糊的"帮我做一个网站",而是直接基于前面已经确定的产品结构往下施工。第一版也没有急着堆视觉效果,而是先把最重要的链路跑通:简历上传、JD 输入、发起分析、结果展示。核心流程稳定以后,再补文件处理、加载状态、错误提示以及后续 AI 调用所需要的结构。
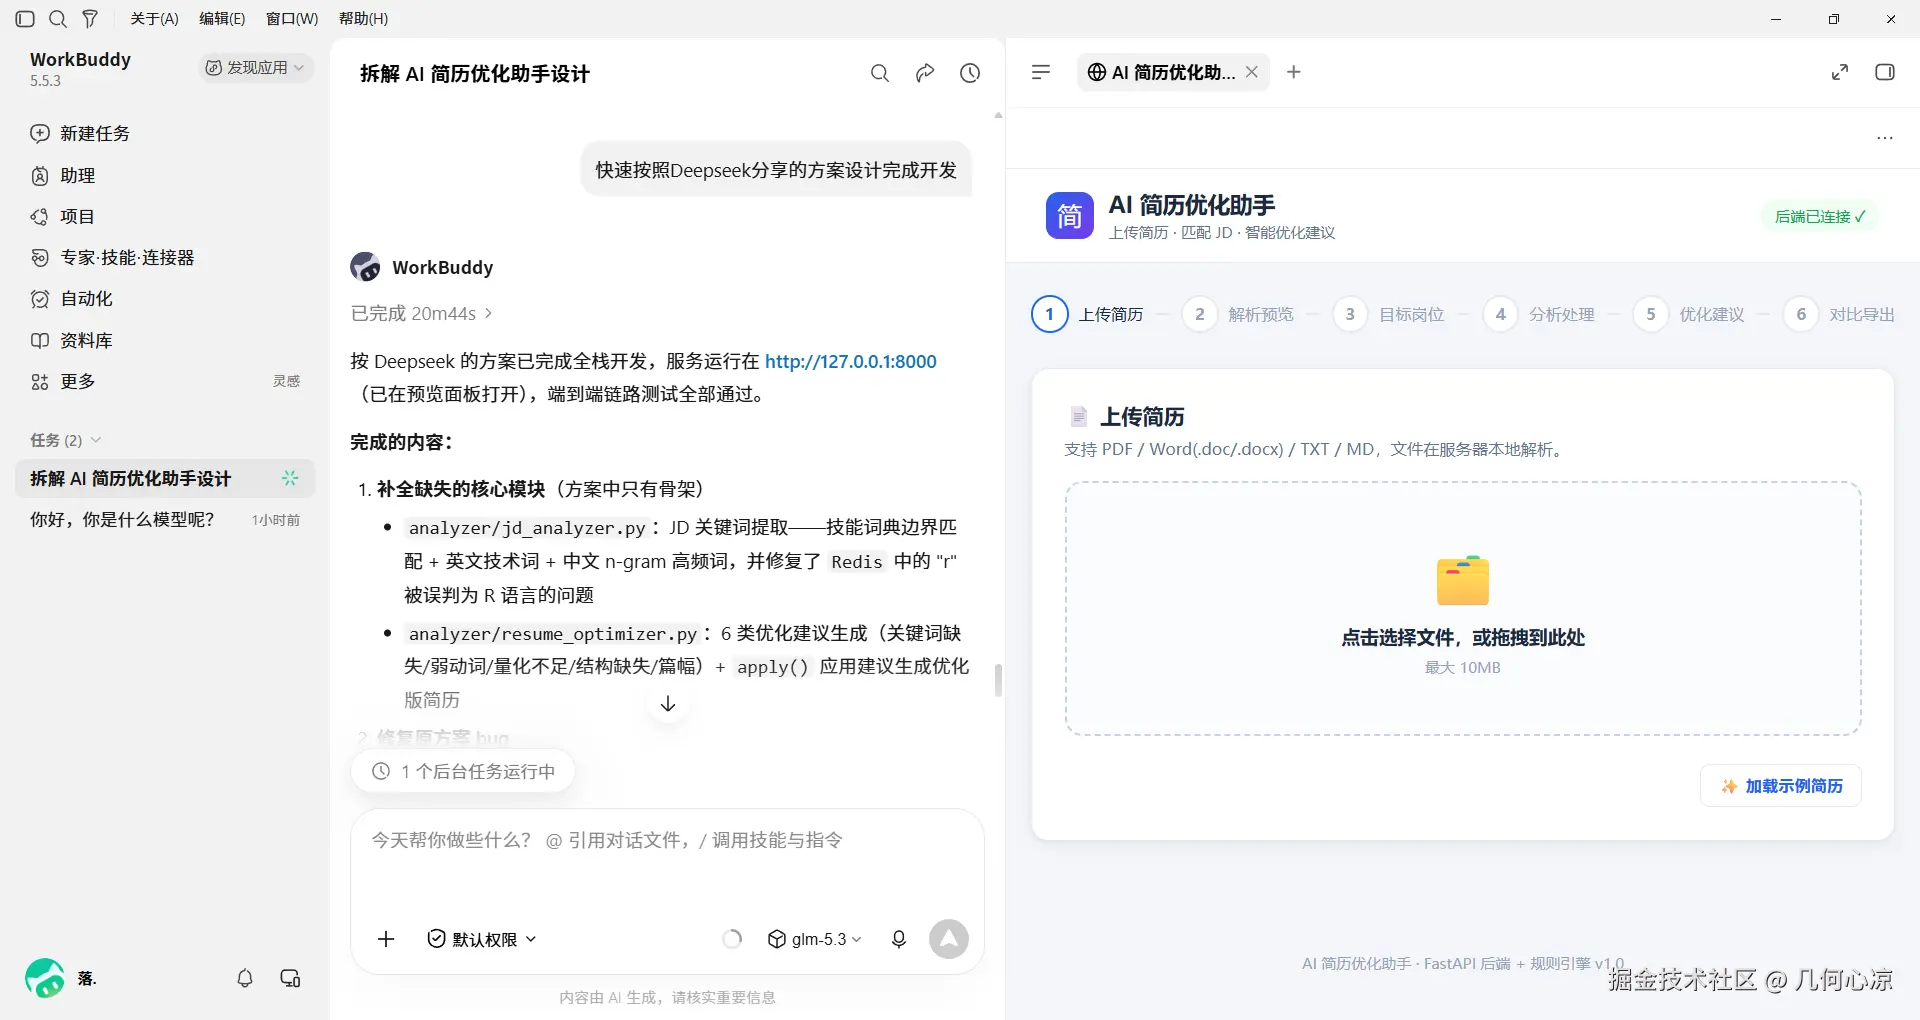
做到这里,多模型的便利开始变得非常具体。前面我需要的是把产品想清楚,现在需要的则是持续处理代码和工程细节。项目还是原来的项目,工作环境也没有变,真正变化的只是当前任务更适合调用哪一种模型能力。
如果每换一次模型都要重新注册平台、购买额度、配置工具,这种"各取所长"很快就会被折腾成本抵消。现在三款模型已经在同一份 Token Plan 里,选择模型这件事反而变得很轻。
3.3 页面只是外壳,真正难的是读懂"人"和"岗位"
第一版 Demo 能跑之后,真正困难的部分才出现。
对于简历优化工具来说,页面做得再漂亮也只是外壳。真正决定它有没有价值的,是系统能不能同时理解候选人的经历 和岗位真正需要的能力。
一段项目经历单独看可能写得没问题,但放进具体 JD 之后,问题很快就会暴露出来:招聘方反复强调的技术关键词有没有出现?项目经历有没有证明对应能力?是不是只写了"负责什么",却没有给出任何结果?哪些内容应该强化,哪些其实与岗位关联不大?
到了这一层,输入不再只是几句话,而可能同时包含简历全文、岗位 JD,甚至 PDF 页面和截图,因此我把 MiniMax-M3 放到了这一部分。
我并不把它包装成"更懂招聘"的模型,我更看重的是它在长上下文和多模态输入 上的能力形态。于是 Prompt 也不再停留在"帮我润色",而是按照 理解岗位 → 读取简历 → 建立能力对应关系 → 找出缺口 → 给出修改理由和优化内容 来组织。
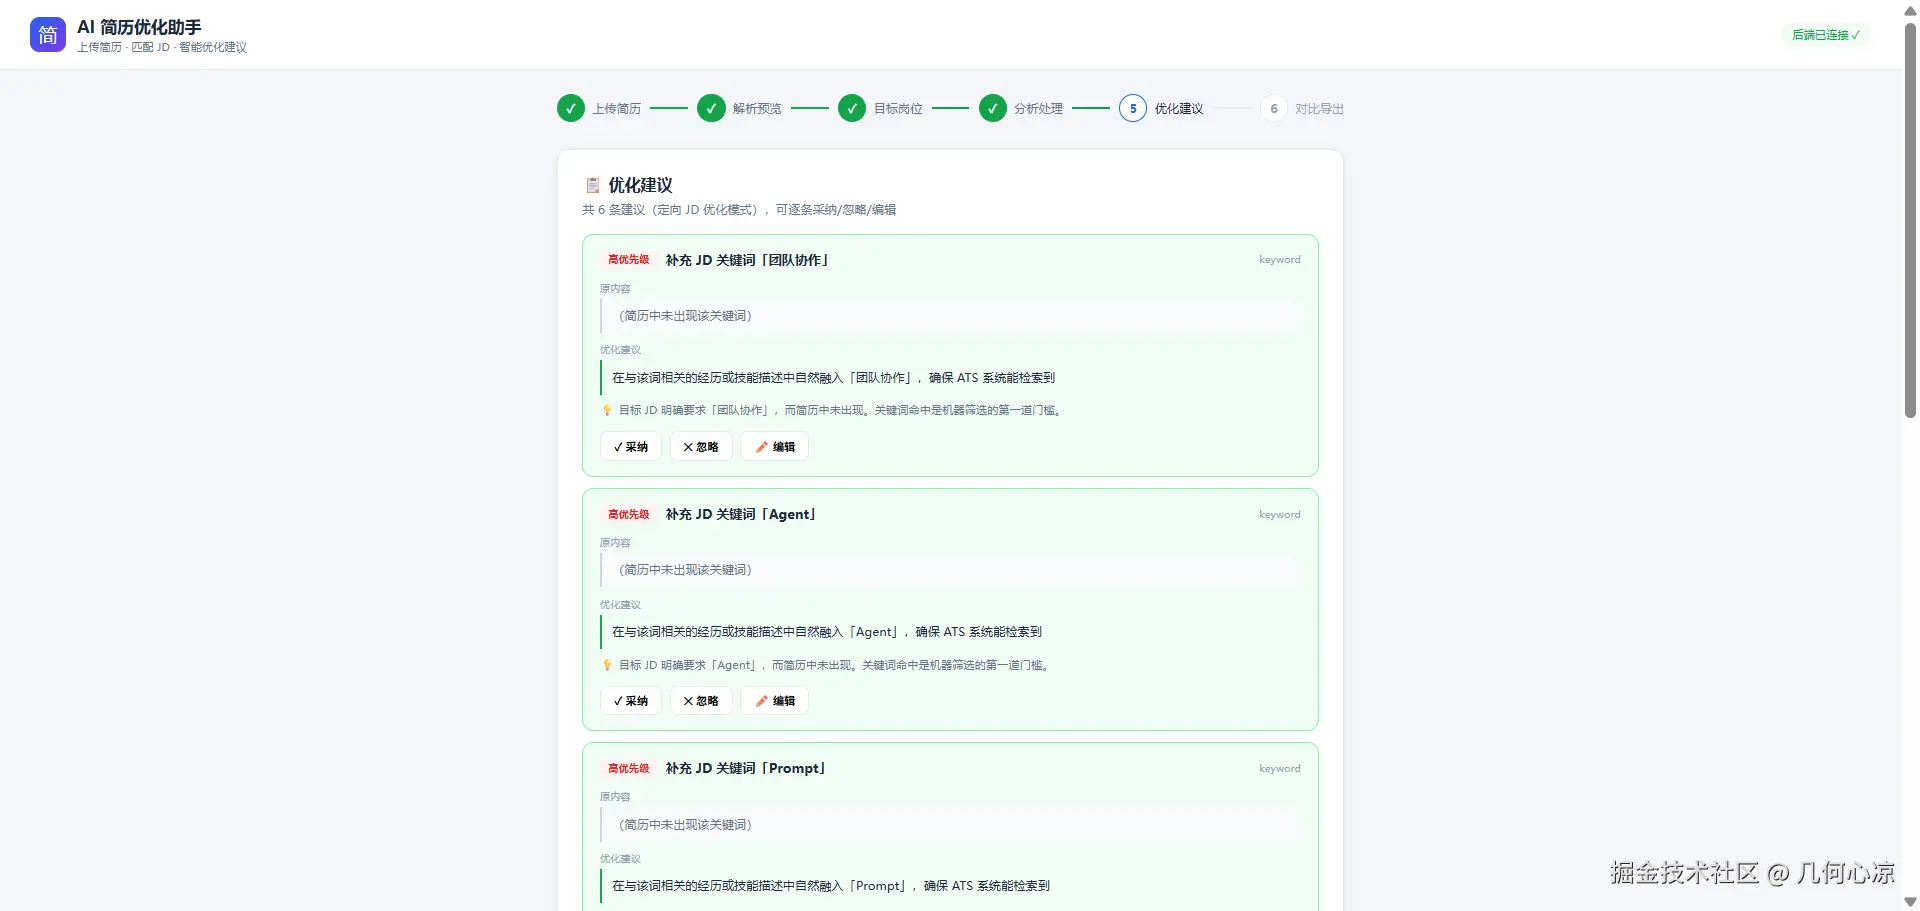
最终呈现给用户的,也不只是几段被重写的文字,而是岗位匹配、问题诊断、修改建议以及对应的优化结果。
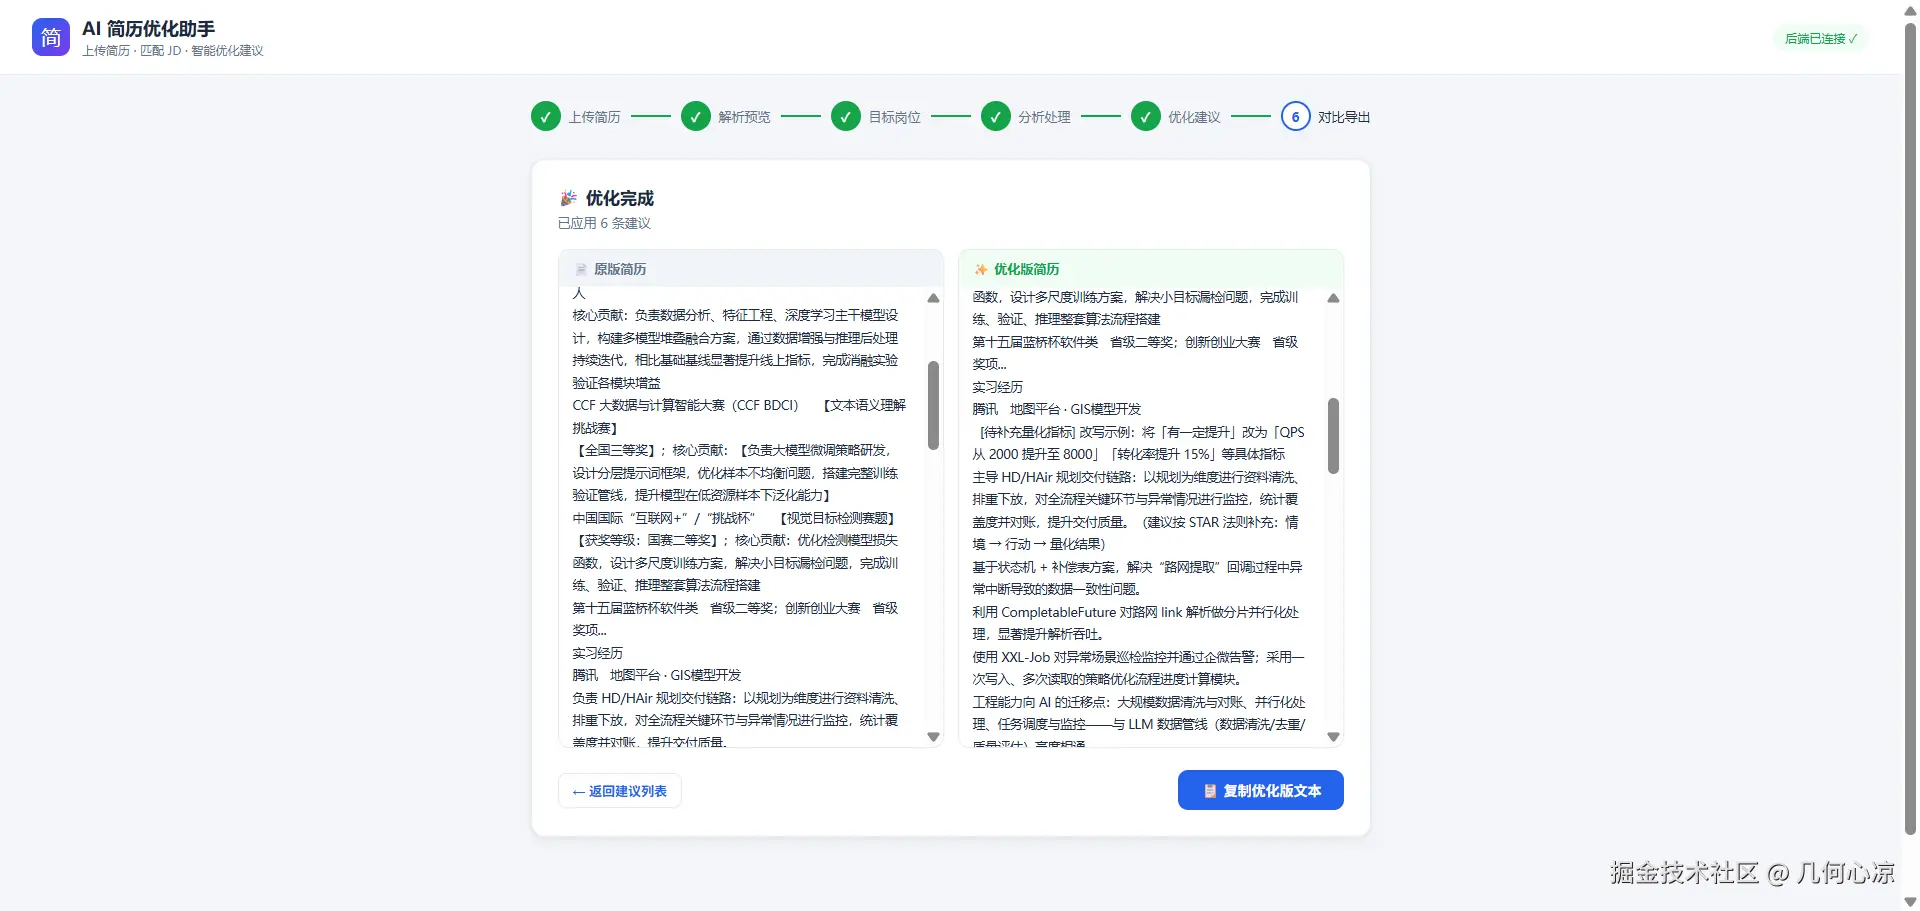
做到这里,我已经不太关心这三款模型到底谁排第一了。
因为这个项目真正证明的,是另一种更实际的用法:需求需要被想明白,工程需要被真正写出来,简历与 JD 又需要被深入理解;任务不同,本来就没必要强迫同一款模型把所有事情都做完。
而 Token Plan 恰好把这种选择成本压了下来。
整个项目里,我实际用了 DeepSeek-V4-Pro、GLM-5.3 和 MiniMax-M3 三款模型,却没有为它们分别维护三份独立订阅。 谁更适合眼前的问题,就把对应能力用起来。
相比"一个套餐里有多少款模型",这才是我觉得 Token Plan 更有意思的地方------不是模型越多越好,而是每一步都选对模型
四、不是模型越多越好,而是每一步都选对模型
把「AI 简历优化助手」真正跑完之后,我反而更确定了一件事:多模型的意义,从来不是模型列表越长越好,而是项目走到不同阶段时,手里始终有一款更合适的模型可以用。
需求还没想清楚时,我更需要模型帮我把产品逻辑拆透;进入开发阶段,Coding 和工程执行又成了主角;等页面真正跑起来,简历与岗位 JD 的理解、匹配和分析,又是另一种完全不同的能力需求。整个项目从头到尾没有所谓的"万能模型",但这并没有成为问题------因为我根本不需要押注某一个模型。
这也是这次 Token Plan 用下来让我觉得比较舒服的地方。
以前想把多款模型都用起来,往往意味着在几个平台之间来回切换:这边还有额度没用完,那边又得重新充值,模型想换一次,先得算一遍订阅账。现在这些选择被收进了一份 Token Plan 里,我更关注的是任务本身,而不是下一步又要去哪个平台买模型。
再加上目前整体价格大约相当于官方调用价格的 6 折左右,对于 Coding、长文本处理、反复调试这种高频场景,这种优势就不只是"便宜一点",而是让我敢于更自由地尝试不同模型,而不用每次切换都先考虑成本。
所以到最后,我最喜欢的反而不是"一个套餐里塞了多少模型",而是这种选择权:
DeepSeek、GLM、MiniMax 谁更适合眼前的问题,就用谁。
模型可以换,项目不用重来;能力可以组合,订阅不用拆成好几份。对真正把 AI 放进工作流里的人来说,这种自由度,比单纯拥有更多模型更有价值。
五、WorkBuddy 只是一个入口:Token Plan 还能接进更多 AI 工具
这次为了把多模型工作流真正跑起来,我选择了 WorkBuddy,但做到这里也能发现:WorkBuddy 其实只是 Token Plan 的一个使用入口,并不是它的边界。
按照目前平台提供的支持范围,Token Plan 还可以配合 OpenClaw、Claude Code、OpenCode、KiloCode、Codex、CC Switch、Hermes 等国内外主流 AI 编程和工作流工具使用。也就是说,订阅之后拿到的不只是一个固定聊天窗口,而是一套可以继续接进现有工具链的模型资源。此前的实际项目中,AiiOnly 也已经被用于不同模型之间的灵活切换,模型发生变化时无需重新维护一套账号和账单体系。
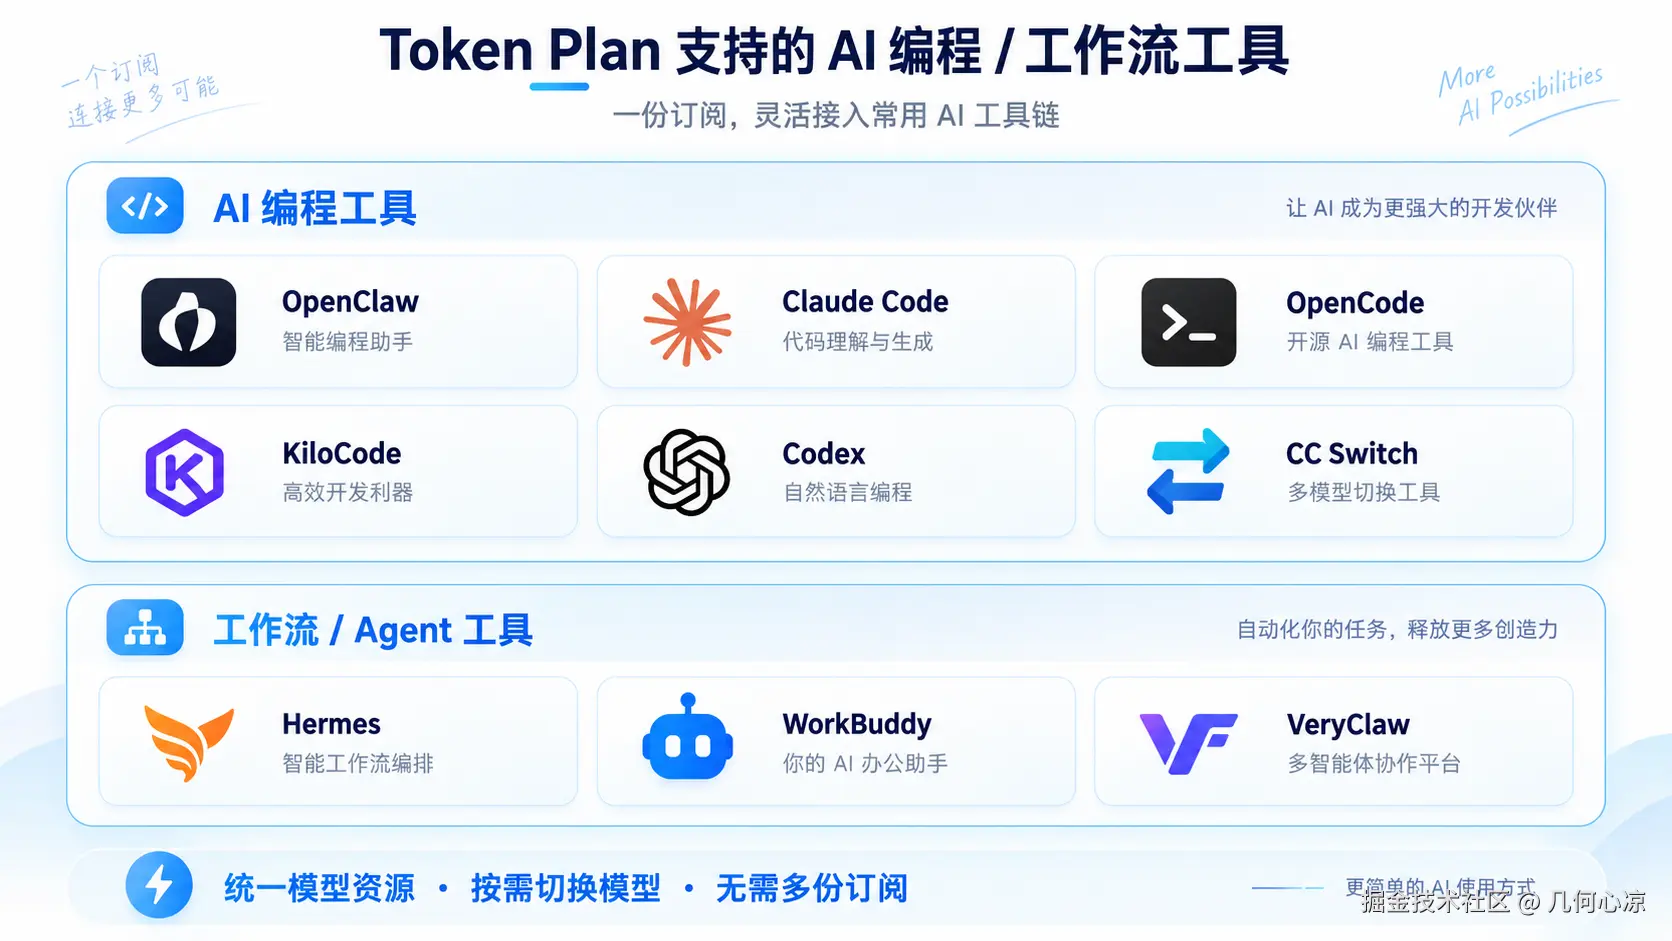
这点对开发者尤其有吸引力。有人习惯在 WorkBuddy 里做 Agent,有人日常离不开 Claude Code 或 Codex,也有人已经把 OpenCode、CC Switch 之类的工具塞进自己的开发流程。过去换工具、换模型经常意味着重新折腾服务商和 API,而 Token Plan 更像是把底层模型能力先统一起来,至于上层用什么工具,可以根据自己的习惯来选。
AiiOnly 自己也在继续扩展这套生态,例如面向 Agent 和开发场景的 VeryClaw,之前就已经能够把 AiiOnly 接进日常开发与任务工作流。
所以从 WorkBuddy 往外看,Token Plan 真正想做的并不是再造一个"只能在这里用 AI"的孤岛,而是让一份模型订阅尽可能进入更多已经成熟的 AI 工具里。对我这种经常换模型、换任务,但又不想反复维护几套订阅的人来说,这种开放性反而比单纯多几个模型更实用。
六、我最后留下的,不是某个模型,而是一套随时能换模型的工作方式
把这次「AI 简历优化助手」从头做到尾,我其实没有找到所谓的"终极模型",反而越来越不想找了。
DeepSeek、GLM、MiniMax 各有适合发挥的地方,后面还会不断有新的模型出现。与其每次新模型发布都重新考虑"要不要换阵营",我更愿意把选择权留在自己手里:项目需要什么,就用什么;哪款模型在当前任务里更合适,就切到哪款。
这也是为什么 Token Plan 最后给我留下的印象,不只是"一个套餐里有很多模型"。它真正省掉的是那些散落在模型之外的东西------多个账号、多份订阅、分散的额度,以及每换一款模型都重新折腾一遍的成本。
更何况,对于持续 Coding、长文本处理、Agent 任务这类高频场景,平台目前给出的价格口径大约是官方调用价格的 6 折左右。当模型调用从"偶尔玩一下"变成每天都在发生的生产力工具,这种成本差异就开始变得很现实。
如果你本身就是 AI 重度用户,或者已经在 WorkBuddy、Claude Code、Codex 等工具里频繁使用模型,那 Token Plan 的价值其实很好理解:
不是逼你选定唯一一个模型,而是花一份订阅,把更多选择留给真正的任务。
目前通过我的专属链接注册 AiiOnly,新用户可以获得 15 元代金券新人礼 ;另外,通过我的专属链接注册成功,还可以额外领取一张 5 元无门槛 Token Plan 代金券。如果本身就想尝试多模型工作流,这个福利正好可以拿来先跑一遍。
链接直达: maas.aiionly.com/login?invit...
模型还会继续更新,工具也一定会继续变化。但对我来说,这次真正搭起来的东西反而没那么容易过时------不是某一款模型,而是一套随时可以把更合适模型换进来的工作方式。