千笔-AIWritePaper · https://www.aiwritepaper.com
系统综述里最容易买错的不是「哪个 AI 最强」,而是把检索式草稿、题录筛选、数据抽取、结果综合当成同一选型 。NNLM(Network of the National Library of Medicine)Health Bytes 公开场次视频标题为 Navigating Systematic Reviews with AI: Best Practices and Challenges (2025-04-09;讲者公开信息:Margaret Foster,Texas A&M University Medical Sciences Library)。公开介绍强调:AI 可能增强证据综合若干环节,但需要实务指引,并正视挑战;公开材料常见主线包括明确目标、选型试跑、持续监测,以及把 Human in the Loop 放对位置。本文不扩写视频简介腔、不编造讲者原话,而把可操作验收落成选型表 + 人工终裁分层 + 能写/不能写 + 失败含义 (对标 BrainX 88 写法,不停留在只有闸门的 82 地板)。逐字稿本次未稳定保存,语料以公开视频页、主办方预告与可核对的公开要点为准。
视频:https://www.youtube.com/watch?v=lsysVo3ZGz4
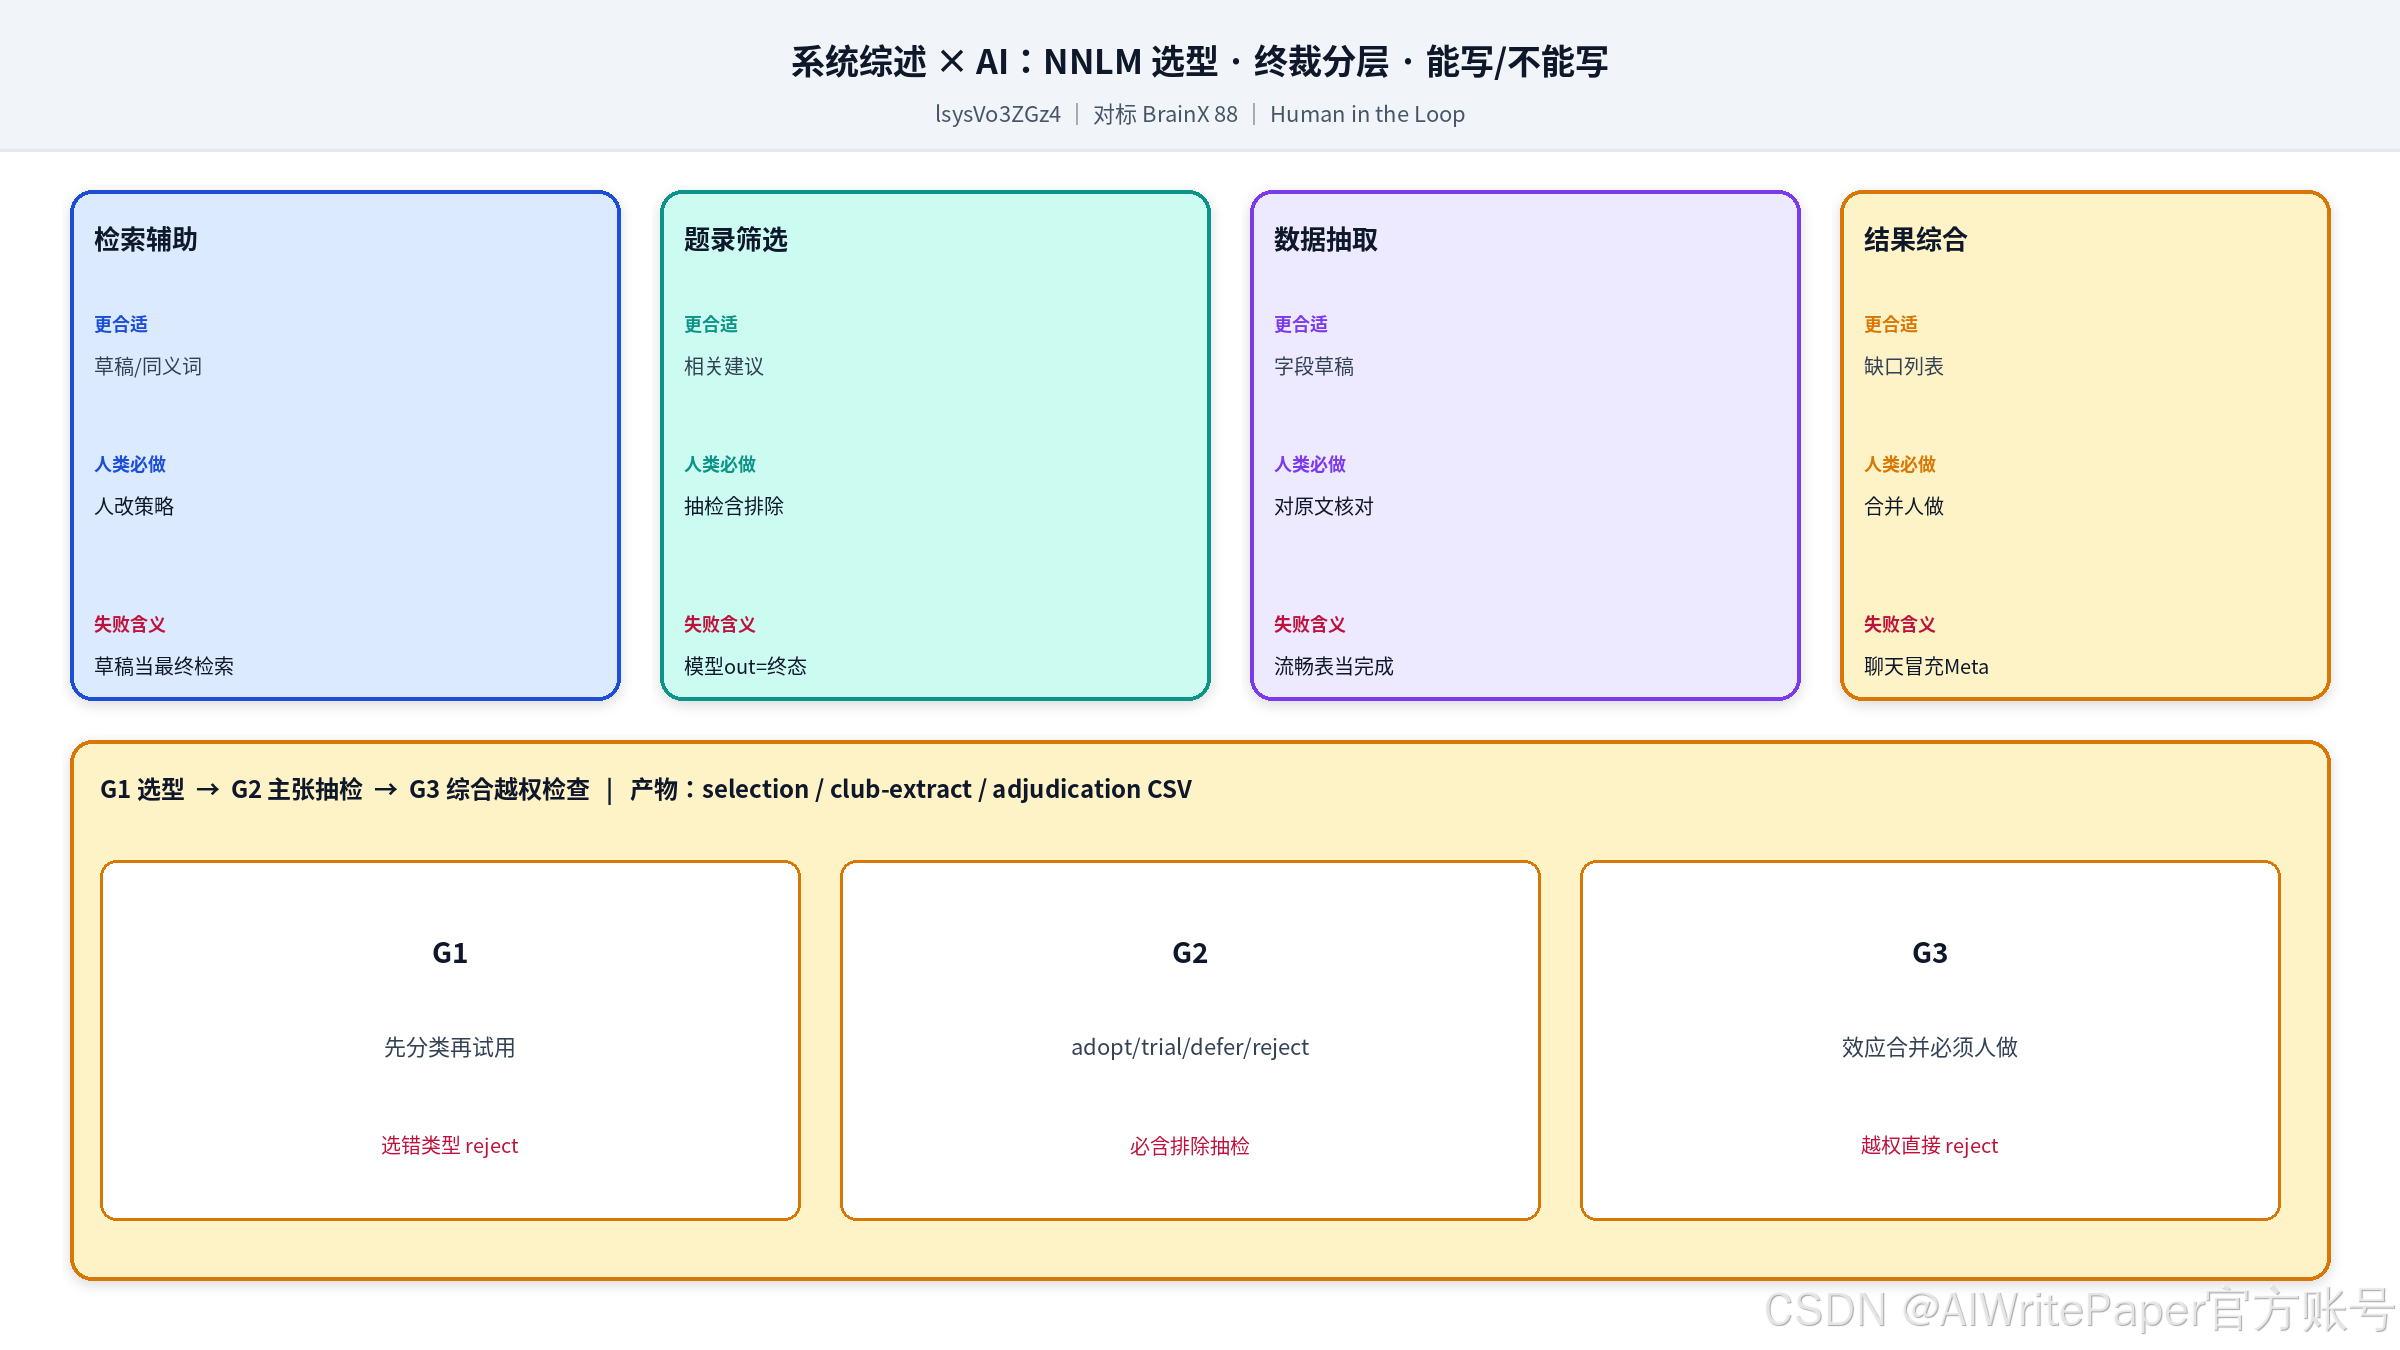
图:检索/筛选/抽取/综合四栏选型;三道人类终裁;底部能写不能写与可审计产物。
目标说明
读完应能独立完成五件事:
- 用一句话说清验收核:先选对综述阶段工具类型,再抽检输出主张,最后由人类写下 adopt / trial / defer / reject。
- 对照选型表,判断当前任务属于检索辅助、题录筛选、抽取还是综合。
- 列出「能写 / 不能写」边界,避免把模型排序写成已完成纳入。
- 当天跑最小实验:
sr-selection.csv+sr-club-extract.csv+sr-adjudication.csv,至少 1 条 reject/defer。 - 对外披露时把公开预告要点标成预告/公开快照,不写成你团队系统综述已终审的结论。
适用边界
适合
- 课题组开始用通用 LLM / 筛选工具做 SR,需要把门禁写进 SOP。
- journal club 已讨论「AI 能减负」,但停在经验之谈。
- 需要区分「辅助二筛」与「自动完成 PRISMA」。
- 希望把不确定性写成行级终裁,而不是把一次通顺输出写进定稿。
不适合
- 把 webinar 扩成「AI 已可无人值守完成系统综述」站队文。
- 无人类终裁就把模型纳入/排除写进最终流程。
- 只有聊天记录,无选型表/抽检 CSV,却宣称已部署证据综合 AI。
- 上传未发表数据到不符合保密要求的公网工具还宣称「已合规」。
- 索要危险操作细节:本文只验收流程门禁。
风险
公开材料同时谈效率与挑战/伦理,本身反对单点神话。常见关切包括漏检(假阴性)、偏倚、透明度与验证不足------这些应进 limitations。最小实验证明闸门可跑通,不是某条临床主张为真。视频未逐字核验的句子一律不当引语。
选型 / 验收表
| 阶段 | 更合适 | 人类必做 | 产物 | 失败含义 |
|---|---|---|---|---|
| 检索辅助 | 检索式草稿/同义词扩展 | 对照库语法与金标准试检索 | search-log.md | 把草稿当最终检索策略 |
| 题录筛选 | 相关/不相关排序或建议 | 双人/抽样复核;盯假阴性 | screen-sample.csv | 模型 out = 最终排除 |
| 数据抽取 | 字段草稿与定位 | 对原文逐字段核对 | extract-audit.csv | 流畅表格当已抽取完成 |
| 结果综合 | 缺口列表/异质性提醒 | 效应合并与解释必须人做 | synth-notes.md | 聊天摘要冒充 Meta 分析 |
完整表见 _w/sr-selection.csv。公开讨论里,筛选(尤其相关性判断)常被看作较有希望的切入点,但仍强调先试跑、再谈验证指标(如敏感性、漏检代价),不是「上线即可信」。
能写 / 不能写(终裁强度来源)
| 对象 | 能写 | 不能写 |
|---|---|---|
| 公开场次 | AI 可用于若干 SR 环节;需试点与人在环 | 「本场已证明某工具敏感度 xx%」(无逐字核验勿写) |
| 检索输出 | 候选式与待验证同义词 | 「检索已穷尽且无漏检」 |
| 筛选输出 | 建议排序 + 抽检计划 | 「自动完成纳入排除」 |
| 抽取输出 | 待核对字段草稿 | 「数据提取已终态」 |
| 综合输出 | 争议点/缺口清单 | 「AI 已完成证据综合与推荐」 |
| 对外沟通 | 助手非替代;日志可审计 | 「NNLM 场次=你们协议已过审」 |
人工终裁分层(G1--G3)
| 层 | 问题 | 动作 | 产物 |
|---|---|---|---|
| G1 选型 | 当前是检索/筛选/抽取/综合哪一类? | 选错类型 → reject 重选 | sr-selection.csv |
| G2 主张抽检 | 模型句子是否可指回可打开记录? | adopt / trial / defer / reject | sr-club-extract.csv |
| G3 综合越权 | 是否把效应合并/推荐交给模型? | 越权 → reject;只留缺口列表 | sr-adjudication.csv |
对标 BrainX 88:终裁分层要写进当天产物,不能停在「我们会注意伦理」口号(那是 82 地板风险)。
失败含义(写进 SOP)
| 现象 | 含义 | 动作 |
|---|---|---|
| 高特异性、低召回 | 可能系统性漏检 | 停自动排除;提高人工抽检 |
| 无试点金标准 | 无法谈「省了多少」 | 先小样本对照再扩 |
| 只有通过率无不通过样本 | 闸门未执行 | 整单作废 |
| 把工具分写进结果节 | 越权 | 移到方法限制或附录 |
| 全 adopt 无 defer/reject | 终裁形同虚设 | 强制至少 1 条 reject/defer |
当天最小实验
- 选一篇进行中的 SR 主题,固定 20--50 条题录样本。
- 填
sr-selection.csv:声明本轮只做「筛选辅助」或「检索草稿」之一。 - 跑工具/LLM 得到建议;人工抽检 ≥10 条,写入
sr-club-extract.csv。 - 对每条建议做 G2 终裁;至少 1 条 reject 或 defer。
- 用
sr-adjudication.csv记录:是否有人把「综合」偷偷交给模型------有则 reject。
模板见 _w/ 下三个 CSV。
可验证清单
- 选型表已选且未混阶段
- 抽检表含通过与不通过
- 至少 1 条 reject/defer
- 无「自动完成 PRISMA」表述
- 对外口径标注公开快照
- 限制节写了假阴性/透明度
踩坑
- 把 webinar 标题当操作手册:仍要落 CSV。
- 只报省时百分比:不报漏检策略。
- 筛选与综合混用同一提示:选型失败。
- 无金标准试点就全库自动:不可审计。
- 编造讲者原话:本文明确禁止。
文档口径
对外:「AI 可辅助系统综述部分环节;纳入、抽取核对与效应解释由人类终裁。」对内:三张 CSV 路径、抽检比例、停用条件。
试点设计(写进方法而不是口头)
公开讨论强调先试跑再扩。建议把试点写成四行就够:
- 金标准样本来源(已人工双筛的子集)。
- 工具/提示版本号。
- 主指标:召回(漏检)优先还是省时优先------必须显式选。
- 停用阈值:漏检超过阈值即停自动建议。
没有这四行,就不要在组会说「我们按 NNLM 最佳实践做了」。
假阴性为什么权重大
系统综述的核心风险往往是漏掉该纳入的研究。模型很会「看起来果断地排除」。因此 G2 抽检要故意加「模型排除」样本,而不是只抽「模型纳入」。抽检表缺排除样本 = 终裁偏置。
披露模板(可改)
「本题录筛选使用【工具/模型 + 版本】生成相关性建议;最终纳入排除由人工按协议完成;试点样本与不一致列表见附录。」
journal club 用法
- 会前每人填 3 行
sr-club-extract.csv。 - 会上只讨论 defer/reject,不朗读 adopt。
- 会后更新
sr-adjudication.csv:是否有人提议跳过人工综合。
与自动化筛选文献的关系
近年有大量 LLM 筛选研究,报告的召回/特异度区间很宽。你的 SOP 应引用「需要验证」这一事实,而不是引用某篇的最高点当自己的成绩。把外部论文当背景,把自己的试点当证据。
不能写进结果节的句子
- 「AI 确认该干预有效」
- 「模型已完成 Meta 分析」
- 「按 webinar 结论,可省略双人筛」
这些句子一出现,G3 直接 reject。
能写进方法节的句子(示例)
- 「我们使用【工具】对题录做相关性排序建议,并按协议人工复核。」
- 「试点阶段优先监控漏检,阈值见附录。」
- 「AI 不参与效应量合并与推荐意见撰写。」
筛选辅助的抽检比例经验规则(可改)
- 试点:模型纳入与排除各抽 ≥10 条。
- 扩面前:排除样本再抽一轮,专门找假阴性。
- 意见不一致:进入双人讨论,不把模型当第三票。
规则要写进 SOP;数字可按库规模调整,但「排除样本必抽」不宜删。
工具更换时的回归
换模型版本或换供应商,视为新选型:重填 G1,重跑试点,不继承旧 adopt 列表。把版本号写进 sr-selection.csv 的 tool_version 列。
阶段混用的典型事故
同一提示里要求模型「检索并筛选并总结并给临床建议」------这是选型表上的全阶段熔断。拆开后:
- 检索助手只许输出检索式与同义词;
- 筛选助手只许输出相关/不相关建议;
- 综合只许输出争议与缺口。
混用一次,G1 记 reject,并在 note 写「prompt_stage_mixing」。
人类在环的位置图(文字版)
检索草稿 → 人改策略 → 题录库 → 人定纳入规则 → 模型建议 → 人抽检 → 全文 → 人抽取核对 → 综合 → 人解释与推荐。
每一箭头上的「人」都可以写成 SOP 工时;删掉任一「人」都要有书面豁免------通常不该有。
对外发言检查
发公众号/组会汇报前删掉:未核验的准确率、未试点的「已全面采用」、把 NNLM 场次当作背书徽章的句子。
总结
NNLM 场次提供的是最佳实践讨论入口,不是免审徽章。工程上要对标 BrainX 88:选型表分阶段、终裁分 G1--G3、能写/不能写写死、失败含义进 SOP。去掉视频名与机构名后,若手里还剩这四样,才算冲高分写法;若只剩「AI 很有潜力」,就仍停在地板风险。