从可落地的方案、选型取舍与实施路径来写。
谷歌在 SEMICON Taiwan 2026 上宣布 TPU 互联架构支持 100 万芯片规模,背后是一套名为 Virgo 的网络设计。这套网络的核心思路是用高基数交换机替代传统三层 Clos 拓扑,将每个芯片的带宽从 100 Gbps 提升到 400 Gbps,同时在单数据中心内连接超过 13.4 万颗 TPU 8t 芯片,提供每秒 47 PB 的无阻塞对分带宽 cite: 1, 6, 15。
架构选型从来不是一步到位
这种扁平化两层结构降低了延迟,但代价是对交换机硬件和光纤布线提出了更高要求。单个 Virgo 网络已接近物理极限,要扩展到百万芯片,就必须跨多个地理位置组成逻辑训练集群,依赖 JAX 与 Pathways 框架做数据并行 cite: 5, 7。
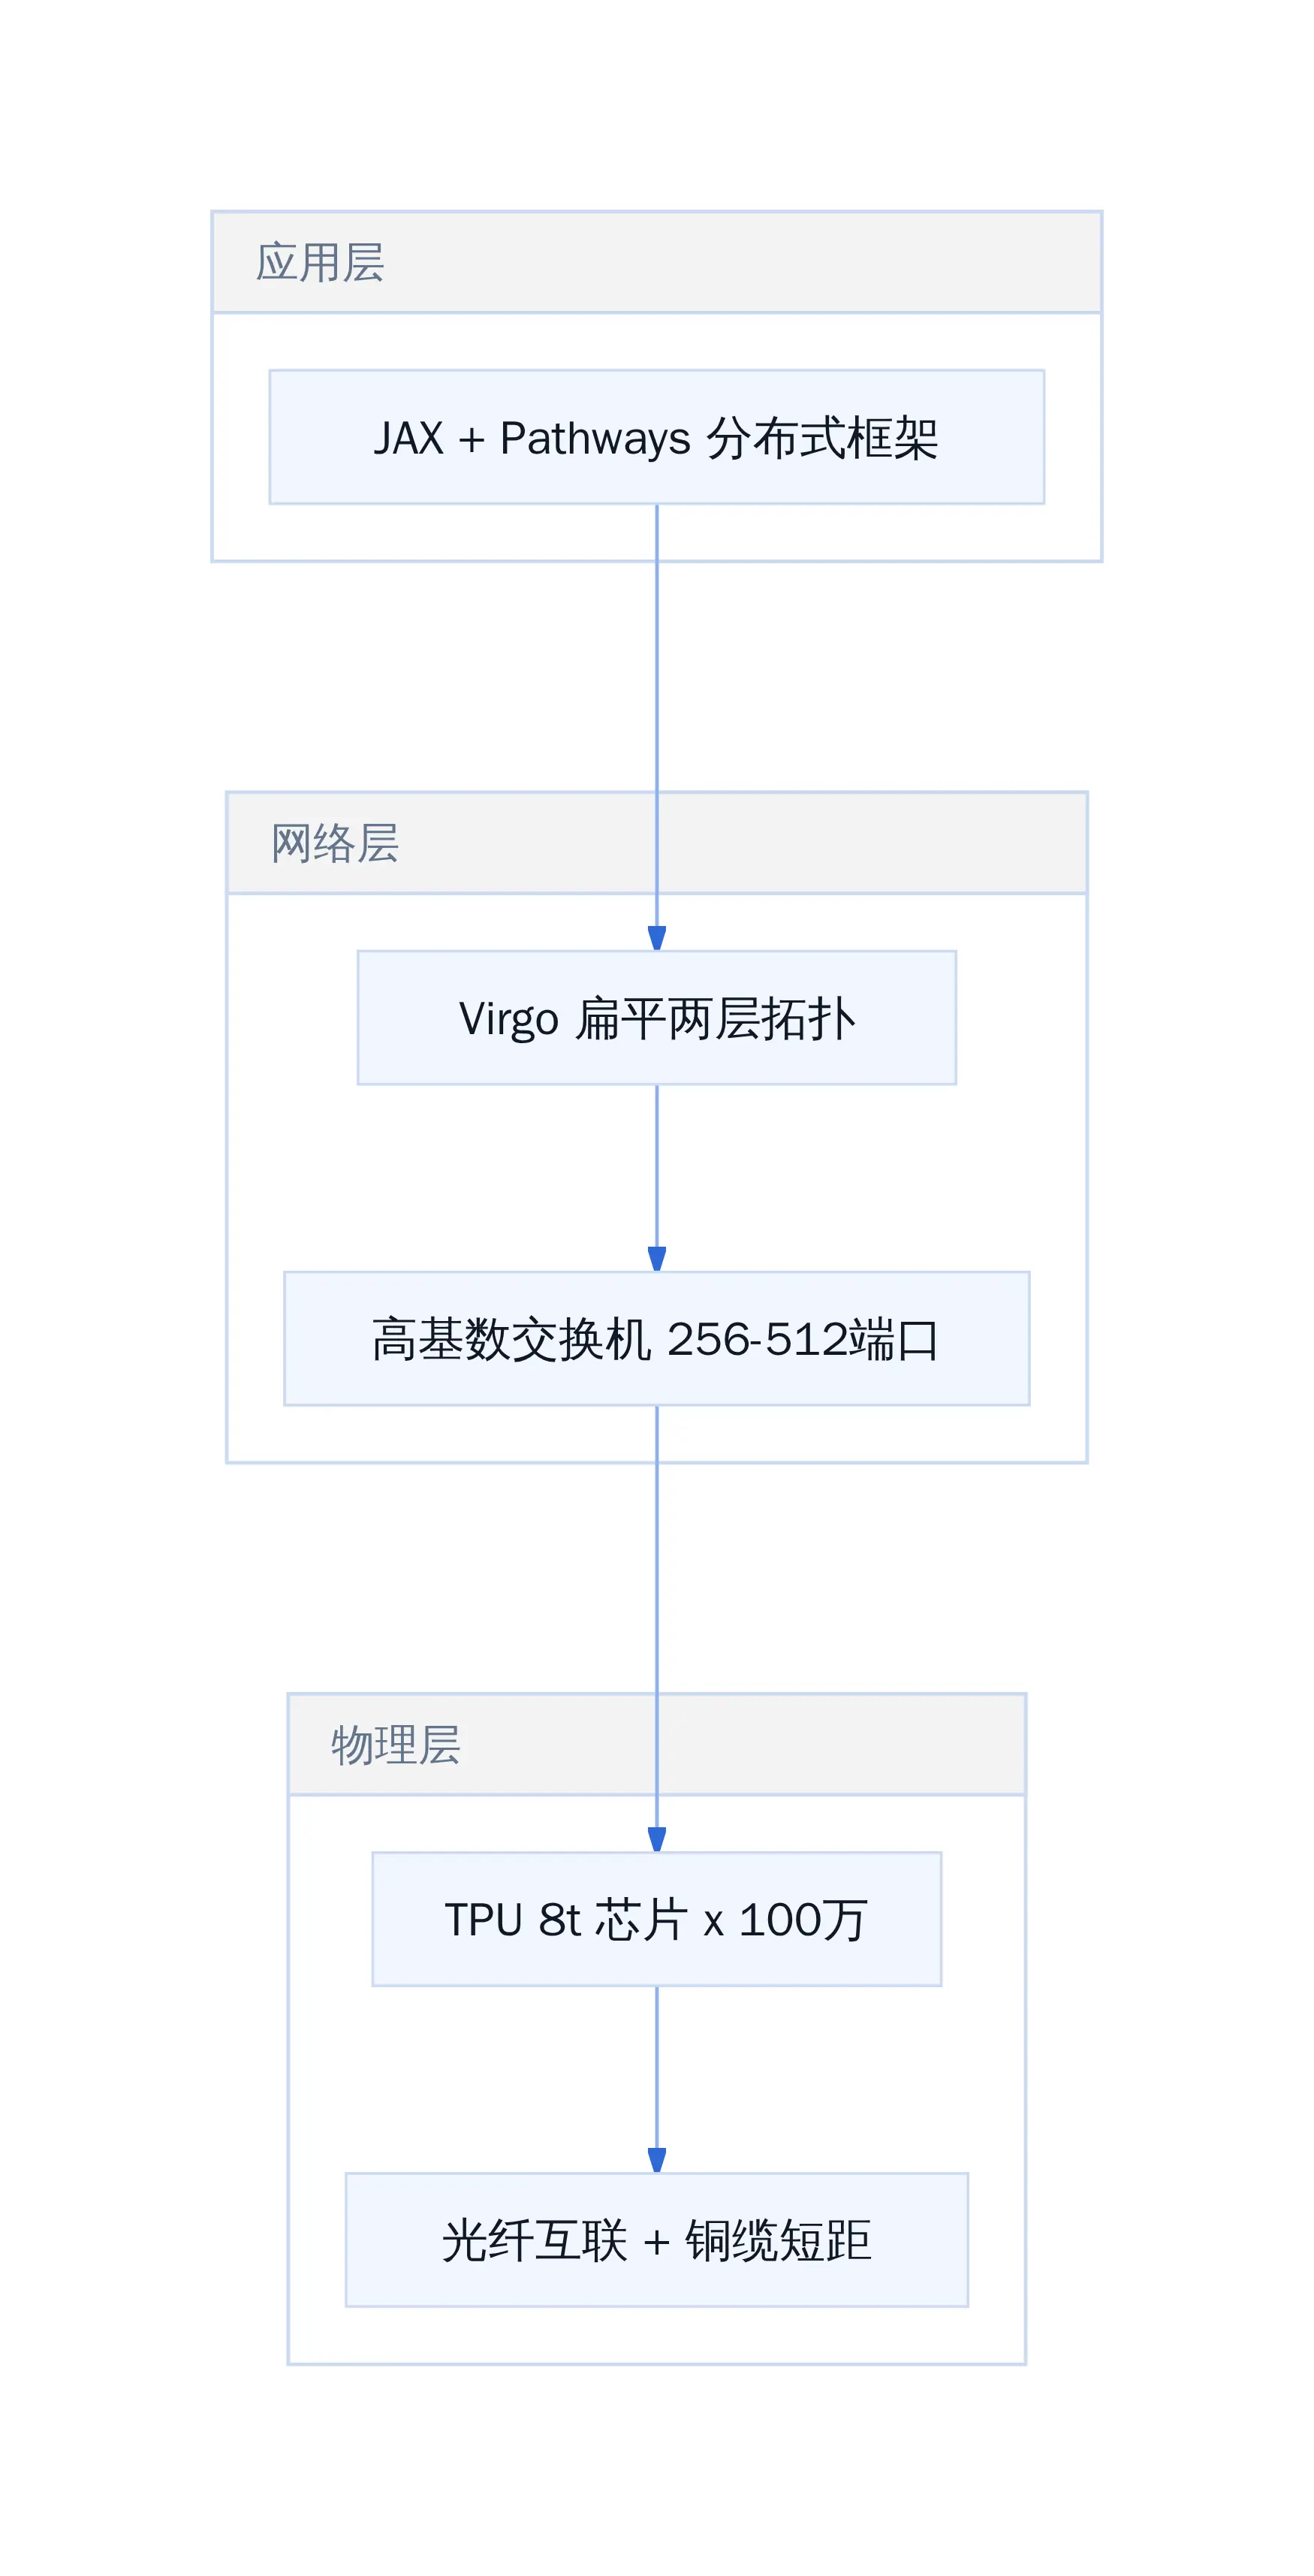
TPU 百万芯片互联架构分层
瓶颈转移的关键在于功耗密度。TPU v8 单芯片功耗达 1300W,较前代提升 30%,而电源架构已从传统 -48V 或 220V AC 转向 ±400V 高压直流方案 cite: 2, 16。高压直流传输损耗小、转换级数少,但对电源芯片耐压、短路保护、电弧抑制提出全新要求,国内供应链在此领域的突破仍在进行中。
冷却系统同样是硬性约束。谷歌自 2020 年起已在吉瓦级规模部署先进液冷方案,并实现 99.999% 机群运作时间 cite: 3。但冷板接口、快接头、磁力泵等核心部件的标准化程度不足,各厂商规格不一,规模化部署时集成成本显著上升 cite: 2。
电网审批比买芯片还慢
马斯克在 G20 峰会上给出的数据更为直接:到 2027 年 AI 芯片电力缺口将达至少 15 吉瓦,而芯片产能年增 40%-50%,电力供应仅增 10%-20% cite: 8, 9。一位行业人士指出,AI 园区的经济性越来越取决于电力能否按时交付,而非园区能否被建成 cite: 11。这意味着选址策略必须把电网接入时间纳入核心约束,而不是单纯看土地和劳动力成本。
传统 SaaS 化交钥匙方案在这里面临天花板。这种方案假设算力是可抽象的资源,按需分配即可。但当基础设施本身的物理约束(电力、散热、带宽)成为瓶颈时,抽象层反而掩盖了真实的容量规划问题。AI 原生基建思维要求从一开始就把电力容量、冷却能力、网络拓扑作为一等公民来处理,而不是事后补救。
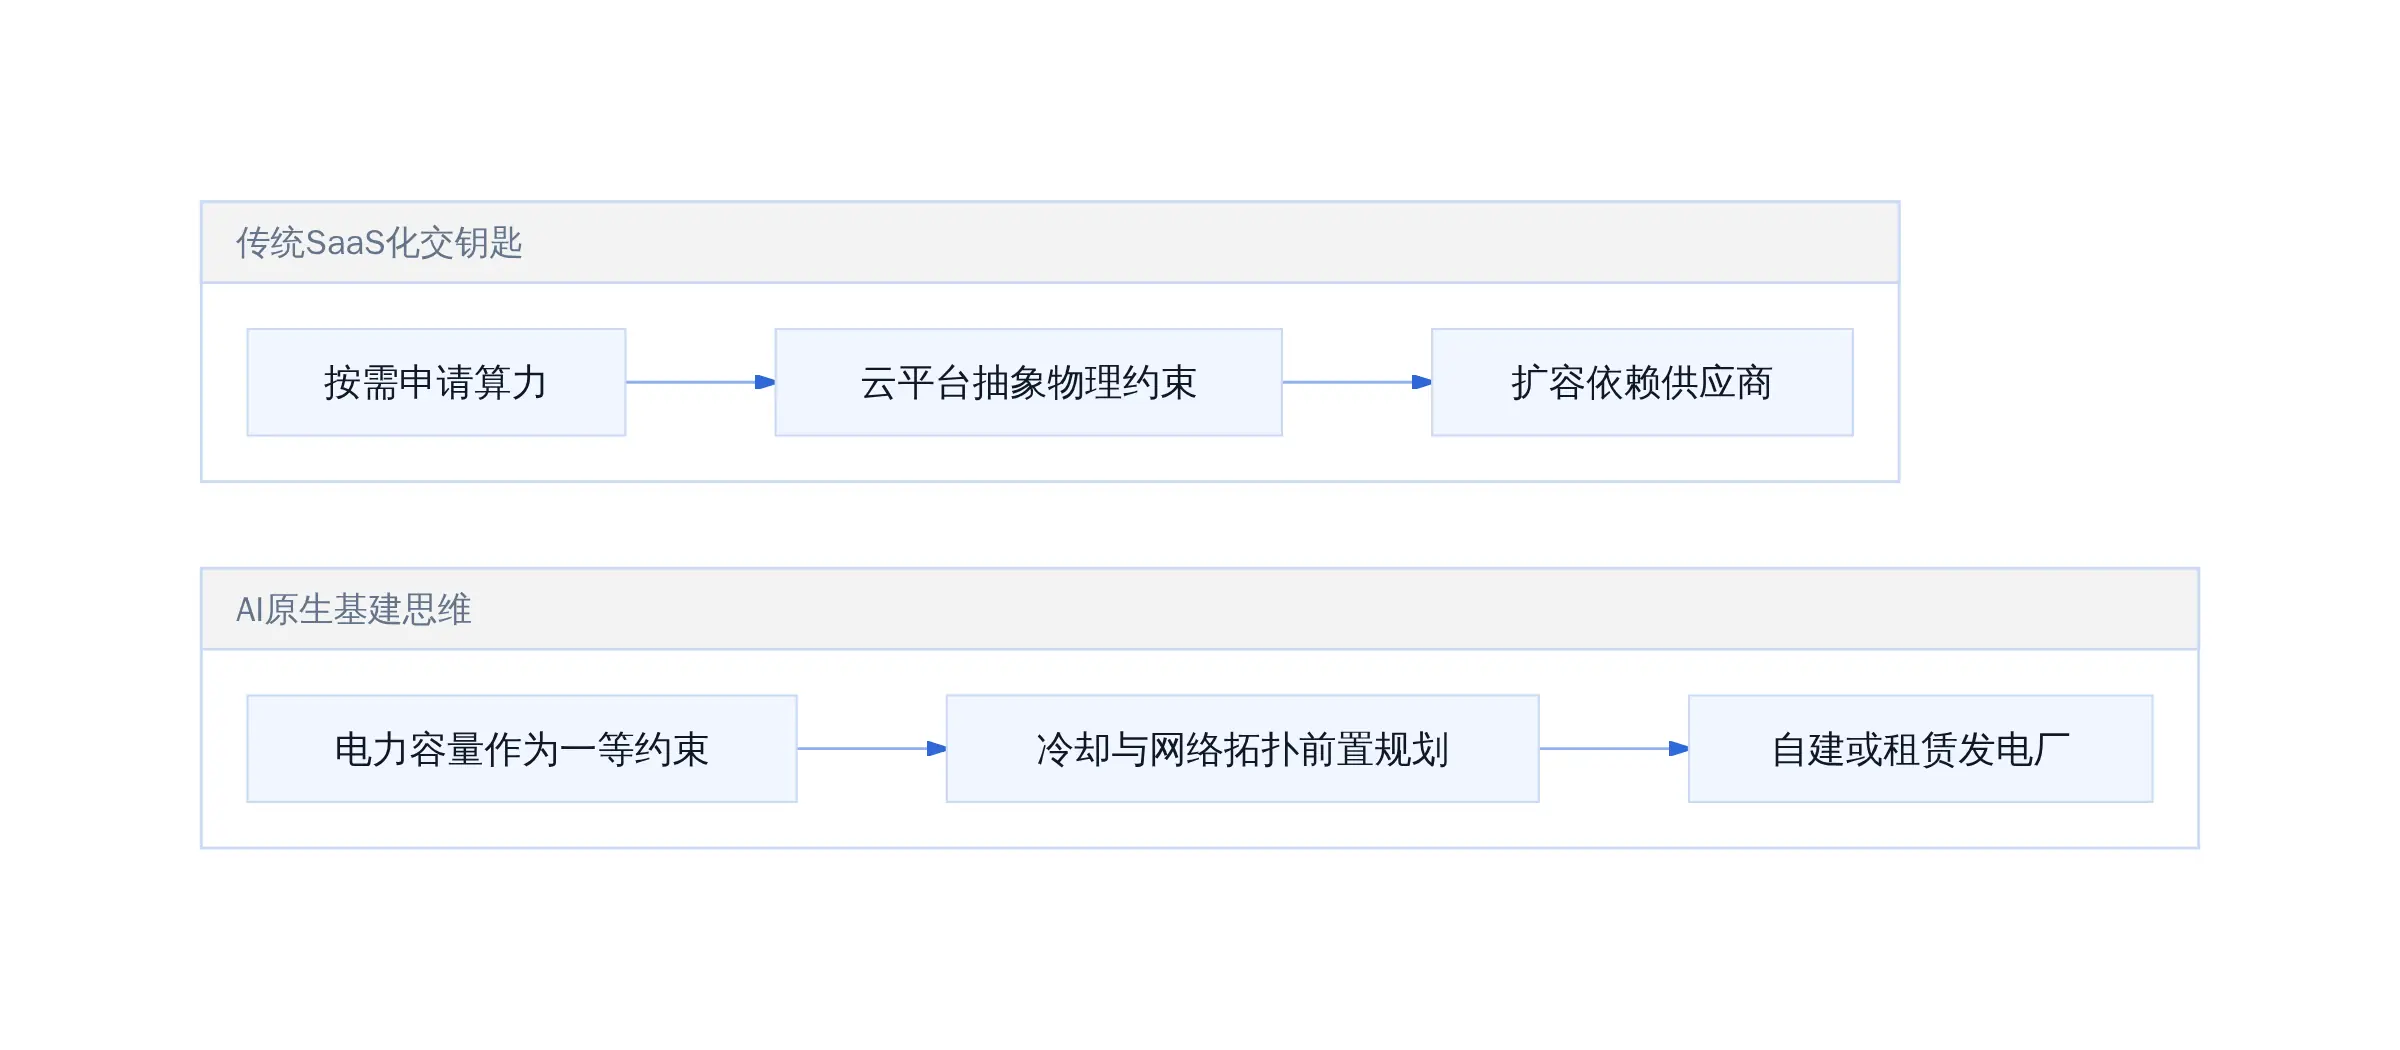
传统 SaaS 方案 VS AI 原生基建
选型决策上,如果在兆瓦级以下规模运行、模型训练周期可控,可以直接使用云厂商 TPU 实例;但如果目标是构建百万芯片级的独立训练集群,就需要提前锁定电力容量,并考虑自建液冷基础设施或与发电厂绑定选址 cite: 1, 8, 11。这条路的前期投入极高,但一旦建成,边际成本会显著低于纯租赁方案。
Virgo 网络虽然把单芯片带宽推到 400 Gbps,但这套架构对交换机硬件和光纤布线提出了极高要求。单个 Virgo 网络只能容纳约 13.4 万颗 TPU 8t 芯片,要扩展到百万芯片规模,就必须跨多个地理位置组成逻辑训练集群。这意味着数据并行策略需要从单机柜级提升到跨数据中心级,JAX 与 Pathways 框架的分布式调度复杂度显著增加。
架构选型从来不是一步到位
网络层的扩展只是冰山一角。更根本的问题在于,百万芯片集群的功耗正在突破传统数据中心的承载上限。TPU 8t 单芯片功耗约 1300W,百万芯片的理论峰值功耗超过 1.3 吉瓦,这还只是芯片本身,不含冷却、供电转换和网络交换的损耗。实话说,这个量级的电力需求已经接近中小型城市的总用电量。
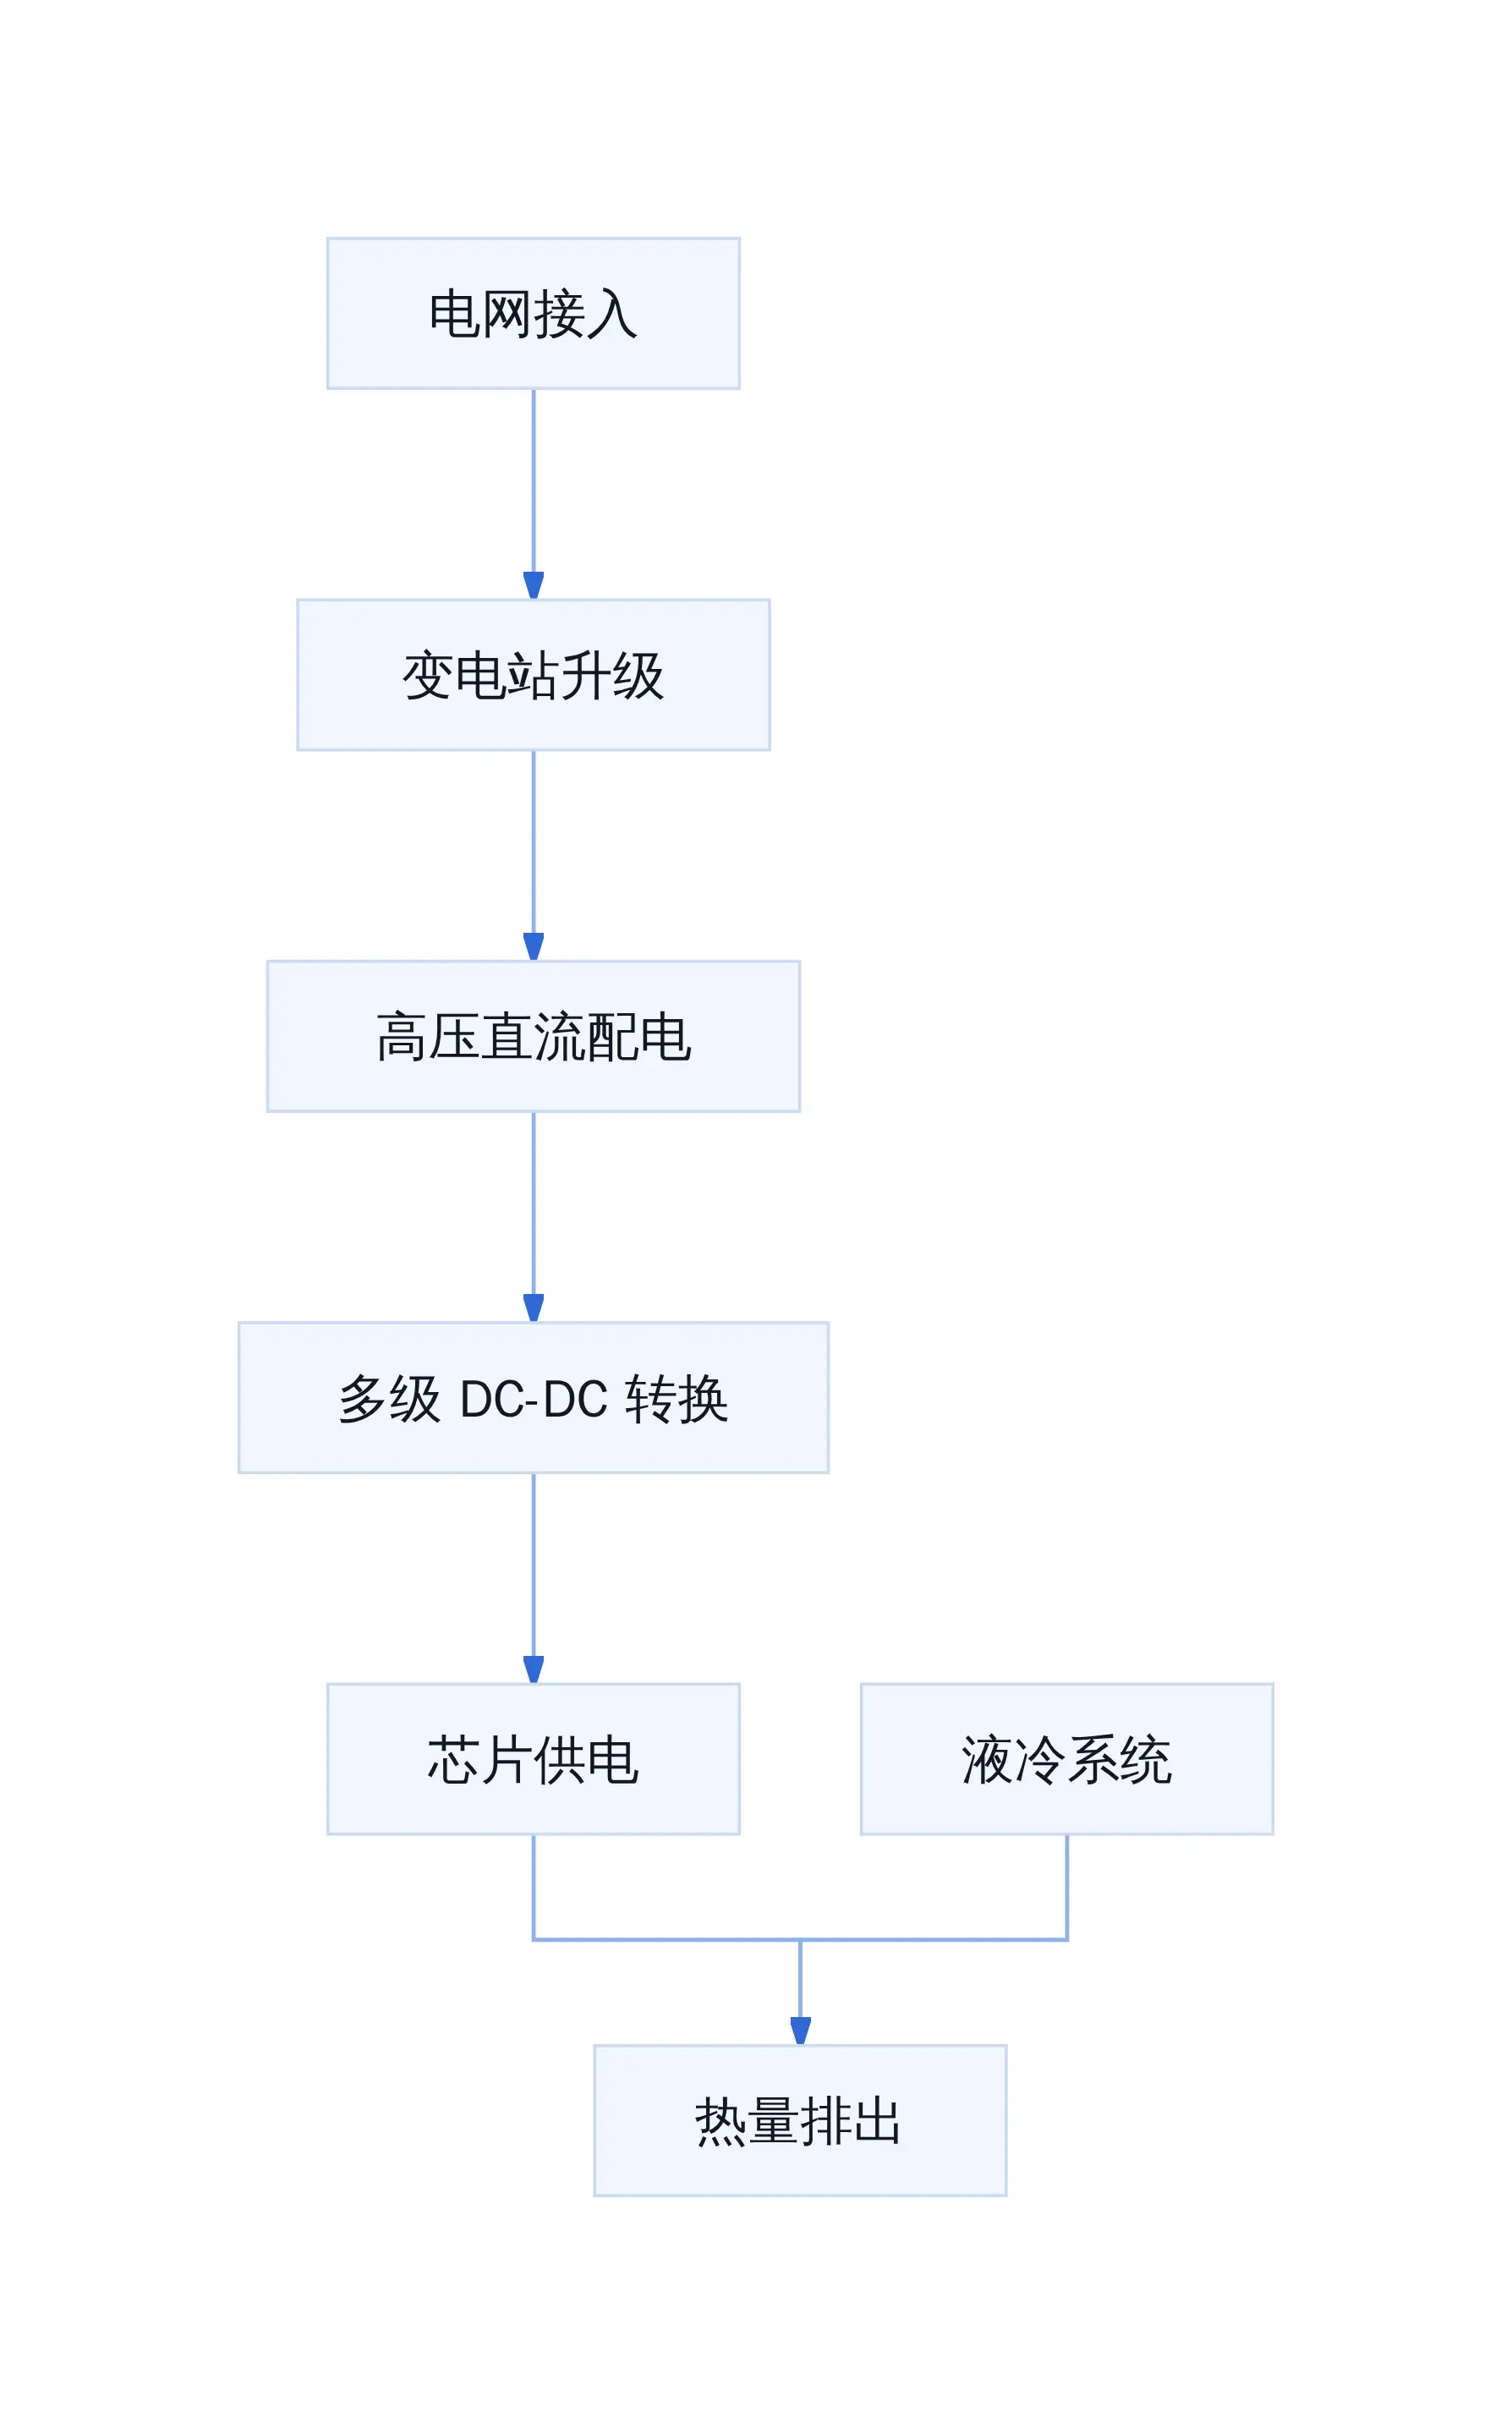
AI 数据中心电力链路
谷歌选择的路径是把电力问题前置。AITime 的报道明确指出,AI 园区的经济学越来越取决于电力能否按时交付,而不仅仅取决于园区能否被建成。一个能快速并网的项目,可能在竞争对手还没清理完工程障碍时就开始产生回报。芯片决定上限,电力决定下限------当算力规模跨过百万级门槛后,这句话从比喻变成工程现实。
高压直流(HVDC)架构是其中的关键技术分支。TPU v7 采用 +/-400V 高压直流方案,相比传统 -48V 或 220V AC 架构,传输损耗更小、转换级数更少。但高压直流对电源芯片、隔离设计、短路保护和电弧抑制提出了全新要求。国内已有企业布局液冷系统,但冷板接口、磁力泵等核心部件仍需突破。标准化程度不足也是规模化部署的隐形成本。
基建工期不等人
在 X 条件下,推荐优先解决电力获取而非芯片采购。具体来说:若项目选址位于电网容量充裕的区域,直接扩容即可;若位于电力紧张区域,需要评估自建发电厂或与能源公司签订长期购电协议的可行性。当条件变化为 Y------即项目规模突破 500MW 级------切换为 B 方案:考虑区位迁移,选择有富余核电、水电或风电资源的地区。这个判断的边界条件是,上述建议适用于超大规模训练集群,中小规模推理部署的电力约束完全不同。
可以今天就做的三件事:第一,盘点现有数据中心的剩余电力容量,区分可用容量与需扩容容量;第二,与属地电网公司建立沟通渠道,了解并网点位、扩容周期和政策门槛;第三,评估液冷方案的适配性,特别是冷板接口标准化程度和供应商交付能力。这三项工作并行推进,能在项目立项阶段就排除电力瓶颈这一高风险因素。
架构选型从来不是一步到位
Virgo 网络把单芯片带宽推到 400 Gbps,但百万芯片集群的扩展路径,从一开始就是一条多重约束下的最优解,而不是单一技术指标的线性外推。实话说,当芯片数量跨越 10 万量级,网络拓扑已经不是瓶颈,电力供给才是。
从网络架构到电力链路的工程取舍
TPU 8t 单芯片功耗约 1300W,百万芯片的理论峰值功耗超过 1.3 吉瓦。这还只是芯片本身的能耗。一套完整的数据中心电力链路包含多个环节:电网接入、变电站升级、高压直流配电(HVDC)、多级 DC-DC 转换、机架级配电,以及液冷系统的泵阀功耗。
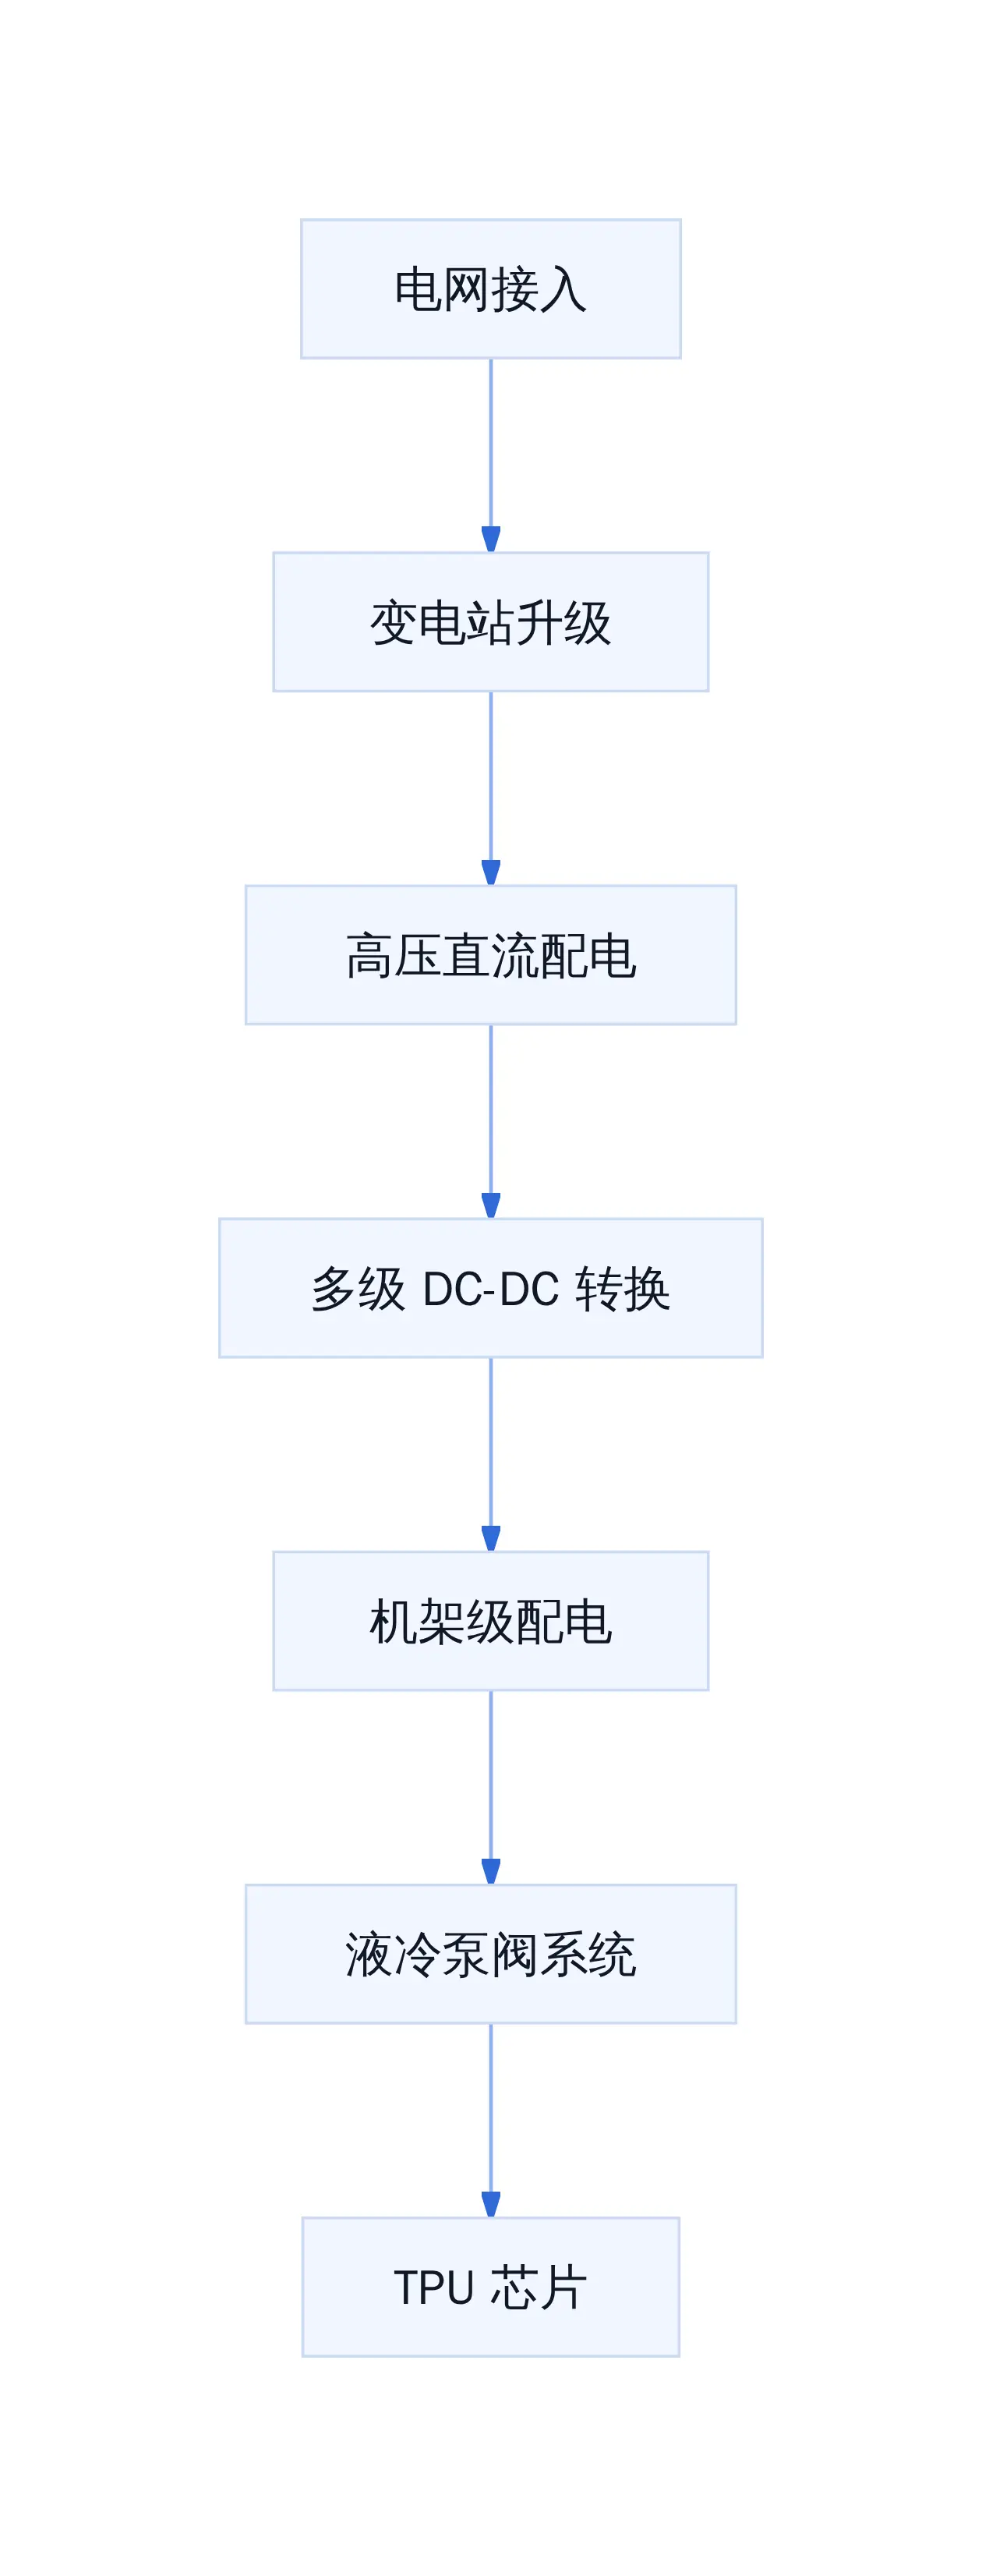
AI 数据中心电力链路
某头部云厂商 2026 年在德克萨斯州新建数据中心的复盘数据显示,传统 -48V 交流架构的端到端电效约为 85%,而采用 +/-400V 高压直流方案后,端到端电效能提升至 92% 左右。这 7 个百分点的差距,在百万芯片集群的尺度上意味着数百兆瓦的功率节省,直接转化为每年的巨额电费差异。
更关键的问题是,高压直流架构对电源芯片、隔离设计和安全防护提出了全新要求。芯片级的耐压、效率和集成度,机架级的短路保护与电弧抑制,这些都不是现有数据中心经验的直接平移。
架构选型从来不是一步到位
选址、能源与电网接入的现实约束
谷歌的 TPU 集群已经部署在爱荷华州、俄勒冈州和德克萨斯州等地,选址逻辑清晰:靠近可再生能源丰富的区域,同时避开人口密集区的电网拥堵地带。但这种选址策略的前提是,当地电网具备足够的扩容能力。
马斯克在 G20 峰会上的判断被行业广泛引用:到 2027 年 AI 芯片面临的电力缺口将达至少 15 吉瓦,而芯片产能年增 40%-50%,电力供应仅增 10%-20%。这不是一个可以被技术优化完全消化的结构性缺口。
实际落地中,有三种典型路径:
路径一:传统购电协议(PPA)+ 电网扩容。适用于已有成熟电网基础设施的区域,建设周期长但合规风险低。谷歌在部分项目上采用此路径,但电网扩容审批通常需要 2-3 年。
路径二:自建分布式能源 + 储能系统。适用于电网薄弱但可再生能源资源丰富的区域。Azure 在北卡罗来纳州的项目就是典型案例,配套 200MW 光伏电站和 100MWh 储能,实现部分离网运行。这种路径前期资本支出高,但长期运营成本低。
路径三:天然气调峰电站 + 绿电混合。在电网接入受限但天然气资源丰富的区域,配置燃气轮机作为调峰电源,白天用可再生能源,晚间切换至燃气发电。Meta 在得州的部分项目采用此模式。
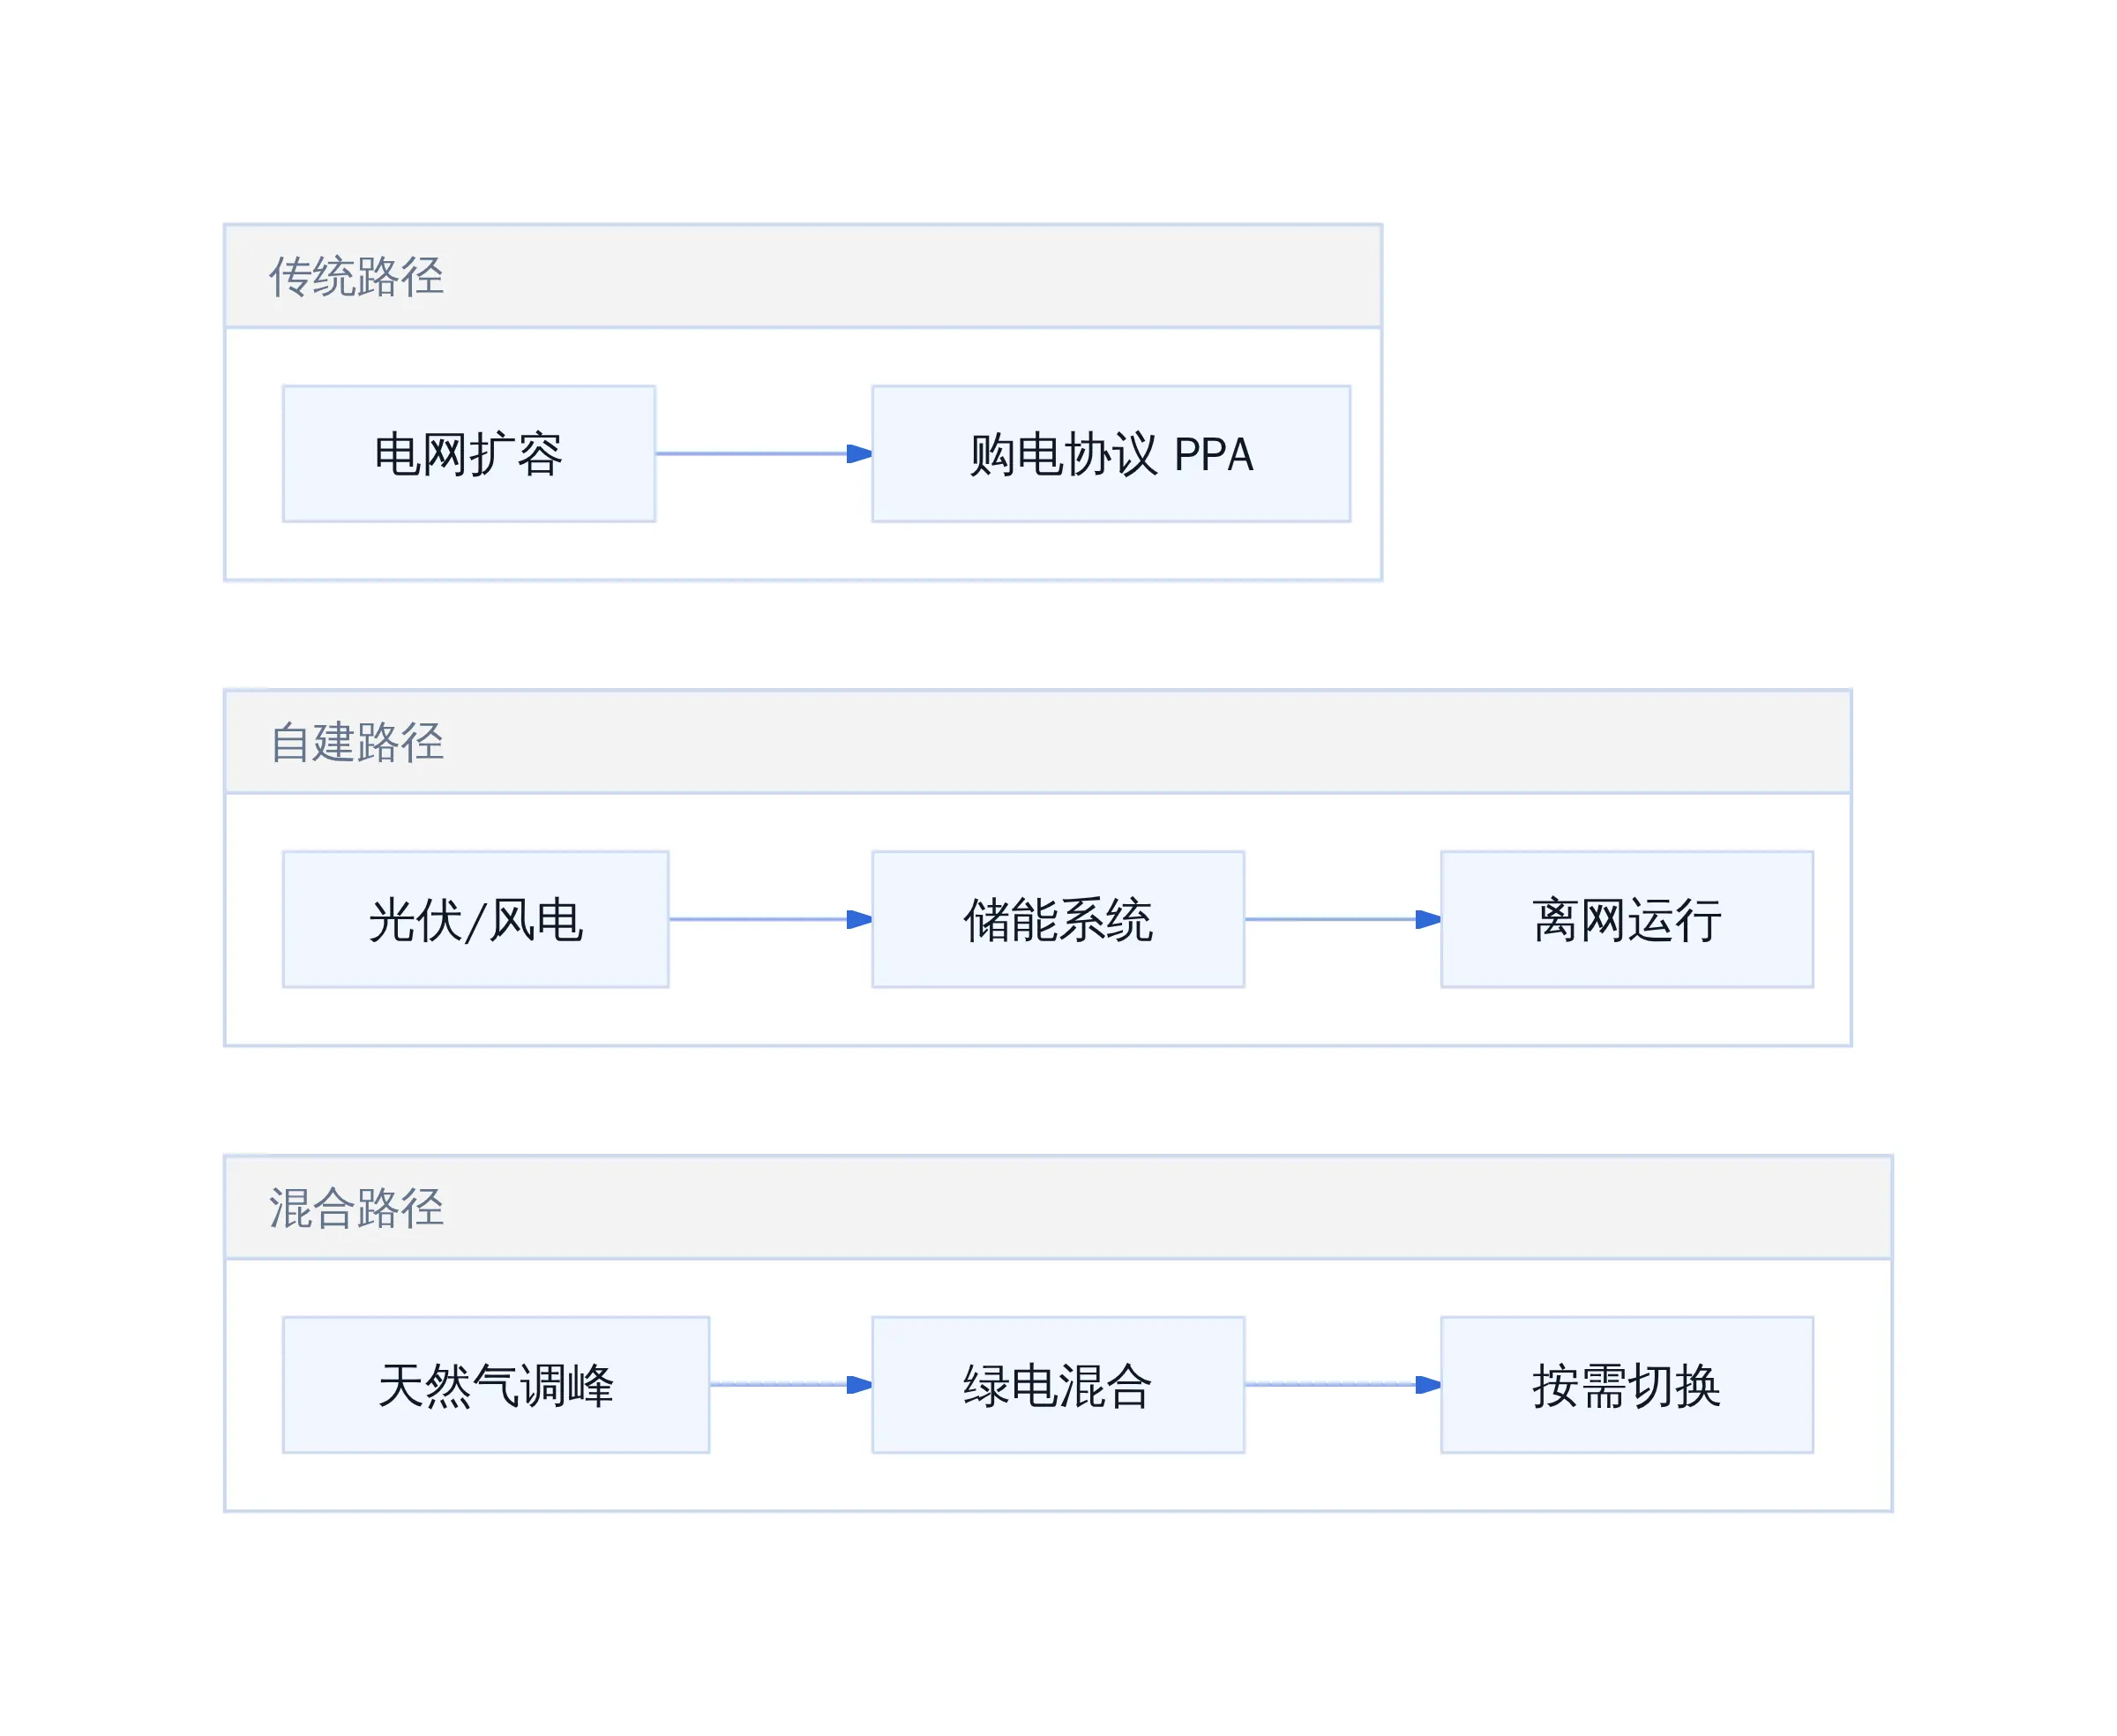
AI 数据中心电力路径对比
选址从来不是纯技术问题
落地路径:三种典型部署模式与选型决策
不同规模的团队面对的是完全不同的约束条件,选型逻辑也相应分化。
超大规模训练集群(10 万芯片以上):适用自建路径或混合路径。电力供给稳定性优先于短期成本,建议配置冗余电源架构和自动切换机制。JAX 与 Pathways 框架的分布式调度复杂度已经很高,如果再叠加电力波动导致的中断风险,训练效率损失难以量化。
中等规模推理集群(1000-10000 芯片):传统购电协议 + 电网扩容仍是主流选择。这类集群对电价敏感度更高,但对供电稳定性的容忍度也相对较高。可以接受短时断电后的任务重启,但不适合频繁调度中断。
小规模实验集群(<1000 芯片):直接租用云厂商 TPU 实例是最优路径。谷歌 Cloud 的 Ironwood TPU 实例已经对外开放,虽然单实例成本高于自建,但避免了电力、冷却、网络等基础设施的复杂投入。对于大多数团队,这个选择在当前阶段是明确的。
选型决策表可以简化为三个维度:
| 维度 | 自建设计 | 混合部署 | 云实例租用 |
|---|---|---|---|
| 前期资本支出 | 极高 | 高 | 低 |
| 运营控制力 | 强 | 中 | 弱 |
| 电力风险承担 | 全额承担 | 部分转移 | 转移给云厂商 |
| 适用场景 | 10 万芯片以上 | 1-10 万芯片 | <1 万芯片 |
每一层约束都在重塑架构选择
可执行的下一步建议
如果你是基础设施负责人,接下来的 90 天内可以完成三件事:
第一,评估当前或规划的算力规模是否触及电力约束边界。简单阈值:单集群峰值功耗超过 50MW 时,必须启动电力专项论证;超过 100MW,建议同步启动至少两种备选电源方案。
第二,梳理当地电网的扩容周期和审批流程。每个地区的电力公司响应速度差异巨大,提前 6-12 个月启动沟通,比事后补手续节省的时间远超预期。
第三,在 JAX 或 PyTorch 分布式框架层面引入电力感知的调度策略。谷歌的 Pathways 框架已经支持跨地理位置的逻辑集群调度,其他框架如 DeepSpeed、Megatron-LM 也在跟进类似能力。电力波动时的任务自动迁移和断点续训,是从「能用」到「可靠」的关键一步。
芯片决定上限,电力决定下限。当百万芯片成为可能,真正稀缺的资源已经从硅片转向了 electrons。
参考文献
1 谷歌TPU AI 基建规模迈入100 万级,核心瓶颈从"缺芯"转向"缺电". www.ithome.com/1/002/828.h... 2 算力权力的重构:谷歌TPU的崛起逻辑与中国AI芯片的突破瓶颈------一位AI系统专家的深度启示录_财富号_东方财富网. caifuhao.eastmoney.com/news/202603... 3 Google Cloud 宣布推出 Ironwood TPU 以及全新虛擬機器 Axion,為 AI 推論時代注入動能. blog.google/intl/zh-tw/... 4 张量处理单元(TPU). cloud.google.com/tpu?hl=zh-C... 5 AI芯片"分工"时刻!谷歌第八代TPU,为什么是两款?. wallstreetcn.com/articles/37... 6 TPU架构:Google七代产品完整指南| Introl Blog. introl.com/zh/blog/goo... 7 智能体时代的架构设计:Google Cloud TPU 7x、TPU 8t 和 TPU 8i 的详尽比较分析 | Google Codelabs. codelabs.developers.google.com/gemini-inte... 8 电从哪里来?美国AI产业如何解决这个最大瓶颈?|界面新闻 · JMedia. www.jiemian.com/article/136...