你手上有三段素材:一段口播、一段环境声、一段背景音乐。你想"把它们合并成一个文件",于是丢进工具,点合并,导出。结果出来的不是你要的------本该同时响的背景音乐排到了口播后面,或者本该一段接一段的三段访谈全叠成了一锅粥。参数反复检查没错;换个工具,还是错。
底层原理:一个改的是时间轴,一个改的是幅度
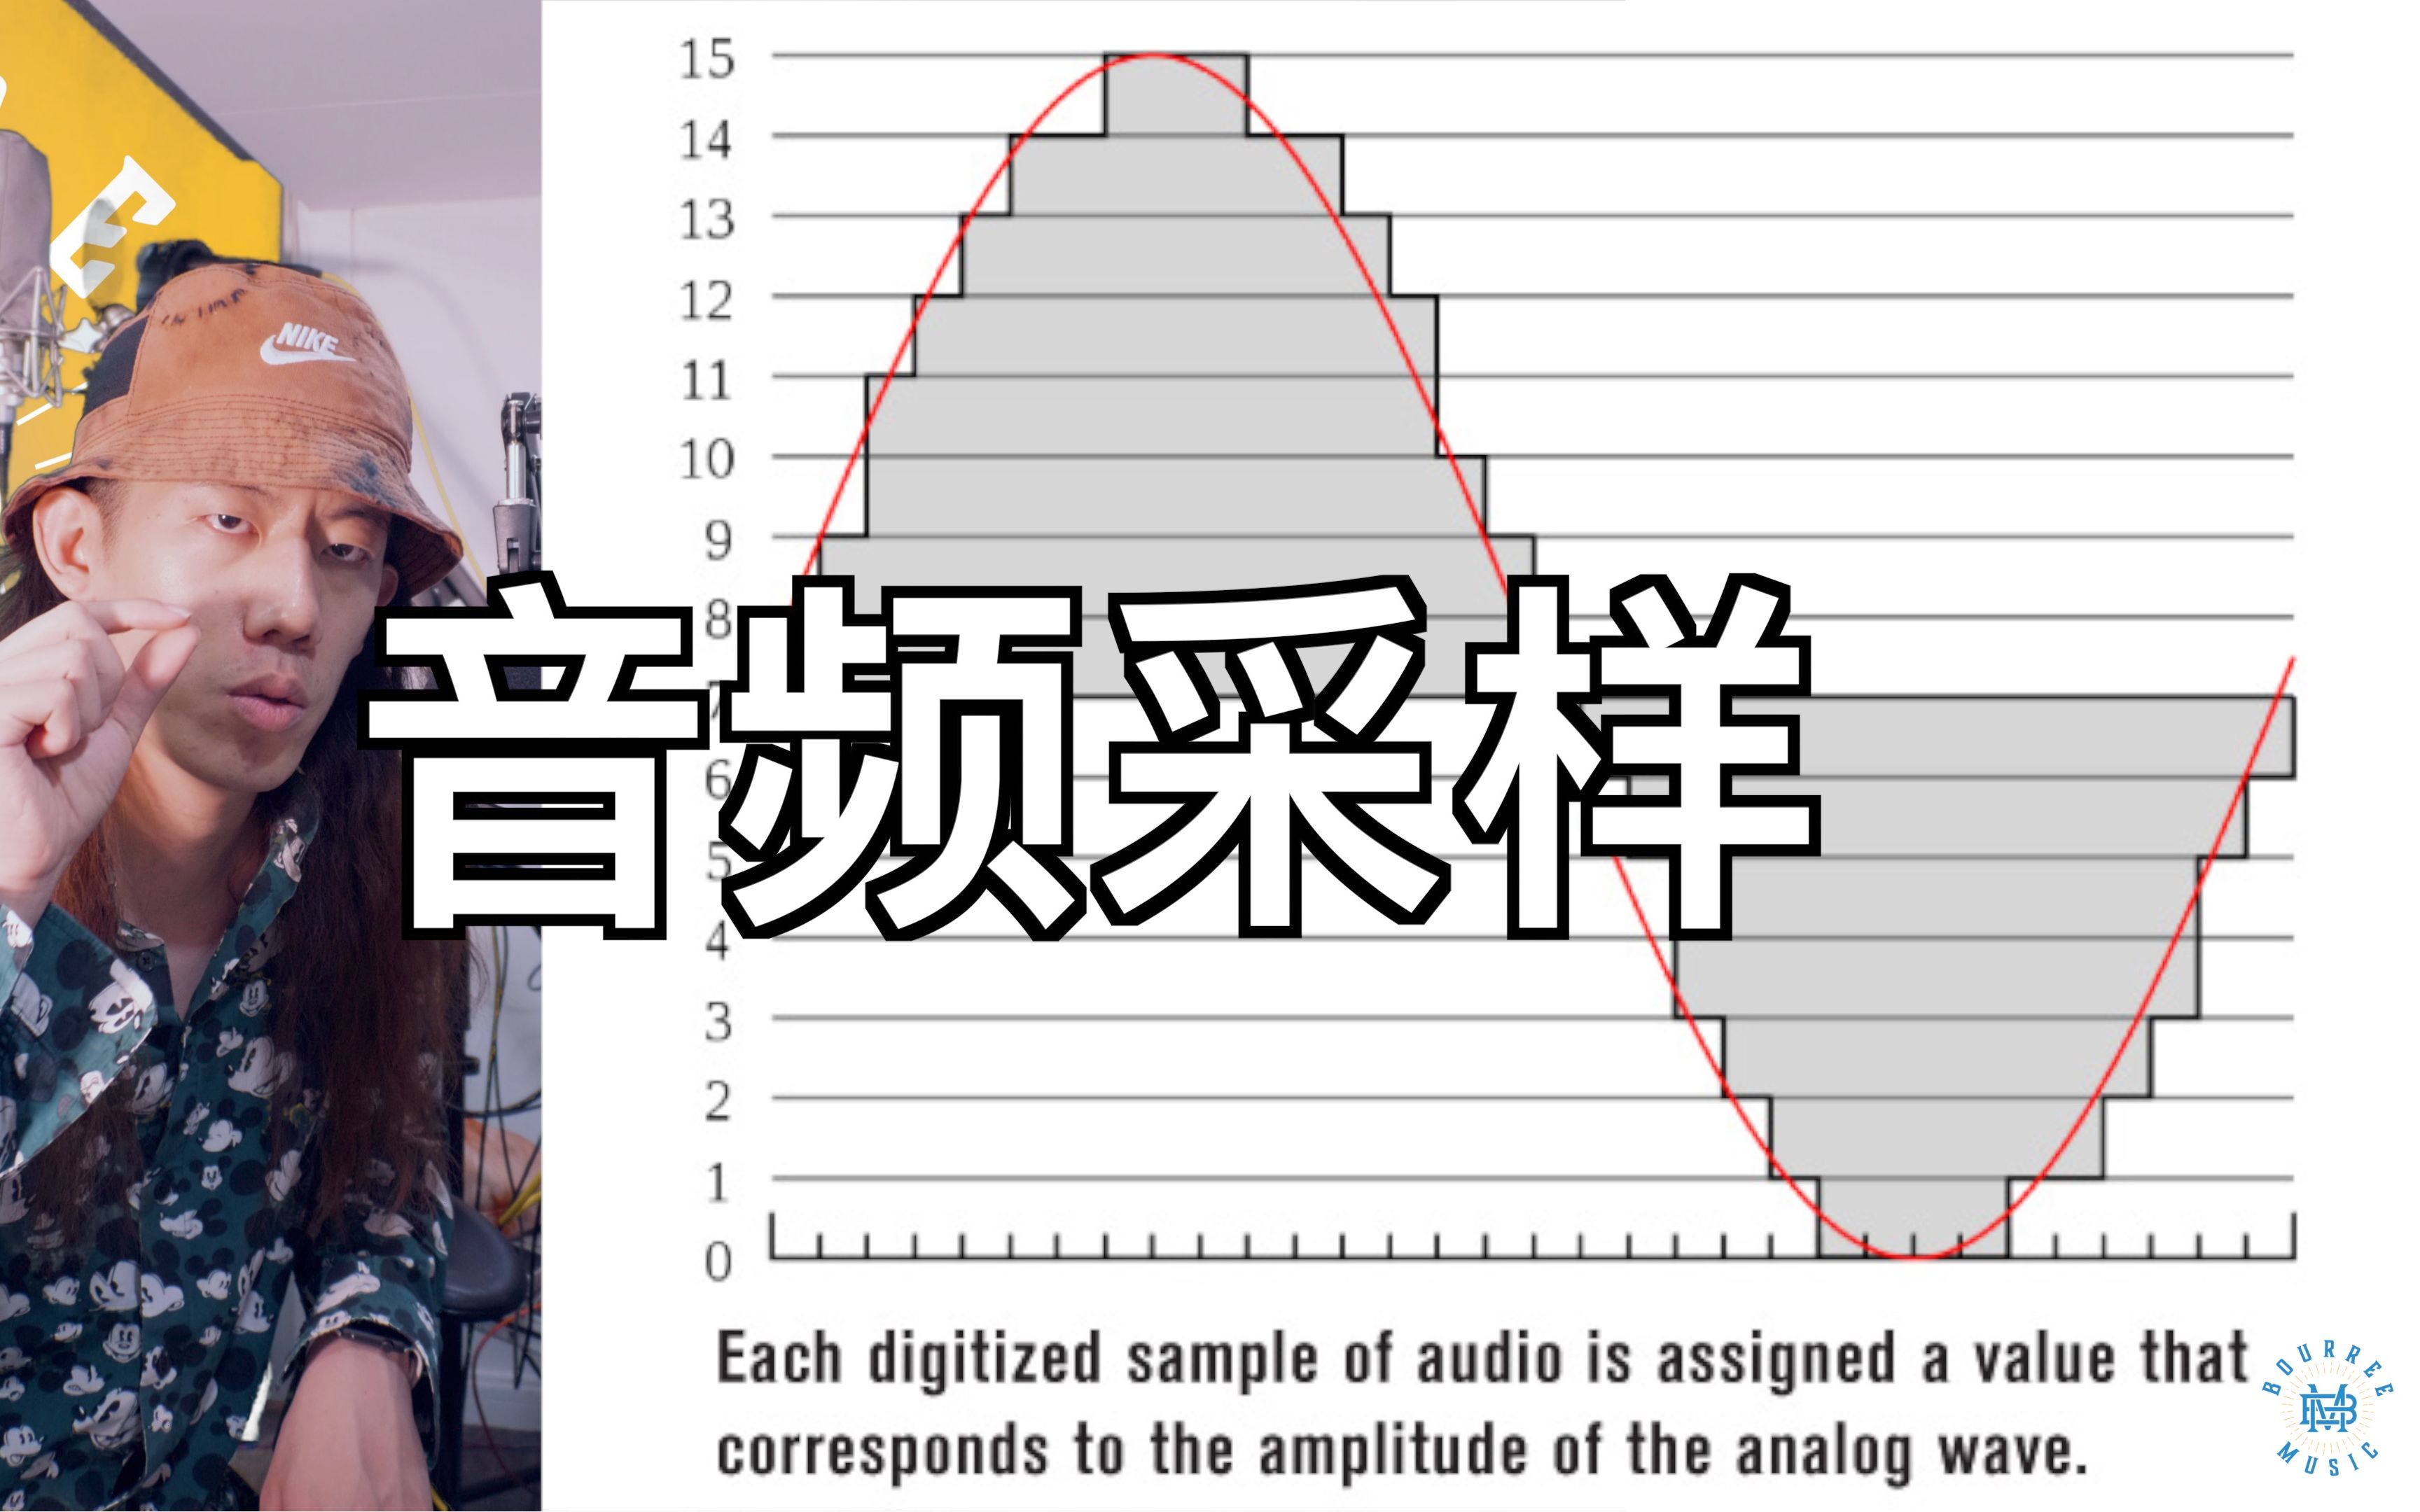
把音频还原成 PCM 采样序列看,两种操作的数学形式差别一目了然。
串联 是序列首尾相接。A 有 M 个采样点,B 有 N 个,结果是长度 M+N 的新序列。它不改采样点的幅度 ,只改序列的长度,所以天然不会削波。风险全在接缝那一个点:两端采样点幅度差很大时,波形出现台阶式跳变,宽频瞬态能量被激发,听上去就是一声"咔哒"。
叠加 是序列逐点相加。结果长度取 max(M, N),每个位置的值是 Ai + Bi。它不改总长度,改的是每个采样点的幅度。两路同相成分幅度直接相加,超过定点格式满刻度 0dBFS 就被截断成方波,这就是失真。风险分布在整条时间轴上。
写成一行就是:串联动时间轴,叠加动幅度。两种操作对应的翻车方式完全不同,排查方向也完全不同------串联出问题查接缝,叠加出问题查电平。
还有一层区别常被忽略:叠加要求两路信号采样率、声道数完全一致才能逐点相加;串联在有些工具里只需编码格式一致就能流拷贝,不必解码。叠加对素材规格的要求严格得多。
判断一:看你要的总时长是"相加"还是"取最大"
这是最快也最不易误判的一条判据。问自己一句:合并完的文件应该多长?
• 三段各 2 分钟的访谈拼成一集,答案是 6 分钟 → 要串联
• 一段 2 分钟口播配一首 3 分钟音乐,答案是 3 分钟 → 要叠加
时长是"加起来"还是"取最长的那个",这一句就把两种语义分开了。操作前先写下预期时长,导出后核对实际时长,对不上就是选错了模式。
判断二:看内容在时间上是"排队"还是"共存"
时长判据在两段素材恰好一样长时会失灵,这时候看内容的时间关系。
排队关系:这一段说完下一段说,任意时刻只有一个"主体"。多段访谈、有声书分章、录播课的多节内容 → 串联。
共存关系:两路内容本来就该同时被听到。人声配 BGM、口播加环境音、多轨乐器合成一首歌 → 叠加。
有一类混合场景:多段口播底下要铺一条贯穿全场的背景音乐。这不是二选一,是先串联再叠加:先把口播串成一条完整人声轨,再与音乐轨叠加。顺序反了,接缝处的音乐会断裂重启,一听就出戏。
处理顺序的原则:先做改时间轴的操作,再做改幅度的操作。 时间轴一旦定下来,幅度调整才有稳定的参照。
判断三:看你怕的是"接缝"还是"爆音"
这条判据反过来用:从已遇到的问题倒推自己走的是哪条路径。
如果导出后在两段交界处听到"咔哒"这类极短爆响,走的是串联路径,问题在接缝。对策是在接缝处做 5~20ms 交叉淡化,让 A 的尾巴淡出、B 的头部淡入,把波形跳变抹成斜坡。还要顺手确认直流偏移------波形整体偏离零线的素材,接缝跳变比正常素材大得多。
如果导出后整体听着发糊,响的地方破音、安静的地方底噪浮起,走的是叠加路径,问题在电平。对策是给叠加留余量:每路先压到 -12~-6dBFS,叠加后总线峰值控制在 -6dBFS 附近,导出前看真峰值而不是采样点峰值。
判断四:看素材规格是否需要提前统一
第四条判断决定你要不要在合并之前多做一道工序。
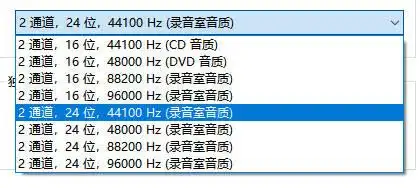
叠加必须逐采样点对齐,采样率、声道数、位深三项都要先统一。48kHz 口播和 44.1kHz 音乐直接叠,工具必然偷偷重采样其中一路,质量档位低则高频发闷(低阶插值对奈奇斯特频率附近的成分滤不干净,会留下频谱镜像),转换比例不精确时时长还会微小漂移,越往后偏得越多。
串联的规格要求宽松些但也不是没有:采样率不一致的两段串在一起,播放器按第一段采样率解读后面那段就会变速变调;声道数不一致在有些容器里直接解析失败。
两种语义都建议合并前把素材规格统一到同一套参数,48kHz / 立体声 / 16bit 是最稳的一档。
落到操作:一条不返工的顺序
四条判断落成固定动作,顺序是这样。
第一步,写下预期总时长,据此定语义:相加就是串联,取最长就是叠加。
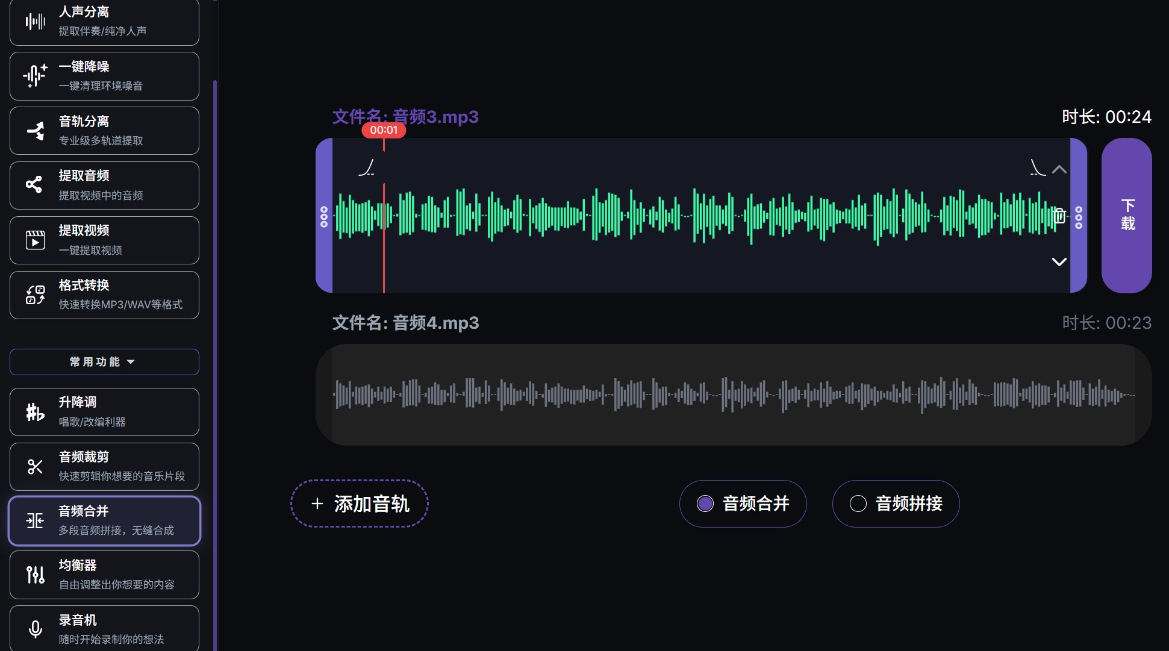
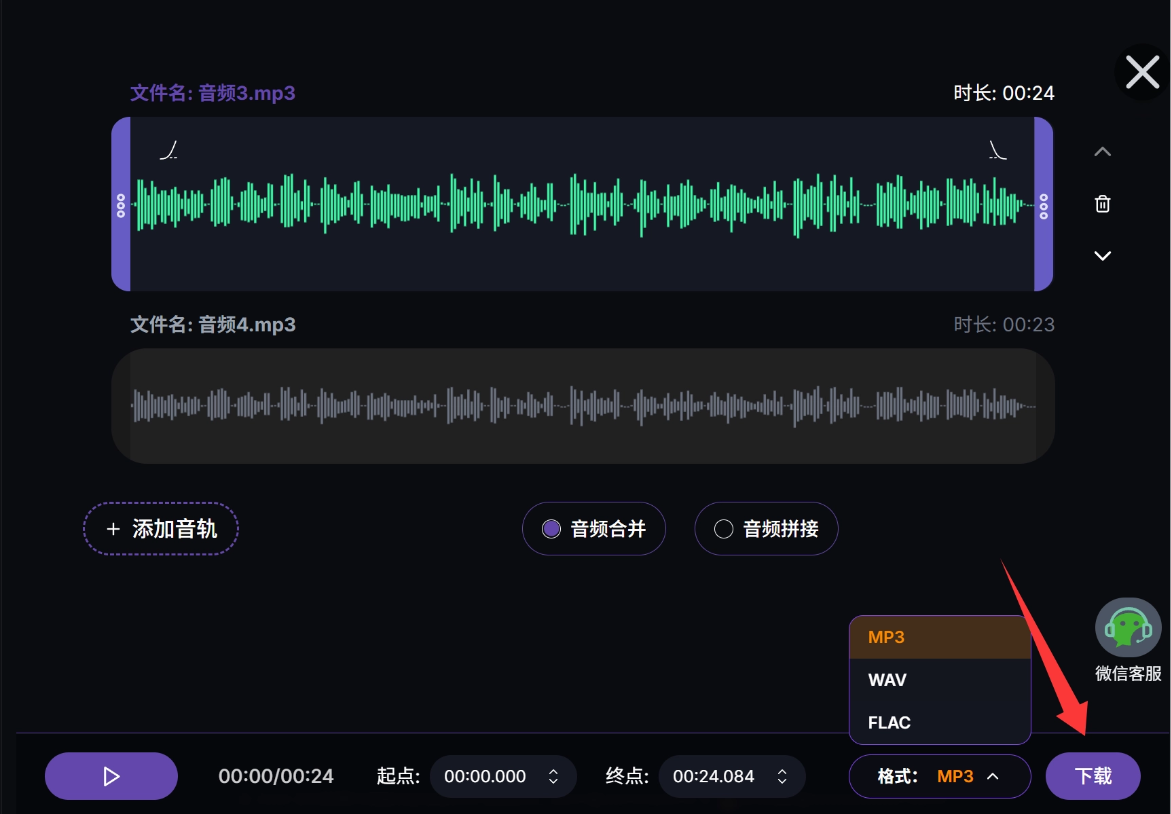
第二步,统一素材规格。检查每段的采样率、声道数、位深,不一致的先转到同一档。用免费音频拼接,处理的是你上传的本地音频文件,不支持粘贴链接让它在线抓取解析。
第三步,按语义执行。串联时导入顺序就是播放顺序,导出后先核对总时长,再逐个接缝听一遍;叠加时先把每路压到 -12~-6dBFS,再叠,最后看总线峰值。
第四步,验收只看三个数:总时长、峰值、接缝。三项都过才算完。
最后
"合并"这个词太笼统,把两件数学形式完全不同的操作包在了一个按钮里。绝大多数合并事故的根源不是参数调错,而是一开始就没分清自己要的是串联还是叠加。
先想清楚要"接在后面"还是"叠在一起",再动手------这一句省下来的时间,比学会任何一组参数都多。