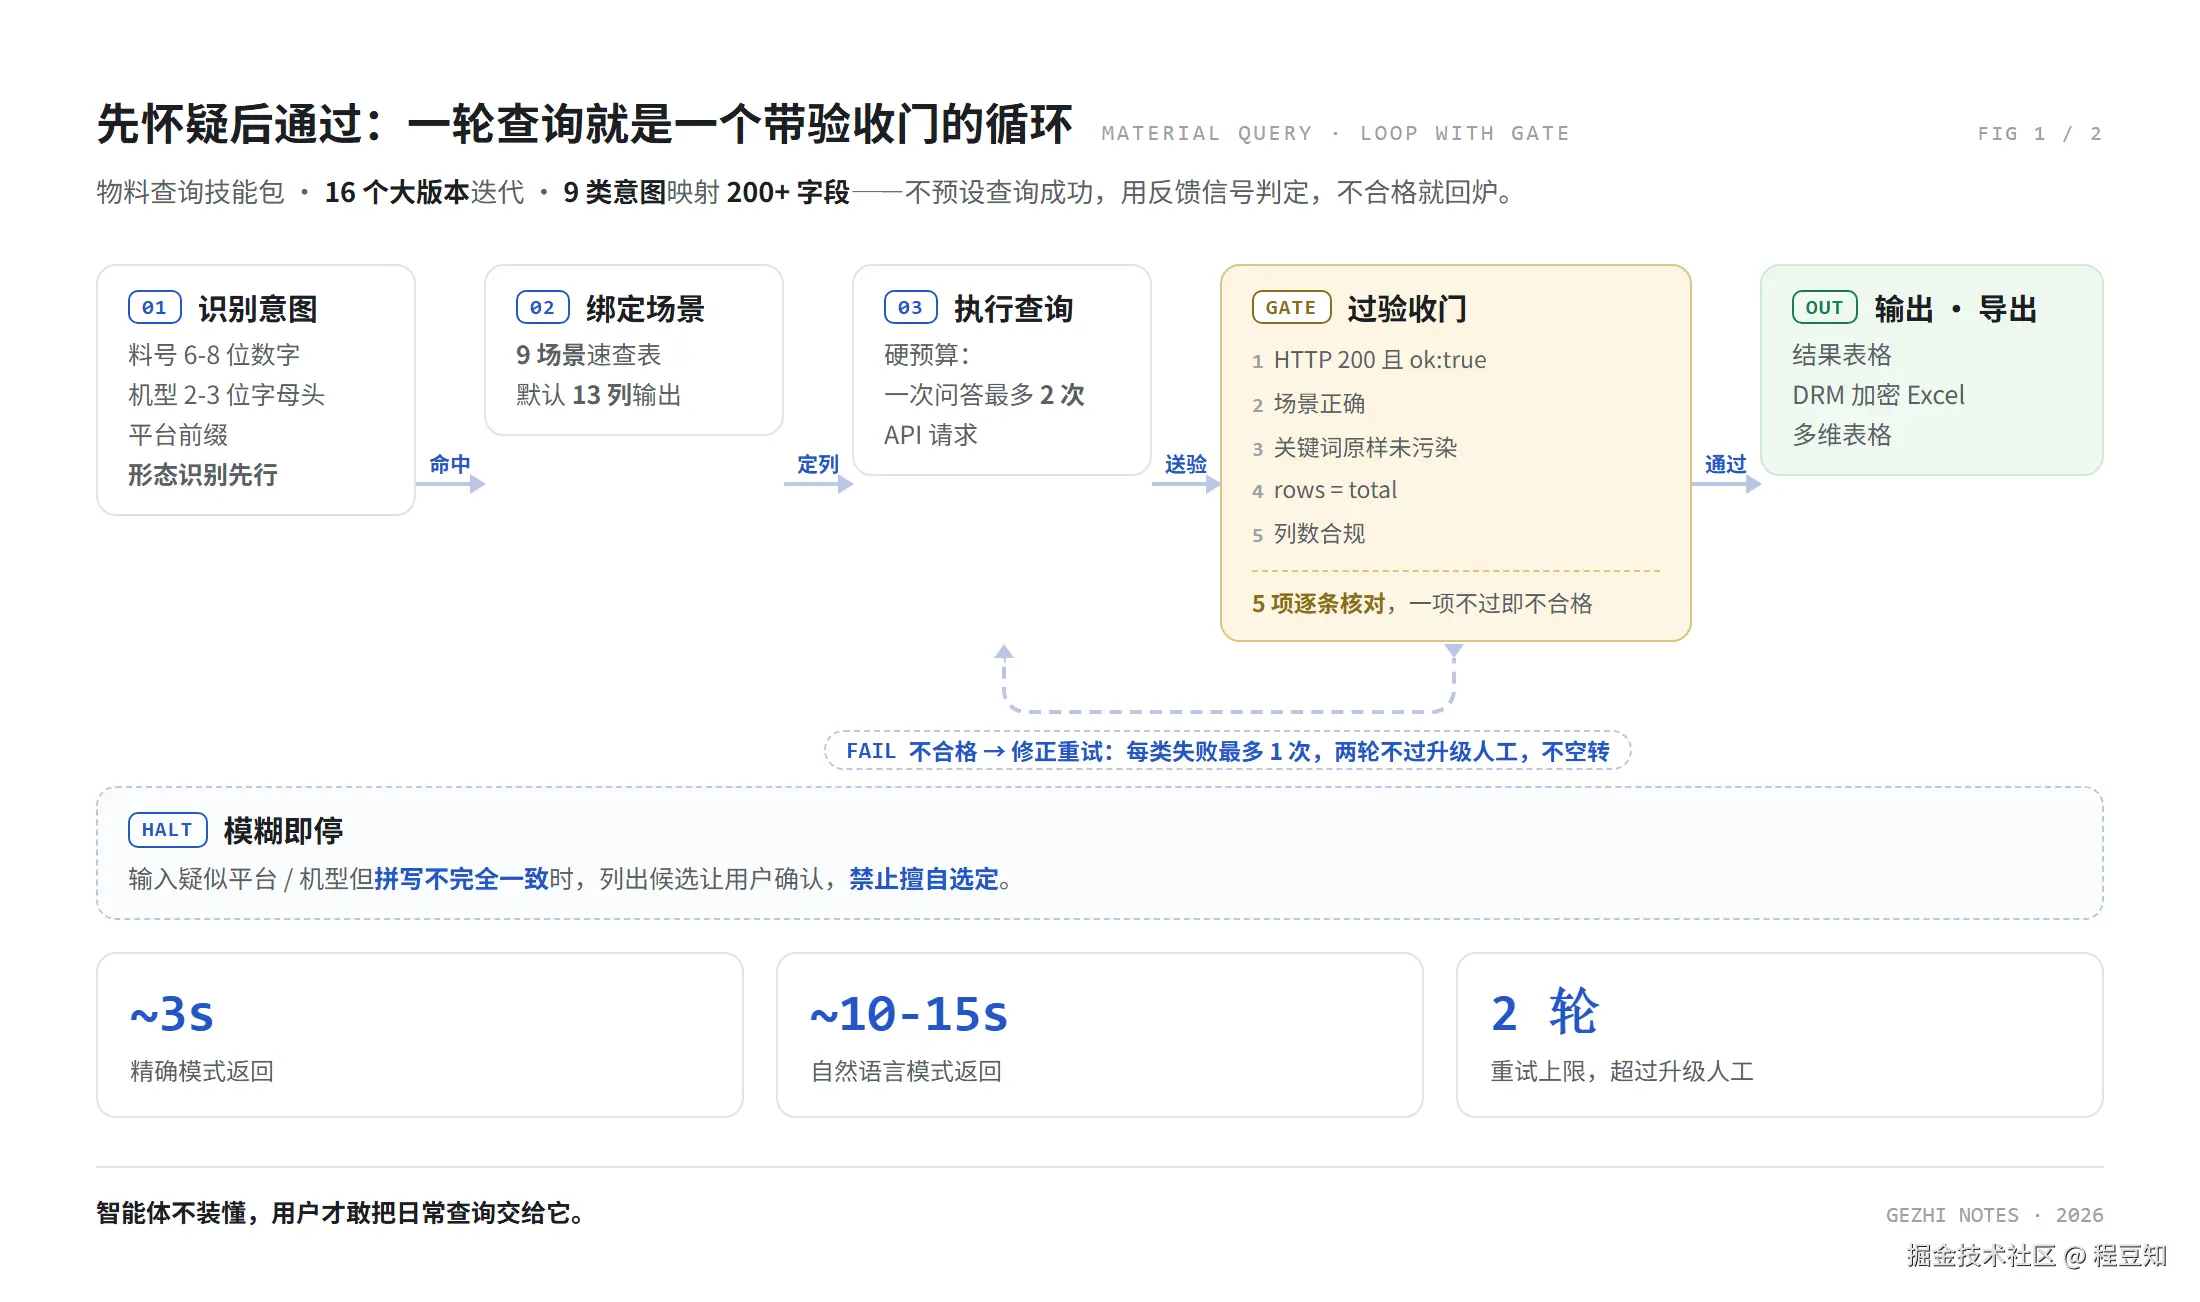
图 · 查询循环五要素:先怀疑后通过,验收门不合格就回炉,模糊即停列候选
结论先行:查询类智能体赢信任,靠「先怀疑后通过」
这篇复盘我用得最久的一个 AI 技能包:物料信息查询。它跑在一家大型制造企业的品类管理日常里,迭代到第 16 个大版本,解决的事很朴素------查物料不用再记 N 种查询姿势,不用再提 IT 取数工单等半天。
查询类智能体最容易死于「一本正经地胡说」:查空了编几行补上,查错了不核对直接输出。所以这个包的说明文件第 0 节就立了总纲,原话是:
每一轮都是「先怀疑后通过」------不预设查询会成功,用反馈信号判定,不合格就修正或升级,禁止在无信号支撑时输出结论。
这篇文章里所有的工程手段,都是为了把这句话变成可执行的机制。
定位与场景:九类意图,一张速查表
使用方是品类、研发、采购三类同事。说明文件在描述栏一次性枚举了 9 类触发意图:引用关系(这个料用在哪)、机型物料(这个机型用了哪些料)、全量分类、采购状态、关键词查询、规格属性、重复 BOM、图纸下载、降成本措施,并配了一张触发关键词表------「查料号」「查细类」「降成本措施」这类口语说法都能命中。
版本日志就是需求史:v16 新增机型反查,v16.1 修复导出对齐。16 个大版本,没有一条是规划出来的,全是被真实提问磨出来的。
这套意图路由落到系统里,就是一个检索工作台。下图即检索工作台的示意重绘:左栏为全部场景入口,右侧是提问输入区------输出字段可折叠展开,一键执行,模型在幕后做的「先怀疑后通过」,用户看到的就是这一屏。
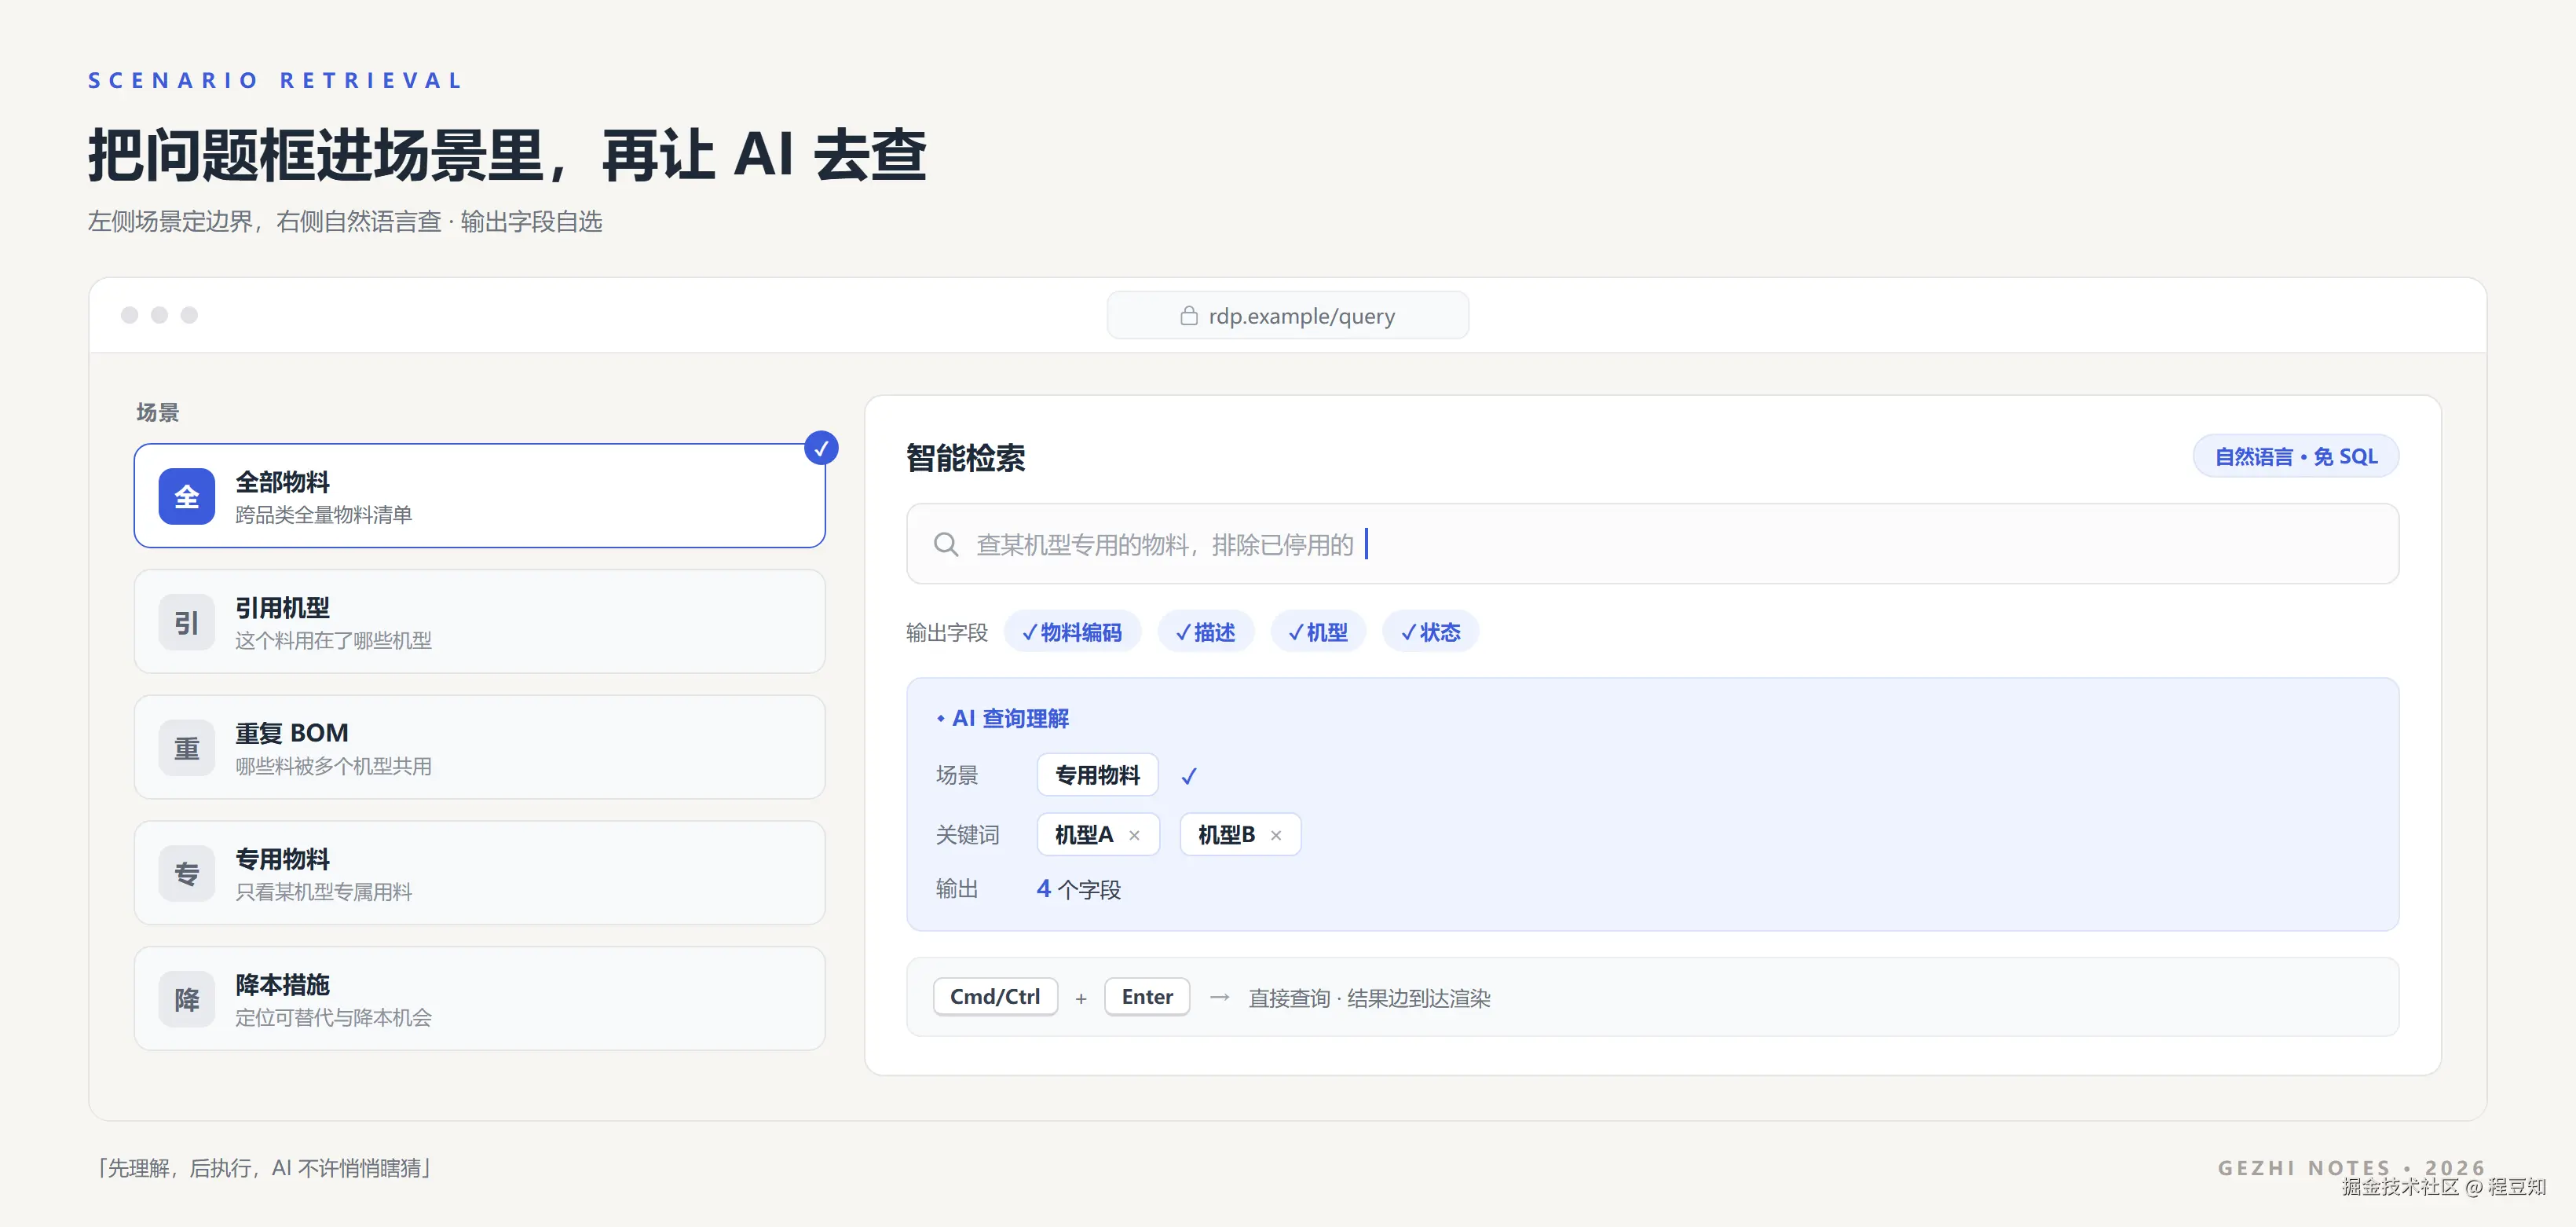
图 · 检索工作台:左栏为全部查询场景入口,右侧输入区支持输出字段折叠与一键执行(示意重绘)
完整流程:把一次问答设计成一个循环
整个包的核心不是某个脚本,而是一个循环的定义。说明文件第 0 节用一张五要素表把它写死:
| 要素 | 这个包里的定义 |
|---|---|
| 程序 | 识别意图 → 绑定场景 → 执行查询 → 过验收门 → 输出/导出 |
| 产物 | 结果表格,或加密 Excel / 多维表格导出 |
| 反馈信号 | HTTP 状态码 + rows/total/truncated/elapsed_ms + 验收门 |
| 运行账本 | STATE.md,每次问答追加一行 |
| 终止条件 | 验收门通过即终止;失败重试上限 2 轮,升级人工,不空转 |
意图路由靠关键词形态:料号是 6-8 位数字或数字字母混合,机型是 2-3 位数字加字母开头,平台编码有固定前缀,二级产品线只有 16 个枚举词。模型先做「形态识别」,再做查询,而不是上来就让大模型自由理解。
场景表承载字段映射:9 个场景合计映射 200+ 个字段。字段最多的场景单表 72 个字段、默认只输出 13 个;采购库场景 27 个字段里包含需求数量、当月采购量、滚动 12 个月采购量、在产 BOM 数量------采购同事一张表看完,不用再跨系统拼数。
模式选择有硬规则:能识别出场景一律走精确模式(约 3 秒返回),识别不了才交给自然语言解析(约 10-15 秒)。规范里写死一句「自然语言模式与场景参数混用会 400」,从源头杜绝参数打架。
预算是硬的:一次问答最多 2 次 API 请求。这是给模型上的紧箍咒------它天生喜欢「多试几次」,预算逼它先想清楚再出手,而不是连环试探。
模糊即停。原文:
用户输入疑似平台/机型但拼写不完全一致时,列出候选让用户确认后才能继续,禁止擅自选定。
宁可多一轮对话,不替用户做一次猜测------这是查询类智能体信任的底线。
提示词工程与防错设计:验收门是最后一道闸
验收门 5 项检查表,每次响应逐项核对:
- HTTP 200 且业务返回 ok:true;
- 场景绑定正确;
- 关键词未被污染------查询词必须从用户消息原样复制,一字不差,防转义、空格、全半角漂移;
- 结果完整性------rows 与 total 对得上,截断标记没有被忽略;
- 输出符合专属规范------该场景要求 13 列就是 13 列,缺一不可。
语义对照表防混淆。说明文件里专门有一节区分「机型物料查询」(该机型用了全部哪些物料,超集)与「专用物料查询」(哪些物料只被这个机型使用,子集)------一字之差,结果完全不同,判定规则的最后一句是「拿不准时问一句」。
输出规范带业务翻译。重复 BOM 场景配了「字段名到用户语言」的映射表,「下层部件重复说明」有值时必须主动提示:备件可直接通过升级软件进行替换------把数据库字段翻译成业务动作。降成本场景规定 13 列逐条输出不截断,措施状态做枚举映射(Create=创建、Verify=技术审核、Implement=导入论证),并明文禁止输出 JSON 原文、只给摘要不给明细、截断、省略列、省略链接。
错误处理写成对照表:
| 情况 | 处置 |
|---|---|
| 429 限速(20 次请求/分钟/IP) | 按返回的等待秒数等待后重试 |
| 自然语言模式 400 | 换个说法重试一次,仍失败就列出 9 场景让用户选,不重试第三次 |
| 自然语言模式 503 | 直接改精确模式 |
| 结果截断 | total 是真实总数;要全量走导出,禁止反复分页查询 |
重试纪律一句话:每类失败最多修正重试 1 次,两轮失败升级人工。
图纸下载三重防错。图纸走两段式:先用 SQL 从全量物料表查三类编码与描述,再调飞书集成流回调接口取下载链接。链路上加了三道锁:
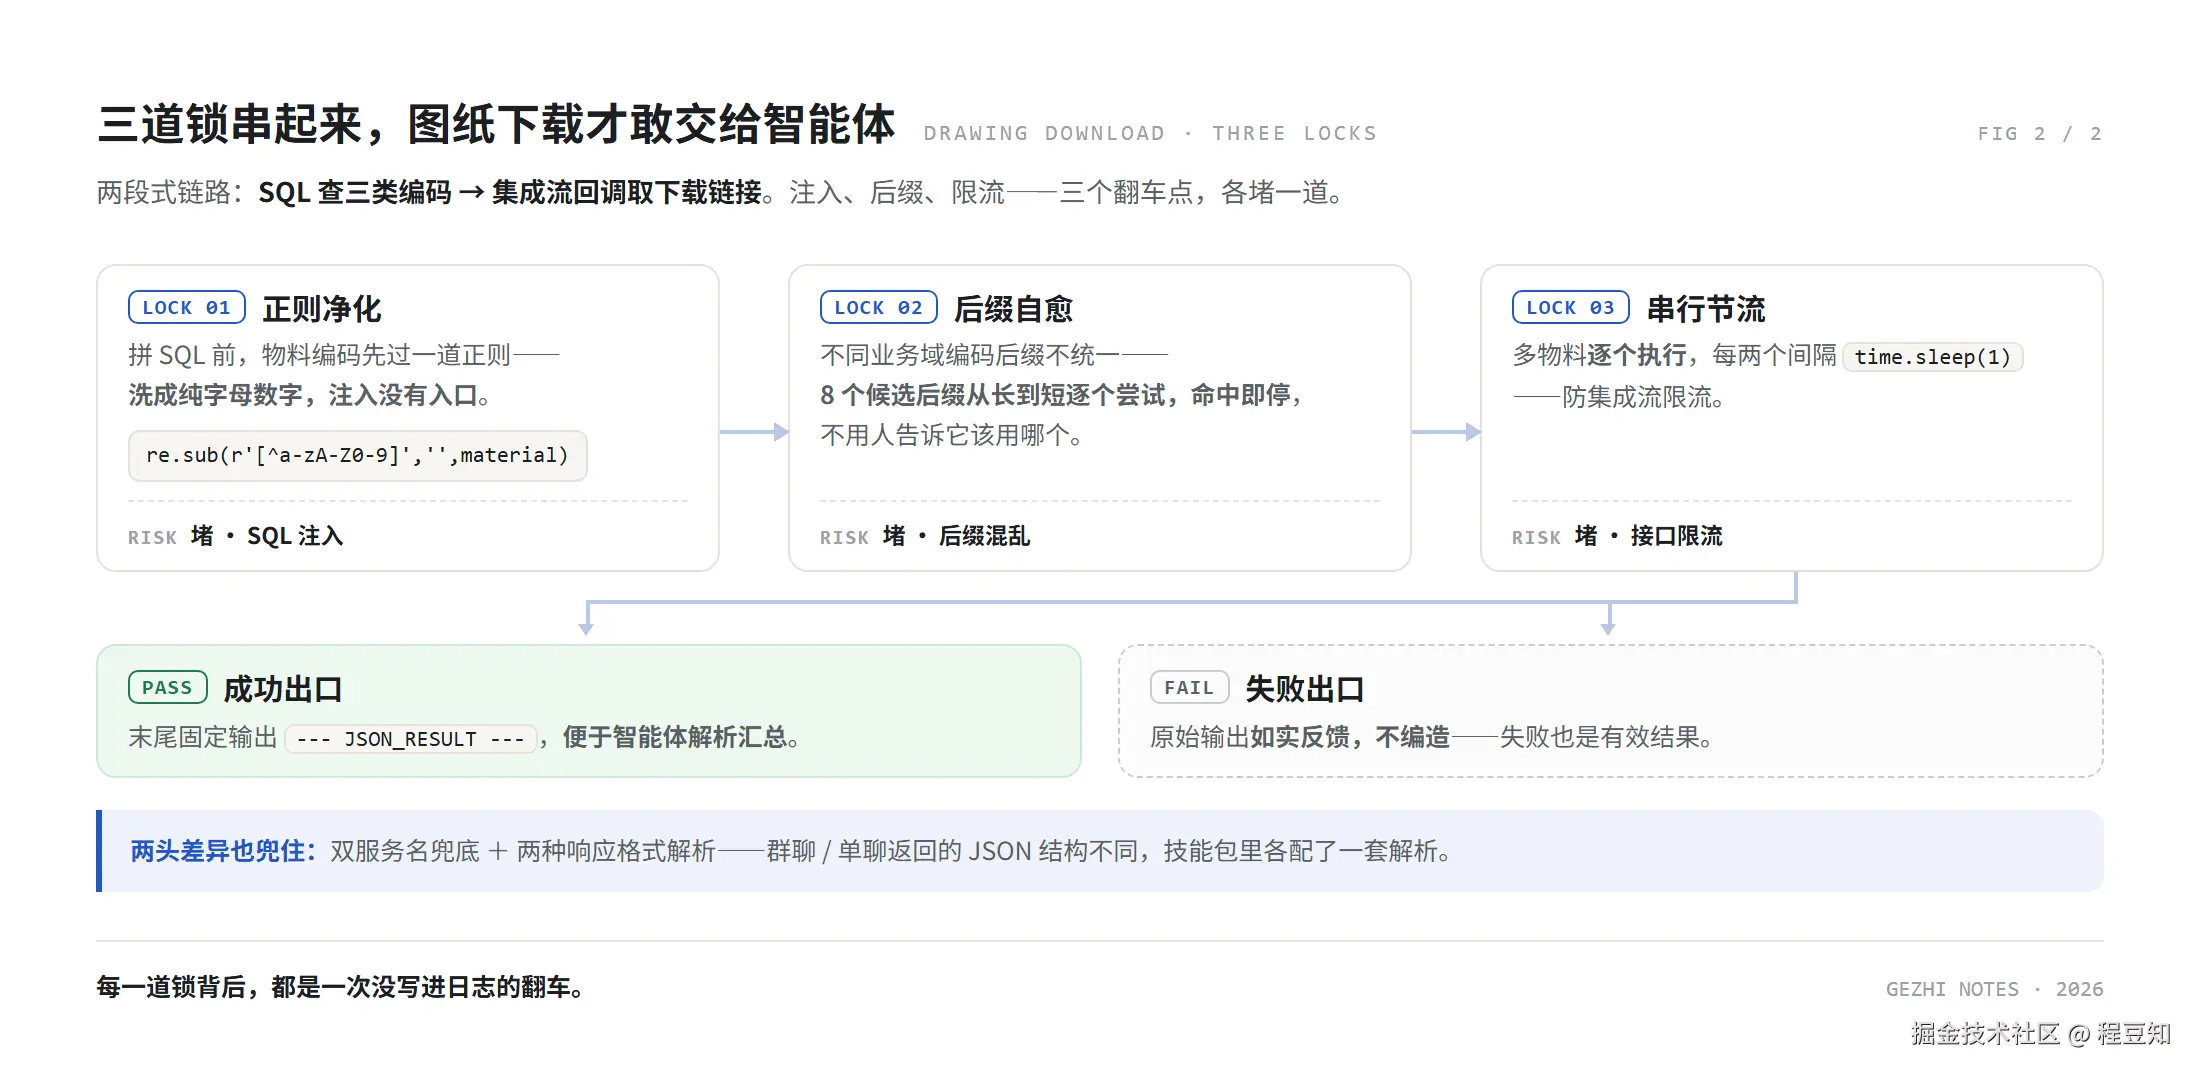
图 · 图纸下载三重防错:正则净化 → 后缀自愈 → 串行限流,失败如实反馈
- 第一重,正则净化 :拼 SQL 前用
re.sub(r'[^a-zA-Z0-9]','',material)把物料编码洗成纯字母数字,注入没有入口; - 第二重,后缀自愈:不同业务域的编码后缀不统一,脚本把 8 个候选后缀从长到短逐个尝试,命中即停,不用人告诉它该用哪个;
- 第三重,串行节流 :多物料逐个执行、每两个间隔
time.sleep(1)防集成流限流;另配双服务名兜底、两种响应格式解析(群聊和单聊返回的 JSON 结构不同),末尾固定输出--- JSON_RESULT ---便于智能体解析汇总。
降成本两阶段查询 。措施表里没有平台字段,硬查查不了,于是拆两步:第一阶段先查平台关联了哪些物料号,第二阶段每批 200 个做 IN 查询,最后按「措施编号 + 变更前后料号」去重。顺带记了一个全角括号的坑:SELECT "单机降额(元)" 这种带全角括号的列名必须双引号包裹------写进 SQL 指南一次,就不再踩第二次。
查询逻辑文档化是这个包的一个隐藏选择:它没有专门的查询脚本,复杂查询的执行逻辑由一份 SQL 指南文档承载------字段字典、示例 SQL、字段别名映射表(「料号、物料号、物料」都指向同一个编码字段)、输入值格式识别表。文档即程序:改口径只需改文档,不用发版。
规模数字可以感受一下:单机型查询 647 行;单平台一次查询 22754 行、触发截断、单次只回 2000 行;导出上限 10 万行;缓存每日 8:30 重建保新鲜。规格属性走二级路由------先从品类属性信息表按细类拿到多维表格 ID 与数据表 ID,再查明细表,每个细类一张独立明细表,元数据驱动。
价值与账本:用数据把智能体养出来
运行账本 STATE.md 是这个包能持续变好的原因。每次问答结束追加一行 JSON:模式、场景、关键词类型、返回行数、结局、重试次数、耗时。按周复盘高频场景、空结果率、重试率,反哺字段白名单的调优。智能体不是上线即结束,是用数据养出来的。
导出与写表各有管线:异步拿 key、轮询下载、DRM 加密 Excel(5 分钟自动清理、10 万行上限、超限直接拒绝);写多维表格则以用户身份创建写入,表格归用户所有,100 行一批。收尾还有一份 7 条严禁清单,包括「循环试探全部场景」「导出文件放公网位置」------每条背后都有一次没写进日志的翻车。
可以带走的方法:给智能体立一道验收门
这套设计的核心只有一句:不预设查询会成功,用反馈信号判定,没有信号支撑就不输出结论。复刻它不需要复杂框架,三件套就够:
- 一张「意图 → 场景 → 动作」路由表,把常见问法枚举进提示词;
- 一道验收门,状态码、行数、截断标记逐项核对,不合格修正重试,两轮不过升级人工;
- 一个运行账本,每次执行追加一行记录,定期复盘空结果率与重试率。
智能体不装懂,用户才敢把日常查询交给它。
脱敏声明:文中企业与内部标识已泛化为「一家大型制造企业」,界面图为示意重绘、非原系统实拍;查询机制、场景规则与运行数据为实测原貌。原文与图集见格致笔记:ai.magicsnake.cn/works/s1-qu...