围绕第三章人工智能训练业务流程的参考资料、核心环节、考点范围及后续安排展开讲解,内容如下:
- 参考资料说明
- 资料来源:该PPT为华为智能计算1+X团队制作,曾用于华为内部师资培训,并非本次授课方原创内容。
- 内容特点:基于行业通用的约定俗成流程框架搭建,细节详实但存在冗余内容,适配团队按季度汇报的长周期项目场景。
- 使用规则:无强制学习要求,仅作为拓展内容发放,备考学员无需查阅,避免内容过杂影响备考效率。
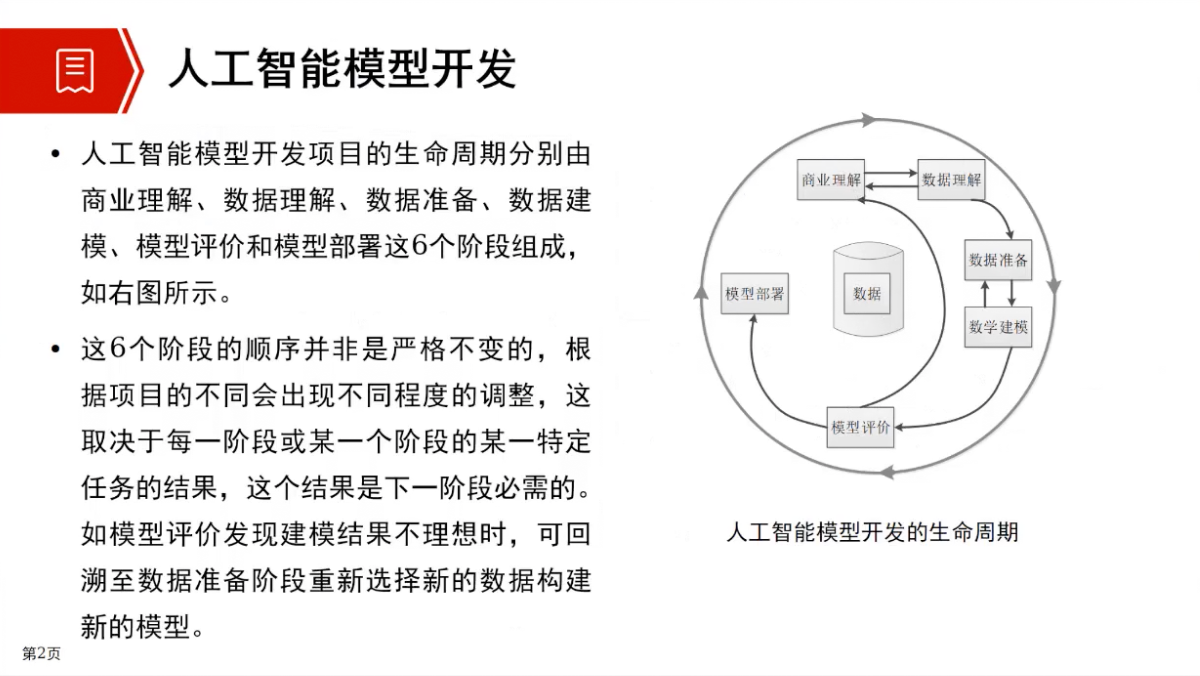
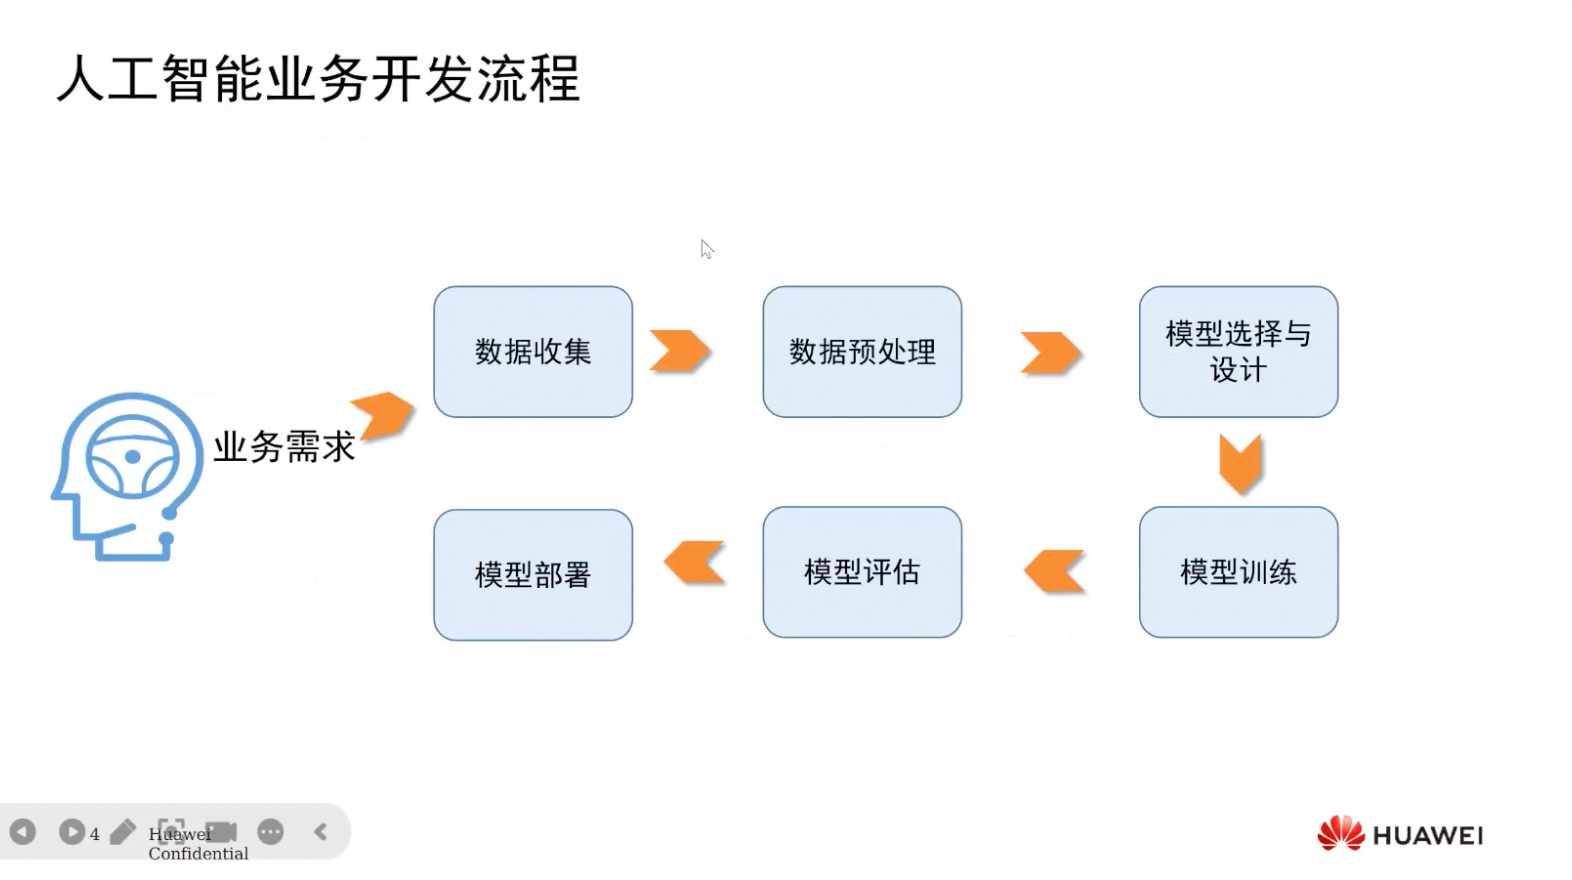
- 人工智能开发全流程核心要点
-
需求与立项阶段:需完成业务需求梳理、项目立项工作,编制目标策划书、可行性分析报告,明确项目商业目标。
-
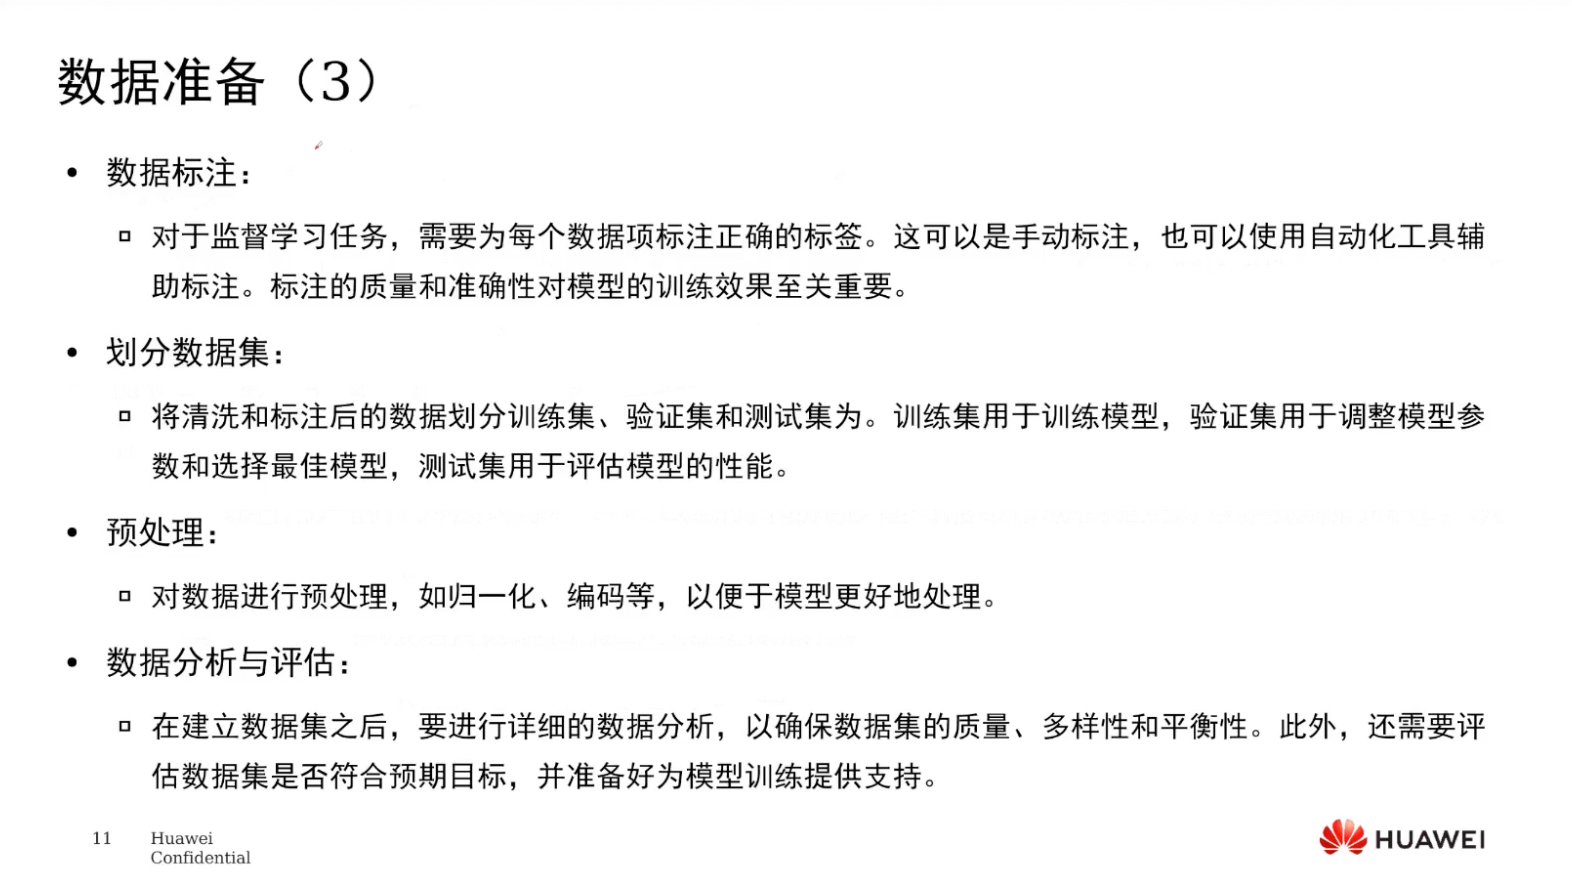
数据准备阶段
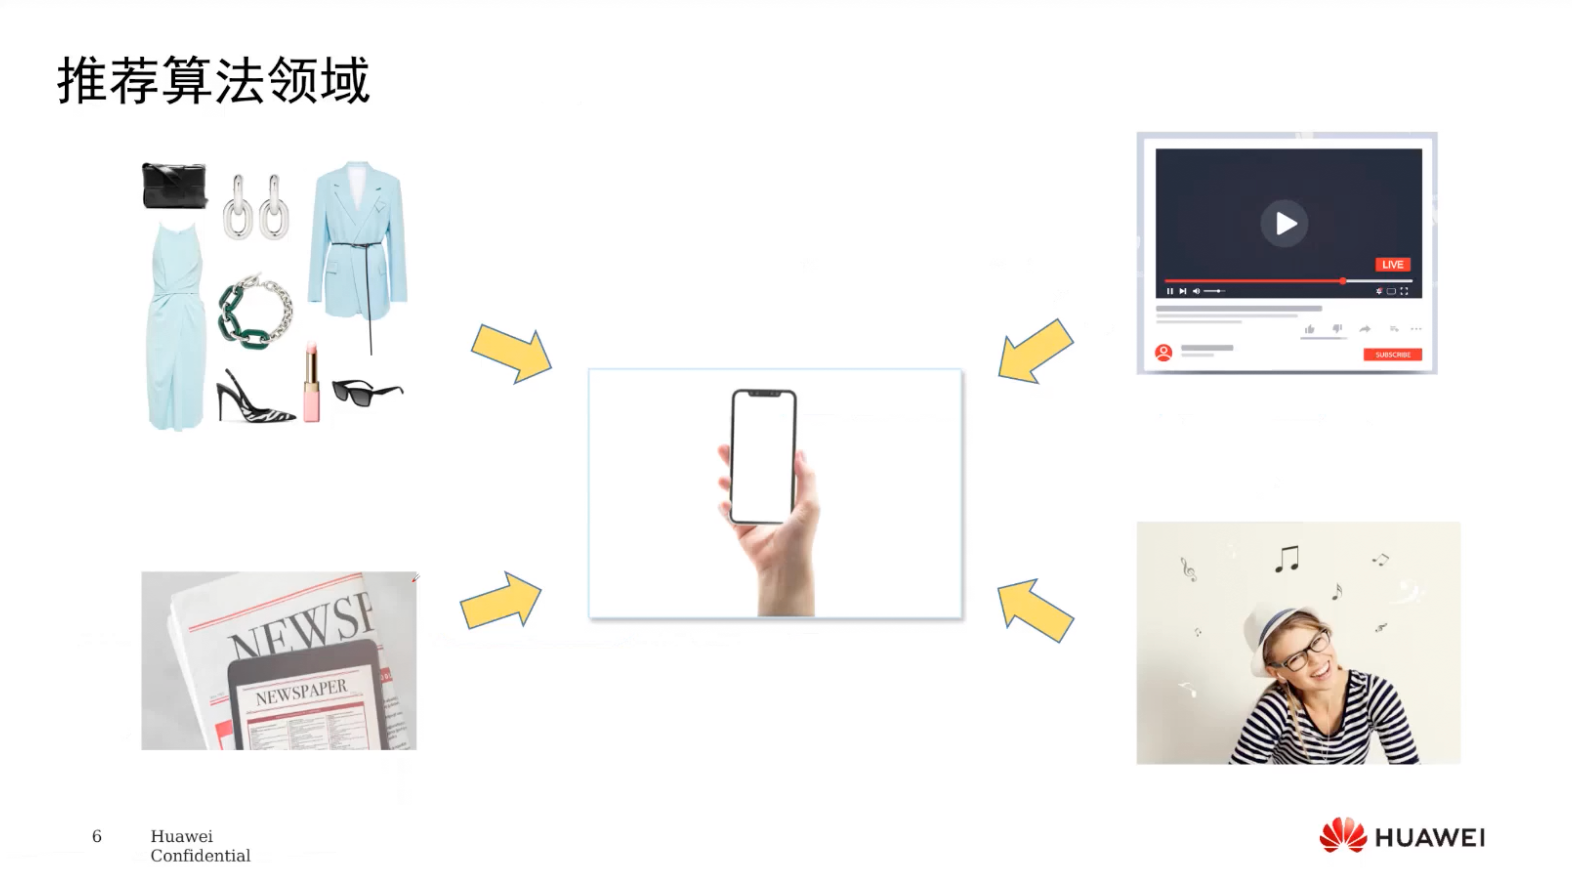
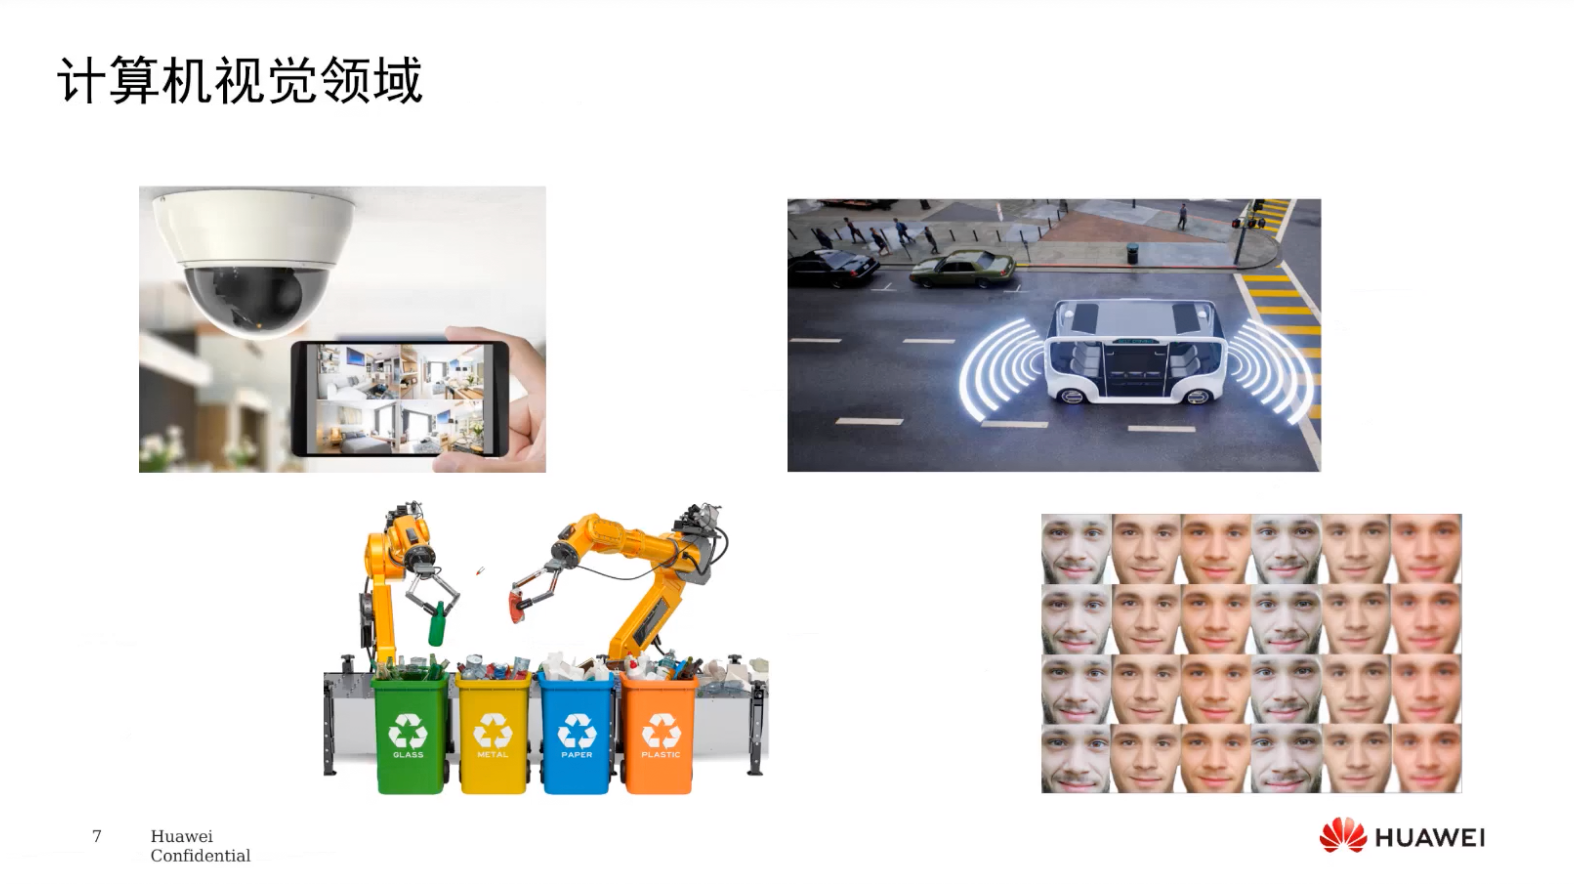
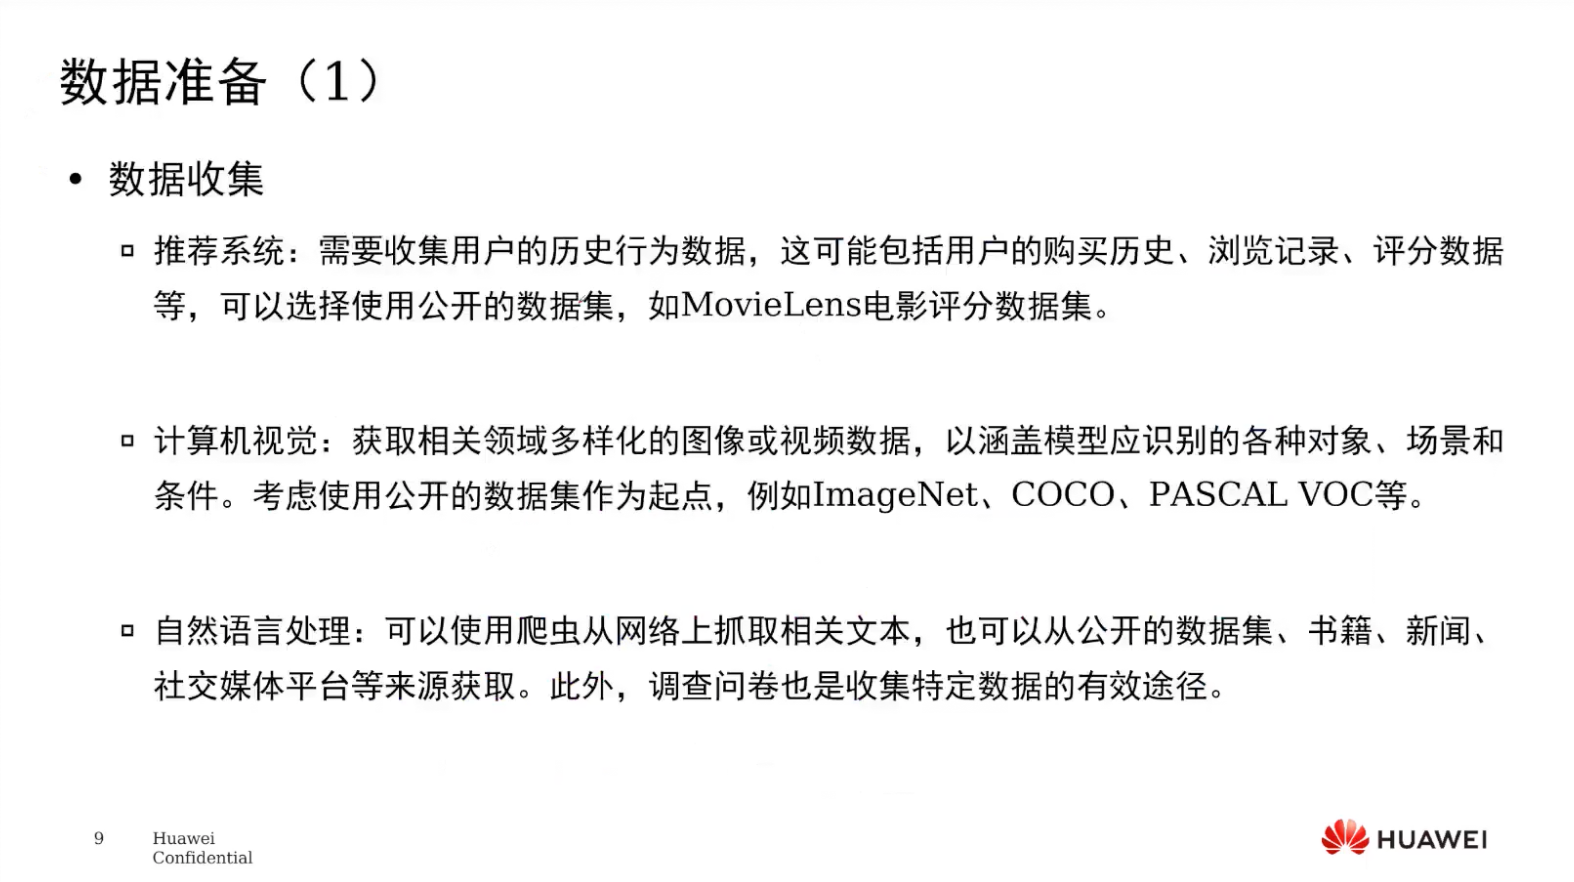
- 分场景数据源:推荐算法领域采集用户购买记录、UV/PV/GMV 等指标;计算机视觉领域常用 ImageNet、COCO 等开源数据集,分别适配算法演示、目标检测场景,教学场景因权限限制多使用公开数据。
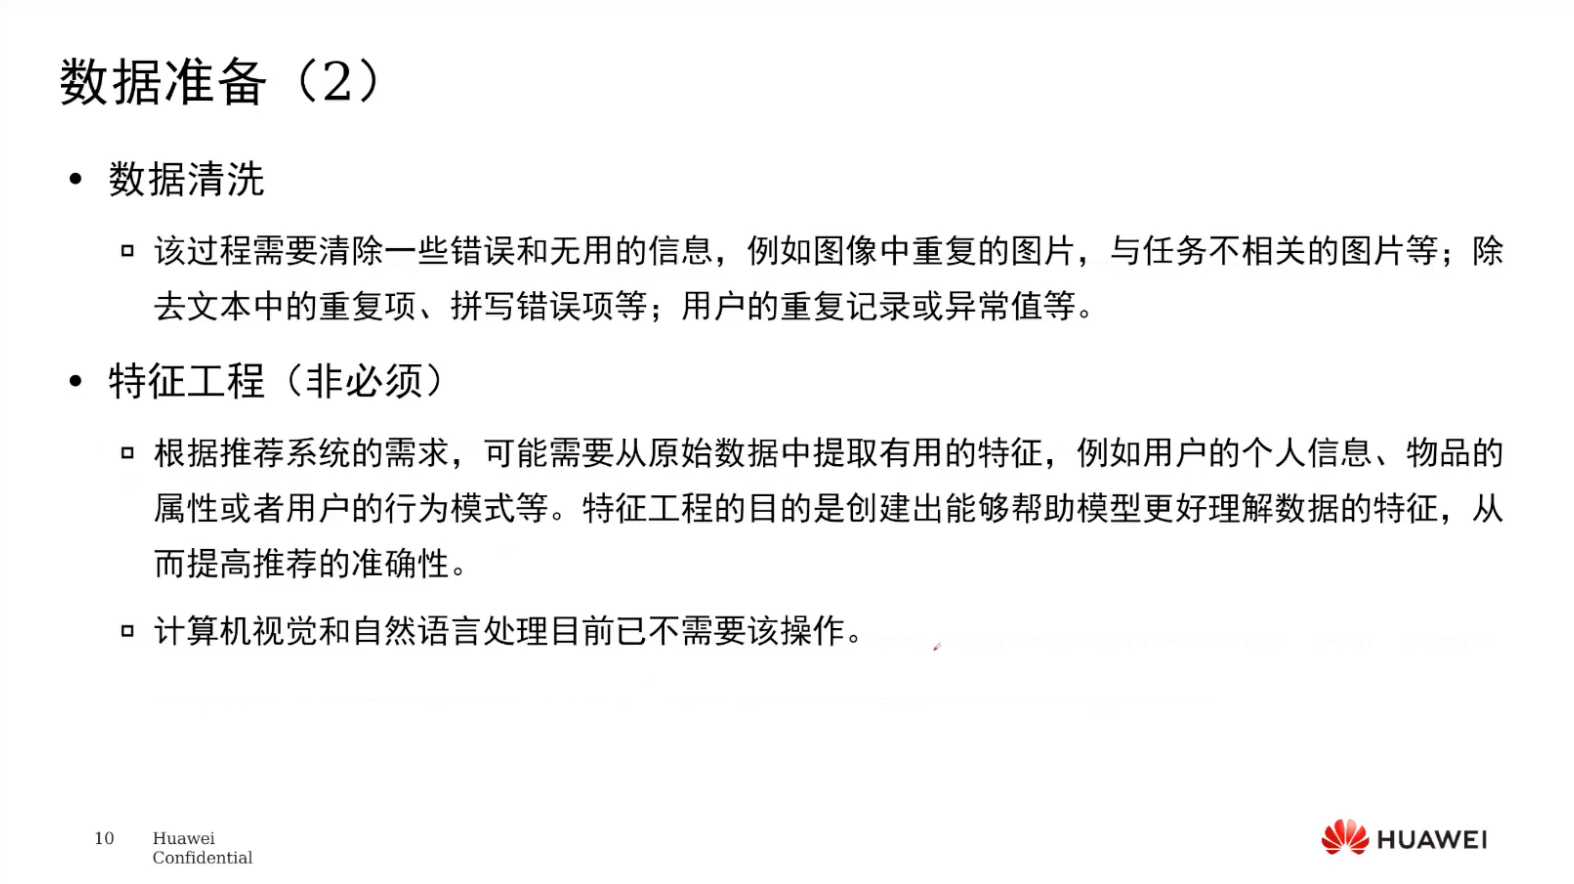
- 数据处理要求:深度学习场景下特征工程非必须,神经网络可自主完成特征筛选,仅需完成空值、异常值等基础清洗操作。
- 后续处理环节:完成数据标注后按比例划分为训练集、验证集、测试集,再执行归一化、编码等预处理操作,最终出具数据质量报告。
- 核心逻辑提示:数据质量直接决定模型可达到的上限,项目总结阶段需明确标注初始数据质量水平。
-
模型选型与训练阶段
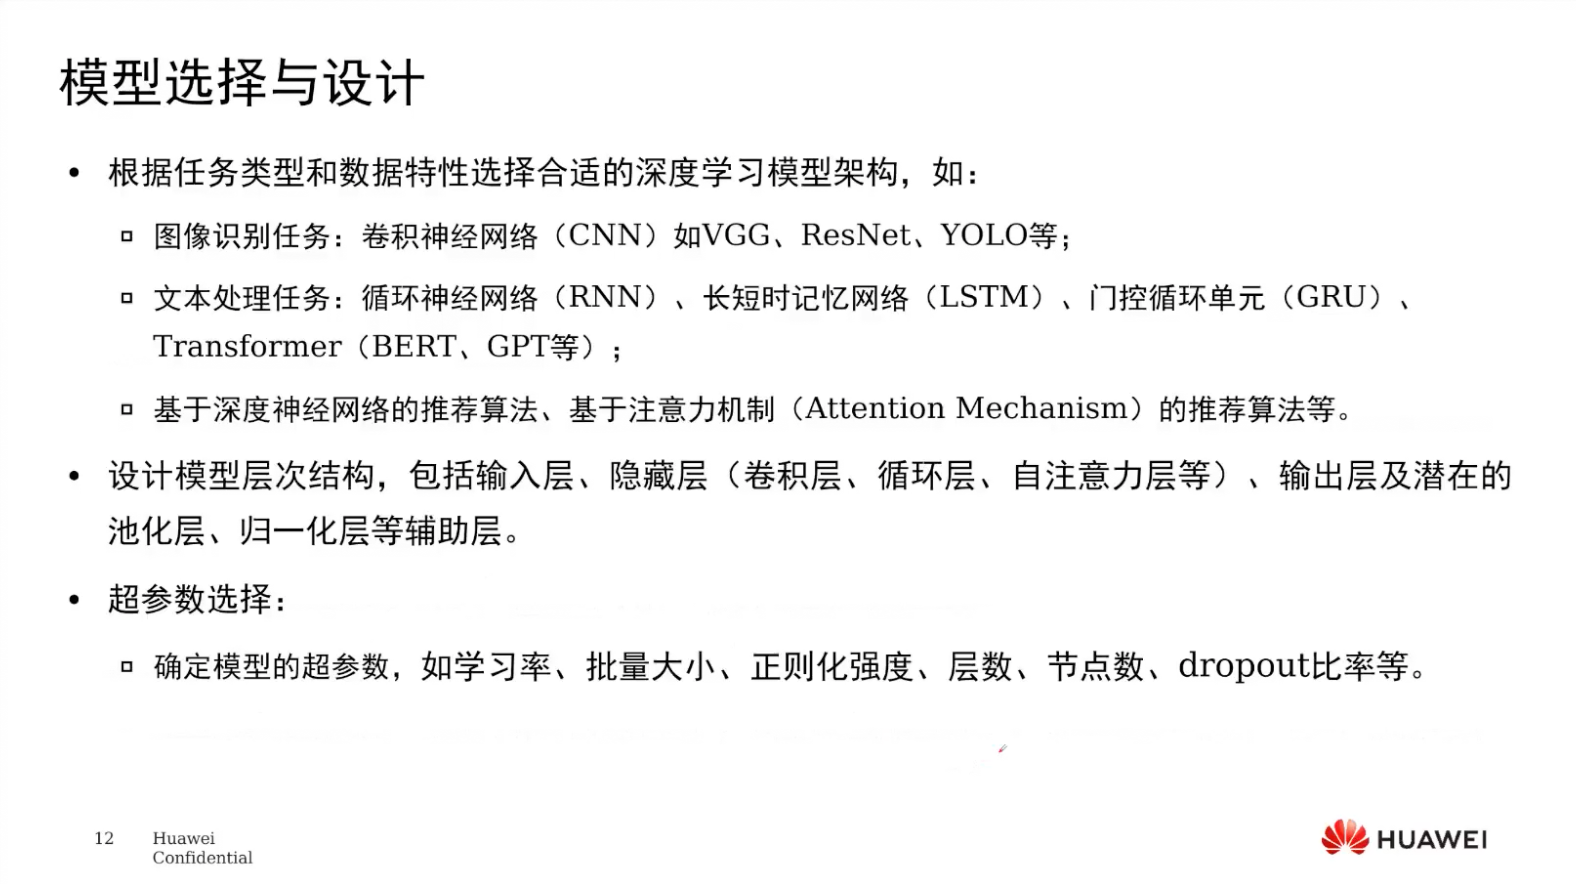
- 选型匹配逻辑:根据处理场景匹配对应模型,如图像类任务可选 CNN、VGG、ResNet、Yolo 等,文本类任务可选 LSTM、GRU 等。
- 框架与参数设置:可选用 TensorFlow、PyTorch 等成熟框架,需手动设置学习率、批量大小、隐藏层层数等超参数。
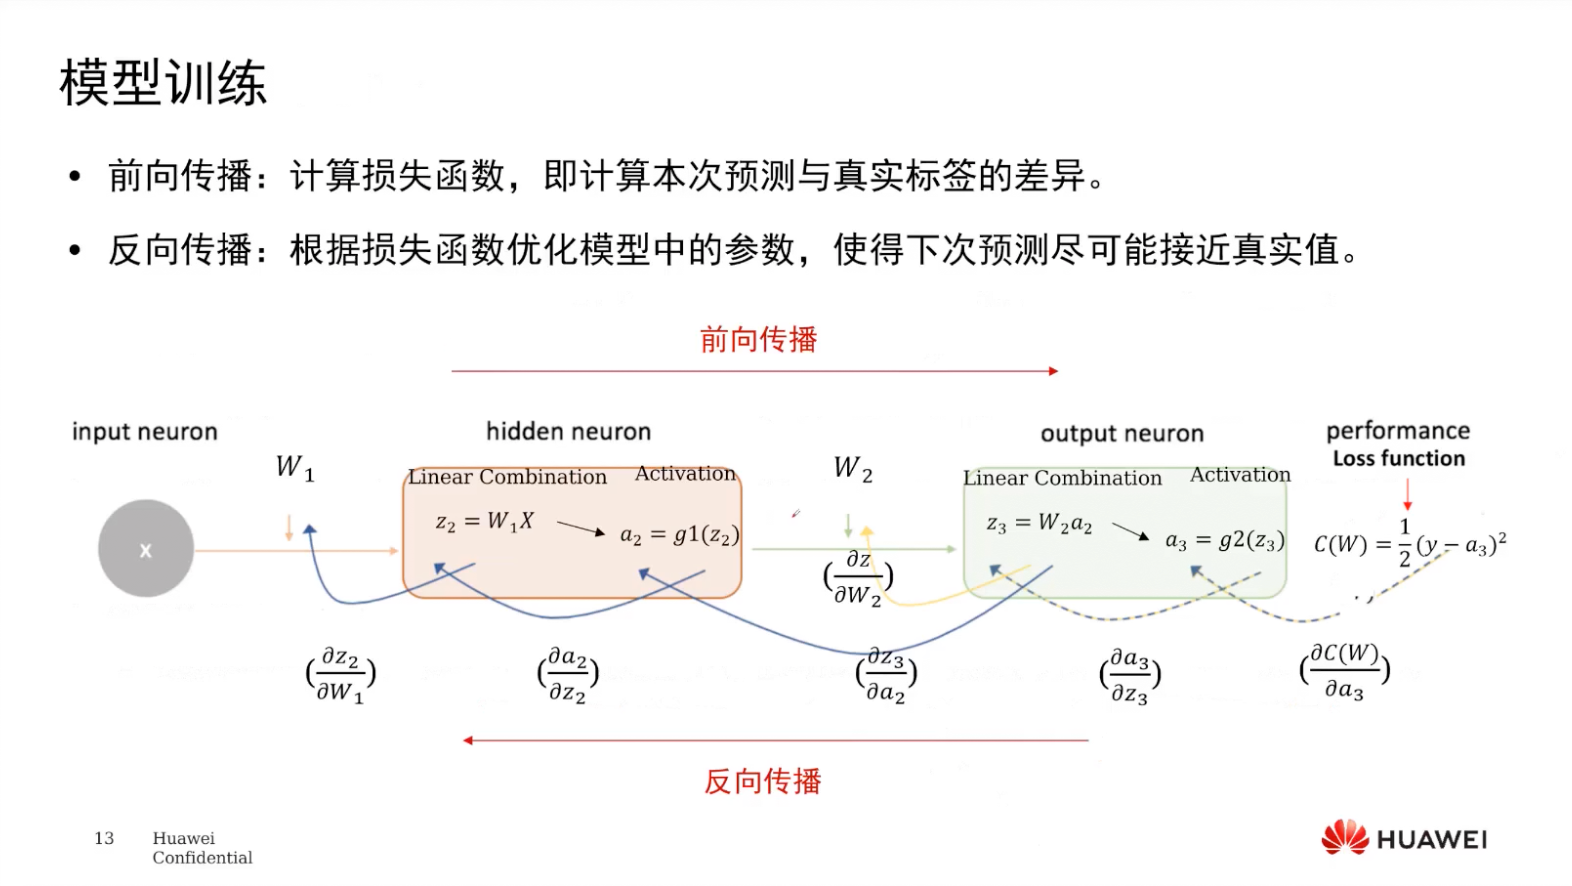
- 训练执行逻辑:通过正向传播计算损失函数,再经链式求导反向传播调整权重参数,完成模型训练流程。
-
模型评估阶段
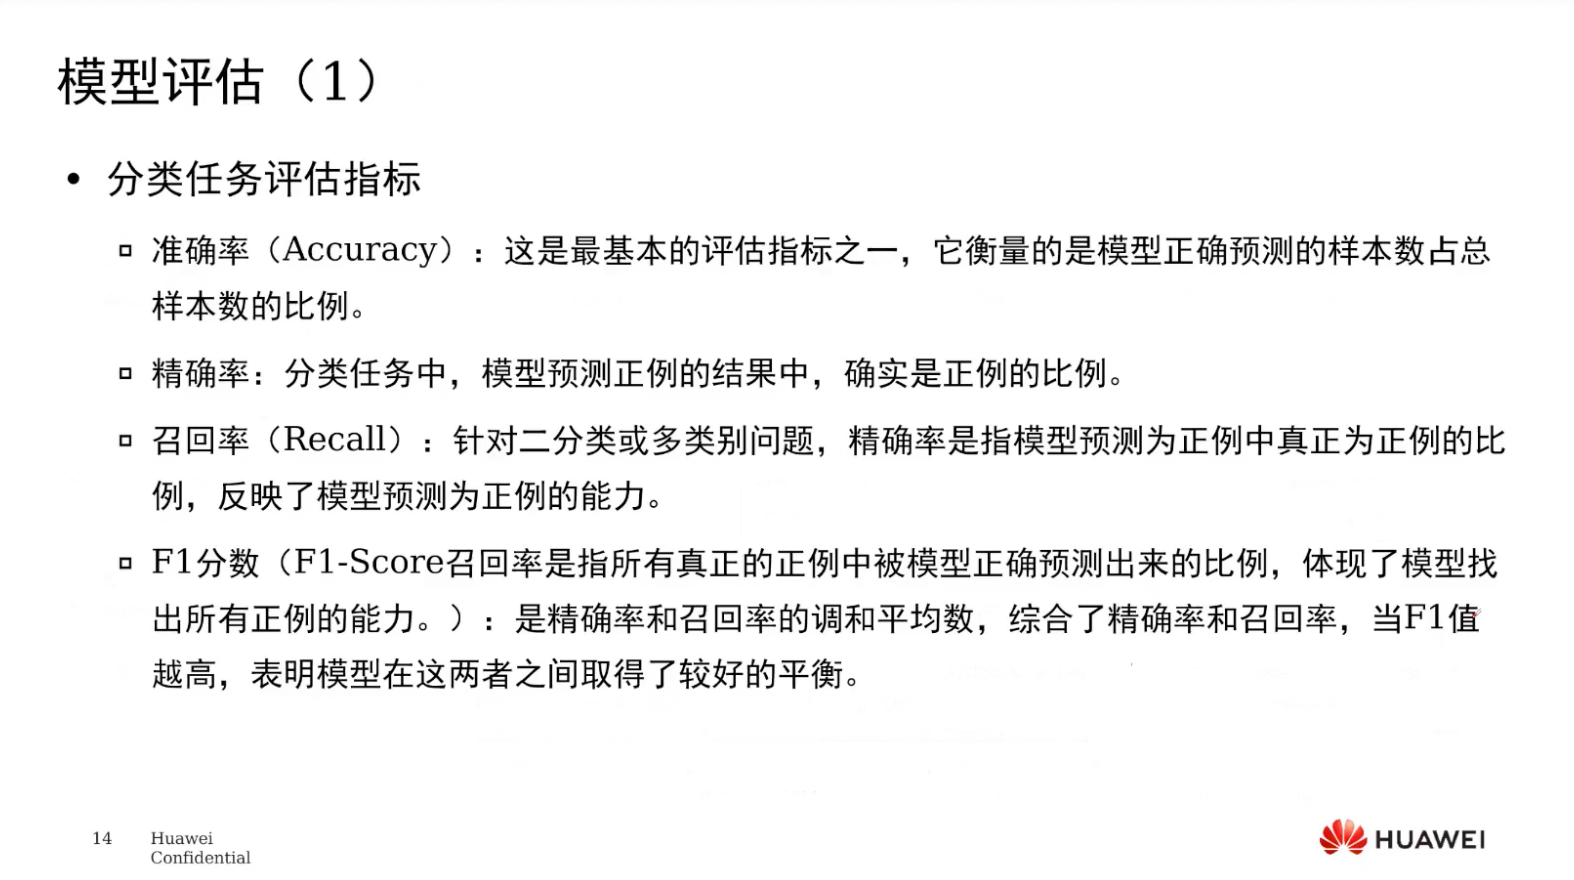
- 分类任务评估:核心参考准确率、召回率、精度、F1 值等指标,对应机器学习混淆矩阵内容,非考试重点无需深究公式。
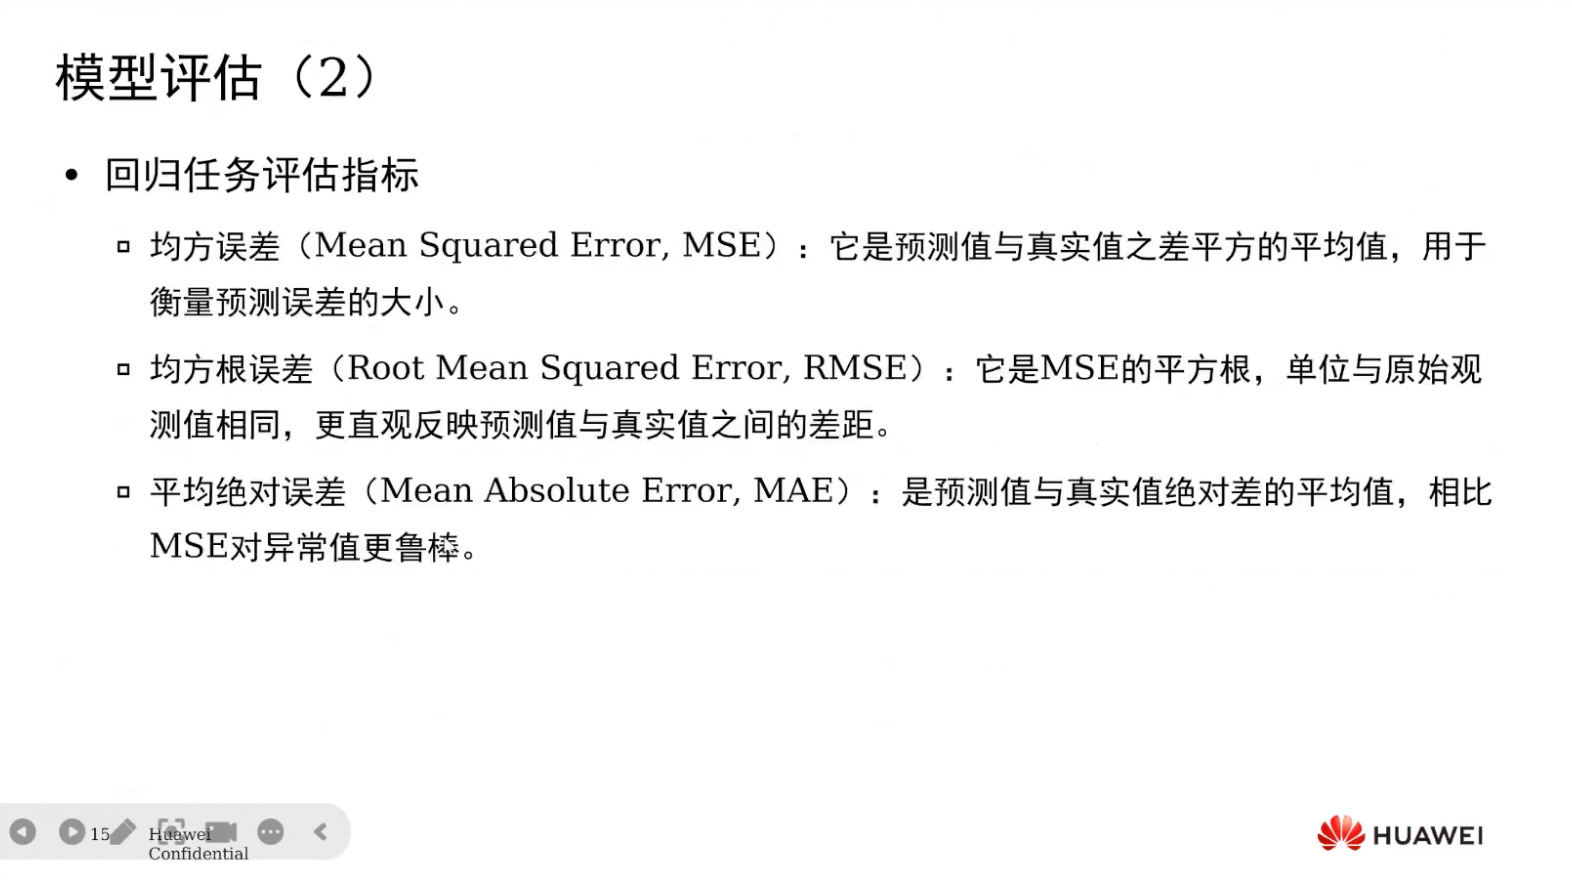
- 回归任务评估:核心参考均方误差、均方根误差、平均绝对误差,误差值越小代表模型拟合效果越贴近真实规律。
- 迭代规则:评估结果不达标需返回对应环节调整后重新训练,评估达标后方可进入后续部署环节。
-
模型部署阶段
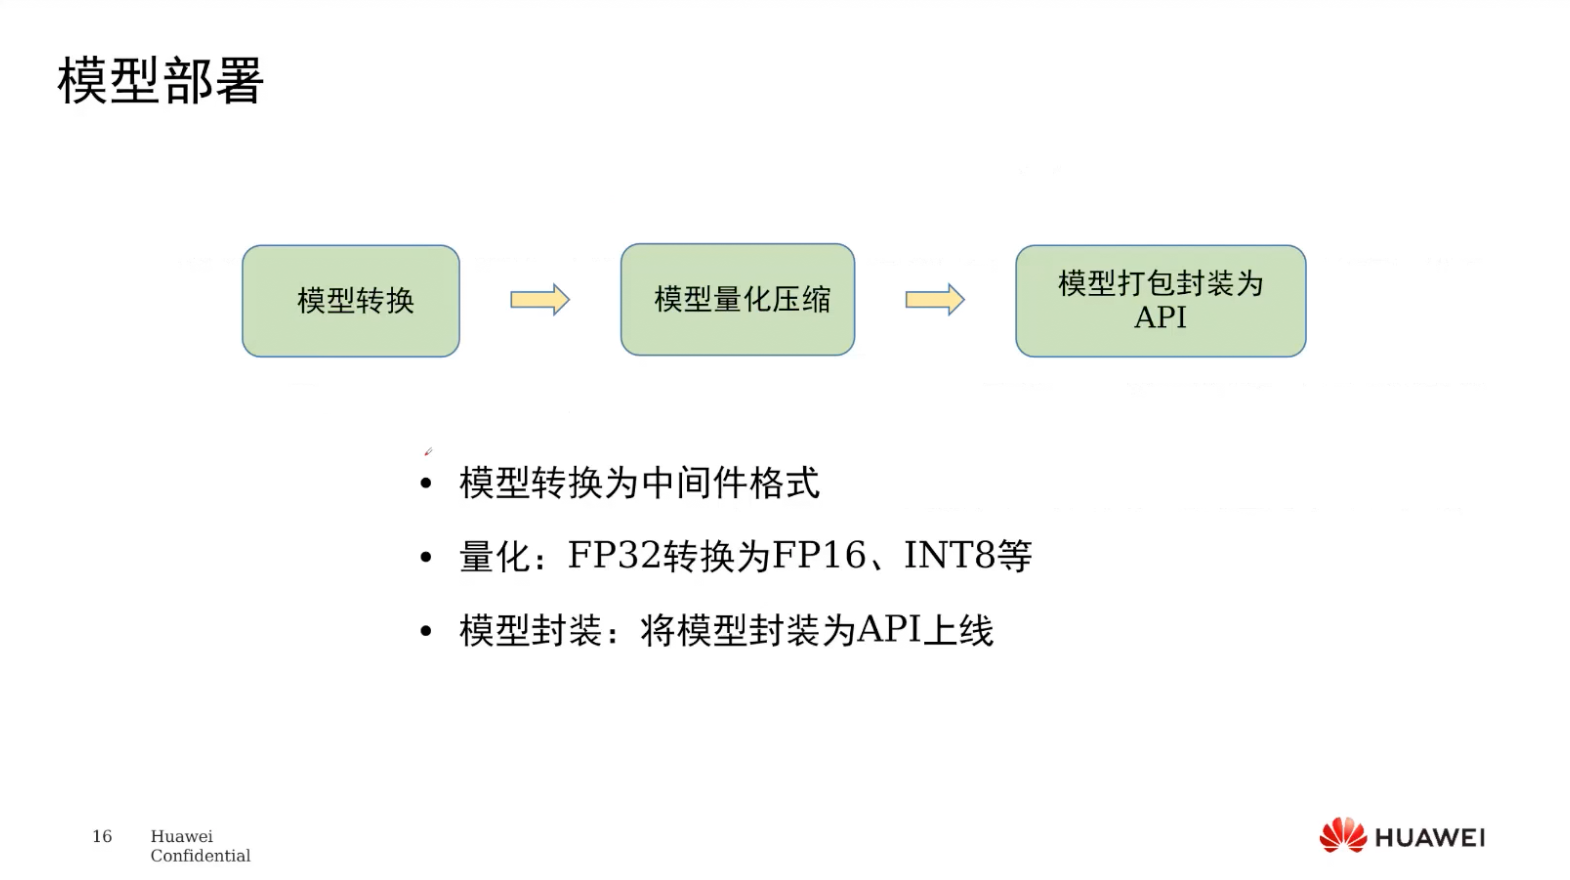
- 通用部署流程:先将高精度模型量化压缩为低精度模型,类似图片压缩,过度压缩会出现精度失真,再封装为可直接调用的 API 上线。
- 华为体系特殊要求:华为采用 ARM 架构服务器,需额外完成数据、模型格式转换,对应岗位为模型移植工程师,非华为场景可省略。
-
- 考试相关重点提示
- 明确必考内容:模型选型方法、爬虫类数据清洗操作、AI 开发全流程框架为明确考点,后续课程会针对性开展专项讲解。
- 非考点提示:机器学习评估指标公式、复杂特征工程细节、非考试相关的拓展内容均不做考核要求,无需额外花费时间学习。