花几万块搭的 AI Agent 系统,写代码全是 bug,调工具顺序乱七八糟?微软开源了一个 3500 行的轻量框架,让 Agent 在真实环境里「练级」,SWE-bench 分数暴涨 14.6 个百分点。本文拆解它的架构、优劣和适用场景。
花了好几万搭了一套 AI Agent 系统,结果它写出来的代码全是 bug,调用工具顺序乱七八糟,用户体验一塌糊涂。你想让它「变聪明一点」,但微调?那是大厂才干得起的事。Prompt Engineering?调来调去也就那样。
有没有一种可能,让 Agent 自己在真实环境里「练级」,用强化学习的方式越用越聪明?
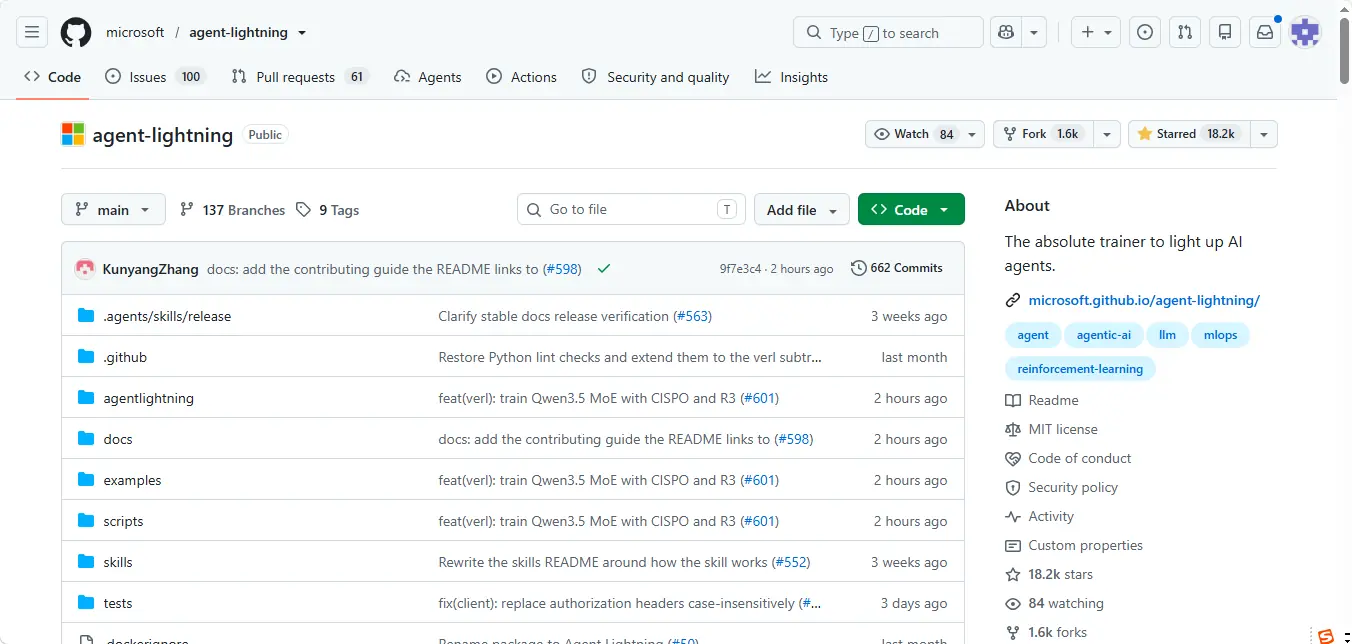
微软 Research 最近开源的 Agent Lightning,就是干这事的------而且只用了 3500 行代码。
GitHub:
一句话说清楚
Agent Lightning 是微软研究院开源的一个轻量级强化学习框架,专门用来训练 AI Agent------不是在模拟环境里「打游戏」,而是让 Agent 直接在真实工具链、真实代码环境、真实浏览器里跑,然后用真实交互数据来训练模型变得更聪明。
核心硬指标:
| 指标 | 数据 |
|---|---|
| ⭐ Star 数 | 18,300+ |
| 🍴 Fork 数 | 1,600+ |
| 📝 代码量 | ~3,500 行 |
| 💻 主要语言 | Python (100%) |
| 📜 License | MIT |
| 🏢 维护方 | Microsoft Research |
| 📦 版本 | v1.0.1 (2026年8月) |
它解决了一个什么问题
训练 AI Agent 一直是个老大难问题。
传统做法是把 Agent 的所有能力「模拟」出来------比如你想训练一个会写代码的 Agent,你得先造一个假的代码编辑器、假的终端、假的文件系统,然后在这个「沙盒」里让模型不断试错。
问题在于:模拟环境和真实环境差距太大。就像你在驾校练了 100 小时倒车入库,结果上路发现车位根本不是驾校那个宽度。
Agent Lightning 的思路很直接:别模拟了,直接在真实环境里练。
它通过一个轻量级代理(Proxy)拦截模型的所有请求,Agent 用真实工具、真实代码、真实文件系统,训练数据就是真实交互过程。模型在真实环境里犯的错,会变成训练信号反过来优化模型。
这个思路不新,但之前没人把它做到 3500 行代码这么轻。像 TRL、OpenRLHF 这些框架,动辄几万行,还得配一堆基础设施。Agent Lightning 的作者显然想清楚了一件事:复杂的问题不一定需要复杂的解决方案 (据 arXiv 论文 介绍,项目始于 2025 年)。
核心功能
零改动 Agent 集成
这是最让我眼前一亮的设计。你现有的 Agent 代码------用 LangChain 写的、用 AutoGen 写的、甚至手写的------一行都不用改。
Agent Lightning 通过一个 OpenAI 兼容的 API Gateway 做中间人,Agent 以为自己在跟普通模型聊天,实际上所有请求都被代理了。训练数据在这个过程中被静默捕获。
这就像给你的 Agent 装了一个「行车记录仪」------Agent 该怎么跑还怎么跑,但每一次交互都被记录下来用于训练。
真实环境训练
Agent 可以调用真实工具(MCP 工具、代码执行器、文件系统),上下文保持完整,控制流不被打断。这意味着模型学到的是「在真实场景下怎么用工具」,而不是「在模拟器里怎么刷分」。
项目提供了完整的 Coding Agent 训练案例:用 6K 训练样本,在 Qwen3.5-9B 上跑完端到端流程,SWE-bench Verified 分数从 41.8% 涨到 56.4%,提升 14.6 个百分点 (据 v1.0 技术报告)。数据清洗、防 reward hacking、训练脚本全部开源。
原生 Kubernetes 支持
Agent 可以直接作为 Kubernetes Job 运行,不需要依赖外部沙盒服务。这在生产环境里很实用------你不需要为训练额外维护一套 sandbox 基础设施,K8s 集群里直接起 Pod 就行。
三组件极简架构
整个框架只有三个核心组件:
- Trainer:跑 verl 和 vLLM,构建训练样本,更新模型策略
- API Gateway:代理模型请求,捕获训练数据
- Rollout Controller:在本地或 K8s 上运行 Agent
三者分工清晰,Trainer 生成 rollout、Controller 启动 Agent、Gateway 把交互变成训练数据。没有花哨的微服务拆分,没有一堆配置文件,就这三样。
技术架构
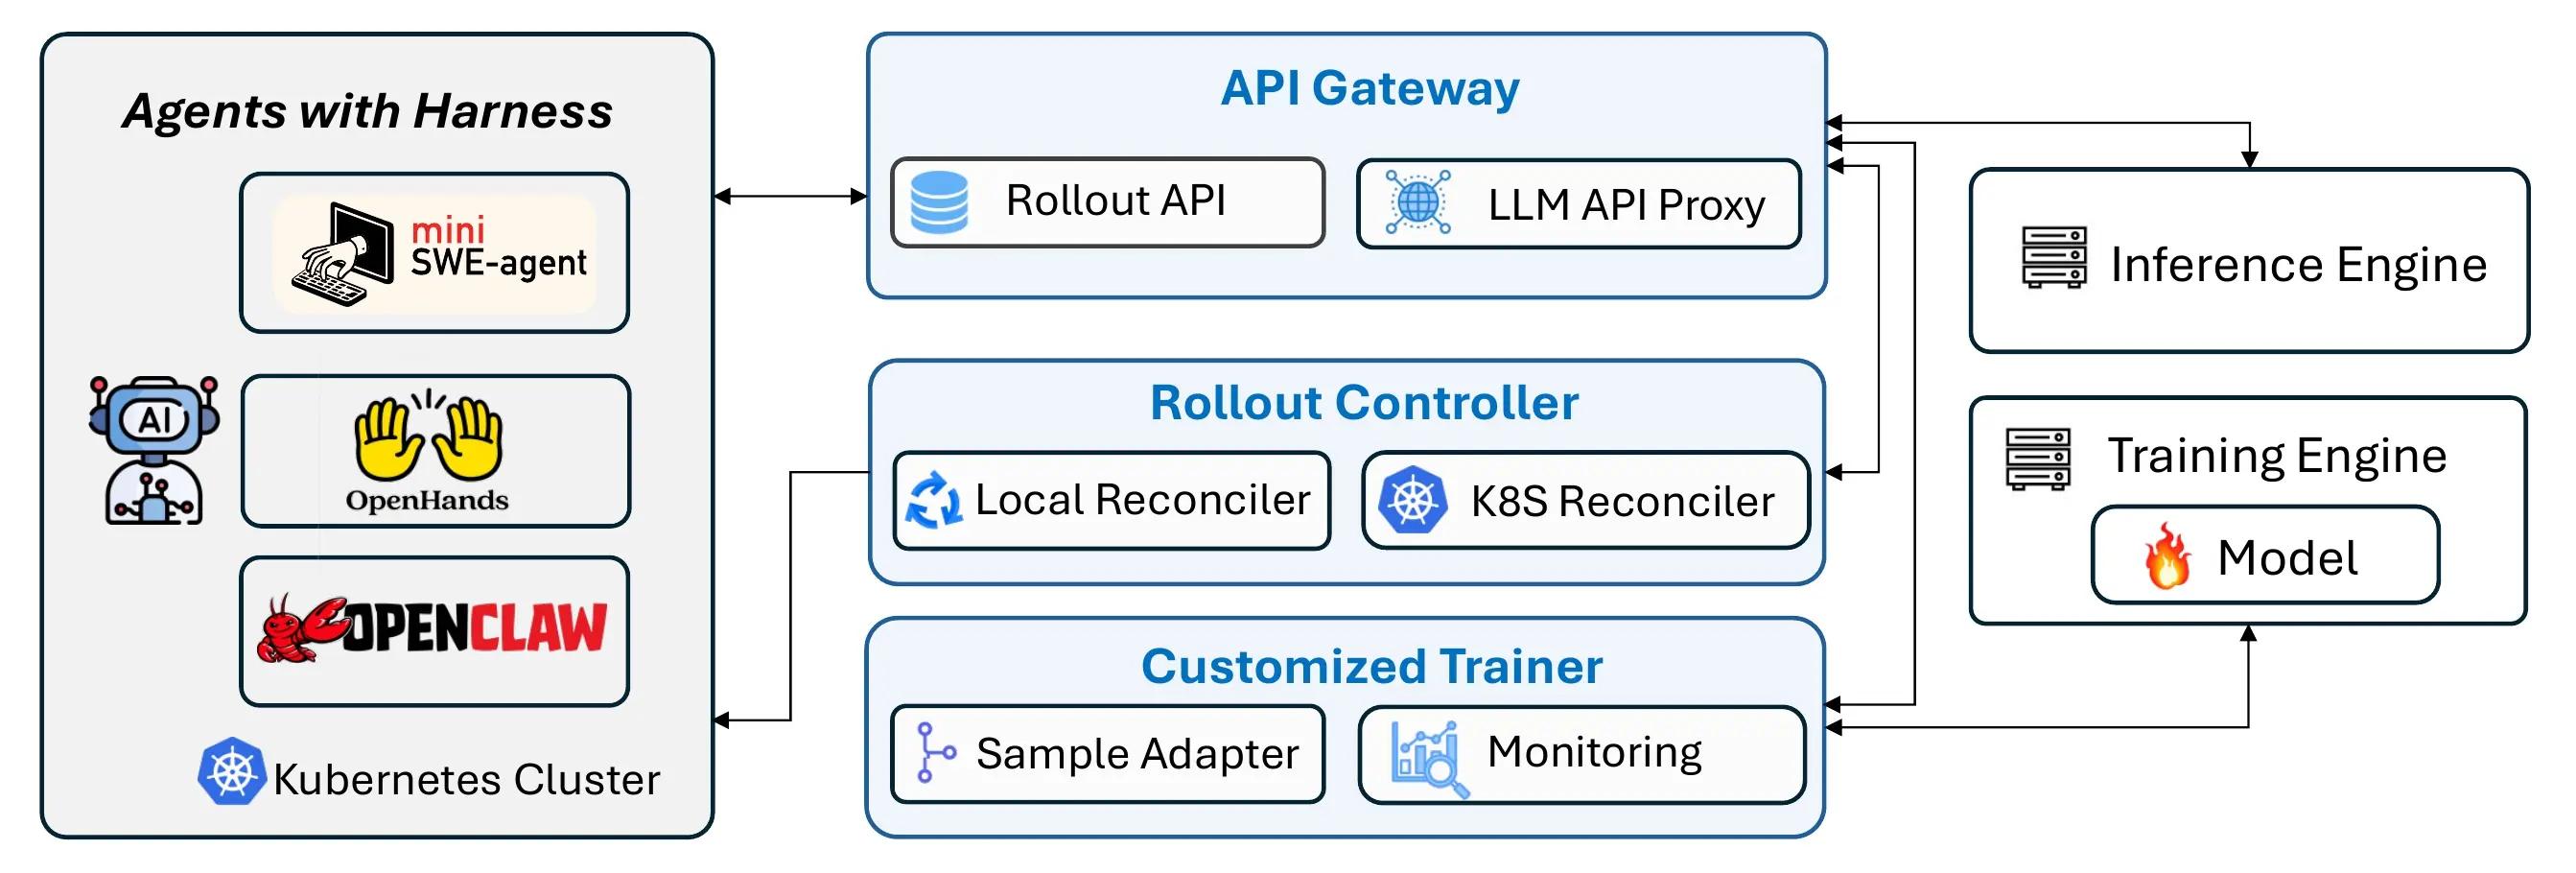
技术栈选型很有意思:
| 组件 | 选型 | 为什么这么选 |
|---|---|---|
| 推理引擎 | vLLM | 高吞吐量推理,社区成熟 |
| RL 框架 | verl | 专为 LLM RL 设计,与 vLLM 深度集成 |
| API 网关 | FastAPI | Python 生态里最快的异步框架 |
| 配置管理 | Hydra + OmegaConf | 灵活的配置覆盖,学术圈标配 |
| 容器编排 | Kubernetes (kr8s) | 原生 K8s 支持,轻量客户端 |
| 日志 | structlog | 结构化日志,方便调试 |
最值得关注的设计决策:选了 verl 而不是自研 RL 引擎。verl 是字节跳动开源的 LLM RL 框架,专门优化了 PPO/GRPO 在大模型上的训练效率。Agent Lightning 不重复造轮子,把精力放在「让 Agent 真实环境训练」这个差异化价值上,非常务实。
另一个亮点是 OpenAI 兼容 API 的设计 。根据 vLLM 官方博客 的分析,在 Agent RL 中如果用 token ID 而不是文本做中间表示,能避免重 tokenize 带来的信息丢失。Agent Lightning 通过代理层实现了这一点,Agent 完全无感。
同类项目对比
| 维度 | Agent Lightning | TRL (HuggingFace) | OpenRLHF | AgentGym |
|---|---|---|---|---|
| 代码量 | ~3,500 行 | ~50,000+ 行 | ~20,000 行 | ~10,000 行 |
| Agent 训练 | ✅ 核心能力 | ❌ 不支持 | ⚠️ 需大量适配 | ⚠️ 需大量适配 |
| 真实环境 | ✅ 原生支持 | ❌ 仅模拟 | ❌ 仅模拟 | ⚠️ 部分支持 |
| K8s 支持 | ✅ 原生 | ❌ 需自建 | ❌ 需自建 | ❌ 需自建 |
| 上手难度 | 低 | 中 | 高 | 中 |
| 生产就绪 | ⚠️ 早期 | ✅ 成熟 | ⚠️ 成熟度一般 | ⚠️ 早期 |
核心区别:TRL 和 OpenRLHF 是通用 RL 训练框架,Agent Lightning 专注于「Agent 在真实环境中的 RL 训练」这个垂直场景。如果你只是想做 SFT 或者 PPO 微调,TRL 更合适;如果你想让 Agent 在真实工具链里越用越聪明,Agent Lightning 是目前最轻量的选择。
优势与不足
优势
Agent Lightning 最大的优势是极简,整个框架只有 3500 行代码,读一遍就能理解全貌,维护成本极低。在此基础上它做到了零改动集成,你现有的 Agent 代码不用改一行,通过代理层就能透明接入训练流程。更关键的是它支持真实环境训练,不是在模拟器里跑,而是在真实工具链里训练,模型学到的东西泛化能力更强。项目还开源了完整的 Coding Agent 训练案例,从数据清洗到训练到评估全流程可复现。微软 Research 的背书意味着这不是个人项目,有持续维护的保障,加上 MIT 协议,商用友好,不用担心 License 问题。
不足
但也要看到它的局限。v1.0 刚发布不到两个月,社区工具链和最佳实践还在积累中,生态尚处于早期。RL 训练天然需要多卡资源,单卡跑 Coding Agent 这种案例不现实,GPU 门槛不低。虽然有 MkDocs 文档站,但部分高级配置(如异步训练)的说明偏简略,文档覆盖还有提升空间。另外 verl 有 breaking changes(0.9.0 重命名了关键类),版本兼容需要留意。最后,项目仅支持 Python 3.12+,对老项目升级有一定门槛。
前景判断
Agent Lightning 目前处于早期成长阶段,v1.0 刚发布,核心功能稳定但社区生态还在建立中。好消息是被弃用风险很低,微软 Research 的项目有论文、有博客、有内部团队在用,不太可能突然停更。它适合的场景很明确:你有一个 Agent 想让它越用越聪明,手上有 GPU 资源(至少 1-2 张 A100/H100),不想从零搭建 RL 训练基础设施,而且 Agent 已经能跑起来了只是效果不够好。反过来,如果你需要的是纯 SFT 微调(TRL 更合适)、没有 GPU 资源、需要立即上生产、或者 Agent 还没写好,那这个项目暂时不适合你。
GitHub:
写在最后
Agent Lightning 让我看到了 AI Agent 训练的一个趋势:从「造更好的模拟器」转向「在真实世界里训练」。
过去几年,大家在 Agent 领域投入了大量精力做环境模拟------代码沙盒、浏览器模拟、工具 Mock。但模拟和真实之间的鸿沟始终存在。Agent Lightning 的思路是:与其花精力缩小这个鸿沟,不如直接跨过去。
3500 行代码、零改动集成、真实环境训练------这三个关键词组合在一起,降低了 Agent RL 训练的门槛。虽然现在还处于早期,但方向是对的。
如果你正在做 Agent 相关的开发,不妨关注一下这个项目。即使现在不直接用,了解「让 Agent 在真实环境里用 RL 变聪明」这条技术路线,对你的架构决策也会有启发。
关注
如果这篇文章对你有帮助,可以点个关注,我会持续更新 AI 开源工具的深度解读系列。