一、介绍
1.1什么是迁移学习
迁移学习的核心思想是:指利用已经训练好的模型,在新的任务上进行微调。迁移学习可以加快模型训练速度,提高模型性能,并且在数据稀缺的情况下也能很好地工作。
1.2为什么需要迁移学习
传统卷积神经网络通过卷积层和池化层不断堆叠,但实际中发现:随着卷积层和池化层的叠加,学习效果不会逐渐变好,反而出现2个问题:
1.梯度消失和梯度爆炸
**梯度消失:**若每一层的误差梯度小于1,反向传播时,网络越深,梯度越趋近于0.
梯度爆炸:若每一层的误差梯度大于1,反向传播时,网络越深,梯度越来越大。
2.退化问题
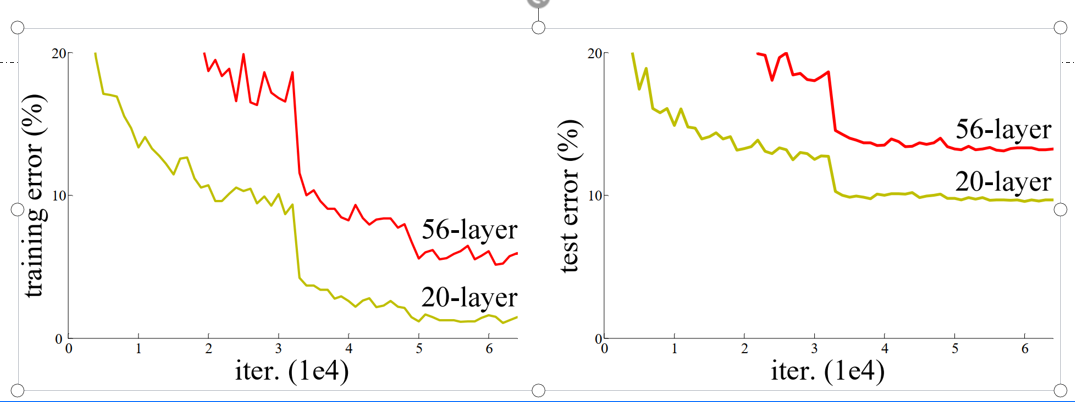
56层网络的训练误差和测试误差反而比20层更高。
这说明网络加深后,性能不是变好,而是变差。
这不是过拟合,而是**退化问题。**因为训练时候就已经是56 层网络的训练误差和测试误差反而比 20 层更高,所以这不属于过拟合。
二、ResNet如何解决这些问题
为了解决梯度消失或梯度爆炸的问题,可以通过数据的预处理以及在网络中使用BN层来解决。
为了解决深层网络中的退化问题,可以人为地让神经网络某些层跳过下一层神经元的连接,隔层相连,弱化每层之间的强联系。这种神经网络被称为残差网络。
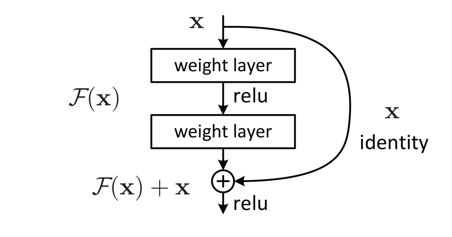
公式:y=F(x)+x
x:输入;
F(x):经过两层权重层后的输出;
F(x)+x:残差连接。
为什么残差连接能解决退化问题?
如果某些层学不到有用特征,可以让F(x)解决0,这是y接近x,相当于恒等映射。
这样深层网络至少不会比浅层网络差。
梯度可以通过shortcut直接回传,缓解梯度消失。
三、Batch Normalization
batch Normalization目的:使所有的feature map满足均值为0,方差为1的分布规律。
BN的作用:
1.让每层输入分布更稳定;
2.加速训练;
3.允许使用更大的学习率;
4.有一定正则化效果;
5.缓解梯度消失/爆炸。
在ResNet中,BN被大量使用,是ResNet能训练很深的关键之一。
四、迁移学习的步骤
4.1选择预训练的模型和适当的层
通常,我们会选择在大模型图像数据集上预训练的模型,如VGG\ResNet等。然后,根据新数据集的特点,选择需要微调的模型层。对应低级特征的任务(如边缘检测),最好使用浅层模型的层,而对于高级特征的任务(如分类),则应选择更深层次的模型。
4.2冻结预训练模型的参数
保持预训练模型的权重不变,只训练新增加的层或者微调一些层,避免因为在数据集中过拟合导致预训练模型过度拟合。
4.3在新数据集上训练新增加的层
在冻结预训练模型的参数情况下,训练新增加的层。这样,可以使新模型适应新的任务,从而获得更高的性能。
4.4微调预训练模型的层
在新层上进行训练后,可以解冻一些已经训练过的层,并且将它们作为微调的目标。这样做可以提高模型在新数据集上的性能。
4.5评估和测试
在训练完成之后,使用数据集对模型进行评估。如果性能仍然不够好,可以尝试调整超参数或者更改微调层。