从行业局势、商业影响与从业者判断来写。
2026年9月,一份解封文件把微软高管的一句话推到了聚光灯下:「这是人类历史上最大规模的劳动窃取。」这句话出自纽约时报诉OpenAI和微软版权案的内部邮件,揭露了科技巨头在AI训练数据获取上的野心与风险。
一、纽约时报为什么要告OpenAI和微软
1.1 谈判破裂后的法律反击
纽约时报并非一开始就选择诉讼。据美联社报道,2024年4月,时报开始与OpenAI和微软就版权问题展开谈判,持续数月后未能达成共识,最终于2024年4月27日向纽约曼哈顿联邦地区法院提起诉讼来源。
谈判破裂的核心分歧在于授权价格。时报认为其内容的市场价值远高于技术公司愿意支付的费用,而OpenAI和微软则认为时报的要求脱离了行业标准。这种分歧反映了AI时代内容授权定价机制尚未建立的行业现状。
1.2 数十亿美元索赔背后的商业逻辑
时报在诉状中要求销毁包含侵权材料的模型和训练数据,并对「数十亿美元的法定和实际损害」负责来源。
这个数字并非随意估算。时报近年来在线上订阅模式上取得了显著成功,其数字收入已超过 print 收入。如果AI模型能够替代用户直接获取时报内容,将直接影响订阅转化率。时报首席法律顾问Ian Crosby在声明中指出:「如果时报无法保护其独立新闻报道,社会将出现人工智能无法填补的真空。」
1.3 为什么是纽约时报------而非其他媒体
时报选择成为首家起诉大型AI公司的美国主流媒体,有其战略考量。首先,时报拥有强大的律师团队和充足的资金储备,能够支撑长期诉讼。其次,时报的内容具有高度独特性和辨识度,便于在诉讼中展示侵权行为。最后,时报已经在技术上采取了保护措施,屏蔽了OpenAI的网络爬虫来源。
这锅,时报决定甩回去
二、820万条日志:微软如何证明「自己偷得很少」
2.1 数据筛选与匹配逻辑
作为取证程序的一部分,微软向时报聘请的专家提供了820万条Copilot对话日志来源。
微软的筛选逻辑是:这些日志命中了涉及时报网站的关键词,因此最有可能包含时报内容。分析结果显示,其中约59,545条与新闻内容至少有16个相同单词。针对调查记者中心的专项评估发现51处「实质性重叠」实例,作者方诉讼中发现24处匹配。在抽样评估的212部著作中,仅10本存在匹配记录。
微软据此主张,其训练行为属于合理使用范畴。模型输出与原文用途不同,偶发的文本重合不足以否定AI训练的变革性价值。
2.2 NYT的反驳:方式本身就是问题
时报首席律师Ian Crosby驳斥了微软的结论:「取证材料清晰表明,微软与OpenAI涉嫌窃取新闻内容以开发替代性商业产品。」时报认为,问题的核心不在于复制了多少内容,而在于未经许可使用本身就是侵权。
这场诉讼的核心不是某一段文字被复制,而是整个新闻生产体系被免费纳入AI的训练管道,成为技术公司替代自身产品的燃料。微软用数据证明「我们偷得很少」,纽约时报用诉讼证明「你们偷的方式本身就是问题」。
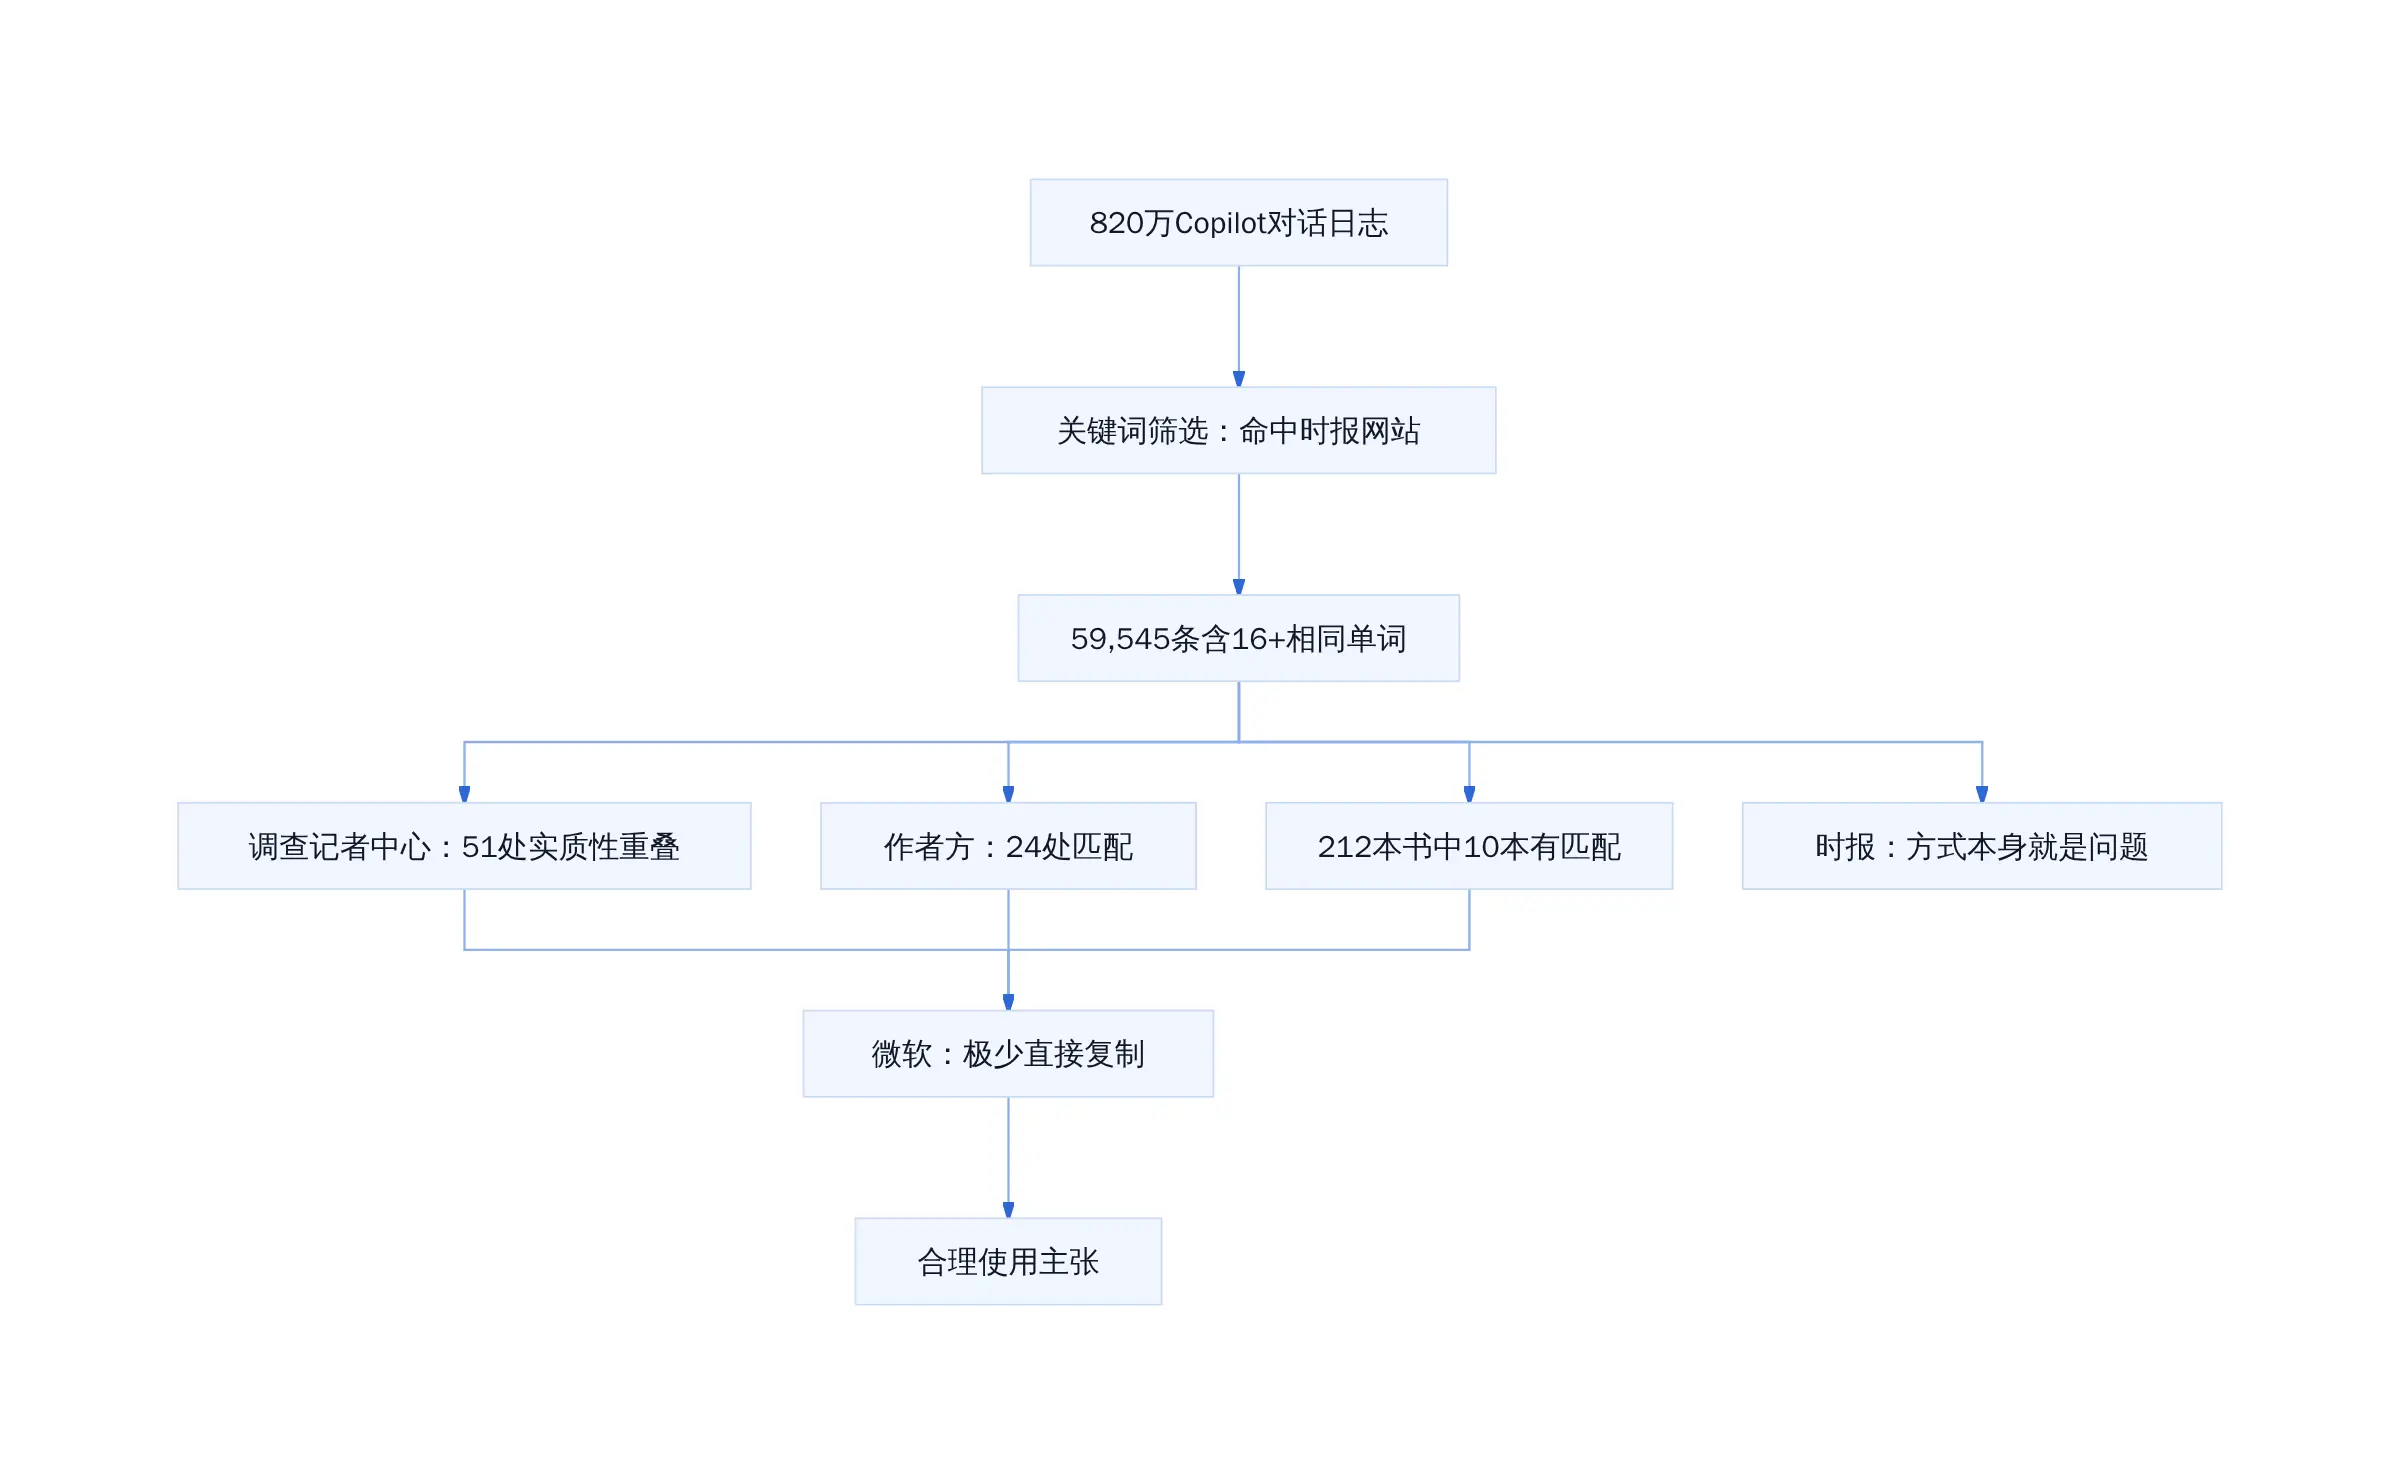
820万日志筛选与匹配结果
三、这场诉讼的核心争议:合理使用还是体系化侵占?
3.1 版权法中的「转换性使用」边界
美国版权法中的「合理使用」原则允许在某些情况下未经授权使用受版权保护的内容,前提是这种使用具有「转换性」------即创造了新的表达、意义或功能。
AI公司的主张是:训练出的模型能够生成新内容,因此具有转换性。时报的反驳是:如果AI输出与原文高度相似,且用于替代原文的市场,就不构成转换性使用。
这个边界目前尚无明确司法解释。法院需要判断:模型「学习」内容与「复制」内容的区别在哪里?当模型能够逐字背诵或精确概括时报文章时,是否已经跨越了合理使用的边界?
3.3 新闻劳动的价值如何被量化
时报在诉状中强调,其深度报道体现了创造力,应当获得公平回报来源。
新闻劳动的价值难以简单量化。时报的年度数字订阅收入约30亿美元,其中部分内容收入来自企业授权。如果AI模型能够免费替代这些内容,时报的损失不仅在于直接的授权收入,更在于读者流失和品牌价值稀释。
真相锁定:核心是体系化侵占
四、对从业者的启示:版权合规的新常态
4.1 AI公司的数据策略需要调整
本案的判决将直接影响AI公司的数据获取策略。如果法院认定未经许可抓取受版权保护内容用于训练构成侵权,AI公司可能需要:
- 建立内容授权机制,与出版商协商授权费用
- 开发过滤系统,识别并排除受版权保护的内容
- 重新评估训练数据的来源合规性
微软在内部文件中曾警告AI可能进入「末日循环」------过度依赖新闻内容导致新闻业崩溃,最终损害AI自身的发展来源。
4.2 内容创作者的议价能力正在上升
时报选择强硬立场,反映了内容创作者对自身价值的重新认识。随着AI生成内容的普及,高质量原创内容的稀缺性上升,创作者的议价能力也在增强。
对于从业者而言,有两点建议:
- 评估数据资产的版权状态:如果你的团队使用外部数据进行训练或分析,需要确认数据来源的合规性。
- 关注行业诉讼进展:本案的判决将形成 precedent,影响整个行业的版权实践。
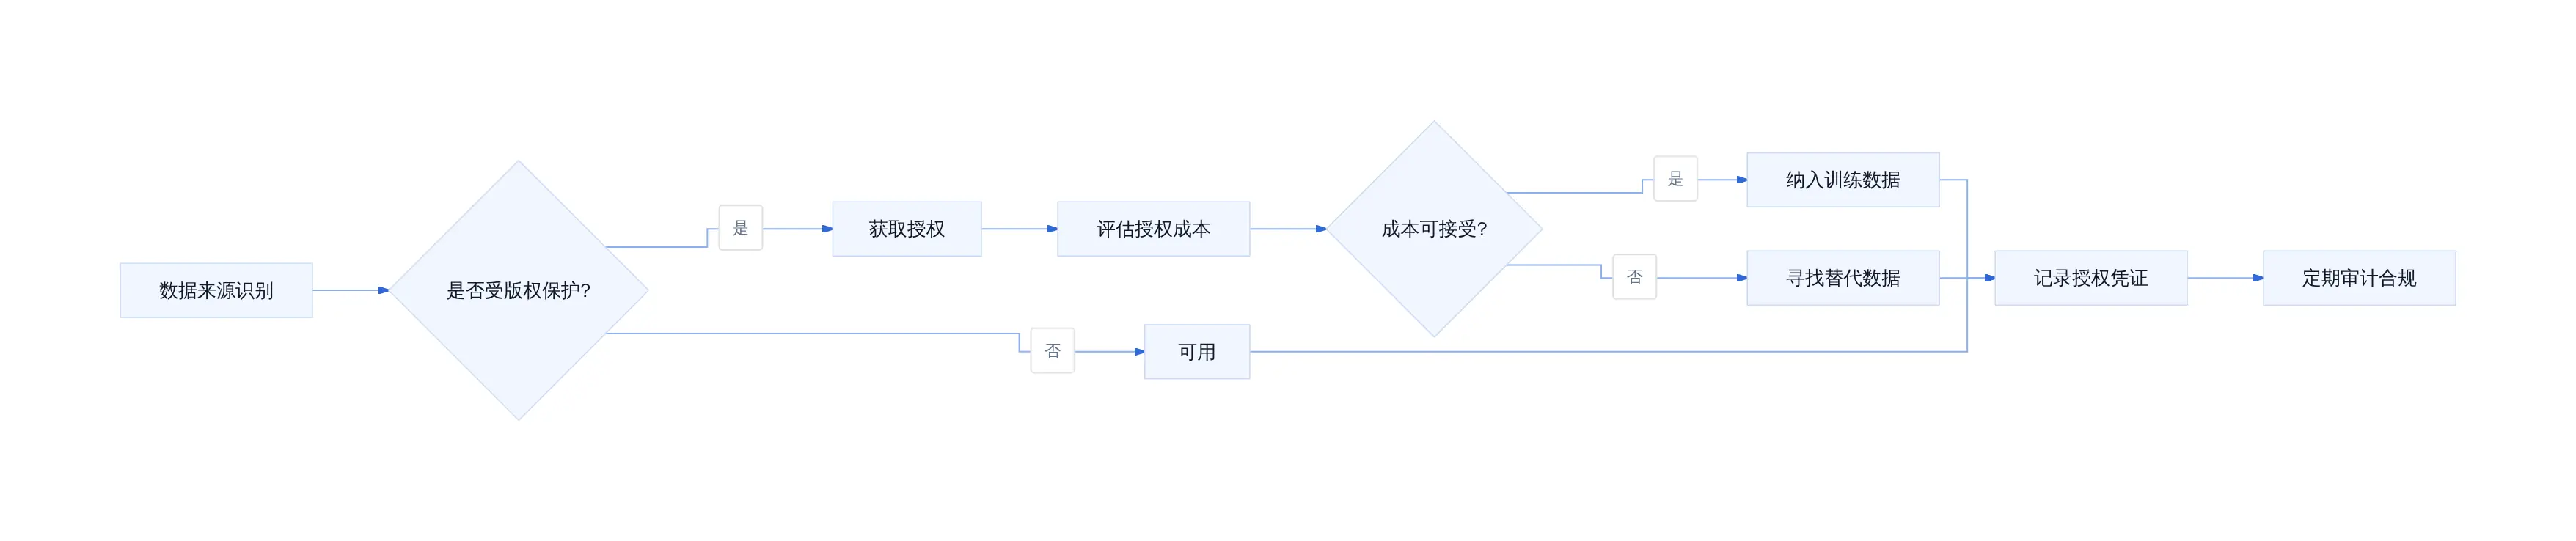
AI数据合规决策路径
这场诉讼的结局尚未可知,但它已经开始重塑AI行业的规则。当技术公司以新闻内容作为燃料时,必须面对一个基本问题:这个燃料是否需要付费?
2023年4月,《纽约时报》与OpenAI就内容授权启动谈判,数月无果后转向诉讼。如今,微软向法院提交了820万条Copilot对话日志,试图证明系统几乎从不直接复现新闻文本------但这恰恰让案件焦点从「复制了多少」转向「复制本身是否合法」
这锅,微软背了
这场诉讼真正要回答的问题
这场诉讼的核心分歧,不在于数据有多小,而在于「偷的方式本身就是问题」这一判断是否成立。微软提交的820万条Copilot对话日志,经筛选后仅有约5.9万条命中16个以上重合词汇,抽样212部著作仅10本存在匹配记录------数字看起来很干净。
逻辑锁死
但纽约时报的论证路径是另一个方向:即便单次重合很少,未经许可将数百万篇受版权保护的新闻内容纳入训练管道,是否构成对新闻劳动体系的系统性侵蚀?这是「量」与「质」的分歧,也是「技术效率」与「创作权利」的深层冲突。
技术公司内部:数据规模远超表面数字
解封文件中披露的内部备忘录揭示了一个更为惊人的事实。OpenAI的中段训练数据集包含超过91,692份来自《纽约时报》《纽约每日新闻》和调查报道中心的作品副本,仅基于Common Crawl的数据集中就有超过200万份来自nytimes.com的文档。微软高管在2023年内部备忘录中称其为「人类历史上最大规模的劳动窃取」
数据本身是证据
。
这些内部警告表明,两家公司的高管层对数据规模的感知,远比公开证据呈现的更为清醒。这也让微软试图以「使用量小」作为抗辩基础的逻辑,显得不够踏实。
行业格局:新闻业存亡与创作者经济的权利博弈
新闻业的生存危机
传统新闻业已经历了二十年的结构性衰退------读者流失、广告收入下滑、调查记者队伍萎缩。《纽约时报》是在线新闻商业模式少数成功案例之一,但也高度依赖订阅和版权收入维持内容产出。当AI模型可以将数百万篇新闻文章直接用于训练,并生成接近或替代原文的输出时,新闻业的护城河正在被系统性削弱。
起诉书中明确提到:「如果纽约时报和其他新闻机构无法制作和保护独立的新闻报道,社会将付出巨大代价。」这不是夸张修辞,而是对新闻业公共职能被侵蚀的现实担忧。
创作者 vs 技术巨头的非对称对抗
结构性失衡
这场诉讼的另一个维度是资源不对称。纽约时报拥有强大的法律团队、充足的资金储备和相对清晰的证据链,但绝大多数独立记者、小型出版社和自媒体创作者并不具备同样的诉讼能力。如果法院在此案中确立「AI训练可豁免于版权授权」的先例,受益的将是极少数技术巨头,而承担成本的将是整个创作者生态。
判例边界将重塑整个行业
两个根本性的问题
此案的判决结果将回答两个关键问题:第一,AI训练行为在何种条件下属于合理使用,何种条件构成侵权;第二,以系统性规模获取受版权保护内容而不支付对价,是否本身就是一种新的侵权形式。
前一个问题已有不少判例可以参考(如Google Books案),但后一个问题涉及的是版权法的边界延伸------传统框架下,合理使用关注的是具体使用行为对原作市场的替代效应,而AI训练的影响发生在更宏观的产业结构层面。
对从业者的判断建议
根据本案进展趋势,可以得出以下判断:短期内此案将以和解或阶段性裁决收场,但判例边界将在此后数年内持续发酵。对于从业者而言,有三条可执行的建议。
第一,内容创作者应明确自身版权授权条款,在可预见的AI使用场景中保留追索权。第二,技术公司应将数据合规成本纳入产品定价模型,而非假设「先用再说」。第三,政策制定者需要推动版权法适应AI时代的框架重构,而非简单套用既有判例。
这场诉讼的真正意义,不在于谁输谁赢,而在于它将决定AI时代的内容价值分配规则。技术公司获得了训练数据,但代价是否是整个内容创作生态的可持续性------这个命题,比820万条日志的数字要沉重得多。
参考文献
- TechCrunch. Microsoft exec called AI scraping 'the largest theft of labor in human history,' new unredacted filings reveal. techcrunch.com/2026/09/17/...
- Ars Technica. Microsoft exec called AI scraping the 'largest theft of labor in human history'. arstechnica.com/tech-policy...
- Superpower Daily. Unsealed NYT Case Filings Expose Internal Warnings at Microsoft and OpenAI. superpowerdaily.com/posts/unsea...