一、场景
在一个SeaTunnel使用流任务获取Kafka topic中的数据时,如果topic从2 个分区扩到了4个分区。结果呢?新分区里的数据,任务一条都消费不到------除非把任务重启一遍。
因为 SeaTunnel 的 Kafka source 默认只会在任务启动时扫描所有分区。
虽然重启可以重新扫描分区,但是还是会有一下问题
- 重启期间整个任务暂停,如果使用checkpoint还原,可能会有数据遗漏;
- start_mode = earliest时,重启后所有分区从头消费,历史数据重放一遍,会有重复数据。
SeaTunnel 官方提供了 partition-discovery.interval-millis 参数:定时扫描 Kafka,发现新分区自动纳入消费,任务不用重启。
二、实战
1、环境准备
- Kafka 集群
- SeaTunnel 2.3.12
2、创建 2 分区的 topic
bin/kafka-topics.sh --create --topic ksource \
  --bootstrap-server ip:9092 \
  --partitions 2 --replication-factor 1
3、编写 SeaTunnel 流任务配置(job/k.conf)
关键配置就三个点:
job.mode = "STREAMING"
显式开启 checkpoint.interval
partition-discovery.interval-millis = 5000。

env {
  parallelism = 2
  job.mode = "STREAMING"
  checkpoint.interval = 5000
}
source {
  Kafka {
    bootstrap.servers = "ip:9092"
    topic = "ksource"
    consumer.group = "seatunnel_k_group"
    partition-discovery.interval-millis = 5000
    start_mode = "EARLIEST"
    format = "json"
    schema = {
      fields {
        id = INT
        cusname = STRING
        amount = DOUBLE
      }
    }
  }
}
sink {
  Console {}
}
说明:
- partition-discovery.interval-millis = 5000:每 5 秒扫描一次 Kafka,发现新分区;
- start_mode = EARLIEST:发现新分区时,从最早开始消费。
- schema 字段类型:INT、STRING、DOUBLE 都是基础类型,直接写即可。
4、启动任务,先验证正常消费
启动 SeaTunnel 任务(本地模式):
bin/seatunnel.sh --config job/k.conf -m local另开一个终端,往 ksource 生产 3 条消息(扩容前 topic 只有 2 个分区,消息轮询分布到 0/1):
bin/kafka-console-producer.sh --broker-list ip:9092 --topic ksource输入(每行一条):
{"id":1,"cusname":"张三","amount":100.50}
{"id":2,"cusname":"李四","amount":200.00}
{"id":3,"cusname":"王五","amount":300.00}
任务控制台出现对应输出,说明消费正常。
5、执行扩容:2 分区 → 4 分区
bin/kafka-topics.sh --alter --topic ksource \
  --bootstrap-server ip:9092 \
  --partitions 4
确认结果:
bin/kafka-topics.sh --describe --topic ksource \
  --bootstrap-server ip:9092
6、生产数据,看新分区是否被消费
继续往 ksource 生产 6 条消息(不指定 key,轮询会分布到全部 4 个分区,其中约一半落到新分区 2/3):
bin/kafka-console-producer.sh --broker-list ip:9092 --topic ksource输入:
{"id":4,"cusname":"赵六","amount":400.00}
{"id":5,"cusname":"孙七","amount":500.00}
{"id":6,"cusname":"周八","amount":600.00}
{"id":7,"cusname":"吴九","amount":700.00}
{"id":8,"cusname":"郑十","amount":800.00}
{"id":9,"cusname":"钱十一","amount":900.00}
任务控制台陆续输出这 6 条消息------包括落在新分区 2/3 上的消息。任务没有重启,新分区的数据被自动消费了。
7、对比实验:不配动态发现会怎样
把配置里的 partition-discovery.interval-millis 删掉,重复第 4~6 步:
- 扩容前生产的消息:正常消费;
- 扩容后生产、落在新分区 2/3 上的消息:永远不出现;
- 只有重启任务,新分区的数据才会被消费。
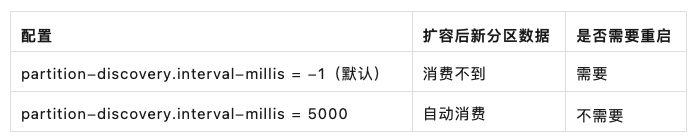
两种配置的差异一览:
三、注意事项
- 新分区消费位置由 start_mode 决定:新分区没有 checkpoint 位点,earliest会把新分区从最早开始消费(分区里有存量数据的话会被全部读一遍);latest只消费新数据。
- 间隔别设太小:每次扫描都会对 Kafka 集群发送元数据请求,值越小,发现得越快、集群压力越大。一般 5 秒起步,分区变更不频繁的可以放到 30~60 秒。
- 分区只能增不能减:Kafka 不支持缩减分区(会丢数据)。
- 扩容会触发消费者重平衡:分区数变化时,消费者组重新分配分区,消费短暂抖动,属正常现象。
- 旧分区数据不受影响:动态发现只解决"新分区",旧分区继续按 checkpoint 位点消费,不会重读。
- 带精度的类型必须加引号: decimal(10,2)、array、map<string, int>
这类含逗号/尖括号的类型声明都要加双引号,否则 HOCON 解析直接报错。
四、总结
partition-discovery.interval-millis 解决的是"Kafka topic 动态扩容"场景下的自动感知问题:配一个正数间隔,SeaTunnel 流任务就能在运行期间定时发现新增分区并自动消费,不用重启、不丢数据、不重放历史。
配套的三个点记住就行:流模式 + 开 checkpoint + 间隔设为正数。新分区的起点看 start_mode,扫描频率和集群负载之间自行权衡。
来源 | 数仓生态圈