千笔-AIWritePaper · https://www.aiwritepaper.com
把 Agents SDK 的 sessions 当成「自动记得上一句」很容易过界:它管的是客户端会话历史的取回与写回 ,不是业务授权、不是 OpenAI 服务端续写、更不是「进程重启后一定还在」。官方 Sessions 写得很直:同一次 run 里,session 不能 与 conversation_id / previous_response_id / auto_previous_response_id 叠用;跑前取历史、跑后只持久化本轮新 item;SessionSettings(limit=N) 只裁剪送入模型的取回量 ,不等于改写库里旧记录;session_input_callback 可改合并策略,但仍只持久化本轮。本文按工程笔记再核对记忆边界、可跑 smoke 与生产禁区。示例模型名写作 gpt-4o,以你账号可用快照与官方文档为准。
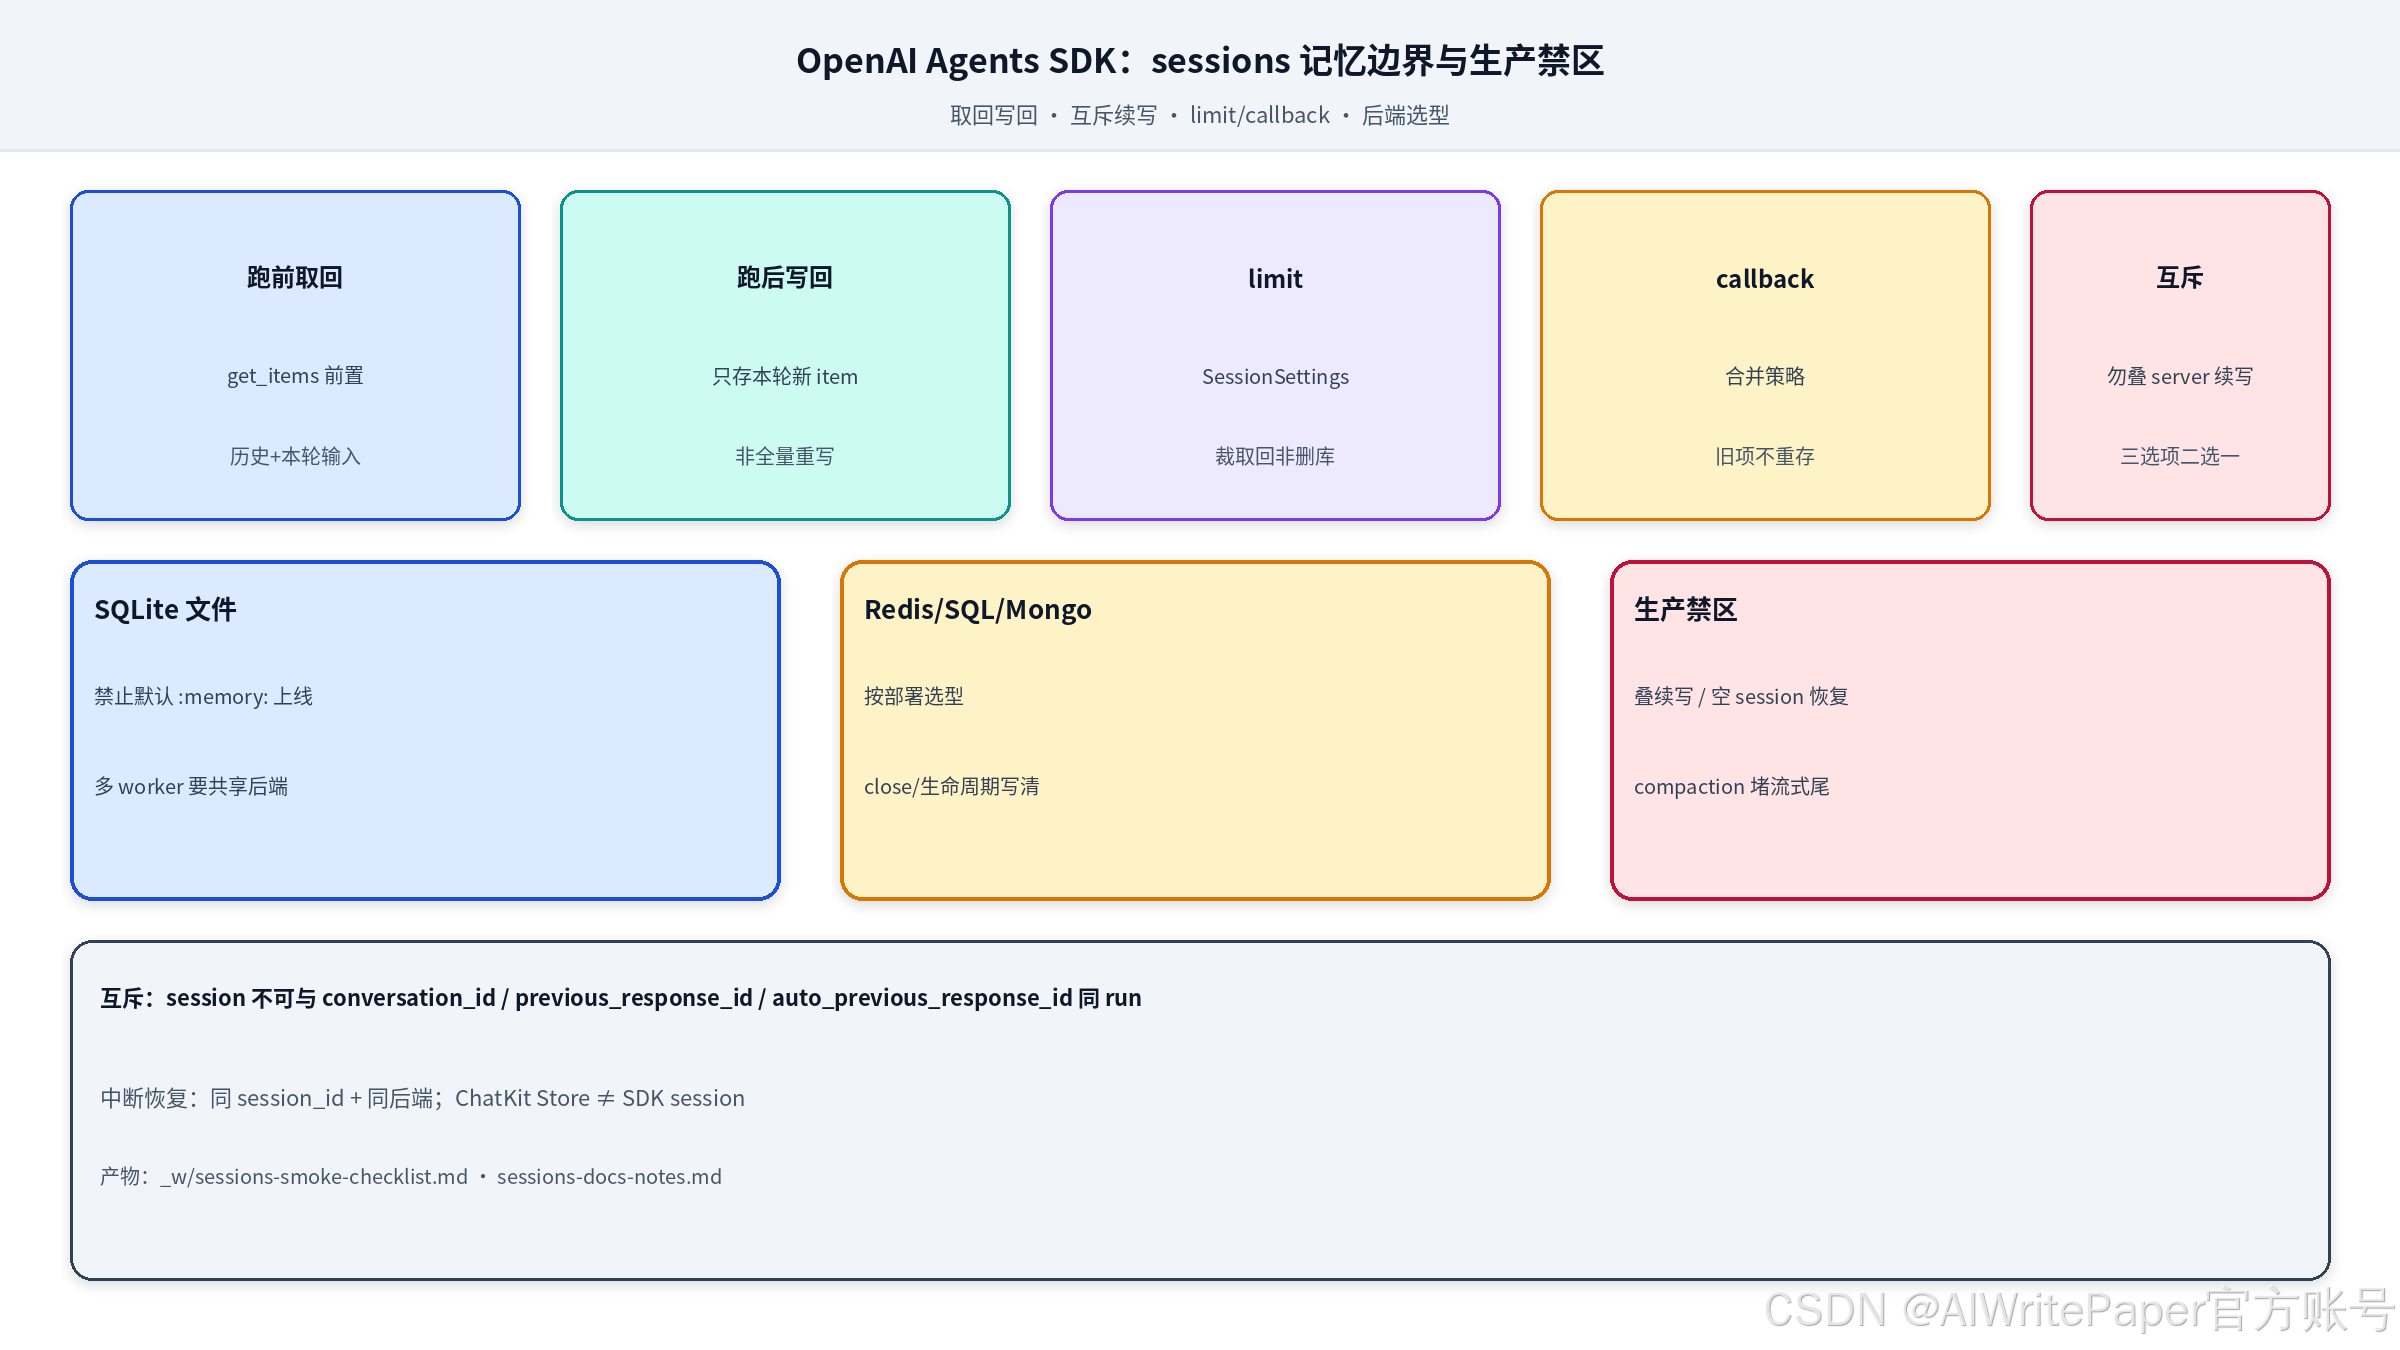
图:上方 sessions 行为;中部互斥与 limit/callback;下方后端选型与生产禁区。
目标说明
读完你应能独立完成五件事:
- 用一句话说清:同一
session_id下,Runner 跑前取历史并前置,跑后把本轮新 item 写入 session。 - 写出可跑片段:
SQLiteSession两轮对话 +RunConfig(session_settings=SessionSettings(limit=...))smoke。 - 钉死互斥:同 run 不可把 session 与 server 续写三选项叠用;要服务端托管就换机制,不要「再加一层 session」。
- 分清
limit(取回上限)与session_input_callback(合并策略):二者都不等于「删库」或「旧历史被再次当新输入存回去」。 - 列出生产禁区:默认
:memory:当持久化、多 worker 共用内存 SQLite、把 ChatKit Store 与 SDK session 当同一东西、压缩会话在流式尾部阻塞却当丢事件。
规格钉死(对照官方 Sessions):
- 行为:Before run 取历史并前置;After run 持久化本轮新 item(用户输入、助手回复、工具调用等)。
- 互斥 :同一次 run,
session不可与conversation_id/previous_response_id/auto_previous_response_id组合。 - 取回控制 :
SessionSettings(limit=None)默认全量;limit=N只取最近 N 条;可经RunConfig.session_settings按轮覆盖。 - 合并回调 :
RunConfig.session_input_callback(history, new_input) -> list;返回值控制本轮模型输入;持久化仍只落本轮新 item。 - 后端 :
SQLiteSession/AsyncSQLiteSession/RedisSession/SQLAlchemySession/MongoDBSession/DaprSession/OpenAIConversationsSession/OpenAIResponsesCompactionSession/EncryptedSession等,按部署选,不要默认内存库上生产。
适用边界
适合上 sessions
- 多轮客服 / 助手:希望 SDK 代管历史,而不是每轮手写
.to_input_list()。 - 同一用户多 Agent 共享一条会话线程(官方允许不同 Agent 共用同一 session)。
- 需要本地或自有库持久化:文件 SQLite、Postgres(SQLAlchemy)、Redis、Mongo、Dapr 等。
- 长对话要裁剪上下文:用
limit或session_input_callback控制送入,而不是每次手工拼 prompt。
更适合别的机制(不要硬指望 sessions)
- OpenAI 服务端续写 :用
conversation_id/previous_response_id/auto_previous_response_id,不要与 session 同 run 叠用。 - ChatKit 线程持久化 :官方写明 SDK session 不是 ChatKit
Store的即插替换。 - 业务审计 / 授权真源:session 存的是对话 item,不是「谁有权看这笔订单」的授权日志。
不该指望它单独搞定
- 进程内
:memory:跨重启:默认无文件路径即内存库,进程结束即丢。 - limit 当合规删除 :
limit只影响取回;库内旧 item 仍在,除非你clear_session/ 后端 TTL / 自管删除。 - callback 改序等于改库:官方说明过滤/重排旧历史不会把旧 item 再当新输入存一遍。
- 压缩包装 = 零延迟流式 :
OpenAIResponsesCompactionSession自动压缩可能在流结束后续等几秒;低延迟场景应关自动压缩、空闲时run_compaction()。
风险提示
生产把「每个请求 SQLiteSession(user_id) 且无文件路径」配到多 worker:各进程内存库互不可见,用户会感觉「随机失忆」。把 session 与 previous_response_id 同 run 叠用,会踩官方互斥。中断审批恢复必须用同一 session 实例或同 ID + 同后端,否则恢复轮看不到原历史。
步骤与机制
1. 记忆边界对照
| 机制 | 做什么 | 不做什么 |
|---|---|---|
session |
客户端历史取回/写回 | 不替代业务授权 |
| server 续写三选项 | OpenAI 侧续写链 | 不与 session 同 run |
SessionSettings.limit |
限制取回条数 | 不自动物理删库 |
session_input_callback |
自定义 history+new 合并 | 不把旧 item 再存成新输入 |
pop_item / clear_session |
纠正末条 / 清空 | 不等于服务端遗忘 |
| Compaction wrapper | 压缩长历史 | 不包 OpenAIConversationsSession |
2. 可跑 smoke:两轮记忆 + limit
先 pip install openai-agents,并导出 OPENAI_API_KEY。下面用文件 SQLite,避免把内存库误当持久化。
python
import asyncio
from pathlib import Path
from agents import Agent, Runner, RunConfig, SQLiteSession, SessionSettings

MODEL = "gpt-4o"  # 占位:以账号可用快照为准
DB = Path("tmp_session_smoke.db")

async def main() -> None:
    agent = Agent(
        name="Geo",
        instructions="用一两句回答;不要编造未给出的数字。",
        model=MODEL,
    )
    session = SQLiteSession("smoke_thread_001", str(DB))
    cfg = RunConfig(
        session_settings=SessionSettings(limit=20),  # 只取最近 20 条送入
    )
    r1 = await Runner.run(
        agent,
        "金门大桥在哪座城市?",
        session=session,
        run_config=cfg,
    )
    r2 = await Runner.run(
        agent,
        "它在哪个州?只答州名。",
        session=session,
        run_config=cfg,
    )
    items = await session.get_items()
    print("ok", bool(r1.final_output), bool(r2.final_output), "n_items", len(items))

if __name__ == "__main__":
    asyncio.run(main())
验收:进程无异常;第二轮能承接第一轮城市语境(有 key 时);get_items() 长度随轮次增加。无 key 时至少应能 import,并确认构造用了文件路径而非默认 :memory:。
3. 合并回调(可选)
需要「只保留最近 10 条历史再拼本轮」时:
python
def keep_recent_history(history, new_input):
    return history[-10:] + new_input

cfg = RunConfig(session_input_callback=keep_recent_history)
记住:返回列表只影响本轮模型输入;SDK 仍只持久化本轮新 item。
4. 后端选型速查
| 类型 | 更合适 | 生产注意 |
|---|---|---|
SQLiteSession 文件 |
单机 / 本地开发 | 别用默认内存库上线 |
RedisSession |
多 worker 共享 | from_url 拥有客户端;close() 后终端态 |
SQLAlchemySession |
已有 Postgres 等 | create_tables 与迁移策略分开 |
MongoDBSession |
已有 Mongo / 多进程 | 批文档大小上限;ping() 先连通 |
OpenAIConversationsSession |
愿把历史放 OpenAI | 与本地 session 二选一思路,勿盲目双写 |
OpenAIResponsesCompactionSession |
长对话压缩 | 勿包 ConversationsSession;流式注意阻塞 |
EncryptedSession |
需加密+TTL | 先选底层再包;密钥轮换自管 |
完整对照与自定义 Session 协议见官方文档;自定义实现需提供 get_items / add_items / pop_item / clear_session(可选 wrapper 关键字以接 RunContext)。
生产禁区
- 默认
:memory:当持久会话:进程一挂用户全忘。 - 多副本共用本地 SQLite 文件无锁策略:并发写与「偶发丢轮」难排。
- 同 run 叠 session + previous_response_id:踩互斥。
- 把 limit=0 / 很小 limit 当「已脱敏删除」:库内仍可能有全文。
- compaction 自动开着却要求流式毫秒级收尾:尾部等待被误判成丢事件。
- 中断恢复换了另一个空 session:审批续跑看不到原历史。
- SDK session 当 ChatKit Store:线程/item 模型不同,勿即插替换。
- EncryptedSession 密钥写进镜像层且无 TTL 策略:等于把密文密钥和明文历史一起交出去。
可验证清单
- smoke 使用文件路径或明确的共享后端,而不是默认可丢的内存库。
- 第二轮问题在无复述城市名时仍能答对州(有 key)。
-
RunConfig.session_settings.limit已写入且能解释「只裁取回」。 - 代码审查确认未与 server 续写三选项同 run。
- 若用 compaction:写明自动/手动策略与流式延迟预期。
- 产物:
_w/sessions-smoke-checklist.md、sessions-docs-notes.md。
踩坑
- 「我传了同一个 session_id 却不记得」 :可能是内存库 + 多进程,或两处
db_path不一致。 - 「callback 过滤了还是爆上下文」:过滤的是送入列表;工具大输出仍可能在本轮新 item 里。
- 「pop 两次想改问题」:官方示例是先 pop 助手再 pop 用户;少 pop 一次会留下脏轮。
- 「ConversationsSession 再包 compaction」:官方明确不要这样包。
总结
sessions 的工程价值是:少手写历史拼接,多显式边界 。边界三句话就够用------同 run 不与 server 续写叠用;limit/callback 管送入不自动等于删库;生产选后端先问「进程挂了 / 多 worker / 要不要加密 TTL」再写代码。把这三条写进评审清单,比再加一层「智能记忆」口号管用。对照官方 Sessions 页做 smoke,把禁区留在 PR 描述里,比上线后再查「为什么用户随机失忆」便宜得多。
生产禁区表(评审用)
| 禁区 | 为什么危险 | 正确做法 |
|---|---|---|
默认 :memory: 上线 |
重启失忆;多 worker 互不可见 | 文件路径或 Redis/SQL/Mongo |
| 同 run 叠 server 续写 | 官方互斥 | 二选一:session 或 conversation_id 等 |
limit 当删除合规 |
库内仍有全文 | 真删除走 clear/TTL/自管策略 |
| callback 过滤当脱敏 | 只改送入,不改存储 | 存储层加密或 EncryptedSession |
| Compaction 包 ConversationsSession | 官方禁止 | 换 underlying 本地/自有库 |
| 中断恢复换空 session | 续跑无历史 | 同 ID + 同后端 |
| SDK session = ChatKit Store | 模型不同 | 各用各的持久化 |
| 密钥写进镜像 | 密文形同虚设 | KMS/环境注入 + 轮换 |
与 server 续写的选型口诀
需要「客户端可控、可换库、可 pop/clear」→ sessions。
需要「OpenAI 托管续写链、少自管存储」→ conversation_id / previous_response_id / auto_previous_response_id。
同一次 Runner.run 不要叠。 迁移期可以按请求路由:老线程走 server 续写,新线程走 session,但单个请求内部保持单一机制。
中断与审批恢复
官方示例:run 出现 interruptions 时,to_state() → approve → 再 Runner.run(agent, state, session=session)。关键是 session 实例或同 ID 同后端 。常见失败:审批服务把 state 存了,却 new 了一个空的 SQLiteSession(same_id) 且连的是另一份 db 文件------表面同 ID,实际空历史。
恢复检查三问:
- session_id 是否同一?
- db_path / Redis URL / engine 是否同一?
- 恢复前
get_items()长度是否符合预期?
Compaction 与流式
OpenAIResponsesCompactionSession 在自动压缩开启时,可能在流式事件结束后仍等待压缩完成。低延迟客服:should_trigger_compaction=lambda _: False ,在回合间隙或空闲任务调用 run_compaction({"force": True})。store=False 的无状态设置下,默认 auto 模式会偏向 input 基压缩------以你锁定版本文档为准,升级后重跑 smoke。
自定义 Session 最小协议
不必继承 ABC;提供:
session_idsession_settings(可 None)get_items/add_items/pop_item/clear_session
若四个方法都声明关键字参数 wrapper: RunContextWrapper | None,SDK 会传入运行上下文,便于多租户路由。只用 **kwargs 不算满足签名。现有无 wrapper 的实现保持兼容。
十分钟排障剧本
- 打印
type(session)与db_path(或后端 URL),确认非意外内存库。 - 跑两轮问题,第二轮省略实体名,看是否仍答对。
- 设
SessionSettings(limit=2)再跑长历史会话,确认行为符合「只取最近」。 - 故意尝试与
previous_response_id同 run(仅在测试环境),确认团队理解互斥。 - 若用 Redis:
close()后再调用应失败;文档写清生命周期。
最小回归(贴进 PR)
- 新增会话功能是否写明后端与持久化?
- 生产配置是否禁止默认
:memory:? - 是否声明未与 server 续写三选项同 run?
- 长对话是否有 limit 或 callback 策略?
- 中断恢复路径是否测过同后端?
团队约定建议
- 命名 :
session_id用user_/thread_/ticket_前缀,禁止裸test。 - 库文件 :开发用
tmp/,生产用托管盘路径或托管库。 - 多 Agent 共享:允许,但要在设计文档写清「谁写、谁读、谁 clear」。
- 加密 :PII 会话默认评估
EncryptedSession或字段级加密。 - 升级 SDK :重跑
_w/sessions-smoke-checklist.md,记录 limit/compaction 行为 diff。
失败含义(写进 oncall)
| 现象 | 含义 | 动作 |
|---|---|---|
| 用户随机失忆 | 多 worker 内存库或路径不一致 | 查后端与副本 |
| 上下文突然变短 | limit/callback 过猛 | 调参并看 get_items 全量 |
| 恢复审批后胡说 | session 空 | 核同后端 |
| 流式尾部卡住数秒 | compaction 等待 | 改手动压缩 |
| dashboard/业务都正常但「不记得」 | 看错 session_id | 对日志打 ID |
文档锚点
- Sessions 主文:行为、互斥、limit、callback、后端表、自定义协议。
- 各后端专页:SQLAlchemy / Encrypted / Advanced SQLite 等。
本文示例为工程 smoke,不构成官方 SLA。字段以你锁定的 SDK 小版本文档为准;升级后以官方页为准重核,而不是凭记忆口算「应该还一样」。
去掉任何产品名,读者手里仍应剩下:可跑 smoke、互斥规则、禁区表与官方 Sessions 链接。这才是冲 tracing/guardrails 同档(88--91)技术文该有的可验收密度。