深度学习常用公式手册
按章节整理的深度学习核心公式,公式采用论文常用格式(LaTeX 排版) 。每条公式包含:公式 → 符号说明 → 应用场景 → PyTorch 实现 → 图形 。
符号读音/含义速查见《深度学习符号速查表》。
章节目录
- 激活函数
- 归一化
- 损失函数
- 优化器与学习率调度
- 正则化
- 卷积与池化
- 序列模型与注意力
- 强化学习
- 生成模型
- 附录 A:公式-API 速查表
- 附录 B:公式图像集(函数曲线/图形)
第一章 激活函数
1.1 Sigmoid
公式
σ ( x ) = 1 1 + e − x , σ ′ ( x ) = σ ( x ) ( 1 − σ ( x ) ) \sigma(x) = \frac{1}{1 + e^{-x}}, \qquad \sigma'(x) = \sigma(x)\big(1 - \sigma(x)\big) σ(x)=1+e−x1,σ′(x)=σ(x)(1−σ(x))
符号说明 :把任意实数压缩到 ( 0 , 1 ) (0, 1) (0,1),可解释为概率;导数最大仅 0.25 0.25 0.25,深层网络中连乘易梯度消失。
应用场景:二分类输出层;LSTM/GRU 的门控(遗忘门、输入门);任何需要"开关概率"的地方。隐藏层已基本弃用(梯度消失)。
PyTorch
python
import torch
import torch.nn.functional as F

logits = torch.randn(8)                 # 8 个样本的二分类原始得分(任意形状均可)
p = torch.sigmoid(logits)               # 逐元素压到 (0,1) → 可视为 P(y=1|x)
print(p.shape)                          # (8,):与输入同形,sigmoid 不改变形状

# ⚠ 实战不要写 F.binary_cross_entropy(sigmoid(z), y)(先σ再log,p≈0时log下溢−inf):
loss = F.binary_cross_entropy_with_logits(logits, y)
# 该版本内部用 log-sigmoid 直接算 log σ(z):数值稳定且少一次指数运算

g = torch.sigmoid(x)                    # 另一主战场:LSTM/GRU 的门(输出当 0~1 开关用)
代码解读
torch.sigmoid是纯逐元素函数,梯度 σ ( 1 − σ ) \sigma(1-\sigma) σ(1−σ) 由 autograd 自动接上,无需手写;..._with_logits是官方推荐的稳定写法:把 log σ ( z ) \log\sigma(z) logσ(z) 合并成一个 kernel,避免中间概率下溢;- 分工:推理 要概率时取
p;训练 算损失时永远把logits直接交给损失函数。
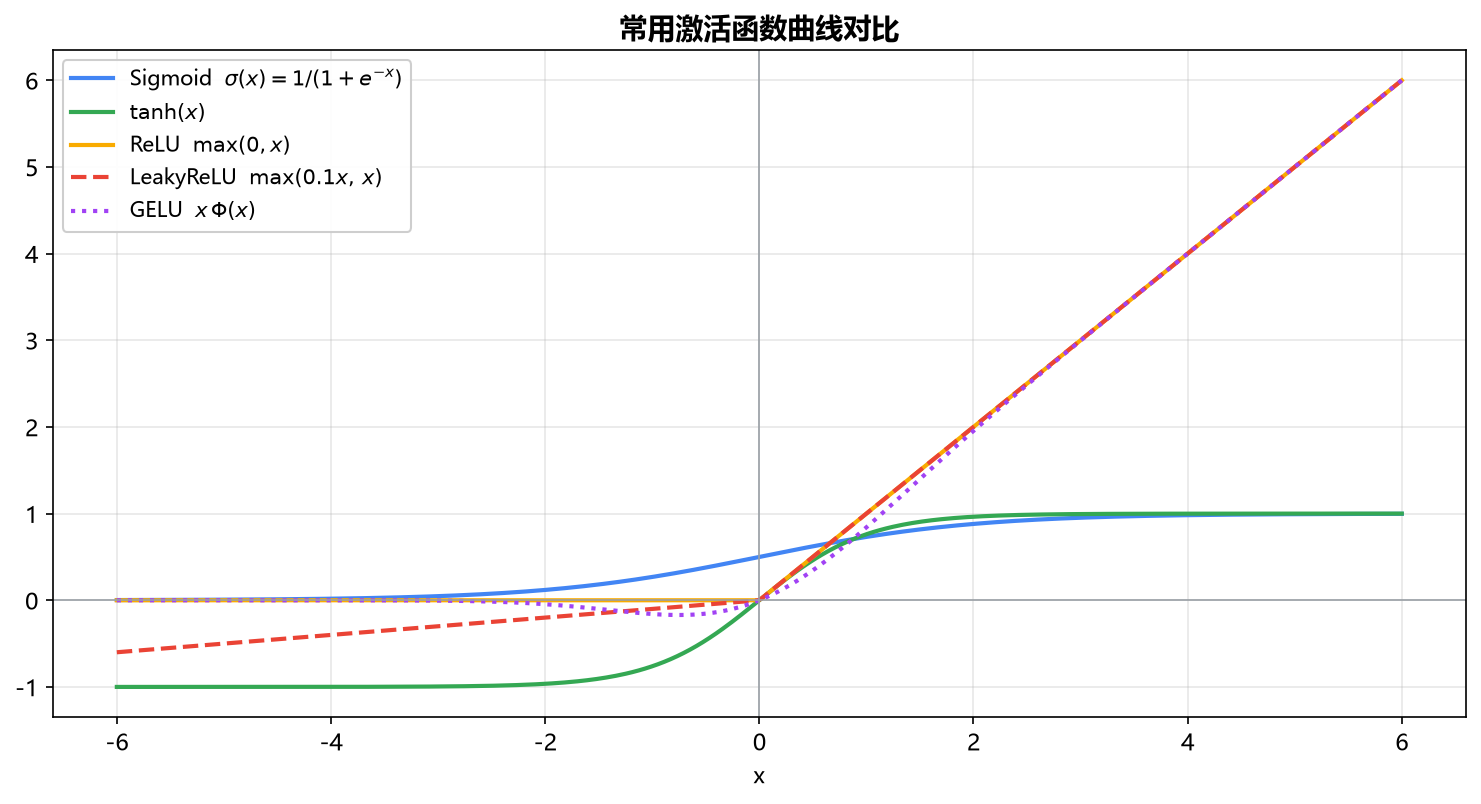
示意图 :曲线形状见 formula_activations.png(蓝线,两端饱和);导数峰值仅 0.25 见 graph_act_deriv.png
图形 :见 formula_activations.png(蓝色曲线,两端饱和);导数曲线见附录 B.1
1.2 tanh
公式
tanh ( x ) = e x − e − x e x + e − x = 2 σ ( 2 x ) − 1 , tanh ′ ( x ) = 1 − tanh 2 ( x ) \tanh(x) = \frac{e^{x} - e^{-x}}{e^{x} + e^{-x}} = 2\sigma(2x) - 1, \qquad \tanh'(x) = 1 - \tanh^{2}(x) tanh(x)=ex+e−xex−e−x=2σ(2x)−1,tanh′(x)=1−tanh2(x)
符号说明 :零中心化(输出均值 ≈ 0 \approx 0 ≈0)的 S 形函数,值域 ( − 1 , 1 ) (-1, 1) (−1,1);梯度峰值为 1 1 1,是 sigmoid 的 4 倍,但仍会饱和。
应用场景:RNN 默认隐藏激活;LSTM 的候选记忆与输出变换;需要输出有正有负的场景。
PyTorch
python
h = torch.tanh(z)                       # 逐元素压到 (−1,1),输出零中心化
rnn = torch.nn.RNN(input_size=128, hidden_size=256)
out, h_n = rnn(x)                       # 其内部隐藏层即 h_t = tanh(W_hh h_{t−1} + W_xh x_t + b)
# 选 tanh 而非 sigmoid 的原因:导数峰值 1 vs 0.25,且输出均值≈0(下游层输入不偏置)
代码解读
nn.RNN不需要显式写 tanh------模块内部已按公式 7.1 组装好,out是全部时刻隐藏态、h_n是末时刻状态;- 若想让 RNN 换激活(如 ReLU),构造时传
nonlinearity='relu'(仅nn.RNN支持,LSTM 固定)。
示意图 :tanh 曲线见 formula_activations.png(绿线,零中心 S 形)
图形 :见 formula_activations.png(绿色曲线)
1.3 ReLU 及其变体
公式
R e L U ( x ) = max ( 0 , x ) , L e a k y R e L U ( x ) = max ( α x , x ) , G E L U ( x ) = x Φ ( x ) \mathrm{ReLU}(x) = \max(0,\, x), \qquad \mathrm{LeakyReLU}(x) = \max(\alpha x,\, x), \qquad \mathrm{GELU}(x) = x\,\Phi(x) ReLU(x)=max(0,x),LeakyReLU(x)=max(αx,x),GELU(x)=xΦ(x)
符号说明 : Φ \Phi Φ 为标准正态分布的 CDF;ReLU 正区间梯度恒为 1 1 1 → 不衰减、计算零成本,代价是 x < 0 x<0 x<0 时梯度为 0 0 0("死神经元");LeakyReLU( α = 0.01 \alpha=0.01 α=0.01)与 GELU 修复负区间。
应用场景:ReLU = CNN/MLP 隐藏层默认;LeakyReLU 用于担心死神经元的深层网络;GELU = Transformer(BERT/GPT)默认。
PyTorch
python
import torch.nn.functional as F

z = torch.randn(64, 256)                  # 某层预激活值 (B=64, 特征=256)
h = F.relu(z)                             # 负半轴直接置 0:输出稀疏、正区间梯度恒 1
h = F.leaky_relu(z, negative_slope=0.01)  # 负半轴留 0.01 斜率 → 修"死神经元"
h = F.gelu(z)                             # 平滑版 x·Φ(x):BERT/GPT 的 FFN 默认

model = torch.nn.Sequential(              # 模块式写法:按顺序堆叠成网络
    torch.nn.Linear(784, 256), torch.nn.ReLU(),   # 惯例:Linear 后紧跟激活
    torch.nn.Linear(256, 10),
)
代码解读
F.*是无状态函数(用完即走),nn.*是可嵌入 Sequential 的模块------激活函数无参数,两者行为完全相同;- "死神经元":某神经元一旦输入恒负,ReLU 梯度恒 0 → 该神经元永久停更新;LeakyReLU 的小斜率保留梯度通路;
- GELU 按概率"软门控"(值越大越放行),曲线光滑 → 优化更稳,是 Transformer 的经验默认。
示意图 :四种激活的曲线对比见 formula_activations.png
图形
第二章 归一化
2.1 BatchNorm(批归一化)
公式
μ B = 1 m ∑ i = 1 m x i , σ B 2 = 1 m ∑ i = 1 m ( x i − μ B ) 2 \mu_{\mathcal{B}} = \frac{1}{m}\sum_{i=1}^{m} x_i, \qquad \sigma_{\mathcal{B}}^{2} = \frac{1}{m}\sum_{i=1}^{m} (x_i - \mu_{\mathcal{B}})^{2} μB=m1i=1∑mxi,σB2=m1i=1∑m(xi−μB)2
x ^ i = x i − μ B σ B 2 + ϵ , y i = γ x ^ i + β \hat{x}i = \frac{x_i - \mu{\mathcal{B}}}{\sqrt{\sigma_{\mathcal{B}}^{2} + \epsilon}}, \qquad y_i = \gamma\, \hat{x}_i + \beta x^i=σB2+ϵ xi−μB,yi=γx^i+β
符号说明 :统计在一个 mini-batch B \mathcal{B} B(大小 m m m)内进行; ϵ ≈ 10 − 5 \epsilon \approx 10^{-5} ϵ≈10−5 防除零; γ , β \gamma, \beta γ,β 为逐特征可学习的缩放/平移,恢复表达能力。推理时改用训练期滑动平均的全局统计量。
应用场景 :CNN/MLP 加速收敛、允许更大学习率、缓解内部协变量偏移;对 batch 大小敏感( m = 1 m=1 m=1 时失效)。
PyTorch
python
bn = torch.nn.BatchNorm1d(256)      # 声明: 256 组可学习 (γ,β) + 2 份滑动平均统计 (running_mean/var)
z = torch.randn(32, 256)            # (B=32, 特征=256)
h = bn(z)                           # 训练态: 沿 B 维算 μ,σ → 逐列归一化 → γx̂+β
print(bn.running_mean.shape)        # (256,):训练期累积的全局统计,推理时用它

bn2d = torch.nn.BatchNorm2d(64)     # CNN 版: 输入 (B,64,H,W),沿 (B,H,W) 统计、每通道一组参数
model.eval()                        # ⚠ 切换: 推理改用 running 统计且不再更新;忘记切 = 结果随机漂移
代码解读
- 构造函数参数 = 通道/特征数 (不是 batch 大小);每个特征独享一对 ( γ , β ) (\gamma,\beta) (γ,β);
- 训练/推理双模式是 BN 最大的坑:训练用"当前 batch 统计"(有噪声但自适应),推理用"滑动平均统计"(确定性强),靠
train()/eval()切换; - batch=1 时训练态方差无意义 → BN 失效,小 batch 请换 LayerNorm 或 GroupNorm。
示意图
BatchNorm 的统计方向(对 (B,256) 张量):
  样本1 [ x  x  x ... ]      每一"列"= 同一特征在不同样本上的取值
  样本2 [ x  x  x ... ]  →   μ,σ 按列计算 → 得到 256 对统计量
  ...                        再逐列归一化: x̂=(x−μ)/√(σ²+ε)
  样本32[ x  x  x ... ]      最后 y = γx̂+β(可学习,恢复表达能力)
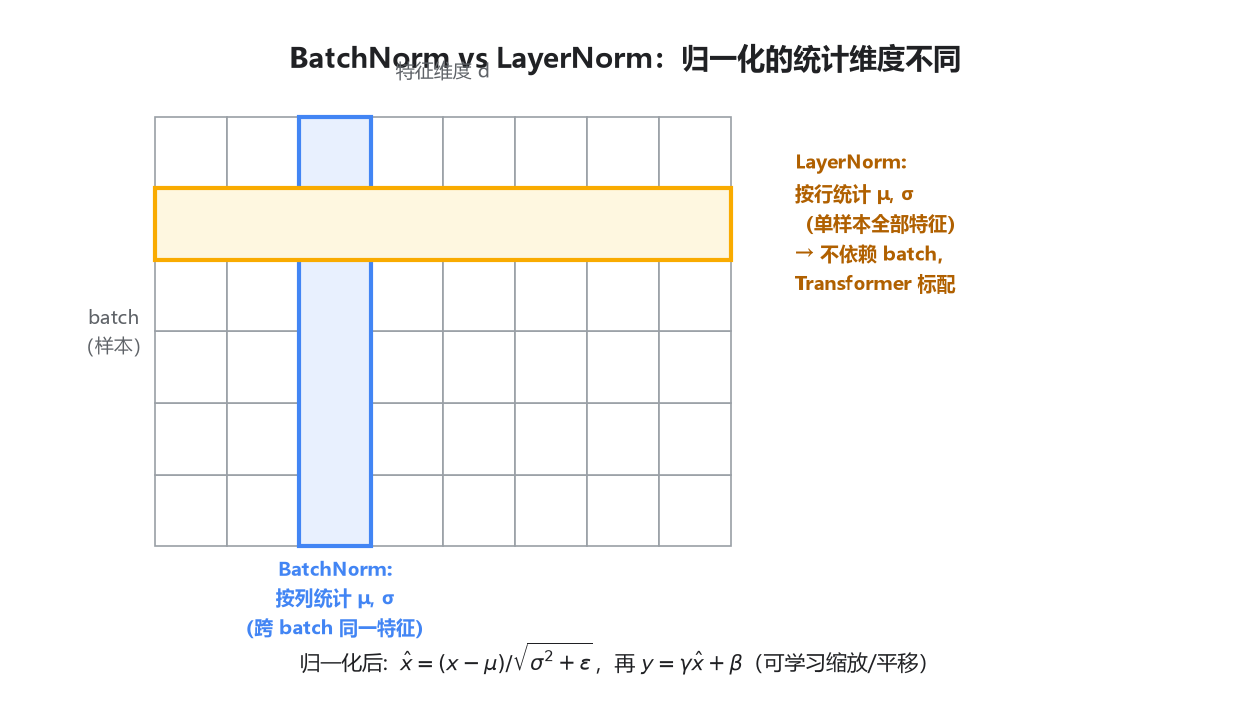
配图见 formula_norm.png(蓝色高亮列)与 graph_norm_hist.png(归一化前后直方图)
图形 :见 formula_norm.png(蓝色列 = BN 的统计方向);归一化前后分布见附录 B.3
2.2 LayerNorm(层归一化)
公式
μ = 1 d ∑ j = 1 d x j , σ 2 = 1 d ∑ j = 1 d ( x j − μ ) 2 , y = γ σ 2 + ϵ ( x − μ ) + β \mu = \frac{1}{d}\sum_{j=1}^{d} x_j, \qquad \sigma^{2} = \frac{1}{d}\sum_{j=1}^{d} (x_j - \mu)^{2}, \qquad y = \frac{\gamma}{\sqrt{\sigma^{2} + \epsilon}}\,(x - \mu) + \beta μ=d1j=1∑dxj,σ2=d1j=1∑d(xj−μ)2,y=σ2+ϵ γ(x−μ)+β
符号说明 :统计维度从"跨 batch"换成"单样本的 d d d 个特征",因此与 batch 大小无关。
应用场景:Transformer 标配(每个 token 独立归一化);RNN;batch 很小的场景。
PyTorch
python
ln = torch.nn.LayerNorm(512)        # 参数 = 归一化形状: 对最后一维(512 个特征)算 μ,σ
x = torch.randn(32, 10, 512)        # (B, T, d): 32 条序列 × 10 个 token × 512 维
h = ln(x)                           # 每个 (b,t) 行独立归一化 → 320 组统计量互不干扰
# 与 BN 的关键差异: 无 running 统计、无 train/eval 差异 → 不存在"忘记切模式"的坑
代码解读
- 构造参数可以是元组做多维归一化,如
LayerNorm((10, 512))对最后两维一起统计; - 统计只依赖单样本 → batch=1、变长序列、推理部署全都行为一致,这是 Transformer 选它的根本原因;
- 参数量:仅 2 d 2d 2d 个( γ , β \gamma,\beta γ,β 各 512),与 batch、序列长无关。
示意图 :统计方向对比见 formula_norm.png(橙色高亮行 = LN 方向)
图形
第三章 损失函数
3.1 MSE(均方误差)
公式
L M S E = 1 n ∑ i = 1 n ( y ^ i − y i ) 2 \mathcal{L}{\mathrm{MSE}} = \frac{1}{n}\sum{i=1}^{n} (\hat{y}_i - y_i)^{2} LMSE=n1i=1∑n(y^i−yi)2
符号说明:误差平方 → 大误差被放大惩罚,对离群点敏感;等价于高斯噪声假设下的负对数似然。
应用场景:回归任务(房价、轨迹预测、图像重建的像素级损失)。
PyTorch
python
pred, target = torch.randn(32, 3), torch.randn(32, 3)   # 32 样本 × 3 维回归输出
loss = torch.nn.functional.mse_loss(pred, target)       # 默认 reduction='mean': 先平方再对全部元素平均
# = ((pred − target)**2).mean()  → 标量,可直接 backward()
loss_sum = torch.nn.functional.mse_loss(pred, target, reduction='sum')
# reduction='sum': 不求平均 → 损失值随 batch 增大而增大(VAE 重建项惯例用 sum)
loss_none = torch.nn.functional.mse_loss(pred, target, reduction='none')
# reduction='none': 保留逐元素误差 (32,3),用于自定义加权(如按样本重要性加权)
代码解读
- 三个
reduction模式决定了"平方之后怎么聚合":mean(默认)/ sum / none(逐元素); - MSE 对离群样本的梯度是 2 e 2e 2e,误差越大梯度越大 → 一个坏样本可能主导整个 batch,必要时换 Huber;
- 输入形状任意且 pred/target 需同形(或可广播)。
示意图 :抛物线形状见 formula_losses.png 左图蓝线
图形 :见 formula_losses.png(左图蓝色抛物线)
3.2 L1 / Huber(SmoothL1)
公式
L L 1 = 1 n ∑ i = 1 n ∣ y ^ i − y i ∣ , L H u b e r = { 1 2 e 2 , ∣ e ∣ ≤ δ δ ( ∣ e ∣ − 1 2 δ ) , ∣ e ∣ > δ ( e = y ^ − y ) \mathcal{L}{\mathrm{L1}} = \frac{1}{n}\sum{i=1}^{n} \lvert \hat{y}i - y_i \rvert, \qquad \mathcal{L}{\mathrm{Huber}} = \begin{cases} \tfrac{1}{2}e^{2}, & \lvert e \rvert \le \delta \\4pt \delta\left(\lvert e \rvert - \tfrac{1}{2}\delta\right), & \lvert e \rvert > \delta \end{cases} \quad (e = \hat{y} - y) LL1=n1i=1∑n∣y^i−yi∣,LHuber={21e2,δ(∣e∣−21δ),∣e∣≤δ∣e∣>δ(e=y^−y)
符号说明 :L1 梯度恒定 → 对离群点鲁棒但零点不可导;Huber 在小误差区取平方(平滑可导)、大误差区取线性(鲁棒),两者兼得; δ \delta δ 为切换点。
应用场景:含离群点的回归;目标检测的边框回归(Faster R-CNN 用 SmoothL1)。
PyTorch
python
loss = torch.nn.functional.l1_loss(pred, target)                  # |e| 的平均:梯度恒 ±1,离群点不爆炸
loss = torch.nn.functional.smooth_l1_loss(pred, target, beta=1.0) # beta 即公式中的 δ(切换点)
# beta=1.0 时: |e|≤1 用 0.5e²(原点平滑可导); |e|>1 用 |e|−0.5(线性鲁棒)
# 目标检测框回归常用 beta=0.1~1.0:小误差精细调、大误差不过度惩罚
代码解读
- L1 的梯度大小与误差无关(恒为 1)→ 收敛末期会在最优解附近"匀速震荡",不如 MSE 精细;Huber 兼得两者;
smooth_l1_loss即 Faster R-CNN 论文里的 SmoothL1;新版别名huber_loss(delta 参数同义);- 选 beta 的经验:设为"典型误差量级",如框回归用 IoU 误差的量级。
示意图 :三段形状对比见 formula_losses.png 左图(绿=L1、橙=Huber)
图形 :见 formula_losses.png(左图绿/橙曲线)
3.3 BCE(二元交叉熵)
公式
L B C E = − 1 n ∑ i = 1 n y i log p i + ( 1 − y i ) log ( 1 − p i ) , p = σ ( y ^ ) \mathcal{L}{\mathrm{BCE}} = -\frac{1}{n}\sum{i=1}^{n} \Big y_i \\log p_i + (1 - y_i)\\log(1 - p_i) \\Big, \qquad p = \sigma(\hat{y}) LBCE=−n1i=1∑nyilogpi+(1−yi)log(1−pi),p=σ(y^)
符号说明 : y ∈ { 0 , 1 } y \in \{0, 1\} y∈{0,1} 为真标签, p p p 为预测概率; y = 1 y=1 y=1 时只剩 − log p -\log p −logp → p → 1 p \to 1 p→1 损失趋于 0。
应用场景:二分类;多标签分类(每个标签独立 BCE 再求和,如图像 tagging)。
PyTorch
python
logits = torch.randn(32)                    # 二分类原始得分 (B,),未经 sigmoid
y = torch.randint(0, 2, (32,)).float()      # 真标签 0/1,需 float 类型

loss = torch.nn.functional.binary_cross_entropy_with_logits(logits, y)
# 内部 = mean( max(z,0) − z·y + log(1+e^{−|z|}) ),即 log-sigmoid 的稳定实现

# 多标签分类(一张图多个标签): 每个标签独立做 BCE 再求和/平均
loss = torch.nn.functional.binary_cross_entropy_with_logits(logits_20, y_20)  # (B,20) 对 (B,20)
# 此时 y 是 0/1 矩阵而非类别索引;与 cross_entropy(单标签互斥)严格区分
代码解读
- 单标签二分类用本公式;多标签 (标签不互斥)也用本公式但逐标签独立;多类互斥 才用
cross_entropy; pos_weight参数可给正类加权(正负样本不平衡时,如正:负=1:50 设 pos_weight=50);- y 必须是 float(0.0/1.0),传 Long 会报类型错。
示意图 : − log p -\log p −logp 曲线见 formula_losses.png 右图蓝线
图形 :见 formula_losses.png(右图蓝色 − log p -\log p −logp 曲线)
3.4 交叉熵(多分类)
公式
L C E = − 1 n ∑ i = 1 n ∑ c = 1 C y i c log y ^ i c , y ^ = s o f t m a x ( z ) = e z c ∑ c ′ e z c ′ \mathcal{L}{\mathrm{CE}} = -\frac{1}{n}\sum{i=1}^{n}\sum_{c=1}^{C} y_{ic}\, \log \hat{y}{ic}, \qquad \hat{\mathbf{y}} = \mathrm{softmax}(\mathbf{z}) = \frac{e^{z_c}}{\sum{c'} e^{z_{c'}}} LCE=−n1i=1∑nc=1∑Cyiclogy^ic,y^=softmax(z)=∑c′ezc′ezc
符号说明 : y i c y_{ic} yic 为 one-hot 标签(代码中用类别索引表示);等价于 − log P ( 正确类 ) -\log P(\text{正确类}) −logP(正确类);与 softmax 是天然组合。
应用场景:一切单标签多分类:图像分类、语言模型下一个词、语音识别。
PyTorch
python
logits = torch.randn(32, 10)              # (B=32, C=10) 原始得分,⚠ 不要先 softmax!
labels = torch.randint(0, 10, (32,))      # (B,) 类别索引 Long 型,无需 one-hot

loss = torch.nn.functional.cross_entropy(logits, labels)
# 等价展开: logp = log_softmax(logits, dim=-1)      # 沿类维度归一化+取log(稳定)
#           loss  = -logp[arange(32), labels].mean() # 取"真类"的 log 概率,取负,按 batch 平均
print(loss.shape)                          # torch.Size([]) 标量 → 直接 .backward()

loss_ls = torch.nn.functional.cross_entropy(logits, labels, label_smoothing=0.1)
# 标签平滑: 把 one-hot 的 1 换成 0.9、0 换成 0.1/C → 防止模型过度自信,提升泛化
代码解读
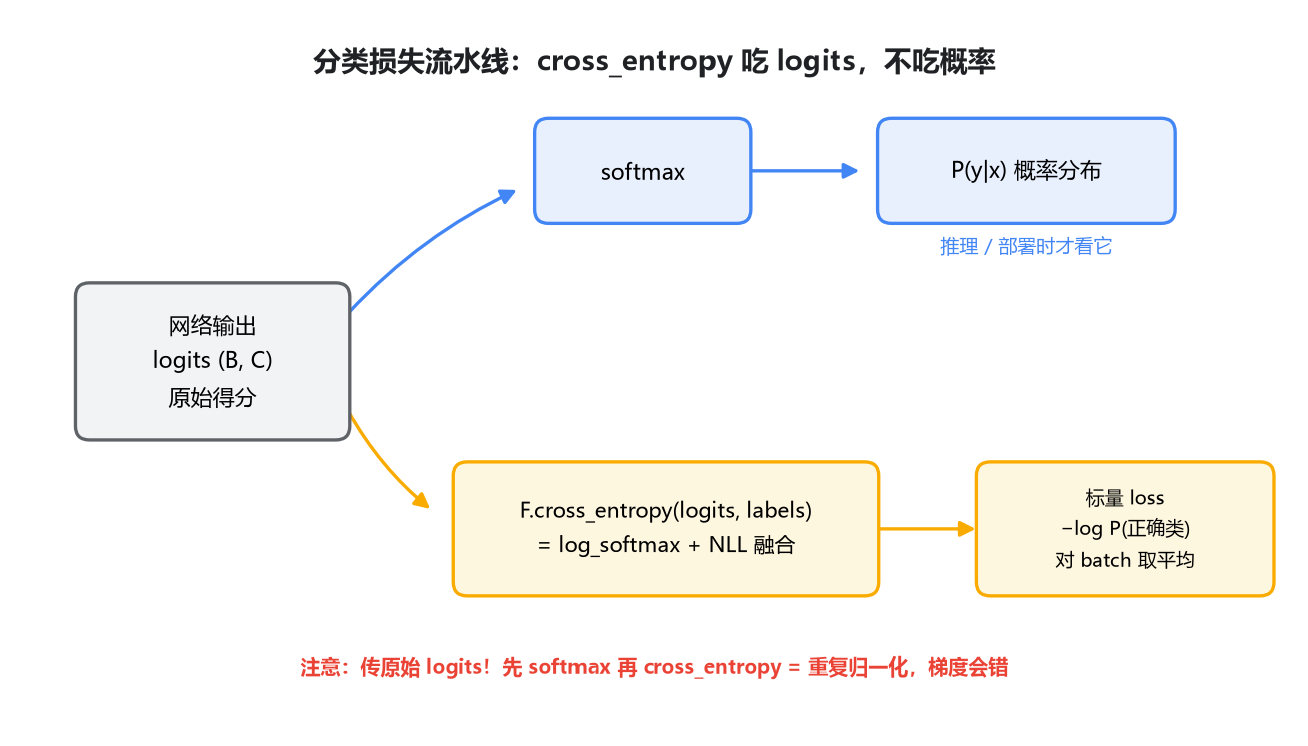
- 传概率进去 = 二次归一化,梯度全错------这是新手最高频错误;
logp[arange(B), labels]这步"按索引取真类"就是公式里 ∑ c y i c log y ^ i c \sum_c y_{ic}\log\hat y_{ic} ∑cyiclogy^ic 的稀疏实现(one-hot 求和只剩一项);- 类别不平衡可传
weight=每类权重张量;想逐样本损失用reduction='none'。
示意图
logits(32,10) ─▶ log_softmax(沿类维) ─▶ 按 labels 索引取真类 ─▶ 取负 ─▶ mean ─▶ 标量 loss
      ▲                                                                    (即 −log P(真类) 的 batch 平均)
      └── ⚠ 入口必须是原始得分
配图见 fig4_ce_pipeline.png
图形
3.5 Focal Loss
公式
L F o c a l = − ( 1 − p t ) γ log p t , p t = { p , y = 1 1 − p , y = 0 \mathcal{L}_{\mathrm{Focal}} = -(1 - p_t)^{\gamma} \log p_t, \qquad p_t = \begin{cases} p, & y = 1 \\ 1 - p, & y = 0 \end{cases} LFocal=−(1−pt)γlogpt,pt={p,1−p,y=1y=0
符号说明 : ( 1 − p t ) γ (1-p_t)^{\gamma} (1−pt)γ 为调制因子( γ = 2 \gamma=2 γ=2)------易分样本( p t → 1 p_t \to 1 pt→1)权重趋近 0,难分样本主导梯度。
应用场景 :极端类别不平衡:目标检测(RetinaNet,前景:背景 ≈ 1 : 1000 \approx 1:1000 ≈1:1000)。
PyTorch
python
p = torch.sigmoid(logits)                    # 预测概率 (B,)
pt = torch.where(y == 1, p, 1 - p)           # p_t: "真类"的概率(y=1 取 p,y=0 取 1−p)
loss = (-(1 - pt) ** 2 * torch.log(pt + 1e-8)).mean()
#        └── 调制因子(γ=2) ──┘   └── 普通 BCE ──┘
# 易分样本 pt→1: (1−pt)²→0 → 该项损失被"静音";难分样本 pt→0: 因子→1 → 主导梯度
代码解读
torch.where(cond, a, b)是逐元素三元选择,这里把二分类统一成"真类概率"一个量 p t p_t pt;+1e-8防 log 0 \log 0 log0;γ 越大对易分样本压得越狠(检测常用 γ=2、α=0.25 再平衡正负类);- torchvision 的
sigmoid_focal_loss是官方优化实现,实战可直接用。
示意图 :Focal 与 BCE 曲线对比见 formula_losses.png 右图(红虚线被压低的部分=易分样本)
图形 :见 formula_losses.png(右图红色虚线:压低易分样本)
3.6 KL 散度
公式
D K L ( q ∥ p ) = ∑ x q ( x ) log q ( x ) p ( x ) = E x ∼ q log q ( x ) − log p ( x ) D_{\mathrm{KL}}(q \,\|\, p) = \sum_{x} q(x) \log \frac{q(x)}{p(x)} = \mathbb{E}_{x \sim q}\big\\log q(x) - \\log p(x)\\big DKL(q∥p)=x∑q(x)logp(x)q(x)=Ex∼qlogq(x)−logp(x)
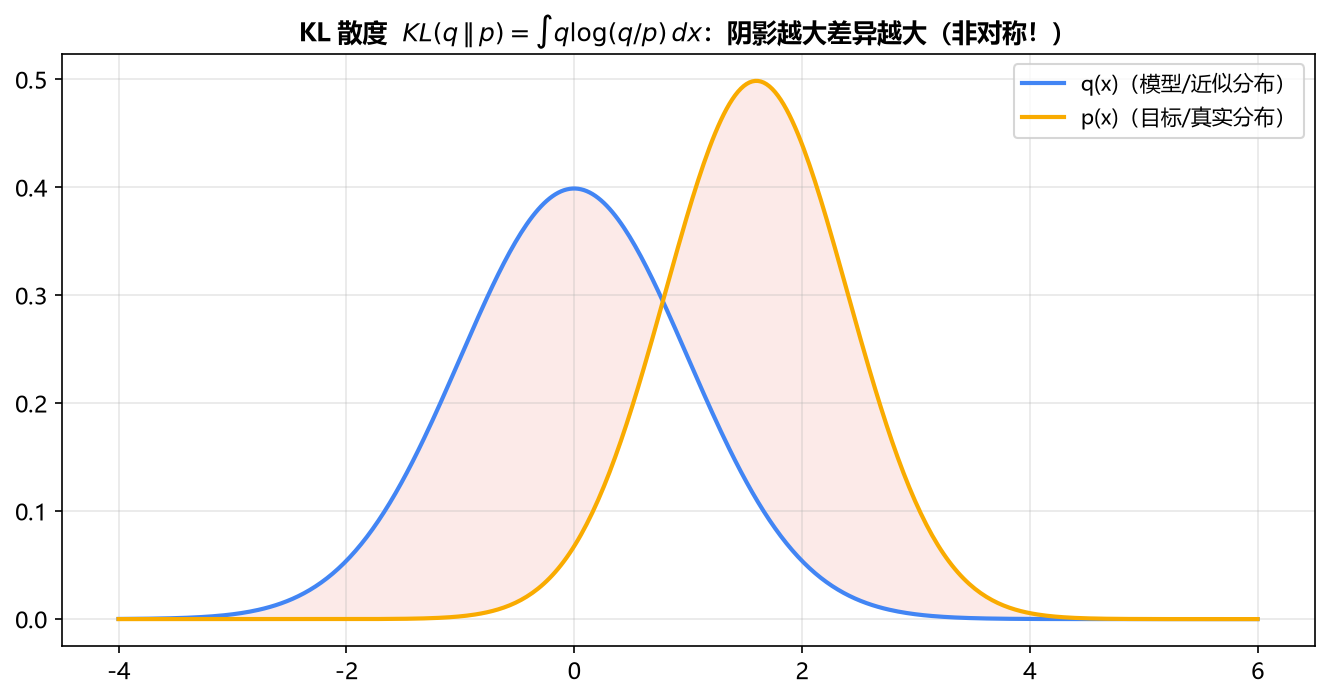
符号说明 :衡量分布 q q q 相对 p p p 的"额外编码长度"; q = p q=p q=p 时为 0;非对称 : D K L ( q ∥ p ) ≠ D K L ( p ∥ q ) D_{\mathrm{KL}}(q\|p) \ne D_{\mathrm{KL}}(p\|q) DKL(q∥p)=DKL(p∥q);两高斯之间有解析解。
应用场景:知识蒸馏(学生匹配教师的软分布);VAE 正则项;PPO 约束新旧策略距离。
PyTorch
python
from torch.distributions import Normal, kl_divergence

# 场景1 VAE: q=N(μ,σ²) 与先验 N(0,1) 的 KL,有解析解 → 直接调用,无需采样
kl = kl_divergence(Normal(mu, std), Normal(0., 1.))     # 逐元素 KL,形状同 mu

# 场景2 知识蒸馏: F.kl_div 的入参约定很特殊 ------
loss = torch.nn.functional.kl_div(
    F.log_softmax(student / T, dim=-1),   # 第1参: 学生的 log 概率(必须先取 log!)
    F.softmax(teacher / T, dim=-1),       # 第2参: 教师的概率(target)
    log_target=False,                     # target 不是 log 形式
    reduction='batchmean',                # 除以 B(而不是元素总数)→ 与 batch 大小解耦
) * T * T                                 # ×T²: 补偿软化导致的梯度缩小(Hinton 原文约定)
代码解读
kl_div的参数顺序/形式是著名陷阱:input 要 log 概率、target 要概率(与直觉相反);reduction='batchmean'才是论文里的"按样本平均";默认 'mean' 会再除以类别数,量纲错;- 温度 T 软化教师分布:T 越大"暗知识"(类间相似度)占比越高; × T 2 \times T^2 ×T2 让梯度量级与 T=1 可比。
示意图 :KL 的几何含义(两分布阴影差)见 formula_kl.png
图形
第四章 优化器与学习率调度
4.1 SGD(随机梯度下降)
公式
θ ← θ − η ∇ θ L \theta \leftarrow \theta - \eta\, \nabla_{\theta} \mathcal{L} θ←θ−η∇θL
符号说明 : η \eta η 学习率是唯一超参;"随机"指每个 mini-batch 梯度是全体梯度的无偏估计。
应用场景:理论基线;CV 大模型精调时配合 momentum + 调度器仍是最优选择之一。
PyTorch
python
opt = torch.optim.SGD(model.parameters(),   # 第1参: 要更新的参数(可训练张量的迭代器/列表)
                      lr=0.01)              # η: 唯一必需超参,步长
# 训练循环三件套:
#   loss.backward()   → 填充每个参数的 .grad(即 ∇θL)
#   opt.step()        → 执行 θ ← θ − η·∇θL(对所有参数并行)
#   opt.zero_grad()   → 清零 .grad(PyTorch 默认累加,不清就叠加上一步)
代码解读
model.parameters()返回生成器,优化器据此为每个参数维护状态(SGD 无额外状态);- 只训部分层:传过滤后的列表,如
[p for p in model.parameters() if p.requires_grad]; - lr 量级经验:SGD 用 0.01~0.1(比 Adam 大 10~100 倍才跑得动)。
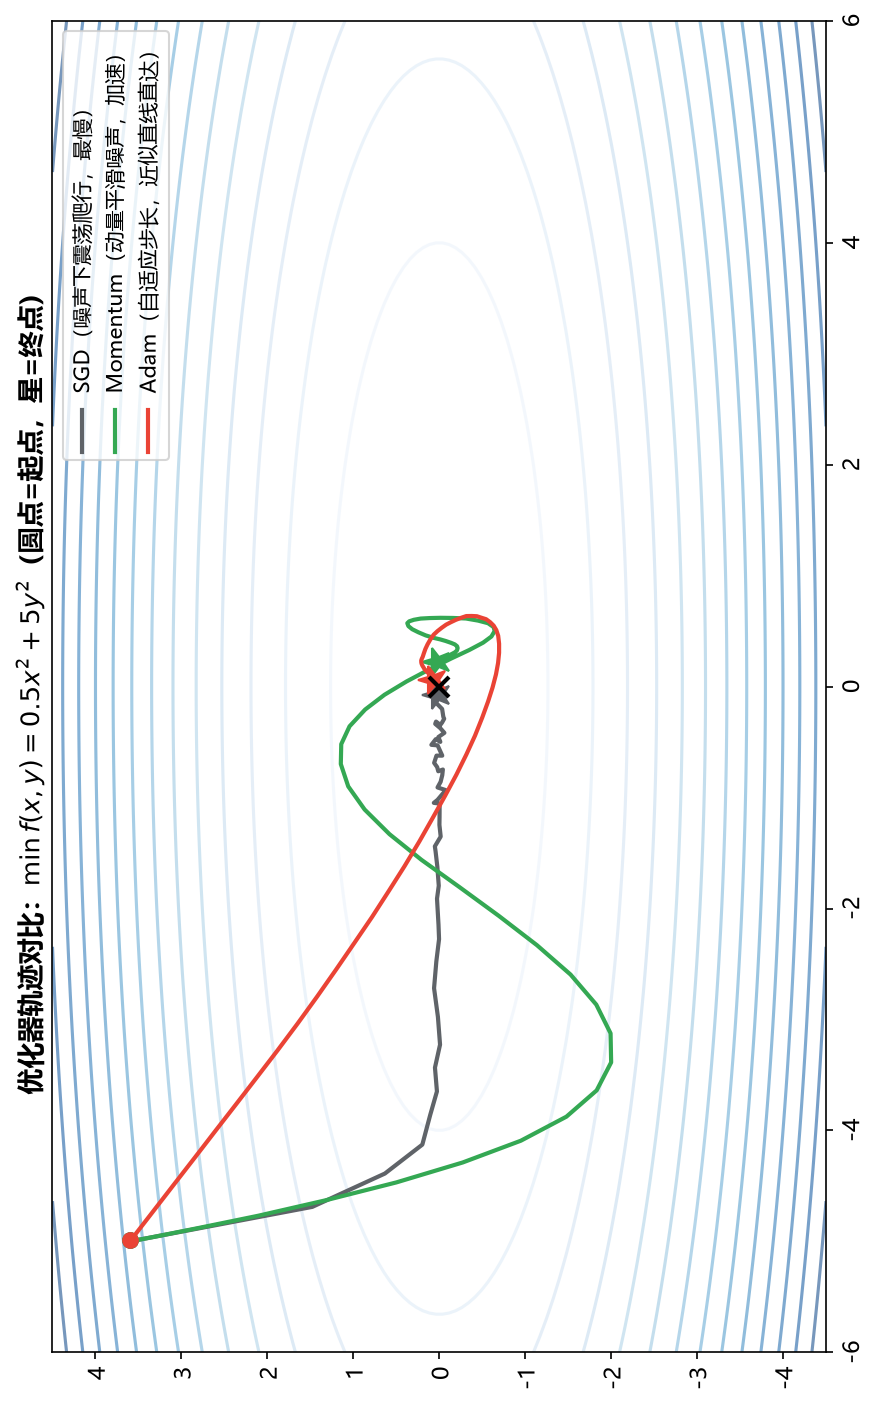
示意图 :单步更新在损失面上的移动见 fig1_hyperparams.png;轨迹见 formula_optimizers.png 灰线
4.2 Momentum(动量法)
公式
v t ← μ v t − 1 + ∇ θ L , θ ← θ − η v t ( μ = 0.9 ) v_t \leftarrow \mu\, v_{t-1} + \nabla_{\theta} \mathcal{L}, \qquad \theta \leftarrow \theta - \eta\, v_t \qquad (\mu = 0.9) vt←μvt−1+∇θL,θ←θ−ηvt(μ=0.9)
符号说明 : v v v 是梯度的指数滑动平均(物理类比:小球带惯性下坡);一致方向被放大、震荡方向相互抵消 → 加速穿过窄谷、平滑 mini-batch 噪声。
应用场景:SGD 的默认增强;CNN 训练标配(SGD + momentum 0.9)。
PyTorch
python
opt = torch.optim.SGD(model.parameters(), lr=0.01,
                      momentum=0.9,        # μ: 动量衰减率,v ← 0.9v + g(历史梯度指数加权)
                      nesterov=True)       # Nesterov 变体: 在"预判位置"θ−ημv 处算梯度,更提前纠错
# 优化器为每个参数多存一份 v(与参数同形)→ 显存开销 ×2
代码解读
- 动量的效果 = 把一致方向的梯度累加放大(稳态增益 1 / ( 1 − μ ) = 10 1/(1-\mu)=10 1/(1−μ)=10 倍),震荡方向互相抵消;
- 因此加了 momentum 后 lr 通常要调小(等效步长变大),否则过冲;
nesterov=True是"先迈一步再回头看梯度",收敛末期更稳,CV 里常用。
示意图 :动量如何冲过窄谷见 formula_optimizers.png 绿线
4.3 Adam
公式
m t = β 1 m t − 1 + ( 1 − β 1 ) g t 一阶矩(梯度均值) v t = β 2 v t − 1 + ( 1 − β 2 ) g t 2 二阶矩(梯度平方均值) m ^ t = m t 1 − β 1 t , v ^ t = v t 1 − β 2 t 偏差修正 θ ← θ − α m ^ t v ^ t + ϵ 自适应步长更新 \begin{aligned} m_t &= \beta_1 m_{t-1} + (1 - \beta_1)\, g_t & &\text{一阶矩(梯度均值)} \\ v_t &= \beta_2 v_{t-1} + (1 - \beta_2)\, g_t^{2} & &\text{二阶矩(梯度平方均值)} \\ \hat{m}_t &= \frac{m_t}{1 - \beta_1^{t}}, \quad \hat{v}_t = \frac{v_t}{1 - \beta_2^{t}} & &\text{偏差修正} \\ \theta &\leftarrow \theta - \alpha\, \frac{\hat{m}_t}{\sqrt{\hat{v}_t} + \epsilon} & &\text{自适应步长更新} \end{aligned} mtvtm^tθ=β1mt−1+(1−β1)gt=β2vt−1+(1−β2)gt2=1−β1tmt,v^t=1−β2tvt←θ−αv^t +ϵm^t一阶矩(梯度均值)二阶矩(梯度平方均值)偏差修正自适应步长更新
符号说明 : g t = ∇ θ L g_t = \nabla_\theta \mathcal{L} gt=∇θL;默认 β 1 = 0.9 \beta_1 = 0.9 β1=0.9、 β 2 = 0.999 \beta_2 = 0.999 β2=0.999、 ϵ = 10 − 8 \epsilon = 10^{-8} ϵ=10−8; v ^ t \sqrt{\hat v_t} v^t 把各维度梯度缩放到相近量级 → 对稀疏梯度与不同量纲特征友好;偏差修正消除 m , v m, v m,v 从零初始化带来的前期偏小。
应用场景:默认首选:Transformer/NLP、GAN、RL;不细调超参时的安全选择。
PyTorch
python
opt = torch.optim.Adam(model.parameters(),
                       lr=1e-3,              # α: 注意比 SGD 小 1~2 个量级
                       betas=(0.9, 0.999),   # (β₁, β₂): 一阶/二阶矩衰减率
                       eps=1e-8)             # ε: 防除零;梯度极稀疏时可提到 1e-4
# 优化器内部为每个参数维护 m, v 两份缓冲(对应公式的 m_t, v_t)→ 显存 ×3

opt = torch.optim.AdamW(model.parameters(), lr=1e-3, weight_decay=0.01)
# AdamW = Adam + 解耦权重衰减: 收缩项直接作用于 θ,不被自适应步长缩放
# (普通 Adam 的 weight_decay 会被 1/√v̂ 扭曲 → 正则效果失真;Transformer 训练标配 AdamW)
代码解读
- 自适应步长的直觉:某参数历史梯度小 → v ^ \sqrt{\hat v} v^ 小 → 实际步长被放大,反之压缩 → 各参数"齐头并进";
- 偏差修正 m ^ , v ^ \hat m, \hat v m^,v^ 只在前几十步起作用( 1 − β t → 1 1-\beta^t \to 1 1−βt→1 后自动消失),无需关心;
- 经验值:NLP/Transformer 用 lr=1e-4~3e-4 + AdamW(wd=0.01);GAN 常用 β₂=0.999→0.9 更稳。
示意图
Adam 的内部缓冲(每个参数 θᵢ 配套):
  mᵢ ← 0.9mᵢ + 0.1gᵢ        梯度方向的滑动平均("往哪走")
  vᵢ ← 0.999vᵢ + 0.001gᵢ²   梯度平方的滑动平均("走多大")
  更新: θᵢ −= α·m̂/(√v̂ᵢ+ε)  → 每个参数拥有自己的等效学习率
配图见 formula_optimizers.png(红线:近似直线直达谷底)
图形(4.1--4.3 对比)
4.4 学习率调度:余弦退火 / Warmup
公式
η t = η min + 1 2 ( η max − η min ) ( 1 + cos π t T ) , Warmup: η t = η max ⋅ t W ( t < W ) \eta_t = \eta_{\min} + \frac{1}{2}\left(\eta_{\max} - \eta_{\min}\right)\left(1 + \cos \frac{\pi t}{T}\right), \qquad \text{Warmup: } \eta_t = \eta_{\max}\cdot \frac{t}{W}\ (t < W) ηt=ηmin+21(ηmax−ηmin)(1+cosTπt),Warmup: ηt=ηmax⋅Wt (t<W)
符号说明 : T T T 为总步数、 W W W 为 warmup 步数;warmup 让模型在梯度噪声最大的初期用小步长稳定下来(Transformer 训练必备)。
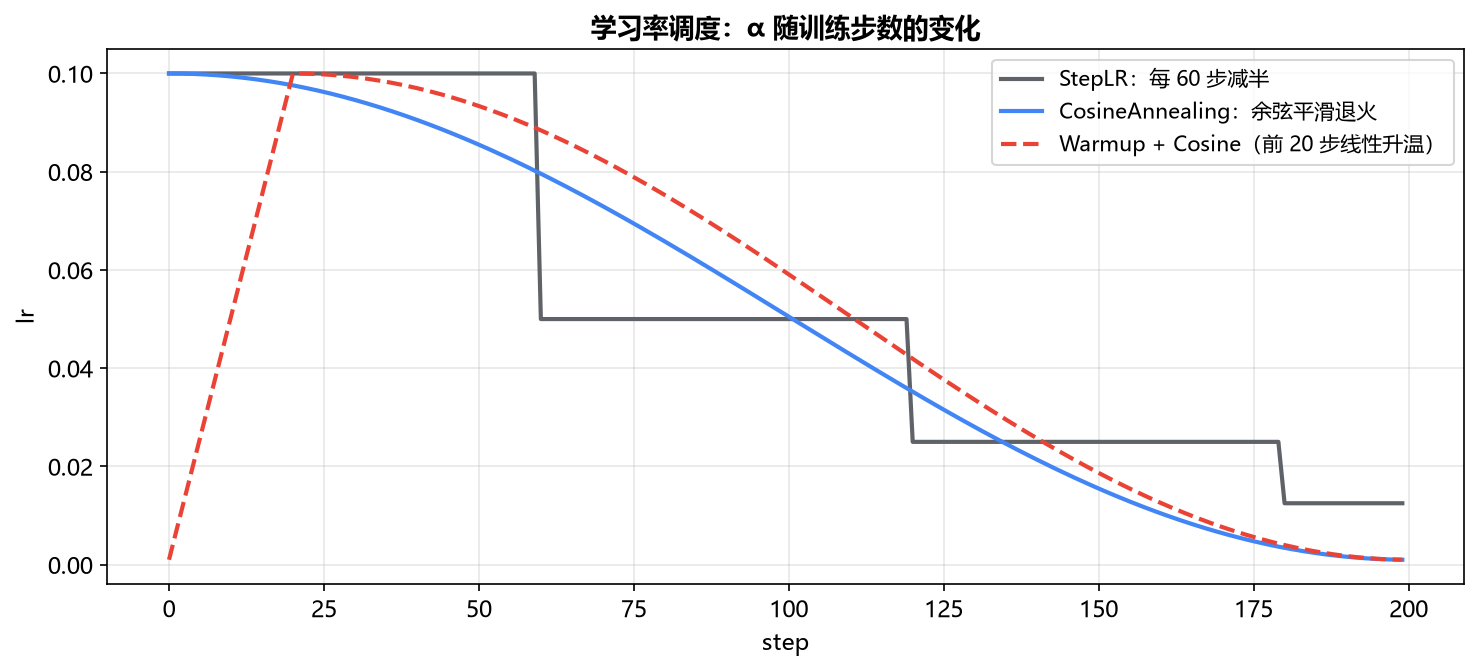
应用场景:几乎所有现代训练:BERT/GPT 的 warmup+cosine;CV 的 StepLR(每 30 epoch 减半)。
PyTorch
python
opt = torch.optim.AdamW(model.parameters(), lr=1e-3)          # lr 这里当作 η_max
warm = torch.optim.lr_scheduler.LinearLR(opt, start_factor=0.01, total_iters=500)
# 前 500 步: lr 从 1e-3×0.01 线性升到 1e-3(让小步长先稳住早期大梯度)
cos  = torch.optim.lr_scheduler.CosineAnnealingLR(opt, T_max=19500)
# 第 500 步后: 按余弦从 1e-3 平滑降到 η_min(默认0),T_max = 剩余总步数
sched = torch.optim.lr_scheduler.SequentialLR(opt, [warm, cos], milestones=[500])
# SequentialLR: 步数 <500 用 warm,≥500 切到 cos(milestone 是"切换点"而非长度)

# 每个训练步的顺序(顺序错了 lr 会错拍):
#   loss.backward(); opt.step(); sched.step()
print(sched.get_last_lr())     # 查看当前实际 lr,调试调度必备
代码解读
- 调度器改的是优化器参数组里的 lr:
opt.param_groups[0]['lr'],可用 print 验证曲线; - warmup 步数经验 = 总步数的 1%~5%(或前 1~2 个 epoch);
- 按 epoch 调度(CV 常见)就在 epoch 末尾调
sched.step(),按 step 调度(NLP)就放在每步opt.step()后。
示意图 :三种调度曲线(阶梯/余弦/warmup+余弦)见 formula_lrschedule.png
图形
4.5 梯度裁剪
公式
g ← c ∥ g ∥ 2 g if ∥ g ∥ 2 > c g \leftarrow \frac{c}{\lVert g \rVert_2}\, g \quad \text{if} \quad \lVert g \rVert_2 > c g←∥g∥2cgif∥g∥2>c
符号说明 : c c c 为阈值(常取 1.0 1.0 1.0 或 5.0 5.0 5.0);把全局梯度范数缩放到 c c c,只改长度不改方向;防"梯度爆炸"而非消失。
应用场景:RNN/LSTM 训练必备;Transformer、RL(策略梯度方差大)常规配置。
PyTorch
python
loss.backward()                                            # 先算出原始梯度 g
torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
# 内部: total = sqrt(Σ‖g‖²)(全局范数); 若 total > 1.0 → 所有 gᵢ 统一乘 1.0/total
# 名字带 _ 后缀 = 原地修改 .grad;返回值是裁剪前的范数(可收集监控)
opt.step()                                                 # 用"裁剪后"的梯度更新
norm = torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0)   # 返回值 = 裁剪前 ‖g‖
# 实战技巧: 把 norm 记到日志/曲线,突增 = 训练即将失稳的预警信号
代码解读
- 必须夹在
backward()与step()之间------它改的是.grad,不是参数; - "全局范数"把所有参数拼成一个大向量算 ∥ g ∥ 2 \lVert g\rVert_2 ∥g∥2,保持各参数梯度的相对比例(方向不变);
- 按元素夹断用
clip_grad_value_(params, 1.0)(改方向,少用);RNN 必加,Transformer 常设 1.0。
示意图 :梯度来自反向传播链见 fig3_autograd.png;五步循环中的位置见 fig9_training_loop.png
图形 :梯度 ∥ g ∥ \lVert g \rVert ∥g∥ 即反向传播产物,见 fig3_autograd.png
第五章 正则化
5.1 L2 正则 / 权重衰减
公式
L ′ = L + λ ∥ θ ∥ 2 2 ⟺ θ ← θ − η ∇ θ L − 2 η λ θ \mathcal{L}' = \mathcal{L} + \lambda \lVert \theta \rVert_2^{2} \qquad \Longleftrightarrow \qquad \theta \leftarrow \theta - \eta\, \nabla_\theta \mathcal{L} - 2\eta\lambda\, \theta L′=L+λ∥θ∥22⟺θ←θ−η∇θL−2ηλθ
符号说明 : λ \lambda λ 控制收缩强度;等价更新式显示每步把权重额外往 0 收缩 2 η λ 2\eta\lambda 2ηλ 倍 → 模型更平滑、抗过拟合。(AdamW 中 weight_decay 与梯度解耦,效果更纯粹。)
应用场景 :几乎所有训练的默认配置( λ ∈ 10 − 4 , 10 − 2 \lambda \in 10\^{-4}, 10\^{-2} λ∈10−4,10−2);小数据集防过拟合首选。
PyTorch
python
opt = torch.optim.AdamW(model.parameters(), lr=1e-3,
                        weight_decay=0.01)     # λ: 每步把 θ 额外收缩 η·λ·θ(与梯度无关)
# ⚠ 惯例: 偏置 b 和归一化的 γ/β 不加衰减(正则它们没意义还会伤拟合):
decay, no_decay = [], []
for n, p in model.named_parameters():
    (no_decay if (p.ndim == 1 or 'bias' in n) else decay).append(p)
opt = torch.optim.AdamW([{"params": decay, "weight_decay": 0.01},
                         {"params": no_decay, "weight_decay": 0.0}], lr=1e-3)
# 参数分组: 不同组可用不同 lr / wd,是微调大模型的常规操作
代码解读
weight_decay就是公式里的 λ;AdamW 中它与自适应步长解耦 (直接乘性收缩),Adam 中则被 1 / v ^ 1/\sqrt{\hat v} 1/v^ 扭曲;p.ndim == 1筛出偏置/LN 参数(都是一维),这是 HuggingFace 训练脚本的标准写法;- λ 过大会欠拟合(权重被压死);先跑 wd=0 基线再 grid 搜 1e-4~1e-1。
示意图 :权重指数收缩曲线 θ t = θ 0 ( 1 − η λ ) t \theta_t=\theta_0(1-\eta\lambda)^t θt=θ0(1−ηλ)t 见 graph_weight_decay.png
图形 :权重指数收缩曲线见附录 B.4; λ \lambda λ 在损失中的位置见 fig1_hyperparams.png
5.2 Dropout
公式
a ′ = a ⊙ m 1 − p , m j ∼ B e r n o u l l i ( 1 − p ) i.i.d. 推理: a ′ = a \mathbf{a}' = \frac{\mathbf{a} \odot \mathbf{m}}{1 - p}, \quad m_j \sim \mathrm{Bernoulli}(1 - p) \ \text{i.i.d.} \qquad \text{推理: } \mathbf{a}' = \mathbf{a} a′=1−pa⊙m,mj∼Bernoulli(1−p) i.i.d.推理: a′=a
符号说明 : p p p 为失活概率(隐藏层常 0.1 ∼ 0.5 0.1 \sim 0.5 0.1∼0.5); ⊙ \odot ⊙ 为逐元素乘;除以 ( 1 − p ) (1-p) (1−p) 保持激活期望不变(inverted dropout),故推理期无需缩放。
应用场景 :全连接层防共适应;Transformer 中注意力与 FFN 后常用 p = 0.1 p=0.1 p=0.1;CNN 中逐渐被 BN+数据增强取代。
PyTorch
python
drop = torch.nn.Dropout(p=0.1)      # p = 置零概率(注意是"丢掉"的概率,不是保留)
h = drop(a)                         # 训练态: 每个元素独立以 0.1 概率置 0,存活者 ×1/(1−0.1) 放大
# 同一 forward 内 mask 固定;每次 forward 重新采样 → 每步都是"不同子网络"
model.eval()                        # 切推理态: 模块自动变恒等映射(不置零不缩放)
h2 = torch.nn.functional.dropout(a, p=0.1, training=True)   # 函数式需手动传 training 标志
代码解读
- ×1/(1−p) 的缩放保证训练/推理时期望一致(inverted dropout),所以推理无需任何补偿;
- 函数式
F.dropout的training参数默认 True------推理时忘了传 False 会引入随机性,推荐用模块式 让它跟随model.eval(); - p 的选择:输入层小(0.1)、宽隐藏层大(0.5);Transformer 常用 0.1。
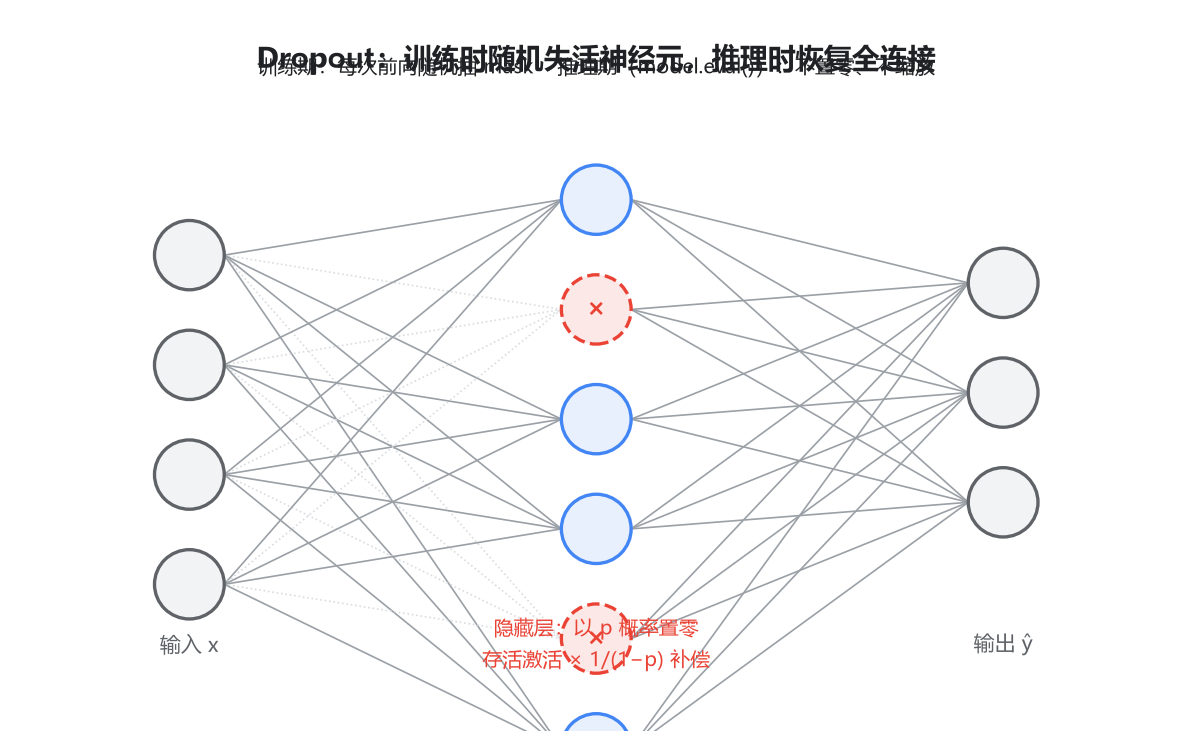
示意图 :节点失活结构见 formula_dropout.png(红叉=被置零,虚线边=断开)
图形
5.3 早停(Early Stopping)
公式(准则)
每个 epoch 评估: L v a l ( e ) ≥ min e ′ < e L v a l ( e ′ ) 连续 K 次 ⟹ 停止并回滚最优权重 \text{每个 epoch 评估: } \quad \mathcal{L}{\mathrm{val}}^{(e)} \ge \min{e' < e} \mathcal{L}_{\mathrm{val}}^{(e')} \ \text{连续 } K \text{ 次} \quad \Longrightarrow \quad \text{停止并回滚最优权重} 每个 epoch 评估: Lval(e)≥e′<eminLval(e′) 连续 K 次⟹停止并回滚最优权重
符号说明 : K K K 为 patience;本质是"用验证集选择迭代次数"这一超参。
应用场景:训练时间长/数据小的场景;与权重衰减并列为最廉价的正则手段。
PyTorch
python
best, patience, bad = 1e9, 5, 0
for epoch in range(100):
    train_one_epoch()                    # 正常训练一个 epoch
    val = evaluate()                     # 验证集损失(no_grad 下算,别用训练损失判断!)
    if val < best:                       # 创新高 → 存档
        best, bad = val, 0
        torch.save(model.state_dict(), "best.pt")   # 只存权重(state_dict),不存整个模型对象
    else:
        bad += 1                         # 连续不改善计数
        if bad >= patience: break        # 耐心耗尽 → 停(此时 best.pt 就是最优点)
model.load_state_dict(torch.load("best.pt"))        # 训练结束后回滚到验证最优权重
代码解读
- 存
state_dict()(纯权重字典)而非pickle整个模型:跨版本可加载、文件小; - 判据必须用验证集损失:训练损失在过拟合开始后仍会下降,用它早停永远停不下来;
- patience 太小会过早停(噪声波动误判),太大浪费时间;5~10 个 epoch 是常见起点。
示意图 :训练/验证损失曲线的"拐点"即早停位置(train↓ val↑ 分叉处)------与 graph_weight_decay.png 同属"防过拟合三件套"
第六章 卷积与池化
6.1 卷积运算与输出尺寸
公式
y i , j = ∑ m ∑ n w m , n x i + S m − P , j + S n − P + b , O = ⌊ W − K + 2 P S ⌋ + 1 yi, j = \sum_{m}\sum_{n} wm, n\, xi + S m - P,\\; j + S n - P + b, \qquad O = \left\lfloor \frac{W - K + 2P}{S} \right\rfloor + 1 yi,j=m∑n∑wm,nxi+Sm−P,j+Sn−P+b,O=⌊SW−K+2P⌋+1
符号说明 : W W W 输入尺寸、 K K K 核大小、 P P P 填充、 S S S 步幅(工程实现为互相关,统称卷积);参数量 = K 2 ⋅ C i n ⋅ C o u t = K^2 \cdot C_{\mathrm{in}} \cdot C_{\mathrm{out}} =K2⋅Cin⋅Cout,与输入尺寸无关(权重共享)。
应用场景 :CNN 架构设计时推算特征图尺寸;感受野计算;"same 卷积"即取 P = ( K − 1 ) / 2 P=(K-1)/2 P=(K−1)/2 使 O = W O=W O=W。
PyTorch
python
conv = torch.nn.Conv2d(in_channels=3,      # 输入通道: RGB=3(必须与 x 的第2维一致)
                       out_channels=64,    # 卷积核个数 = 输出通道 = 64 种"模板"
                       kernel_size=3,      # K=3(传元组 (3,5) 可非方形)
                       stride=1, padding=1)  # P=(K−1)/2=1 → 尺寸不变(same 卷积)
x = torch.randn(8, 3, 224, 224)            # (B, C_in, H, W) 四维固定约定
out = conv(x)                              # → (8, 64, 224, 224)
# 尺寸公式验证: O = (224 − 3 + 2×1)/1 + 1 = 224 ✓
print(conv.weight.shape)                   # (64, 3, 3, 3) = (C_out, C_in, K, K)
# 参数量 = 3×3×3×64 + 64(偏置) = 1792,与输入 224×224 无关(权重共享的威力)
代码解读
- 张量约定永远是 (B, C, H, W):通道维在第 2 位,BatchNorm2d 的参数也对应这一维;
weight形状 (C_out, C_in, K, K):每个输出通道是一张"对所有输入通道求和"的 3D 模板;- 下采样用
stride=2(O 减半);groups=C_in变深度可分离卷积(MobileNet 省参数量)。
示意图
尺寸速算(套公式 O = ⌊(W−K+2P)/S⌋+1):
  224 ──K3,P1,S1──▶ 224 ──K3,P1,S2──▶ 111 ──K3,P1,S2──▶ 55 ...
        same卷积        stride2下采样
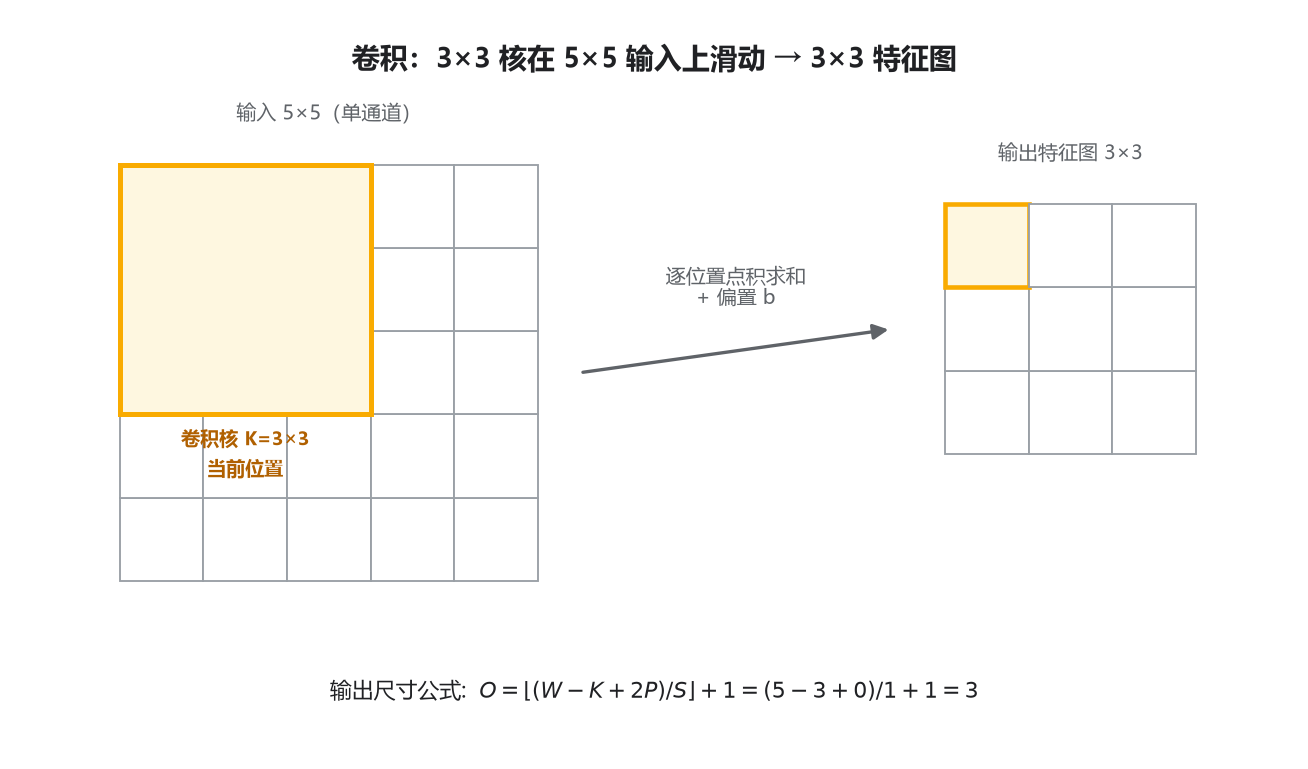
滑动过程见 formula_conv.png;1D 信号版见 graph_conv1d.png
图形
6.2 最大池化
公式
y i , j = max ( m , n ) ∈ R i j x m , n , R i j = 以 ( i S , j S ) 为起点的 K × K 窗口 yi, j = \max_{(m, n) \in \mathcal{R}{ij}} xm, n, \qquad \mathcal{R}{ij} = \text{以 } (iS, jS) \text{ 为起点的 } K \times K \text{ 窗口} yi,j=(m,n)∈Rijmaxxm,n,Rij=以 (iS,jS) 为起点的 K×K 窗口
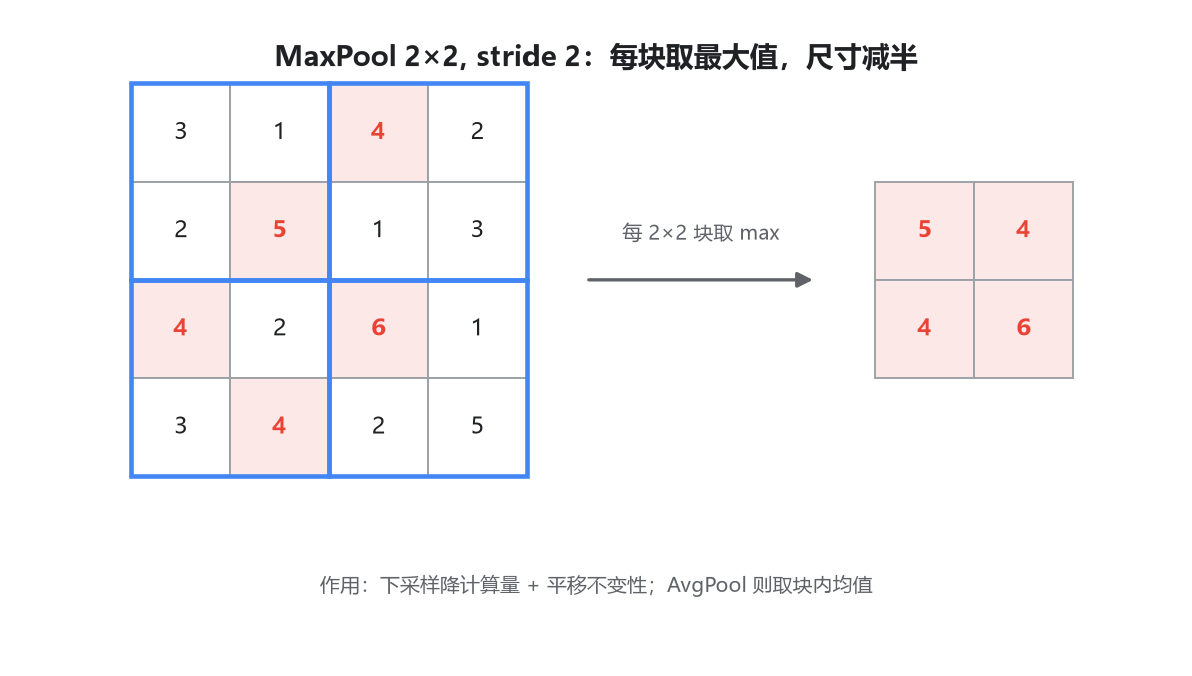
符号说明 :无参数操作;保留窗口内最强响应 → 小幅平移不改变输出(平移不变性); K = 2 , S = 2 K=2, S=2 K=2,S=2 时尺寸减半。
应用场景 :CNN 下采样降计算量;扩大感受野;经典 VGG 每两个卷积接一次 2 × 2 2\times 2 2×2 池化。
PyTorch
python
pool = torch.nn.MaxPool2d(kernel_size=2, stride=2)   # 2×2 窗口、步长2 → H,W 各减半
out = pool(x)                                        # (B,64,224,224) → (B,64,112,112)
# 无参数、无训练/推理差异:纯函数式下采样
avg = torch.nn.AvgPool2d(2)                          # 均值版:背景/纹理类任务更平滑
gap = torch.nn.AdaptiveAvgPool2d(1)                  # 全局平均池化: 任意 H,W → (B,64,1,1)
# Adaptive 版不用算尺寸:直接指定"输出想要多大",分类头前标配
代码解读
- MaxPool 保留窗口内最大响应 → 对微小平移/形变不敏感(平移不变性的来源);
- 现代 CNN(ResNet 之后)倾向用
stride=2卷积做下采样:可学习、信息损失少;池化留给收尾(GAP); AdaptiveAvgPool2d(1)把任意尺寸特征图压成每通道一个数 → 接分类头,免去尺寸对齐烦恼。
示意图 :2×2 取 max 的过程见 formula_pool.png(红底=被选中的最大值)
图形
第七章 序列模型与注意力
7.1 RNN 递推
公式
h t = tanh ( W h h h t − 1 + W x h x t + b ) , y ^ t = W h y h t + b y h_t = \tanh\left(W_{hh}\, h_{t-1} + W_{xh}\, x_t + b\right), \qquad \hat{y}t = W{hy}\, h_t + b_y ht=tanh(Whhht−1+Wxhxt+b),y^t=Whyht+by
符号说明 : h t h_t ht 是"到 t t t 为止的摘要";参数在所有时间步共享;反向传播时 Jacobian 连乘导致长程梯度消失/爆炸。
应用场景:短序列基线;教学与理解序列建模的起点(实战多用 LSTM/Transformer)。
PyTorch
python
rnn = torch.nn.RNN(input_size=128,      # 每个时间步输入 x_t 的维度
                   hidden_size=256,     # 隐藏态 h_t 的维度
                   batch_first=True)    # ⚠ 默认 False! 设为 True 才能用直观的 (B,T,·) 顺序
x = torch.randn(32, 10, 128)            # (B=32 条序列, T=10 步, 每步 128 维)
h_all, h_last = rnn(x)                  # h_all: (32,10,256) 每步的 h_t; h_last: (1,32,256) 末步
# h_last 的层维=1(单层); num_layers=2 时 h_all 不变、h_last 变 (2,32,256)
代码解读
batch_first是 PyTorch RNN 系第一坑:默认 (T,B,·) 是历史遗留,忘了设就要到处 transpose;- 两个返回值的分工:序列标注任务用
h_all(每步都要预测),整句分类用h_last(末步摘要); - 变长序列需配
pack_padded_sequence防止 padding 位置污染隐藏态(进阶)。
示意图
x₀ ─▶ [RNN] ─▶ x₁ ─▶ [RNN] ─▶ x₂ ─▶ [RNN]     同一个 rnn 模块被"展开"复用 T 次
        │            │            │            (参数共享 = 公式中的 W 不随 t 变)
        ▼            ▼            ▼
       h₀ ────────▶ h₁ ────────▶ h₂            h_all = [h₀,h₁,h₂]  h_last = h₂
图形
x₀ ─▶ [RNN] ─▶ x₁ ─▶ [RNN] ─▶ x₂ ─▶ [RNN] ─▶ ...
        │            │            │
        ▼            ▼            ▼
       h₀ ────────▶ h₁ ────────▶ h₂        h_t 携带"至今为止"的信息(参数共享)
7.2 LSTM
公式
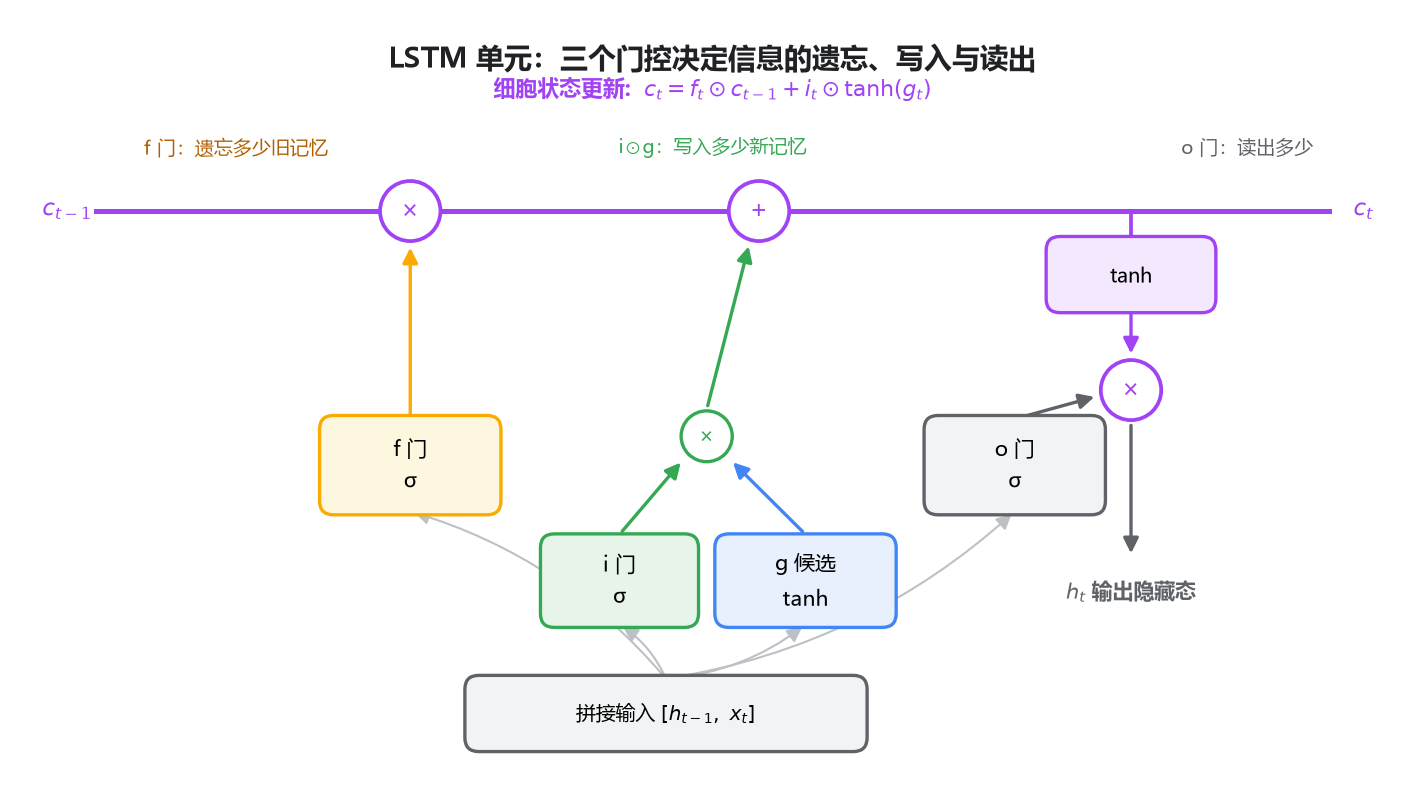
f t = σ ( W f h t − 1 , x t + b f ) 遗忘门 i t = σ ( W i h t − 1 , x t + b i ) 输入门 c ~ t = tanh ( W c h t − 1 , x t + b c ) 候选记忆 o t = σ ( W o h t − 1 , x t + b o ) 输出门 c t = f t ⊙ c t − 1 + i t ⊙ c ~ t 细胞状态更新 h t = o t ⊙ tanh ( c t ) 隐藏态输出 \begin{aligned} f_t &= \sigma(W_f h_{t-1}, x_t + b_f) & &\text{遗忘门} \\ i_t &= \sigma(W_i h_{t-1}, x_t + b_i) & &\text{输入门} \\ \tilde{c}t &= \tanh(W_c h_{t-1}, x_t + b_c) & &\text{候选记忆} \\ o_t &= \sigma(W_o h_{t-1}, x_t + b_o) & &\text{输出门} \\ c_t &= f_t \odot c{t-1} + i_t \odot \tilde{c}_t & &\text{细胞状态更新} \\ h_t &= o_t \odot \tanh(c_t) & &\text{隐藏态输出} \end{aligned} ftitc~totctht=σ(Wfht−1,xt+bf)=σ(Wiht−1,xt+bi)=tanh(Wcht−1,xt+bc)=σ(Woht−1,xt+bo)=ft⊙ct−1+it⊙c~t=ot⊙tanh(ct)遗忘门输入门候选记忆输出门细胞状态更新隐藏态输出
符号说明 : ⋅ , ⋅ \\cdot,\\cdot ⋅,⋅ 为向量拼接; c t c_t ct 只经历逐元素加法与门控乘法 → 梯度可长距离无衰减流动("梯度高速公路"),解决 RNN 长程依赖问题。
应用场景:语音、时序预测、机器翻译(前 Transformer 时代主力);仍广泛用于轻量时序任务。
PyTorch
python
lstm = torch.nn.LSTM(input_size=128, hidden_size=256,
                     num_layers=2,          # 堆叠 2 层: 第2层的输入是第1层的 out 序列
                     batch_first=True)
x = torch.randn(32, 10, 128)
out, (h_n, c_n) = lstm(x)
# out : (32,10,256)  = 最后一层每步的 h_t
# h_n : (2,32,256)   = 每层的末步 h_T(层维在前!)
# c_n : (2,32,256)   = 每层的末步细胞状态 c_T(LSTM 独有,RNN 没有第二个返回值)
# 四组门 (f,i,g,o) 的 W,b 全部封装在 lstm.parameters() 里,共 4×2 层份
代码解读
- 解包
(h_n, c_n)是 LSTM 的签名特征:细胞状态 c 是"长期记忆线",h 是"对外输出"; - 多层时
out只来自最顶层;取中间层状态用h_n[0](第 1 层末步); - 双向 LSTM 加
bidirectional=True:out 的隐藏维翻倍(正反向拼接),h_n 层维也翻倍。
示意图 :门控信息流(f 门遗忘 / i⊙g 写入 / o 门读出)见 formula_lstm.png
图形
7.3 缩放点积注意力
公式
A t t e n t i o n ( Q , K , V ) = s o f t m a x ( Q K ⊤ d k ) V , M u l t i H e a d = C o n c a t ( h e a d 1 , ... , h e a d h ) W O \mathrm{Attention}(Q, K, V) = \mathrm{softmax}\!\left(\frac{Q K^{\top}}{\sqrt{d_k}}\right) V, \qquad \mathrm{MultiHead} = \mathrm{Concat}(\mathrm{head}_1, \dots, \mathrm{head}_h)\, W^{O} Attention(Q,K,V)=softmax(dk QK⊤)V,MultiHead=Concat(head1,...,headh)WO
符号说明 : h e a d i = A t t e n t i o n ( Q W i Q , K W i K , V W i V ) \mathrm{head}_i = \mathrm{Attention}(Q W_i^{Q}, K W_i^{K}, V W_i^{V}) headi=Attention(QWiQ,KWiK,VWiV);自注意力中 Q , K , V Q, K, V Q,K,V 由同一输入线性投影; d k \sqrt{d_k} dk 缩放防点积过大使 softmax 饱和;softmax 按行归一化 → 每个查询得到一组和为 1 的权重。
应用场景 :Transformer 全部信息交换:编码器自注意力、解码器因果注意力、交叉注意力;复杂度 O ( T 2 d ) O(T^2 d) O(T2d)。
PyTorch
python
import torch.nn.functional as F
# q,k,v: (B, h, T, d_k) ------ 已由 x @ W_q / W_k / W_v 投影得到
out = F.scaled_dot_product_attention(q, k, v, is_causal=True)
# 官方融合内核: 自动选 FlashAttention/mem-efficient 后端
# is_causal=True: 内部加下三角 mask,第 i 个 token 只能看 ≤i(GPT 式自回归)
# 不显式存 T×T 的 scores → 显存 O(T²) 降到 O(T)

# 手写等价版(理解公式用):
scores = q @ k.transpose(-2, -1) / (q.size(-1) ** 0.5)   # QKᵀ/√d_k → (B,h,T,T)
attn = scores.softmax(dim=-1)                            # 每行归一化 = 注意力权重
out = attn @ V                                           # 加权求和 V → (B,h,T,d_v)
# 显式 mask(如 padding): F.scaled_dot_product_attention(q,k,v, attn_mask=mask)
代码解读
q.size(-1)**0.5就是公式的 d k \sqrt{d_k} dk :不除的话 d_k 大时点积方差大 → softmax 一步到位饱和、梯度消失;is_causal与attn_mask不要同时传;mask 约定是"被遮位置加 −inf"(bool mask 则 True=保留,注意版本差异);- 多头 = 把 d_model 切成 h 份并行做本公式:
nn.MultiheadAttention或手动view(B,T,h,d_k).transpose(1,2)。
示意图 :完整形状变换链(QKᵀ→scores→weights→@V)见 fig5b_attention.png
图形 :见 fig5b_attention.png
7.4 正弦位置编码
公式
P E ( p o s , 2 i ) = sin ( p o s 10000 2 i / d m o d e l ) , P E ( p o s , 2 i + 1 ) = cos ( p o s 10000 2 i / d m o d e l ) PE_{(pos,\, 2i)} = \sin\!\left(\frac{pos}{10000^{\,2i/d_{\mathrm{model}}}}\right), \qquad PE_{(pos,\, 2i+1)} = \cos\!\left(\frac{pos}{10000^{\,2i/d_{\mathrm{model}}}}\right) PE(pos,2i)=sin(100002i/dmodelpos),PE(pos,2i+1)=cos(100002i/dmodelpos)
符号说明 : p o s pos pos 为时间步、 i i i 为维度索引;不同频率的正弦波叠加 → 每个位置有唯一"指纹",且任意相对位移可由线性变换表示。
应用场景:原始 Transformer;现代模型多用可学习位置嵌入或 RoPE(旋转位置编码)。
PyTorch
python
pos = torch.arange(5000).unsqueeze(1).float()   # (5000,1) 位置列向量: 0..4999
i = torch.arange(0, 512, 2).float()             # (256,) 偶数维索引: 0,2,4,...,510
pe = torch.zeros(5000, 512)                     # 预生成整张位置编码表 (max_len, d_model)
# 广播: (5000,1)/(1,256) → (5000,256),正好填满偶/奇两组维度
pe[:, 0::2] = torch.sin(pos / 10000 ** (i / 512))   # 偶数维 = sin
pe[:, 1::2] = torch.cos(pos / 10000 ** (i / 512))   # 奇数维 = cos(同频率配对)
x = x + pe[:T]                # 与 token 嵌入"相加"(不是拼接): (T,512)+(T,512)
# pe 无梯度需求 → 注册为 buffer: model.register_buffer('pe', pe),随 .to(device) 迁移
代码解读
10000**(i/512)生成从 1 到 10000 的几何级数波长:低维高频、高维低频(热力图的条纹疏密);- 切片赋值
0::2 / 1::2是"偶/奇交错"的向量化写法,避免循环; - 相加而非拼接:保持 d_model 不变,且让注意力能用线性变换感知相对位置(论文性质)。
示意图 :PE 矩阵热力图(左密右疏的正弦条纹)见 graph_pe_heatmap.png
图形:热力图见附录 B.6
第八章 强化学习
8.1 折扣回报
公式
G t = ∑ k = 0 ∞ γ k r t + k + 1 = r t + 1 + γ G t + 1 , γ ∈ 0 , 1 G_t = \sum_{k=0}^{\infty} \gamma^{k}\, r_{t+k+1} = r_{t+1} + \gamma\, G_{t+1}, \qquad \gamma \in 0, 1 Gt=k=0∑∞γkrt+k+1=rt+1+γGt+1,γ∈0,1
符号说明 : γ \gamma γ 权衡眼前与长远: γ → 0 \gamma \to 0 γ→0 贪心、 γ → 1 \gamma \to 1 γ→1 远视(常取 0.99 0.99 0.99);递推式是从轨迹反推回报的 O ( T ) O(T) O(T) 算法依据。
应用场景 :一切 RL 的目标定义;REINFORCE 直接用 G t G_t Gt 加权 log π \log \pi logπ。
PyTorch
python
# rewards: 一条轨迹的即时奖励列表 [r₀, r₁, ..., r_{T-1}]
G, out = 0.0, []                    # G 从轨迹末尾的 0 起步(终止后无未来奖励)
for r in reversed(rewards):         # 从后往前扫:因为 G_t 依赖 G_{t+1}
    G = r + gamma * G               # 递推 G_t = r_t + γ·G_{t+1}(公式右半,O(T) 一遍算完)
    out.insert(0, G)                # 倒着算的,插回表头恢复时间正序
returns = torch.tensor(out)         # (T,):每个时刻的"从此刻看总回报"
# 向量化替代(无循环): 用 torch.cumsum 配合 gamma 的幂,或 flip→cumsum→flip
代码解读
- 递推方向是关键: G t G_t Gt 需要"未来"信息,所以必须从轨迹尾部倒着算;正序循环做不到 O(T);
insert(0,·)是 O(n²),长轨迹可改out.append(G)后out[::-1]一次反转;- 非终止任务(持续控制)没有自然终点,改用 bootstrapping: G t = r t + γ V ( s t ) G_t = r_t + \gamma V(s_t) Gt=rt+γV(st)(见 8.2)。
示意图
时间 →    t=0     t=1     t=2     t=3(末)
r:        r₀      r₁      r₂      r₃
G:        G₀ ◀── G₁ ◀── G₂ ◀── G₃=r₃      反向递推: G_t = r_t + γG_{t+1}
          (γ 每往前一步把未来奖励"折价"一次)
γ k \gamma^k γk 折价曲线见 graph_discount.png
图形 : γ k \gamma^k γk 衰减曲线见附录 B.7
8.2 贝尔曼方程与 TD 误差
公式
V π ( s ) = E r + γ V π ( s ′ ) , Q ∗ ( s , a ) = E r + γ max a ′ Q ∗ ( s ′ , a ′ ) V^{\pi}(s) = \mathbb{E}\big r + \\gamma\\, V\^{\\pi}(s') \\big, \qquad Q^{*}(s, a) = \mathbb{E}\big r + \\gamma \\max_{a'} Q\^{\*}(s', a') \\big Vπ(s)=Er+γVπ(s′),Q∗(s,a)=Er+γa′maxQ∗(s′,a′)
δ t = r t + γ V ( s t + 1 ) − V ( s t ) \delta_t = r_t + \gamma\, V(s_{t+1}) - V(s_t) δt=rt+γV(st+1)−V(st)
符号说明 : V / Q V/Q V/Q 满足"自洽"递归------当前估计应等于即时奖励加折现的下一步估计;TD 误差 δ t \delta_t δt 度量自洽被破坏的程度,驱动一切 TD 学习。
应用场景 :DQN(用 δ 2 \delta^2 δ2 作损失)、Actor-Critic( δ \delta δ 作优势估计)、GAE( δ \delta δ 的加权累积)。
PyTorch
python
# v_net: Critic 网络,输入状态输出 V(s),形状 (B,1)
with torch.no_grad():                       # ⚠ 目标侧 r+γV(s') 必须切断梯度(半梯度 TD)
    target = r + gamma * v_net(s_next).squeeze(-1)   # (B,) 自洽目标 y
delta = target - v_net(s).squeeze(-1)       # (B,) TD 误差 δ_t = y − V(s)
loss = (delta ** 2).mean()                  # 最小化 δ² → 把 V(s) 拉向自洽目标
# 若不加 no_grad: 目标里也含 v_net 参数 → "自己追自己",训练发散(经典错误)
代码解读
- "半梯度":只对 δ \delta δ 中的 V ( s t ) V(s_t) V(st) 求导,把 V ( s t + 1 ) V(s_{t+1}) V(st+1) 当常数------这是 TD 方法稳定性的数学前提;
squeeze(-1)把 (B,1) 压成 (B,) 与 r 对齐;形状不齐是 RL 代码第二大 bug 源(第一是 no_grad);- DQN 只需把
v_net换成q_net(...).gather(1,a)、目标侧加max,其余完全同构。
示意图 :δ 在交互循环与 GAE 时间轴中的位置见 fig6_rl_loop.png
8.3 策略梯度与 PPO-Clip
公式
∇ θ J ( θ ) = E ∇ θ log π θ ( a ∣ s ) G t \nabla_{\theta} J(\theta) = \mathbb{E}\big \\nabla_{\\theta} \\log \\pi_{\\theta}(a \\mid s)\\, G_t \\big ∇θJ(θ)=E∇θlogπθ(a∣s)Gt
L C L I P ( θ ) = E min ( ρ t A \^ t , c l i p ( ρ t , 1 − ϵ , 1 + ϵ ) A \^ t ) , ρ t = π θ ( a t ∣ s t ) π θ o l d ( a t ∣ s t ) L^{\mathrm{CLIP}}(\theta) = \mathbb{E}\Big \\min\\big( \\rho_t \\hat{A}_t,\\; \\mathrm{clip}(\\rho_t,\\, 1-\\epsilon,\\, 1+\\epsilon)\\, \\hat{A}_t \\big) \\Big, \qquad \rho_t = \frac{\pi_{\theta}(a_t \mid s_t)}{\pi_{\theta_{\mathrm{old}}}(a_t \mid s_t)} LCLIP(θ)=Emin(ρtA\^t,clip(ρt,1−ϵ,1+ϵ)A\^t),ρt=πθold(at∣st)πθ(at∣st)
符号说明 : A ^ \hat A A^ 为优势函数(常用 GAE 估计); ρ t \rho_t ρt 为新旧策略的重要性采样比;clip 把单次更新幅度限制在 ± ϵ \pm\epsilon ±ϵ(常 0.2 0.2 0.2)内 → 训练稳定。
应用场景:机器人控制、游戏 AI、RLHF(大模型对齐即用 PPO 变种)。
PyTorch
python
# new_logp: 当前策略 π_θ 对"旧数据里动作"的 log 概率(本次 forward 算出,有梯度)
# old_logp: 收集数据时旧策略 π_θ_old 记录的 log 概率(常量,无梯度)
ratio = (new_logp - old_logp).exp()     # ρ = π_θ/π_θ_old = exp(log差)(比直接除概率数值稳)
surr1 = ratio * adv                     # 无约束目标: ρ·Â
surr2 = torch.clamp(ratio, 0.8, 1.2) * adv      # clip(ρ, 1−ε, 1+ε)·Â, ε=0.2
loss = -torch.min(surr1, surr2).mean()  # 取 min = 悲观下界;加负号因为优化器只做 minimize
# min 的作用: Â>0 时 ρ 超过 1.2 后梯度为0(不许再抬高好动作概率);Â<0 时对称
代码解读
- 整个 PPO 的"信任域"就靠 clip 一行实现:无需二阶信息就限制了单步策略变化幅度;
adv要先做标准化(adv−mean)/std(批内),否则量纲漂移导致裁剪阈值失效;- exp 的输入是 log 概率之差,天然避免下溢;ratio 初始≈1,偏离 1 的程度 = 策略已走多远。
示意图 :策略更新在交互循环中的位置见 fig6_rl_loop.png(下半 GAE 时间轴产出 adv)
图形 :交互循环与 GAE 时间轴见 fig6_rl_loop.png;GAE 权重曲线见附录 B.8
第九章 生成模型
9.1 VAE:ELBO 与重参数化
公式
log p ( x ) ≥ E q ( z ∣ x ) log p ( x ∣ z ) − D K L ( q ( z ∣ x ) ∥ p ( z ) ) (ELBO) \log p(x) \ \ge\ \mathbb{E}{q(z \mid x)}\big \\log p(x \\mid z) \\big - D{\mathrm{KL}}\big( q(z \mid x) \,\|\, p(z) \big) \qquad \text{(ELBO)} logp(x) ≥ Eq(z∣x)logp(x∣z)−DKL(q(z∣x)∥p(z))(ELBO)
z = μ + σ ⊙ ε , ε ∼ N ( 0 , I ) (重参数化) z = \mu + \sigma \odot \varepsilon, \quad \varepsilon \sim \mathcal{N}(0, I) \qquad \text{(重参数化)} z=μ+σ⊙ε,ε∼N(0,I)(重参数化)
D K L ( N ( μ , σ 2 ) ∥ N ( 0 , 1 ) ) = − 1 2 ∑ ( 1 + log σ 2 − μ 2 − σ 2 ) D_{\mathrm{KL}}\big(\mathcal{N}(\mu, \sigma^2) \,\|\, \mathcal{N}(0, 1)\big) = -\frac{1}{2}\sum \left( 1 + \log \sigma^{2} - \mu^{2} - \sigma^{2} \right) DKL(N(μ,σ2)∥N(0,1))=−21∑(1+logσ2−μ2−σ2)
符号说明 :ELBO 第一项是重建质量、第二项把后验拉回先验;重参数化把随机性移入 ε \varepsilon ε,使采样操作可导------VAE 能端到端训练的关键。
应用场景:图像生成与插值、表征学习、异常检测(重构误差大 = 异常)。
PyTorch
python
mu, logvar = encoder(x)          # 编码器输出两个头: μ 和 log σ²(学 log 值域无约束、更稳)
std = (0.5 * logvar).exp()       # σ = exp(logvar/2)
z = mu + std * torch.randn_like(mu)     # 重参数化: z = μ + σ⊙ε, ε~N(0,I)
# 关键: 随机性全在 ε 里 → z 对 (μ,σ) 是可导函数 → 梯度能穿过"采样"这一步

x_hat = decoder(z)               # 解码器重建 x̂ = p(x|z) 的均值
recon = F.binary_cross_entropy(x_hat, x, reduction='sum')   # −E[log p(x|z)],按样本求和
kl = -0.5 * (1 + logvar - mu.pow(2) - logvar.exp()).sum()   # KL 解析解,无需采样
loss = recon + kl                # = −ELBO;两项量级要平衡(β-VAE 给 kl 乘 β 调权重)
代码解读
- 若直接
z = Normal(mu,std).sample():采样节点不可导,encoder 收不到梯度------重参数化就是绕开它; randn_like(mu)保证 ε 与 μ 同形状同设备;每个 batch 重新采样(蒙特卡洛单样本估计已够用);- KL 用解析解而非采样估计:方差为零;公式即 − 1 2 ∑ ( 1 + log σ 2 − μ 2 − σ 2 ) -\frac12\sum(1+\log\sigma^2-\mu^2-\sigma^2) −21∑(1+logσ2−μ2−σ2) 的逐元素实现;
reduction='sum'与 KL 的 sum 配套(ELBO 是"每样本"的下界);用 mean 会让 KL 相对过强。
示意图
x ─▶ encoder ─▶ μ,logσ² ─┬─▶ z = μ+σ⊙ε ─▶ decoder ─▶ x̂ ─▶ recon 损失
                          │      ▲ ε~N(0,I)(梯度走 μ,σ 这条路)
                          └──────────────▶ KL 解析解 ─▶ + ─▶ loss
配图见 fig7a_vae.png
图形 :见 fig7a_vae.png
9.2 GAN:极小极大博弈
公式
min G max D V ( D , G ) = E x ∼ p d a t a log D ( x ) + E z ∼ p z log ( 1 − D ( G ( z ) ) ) \min_{G} \max_{D}\ V(D, G) = \mathbb{E}{x \sim p{\mathrm{data}}}\big \\log D(x) \\big + \mathbb{E}{z \sim p{z}}\big \\log\\big(1 - D(G(z))\\big) \\big GminDmax V(D,G)=Ex∼pdatalogD(x)+Ez∼pzlog(1−D(G(z)))
符号说明 : D D D 想把真样本判 1、假样本判 0; G G G 想让 D ( G ( z ) ) → 1 D(G(z)) \to 1 D(G(z))→1;纳什均衡时 D D D 处处输出 0.5 0.5 0.5。
应用场景:高分辨率图像生成(StyleGAN)、图像翻译(pix2pix)、数据增强;训练需交替更新、注意模式崩溃。
PyTorch
python
z = torch.randn(64, 100)                    # 64 个噪声向量 z ~ N(0,I)
one, zero = torch.ones(64,1), torch.zeros(64,1)   # 真/假标签

# ---- 第1步 训 D(冻结 G)----
fake = G(z).detach()        # ⚠ detach: 切断通往 G 的梯度,否则训 D 会顺带改 G
d_loss = F.binary_cross_entropy(D(real), one) + F.binary_cross_entropy(D(fake), zero)
opt_D.zero_grad(); d_loss.backward(); opt_D.step()

# ---- 第2步 训 G(冻结 D 的参数,但梯度要"穿过"D 流回 G)----
g_loss = F.binary_cross_entropy(D(G(z)), one)     # 非饱和变体: 让 D 把假图判成真
opt_G.zero_grad(); g_loss.backward(); opt_G.step()
# 注意这里不 detach: 梯度路径 G → D → loss 必须通畅(只是 opt_D 不更新而已)
代码解读
- 两个优化器各管一家:
opt_D只含D.parameters()、opt_G只含G.parameters(); detach()与"冻结"的区别:detach 断计算图(本次反向不流过),冻结是 requires_grad=False(永久);训 D 用 detach 更省事;- 原始极小极大里 G 的梯度是 log ( 1 − D ( G ( z ) ) ) \log(1-D(G(z))) log(1−D(G(z))),训练初期 D 太强 → 梯度≈0(饱和);非饱和变体 − log D ( G ( z ) ) -\log D(G(z)) −logD(G(z)) 梯度健康,是实战标准做法;
- 交替比例通常 1:1;D 赢太多/输太多都崩,监控两边 loss 与生成样本图。
示意图 :对抗结构与梯度通路见 fig7b_gan.png(造假者 vs 验钞员)
图形 :见 fig7b_gan.png
附录 A:公式 → PyTorch API 速查表
| 公式 | PyTorch API | 常用超参 |
|---|---|---|
| σ ( x ) \sigma(x) σ(x) sigmoid | torch.sigmoid / F.binary_cross_entropy_with_logits |
--- |
| ReLU / GELU | F.relu / F.gelu |
--- |
| BatchNorm | nn.BatchNorm1d/2d |
eps=1e-5, momentum=0.1 |
| LayerNorm | nn.LayerNorm(d) |
eps=1e-5 |
| MSE | F.mse_loss |
reduction='mean' |
| 交叉熵 | F.cross_entropy(吃 logits) |
label_smoothing=0~0.1 |
| KL | F.kl_div / kl_divergence |
reduction='batchmean' |
| SGD+动量 | optim.SGD(momentum=0.9) |
lr=0.01~0.1 |
| Adam / AdamW | optim.Adam / optim.AdamW |
lr=1e-4~1e-3, wd=0.01 |
| 余弦调度 | lr_scheduler.CosineAnnealingLR |
T_max=总步数 |
| 梯度裁剪 | clip_grad_norm_ |
max_norm=1.0 |
| Dropout | nn.Dropout(p) |
p=0.1~0.5 |
| 卷积 | nn.Conv2d(k, s, p) |
same: p=(k−1)/2 |
| 池化 | nn.MaxPool2d(2) |
stride=2 |
| RNN / LSTM | nn.RNN / nn.LSTM |
batch_first=True |
| 注意力 | F.scaled_dot_product_attention |
is_causal=True |
| 重参数化 | mu + std*eps(手写) |
--- |
附录 B:公式图像集(把公式画成函数曲线/图形)
正文每条公式配有结构示意图 (数据怎么流);本附录补上图像视角 :把公式本身画成函数曲线/图形,看它的形状如何随参数变化。
生成脚本:
make_formula_graphs.py。
公式 → 图像总览
| 编号 | 公式(正文章节) | 图像文件 | 图像告诉你什么 |
|---|---|---|---|
| G1 | 激活函数及导数(1.1--1.3) | graph_act_deriv / formula_activations | σ ′ \sigma' σ′ 峰值仅 0.25 且两端趋于 0 → 梯度消失;ReLU 正区间导数恒 1 |
| G2 | softmax 温度(1.1、7.3) | graph_softmax_temp | τ↓ 分布尖锐自信,τ↑ 平坦随机 |
| G3 | BN/LN 标准化(2.1--2.2) | graph_norm_hist | 任意分布被拉成 μ=0、σ=1 |
| G4 | 损失函数族(3.1--3.5) | formula_losses | MSE 放大大误差;Huber 折中;Focal 压低易分样本 |
| G5 | KL 散度(3.6) | formula_kl | 两分布间阴影面积 ≈ 差异程度(非对称) |
| G6 | 权重衰减(5.1) | graph_weight_decay | 权重按 ( 1 − η λ ) t (1-\eta\lambda)^t (1−ηλ)t 指数收缩向 0 |
| G7 | 优化器更新式(4.1--4.3) | formula_optimizers | 窄谷中三条轨迹:SGD 爬行 / 动量加速 / Adam 直达 |
| G8 | 学习率调度(4.4) | formula_lrschedule | α 随步数的形状:阶梯 / 余弦 / warmup |
| G9 | 卷积(6.1) | graph_conv1d / formula_conv | 卷积 = 滑动加权求和;差分核提取"变化率" |
| G10 | 位置编码(7.4) | graph_pe_heatmap | 低频→高频正弦条纹 = 每个位置的唯一指纹 |
| G11 | 折扣回报(8.1) | graph_discount | γ k \gamma^k γk 衰减:k 步后奖励的"现价",γ=0.99 半衰期≈69 步 |
| G12 | GAE 优势估计(8.3) | graph_gae_weights | ( γ λ ) l (\gamma\lambda)^l (γλ)l 权重:λ 是偏差←→方差的旋钮 |
| G13 | Dropout(5.2) | formula_dropout | 节点随机失活的结构图 |
| G14 | LSTM 门控(7.2) | formula_lstm | 三个门如何控制细胞状态的信息流 |
B.1 激活函数的导数(公式 1.1--1.3)
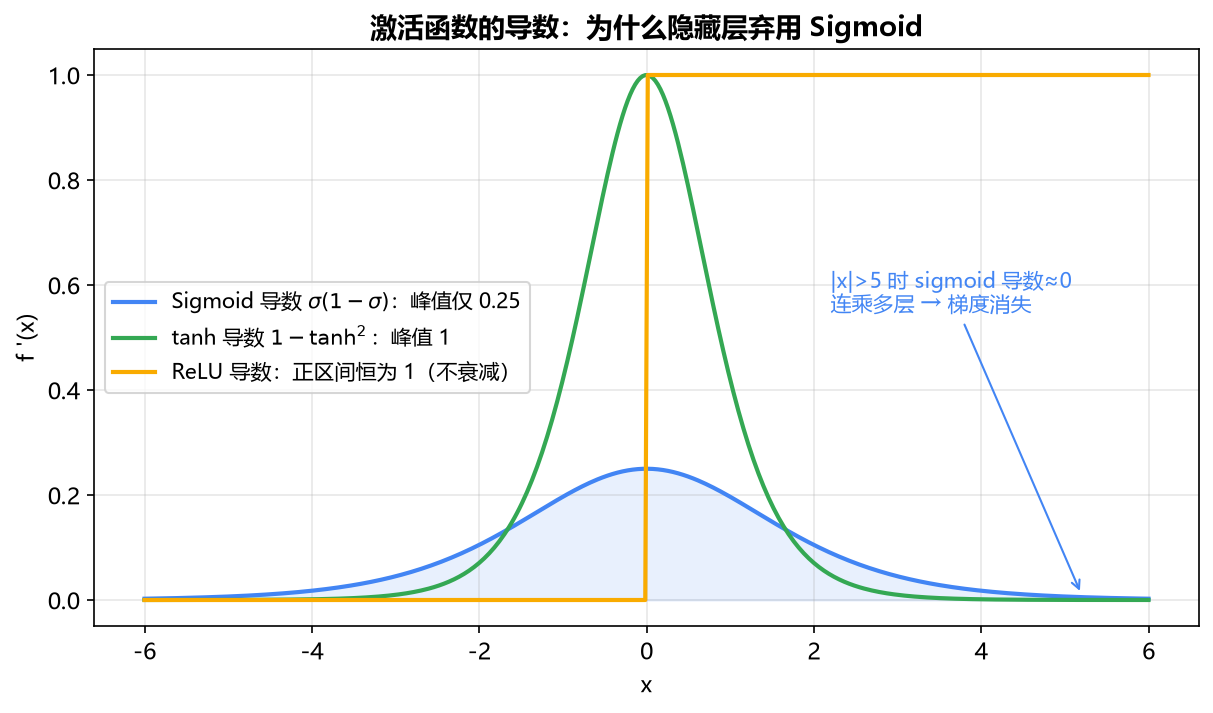
读图 :反向传播时梯度要连乘各层导数。 σ ′ ( x ) = σ ( 1 − σ ) \sigma'(x) = \sigma(1-\sigma) σ′(x)=σ(1−σ) 最大只有 0.25 0.25 0.25、 ∣ x ∣ > 5 \lvert x \rvert > 5 ∣x∣>5 后几乎为 0------连乘 10 层就剩 10 − 6 10^{-6} 10−6,这就是梯度消失;ReLU 正区间导数恒为 1,连乘不衰减,因此成为隐藏层默认。
B.2 softmax 的温度 τ(公式 1.1、7.3)
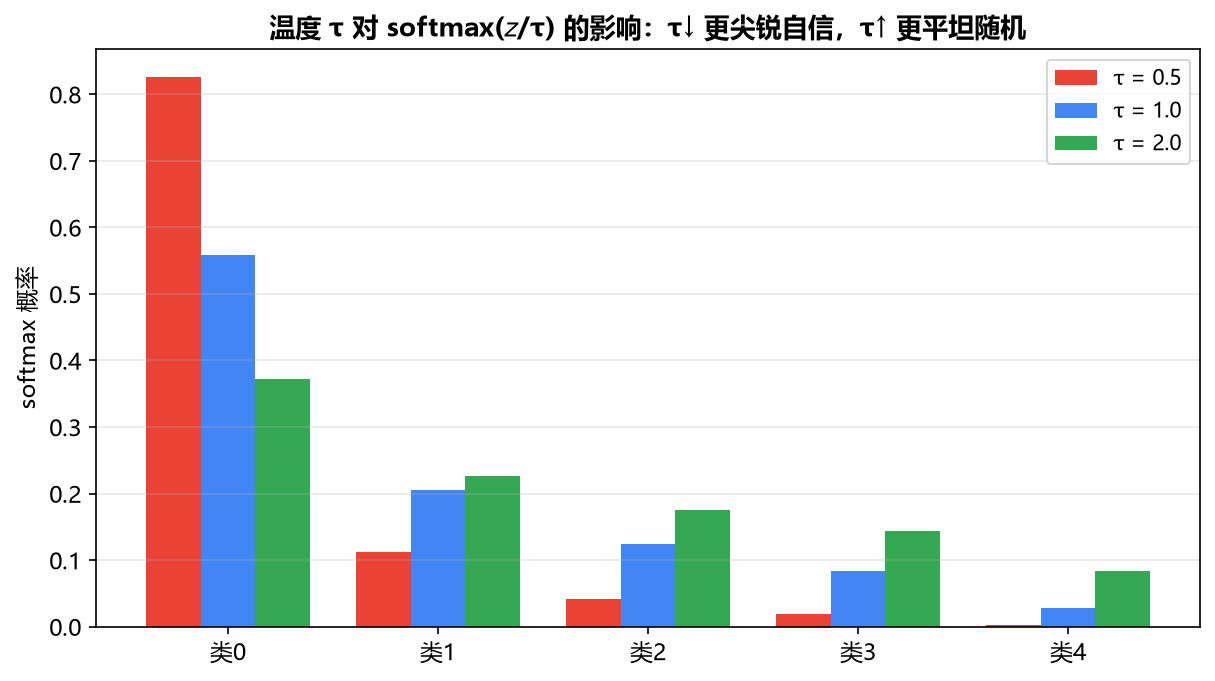
读图 :同一组 logits, τ = 0.5 \tau=0.5 τ=0.5 时最大类概率 0.83(尖锐), τ = 2 \tau=2 τ=2 时降到 0.37(平坦)。知识蒸馏用大 τ 让教师"说出"类间相似度;LLM 采样调 τ 控制创造性。
B.3 归一化前后的分布(公式 2.1--2.2)
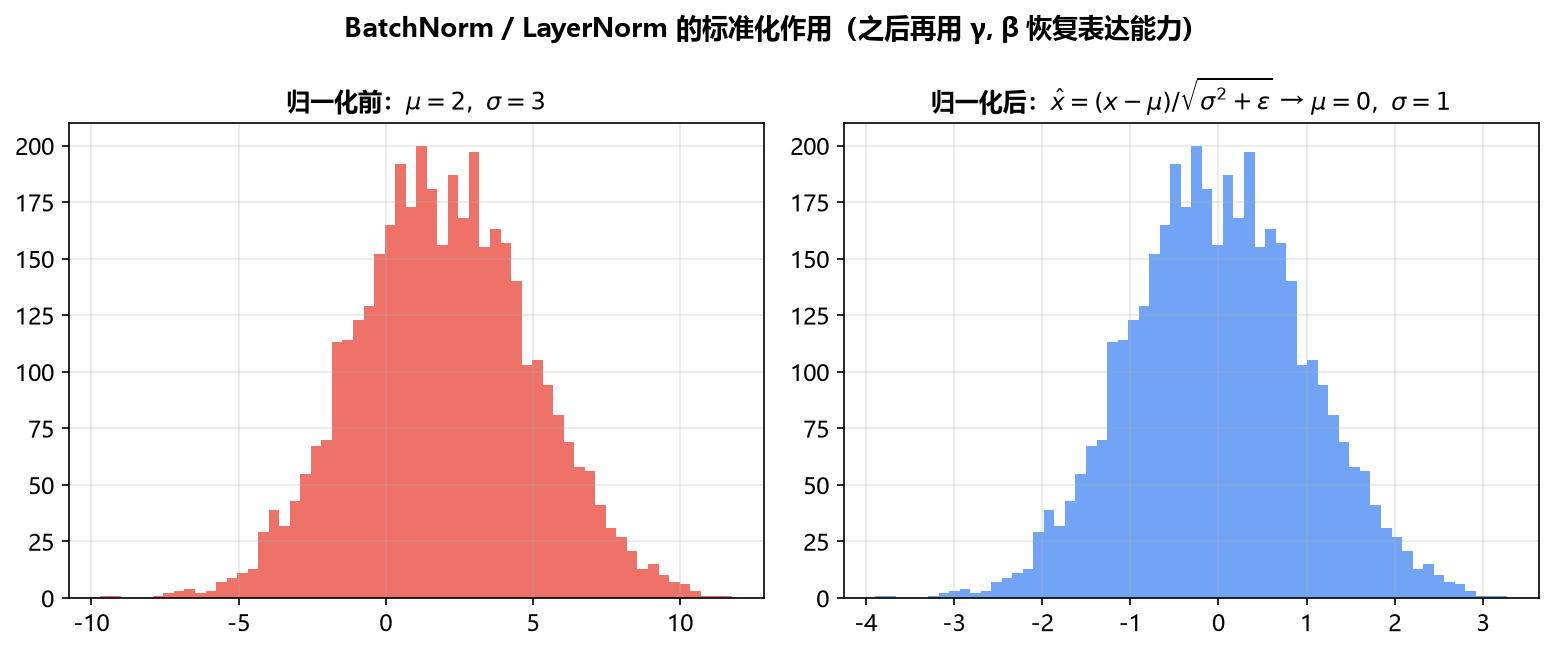
读图 :左为某层原始激活( μ = 2 \mu=2 μ=2、 σ = 3 \sigma=3 σ=3),右为 x ^ = ( x − μ ) / σ 2 + ϵ \hat x = (x-\mu)/\sqrt{\sigma^2+\epsilon} x^=(x−μ)/σ2+ϵ 之后------任何分布都被标准化为 μ = 0 \mu=0 μ=0、 σ = 1 \sigma=1 σ=1,各层输入尺度稳定,训练才敢用大学习率。 γ , β \gamma, \beta γ,β 再把它平移缩放回网络需要的形状。
B.4 权重衰减 = 权重指数收缩(公式 5.1)
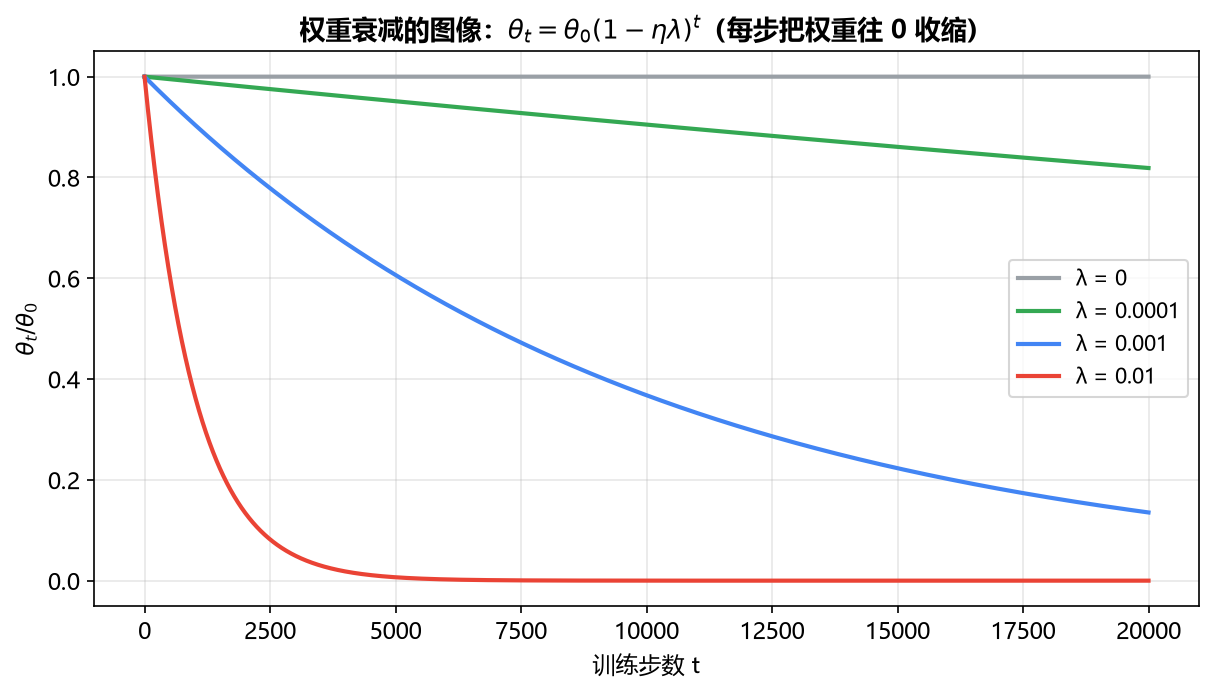
读图 :更新式 θ ← θ − η ∇ L − η λ θ \theta \leftarrow \theta - \eta\nabla\mathcal{L} - \eta\lambda\theta θ←θ−η∇L−ηλθ 中,即使梯度为 0,权重也每步乘 ( 1 − η λ ) (1-\eta\lambda) (1−ηλ)。 λ = 10 − 2 \lambda=10^{-2} λ=10−2 时 2 万步后权重只剩 13%------大 λ 强行压缩模型容量,小 λ( 10 − 4 10^{-4} 10−4)只做轻微约束。
B.5 一维卷积:滑动加权求和(公式 6.1)
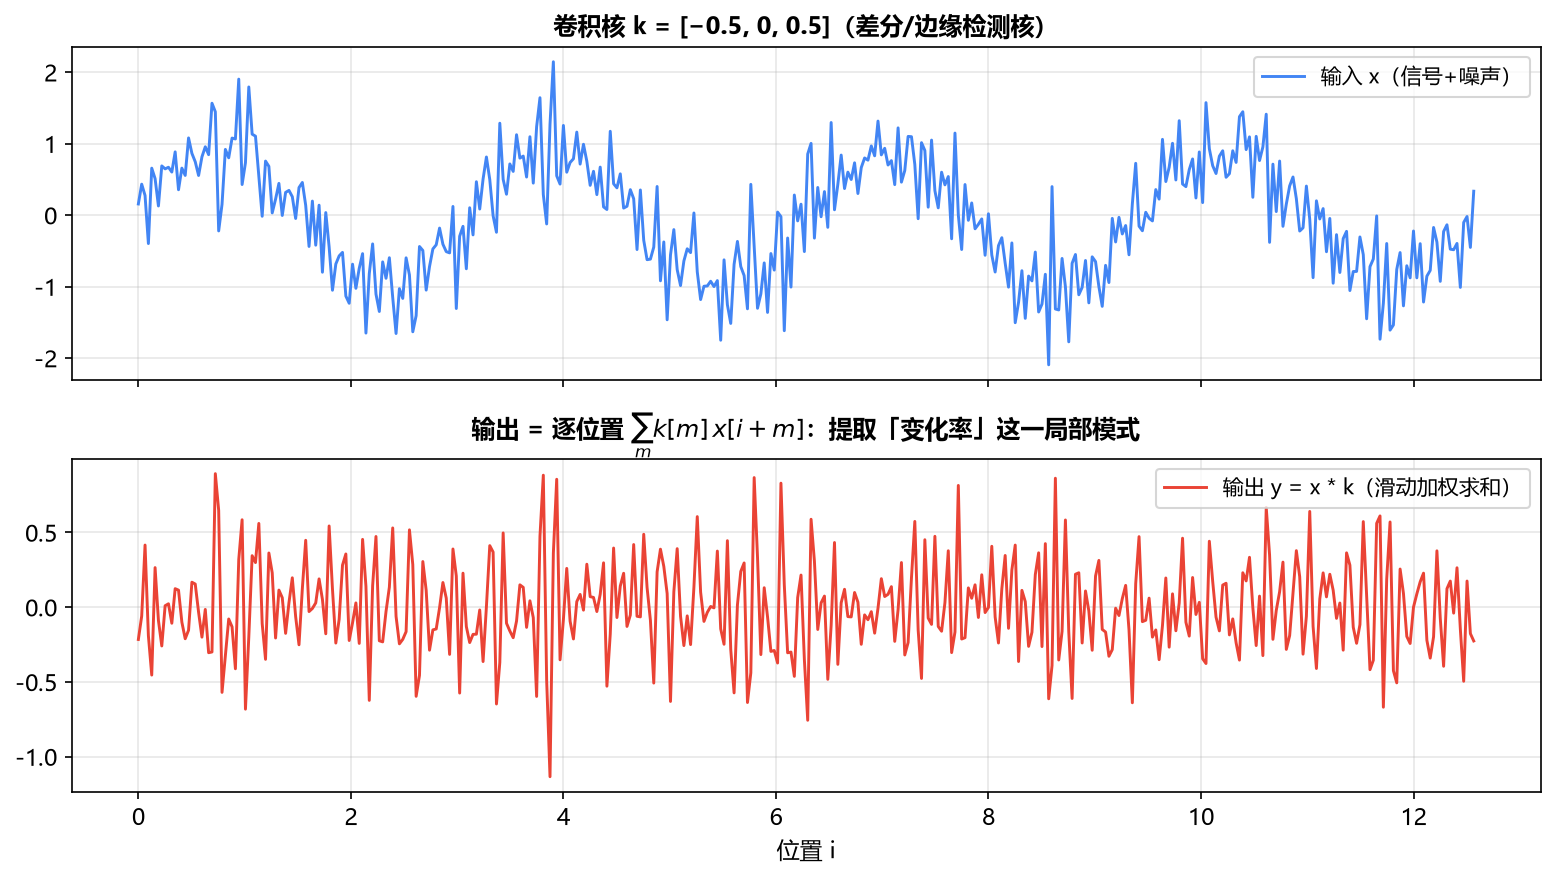
读图 :上为带噪输入信号,下为与差分核 − 0.5 , 0 , 0.5 -0.5, 0, 0.5 −0.5,0,0.5 卷积的输出------正弦变成余弦状(导数),噪声被差分放大。卷积核就是"模板",输出 y i = ∑ m k m x i + m yi = \sum_m km\,xi+m yi=∑mkmxi+m 即"哪里有这个模式"。
B.6 正弦位置编码热力图(公式 7.4)
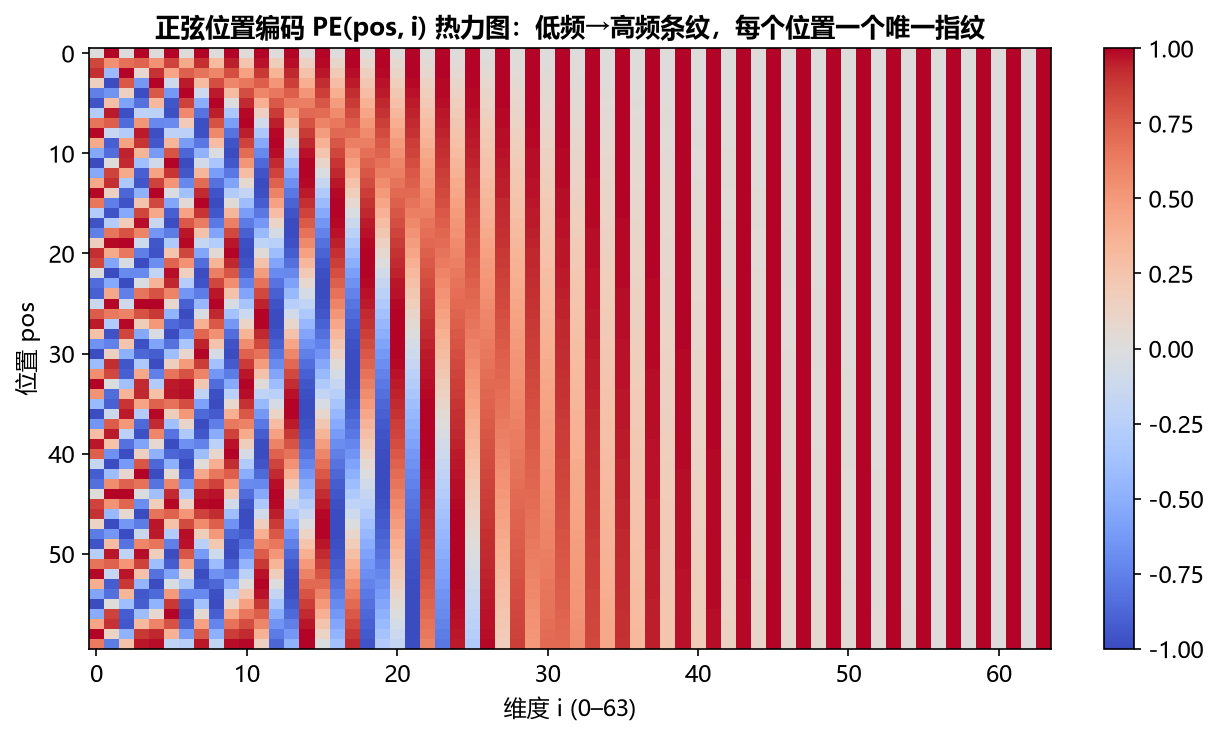
读图:行是位置、列是维度。左侧维度频率高(条纹密)、右侧频率低(条纹疏),类似二进制计数尺------任意两行的图案差异随位置距离单调变化,网络据此感知顺序与相对距离。
B.7 折扣因子 γᵏ:未来奖励的"现价"(公式 8.1)
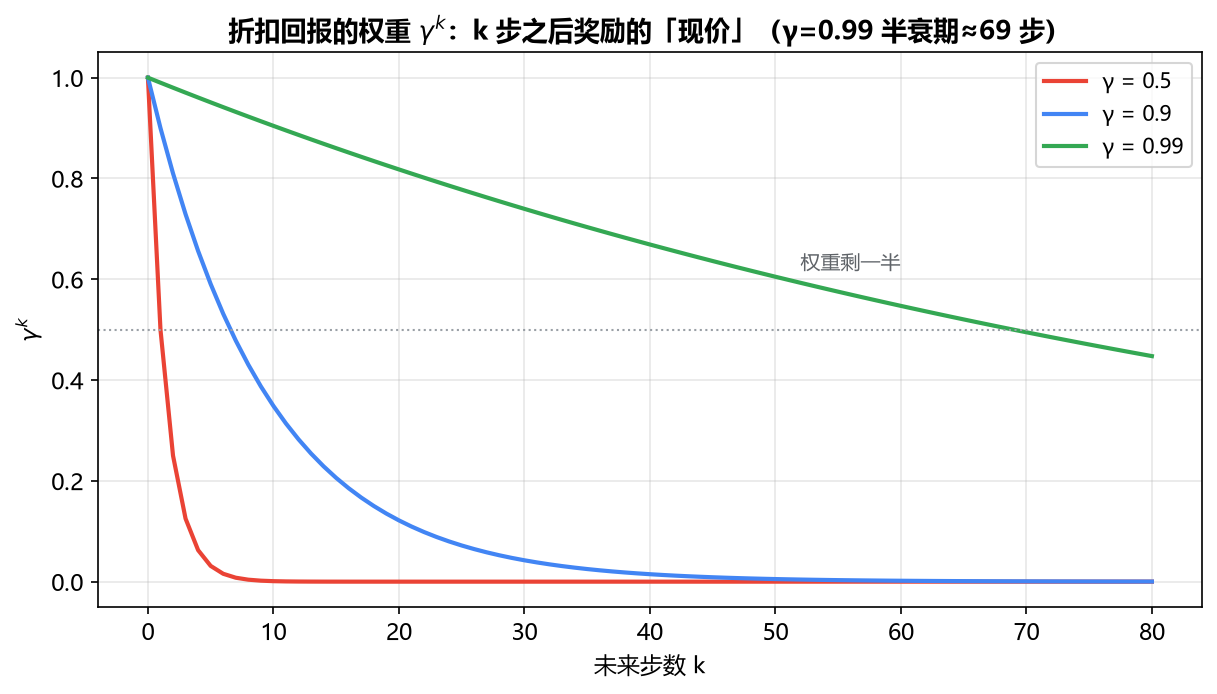
读图 : γ = 0.5 \gamma=0.5 γ=0.5 时 10 步后的奖励只值 0.001(极度短视); γ = 0.99 \gamma=0.99 γ=0.99 时 69 步后仍值一半(远视)。选 γ 就是选"智能体关心多远的未来",episodic 短任务用小 γ,持续控制用 0.99+。
B.8 GAE 的 (γλ)ˡ 权重(公式 8.3)
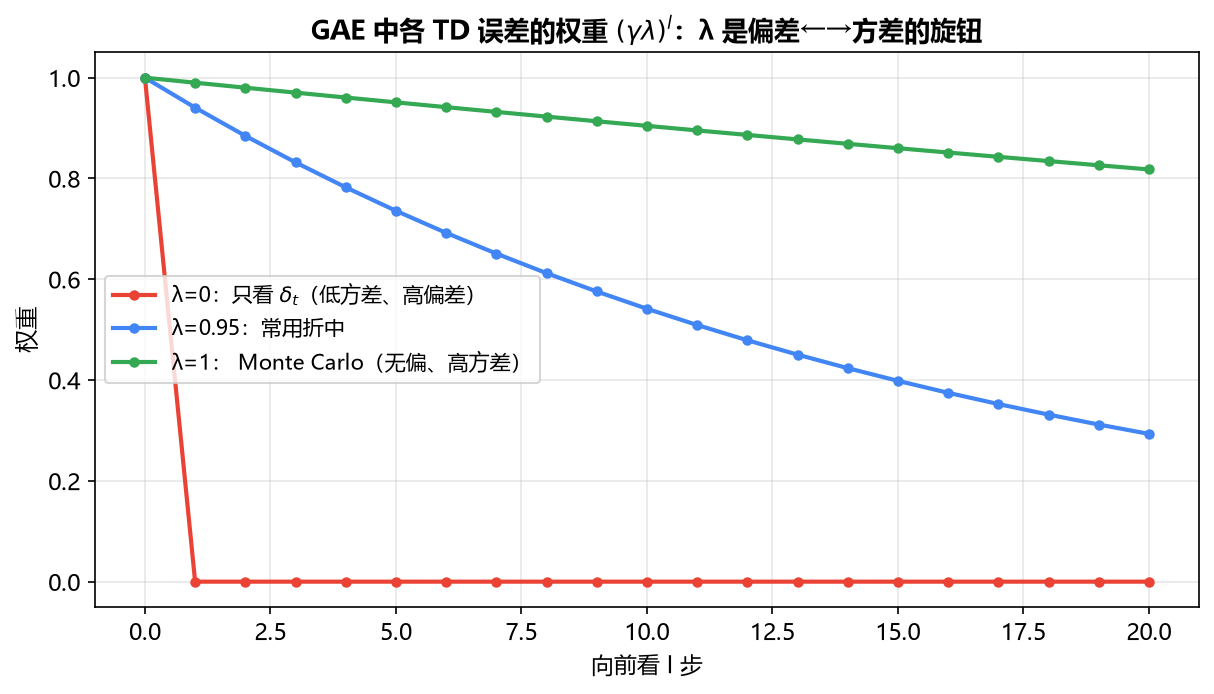
读图 : A ^ t = ∑ l ( γ λ ) l δ t + l \hat A_t = \sum_l (\gamma\lambda)^l \delta_{t+l} A^t=∑l(γλ)lδt+l 是未来各步 TD 误差的加权和,权重按 ( γ λ ) l (\gamma\lambda)^l (γλ)l 衰减。 λ = 0 \lambda=0 λ=0 只信当前一步 δ(方差小但有偏); λ = 1 \lambda=1 λ=1 把全部未来误差等权累加(无偏但方差大);0.95 是经验甜点位。