Kafka connect 就是一个数据传输的工具,可以使用connect非常方便的将外部系统当中的数据可以和Kafka之间做数据的传递。
比如说文件,比如说数据库。可以将文件中的数据导入到Kafka当中,也可以将MySQL中的数据导入到Kafka中。还可以将Kafka中的数据导出到MySQL,HDFS,离线的本地文件等等这些外部的存储设备。
比如也可以使用flume去采集日志文件的数据导入到Kafka中,或者将Kafka的数据导出到HDFS,这些其实也是可以去做到的。但是Kafka connect有它自己的优势,比如Kafka connect可伸缩,安全可靠,而且是一个流式的处理。
自动offset管理,生产者生产的消息是有offset,消费消费的消息也是有offset。如果要将数据库中的数据或者文件中的数据导入到Kafka,那数据库和文件扮演的是生产者的角色。Kafka拉取数据得知道拉取到什么位置了。这个文件中有新的行出现的时候,它得知道拉取什么样的数据。
而kafka offset是自动维护的,不需要手动去进行管理。
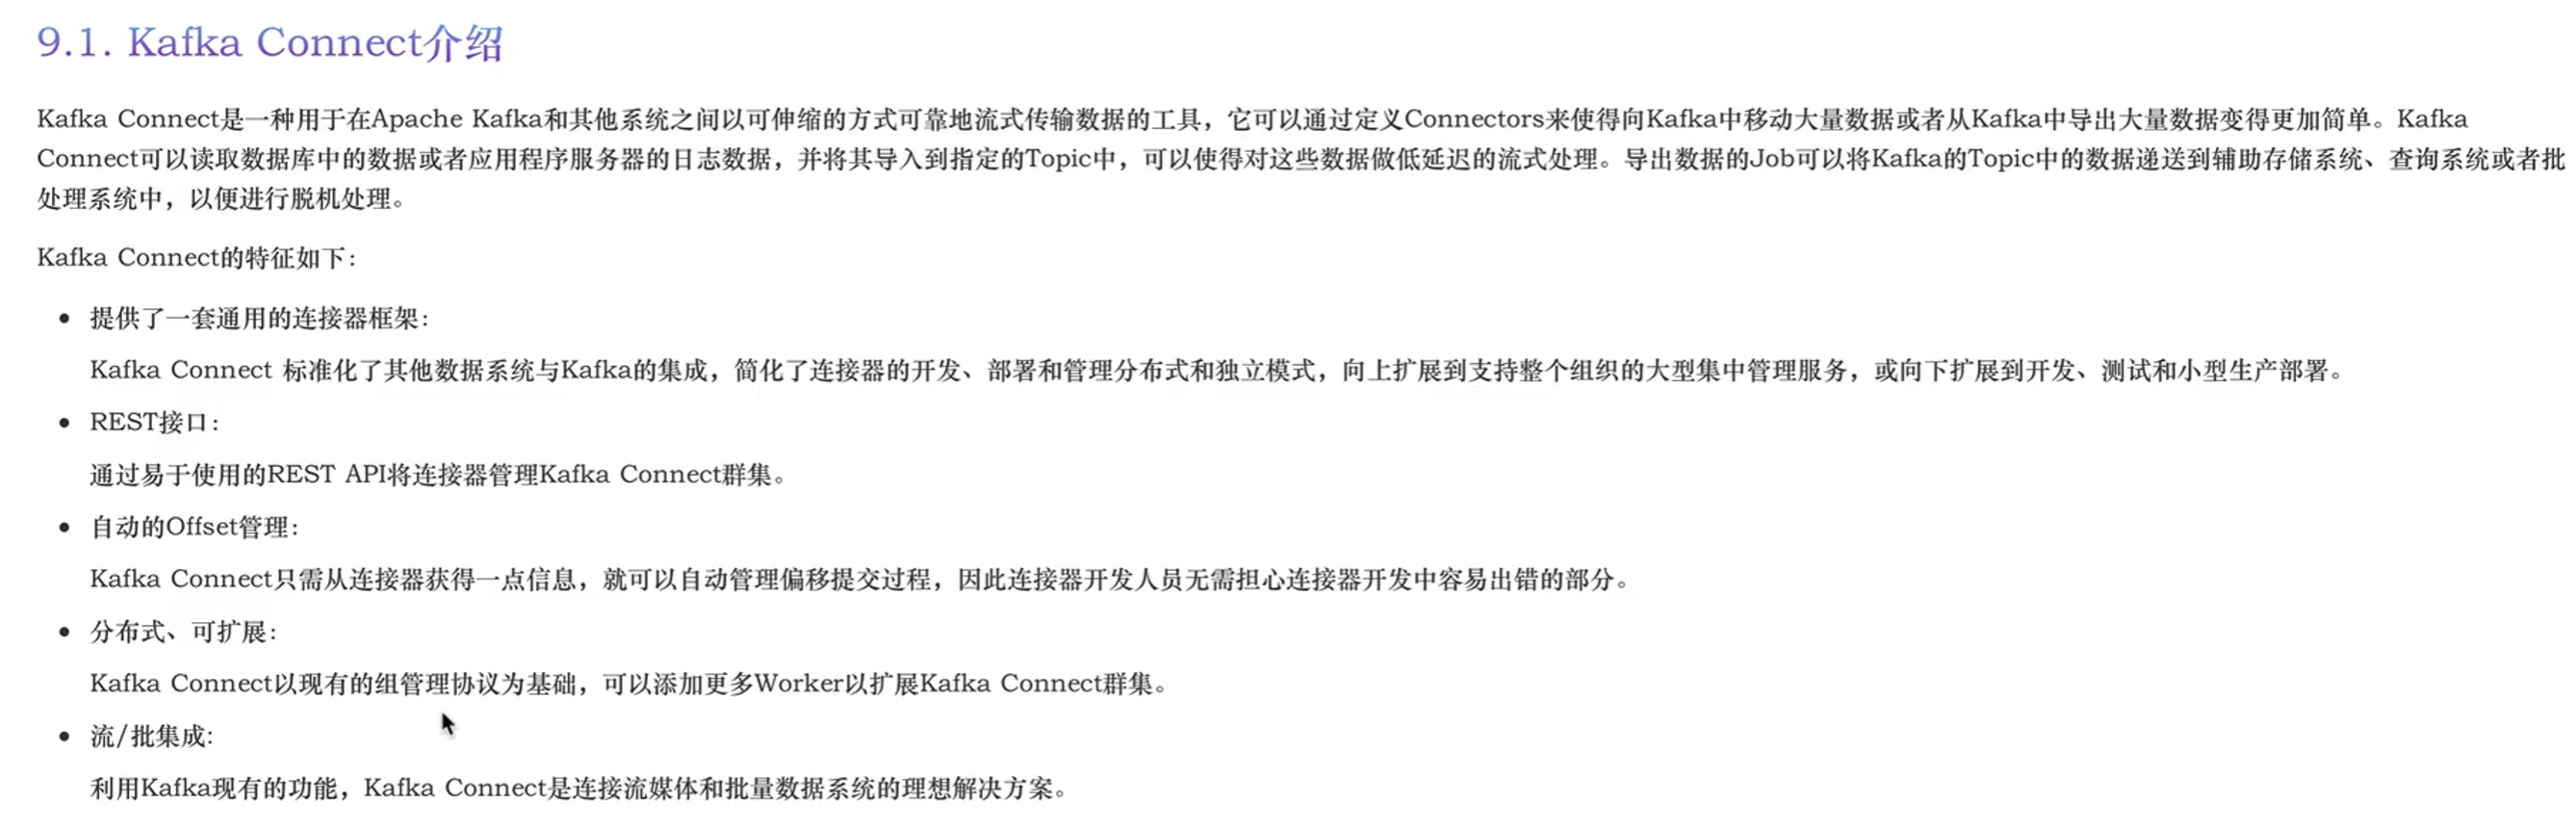
Kafka connect 就是一个与外部存储系统,数据系统之间的数据导入和导出的一个工具。
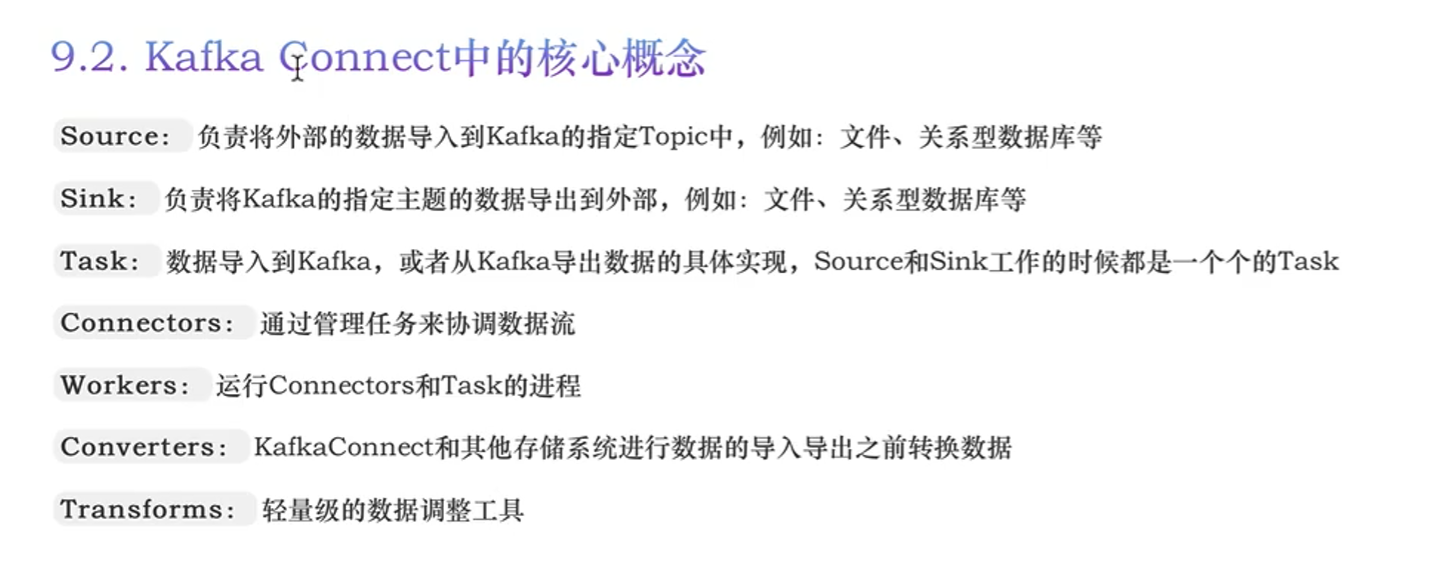
Kafka connect 单机模式
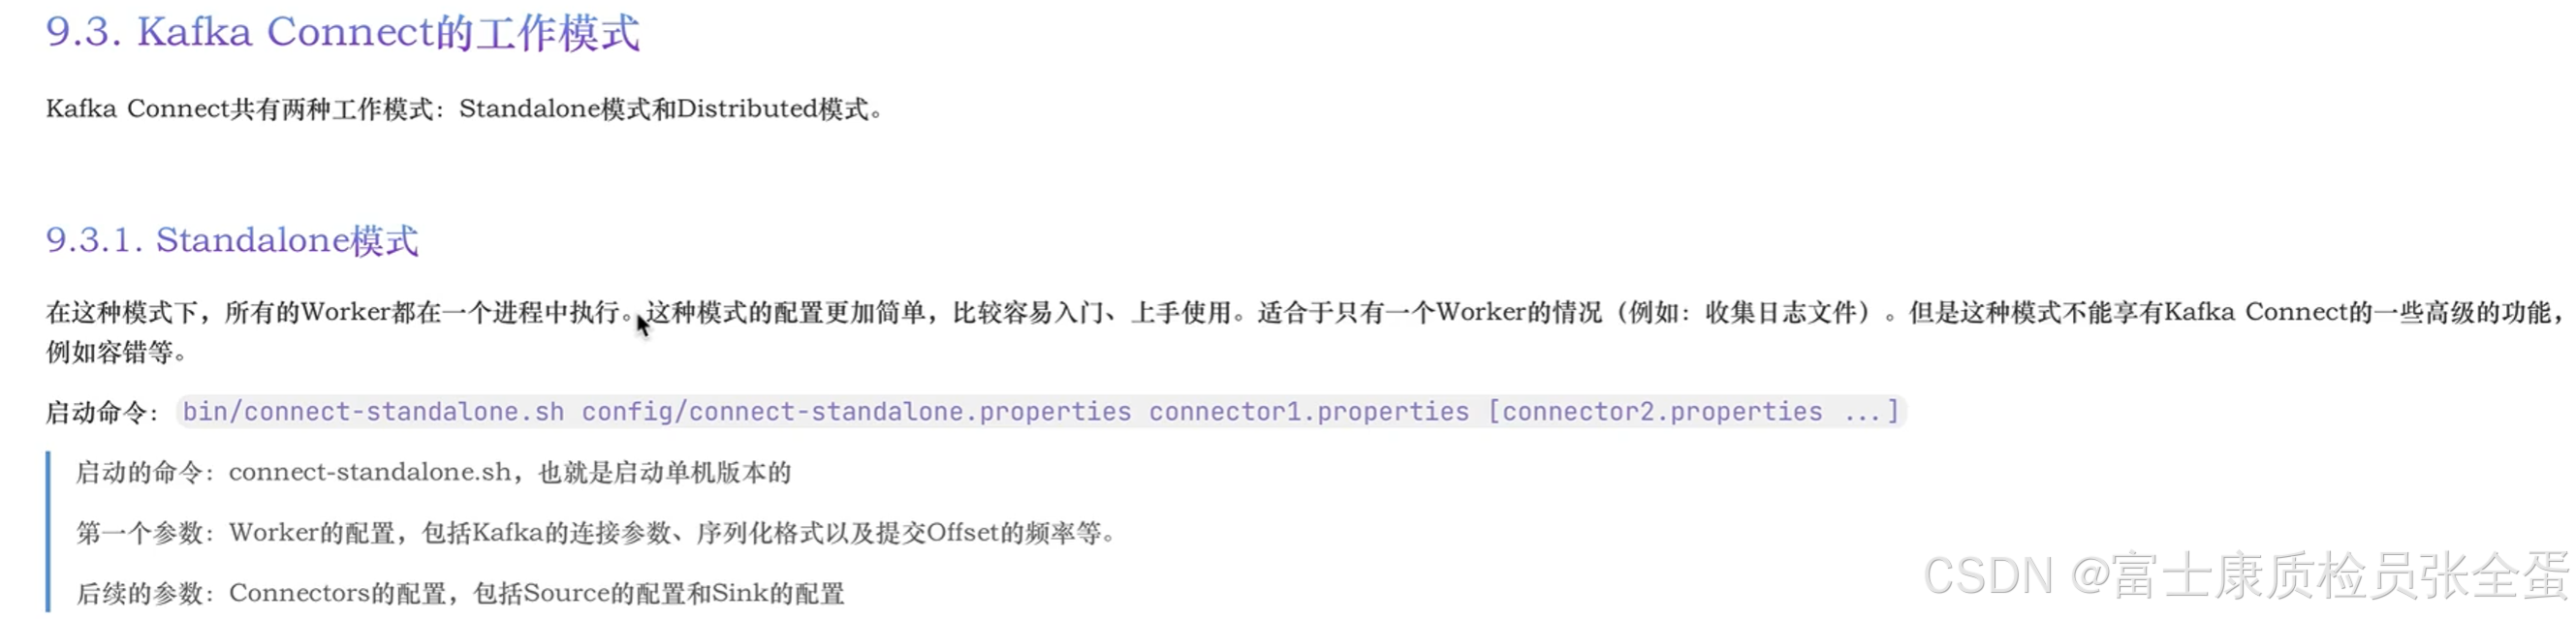
启动命令至少两个参数,一个是connect-stand-alone的一个配置,从第二个参数往后就是各种connect的配置了。
source是一种connect,sink也是一种connect。所以要将source的配置和sink的配置都放在后面的配置文件当中。
目录结构说明
kafka conf目录下的文件
├── connect-standalone.properties  # Connect 运行进程的主配置文件 (配置 JSON Converter)
├── connect-file-source.properties # FileSource Connector 配置文件(读文件 -> Kafka)
├── connect-file-sink.properties # FileSink Connector 配置文件(Kafka -> 写文件)文件一:connect-standalone.properties
Connect 运行进程的主配置文件,因为是一个单机版本,所以写localhost也是没有问题的。
bootstrap.servers=localhost:9092
这两个是转换器,当Kafka从外部的存储设备中读到了数据之后把这每一条的数据转换成什么格式,在这里转成了json格式。(Key 和 Value 的序列化方式:使用 JSON 格式)
key.converter=org.apache.kafka.connect.json.JsonConverter
value.converter=org.apache.kafka.connect.json.JsonConverter
默认是打开的状态,打开之后它能够有很多的键值对都存储到Kafka的topic当中。
key.converter.schemas.enable=true
value.converter.schemas.enable=true
Kafka connect会自动的保存offset,在stand alone的模式下,这个offset是保存在一个文件当中的。默认是保存在这个文件当中。(Standalone 模式下保存 Connector 偏移量(Offset)的文件路径)
offset.storage.file.filename=/tmp/connect.offsets
这个是自动保存offset一个偏移量,一个时间,10s。
offset.flush.interval.ms=10000
上面文件的内容其实不需要去修改什么。connect-standalone.properties 内容:
bootstrap.servers=10.20.13.111:9092,10.20.12.107:9092,10.20.13.112:9092

key.converter=org.apache.kafka.connect.json.JsonConverter
value.converter=org.apache.kafka.connect.json.JsonConverter
key.converter.schemas.enable=true
value.converter.schemas.enable=true

offset.storage.file.filename=/tmp/connect.offsets
offset.flush.interval.ms=10000

plugin.path=/apps/svr/kafka/libs

errors.tolerance=all
errors.log.enable=true
errors.log.include.messages=true
文件二:connect-file-source.properties
读取本地 JSON 文件并发送到 Kafka Topic 的 Connector 配置。
name=local-file-source 这个可以随便取,这个就是source的名字
connector.class=org.apache.kafka.connect.file.FileStreamSourceConnector 这个是读取文件的类
tasks.max=1 这个任务要跑在多少个task当中,stand alone只有一个task
file=/home/apps/access.log 要读取文件的位置
topic=connect-test 读到了文件之后将消息存在哪个主题当中
name=local-file-source
connector.class=org.apache.kafka.connect.file.FileStreamSourceConnector
tasks.max=1
file=/home/apps/access.log
topic=connect-test

[apps@TLKYVM202012107 kafka]$ bin/kafka-topics.sh --create --topic connect-test --bootstrap-server 10.202.13.111:9092,10.202.12.107:9092,10.202.1
3.112:9092 --partitions 3 --replication-factor 3
Created topic connect-test.
文件三:connect-file-sink.properties
name=local-file-sink
connector.class=org.apache.kafka.connect.file.FileStreamSinkConnector
tasks.max=1
file=test.sink.txt 最后数据要保存到什么文件当中
topics=connect-test
name=local-file-sink
connector.class=org.apache.kafka.connect.file.FileStreamSinkConnector
tasks.max=1
file=/home/apps/access.log.sink
topics=connect-test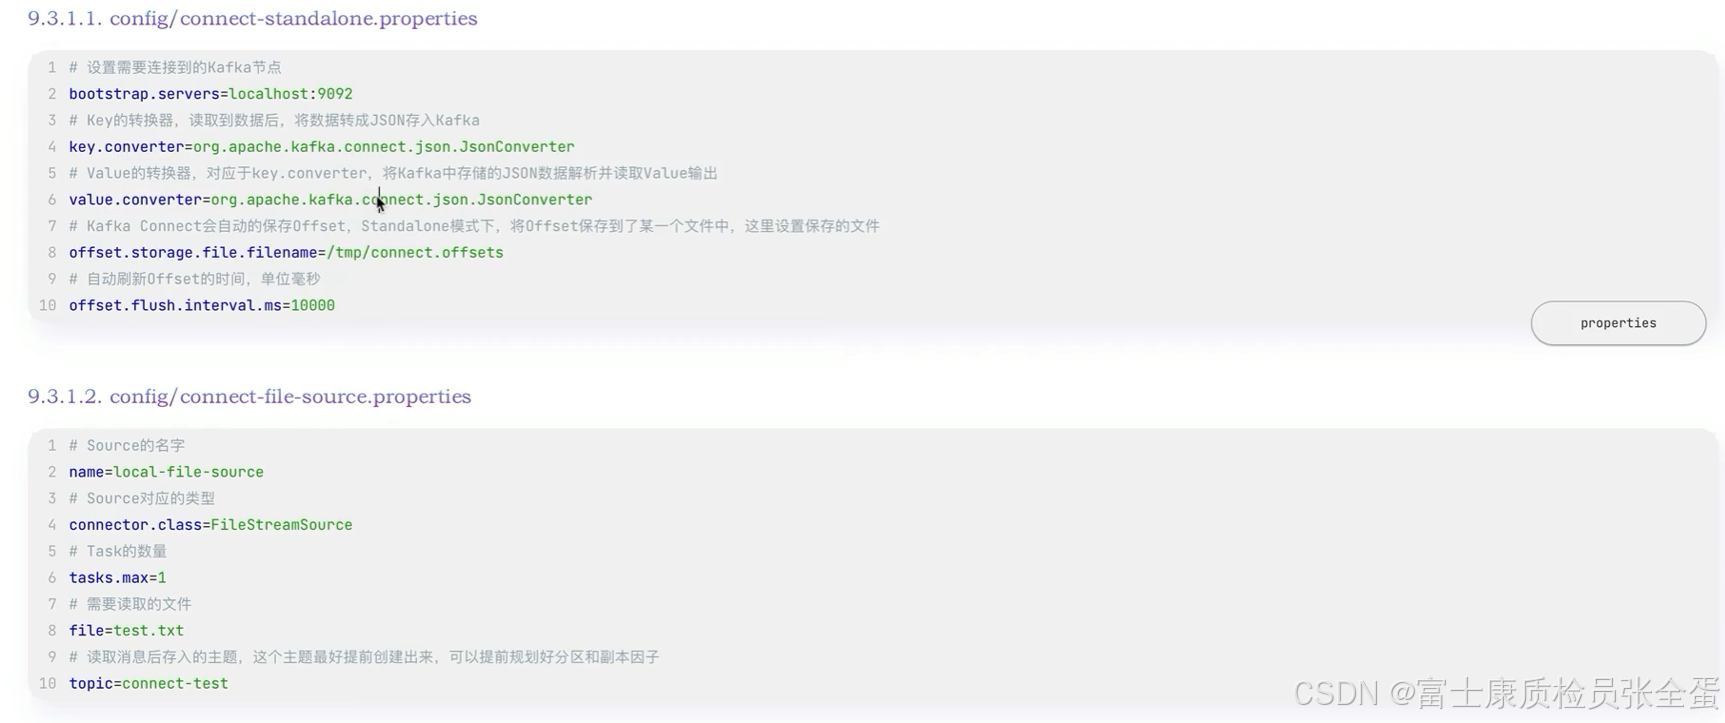
[apps kafka]$ ./bin/connect-standalone.sh -daemon  config/connect-standalone.properties config/connect-file-source.properties config/connect-file-sink.properties

[apps kafka]$ jps -l
58531 kafka.Kafka
9446 org.apache.zookeeper.server.quorum.QuorumPeerMain
84262 sun.tools.jps.Jps
20844 org.apache.kafka.connect.cli.ConnectStandalone
数据未写入文件(FileSink 无输出)诊断
通常是因为 Topic 中尚无新消息 、Connector 无法读取文件(权限/路径错误) 、或者 Converter 模式不匹配导致解析失败。
**1.检查 Source 文件的追加写入:**验证消息触发。
FileStreamSourceConnector 默认只读取启动后新增追加(Append)的内容 ,或者从上次 offset 继续读。如果 test-input.txt 在启动前就已经写入完毕,Connector 不会自动重新读取整份文件。
在控制台运行以下命令追加一条新的 JSON 数据:
[apps ~]$ echo '{"id": 1, "name": "Kafka Test"}' >> access.log验证方式 :观察控制台日志是否有数据发送记录,并检查 access.log.sink 是否产生数据。
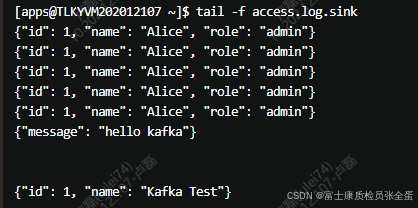
**2.检查 Kafka Topic 是否有数据:**确认 Source 是否成功发消息。
使用 Kafka 自带的命令行消费者,确认 FileStreamSource 是否成功将数据写入到了 Kafka Topic 中:
[apps kafka]$ bin/kafka-console-consumer.sh  --bootstrap-server 10.202.13.111:9092,10.202.12.107:9092,10.202.13.112:9092 --topic connect-test  --from-beginning
{"schema":{"type":"string","optional":false},"payload":"{\"id\": 1, \"name\": \"Kafka Test\"}"}
{"schema":{"type":"string","optional":false},"payload":"{\"id\": 1, \"name\": \"Alice\", \"role\": \"admin\"}"}
{"schema":{"type":"string","optional":false},"payload":"{\"id\": 1, \"name\": \"Alice\", \"role\": \"admin\"}"}
{"schema":{"type":"string","optional":false},"payload":"{\"id\": 1, \"name\": \"Alice\", \"role\": \"admin\"}"}
{"schema":{"type":"string","optional":false},"payload":"{\"id\": 1, \"name\": \"Alice\", \"role\": \"admin\"}"}
{"schema":{"type":"string","optional":false},"payload":"{\"id\": 1, \"name\": \"Alice\", \"role\": \"admin\"}"}
{"schema":{"type":"string","optional":false},"payload":"{\"message\": \"hello kafka\"}"}
**3.排查 JsonConverter 格式匹配问题:**检查 Schema 开关。
如果 connect-standalone.properties 中设置了 value.converter=org.apache.kafka.connect.json.JsonConverter,请核对 schemas.enable 的设置:
-
如果
value.converter.schemas.enable=false:Topic 中的消息必须是纯 JSON(例如{"id":1})。 -
如果
value.converter.schemas.enable=true:Topic 中的消息必须包含schema和payload结构(例如{"schema":{...},"payload":{"id":1}})。
若配置与实际消息格式不匹配,Sink 会跳过或抛出转换异常。
验证方式 :查看启动终端输出的日志中是否有 DataException 或 ParseException。
**4.检查文件路径与写权限:**确认输出文件创建成功。
检查 connect-file-sink.properties 中的 file 路径:
-
确认指定路径的上级目录是否存在且当前运行 Kafka 的用户拥有写权限。
-
如果写的是相对路径,它会创建在执行启动命令时的当前工作目录下。
验证方式 :使用绝对路径测试(例如 file=/home/apps/access.log.sink),并检查该路径下是否成功创建了文件。
**5.检查 logs 目录下的日志文件:**定位后台日志。
-daemon 模式默认会将控制台标准输出和错误日志重定向到 Kafka 安装目录下的 logs/ 文件夹中(例如 connect.out 或 connect.log)。