水光互补短期调度:一次 NSGA-II 双目标优化的完整拆解
光伏在中午顶着满发,傍晚归零;电网负荷的高峰却落在上午和晚间。
两条曲线错开大约三个小时,中间的缺口交给水电来补。今天要拆的这份 MATLAB 代码,回答的问题很具体:一天 24 小时,水库水位该怎么安排,才能既压住水光总出力的峰值,又让出力尽量贴着负荷走。
80 个个体,70 代迭代,最后交出一张 63 个解的帕累托前沿。下面从数学模型一路拆到运行结果。
一、研究背景
光伏出力在 14 时前后达到 277 MW,19 时之后归零。电网负荷在 11 时冲到 1340 MW,午后跌到 572 MW,晚间再回到 780 MW 附近。负荷的日内波动是 2.3 倍,光伏的波动是它的全部。
水电在这里充当调节电源,但调节能力有边界。代码把库水位限制在 2451.5 到 2455 m 之间,折算成发电流量是 175.7 到 1029.0 m³/s,对应出力 186 到 1091 MW。上限看着很宽,真正绑住手脚的却是另一条约束:水光总出力不得超过电网负荷。
削峰和贴合负荷因此构成一对矛盾。把水位压低,总出力峰值跟着下来,出力与负荷之间的缺口就拉大;贴着负荷走,峰值又必然被顶上去。两个目标都想取最优,只能交给多目标算法,一次算出一整条权衡曲线。
二、代码做了什么
输入是一个 1×24 的水位序列,输出是两个目标值,另有一份存着完整前沿解集的 .mat 文件。
| 文件 | 承担的工作 |
|---|---|
main.m |
参数设定、种群初始化、NSGA-II 主循环、结果保存 |
myfun.m |
计算两个目标值 f1、f2 |
HydroData.m |
集中定义负荷、光伏与电站参数 |
test.m |
约束校验,返回可行标志 |
Dominates.m |
判断两个解之间的支配关系 |
NonDominatedSorting.m |
快速非支配排序,为每个个体标注等级 |
CalcCrowdingDistance.m |
计算拥挤距离,维持前沿解的分布均匀性 |
SortPopulation.m |
先按等级升序、再按拥挤距离降序排列种群 |
Crossover.m |
算术交叉算子 |
Mutate.m |
高斯变异算子 |
PlotCosts.m |
主循环中的实时前沿绘图 |
result.m |
结果输出、折中解选取与六张成果图 |
HydroData.m 的写法值得借鉴。负荷、光伏、出力系数、水头、水位流量拟合系数全部收在一个函数里,目标函数、约束函数和主程序各自调用,同一组常数不会在三处各写一遍。改参数的时候省事,也少了版本对不上的隐患。
三、数学模型与公式原理
3.1 决策变量与水位流量关系
决策变量是 24 个小时的库水位 x(t)。发电流量与水位用一条线性拟合关系换算:
Q_m(t) = 243.8 · x(t) − 597500 [m³/s]斜率 243.8 的含义是水位每抬高 1 m,发电流量增加 243.8 m³/s。代入上下限:水位 2451.5 m 对应 175.7 m³/s,2455 m 对应 1029.0 m³/s。前者低于发电流量下限 200 m³/s,真正可用的水位下沿因此被抬到 2451.60 m。
3.2 水电出力核算
P_W(t) = A · Q_m(t) · H_mA = 8.5 是电站综合出力系数,H_m = 124.75 / 1000 = 0.12475 km 是平均发电水头。水头用 km 而不是 m 输入,是为了让出力直接落在 MW 量级。标准出力公式是 P = 9.81·η·Q·H,水头换成 km 之后写成 P(MW) = 9.81·η·Q·H(km),于是 A 实际等效于 9.81η,反推电站综合效率约 0.867,落在常规机组的合理区间里。
代入数值,P_W ≈ 1.0604 × Q_m。折中解中 655 m³/s 的流量对应 694.8 MW 出力,量级自洽。
3.3 两个目标函数
f1 = max_t [ P_W(t) + P_p(t) ]
f2 = sqrt( (1/24) · Σ_t [ P_D(t) − P_W(t) − P_p(t) ]² )
f1 取 24 个时段水光总出力的最大值,最小化它就等于削峰。f2 是出力与负荷之差的均方根,最小化它等于让出力曲线贴住负荷曲线。
这里有个容易忽略的地方。约束要求水光总出力不得超负荷,所以 P_D − P_W − P_p 恒为非负,f2 度量的是"缺了多少",而不是"偏了多少"。折中解的缺额均值 145.7 MW、标准差 134.8 MW,两者量级相当,说明 f2 既反映了平均缺口水平,也包含了缺口的起伏。
3.4 约束条件
(1)  0 ≤ P_W ≤ 17803 MW
(2)  P_W + P_p ≤ P_D
(3)  200 ≤ Q_m ≤ 7000 m³/s
(4)  库容上下限(代码中已注释,未启用)
四条约束里,实际起作用的是第三条的下限和第二条。
发电流量下限 200 m³/s 把水位下限从 2451.5 m 抬到 2451.60 m。第二条约束更狠,它给每个时段切出一条独立的上限:
x_UB(t) = ( (P_D(t) − P_p(t)) / (A·H_m) − k0 ) / k124 个时段里最紧的是 14 时,上限只有 2451.95 m,可行带宽 0.35 m。11 时因为负荷高、光伏也不低,这条约束反而失效,水位上限退回到 2455 m 的箱式边界。
另外两条上限在本算例中永远不会触发。流量上限 7000 m³/s 反算对应水位 2479.5 m,比水位上限还高 24.5 m;出力上限 17803 MW 反算对应流量 16789 m³/s,是流量上限的 2.4 倍。两个数字彼此不匹配,多半来自不同机组的参数,建议按实际机组容量与满发流量重新标定。
四、算法步骤
NSGA-II 的六个环节,在这份代码里都有对应实现。
- 种群初始化。主循环之前先由约束反推可行区间,记作逐时的
[x_LB, x_UB],再在盒内均匀采样。80 个个体一次生成完毕,不会因为可行域狭窄而反复重采样。这一步处理得干净。 - 快速非支配排序。两两比较所有个体,为每个个体记录它支配了谁、以及被多少个体支配。被支配数为 0 的个体构成第一前沿,逐层剥离得到后续各层。
- 拥挤距离。在同一层前沿内,按每个目标分别排序,取相邻两个解的目标值之差做归一化,再对各目标方向求和。边界解的距离设为无穷大,保证前沿两端不被丢弃。
- 交叉。每次随机挑两个父代做算术交叉,
y1 = α·x1 + (1−α)·x2,y2 = α·x2 + (1−α)·x1,α 是逐维随机系数。交叉比例 0.7,实际产生 56 个子代。 - 变异。从 24 个基因里随机挑出 1 个(
ceil(0.02 × 24) = 1),叠加标准差 0.35 m 的高斯扰动。变异比例 0.4,每代有 32 个个体参与变异。 - 环境选择。父代、交叉子代、变异子代合并成一个 168 个体的临时种群,重新做非支配排序与拥挤距离计算,再按"等级优先、同等级看拥挤距离"的顺序截断回 80 个。
约束怎么处理?代码用的是拒绝策略:交叉或变异产生的个体只要 test() 返回 0,就直接丢弃,用父代替换。因为初始种群本身就落在可行盒内,这种做法在本算例里不会导致种群收缩,代价是牺牲了一部分搜索多样性。
五、技术路线
把上面的环节串起来,整条路线是这样:
初始化:在逐时可行区间 [x_LB, x_UB] 内均匀采样 80 个个体
   ↓
非支配排序 + 拥挤距离计算
   ↓
for it = 1 : 70
    随机选择父代 → 算术交叉(56 子代)→ 高斯变异(32 子代)
    约束校验,违反者回退父代
    父代 + 交叉子代 + 变异子代 合并为 168 个体
    非支配排序 → 拥挤距离 → 排序 → 截断回 80
    记录本代最小 f1、最小 f2 与前沿解个数
end
   ↓
输出帕累托前沿、折中解与 24 小时调度过程
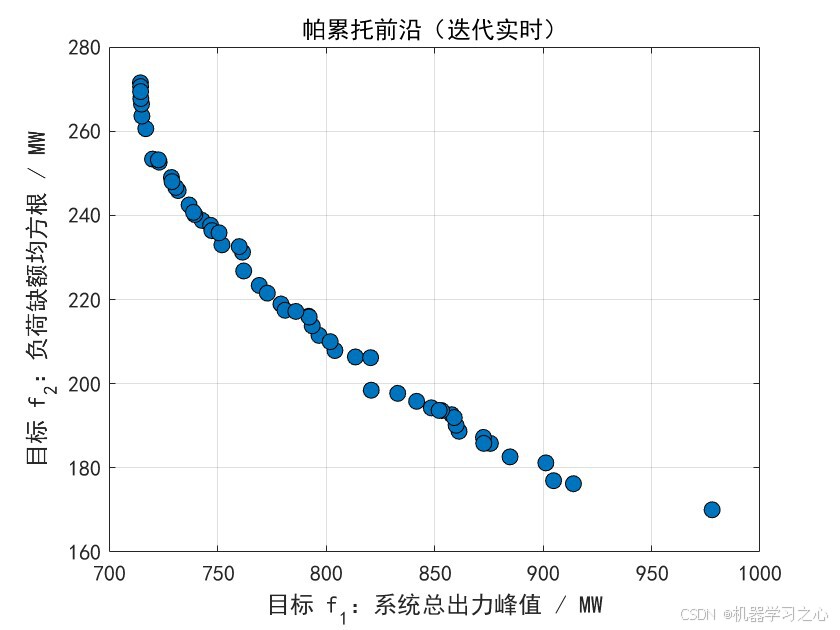
下面的图是主循环跑到第 70 代时的实时前沿。横轴是系统总出力峰值,纵轴是负荷缺额均方根,每个点代表一套完整的 24 小时调度方案。
六、参数设定
算法参数:
| 参数 | 取值 | 说明 |
|---|---|---|
nVar |
24 | 决策变量维数,即调度时段数 |
VarMin / VarMax |
2451.5 / 2455 m | 库水位上下限 |
nObj |
2 | 目标个数 |
MaxIt |
70 | 最大迭代代数 |
nPop |
80 | 种群规模 |
pCrossover |
0.7(56 个子代) | 交叉比例 |
pMutation |
0.4(32 个个体) | 变异比例 |
mu |
0.02(每代 1 个基因) | 变异率 |
sigma |
0.35 m | 高斯变异步长 |
PlotStep |
10 | 实时绘图间隔 |
电站与负荷数据:
| 符号 | 取值 | 说明 |
|---|---|---|
P_D |
572 ~ 1340 MW | 24 小时电网负荷 |
P_p |
0 ~ 277 MW | 24 小时光伏出力 |
A |
8.5 | 电站综合出力系数 |
H_m |
0.12475 km | 平均发电水头(124.75 m) |
k1 / k0 |
243.8 / −597500 | 水位流量线性拟合系数 |
P_W 上下限 |
0 / 17803 MW | 水电出力约束 |
Q_m 上下限 |
200 / 7000 m³/s | 发电流量约束 |
七、运行结果
7.1 收敛过程
70 代跑完,前沿解个数从第 1 代的 8 个增长到第 70 代的 63 个,中途在第 64 代达到最多的 74 个。最终 f1 稳定在 714.49 MW ,f2 稳定在 170.04 MW。
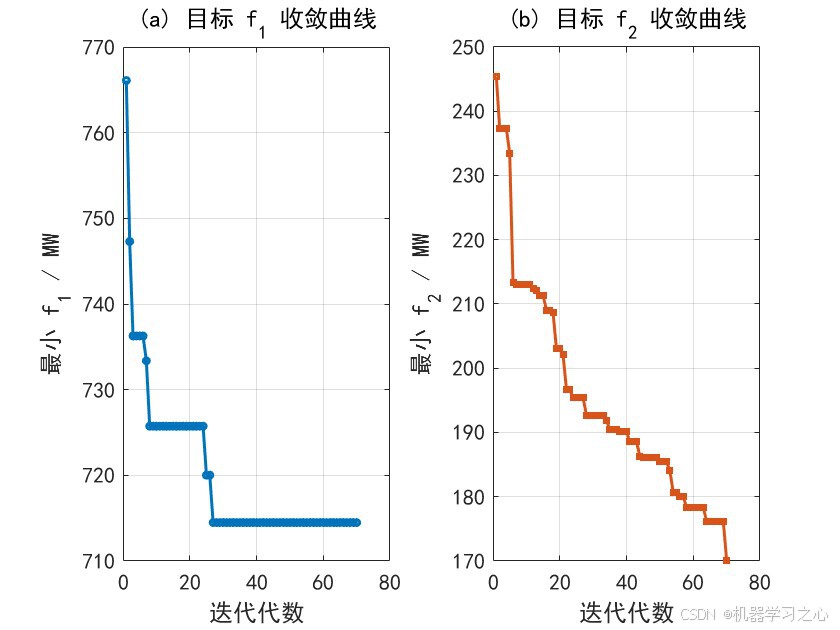
收敛曲线呈明显的阶梯状,前 30 代贡献了绝大部分改进,40 代之后两条曲线基本走平。阶梯形态和目标函数的结构有关:f1 取的是 24 个时段里的最大值,只有变异恰好把所有时段都压下来一格,峰值指标才会整体下移,中间过程就表现为长时间的平缓。
7.2 帕累托前沿
63 个解的分布范围:f1 从 714.49 到 977.94 MW,f2 从 170.04 到 271.50 MW。两个目标呈清晰的负相关,前沿形状光滑,没有明显断点。
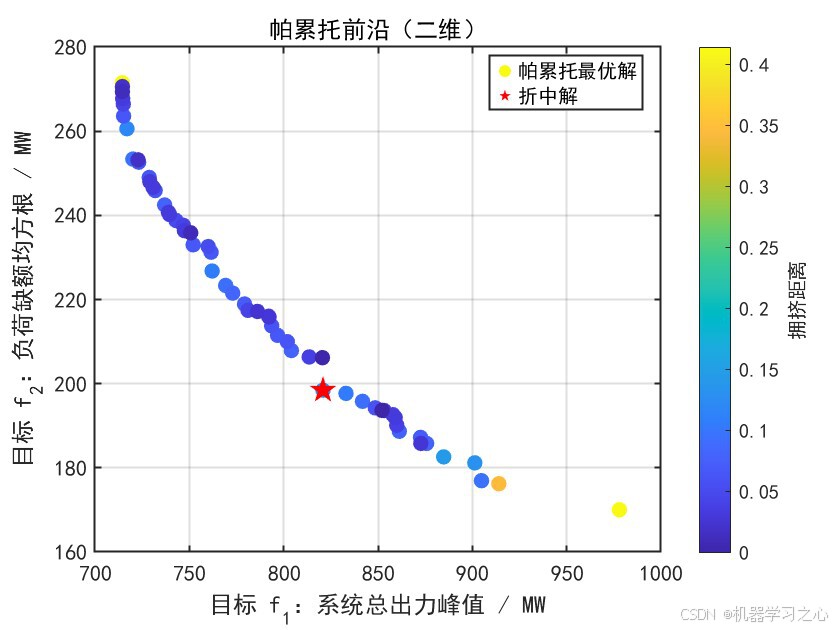
图 2 中颜色表示拥挤距离,红色五角星是折中解,落在前沿的中段。
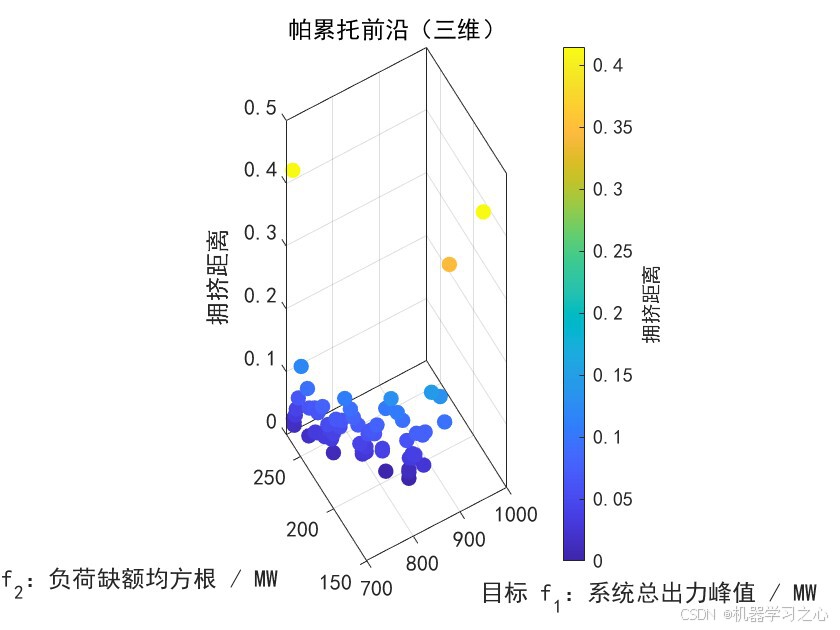
把拥挤距离放到第三个维度上看得更清楚:绝大多数解的拥挤距离集中在 0 到 0.1 之间,只有前沿两端的少数端点解因为边界处理被赋了较大数值。绘图时无穷大的拥挤距离被替换成了有限大值,所以图上呈现出几个孤立的亮点,这是可视化处理的结果,不代表这些解本身更优。
7.3 折中解与调度过程
折中解的挑法是:把两个目标各自归一化到 0, 1,再算到理想点 (0, 0) 的欧氏距离,距离最小的解胜出。结果是编号 6 的方案,f1 = 820.84 MW,f2 = 198.45 MW。
它的 24 小时水位序列落在 2451.81 到 2453.75 m 之间。
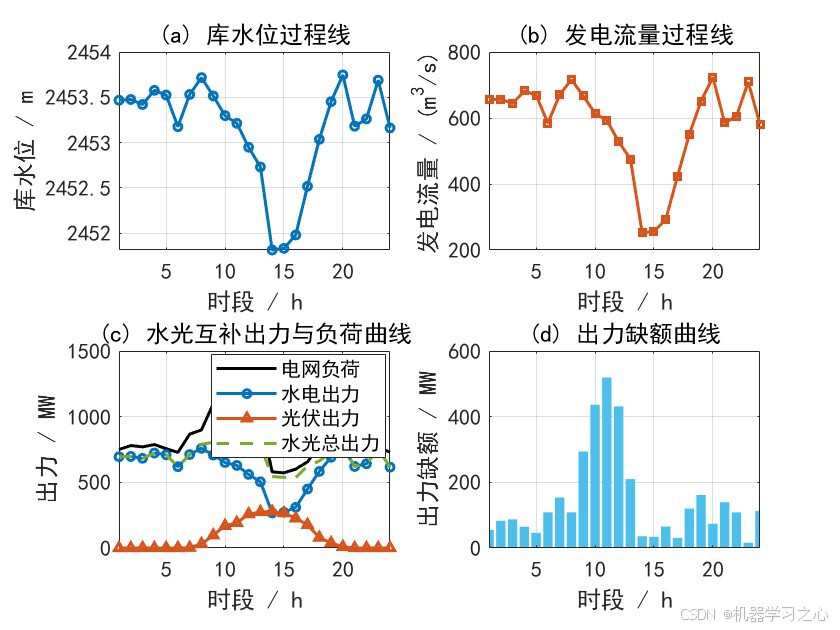
水位过程线的形状很有代表性。13 到 17 时被压到 2451.8 到 2452.7 m,因为这段时间光伏出力接近满发,水电必须让路,否则总出力会顶穿"不过发"约束;上午 9 到 12 时和晚间 23 时水位抬高,因为这些时段负荷高、光伏弱,缺口最大。
把这条曲线和前面算出的逐时上限 x_UB(t) 叠在一起看,凹陷位置完全重合。水位过程线的形状主要是可行区间的形状,而不是水量平衡演化出来的结果,这一点后面还会提到。
对应到出力上,水电在 267.13 到 767.11 MW 之间摆动,光伏在 0 到 277 MW 之间摆动,叠加后的总出力在 11 时达到峰值 820.84 MW。
缺额最大的时刻出现在 11 时,519.16 MW,当时负荷 1340 MW,光伏只有 192 MW。缺额最小的时刻是 23 时,仅 15.82 MW,此时水位 2453.69 m 已经贴近该时段的上限 2453.75 m。
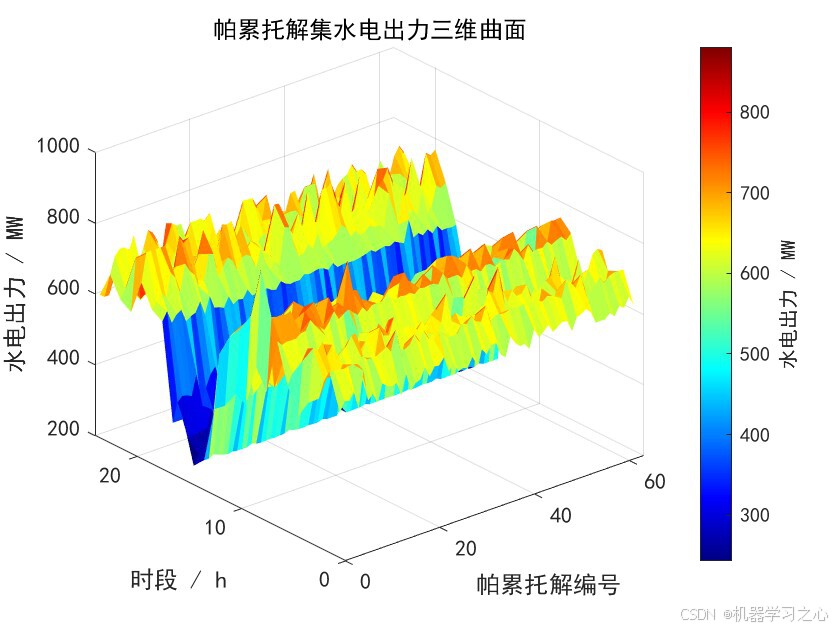
7.4 解集全貌
把 63 个解的水电出力铺成三维曲面,低洼出现在中午时段,与光伏出力最高的几个小时对齐,两端则被抬高。
八、运行环境
MATLAB R2020b及以上即可。代码只用了基础语言特性,randperm(n, k) 的双参数形式是唯一有版本要求的地方。
不依赖任何工具箱。优化、排序、绘图全部使用 MATLAB 自带函数,从零安装的 MATLAB 就能跑。
绘图需要中文字体。result.m 里指定了 SimHei,Windows 下可以直接运行;Linux 或 macOS 上需要换成系统内可用的中文字体,否则图上的中文标签会显示成方框。
运行产出三样东西:命令行的结果报表、ParetoFront_F1.mat 数据文件,以及六张成果图。
计算量很轻。种群规模 80,每代最多评价 88 次目标函数(56 个交叉子代加 32 个变异个体),70 代合计不超过 6300 次评价,而目标函数本身只是向量化的四则运算。
九、应用场景
日前调度计划的生成。 给定次日 24 小时负荷预测与光伏预测,一次算出整条权衡前沿。调度员按实际需求在前沿上挑点:优先保供电就选 f2 小的方案,优先压峰就选 f1 小的方案。
新能源消纳能力的评估。 把光伏出力曲线换成不同装机规模重跑,观察前沿整体右移或下移的幅度,可以量化再增加多少光伏会让电网缺口明显扩大。
调节电源容量的校核。 水电装机、水位运行区间、发电流量下限都是输入,改动这些参数看前沿形状的变化,比单点仿真更容易看出制约瓶颈在哪里。
算法教学与验证。 决策变量维数适中、目标函数可解析写出、可行域可解析推导,作为 NSGA-II 的测试平台很合适,六个算子的实现也方便逐个替换做对照实验。
需要说清楚的是,这份代码的模型是简化版:没有水量平衡约束,也没有启用库容约束,24 个小时的水位实际上是相互独立的变量。用于演示算法、探索权衡关系没有问题,直接拿去当生产调度方案使用,得先把这些约束补齐。
十、代码层面可以追问的三个问题
问题一:采样边界与算子边界不一致
初始化的采样区间是逐时的 [x_LB, x_UB(t)],最窄处(14 时)只有 0.35 m。交叉与变异函数的裁剪区间却是 [2451.5, 2455],宽 3.5 m。
高斯变异的标准差 sigma = 0.1 × (2455 − 2451.5) = 0.35 m,恰好等于最窄时段的全部可行带宽。只要变异恰好落在 14 时这个基因上,个体就有相当大的概率被推出可行域,然后被 test() 拦下、回退成父代。每代有 32 个个体参与变异,无效扰动的累积并不小。
改法很简单:把 Crossover() 与 Mutate() 的边界参数换成逐时的 [x_LB, x_UB],主程序里改两行就够。
问题二:父代选择不是锦标赛
代码里选父代用的是 randi([1 nPop]),均匀随机,不带任何偏向。教科书写法是二元锦标赛,按非支配等级和拥挤距离在两两比较中取胜者。这里的选择压力全部由"父代与子代合并后截断到 80"这一步承担。
这种精英保留策略本身没有错,收敛性也能保证。代价是交叉的两个亲本完全随机配对,好的基因组合被撞上的概率偏低。目标数少、种群小的时候影响有限,问题规模上去之后就会显现。
问题三:前沿的覆盖范围比预期窄
这一条最值得留意。同样满足全部约束的可行解里,有两个极端解可以直接构造出来:
| 构造方式 | f1 / MW | f2 / MW | 是否可行 |
|---|---|---|---|
| 24 时段水位全部取可行下限 2451.60 m | 489.07 | 581.84 | 通过 |
24 时段水位逐时贴住上限 x_UB(t) |
1283.13 | 11.61 | 通过 |
第一个解的峰值只有 489.07 MW,比前沿里最小的 714.49 MW 低 31%。第二个解的缺额均方根只有 11.61 MW,比前沿里最小的 170.04 MW 低一个数量级。两个解都没有被前沿里的任何解支配,它们把真实前沿的两端各自向外推了一大截。
换句话说,70 代搜索得到的前沿,只覆盖了真实前沿中间的一段。
原因不难理解。要让缺额接近 0,需要 24 个时段同时贴住各自的上限,在高维空间里这是极窄的目标区域;而算子的探索能力有限,每代只有 32 个个体参与变异,每个个体只动 1 个基因。80 个体、70 代的采样量,放在 24 维空间里确实偏少。
改进方向有几条:把代数提到 300 到 500;在初始种群里注入若干贴边解或按规则生成的启发式解;把父代选择换成二元锦标赛;或者利用问题结构,把可以解析求解的维度单独处理。
结语
回到开头那个问题:24 小时的水位到底该怎么定。
这份代码给出的答案是 63 个方案,从"峰值 714 MW、缺口 271 MW"到"峰值 978 MW、缺口 170 MW",中间连续可取。选哪个,取决于调度目标是把尖峰压下去,还是把电量缺口补上来。多目标优化的价值也正在这里,它不替你做决定,而是把每个选择要付的代价摊开摆在你面前。
代码和图片来自同一套工程。如果你正在做水光互补或者类似的短期调度问题,这份实现可以当作起点;把水量平衡与库容约束补齐、把机组参数标定到真实值,它离生产可用就不远了。
说明:本文的公式、参数、图表与全部数值均来自作者本地的 MATLAB 运行输出,未做改动。第十节中两个对照解为按同一模型解析构造,并已用独立脚本复算校验其可行性。