在汽车、航空航天、造船与重型机械行业,二维图纸仍是制造意图的主要载体:几何尺寸与公差(GD&T)、材料规格、表面粗糙度等关键制造信息(PMI)都落在图纸上。对质量部门而言,一份检测表格的生命线是完整 与可追溯------图上每一条尺寸公差都必须被编号、被转录、被检验,一条都不能漏。过去这条链完全靠人工:读图、敲号、誊表,耗时且易错。如今,从"读图"到"编号"再到"制表"的自动化技术瓶颈正在被一项项突破。
壹 读图:从2D图纸读取PMI的方法*· 方法篇*
检测表格的源头是图纸上的 PMI。怎么把"图片"变成"数据"?2025--2026 年的主流答案是一条"先定位、后解析"的混合管线。
先定位,再解析:OBB 检测 + 文档理解模型
新加坡 A*STAR 与南洋理工团队在 1,367 张二维工程图纸、九类标注(GD&T、通用公差、尺寸、材料、注释、半径、表面粗糙度、螺纹、标题栏)上构建了完整数据集,先用 YOLOv11 旋转框(OBB)检测器把每条标注从图纸上"框"出来,再交给微调后的文档理解模型 Donut 逐块解析为结构化 JSON------单模型方案取得 GD&T 精确率 94.77%、多数类别召回率 100%、总体 F1 分数 97.3%、幻觉率降至 5.23%1。旋转框先行是关键设计:先按空间位置切出每条标注的贴片,再识别,天然规避了全局版面干扰与旋转文字问题。
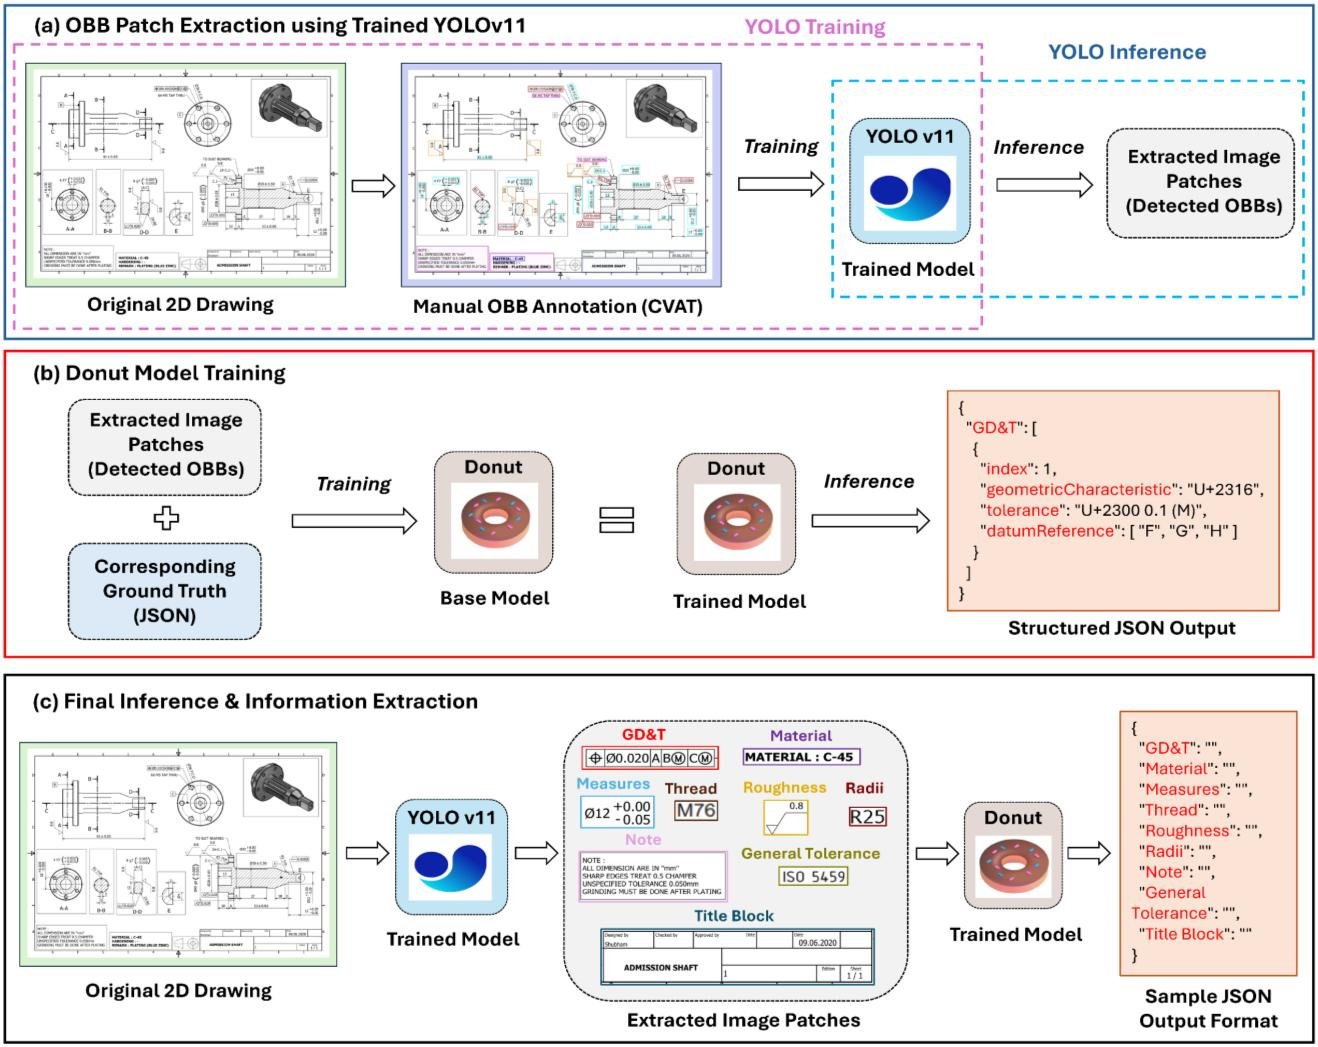
图 1|"先定位、后解析"的 PMI 读取管线:YOLOv11 旋转框提取标注贴片 → 微调 Donut 输出结构化 JSON(图源:arXiv:2505.01530v3 1)
版面检测是"中间件",也是"领域关"
读图的第一步其实是版面切分------定位图框、标题栏、视图与标注区。Buro Happold 与伯明翰城市大学团队在 AEC 图纸版面数据上对比了五种架构:RF-DETR 以 mAP50 0.949(精确率 0.985)拿下检测精度最优,视觉语言模型 Qwen3-VL 则以 F1 0.911 领跑解析端;但在通用文档数据集上预训练的模型直接迁移到工程图纸会发生明显的"领域干扰"------DocLayout-YOLO 的 mAP50 只有 0.675、F1 仅 0.6622。这对车间选型的启示很直接:图纸检测模型必须用图纸数据训练,通用文档模型不能拿来就用。
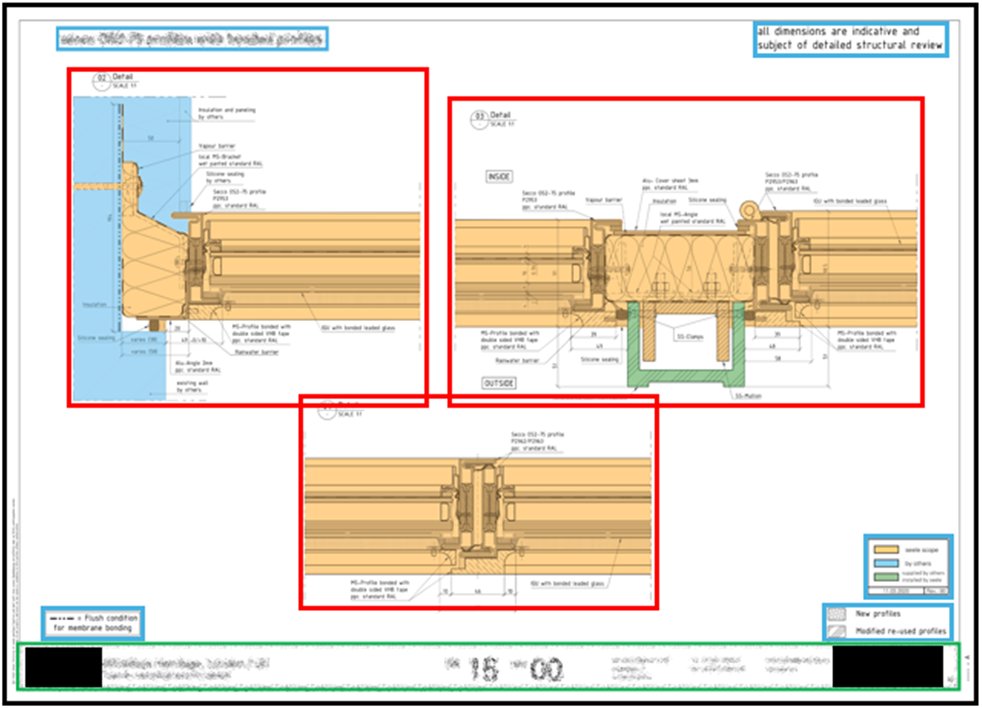
图 2|真实工程图纸的复杂版面:多视图嵌套、密集注释、局部放大------这正是通用文档模型"水土不服"的原因(图源:arXiv:2607.18997 2)
标注与几何的显式关联:让每个数值知道自己属于谁
读图不止识别文字,还要把每条尺寸"锚"到几何对象上。韩国忠南大学团队提出 Drawing-Recode 框架,用交叉注意力机制配合新设计的标注关联损失(Annotation Grounding Loss, AGL),把标注层特征显式地"绑定"到几何层特征:与基线相比平均倒角距离(MCD)改善 27.8%,无效输出比例从 20.31% 压到 0.97%,且在接近工业条件的扫描图纸上保持稳定3。这种"标注-几何对齐"能力,正是下一章气泡编号可靠性的技术底座。
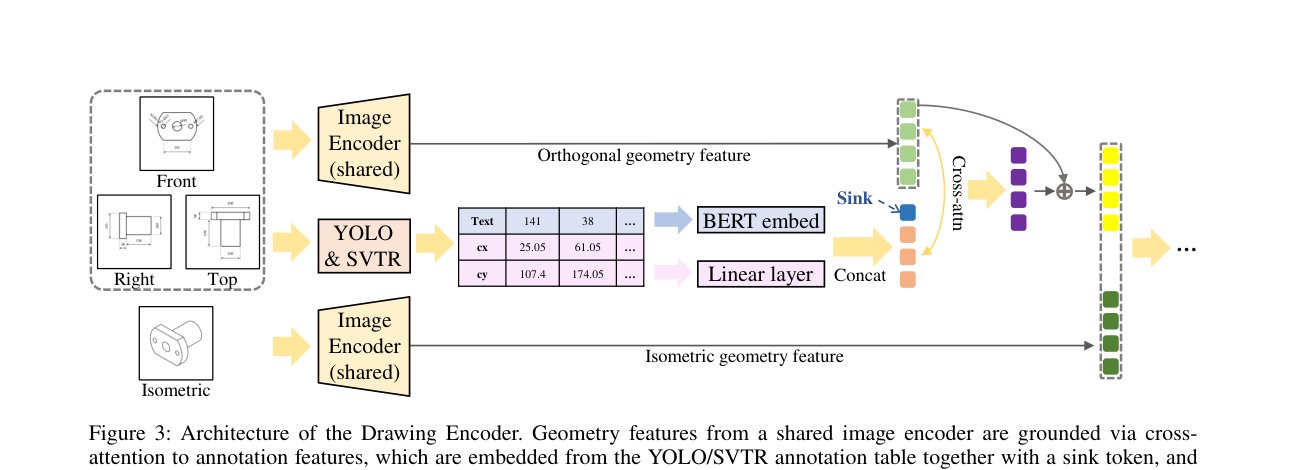
图 3|Drawing Encoder 架构:几何特征经交叉注意力与标注特征关联,"让尺寸知道自己描述的是哪段几何"(图源:arXiv:2607.27558 3)
贰PMI数据读取可靠性评估*· 可信篇*
自动读图的结果要进检测表格,先要回答一个问题:读出来的数据可信到什么程度?2026 年的多项基准研究给出了三把尺子。
尺子一:找到 ≠ 抄对
美国 Predii 与橡树岭国家实验室发布 Enginuity 基准,在 494 张军工维修手册图表上评测四个前沿 VLM:模型"找到零件"的能力不错------Recall@all 达 0.61--0.87;但"把零件描述抄准确"的 Token F1 只有 0.03--0.18,二者存在系统性落差4。作为对照,Tesseract OCR 加正则解析的基线 Recall@all 仅为 0.012------传统 OCR 在这类图上几乎完全失效。该研究还发现:常规字符重合度指标会低估模型对技术描述的真实能力 2--6 倍,评测检测数据质量时应叠加语义相似度等多维指标。
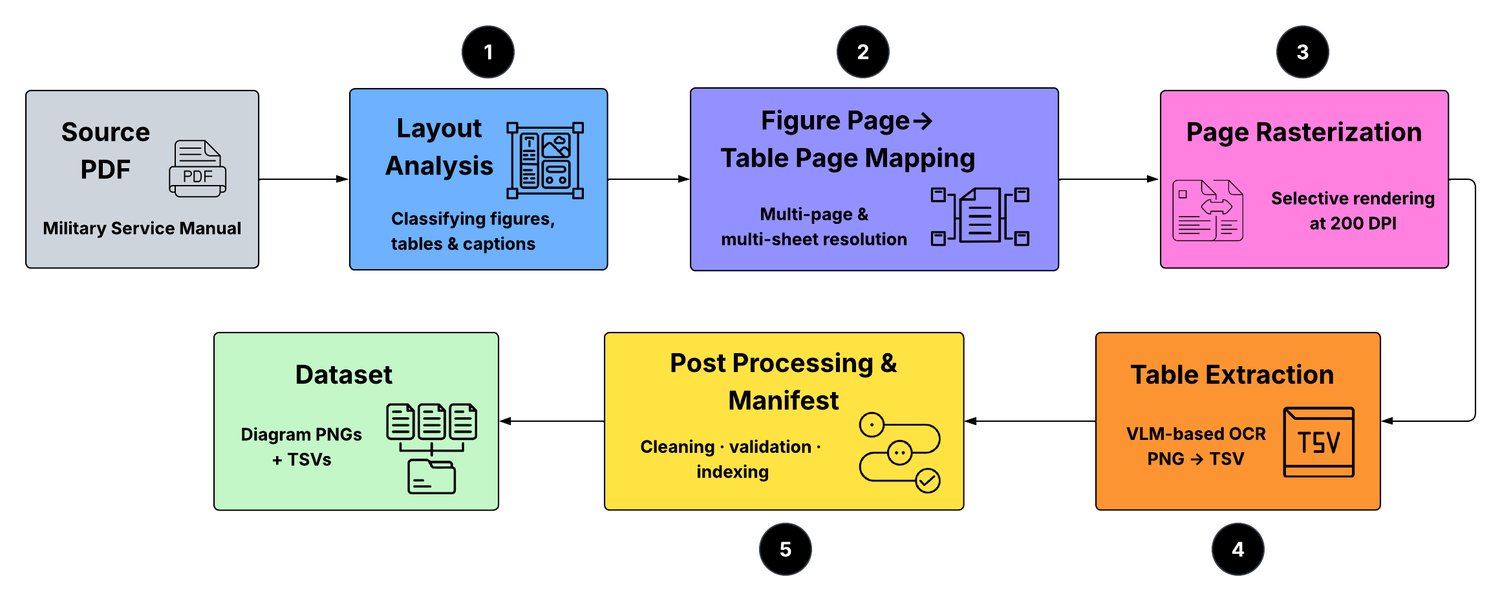
图 4|从工程图纸到结构化表格的端到端管线:版面分析→页映射→栅格化→VLM 表格提取→清洗校验(图源:arXiv:2606.03410 4)
尺子二:端到端与结构先验的互补
在通用文档解析侧,百度千帆团队发布的 4B 参数端到端模型 Qianfan-OCR 在 OmniDocBench v1.5 上以 93.12 分位列所有端到端模型第一,OlmOCR Bench 79.8、OCRBench 880;其"Layout-as-Thought"机制允许模型先输出布局思考再给最终答案,专门改善复杂版面与乱序文档的识别5。把这两把尺子合起来看:数值型标注的识别已过可用线,但表格级描述保真度仍是短板------检测表格中的公差值、基准字母这类"关键字段",必须设置独立校验环节。
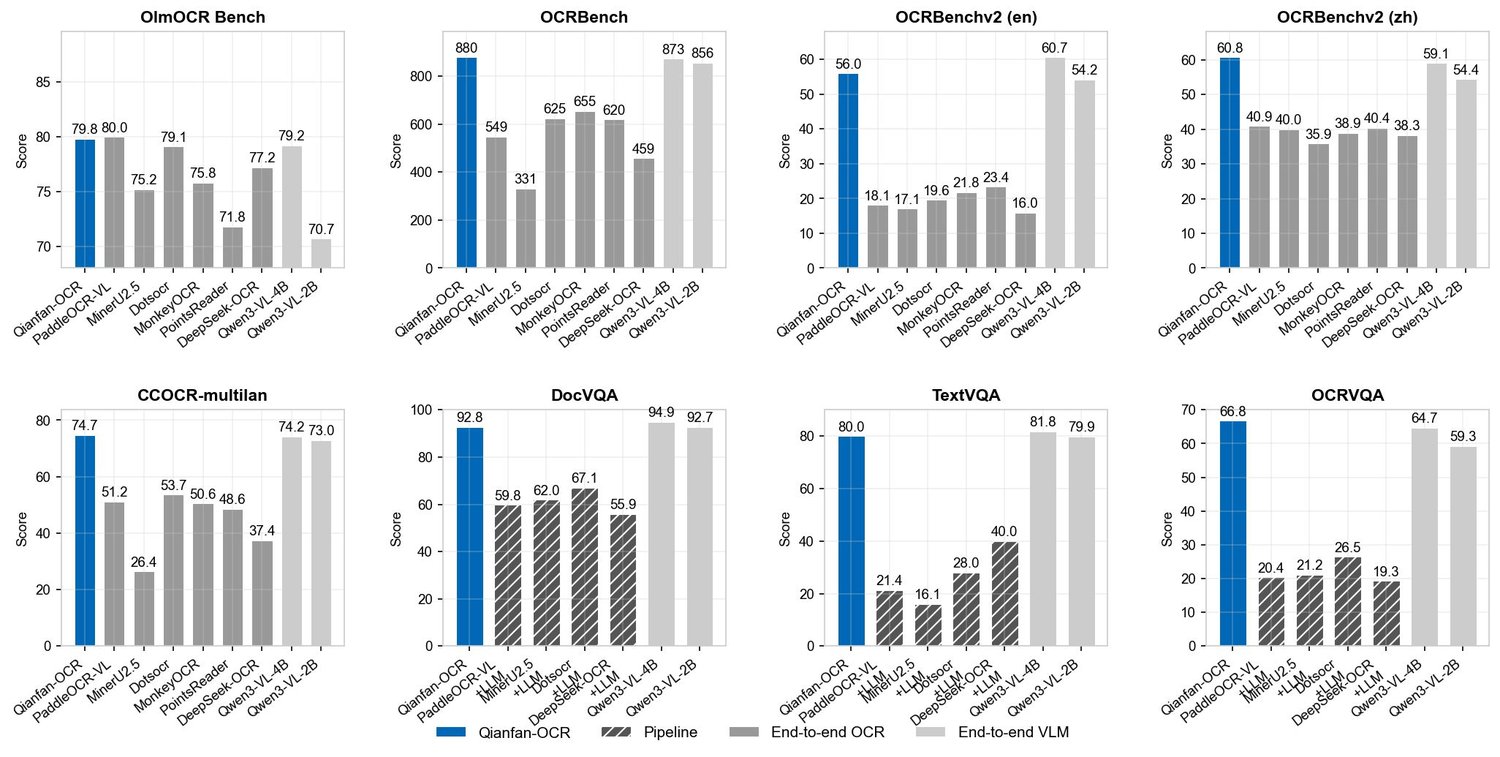
图 5|OmniDocBench v1.5 等多项基准成绩:端到端模型已逼近甚至超过部分多级管线系统(图源:arXiv:2603.13398 5)
尺子三:幻觉率要分类看
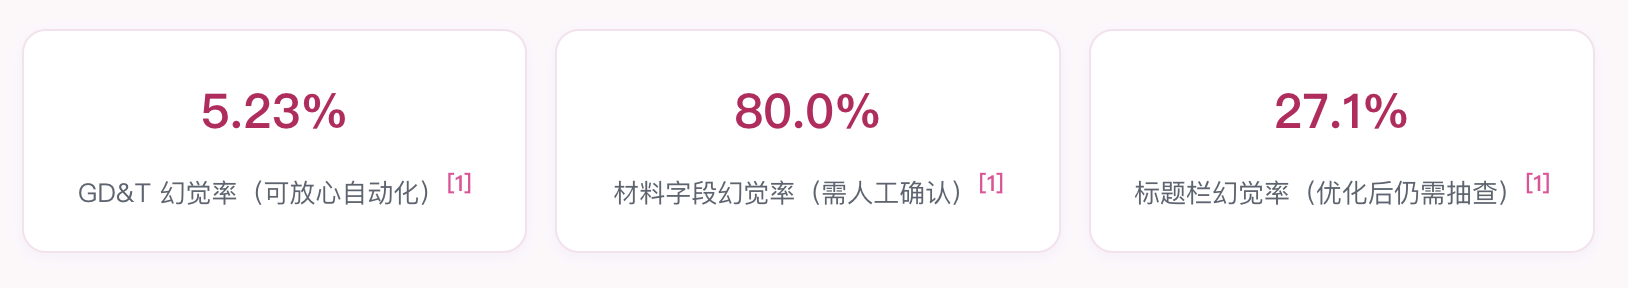
回到图纸本身,1 的细分类数据值得每位质量工程师注意:GD&T 类标注幻觉率仅 5.23%,但材料类幻觉率仍高达 80.0%、通用公差 66.7%、标题栏从 44.9% 优化到 27.1%1。也就是说,识别可靠性是"分字段"的:几何公差、尺寸这类高度模板化的内容可以放心自动采集;材料、通用公差这类依赖上下文的字段,当前技术条件下仍应保留人工确认环节。
落地的经济学:算得过账,才进得了车间
可靠性之外,车间更关心成本。T-Tech 团队公开了一套已部署系统的质量调整成本模型:其混合专家 VLM(总参 35B、激活 3B)在单张 H100 上即可服务多类工作流,按生产遥测数据校准复核与纠错成本后,预期成本较人工基线降低超过 80%,较最佳开源竞品降低超过 50%,而更大的基线模型反而在经济上不可行6。这给"多大模型进车间"提供了参照:够用的中等模型 + 恰当的数据策展,比堆参数更划算。
叁气泡图自动生成质量评估要点*· 编号篇*
气泡图(Ballooning)是连接"读图"与"制表"的桥梁:给图上每条标注分配唯一编号。自动生成的气泡图质量怎么评?研究给出了四个要点。
要点一:标注-符号关联正确率是第一指标
编号的本质是"文本---符号"关联。布鲁塞尔自由大学团队构建了首个规模化文本-符号链接标注数据集并给出可复现基准:逻辑电路图上符号检测 mAP@50 达 0.995、107 类 P&ID 分类约 0.91;在关联环节,一个简单的成对几何模型即可达到约 99% 的 top-1 正确率,而更密集的图纸场景仍受益于几何规则链7。这提示:评估气泡图质量,先别急着看编号好不好看,先统计"每条标注是否挂对了对象"。
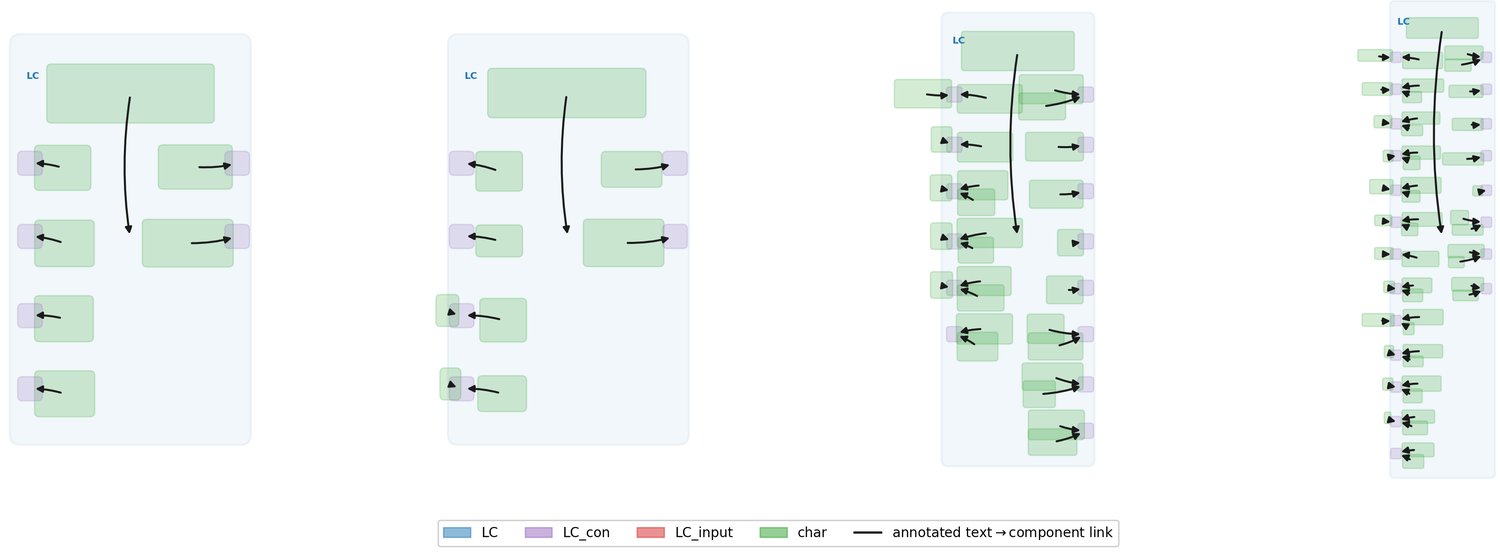
图 6|文本标注→图形组件的链接标注样本:不同密度下关联难度差异显著(图源:Electronics 15(17):3785 7)
要点二:位置也要评------"布局感知"评估
IBM 苏黎世研究团队在键值抽取任务上指出:多级 OCR 管线会逐级传播错误,而"识别---定位---关联"应一次完成。他们把 256M 参数的 SmolDocling 微调成单遍完成三项任务的模型,并引入布局感知评估框架 ------在文本匹配之外叠加包围盒空间校验,只有"抄对了且位置标对了"才算正确;在该评估下,256M 小模型超过更大的零样本 VLM 基线,同时比 Qwen2.5-VL(7B) 小 27 倍、推理快 5 倍以上8。映射到气泡图场景:编号气泡的位置精度必须与编号本身一起验收,否则"编号对了、气泡飘了"同样会误导检验员。
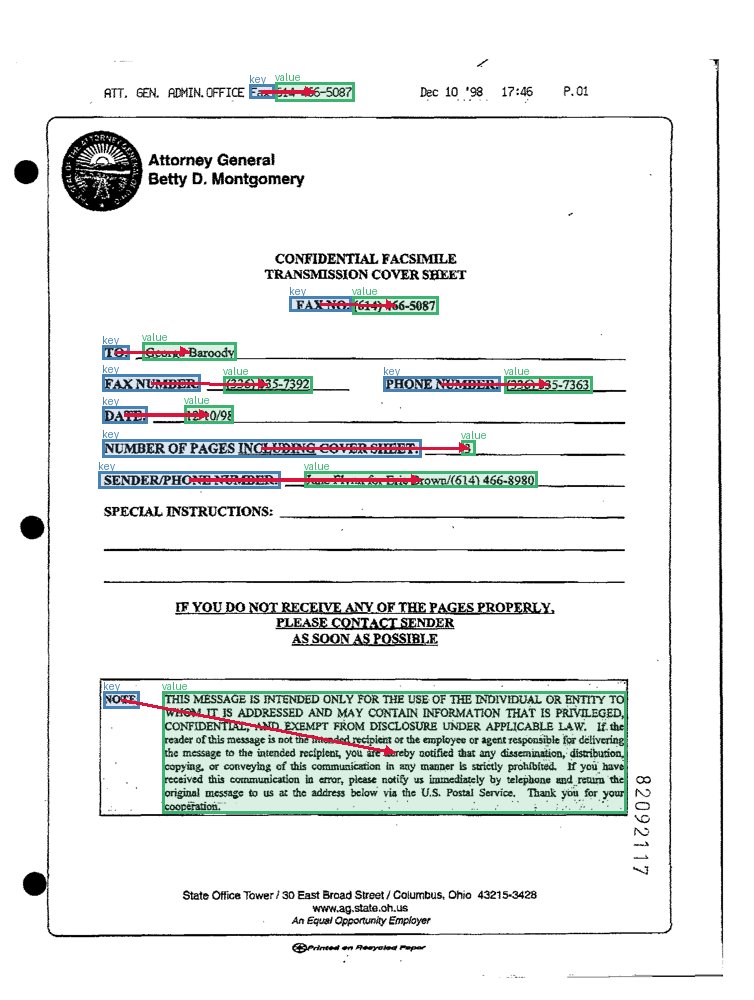
图 7|"识别---定位---关联"一体化的键值抽取:key/value 的包围盒被同时标注与校验(图源:arXiv:2608.20868 8)
要点三:规则优先、AI 兜底、人工收口
新加坡 A*STAR 团队把"标注→特征映射"拆成确定性打分、多模态推理、受限 LLM 三级瀑布,最后只保留一轮人工复核:在 20 组真实 CAD-图纸配对上,平均精确率 83.67%、召回率 90.46%、F1 86.29%;完整流水线比最近的降级变体高出 12.0 个百分点9。两组细节尤其值得写进验收规范:召回率标准差仅 11.65%(跨零件稳定找回),但精确率标准差达 16.98%------失误集中在重复特征与几何相似特征上,这正是气泡编号最容易张冠李戴的地方,抽检应重点覆盖。
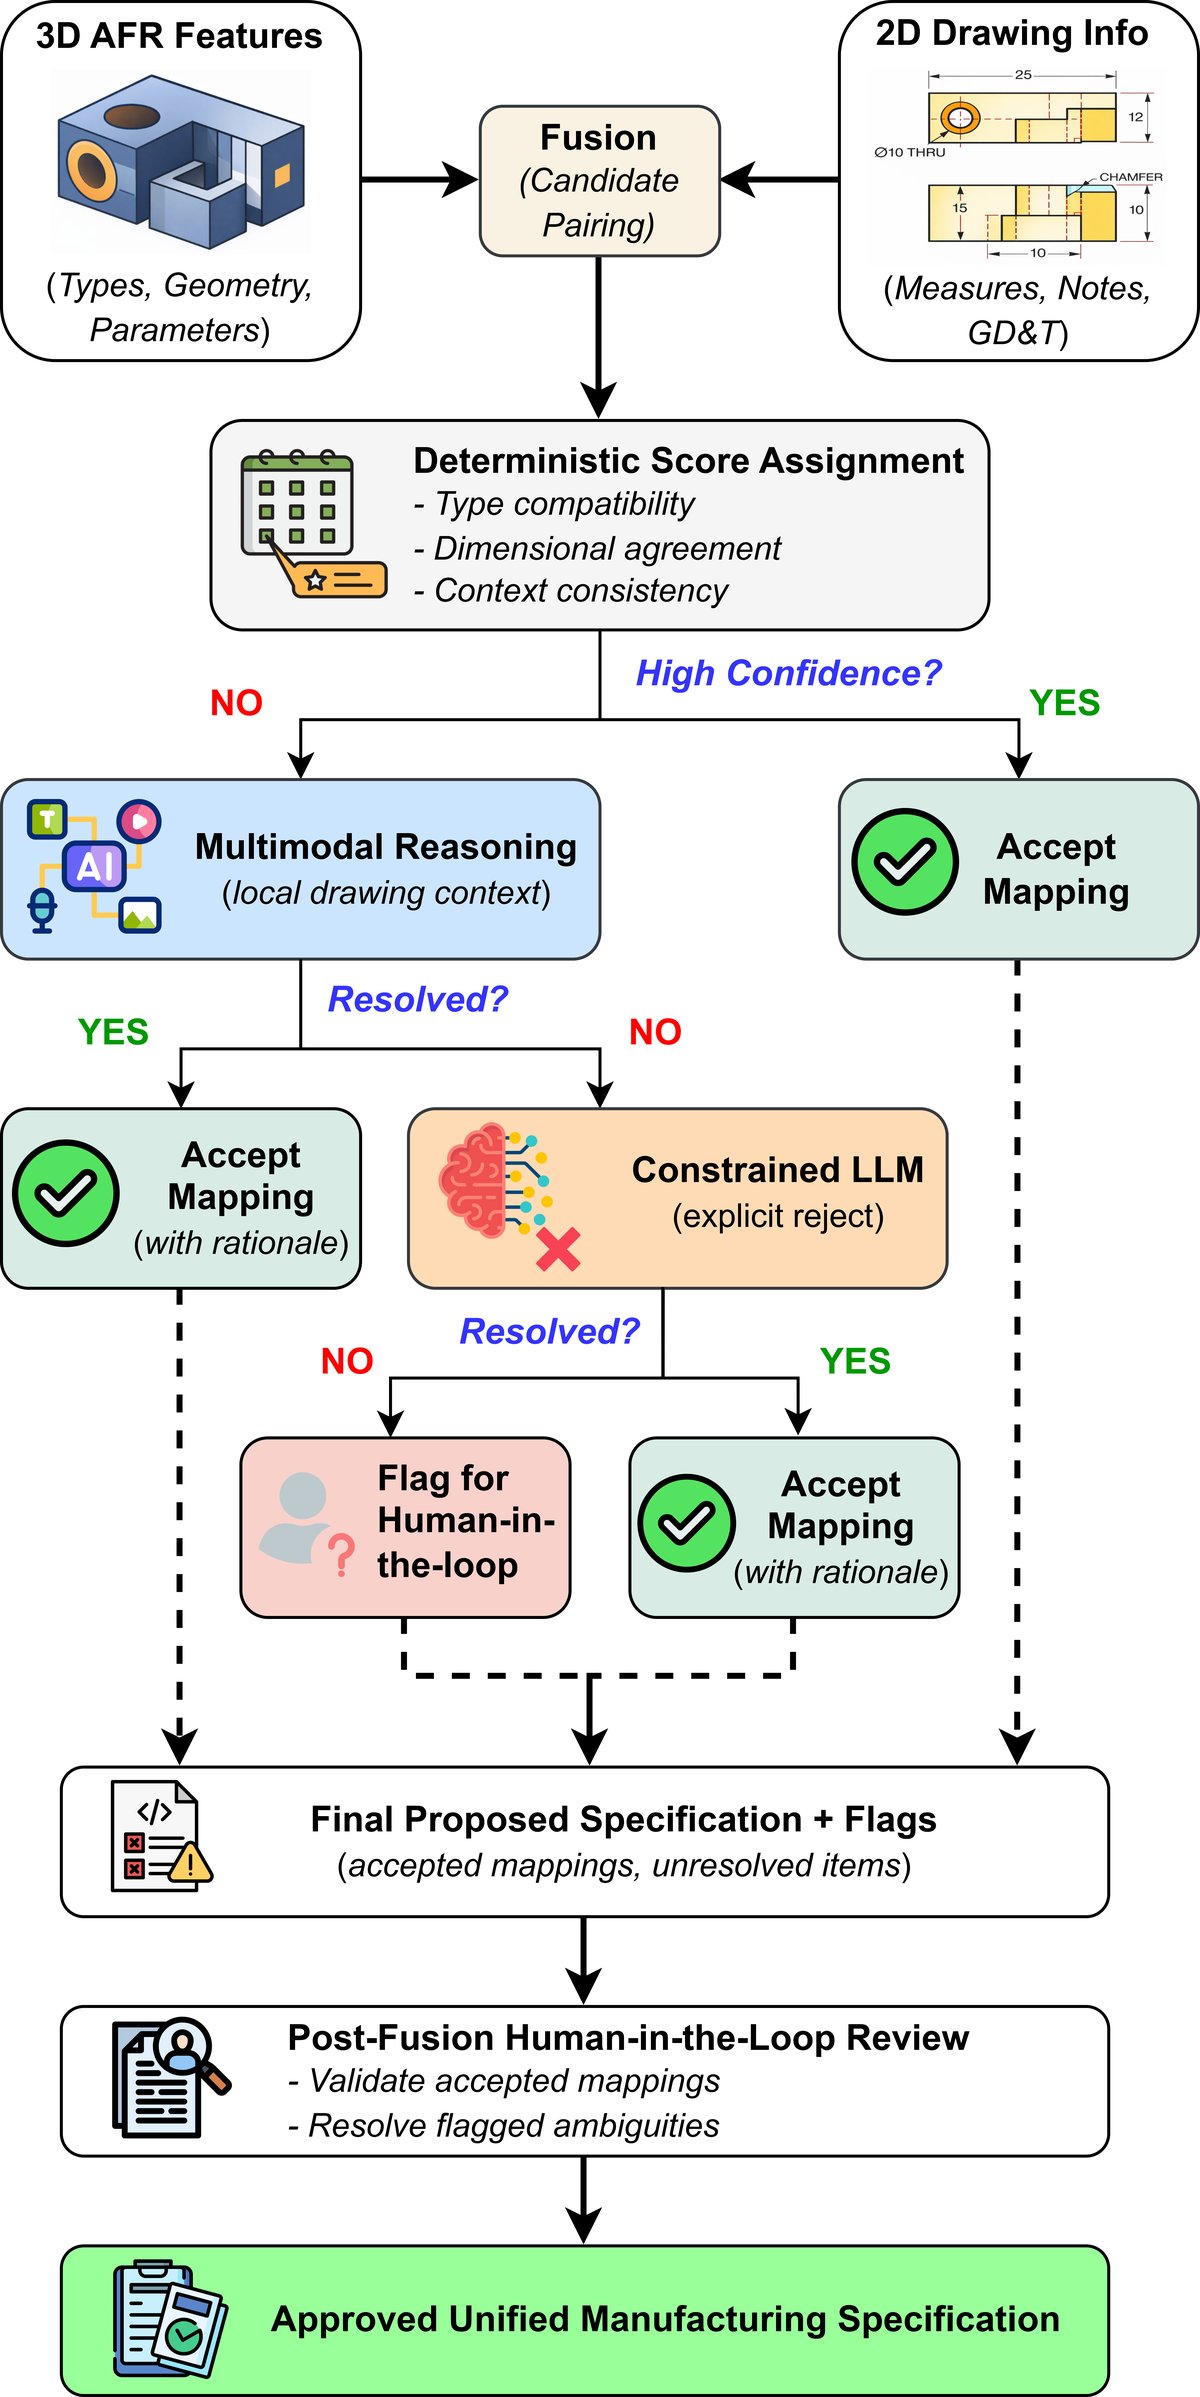
图 8|确定性优先的三级映射瀑布:规则→多模态→受限 LLM→单轮人工复核(图源:arXiv:2602.18296 9)
要点四:把"未解决"当成正式输出
9 的框架明确保留"Flag for Human-in-the-loop"通道------无法置信决断的映射被显式标记而非强行给出答案9。对气泡图生成而言,一份"95% 已确认 + 5% 明确存疑"的编号清单,远比一份"100% 看似正确"的清单更适合车间:前者让复核有的放矢,后者把风险藏进了无人查看的角落。
肆自动生成质量检测表格如何维护*· 运营篇*
制表不是终点。表格会过时:图纸会升版、工艺会变更、检验要求会加严。检测表格的维护,考验的是"证据链"与"变更链"的工程化。
证据链:每条结论都能回到实测与条款
美国康涅狄格大学团队提出的 FRAME 框架把"结构化规格→计量证据"做成了闭环:任务管理器展开检验需求,证据记忆全程追踪测量来源、可采性与覆盖率,只有证据完整且通过确定性符合性评估才允许放行 PASS 判定10。其中对应性门控的数据极具说服力:引入门控后,L1 任务候选正确率从 54.8% 升至 92.9%、错误放行率从 45.2% 降至 2.4%;L2 任务错误放行率从 47.6% 降至 3.6%10。对检测表格的启示:表格里的每个判定值都应携带测量溯源字段(仪器、方法、覆盖状态),缺失证据就不能出结论。
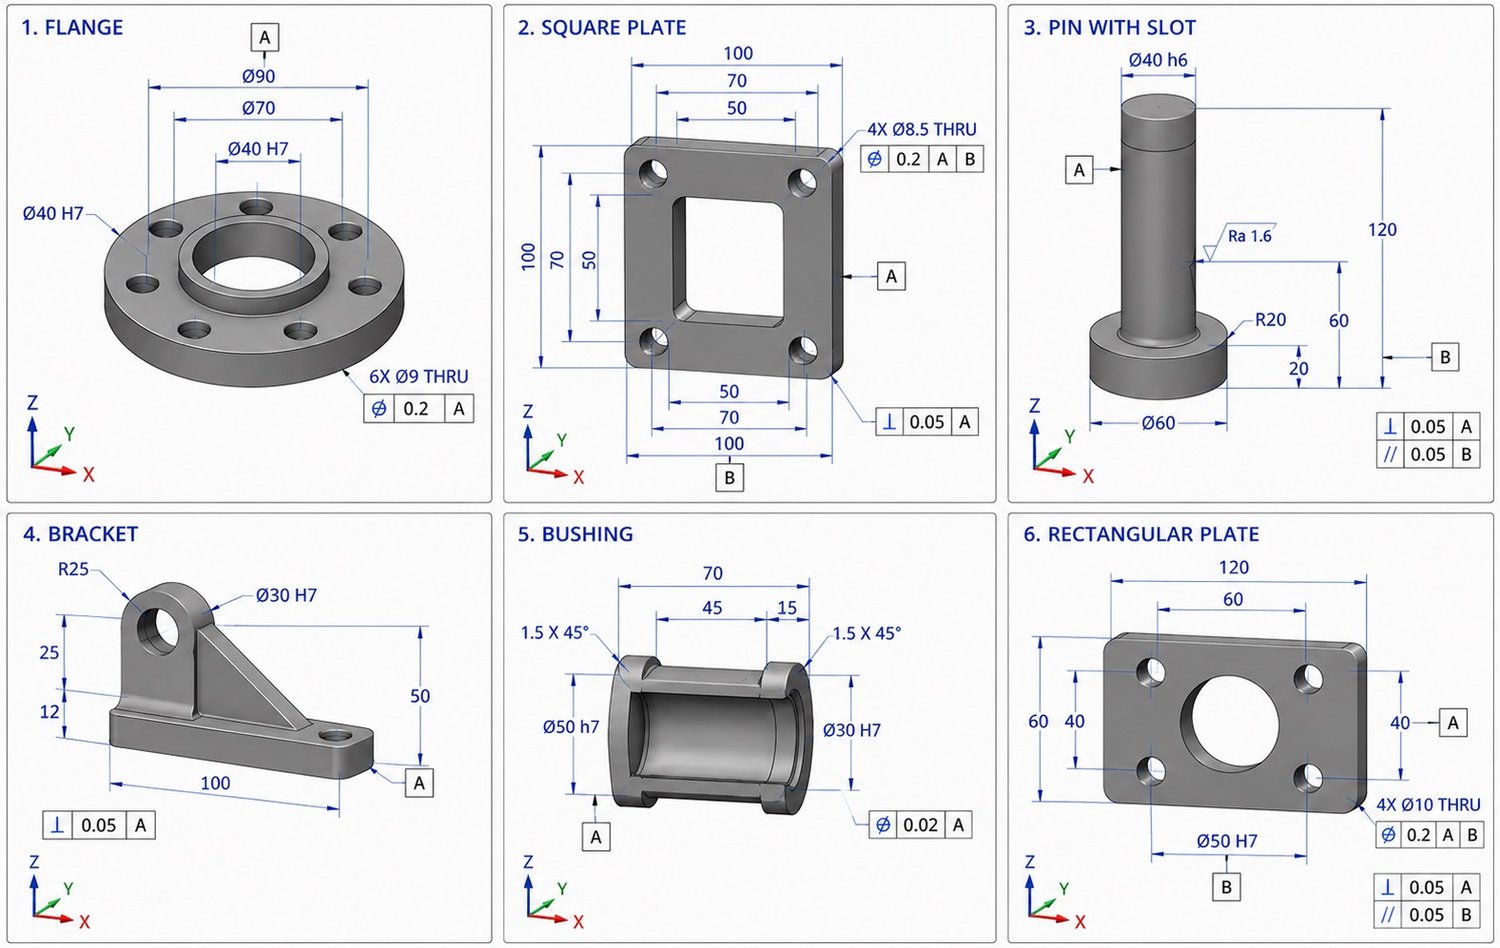
图 9|带完整 GD&T 标注的六类典型检验对象:法兰、方板、销轴、支架、衬套、矩形板(图源:arXiv:2609.14219 10)
变更链:升版不断号,报表不重做
检测表格最大的维护痛点是图纸升版:一处改动,全套编号与报表都要跟着变。工程实践中的成熟做法已经收敛为三条:
- 锚定式编号------每条特性以"图区位置 + 保存视图 + 标签"三重坐标锚定在图纸上,升版重抓时编号体系不漂移;
- 差量更新------新版图纸只对发生变化的标注重新捕获,未变特性沿用原编号,检测表格做增量修订而非推倒重来;
- 报表双向绑定------Excel/HTML 检测报表与图纸视图联动,改报表可见、改图纸即更新。
目前这套能力已在商用工具中落地:例如 MBDVidia_BALLOON2D 一类的自动气泡图软件,即按上述思路实现自动捕获图纸标注、输出机器可读的特性清单(BoC),并支持升版比对与报表绑定†。它解决的正是"编号体系跨版本连续"这个维护环节最头疼的问题。
† 产品能力描述来源于其公开帮助文档;本文所引研究数据均出自文末参考文献。
运营节奏:把人工复核变成制度而非补救
综合前述研究,一套可持续的维护制度可以概括为"三层四检":字段分层 (几何公差/尺寸自动放行,材料/通用公差人工确认1)、版本差检 (升版只重抓变化项)、位置抽检 (对重复特征与相似特征的气泡位置重点抽查9)、证据核检(判定值必须携带可追溯测量证据10)。同时,随着中等参数模型在成本结构上的优势被验证6,车间完全可以按"一机型一策"渐进扩容,而不是一次性重构整条质量链。
结结语
二维图纸不会消失,会消失的是围绕它的重复手工劳动。2025--2026 年的研究进展清晰地勾勒出一条车间级落地路线:读图 用"旋转框检测 + 文档理解模型"拿下 94% 以上的结构化精度1;编号 用"几何关联 + 布局感知评估"把正确率与位置精度一起锁进验收指标78;制表 与维护则用"证据链 + 锚定式编号 + 差量升版"让检测表格活起来10。当"读图---编号---制表"被压缩为一次可复核、可追溯、可升级的流程,质量检测表格就不再是从图纸誊抄出来的副产品,而是驱动车间质量数据流转的起点。
参考文献
- 1 Khan M T, Yong Z, Chen L, Tan J M, Feng W, Moon S K. Automated Parsing of Engineering Drawings for Structured Information Extraction Using a Fine-tuned Document Understanding Transformer. arXiv:2505.01530v3, 2025.
- 2 Huang T, Lombardi A, Elnagar A, Zalouk A, Paul G, Najjarpour S, Sigurdsson A, Ismail K, Ragab M, Vakaj E. Benchmarking Deep Learning Approaches for AEC Engineering Drawing Layout Detection and Information Extraction. Proc. EC3 2026, arXiv:2607.18997, 2026.
- 3 Kim M, Kim Y, Kim H. Drawing-Recode: Annotation Grounding for Parametric CAD Code Generation from Raster 2D CAD Drawings. arXiv:2607.27558, 2026.
- 4 Kumar A, Motiyani I, Kasturi T, Seefried E, Movva P, Ghosal T. Enginuity: A Dataset and Benchmark for Vision-Language Understanding of Engineering Diagrams. arXiv:2606.03410, 2026.
- 5 Baidu Qianfan Team. Qianfan-OCR: A Unified End-to-End Model for Document Intelligence. arXiv:2603.13398, 2026.
- 6 Evdokimov M, Ivanov M, Tsiupin D, Tsymboi O, Potapov A, Ivanov A. Closing Cost-Quality Gap in Document VLMs: Difficulty-Aware Data Curation and Quality-Adjusted Deployment Economics. arXiv:2609.01575, 2026.
- 7 Almasri F, Léchaudé P, Debeir O. Automated Digitization of Engineering Schematics. Electronics, 2026, 15(17): 3785.
- 8 Gurbuz A S, Nassar A, Auer C, Lysak M, Morin L, Omenetti M, Strohmeyer T, Vagenas P, Livathinos N, Dolfi M, Staar P. Identify, Locate, Link: End-to-End Key-Value Extraction from Document Images. arXiv:2608.20868, 2026.
- 9 Khan M T, Chen L, Feng W, Moon S K. Context-Aware Mapping of 2D Drawing Annotations to 3D CAD Features Using LLM-Assisted Reasoning for Manufacturing Automation. arXiv:2602.18296, 2026.
- 10 Chen Z, Ge J, Chen R, Castanier M P, Gorsich D, Imani F. Task-Specified Active Metrological Inspection with Measurement-Steered VLA Manipulation and Deterministic Evidence Gating. arXiv:2609.14219, 2026.