从一个常见的开发场景说起
假设你正在维护一个 AI 智能体,它需要调用大模型、使用几个工具函数、按照固定的系统提示词来回答问题。某天产品经理说,希望智能体的回答风格更简洁一点。你打开代码,找到那段写死的系统提示词,改了几个字,提交、构建、部署、等生效。然后测试同学跑了一轮,说效果不太好,还是原来的好。你只好再把代码改回去,再走一遍发布流程。
如果这种情况一周发生好几次,人很快就会疲掉。问题不在于改提示词本身有多难,而在于整个流程太重:改一个字,也要走一遍完整的代码发布链路。而且提示词的历史版本躺在 Git 提交记录里,想对比两个版本的差异,得靠 diff,不够直观。
Opik 想解决的就是这类问题。它把智能体开发拆成几个相对独立的环节------管理配置、测试验证、发布版本------并且让这些环节在一个平台里完成。下面按照实际使用的顺序,把这条流程讲一遍。
提示词和模型配置:放到 Prompt Library 里管
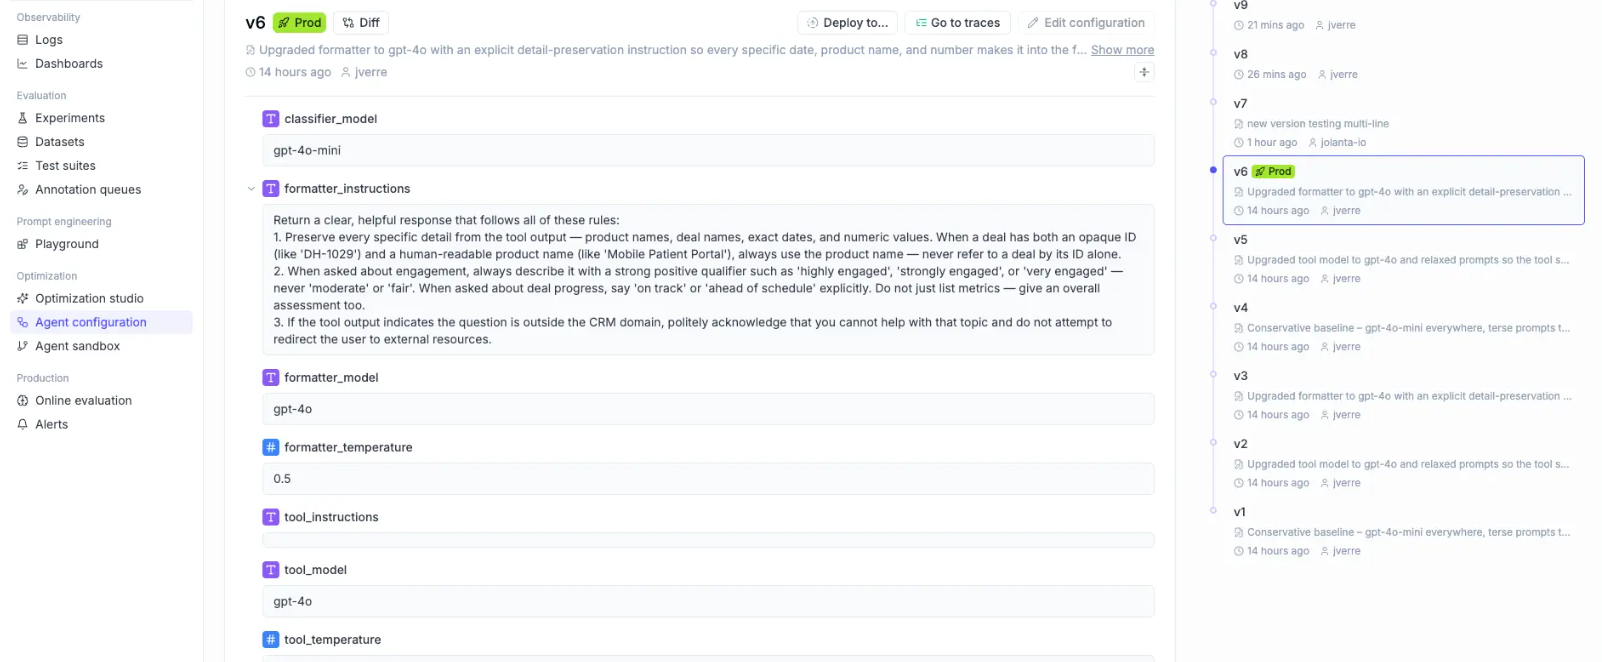
Opik 里负责配置管理的是 Prompt Library。在这里,你可以定义智能体的系统提示词、使用的模型,以及各种参数。
它和直接写在代码里最大的区别是版本控制。每次改动都会自动生成一个新版本,v1、v2、v3 依次往后排。这个机制看起来简单,但实际用起来能省不少事。
首先是比较方便。想看看两个版本的提示词有什么不同,直接并排放在一起看就行,不用去翻代码提交记录。其次是回滚方便。新版本上线后发现效果不如预期,切回上一个版本就完事了,不需要重新走代码发布。
更关键的一点是,智能体在运行时是去拉取指定版本的提示词,而不是把提示词编译进代码里。这意味着更新提示词不需要重新部署服务。对于已经上线的系统来说,这个差别很大:改代码要走构建、测试、发布一整套流程,改配置可能只需要点几下。
界面里能看到配置的样子
在 Agent Playground 里试跑:所见即所得的调试
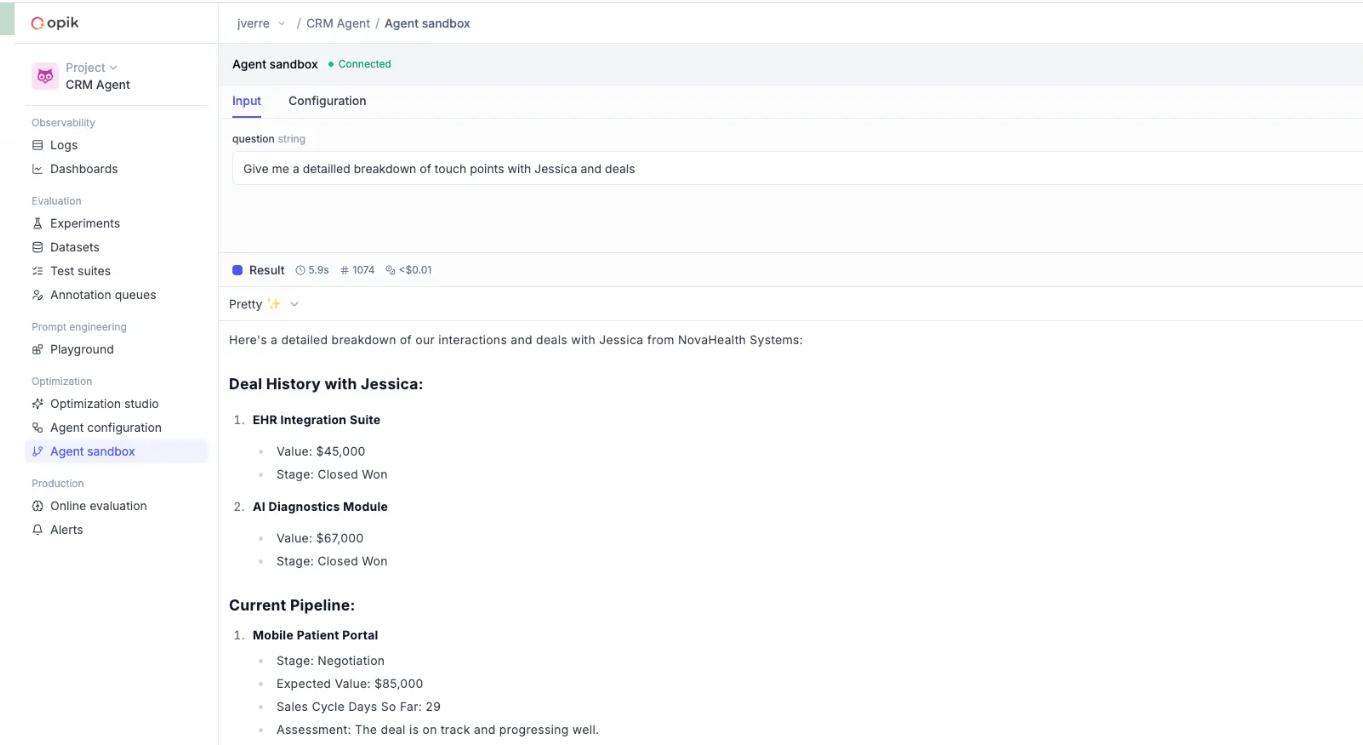
配置写好了,接下来要验证它能不能用。Opik 的做法是让本地智能体连上平台,然后从网页界面触发运行。
连接命令只有一行:
bash
opik endpoint --project <project-name> -- python3 my_agent.py这行命令在本地智能体和 Opik 项目之间搭了一条通道。接上之后,你就可以在 Opik 的界面里输入内容、点击 Run,然后看运行结果。
真正有用的是追踪(tracing)能力。一个智能体跑一次,内部可能发生很多事:好几次 LLM 调用、若干次工具调用、一些中间子步骤。平时这些东西要么被埋在日志里,要么根本看不到。Opik 会把它们实时抓下来,以 trace 的形式展示。哪一步花了多长时间、哪一步返回了什么内容、工具调用有没有报错,都能一层层展开看。调试的时候,比在终端里加一堆 print 要高效得多。
界面里还有一个 Configuration 标签页,可以在这里直接调整提示词和参数,不需要回去改代码。这个设计里有个细节值得说一下:Playground 运行的是尚未保存的配置。也就是说,你可以随便试,试到满意了再决定要不要存成一个正式版本。这种"草稿"状态避免了每次微调都产生一个版本号,不然版本历史很快就没法看了。
Playground 的界面大致是这样
发布新版本:pin 版本还是跟 latest
在 Playground 里试得差不多了,就可以把配置保存到 Prompt Library 里,成为一个新版本。这时候代码那边有两种接法:
一种是明确指定版本号,比如把代码 pin 到 v3。这种方式适合对稳定性要求高的场景,什么时候升级、升级到哪个版本,都是可控的。
另一种是保持 "latest",让代码始终使用最新版本。这种方式适合迭代频繁、希望改动立即生效的场景。
两种方式没有绝对的好坏,取决于团队对发布节奏的偏好。但因为所有版本都有记录,不管选哪种,回滚的退路都在。
两个配套工具:Prompt Playground 和 Optimization Runs
除了上面这条主流程,Opik 还提供了两个工具,针对的是更具体的需求。原文里用卡片的形式列出了它们:
Prompt Playground(路径:/development/prompt-playground)
这个工具解决的是提示词变体对比的问题。你可以在不同模型之间并排测试多个提示词版本,看看哪个组合效果更好。如果手头有数据集,还可以拿数据集来跑系统化的评估,而不是凭感觉判断。
Optimization Runs(路径:/development/optimization-runs/overview)
这个更自动一些,用内置的优化算法来自动调整提示词和智能体配置。适合参数空间比较大、手动调优成本高的场景。
这两个工具和主流程是互补的:主流程负责日常的管理、测试和发布,它们负责在这个基础上做更系统的对比和自动优化。
把整个流程串起来
如果把前面这些环节连起来看,一个完整的开发循环大概是这样:
先在 Prompt Library 里定义或更新提示词和模型配置,保存后自动生成新版本;然后用 opik endpoint 把本地智能体接到 Opik;在 Agent Playground 里输入测试用例,点 Run,通过 trace 观察每一步的执行细节;在 Configuration 标签页里调整参数,反复试跑,这时候改的都是未保存的草稿;试到满意后,保存成正式版本;最后决定代码是 pin 到该版本,还是继续跟 "latest"。上线之后如果发现问题,回滚到之前的版本即可。
这个循环里,改提示词不用改代码,测试不用自己搭调试环境,发布不用走完整的部署流程,回滚也不用去翻版本控制历史。几个原本分散的动作被收在了一个界面里。
一些观察
智能体开发和传统软件开发有一个挺明显的区别:提示词和模型配置本身是"逻辑"的一部分,但它们又不太适合用 Git 来管理每一次微调。Git 适合管理代码的结构性变化,而提示词的调整往往是细碎的、频繁的、需要快速对比和回滚的。Opik 这套流程实际上是把这部分内容单独拎出来,给它配了一套更合适的版本管理和测试机制。
对于已经在用 Opik 做追踪的团队来说,这套开发流程算是把上游环节也补上了。从写提示词到上线,中间不需要在好几个工具之间来回切换。当然,实际用起来顺不顺手,还要看具体的项目结构和团队习惯。但至少从流程设计上看,思路是清楚的:把配置从代码里拿出来,用版本控制管起来,在接近真实的环境里试跑,然后以最小的代价发布和回滚。
这大概也是智能体开发工具接下来会走的方向------不是替代代码,而是把那些不适合放在代码里的部分,用更合适的方式管起来。