从零做一个可视化规则引擎:Vue3 递归条件树 + 双引擎结果对比
面向有 Vue 基础、想了解规则引擎落地的开发者。全文约 8000 字,含 4 张流程图与 7 张实现截图。
业务规则一变,就要找开发改代码、重新发版------这个场景在电网、金融、IoT 这些行业里每天都在发生。这次我们花时间做了一件事:把规则的编写权从开发手里交还给业务人员。
成品是一个可视化规则编辑器:左侧编排条件、右侧实时看生成的 JSON 和执行结果,规则改完立刻能验证对不对。技术栈是 Vue 3 + TypeScript + Vite + Pinia + Element Plus。
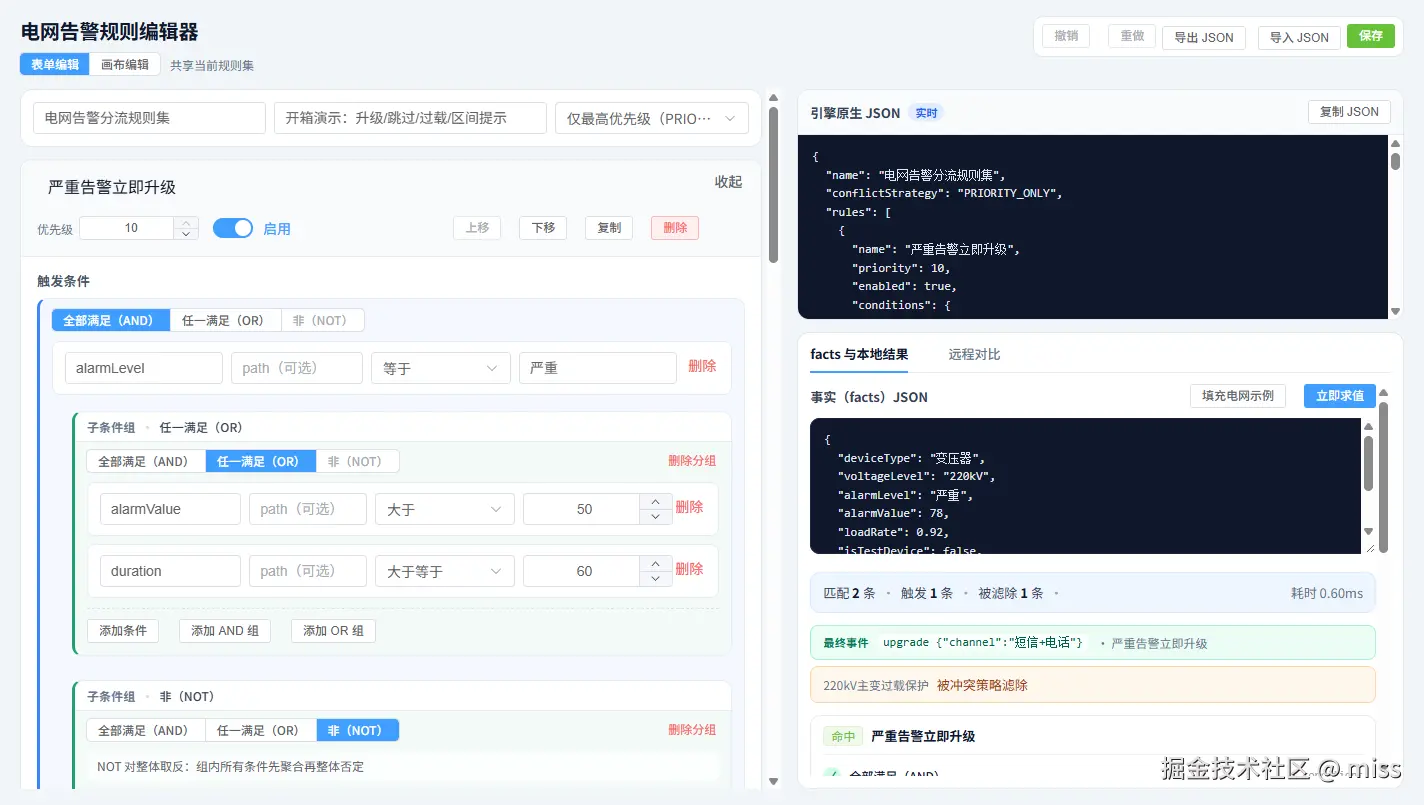
这篇文章不讲空泛的架构,只讲我在实现过程中真正卡过的那些地方和最后选择的解法。如果你也要做一个类似的东西,希望能帮你少踩几个坑。
目录
- 一、先想清楚一件事:前端到底输出什么
- [二、条件树:递归模型 + 不可变更新](#二、条件树:递归模型 + 不可变更新 "#%E4%BA%8C%E6%9D%A1%E4%BB%B6%E6%A0%91%E9%80%92%E5%BD%92%E6%A8%A1%E5%9E%8B--%E4%B8%8D%E5%8F%AF%E5%8F%98%E6%9B%B4%E6%96%B0")
- [三、NOT 组只能有一个孩子,但用户不会乖乖听话](#三、NOT 组只能有一个孩子,但用户不会乖乖听话 "#%E4%B8%89not-%E7%BB%84%E5%8F%AA%E8%83%BD%E6%9C%89%E4%B8%80%E4%B8%AA%E5%AD%A9%E5%AD%90%E4%BD%86%E7%94%A8%E6%88%B7%E4%B8%8D%E4%BC%9A%E4%B9%96%E4%B9%96%E5%90%AC%E8%AF%9D")
- 四、调试期最痛的问题:我想要看到每一个条件的结果
- [五、三态语义:missing 和 error 必须分开](#五、三态语义:missing 和 error 必须分开 "#%E4%BA%94%E4%B8%89%E6%80%81%E8%AF%AD%E4%B9%89missing-%E5%92%8C-error-%E5%BF%85%E9%A1%BB%E5%88%86%E5%BC%80")
- 六、fail-closed:错误绝不允许被翻成"命中"
- [七、编辑即预览:300ms 防抖 + 手动对比](#七、编辑即预览:300ms 防抖 + 手动对比 "#%E4%B8%83%E7%BC%96%E8%BE%91%E5%8D%B3%E9%A2%84%E8%A7%88300ms-%E9%98%B2%E6%8A%96--%E6%89%8B%E5%8A%A8%E5%AF%B9%E6%AF%94")
- 八、双引擎并排对比:提前发现语义差异
- 九、其他几个值得一说的细节
- 十、小结
一、先想清楚一件事:前端到底输出什么
这是整个项目最关键的一个决策,做错了后面全是返工。
我们后端用的是 Drools。最初的想法很自然:前端拼 DRL 字符串,直接丢给后端执行。
想了两天放弃了。原因是 DRL 的语法会随 Drools 版本演进,把生成逻辑放前端等于让两端一起维护同一套语法;更麻烦的是前端根本没法本地执行 DRL 验证,写完只能是"盲发"。
最后定下的方案是:
前端只产标准 JSON,DRL 的转换和执行全部交给后端。
这个方案还有个额外的好处------前端可以选择一个 JSON 规则引擎做本地预览,编辑时立刻能看到结果,不用等后端。我们选了 json-rules-engine-upgraded。
于是整条链路变成这样:
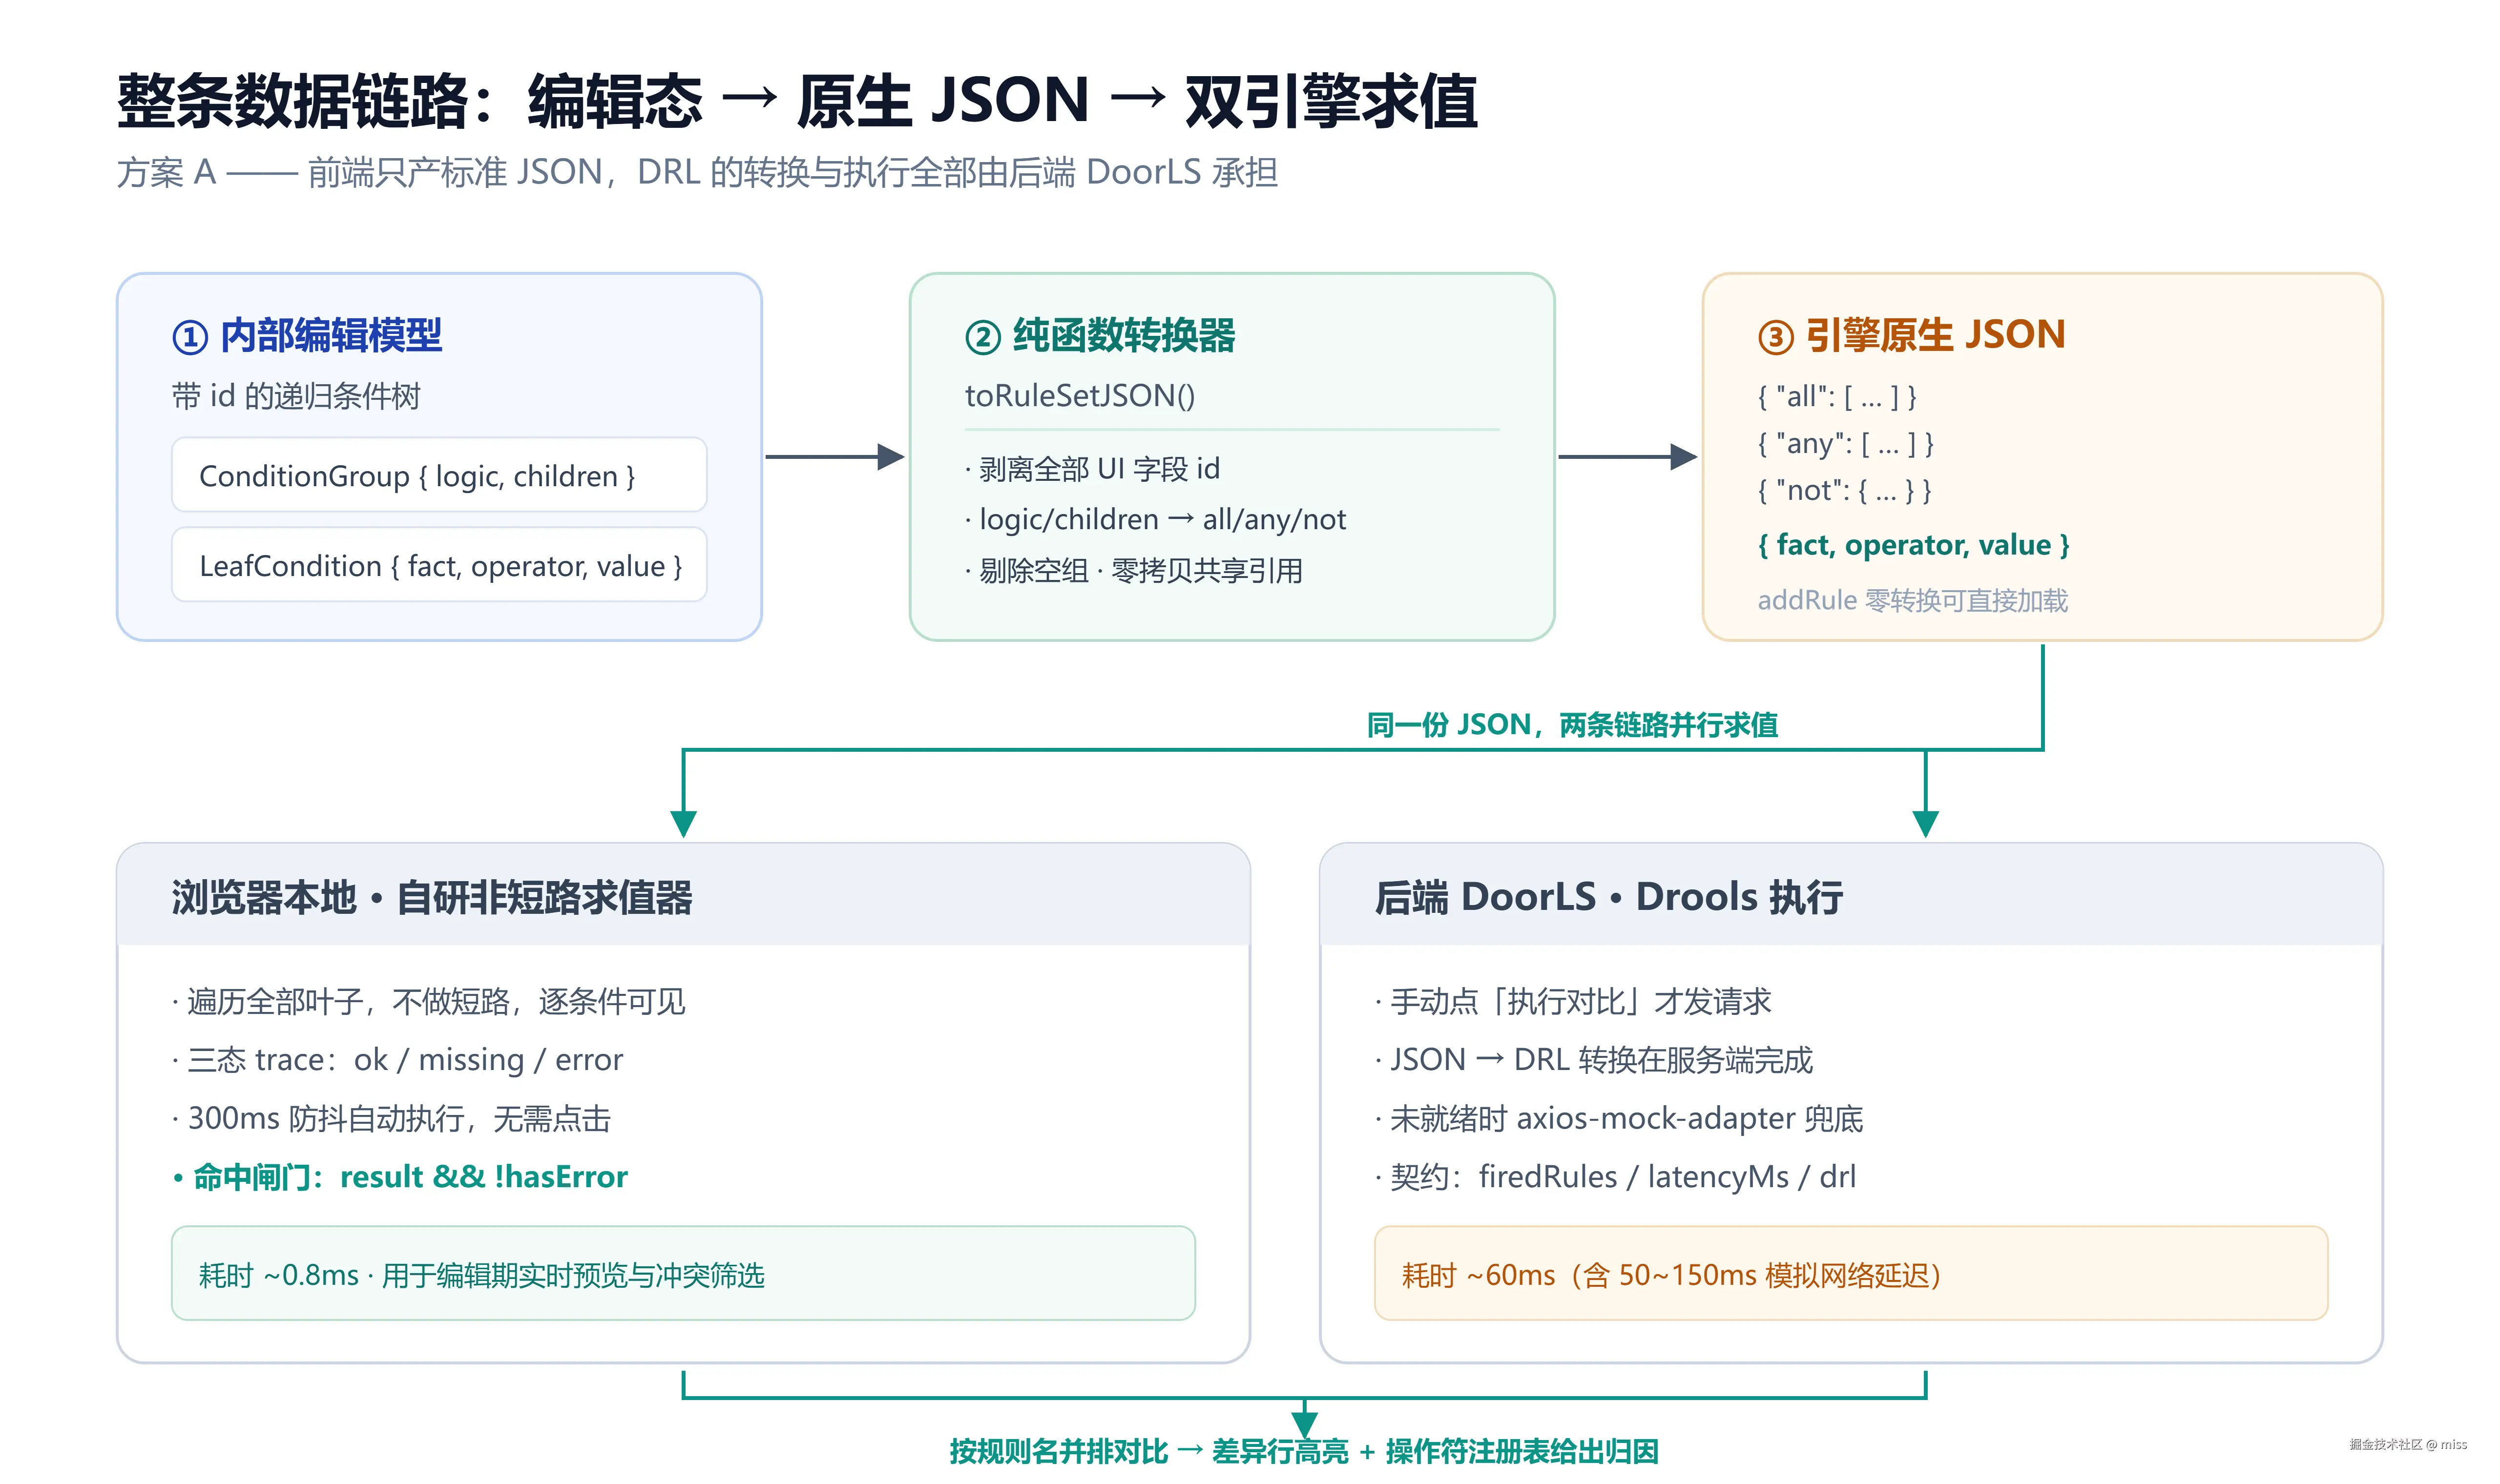
① 内部编辑模型 → ② 纯函数转换器 → ③ 引擎原生 JSON,然后这份 JSON 同时喂给浏览器本地求值器和后端 DoorLS。
关键在于第 ③ 步的产出必须是引擎原生结构,不是我们自定义的中间格式。也就是说:
jsonc
{
  "name": "严重告警立即升级",
  "priority": 10,
  "conditions": {
    "all": [
      { "fact": "alarmLevel", "operator": "equal", "value": "严重" },
      {
        "any": [
          { "fact": "alarmValue", "operator": "greaterThan", "value": 50 },
          { "fact": "duration", "operator": "greaterThanInclusive", "value": 60 }
        ]
      },
      { "not": { "fact": "isTestDevice", "operator": "equal", "value": true } }
    ]
  },
  "event": { "type": "upgrade", "params": { "channel": "短信+电话" } }
}
这份 JSON 拿去 new Engine(rules).addRule() 是零转换能直接加载的。后端将来转 DRL 也只需要认这一套结构,不用再理解一层我们发明的方言。
这里有个建议:在选择方案前,先拿真实数据把两条路都写一遍。 我们当时把一条"220kV 主变过载保护"规则分别用 JSON 和 DRL 描述了一遍,DRL 版本要处理包声明、import、salience、规则名唯一性,还要考虑 dialect------而 JSON 版本一行 all 就完事了。这个对比让决策变得毫无悬念。
二、条件树:递归模型 + 不可变更新
规则条件的本质是一棵可以无限嵌套的树。叶子是条件,枝干是 AND / OR / NOT 分组。
数据结构直接照着最终 JSON 设计:
ts
type ConditionNode = LeafCondition | ConditionGroup

interface LeafCondition {
  id: string
  fact: string          // 字段名
  path?: string         // JSONPath 子路径,可选
  operator: OperatorKey
  value: unknown
}

interface ConditionGroup {
  id: string
  logic: 'all' | 'any' | 'not'
  children: ConditionNode[]
}
两个模型之间的映射关系是完全同构的:
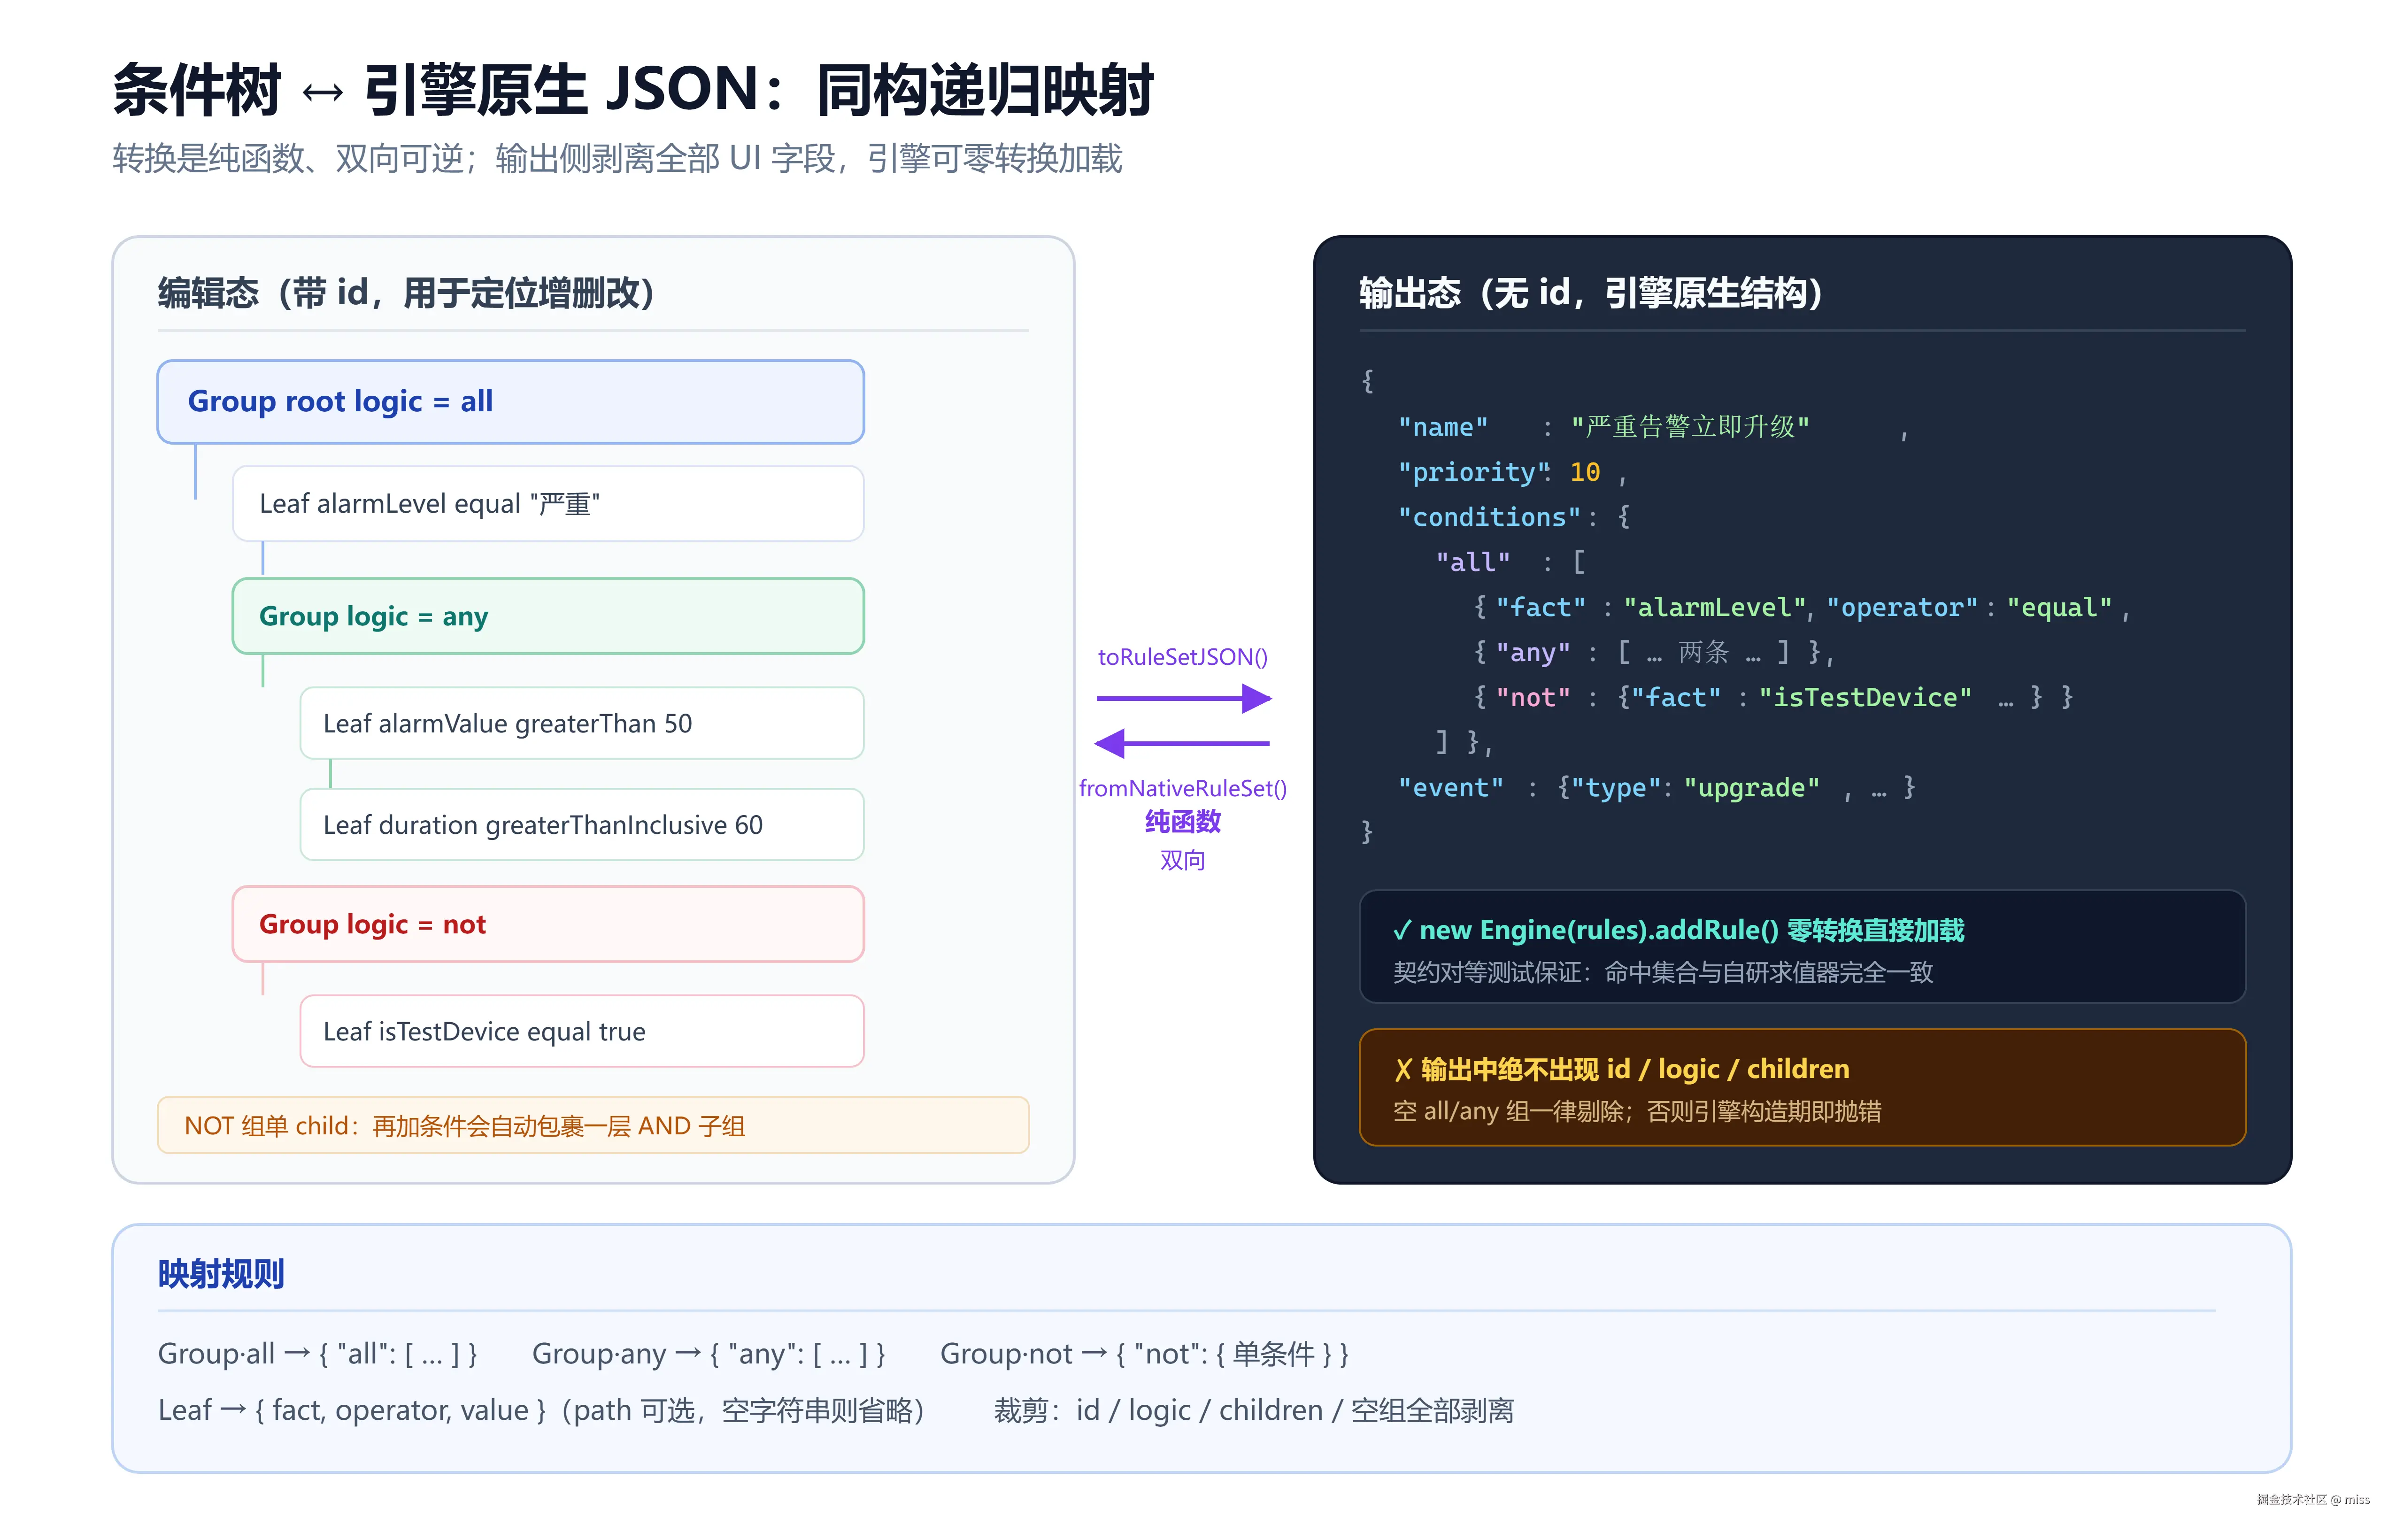
一个很容易被忽略的细节:编辑态和输出态必须是两套模型 。编辑态带 id(要用它定位节点做增删改),输出态不能带任何 UI 字段。
所以我们写了一个纯函数 toRuleSetJSON(),负责剥离全部 id、把 logic/children 递归翻译成 all/any/not、剔除空组。反向的 fromJSON() 用于文件导入,递归补回 id。
因为是个纯函数,它非常好测------输入一棵树,输出一份 JSON,没有副作用。这里也顺手埋了个持续验证:把输出的 rules 过滤掉禁用项后喂给真实的 Engine,命中集合必须和我们的求值器完全一致。这把"引擎能零转换加载"从一句口头约定变成了每次 CI 都会跑的测试。
树的增删改我用的是结构共享的不可变更新。比如删除一个节点,只沿命中路径重建节点,没被触碰的子树直接返回原引用:
ts
function removeIn(group: ConditionGroup, id: string): ConditionGroup {
  let changed = false
  const nextChildren: ConditionNode[] = []
  for (const child of group.children) {
    if (child.id === id) { changed = true; continue }
    if (isGroup(child)) {
      const next = removeIn(child, id)
      if (next !== child) changed = true
      nextChildren.push(next)
    } else nextChildren.push(child)
  }
  return changed ? { ...group, children: nextChildren } : group
}
这样 Vue 的依赖追踪更精准,撤销栈里存的快照也不会共享可变引用。
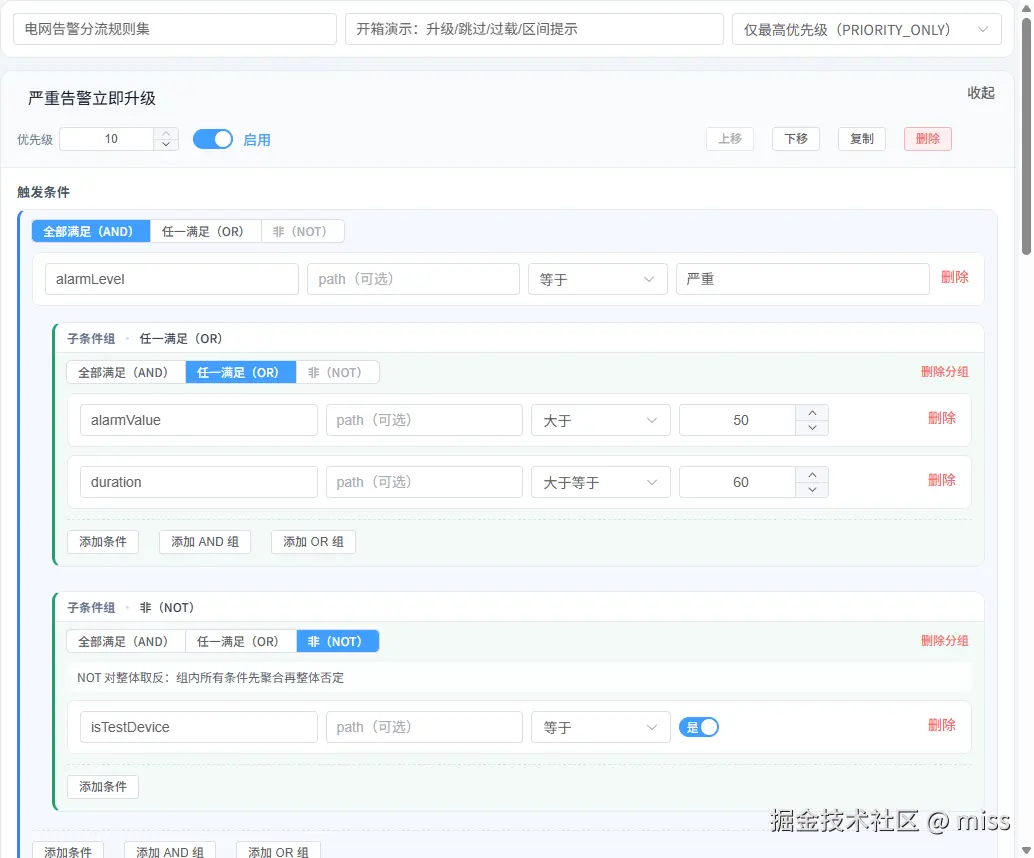
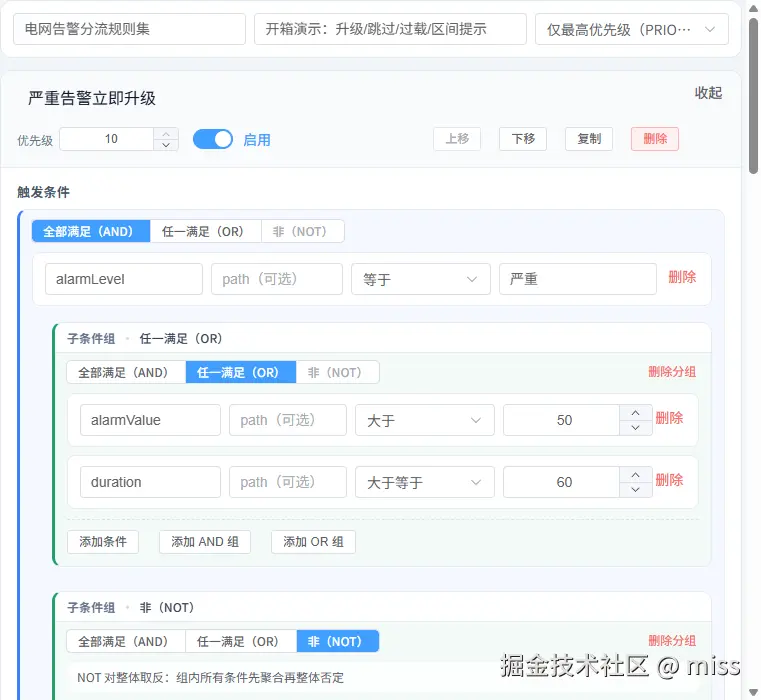
实际渲染出来的条件树长这样------注意每层组卡片左侧的色条会随层级换色,深嵌套时一眼能看出自己在哪一层:
规则集本身的配置(名称、描述、冲突策略)在顶部一个横条里:
三、NOT 组只能有一个孩子,但用户不会乖乖听话
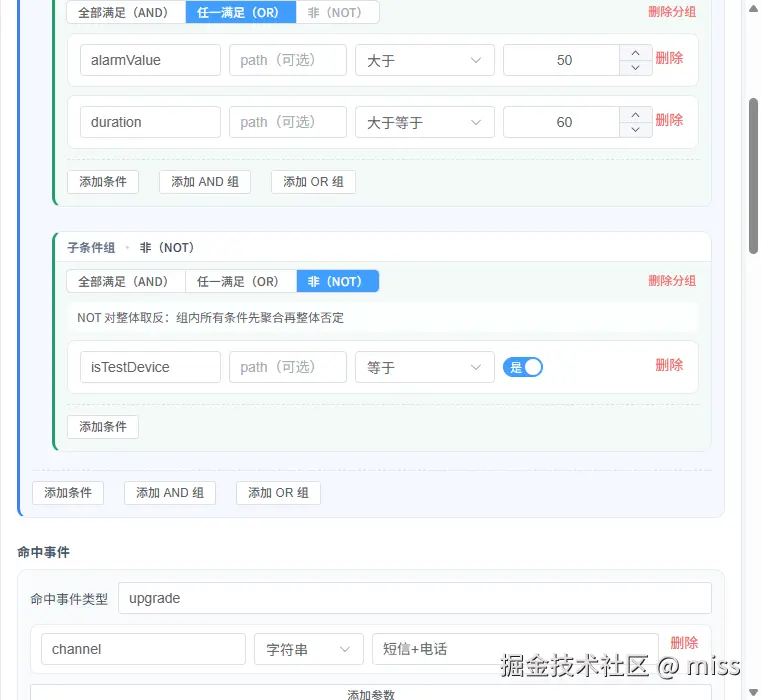
JSON 引擎的 not 语义是单操作数 的:{ not: 某个条件 },不是数组。但用户在界面上点两下就很容易往 NOT 组里塞进第二个条件。
两种处理方式:报错拦住,或者自动适配。我们选了后者------当 NOT 组已经有 1 个孩子、用户又点"添加条件"时,自动把两个条件包裹进一个 AND 子组,再加提示告诉用户"NOT 对整体取反"。
ts
export function addChildSmart(group: ConditionGroup, child: ConditionNode): ConditionGroup {
  if (group.logic === 'not' && group.children.length > 1) {
    throw new Error(`NOT group must have at most one child, got ${group.children.length}`)
  }
  if (group.logic !== 'not' || group.children.length === 0) {
    return { ...group, children: [...group.children, child] }
  }
  // 自动包裹
  const wrapped = createGroup('all', [group.children[0], child])
  return { ...group, children: [wrapped] }
}
界面上的交互成本为零,输出的 JSON 结构依然合法。
深嵌套时用户很容易迷路,所以每个子组顶部有一条吸顶的面包屑,滚动时会一直贴在容器顶部:
这里有个设计原则值得展开说:约束应该内化,而不是弹给用户。 我们一开始的做法是弹出提示"NOT 组只允许一个条件",结果测试时发现业务人员会反复触发这个错误,然后卡在那里不知道怎么办。改成自动包裹之后,同样的操作路径变成了"点什么就是什么",用户完全不需要知道 JSON 里 not 是单操作数的。
四、调试期最痛的问题:我想要看到每一个条件的结果
这一节是整篇文章里我最想分享的部分。
json-rules-engine 的 engine.run(facts) 只返回 { passed: true }------它短路求值。AND 组遇到第一个 false 就停了,后面的条件压根不求值。
但用户需要的是"为什么这条规则没命中",也就是要看到每一个叶子条件的真假。短路求值给不了这个信息。
试过用引擎的 onSuccess / onFailure 钩子,还是绕不开短路;也想过直接改引擎源码,但那样就丧失了升级能力。
最后的解法是:自己写一个非短路求值器。
它直接吃我们定义的那套原生 JSON 条件结构,算子实现从注册表里取,遍历所有叶子节点,产出带路径的 trace 树:
ts
export interface TraceLeaf {
  kind: 'leaf'
  jsonPath: string      // $.conditions.all[1].any[0]
  fact: string
  operator: OperatorKey
  result: boolean
  state: 'ok' | 'missing' | 'error'
  message?: string
}
jsonPath 是关键------结果面板可以直接把每个叶子条件钉在对应的 UI 位置上。
那真正的引擎呢?它不参与业务求值,只出现在契约对等测试里。这个取舍我觉得比"为了用而用"更诚实:引擎负责证明我们的输出格式是标准的,我们的求值器负责提供更好的调试体验。
如果你也在做类似的技术选型,我建议先写一个"最坏情况"的验收用例。 我们当时写的是:"一条 AND 规则有 5 个条件,第 2 个为 false,后续 3 个条件的结果必须仍然可见。"这个用例直接判了 engine.run() 的死刑------它连基本信息都给不了。用这种方式做技术选型,比看文档里列的功能表可靠得多。
五、三态语义:missing 和 error 必须分开
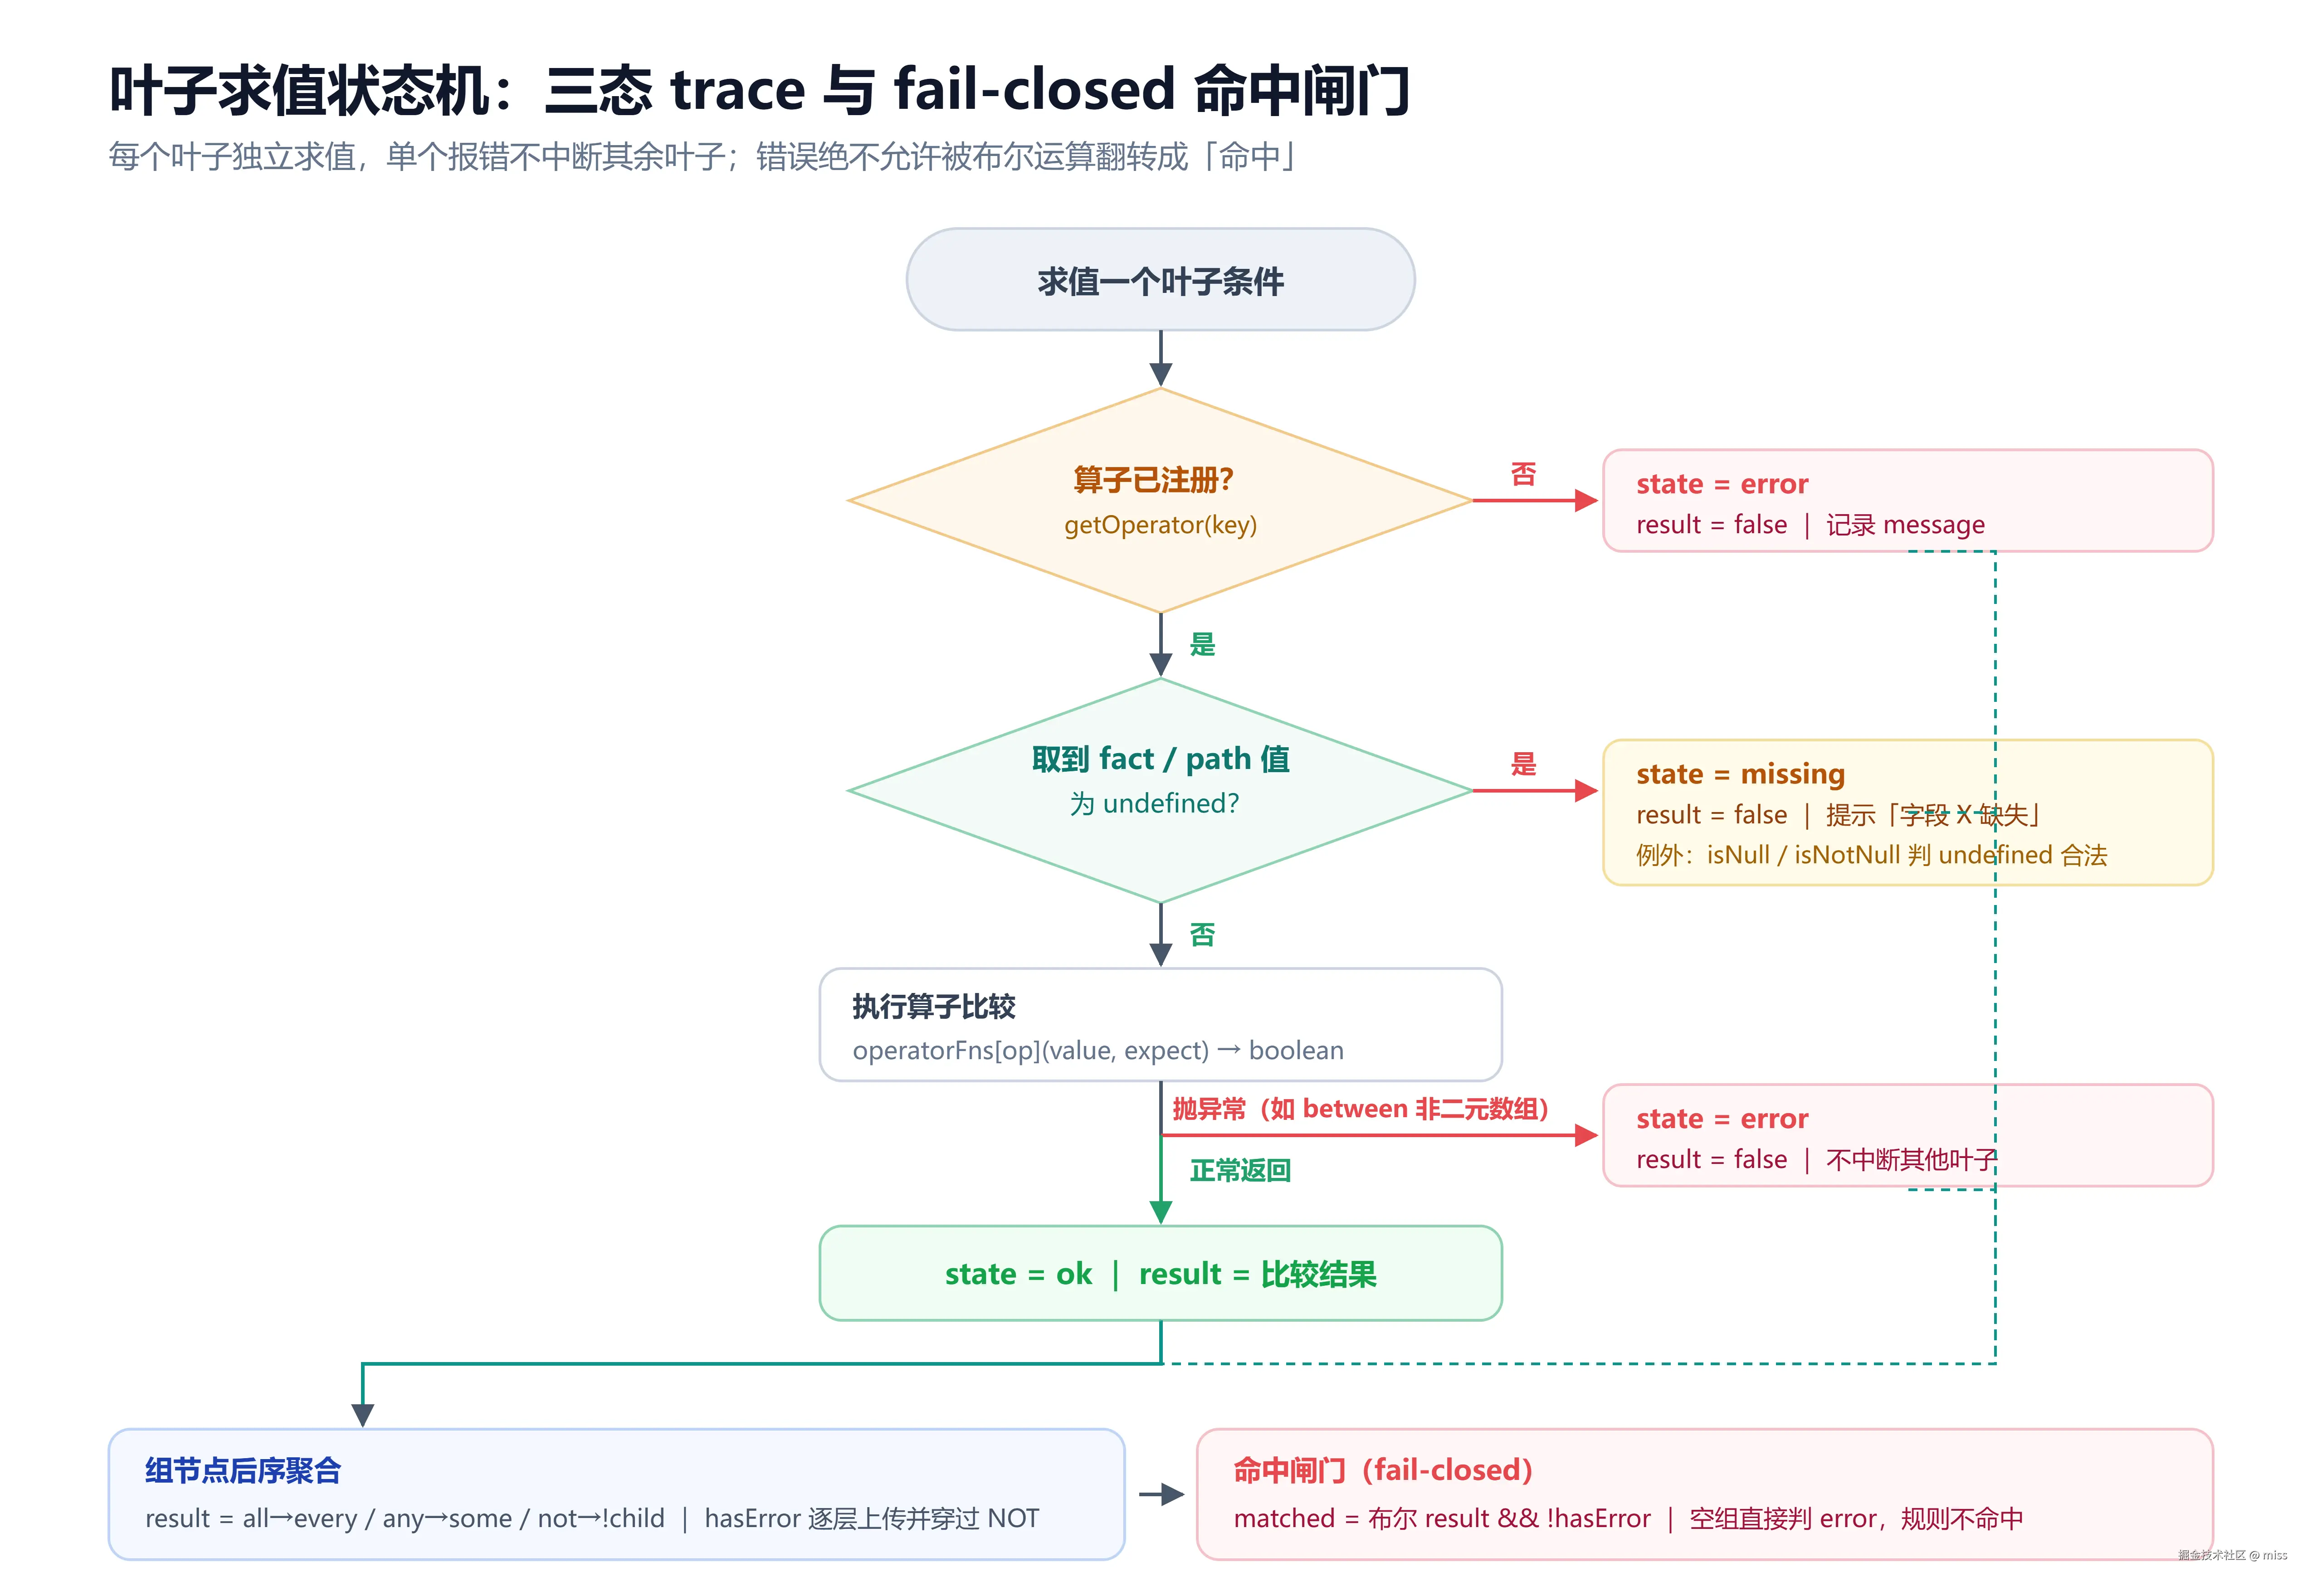
叶子求值结果不能只有 true / false 两态。实际写规则时最容易出问题的是另外两种情况:
missing:字段不存在。用户写了个alarmVal(少个 u),或者 facts 里根本没这个字段。这时候数值比较得到undefined > 50是 false,但"字段缺失"和"条件不成立"是两回事,必须分开提示。error:算子本身出错。比如between的值配成了[1]这种非二元数组,求值直接抛异常。
完整的叶子求值状态流转如下:
ts
if (value === undefined && !NULLABLE_OPERATORS.has(leaf.operator)) {
  return { ...base, state: 'missing', message: `字段 ${leaf.fact} 缺失` }
}
return { ...base, result: operatorFns[leaf.operator](value, leaf.value), state: 'ok' }
注意 isNull / isNotNull 是白名单:它们对 undefined 的判断本来就是合法语义,不该被标成 missing。
单个叶子报错时,不能中断其他叶子的求值------用户需要看到全貌才能定位问题。
结果面板里每个叶子右边都会标出状态,绿色「正常」就是 ok:
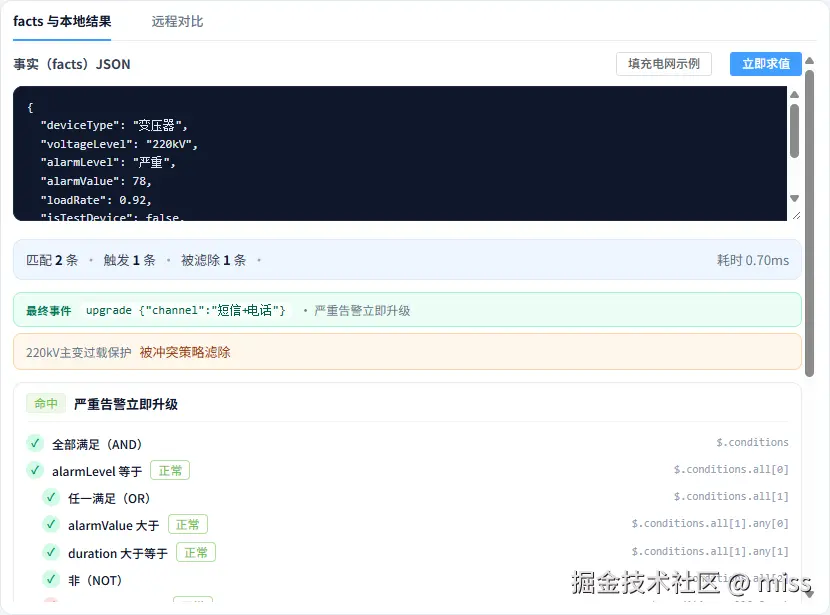
你会发现路径列直接显示了 $.conditions.all[1].any[0] 这样的 JSONPath。这个设计让用户和开发者能用同一种语言沟通问题------用户说"第 2 个条件的 OR 组第 1 条不对",开发者可以直接去 JSON 里定位。
六、fail-closed:错误绝不允许被翻成"命中"
这是我在实际测试中撞出来的一个 bug,想单独拎出来讲。
考虑这条规则:NOT(between 配了个坏值)。
坏值导致叶子求值 error,result 为 false。然后 NOT 组对它取反------布尔结果变成了 true。
规则"命中"了。但实际上它什么都没检查,是个幽灵触发。如果这条规则的事件是"切负荷",后果不用我多说。
修法是给每个组节点加一个后序聚合的 hasError:只要子树里存在任意 error 叶子(或空组),这个标记就为 true,并且透传穿过 NOT。
最终命中判定标准统一改成:
ts
const isMatched = nodeResult(trace) && !nodeHasError(trace)布尔结果和错误状态是两个正交的维度,任何布尔运算都不应该翻转错误的语义。
顺带处理了空组:{ all: [] } 在引擎构造期就会抛 "must contain at least one child condition",所以我们的求值器也对齐成 result = false 且标 error,同时导入校验对任意层级的空组报 EMPTY_CONDITIONS。
这个 bug 给我们的教训是:错误处理不能只做在"正常路径的旁边",它得是求值模型里的一等公民。 我们后来把这条规则写进了团队规范:任何布尔聚合函数,都必须显式声明它对错误输入的处理策略,是透传、短路还是降级。不能默认"错误会被上层自然处理掉"。
七、编辑即预览:300ms 防抖 + 手动对比
本地求值不需要用户点任何按钮。规则或 facts 一变,300ms 防抖后自动跑一次,防抖期间显示"求值中"。
耗时显示实测是 0.7~0.9ms(见截图里右上角的数字),因为纯内存计算,不需要等网络。
注意结果区中间的被滤除标记。规则集有四种冲突策略:
| 策略 | 行为 | 适用场景 |
|---|---|---|
PRIORITY_ONLY |
只保留优先级最高的匹配规则,同优先级取顺序靠前者 | 分级告警(默认) |
FIRE_ALL |
全部匹配规则都执行,按 priority 降序 | 多个动作可叠加 |
FIRST_WIN |
规则顺序里第一条命中的,不看 priority | 短路的告警分流 |
LAST_WIN |
规则顺序里最后一条命中的 | 覆盖式语义 |
截图里"220kV主变过载保护"其实是匹配上了的,但被 PRIORITY_ONLY 策略滤掉了。这个信息必须展示出来------否则用户会困惑"我这条规则明明满足条件为什么不生效"。
冲突筛选的完整流程:
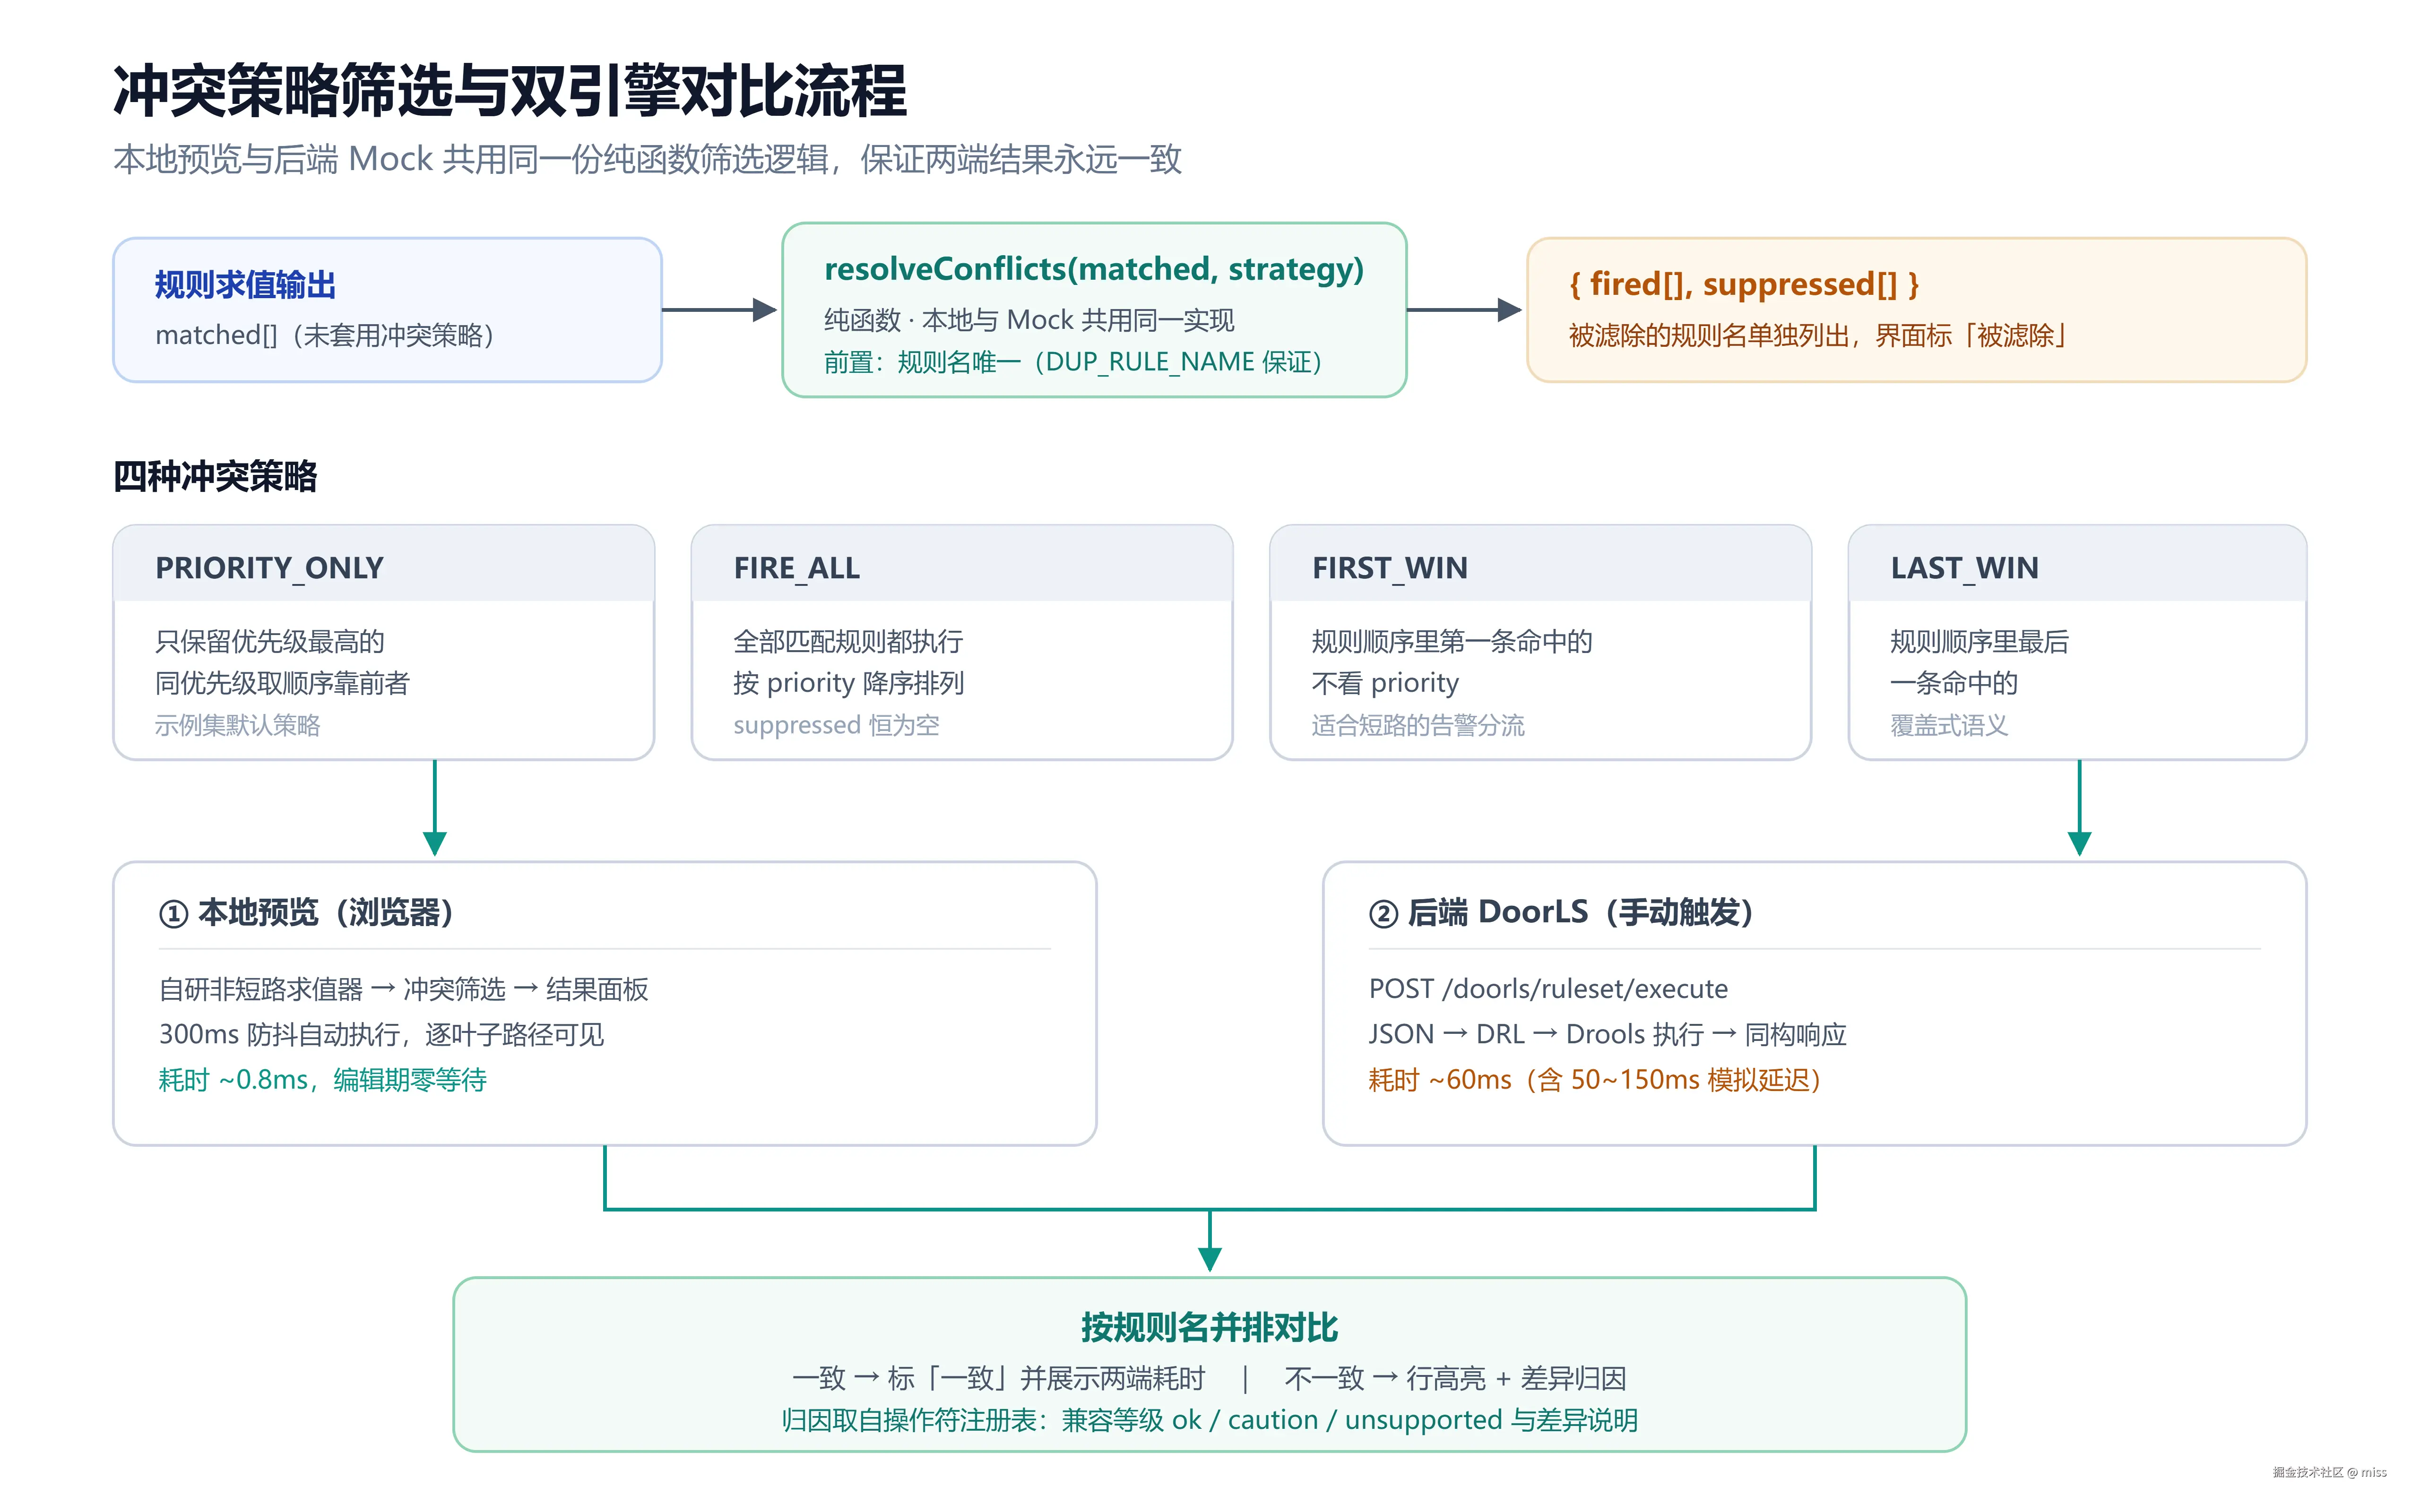
筛选我写成了一个纯函数,本地预览和后端 Mock 共用同一份实现,保证两边结果永远一致:
ts
export function resolveConflicts(matched: MatchedRule[], strategy: ConflictStrategy) {
  // 前置:规则名唯一性由校验层(DUP_RULE_NAME)保证
  // PRIORITY_ONLY → 取优先级最高(同优先级取 order 靠前者)
  // FIRST_WIN / LAST_WIN → 按 order 取首/末
  // FIRE_ALL → 全部保留,按 priority 降序
}这里踩过一个坑:suppressed 是按规则名去重统计的。 如果规则集里出现两条同名规则,被滤除的统计就会错乱。所以我们在校验层加了 DUP_RULE_NAME,把"规则名唯一"变成整个冲突策略模块的前置条件。这类隐式依赖如果不写下来,后面接手的人很容易破坏它------我们在函数注释里专门标注了这一点。
八、双引擎并排对比:提前发现语义差异
前面说了本地引擎和后端 Drools 是两套执行链路。它们的操作符语义并不完全等价------这才是这个项目最大的风险点。
所以对比面板不是"顺便做的功能",而是核心设计目标。
后端接口没就绪之前,用 axios-mock-adapter 在浏览器里模拟实现,返回完全同构的响应(包括 50~150ms 随机延迟、示意性的 DRL 文本):
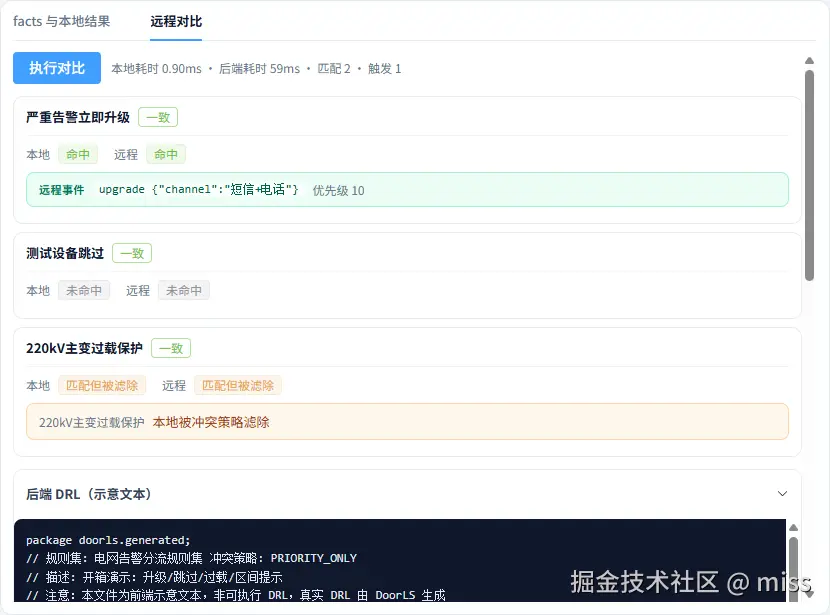
每条规则按名字并排展示本地和远程的判定结果,一致标"一致",不一致的行高亮并给出可能原因。
之所以能做到"给出可能原因",是因为我们维护了一张操作符注册表------单一事实源:
ts
{ key: 'contains', label: '数组包含', factTypes: A, valueKind: 'scalar',
  drools: 'contains', compatibility: 'caution',
  note: '方向:fact 为数组、value 为标量' }
每个操作符记录:适用的字段类型、值的形状、Drools 等价写法、兼容等级(一致/需注意/不支持)和差异说明。这张表同时被三处使用:
- 条件行的操作符下拉(按字段类型过滤)
- 导入时的值形状校验(
valueKind→BAD_VALUE) - 对比面板的差异归因
改一处,三处同步。
Mock 里还内置了一个 diff 场景开关,会故意注入一条语义差异,方便演示和测试对比高亮的效果。
关于"两端语义差异"这件事,我的建议是别指望测试能兜住。 我们的做法是:把兼容等级 caution 的操作符在界面上直接标出来,让业务人员在写下这条规则的那一刻就知道"这个写法在后端可能表现不同"。把风险暴露在编辑期,比上线后 catch 一个静默错误划算太多。
九、其他几个值得一说的细节
撤销重做用快照而非命令模式。 深树操作的逆命令实现成本太高且容易出错,而规则集体积是 KB 级的,50 份 structuredClone 快照内存开销可以忽略。连续输入不逐字符入栈,值编辑在 500ms 防抖后合并成一次快照。
输入防抖要防止"写回后又触发一次"。 我们写了个 useDebouncedCommit,内置一个 lastWritten 基线:
ts
const shouldWrite = (): boolean =>
  !equals(draft.value, read()) && !equals(draft.value, lastWritten)
用来识别"内容其实已经写回过了",避免撤销/重做之后重新编辑同一个值被静默吞掉。外部源变化时同步重置基线。这个坑不实际写一遍是想不到的。
导入必须可撤销。 用户导入 JSON 文件时给了"覆盖当前"和"合并追加"两个选项,重名规则自动加序号后缀,并且整次导入作为一次结构性编辑压入撤销栈。误点导入的代价太大了。
JSONPath 解析只访问自有属性。 resolvePath 用 hasOwnProperty 判定,constructor / __proto__ 这类原型链成员一律返回 undefined,避免从用户导入的文件里被钓出原型污染。
最后是那个"编辑即得原生 JSON"的实时预览面板,它让整个链路的输出始终可见:
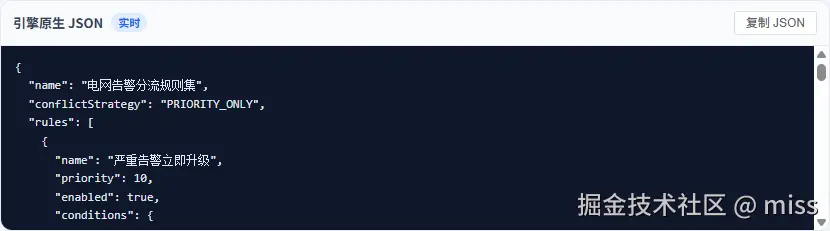
十、小结
回头看,这个项目真正花时间的不是界面,而是下面这几件事:
- 把"输出什么格式"想清楚------选引擎原生 JSON 而不是自定义中间格式,让后续所有环节都变简单了。
- 接受引擎不满足需求,自己写求值器------而不是硬把需求塞进一个不合适的工具里。
- 把错误当成一等公民------三态 trace + fail-closed 闸门,避免配置错误变成生产事故。
- 让差异可见------操作符注册表作为单一事实源,双引擎并排对比把语义差异提前暴露在编辑期,而不是上线后。
最后一点感触:让业务人员自助维护规则,本质上是在把隐式的领域知识显式化。界面上每一个"为什么没命中"的提示、每一个"被滤除"的标记,都是在替他们回答那些原本要问开发的问题。这部分体验做扎实了,工具才真的有人用。
附:项目代码结构
css
src/
├── types/       类型模型(RuleSet / ConditionNode / NativeCondition)
├── utils/       全部纯函数:求值、转换、校验、冲突、历史、路径
│   ├── evaluate.ts    非短路求值器(三态 trace)
│   ├── ruleJson.ts    双向转换 + 结构校验
│   ├── conflict.ts    四种冲突策略筛选
│   ├── operators.ts   操作符注册表(单一事实源)
│   └── tree.ts        结构共享的不可变树操作
├── components/  ConditionGroup 递归组件等 18 个组件
├── stores/      Pinia:规则集状态 / 求值视图 / DoorLS 客户端
├── composables/ 防抖、防抖提交、示例引导
└── mock/        axios-mock-adapter 内置 Mock(normal / diff / compile-error 三场景)
逻辑全部下沉到 utils/ 纯函数,组件保持薄------这也是为什么 utils/** 能做到 100% 行覆盖,而组件测试只覆盖真实交互。
技术栈版本:Vue 3.5 / TypeScript 5.9 / Vite 5.4 / Pinia 2.3 / Element Plus 2.14 / Vitest 2.1,json-rules-engine-upgraded 锁定精确版本 1.0.1。