一.redis 是什么?
1.概念
Redis (Remote Dictionary Server)是一个基于内存的键值对(Key-Value)数据库 ,同时也是一个高性能的缓存中间件。
它最大的特点是快 ------读写操作都在内存中完成,官方标称读性能可达 10 万+ QPS(每秒查询数)。
放在内存里面的东西就叫 缓存,因为程序一断开,内存里面的东西就清空了。
2.为什么radis很快?
- 他的数据放在内存里面--不需要读取磁盘
- 他是单线程模型--避免多线程上下文切换
- 他是基于多路复用(epoll)--单线程也能处理海量并发连接
- 他有高效的底层数据结构------如跳表、压缩列表等
3.redis和mysql 对比
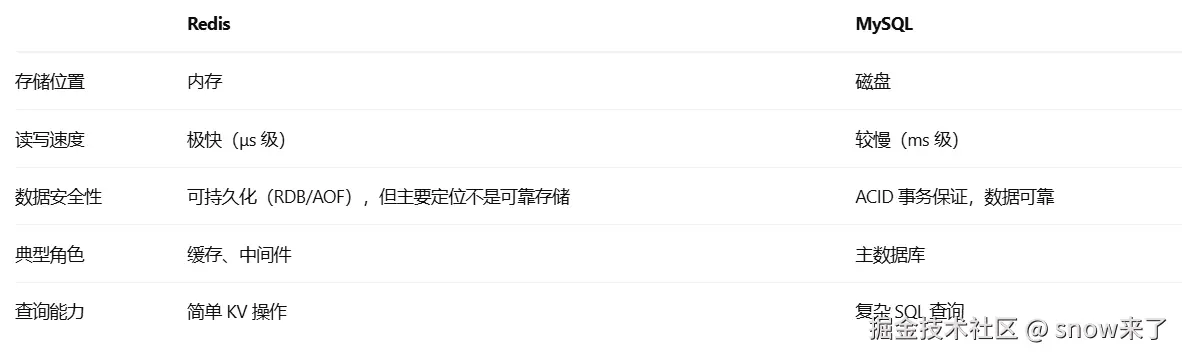
4.Redis 在 AI Agent 项目中的核心价值
不管在哪个项目里面,Redis 就是那个站在数据库前面、用内存换速度的"加速层",让你的系统又快又稳。
他的核心价值用一句话说就是:
Redis 能够帮助 Agent 项目解决 记忆、缓存、检索、协调 四大核心需求,让 AI 从"金鱼记忆"变成"有记忆力的助手"。
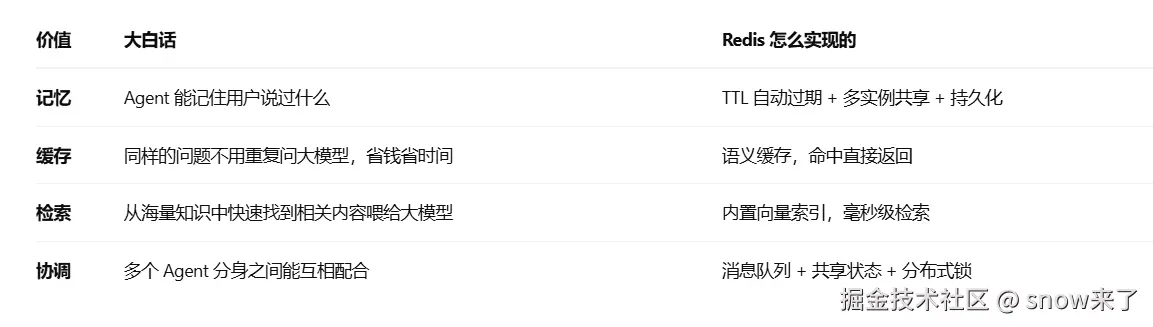
TTL自动过期
TTL 是 Time To Live(生存时间) ,指的是数据的"倒计时有效期"。比如用户登录后,系统会在 Session 里设置一个过期时间(比如 30 分钟)。时间一到,这条登录信息会被自动删除,用户下次操作就需要重新登录。这样做的好处是:即使 Session 信息不小心泄露了,它也会在一段时间后失效,降低被冒用的风险。
在redis里面TTL就像一张编签纸的倒计时,你把你要做的事情都写在便签纸上,时间一到,就把编签纸销毁掉,保证你的秘密不会被泄露出去。
多实例共享
一般 aiAgent项目 会部署在多个服务器上,通过负载均衡来分发需求,那如果第一个请求给了A 服务器(A分身),第二个请求给了B服务器(B分身),B 又不知道 A 回答了什么,怎么办?
这时候,你可能会每次都将历史数据全部带上之后再发送请求。这样做有几个坏处:
- 1.你将和问题不相关的历史数据发送给了大模型,此时就会干扰大模型的回复。
- 2.你的历史数据超出了限制,想带的没有带上,不想带的进入了大模型,大模型阅读历史数据也需要token。
还有没有更好的办法呢?有就是redis,此时它就成了我们不可或缺的帮手。
Redis 就是中间那张公共办公桌,所有分身都往这张桌上放东西、拿东西,谁都能看到。不管用户换到哪个分身,记忆都在。
持久化
内存里存东西最大的问题就是:一断电全没了。用户聊了半天,服务器重启,记忆全丢,用户体验直接崩塌。
Redis 的 RDB/AOF 就像定期把便签纸拍照存档 + 每写一条就记一笔日志,服务器挂了重启之后,记忆能恢复回来,用户毫无感知。
丰富的数据结构
redis 里面有仿佛的数据结构, 而 agent 要存的东西也五花八门:
- 存一段对话文本 → 用 String(就像便利贴,一个名字对应一段内容)
- 存用户资料(姓名、年龄、偏好)→ 用 Hash(就像一张表格,一行一个字段)
- 存任务队列(待办事项列表)→ 用 List(就像排队取号的号码牌)
Redis 不是只能存一种东西,而是各种形状的都有,拿来即用。
语义检索
Redis 在 RediSearch 模块 (Redis 7.2+)中加入了向量索引支持,到 Redis 8.0 直接把 RediSearch 并入内核,变成了原生的向量检索能力。
换句话说,Redis 在内存里存数据,本身就擅长"快速找东西"。而向量检索的本质也是"快速找相似的数据"------Redis 只是在自己已有的存储引擎上,加了一层向量索引算法(HNSW/FLAT) ,让它能按"语义相似度"来找数据,而不只是按 key 精确查找。
消息队列
Redis 消息队列在 Agent 项目里干的就是 "把慢的、容易挂的、易超时的,容易并发打架的动作,从主链路里拎出来排队"。
轻量异步用 List,要可靠和分活用 Streams;消息体只放 ID,别往里塞大东西;量大了别硬扛,换专业 MQ。
5.deepagent的subAgent的中间件和langgraph都可以给多个agent排序,为什么还要用redis的消息队列去管子agent的事情?
Agent 框架(DeepAgent / LangGraph / CrewAI)管的是"谁做什么、怎么做"------也就是编排逻辑。
Redis 管的是"任务放在哪、谁抢到了、别抢重复了、崩了怎么办"------也就是运行时支撑。
框架是大脑,Redis 是手和脚。 大脑想清楚了,活还得靠手干。
框架的 SubAgent 调度 = 你在办公室里,口头喊三个同事帮你干活
人都在、都在线、事情不多 → 没问题
人突然走了(进程重启)、事情堆成山(突发流量)、要跨办公室(多机部署)→ 就乱了
Redis 消息队列 = 公司前台放了个任务登记本谁来都看登记本,谁做完划掉一条
人走了,本子还在
新来一个人,直接翻本子干活
活太多排着队,不会挤爆办公室
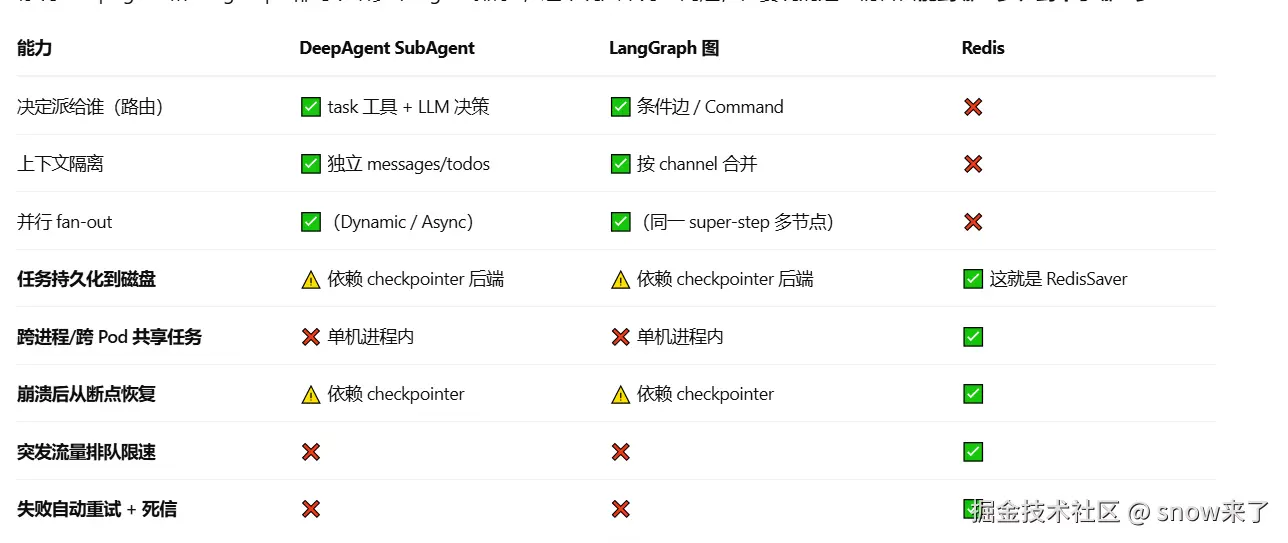
说明一个问题,deepagent的subAgent的中间件和langgraph都可以给多个agent排序,只是在规划,做完这件去做那件。可是在真正运行的时候就,会出现运行比较慢的节点,那么redis就会把这个缓慢节点从主链路里摘出去,将任务丢进消息队列里面,在后台慢慢跑,此时主进程就可以立刻返回。
框架负责"谁先谁后"的编排;Redis 负责"活怎么可靠地跑起来、怎么不被慢节点拖垮、怎么不被流量冲垮"。
6.Redis 的使用场景
场景一:多副本部署
css
10 个 Pod 都跑同一套 LangGraph
→ Pod A 跑到一半挂了
→ 请求被负载均衡转到 Pod B
→ Pod B 凭 thread_id 从 Redis 读出 checkpoint,接着往下跑
没 Redis?Pod B 什么都不知道,用户只能从头来。这是 Redis 不可替代的场景。
场景二:长任务不能阻塞 HTTP
LangGraph 的 super-step 是同步的,一个节点没跑完,图就停在那。Agent 调搜索、跑脚本要 5 分钟,网关 30 秒超时直接断。
Redis Streams 在这里是把长任务从 HTTP 链路里摘出去:
arduino
HTTP 请求 → 建 thread + 写初始 checkpoint → 投一条消息进 Stream → 立即返回 task_id
消费者(另一组进程)→ 读消息 → 推进图 → 每步写 checkpoint → 完成写结果
前端 → 拿 task_id 轮询 / 订阅拿结果
图的编排还是 LangGraph 的,Redis 只是承载了"待办任务"和"每一步的状态快照" 。
场景三:突发流量
1000 个请求同时进来,模型 API 和下游扛不住。框架的并发调度只管"同时跑几个",不管"要不要排队" ------它会照实开满,然后打爆下游。Redis 队列负责限速匀速消费。
场景四:失败重试与死信
框架不提供"失败 3 次进死信队列"这种机制。Redis Streams 的 XACK + 重试 + dead letter,是专门干这个的。
什么时候确实不需要 Redis
如果你的场景是单进程、单 Pod、任务几分钟能跑完、崩了重跑也没关系,那:
- DeepAgent 的 SubAgentMiddleware 足够了
- 或者 LangGraph + MemorySaver 也足够了
- 上 Redis 反而是过度设计
2.redis 的ai Agent项目
2.1.安装
js
docker run -d --name redis -p 6379:6379 redis:7-alpineredis不支持windows,因为 Redis 从 3.2 起就停掉了 Windows 的官方维护。也可以在 docker 上安装。
2.2.在nodejs 里面操作redis
js
import Redis from 'ioredis';

// 创建 Redis 客户端
const redis = new Redis({
  host: 'localhost',
  port: 6379,
  db: 0
});

// 监听连接
redis.on('connect', () => {
  console.log('✅ ioredis 连接成功(mjs 版)');
});

// 错误监听
redis.on('error', (err) => {
  console.error('❌ Redis 连接失败:', err);
});

// 执行操作
async function runRedisDemo() {
  try {
    // =========================
    // 1. String 字符串
    // =========================
    await redis.set('name', '张三');
    await redis.set('code', '6666', 'EX', 300); // 5 分钟过期
    console.log('String name:', await redis.get('name'));

    // =========================
    // 2. Hash 哈希
    // =========================
    await redis.hset('user:1001', 'name', '李四', 'age', 28);
    console.log('Hash user:', await redis.hgetall('user:1001'));

    // =========================
    // 3. List 列表
    // =========================
    await redis.lpush('task:list', '任务1', '任务2');
    await redis.rpush('task:list', '任务3');
    console.log('List:', await redis.lrange('task:list', 0, -1));

    // =========================
    // 4. Set 集合
    // =========================
    await redis.sadd('tag:set', 'redis', 'nest', 'node');
    console.log('Set:', await redis.smembers('tag:set'));

    // =========================
    // 5. ZSet 有序集合
    // =========================
    await redis.zadd('score:rank', 99, '小明', 95, '小红');
    console.log('ZSet 排名:', await redis.zrange('score:rank', 0, -1));

    // =========================
    // 6. 分布式锁(标准写法)
    // =========================
    const lockKey = 'lock:order:1001';
    const lockResult = await redis.set(lockKey, 'locked', 'NX', 'EX', 10);
    console.log('分布式锁:', lockResult ? '加锁成功' : '加锁失败');

  } catch (err) {
    console.error('执行异常:', err);
  }
}

// 运行
runRedisDemo();
2.3 redis 存数会话上下文
我们在控制台实现一个和大模型的对话agent,采用nodejs实现。
在一般的 ai agent 项目里面使用 redis 来存储会话的上下文。他的代码逻辑就是在invoke之前加载redis里面的缓存数据,然后在invoke拿到大模型的回复以后,将回复保存到redis里面。
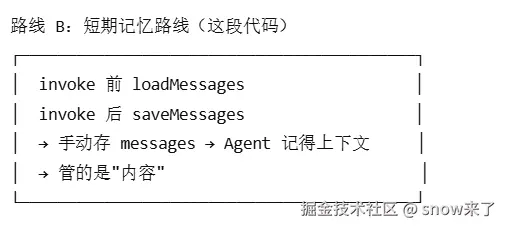
主要代码如下:
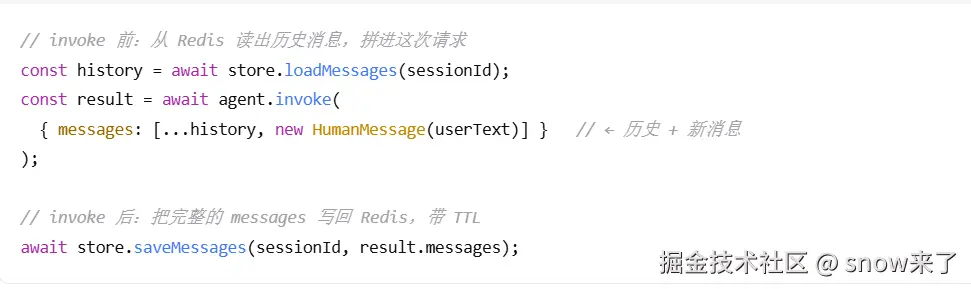
import { mapChatMessagesToStoredMessages, mapStoredMessagesToChatMessages, } from "@langchain/core/messages";是用来做message序列化的工具,
js
存进 Redis 时:
  HumanMessage 实例 ──mapChatMessagesToStoredMessages──→ 纯 JSON(可序列化)

从 Redis 读时:
  纯 JSON ──mapStoredMessagesToChatMessages──→ HumanMessage 实例(可喂给 Agent)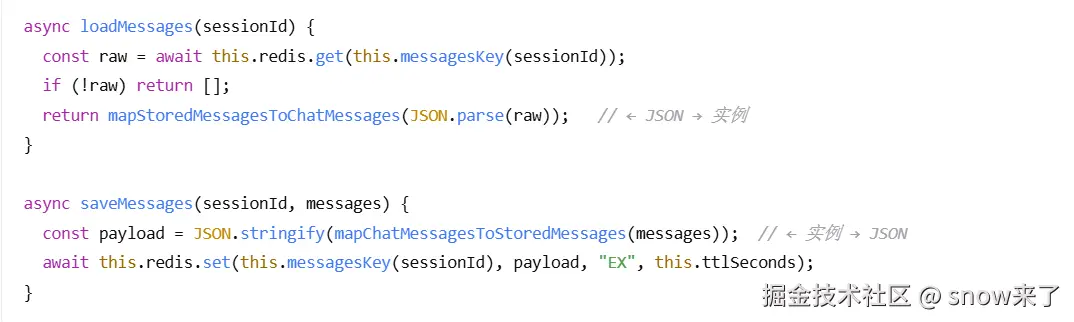
我们用import * as readline from "node:readline/promises"; import { stdin , stdout } from "node:process";实现在控制台上读取用户输入的问题和大模型输出的答案。模拟前端调用接口,拿到问题,返回答案的场景。
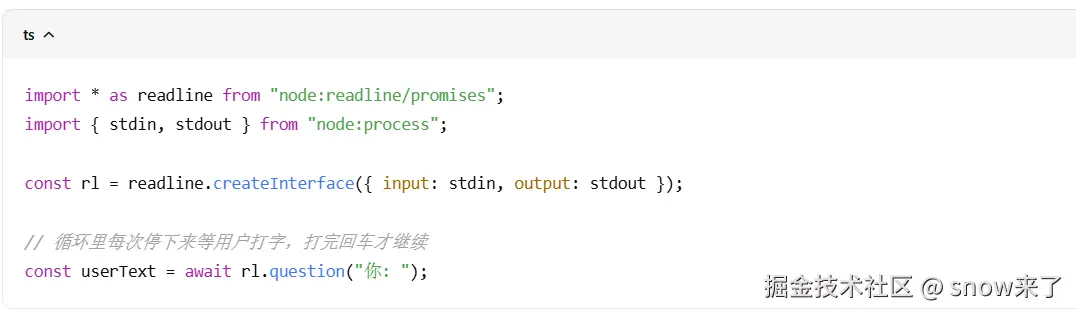
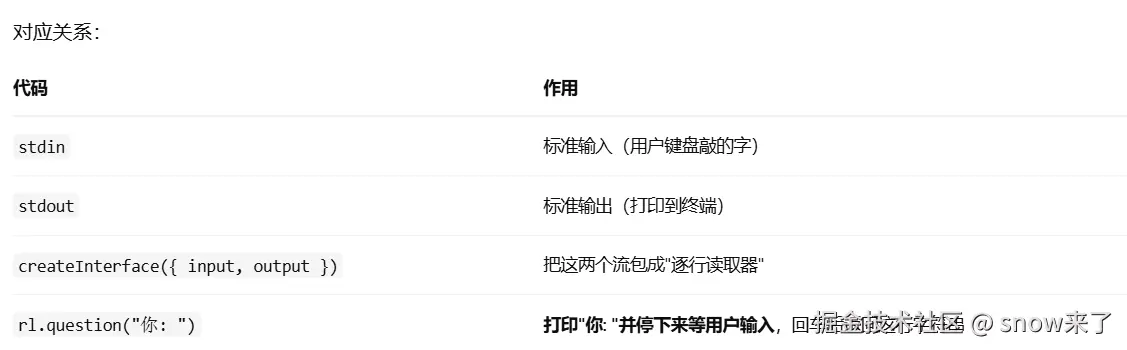
stdin 是键盘输入流,stdout 是屏幕输出流。 传给 readline.createInterface({ input: stdin, output: stdout }),就是告诉 readline:从键盘读、往屏幕写------于是你在终端里就能一行一行地和程序对话。
summarizationMiddleware` 是 `Agent` 的"记忆压缩器"------当对话消息累积太多时,自动把前面的内容总结成一段摘要,腾出空间,同时尽量不丢重要信息。----就是`总结
代码详情:
js
pnpm install @langchain/langgraph @langchain/openai deepagents dotenv langchain zod
js
/**
 * 基于 Redis 的 Agent 短期记忆
 *
 * 模式:
 * - invoke 前:从 Redis 读取该会话的 messages
 * - invoke 后:把 agent 返回的 messages 写回 Redis(带 TTL)
 * - 压缩:由 langchain summarizationMiddleware 在 agent 内部完成
 *
 * 前置:docker compose up -d redis
 *
 * 运行:node src/agent-with-redis-memory.mjs
 * 输入 exit / quit / :q 退出;:clear 清空当前会话记忆
 */
import "dotenv/config";
import Redis from "ioredis";
import * as readline from "node:readline/promises";
import { stdin , stdout } from "node:process";
import { ChatOpenAI } from "@langchain/openai";
import {
  mapChatMessagesToStoredMessages,
  mapStoredMessagesToChatMessages,
} from "@langchain/core/messages";
import { createAgent, HumanMessage, summarizationMiddleware } from "langchain";

const REDIS_HOST = process.env.REDIS_HOST ?? "localhost";
const REDIS_PORT = Number(process.env.REDIS_PORT ?? 6379);
const REDIS_DB = Number(process.env.REDIS_DB ?? 0);
const MEMORY_TTL = Number(process.env.MEMORY_TTL_SECONDS ?? 1800);
const KEY_PREFIX = process.env.MEMORY_KEY_PREFIX ?? "agent:short_memory";
const SESSION_ID = process.env.MEMORY_SESSION_ID ?? "demo_user_001";

const summaryPrompt = `你是对话摘要助手。请用中文总结以下对话,包含:
1. 讨论的主要话题
2. 用户提到的重要事实(姓名、偏好、日期等,务必保留原文信息)
3. 继续对话所需的关键上下文

保持简洁,不要编造,不要遗漏用户明确说过的信息。

待摘要的对话:
{messages}

摘要:`;

class RedisMessageStore {
  constructor({ redis, keyPrefix, ttlSeconds }) {
    this.redis = redis;
    this.keyPrefix = keyPrefix;
    this.ttlSeconds = ttlSeconds;
  }

  messagesKey(sessionId) {
    return `${this.keyPrefix}:${sessionId}:messages`;
  }

  async loadMessages(sessionId) {
    const raw = await this.redis.get(this.messagesKey(sessionId));
    if (!raw) return [];
    return mapStoredMessagesToChatMessages(JSON.parse(raw));
  }

  async saveMessages(sessionId, messages) {
    const payload = JSON.stringify(mapChatMessagesToStoredMessages(messages));
    await this.redis.set(this.messagesKey(sessionId), payload, "EX", this.ttlSeconds);
  }

  async clear(sessionId) {
    await this.redis.del(this.messagesKey(sessionId));
  }

  async ttl(sessionId) {
    return this.redis.ttl(this.messagesKey(sessionId));
  }
}

async function invokeWithMemory(agent, store, sessionId, userText) {
  const history = await store.loadMessages(sessionId);
  console.log(`  ↳ 从 Redis 加载 ${history.length} 条历史`);

  const result = await agent.invoke(
    { messages: [...history, new HumanMessage(userText)] },
    { recursionLimit: 30 },
  );

  await store.saveMessages(sessionId, result.messages);
  const ttl = await store.ttl(sessionId);
  console.log(`  ↳ 写回 Redis ${result.messages.length} 条 (TTL ${ttl}s)`);

  return result;
}

const redis = new Redis({ host: REDIS_HOST, port: REDIS_PORT, db: REDIS_DB });

redis.on("connect", () => console.log("✅ Redis 已连接"));
redis.on("error", (err) => console.error("❌ Redis 错误:", err.message));

const store = new RedisMessageStore({
  redis,
  keyPrefix: KEY_PREFIX,
  ttlSeconds: MEMORY_TTL,
});

const model = new ChatOpenAI({
  model: process.env.MODEL_NAME,
  apiKey: process.env.OPENAI_API_KEY,
  configuration: { baseURL: process.env.OPENAI_BASE_URL },
  temperature: 0,
});

const agent = createAgent({
  model,
  tools: [],
  systemPrompt:
    "你是会话助手。记住用户提到的关键事实,中文简短回答。若消息中有对话摘要,请据此继续对话。",
  middleware: [
    summarizationMiddleware({//总结压缩
      model,
      summaryPrompt,
      trigger: { messages: 8 },
      keep: { messages: 4 },
    }),
  ],
});

console.log("输入 exit / quit / :q 退出,:clear 清空记忆\n");

const rl = readline.createInterface({ input: stdin, output: stdout });
let prevCount = (await store.loadMessages(SESSION_ID)).length;

try {
  while (true) {
    const userText = (await rl.question("你: ")).trim();
    if (!userText) continue;

    if (["exit", "quit", ":q"].includes(userText.toLowerCase())) break;

    if (userText === ":clear") {
      await store.clear(SESSION_ID);
      prevCount = 0;
      console.log("已清空当前会话记忆\n");
      continue;
    }

    const { messages } = await invokeWithMemory(agent, store, SESSION_ID, userText);
    console.log("\n助手:", messages.at(-1)?.content);
    console.log(`当前消息数: ${messages.length}`);
    if (messages.length < prevCount + 2) {
      console.log("  ⚡ 已触发压缩");
    }
    prevCount = messages.length;
    console.log();
  }
} finally {
  rl.close();
}

await redis.quit();
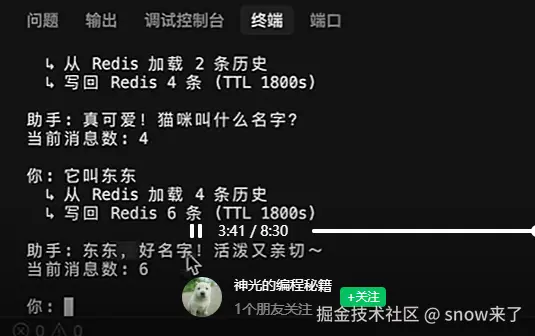
测试就是长这样的
2.4 redis 存储 langgraph 的状态
如果"存状态"指的是 LangGraph 图的运行状态(断点续跑),那确实只能用 Checkpointer------它是 LangGraph 内置的唯一机制。
但如果"存"指的是对话记忆(让 Agent 记住上下文),那不用 Checkpointer 也完全行,自己写 load/save 到 Redis 就行,你之前那份代码就是这么干的。
Checkpointer 是"图状态"的官方方案;"对话记忆"是另一条独立的线,可以自由选择存储方式。
Checkpoint 就是 LangGraph 每一步跑完的"存档快照"------存的是跑到哪了、手里有什么。崩了能续、人能介入、历史能回看。Checkpoint 存在 Redis 里,就能跨进程/跨服务实例共享------不管请求被分到哪个实例上,都能读到存档接着跑。
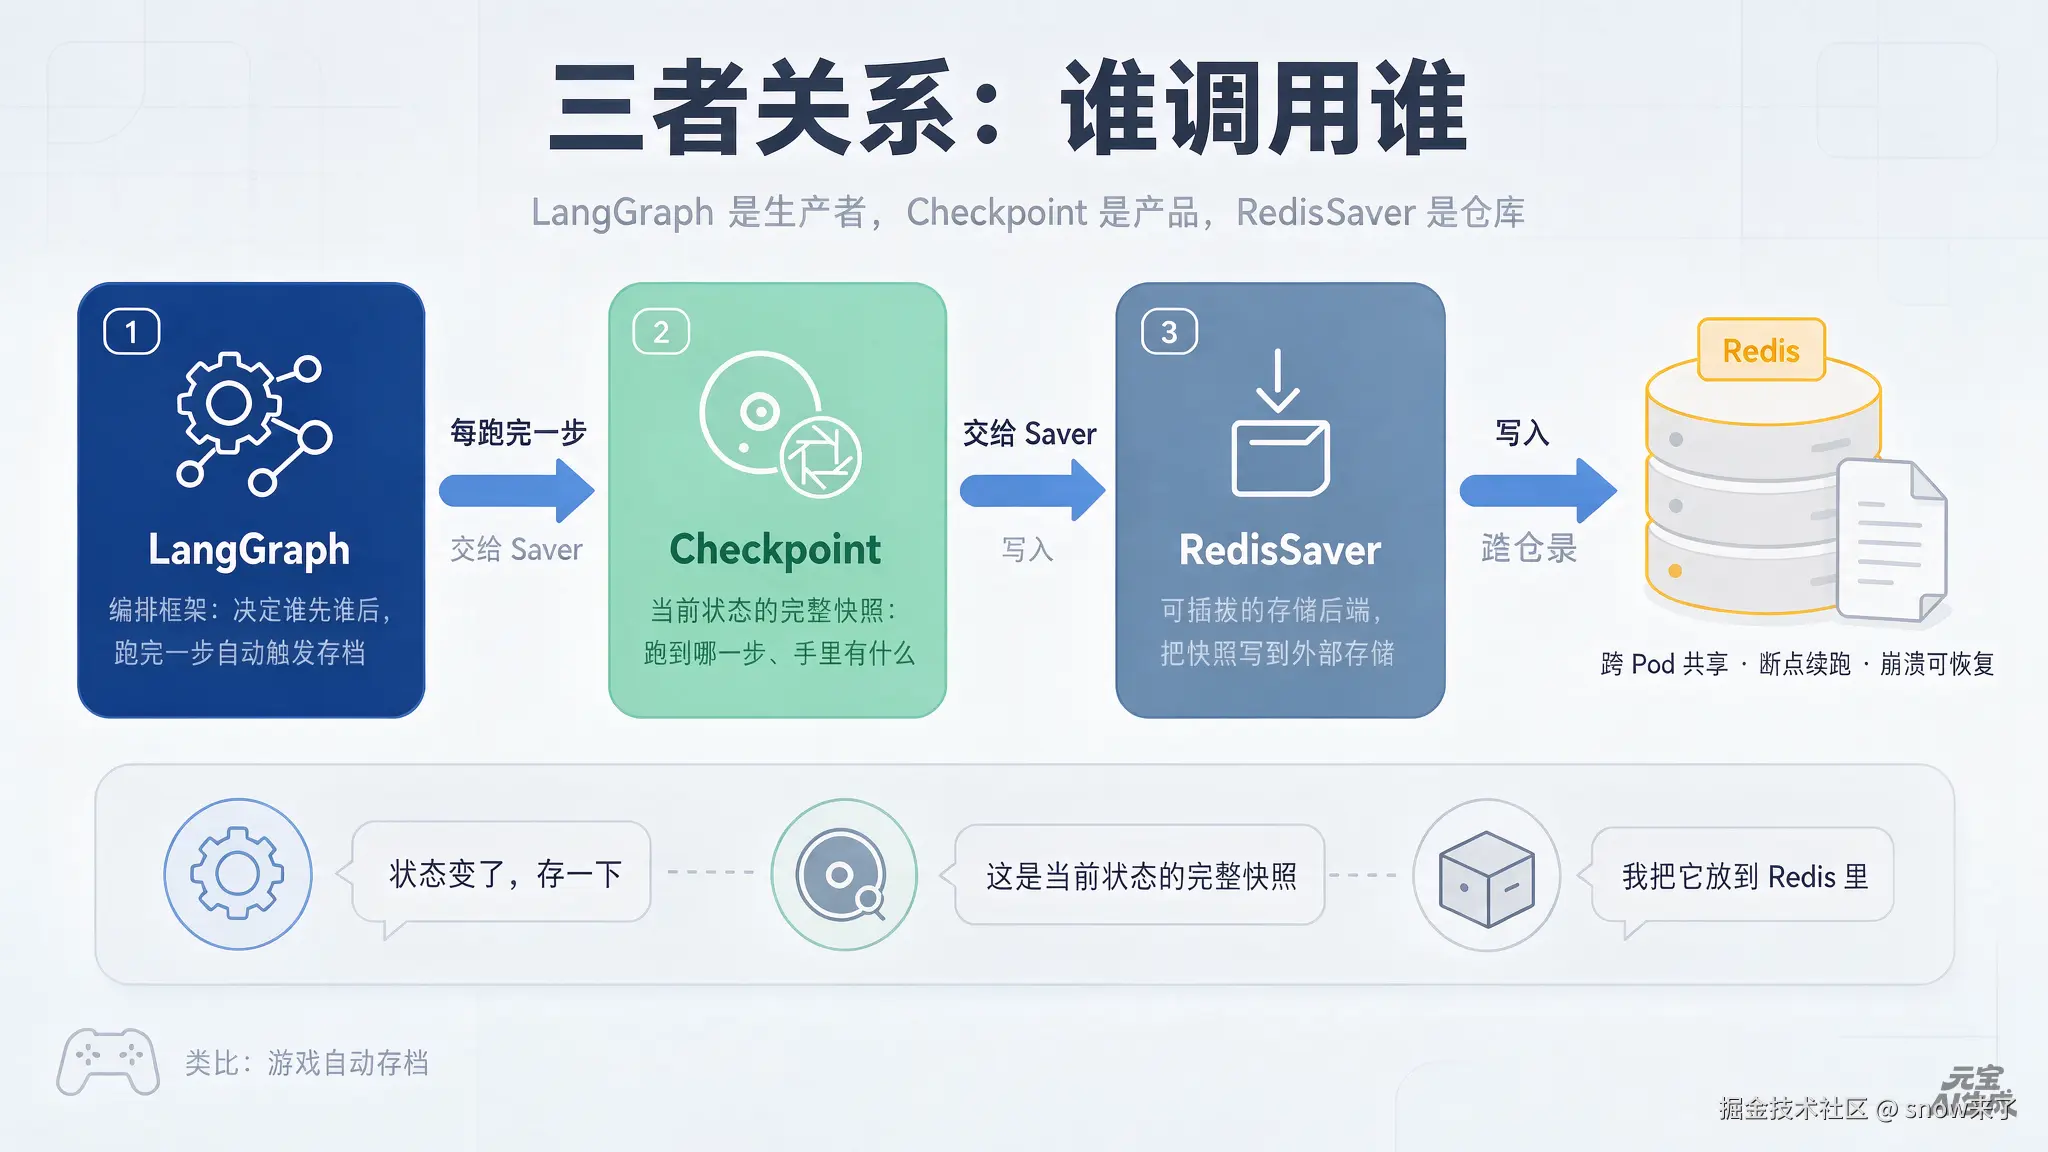
我们利用checkpointer是为了存储langgraph图的运行状态,如果你要是存储对话的上下文,你就可以不用checkpointer。
js
npm install @langchain/langgraph @langchain/core @langchain/langgraph-checkpoint-redis ioredis
js
import { StateGraph, Annotation, MemorySaver } from "@langchain/langgraph";
import { RedisSaver } from "@langchain/langgraph-checkpoint-redis";
import { Redis } from "ioredis";

// ── 1. 状态定义(决定 Checkpoint 里存什么)──────────────
const GraphState = Annotation.Root({
  messages: Annotation<string[]>({
    reducer: (left, right) => left.concat(right),
    default: () => [],
  }),
  step: Annotation<number>({
    reducer: (_left, right) => right,
    default: () => 0,
  }),
});

// ── 2. 节点:就是普通函数 ──────────────────────────────
const researchNode = async (state: typeof GraphState.State) => {
  return {
    step: state.step + 1,
    messages: [...state.messages, "调研完成:找到 3 个竞品"],
  };
};

const analyzeNode = async (state: typeof GraphState.State) => {
  return {
    step: state.step + 1,
    messages: [...state.messages, "分析完成:建议差异化定价"],
  };
};

// ── 3. 连图 ────────────────────────────────────────────
const builder = new StateGraph(GraphState)
  .addNode("research", researchNode)
  .addNode("analyze", analyzeNode)
  .addEdge("__start__", "research")
  .addEdge("research", "analyze")
  .addEdge("analyze", "__end__");

// ── 4. 关键:把 RedisSaver 注入进去 ─────────────────────
const redis = new Redis("redis://localhost:6379");

const saver = new RedisSaver({ client: redis });
await saver.setup();                     // 首次建索引,必须 await

const graph = builder.compile({ checkpointer: saver });

const config = { configurable: { thread_id: "user_123" } };

// 第一次:从头跑,两个节点都执行
const r1 = await graph.invoke(
  { messages: [], step: 0 },
  config
);
console.log(r1);
// { messages: ["调研完成...", "分析完成..."], step: 2 }

// 第二次:同 thread_id,自动从 Checkpoint 恢复
const r2 = await graph.invoke(
  { messages: ["再细化一下"], step: 2 },
  config
);
最关键的代码是
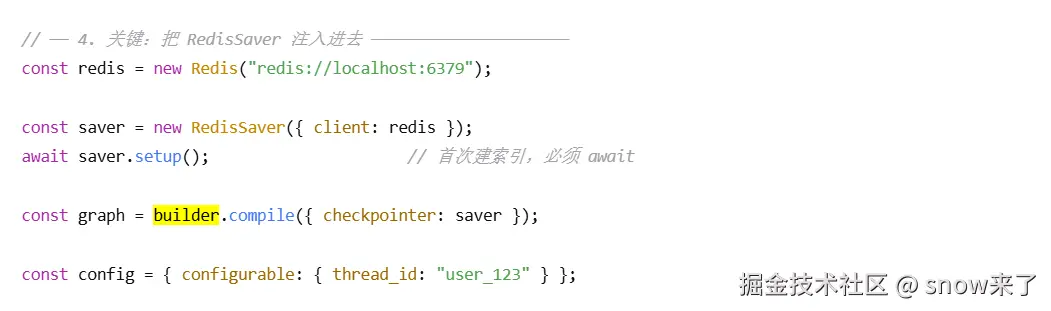
const graph = builder.compile({ checkpointer: saver }); 这句话将checkpoint ,langgraph,redis三者相连的关键代码。它每跑完一个节点,就把当前整个 state 序列化,交给这个 saver 去存储。
在正常的项目里面是这样设置的:
js
// 开发测试:存在内存里
const graph = builder.compile({ checkpointer: new MemorySaver() });

// 生产环境:存在 Redis 里
const graph = builder.compile({ checkpointer: saver });

// 要求强一致:换 PostgresSaver,图的逻辑一行不用改
new Redis(...)建立一条连到本地6379端口Redis的网络连接。new RedisSaver({ client: redis })创建一个存档器,它知道"Checkpoint怎么序列化、怎么读写",并借用第一步的redis客户端去实际操作Redis。await saver.setup()让RedisSaver在Redis里把存档所需的索引结构建好(首次部署跑一次即可)。builder.compile({ checkpointer: saver })把存档器注入到图的运行时里,告诉LangGraph:每跑完一个节点,就把当前状态的快照通过saver 写进 Redis。{ thread_id: "user_123" }是这条对话的存档编号,作为Redis里的key------同一个thread_id下次调用时能读出存档、从断点继续;换个thread_id就是一条全新的对话。
说白了就是:
redis(客户端)负责"连",RedisSaver(存档器)负责"怎么存",setup() 在 Redis里"建好存放的架子",compile()让LangGraph"跑完就往里放"。