Linux 系统------进程概念
1. 冯·诺依曼体系结构
常见的计算机设备,如笔记本电脑与服务器,大多遵循冯·诺依曼体系结构。

迄今为止,我们所认知的计算机均由若干硬件组件构成:
- 输入单元:键盘、鼠标、扫描仪、手写板等
- 中央处理器(CPU):运算器与控制器等
- 输出单元:显示器、打印机等
关于冯·诺依曼体系结构的核心要点:
- 此处所提及的"存储器"指的是内存(主存储器)
- 在不考虑缓存的情况下,CPU 仅能对内存进行读写操作,无法直接访问外设(输入设备或输出设备)(从数据层面而言)
- 外设(输入设备或输出设备)进行数据的输入或输出操作时,亦只能写入内存或从内存中读取数据
- 即所有设备均只能直接与内存进行交互

体系结构的效率由"拷贝"效率决定。
注意:
对冯·诺依曼体系结构的理解不应仅停留在概念层面,而应深入至对软件数据流的理解(例如:通过即时通讯软件与好友聊天时,数据的完整流动过程)。
2. 操作系统(Operating System)
2.1 概念
任何计算机系统都包含一个基本的程序集合,称为操作系统(OS)。从广义上理解,操作系统包含以下内容:
- 内核:进程管理、内存管理、文件管理、驱动管理
- 其他程序:例如函数库、Shell 程序等

2.2 设计操作系统的目的
- 对下:与硬件交互,管理所有的软硬件资源
- 对上:为用户程序(应用程序)提供一个良好的执行环境

2.3 功能定位
- 在整个计算机软硬件架构中,操作系统的定位是:一种专门用于管理的软件
2.4 如何理解"管理"
- 管理示例:学生、辅导员、校长之间的关系
- 描述被管理的对象
- 组织被管理的对象

总结
计算机对硬件进行管理:
- 描述时,使用 struct 结构体
- 组织时,使用链表或其他高效数据结构
2.5 系统调用和库函数概念

- 从开发角度而言,操作系统对外表现为一个整体,但会暴露部分接口供上层应用调用,由操作系统提供的此类接口称为系统调用
- 系统调用的功能较为基础,使用门槛相对较高。开发者可对部分系统调用进行封装以形成库函数,从而便于上层用户或开发者进行二次开发
操作系统如何进行进程管理?
首先描述进程,随后组织进程。
3. 进程
3.1 基本概念与基本操作
- 传统定义:程序的一个执行实例,即正在执行的程序
- 内核观点:作为分配系统资源(CPU 时间、内存)的实体
- 当前观点:进程 = 内核数据结构(task_struct)+ 该进程自身的程序代码与数据
3.1.1 描述进程------PCB
基本概念
- 进程信息被存放于一个称为进程控制块(Process Control Block,PCB)的数据结构中,可视为进程属性的集合
- 在 Linux 操作系统中,PCB 的具体实现为 task_struct
task_struct------PCB 的一种实现
- Linux 中用于描述进程的结构体名为 task_struct
- task_struct 是 Linux 内核的一种数据结构,被装载至 RAM(内存)中,并包含进程的相关信息
3.1.2 task_struct
内容分类
- 标识符:标识本进程的唯一标识符,用于区分其他进程
- 状态:任务状态、退出代码及退出信号等
- 优先级:相对于其他进程的优先级
- 程序计数器:程序即将执行的下一条指令地址
- 内存指针:包括程序代码和进程相关数据的指针,以及与其他进程共享的内存块指针
- 上下文数据:进程执行时处理器寄存器中的数据(示例见 CPU 寄存器图)
- I/O 状态信息:包括已提交的 I/O 请求、分配给进程的 I/O 设备以及进程所使用的文件列表
- 记账信息:可能包含处理器时间总计、时钟数总计、时间限制、记账账号等
- 其他信息
组织进程
可在内核源代码中查阅。系统中所有运行进程均以 task_struct 双链表形式存在于内核中。

3.1.3 查看进程
1. 进程的信息可以通过 /proc 系统文件夹查看
例如:获取 PID 为 1 的进程信息,需查看 /proc/1 目录。

2. 多数进程信息亦可使用 top 和 ps 等用户级工具获取
示例代码------创建一个持续运行的进程以便观察:
cpp
#include <stdio.h>
#include <sys/types.h>
#include <unistd.h>

int main(void) {
    while (1) {
        sleep(1);  /* 进程休眠1秒,循环执行以维持进程运行状态 */
    }
    return 0;
}
3.1.4 通过系统调用获取进程标识符
- 进程 ID(PID)
- 父进程 ID(PPID)
cpp
#include <stdio.h>
#include <sys/types.h>
#include <unistd.h>

int main(void) {
    printf("pid:%d\n", getpid());    /* 获取并打印当前进程的进程ID */
    printf("ppid:%d\n", getppid());  /* 获取并打印当前进程的父进程ID */
    return 0;
}
3.1.5 通过系统调用创建进程------fork
- 执行 man fork 查阅 fork 相关文档
- fork 有两个返回值
- 父子进程代码共享,数据各自开辟独立空间(采用写时拷贝机制)
cpp
#include <stdio.h>
#include <sys/types.h>
#include <unistd.h>

int main(void) {
    int ret = fork();                          /* 创建子进程 */
    printf("hello proc:%d,ret:%d\n", getpid(), ret);  /* 父子进程均执行此句 */
    sleep(1);
    return 0;
}- fork 调用后通常需使用 if 进行分支判断
cpp
#include <stdio.h>
#include <sys/types.h>
#include <unistd.h>

int main(void) {
    int ret = fork();                          /* 创建子进程 */

    if (ret < 0) {                             /* fork调用失败 */
        perror("fork");
        return 1;
    } else if (ret == 0) {                     /* 子进程分支 */
        printf("I am child:%d,ret:%d\n", getpid(), ret);
    } else {                                   /* 父进程分支 */
        printf("I am father:%d,ret:%d\n", getpid(), ret);
        sleep(1);
        return 0;
    }
}
3.2 进程状态

3.2.1 Linux 内核源代码中的进程状态
为理解进程的运行状态,需了解进程的不同状态。进程存在多种状态(在 Linux 内核中,进程亦称为任务)。
以下状态定义于内核源代码中:
cpp
/*
 * 任务状态数组是一个特殊的"位图",用于表示进程睡眠的原因。
 * 因此"running"(运行状态)的值为零,
 * 可以通过简单的位运算测试其他状态的组合。
 */
static const char *const task_state_array[] = {
    "R (running)",    /* 0 */
    "S (sleeping)",   /* 1 */
    "D (disk sleep)", /* 2 */
    "T (stopped)",    /* 4 */
    "t (tracing stop)"," /* 8 */
    "X (dead)",       /* 16 */
    "Z (zombie)",     /* 32 */
};
- R 运行状态(running):并不意味着进程一定正在 CPU 上运行,而是表示进程要么处于运行状态,要么处于运行队列中等待调度
- S 睡眠状态(sleeping):表示进程正在等待某个事件完成(此种睡眠状态亦称为可中断睡眠,interruptible sleep)
- D 磁盘休眠状态(disk sleep):亦称为不可中断睡眠状态(uninterruptible sleep),处于该状态的进程通常正在等待 I/O 操作完成
- T 停止状态(stopped):可通过向进程发送 SIGSTOP 信号来暂停进程。已暂停的进程可通过接收 SIGCONT 信号恢复运行
- X 死亡状态(dead):该状态仅表示进程已终止,不会出现在任务列表中
3.2.2 进程状态查看
ps aux 与 ps axj 命令
- a:显示当前终端上所有用户的所有进程(包括其他用户的进程)
- x:显示无控制终端的进程,例如后台运行的守护进程
- j:显示进程所属的进程组 ID、会话 ID、父进程 ID 以及与作业控制相关的信息
- u:以用户视角显示进程信息,提供进程的详细信息,包括用户、CPU 及内存使用情况等

3.2.3 Z(zombie)------僵尸进程
- 僵尸状态(Zombie) 是一种特殊状态。当进程终止而父进程未读取子进程退出状态码时,将产生僵尸进程
- 僵尸进程将以终止状态保留在进程表中,并持续等待父进程读取退出状态码
- 因此,当子进程终止而父进程仍在运行且未读取子进程状态时,子进程将进入 Z 状态
创建僵尸进程示例:
cpp
#include <stdio.h>
#include <stdlib.h>

int main(void) {
    pid_t id = fork();

    if (id < 0) {                    /* fork调用失败 */
        perror("fork");
        return 1;
    } else if (id > 0) {             /* 父进程分支 */
        printf("parent[%d] is sleeping...\n", getpid());
        sleep(30);                   /* 父进程休眠30秒,来不及回收子进程 */
    } else {                         /* 子进程分支 */
        printf("child[%d] is entering Z state...\n", getpid());
        sleep(5);
        exit(EXIT_SUCCESS);          /* 子进程终止,进入僵尸状态 */
    }

    return 0;
}
编译后于另一终端进行监控。

监控结果:

结果:

3.2.4 僵尸进程的危害
- 进程的退出状态必须予以保留,因其需向父进程汇报任务执行结果。若父进程持续不读取,子进程将长期处于 Z 状态
- 维护退出状态本身即需要占用数据结构,亦属于进程基本信息,故保存于 task_struct(PCB)中。换言之,若进程长期处于 Z 状态,PCB 将始终占用系统资源
- 若父进程创建大量子进程却不回收,将导致内存资源浪费。因数据结构对象本身即占用内存,如同 C 语言中定义结构体变量需在内存中开辟空间
- 从而导致内存泄露
3.2.5 孤儿进程
- 若父进程提前退出而子进程后退出并进入 Z 状态,应如何处理?
- 父进程先退出时,子进程称为孤儿进程
- 孤儿进程将被 1 号 init/systemd 进程收养,并由其回收
cpp
#include <stdio.h>
#include <unistd.h>
#include <stdlib.h>

int main(void) {
    pid_t id = fork();

    if (id < 0) {                    /* fork调用失败 */
        perror("fork");
        return 1;
    } else if (id == 0) {            /* 子进程分支 */
        printf("I am child, pid: %d\n", getpid());
        sleep(10);                   /* 子进程休眠,父进程已退出 */
    } else {                         /* 父进程分支 */
        printf("I am parent, pid: %d\n", getpid());
        sleep(3);
        exit(0);                     /* 父进程先退出 */
    }

    return 0;
}
3.3 进程优先级
3.3.1 基本概念
- CPU 资源的分配顺序即为进程优先级(priority)
- 优先级较高的进程享有优先执行权。合理配置进程优先级对多任务 Linux 系统具有重要作用,可有效改善系统性能
- 亦可将进程绑定至指定 CPU,将非关键进程调度至特定 CPU,从而显著改善系统性能
3.3.2 查看系统进程
在 Linux 或 Unix 系统中,执行 ps -l 命令将输出以下内容:

其中:
- UID:执行者身份
- PID:进程标识符
- PPID:该进程的父进程标识符(即该进程由哪个进程衍生而来)
- PRI:该进程的可执行优先级,值越小优先级越高
- NI:该进程的 nice 值
3.3.3 PRI 与 NI
- PRI 即进程优先级,表示程序被 CPU 执行的先后顺序,此值越小进程优先级越高
- NI 即 nice 值,表示进程可被执行的优先级的修正数值
- PRI 值越小越先被执行。引入 nice 值后,PRI 的计算公式为:PRI(new) = PRI(默认值 80) + nice
- 当 nice 值为负值时,进程优先级值减小,优先级升高,越先被执行
- 因此,在 Linux 下调整进程优先级即为调整进程 nice 值
- nice 的取值范围为 -20, 19,共 40 个级别
3.3.4 PRI 与 NI 的区别
- 进程的 nice 值并非进程优先级本身,二者并非同一概念,但 nice 值会影响进程优先级的计算结果
- nice 值为进程优先级的修正参数
3.3.5 查看进程优先级的命令
用 top 命令更改已存在进程的 nice:
- 执行 top
- 进入后按"r" → 输入进程 PID → 输入 nice 值
注意:
- 其它调整优先级的命令:nice(用于未运行的进程)、renice(用于正在运行的进程)
- 系统函数:
cpp
#include <sys/time.h>
#include <sys/resource.h>

int getpriority(int which, int who);   /* 获取指定进程或进程组的优先级 */
int setpriority(int which, int who, int prio);  /* 设置指定进程或进程组的优先级 */
3.3.6 竞争、独立、并行、并发
- 竞争性:系统进程数目众多,而 CPU 资源有限,甚至仅有一个,因此进程之间具有竞争关系。为提高任务执行效率并合理竞争资源,引入了优先级机制
- 独立性:多进程运行需独享各类资源,各进程运行期间互不干扰
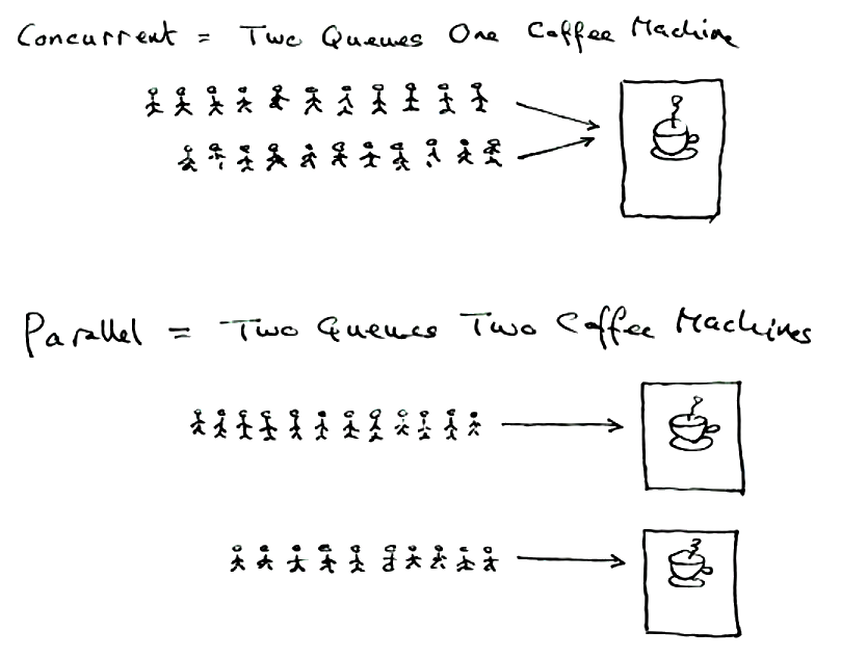
- 并行:多个进程在多个 CPU 上同时执行
- 并发 :多个进程在一个 CPU 下采用进程切换的方式,在一段时间之内,让多个进程都得以推进
3.4 进程切换
CPU 上下文切换:其实际含义是任务切换,或 CPU 寄存器切换。当多任务内核决定运行另外的任务时,它保存正在运行任务的当前状态,即 CPU 寄存器中的全部内容。这些内容被保存在任务自己的堆栈中,入栈工作完成后就把下一个将要运行的任务的当前状况从该任务的栈中重新装入 CPU 寄存器,并开始下一个任务的运行,这个过程就是 context switch。

参考 Linux 内核 0.11 相关代码。

注意:
时间片:现代计算机均为分时操作系统,每个进程均分配有相应的时间片(实质上即为一个计数器)。时间片耗尽后,操作系统将该进程从 CPU 中撤下。
3.5 Linux 2.6 内核进程 O(1) 调度队列

上图是 Linux 2.6 内核中进程队列的数据结构。
3.5.1 一个 CPU 拥有一个 runqueue
若存在多个 CPU,则需考虑进程负载均衡问题。
3.5.2 优先级
- 普通优先级:100~139(与 nice 值的取值范围对应)
- 实时优先级:0~99
3.5.3 活动队列
- 时间片尚未耗尽的所有进程按优先级存放于该队列
- nr_active:运行状态进程的总数
- queue140:每个元素对应一个进程队列,相同优先级的进程按照 FIFO 规则排队调度,数组下标即对应优先级
- 从该结构中选取最优进程的过程如下:
- 从 0 下标开始遍历 queue140
- 查找第一个非空队列,该队列即为优先级最高的队列
- 选取该队列首进程开始运行,调度完成
- 遍历 queue140 的时间复杂度为常数,但效率仍然较低
- bitmap5:共 140 个优先级,对应 140 个进程队列。为提高非空队列的查找效率,可采用 5 x 32 个比特位表示队列的空闲状态,从而显著提升查找效率

3.5.4 过期队列
- 过期队列与活动队列结构相同
- 过期队列中存放的均为时间片耗尽的进程
- 当活动队列中的所有进程均处理完毕后,对过期队列中的进程重新分配时间片
3.5.5 active 指针和 expired 指针
- active 指针永远指向活动队列
- expired 指针永远指向过期队列
- 随着进程执行,活动队列中的进程逐渐减少,过期队列中的进程逐渐增多,因进程时间片到期后转入过期队列
- 在适当时机,只需交换 active 指针与 expired 指针的指向,即可实现一批新活动进程的切换
3.5.6 总结
在系统中查找最优调度进程的时间复杂度为常数,不随进程数量增加而线性增长,此即进程调度 O(1) 算法。
cpp
/* 运行队列结构体定义 */
struct rq {
    spinlock_t lock;

    /*
     * nr_running 和 cpu_load 应位于同一缓存行中,
     * 因为远程 CPU 在进行负载计算时会同时使用这两个字段。
     */
    unsigned long nr_running;
    unsigned long raw_weighted_load;

#ifdef CONFIG_SMP
    unsigned long cpu_load[3];
#endif

    unsigned long long nr_switches;

    /*
     * 此为全局计数器的一部分,仅所有 CPU 的总和具有意义。
     * 任务可以在一个 CPU 上增加此计数器,
     * 若之后发生迁移,则可能在另一个 CPU 上减少它。
     * 始终在运行队列锁的保护下进行更新。
     */
    unsigned long nr_uninterruptible;
    unsigned long expired_timestamp;
    unsigned long long timestamp_last_tick;

    struct task_struct *curr, *idle;
    struct mm_struct *prev_mm;
    struct prio_array *active, *expired, arrays[2];
    int best_expired_prio;
    atomic_t nr_iowait;

#ifdef CONFIG_SMP
    struct sched_domain *sd;
    /* 用于主动负载均衡 */
    int active_balance;
    int push_cpu;
    struct task_struct *migration_thread;
    struct list_head migration_queue;
#endif

#ifdef CONFIG_SCHEDSTATS
    /* 延迟统计 */
    struct sched_info rq_sched_info;
    /* sys_sched_yield() 统计 */
    unsigned long yld_exp_empty;
    unsigned long yld_act_empty;
    unsigned long yld_both_empty;
    unsigned long yld_cnt;
    /* schedule() 统计 */
    unsigned long sched_switch;
    unsigned long sched_cnt;
    unsigned long sched_goidle;
    /* try_to_wake_up() 统计 */
    unsigned long ttwu_cnt;
    unsigned long ttwu_local;
#endif

    struct lock_class_key rq_lock_key;
};

/* 运行队列数据结构 */
struct prio_array {
    unsigned int nr_active;
    DECLARE_BITMAP(bitmap, MAX_PRIO + 1);  /* 包含1位分隔符 */
    struct list_head queue[MAX_PRIO];
};
4. 命令行参数和环境变量
4.1 基本概念
- 环境变量(environment variables)是指操作系统中用于指定运行环境的一系列参数
- 例如:在编写 C/C++ 代码时,链接阶段通常无需指定动态库或静态库的路径,仍可成功链接并生成可执行程序,其原因在于相关环境变量协助编译器完成路径查找
- 环境变量通常具有特定用途,且在系统中通常具有全局属性
4.2 常见环境变量
- PATH:指定命令的搜索路径
- HOME:指定用户主目录(即用户登录 Linux 系统后的默认工作目录)
- SHELL:当前 Shell,其值通常为 /bin/bash
4.3 查看环境变量方法
执行 echo $HOSTNAME(HOSTNAME:本机主机名)
测试 PATH
-
创建 code.c 文件
cpp#include <stdio.h> int main(void) { printf("hello world!\n"); return 0; } -
对比执行 ./hello 与 hello
-
部分指令可直接执行而无需指定路径,用户编译的二进制程序却需指定完整路径,其原因何在
-
将程序所在路径添加至环境变量 PATH:export PATH=$PATH:hello 所在路径
-
对比测试
4.4 与环境变量相关的命令
- echo:显示指定环境变量值
- export:设置新环境变量
- env:显示全部环境变量
- unset:清除指定环境变量
- set:显示本地定义的 Shell 变量及环境变量
4.5 环境变量的组织方式
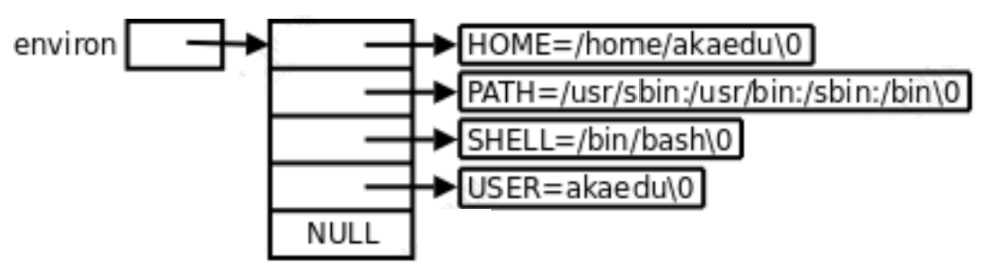
每个进程均接收一张环境表。环境表为字符指针数组,每个指针指向一个以 '\0' 结尾的环境字符串。
4.6 通过代码获取环境变量的方法(不推荐)
方法一:命令行第三个参数
cpp
#include <stdio.h>

int main(int argc, char *argv[], char *env[]) {
    for (int i = 0; env[i] != NULL; i++) {
        printf("%s\n", env[i]);  /* 打印第i个环境变量字符串 */
    }
    return 0;
}
方法二:通过第三方变量 environ 获取
cpp
#include <stdio.h>

int main(int argc, char *argv[]) {
    extern char **environ;  /* 声明外部全局变量environ */

    for (int i = 0; environ[i] != NULL; i++) {
        printf("%s\n", environ[i]);  /* 打印第i个环境变量字符串 */
    }
    return 0;
}
libc 中定义的全局变量 environ 指向环境变量表。environ 未在任何头文件中声明,因此使用时需使用 extern 声明。
4.7 通过系统调用获取或设置环境变量(推荐)
- putenv
- getenv
cpp
#include <stdio.h>
#include <stdlib.h>

int main(void) {
    printf("%s\n", getenv("PATH"));  /* 获取并打印PATH环境变量的值 */
    return 0;
}
常用 getenv 与 putenv 函数获取特定环境变量。
4.8 环境变量通常是具有全局属性的
-
环境变量通常具有全局属性,可被子进程继承
cpp#include <stdio.h> #include <stdlib.h> int main(void) { char *env = getenv("MYENV"); /* 获取MYENV环境变量的值 */ if (env) { printf("%s\n", env); /* 若存在则打印 */ } return 0; }
直接执行查看,无输出结果,说明该环境变量尚未定义。
- 导出环境变量:export MYENV="hello world"
- 再次运行程序,可获取到结果。表明环境变量可被子进程继承。
5. 程序地址空间
5.1 研究平台
- kernel 2.6.32
- 32 位平台
5.2 程序地址空间回顾
在学习 C/C++ 等语言时,通常会接触到如下内存布局图。
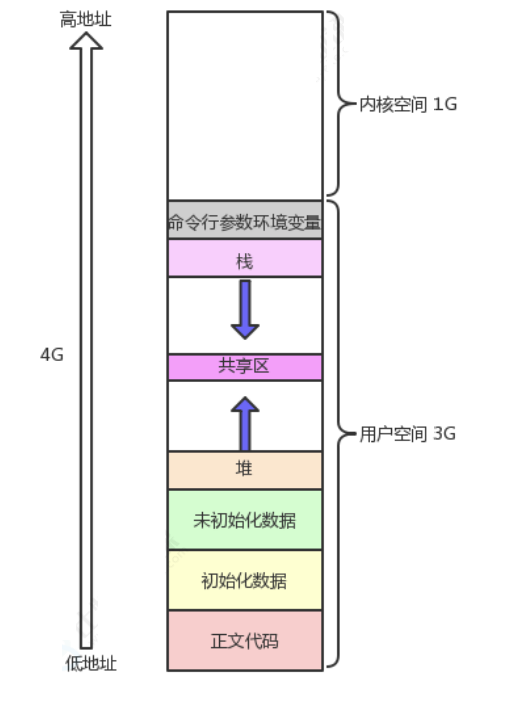
可通过以下代码进行验证:
cpp
#include <stdio.h>
#include <unistd.h>
#include <stdlib.h>

int g_unval;                    /* 未初始化的全局变量(BSS段) */
int g_val = 100;                /* 已初始化的全局变量(数据段) */

int main(int argc, char *argv[], char *env[]) {
    const char *str = "helloworld";  /* 字符串常量(只读数据段) */

    printf("code addr: %p\n", main);           /* 代码段地址 */
    printf("init global addr: %p\n", &g_val);   /* 已初始化全局变量地址 */
    printf("uninit global addr: %p\n", &g_unval); /* 未初始化全局变量地址 */

    static int test = 10;           /* 静态初始化变量(数据段) */

    char *heap_mem = (char *)malloc(10);    /* 堆内存分配 */
    char *heap_mem1 = (char *)malloc(10);
    char *heap_mem2 = (char *)malloc(10);
    char *heap_mem3 = (char *)malloc(10);

    printf("heap addr: %p\n", heap_mem);     /* 堆内存地址(1) */
    printf("heap addr: %p\n", heap_mem1);    /* 堆内存地址(2) */
    printf("heap addr: %p\n", heap_mem2);    /* 堆内存地址(3) */
    printf("heap addr: %p\n", heap_mem3);    /* 堆内存地址(4) */

    printf("test static addr: %p\n", &test); /* 静态变量地址 */
    printf("stack addr: %p\n", &heap_mem);   /* 栈地址(1) */
    printf("stack addr: %p\n", &heap_mem1);  /* 栈地址(2) */
    printf("stack addr: %p\n", &heap_mem2);  /* 栈地址(3) */
    printf("stack addr: %p\n", &heap_mem3);  /* 栈地址(4) */

    printf("read only string addr: %p\n", str);  /* 只读字符串地址 */

    for (int i = 0; i < argc; i++) {
        printf("argv[%d]: %p\n", i, argv[i]);  /* 命令行参数地址 */
    }

    for (int i = 0; env[i] != NULL; i++) {
        printf("env[%d]: %p\n", i, env[i]);    /* 环境变量地址 */
    }

    return 0;
}
运行结果:
$ ./a.out
code addr: 0x40055d
init global addr: 0x601034
uninit global addr: 0x601040
heap addr: 0x1791010
heap addr: 0x1791030
heap addr: 0x1791050
heap addr: 0x1791070
test static addr: 0x601038
stack addr: 0x7ffd0f9a4368
stack addr: 0x7ffd0f9a4360
stack addr: 0x7ffd0f9a4358
stack addr: 0x7ffd0f9a4350
read only string addr: 0x400800
argv[0]: 0x7ffd0f9a4811
env[0]: 0x7ffd0f9a4819
env[1]: 0x7ffd0f9a482e
env[2]: 0x7ffd0f9a4845
env[3]: 0x7ffd0f9a4850
env[4]: 0x7ffd0f9a4860
env[5]: 0x7ffd0f9a486e
env[6]: 0x7ffd0f9a4892
env[7]: 0x7ffd0f9a48a5
env[8]: 0x7ffd0f9a48ae
env[9]: 0x7ffd0f9a48f1
env[10]: 0x7ffd0f9a4e8d
env[11]: 0x7ffd0f9a4ea6
env[12]: 0x7ffd0f9a4f00
env[13]: 0x7ffd0f9a4f13
env[14]: 0x7ffd0f9a4f24
env[15]: 0x7ffd0f9a4f3b
env[16]: 0x7ffd0f9a4f43
env[17]: 0x7ffd0f9a4f52
env[18]: 0x7ffd0f9a4f5e
env[19]: 0x7ffd0f9a4f93
env[20]: 0x7ffd0f9a4fb6
env[21]: 0x7ffd0f9a4fd5
env[22]: 0x7ffd0f9a4fdf
5.3 虚拟地址
代码验证:
cpp
#include <stdio.h>
#include <unistd.h>
#include <stdlib.h>

int g_val = 0;

int main(void) {
    pid_t id = fork();

    if (id < 0) {
        perror("fork");
        return 0;
    } else if (id == 0) {  /* 子进程 */
        printf("child[%d]: %d : %p\n", getpid(), g_val, &g_val);
    } else {               /* 父进程 */
        printf("parent[%d]: %d : %p\n", getpid(), g_val, &g_val);
    }

    sleep(1);
    return 0;
}
输出:
// 输出结果因运行环境而异,仅供参考
parent2995: 0 : 0x80497d8
child2996: 0 : 0x80497d8
可见,输出的变量值与地址完全一致。
由于子进程以父进程为模板创建,父子进程均未对变量进行修改。
修改代码后:
cpp
#include <stdio.h>
#include <unistd.h>
#include <stdlib.h>

int g_val = 0;

int main(void) {
    pid_t id = fork();

    if (id < 0) {
        perror("fork");
        return 0;
    } else if (id == 0) {  /* 子进程 */
        g_val = 100;                            /* 子进程修改变量值 */
        printf("child[%d]: %d : %p\n", getpid(), g_val, &g_val);
    } else {               /* 父进程 */
        sleep(3);                                 /* 父进程等待子进程先执行 */
        printf("parent[%d]: %d : %p\n", getpid(), g_val, &g_val);
    }

    sleep(1);
    return 0;
}
输出结果:
// 输出结果因运行环境而异,仅供参考
child3046: 100 : 0x80497e8
parent3045: 0 : 0x80497e8
可见,父子进程输出地址一致,但变量内容不同。由此可得如下结论:
- 变量内容不同,说明父子进程所访问的并非同一变量; 地址值相同,说明该地址并非物理地址
- 在 Linux 系统中,这种地址叫做虚拟地址;在 C/C++ 程序中可见的地址均为虚拟地址。
物理地址对用户不可见,由操作系统统一管理。操作系统负责将虚拟地址 转化成物理地址。
5.4 进程地址空间
分页与虚拟地址空间
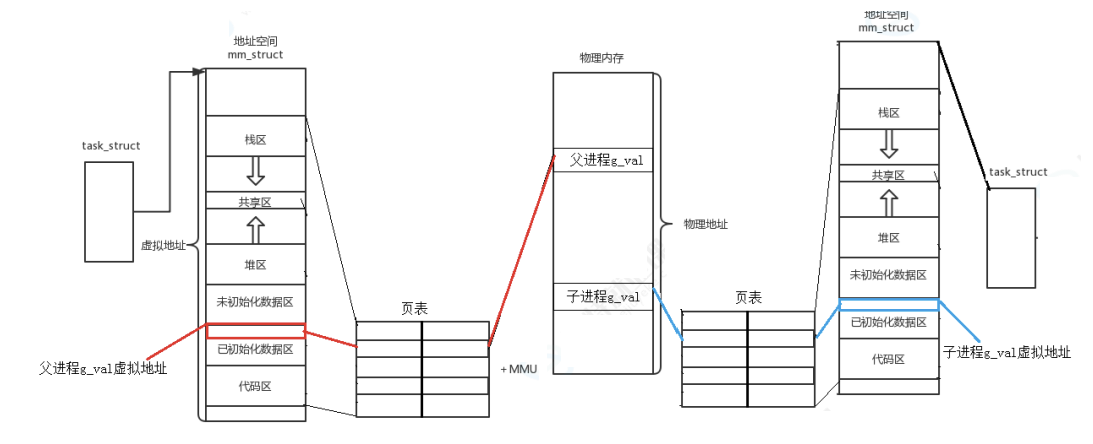
说明:
- 由上图可知,同一变量地址相同,实为虚拟地址相同;内容不同则因被映射至不同物理地址
5.5 虚拟地址内存管理
描述 Linux 下进程的地址空间的所有信息的结构体是 mm_struct(内存描述符)。每个进程只有一个 mm_struct 结构,在每个进程的 task_struct 结构中,有一个指向该进程的 mm_struct 结构体指针。
cpp
struct task_struct {
    /* ... */
    struct mm_struct *mm;
    /* 对于普通用户进程,该字段指向其虚拟地址空间的用户空间部分;
     * 对于内核线程,该部分为 NULL。 */

    struct mm_struct *active_mm;
    /* 该字段是内核线程使用的。当该进程是内核线程时,
     * 它的 mm 字段为 NULL,表示没有内存地址空间。
     * 实际上并非真正的没有,因为所有进程关于内核的映射都是一样的,
     * 内核线程可以使用任意进程的地址空间。 */
    /* ... */
};换言之,mm_struct 结构用于描述完整的用户空间。每个进程均拥有独立的 mm_struct,从而确保各进程拥有独立的地址空间,互不干扰。下图展示了从 task_struct 到 mm_struct 的进程地址空间分布情况:
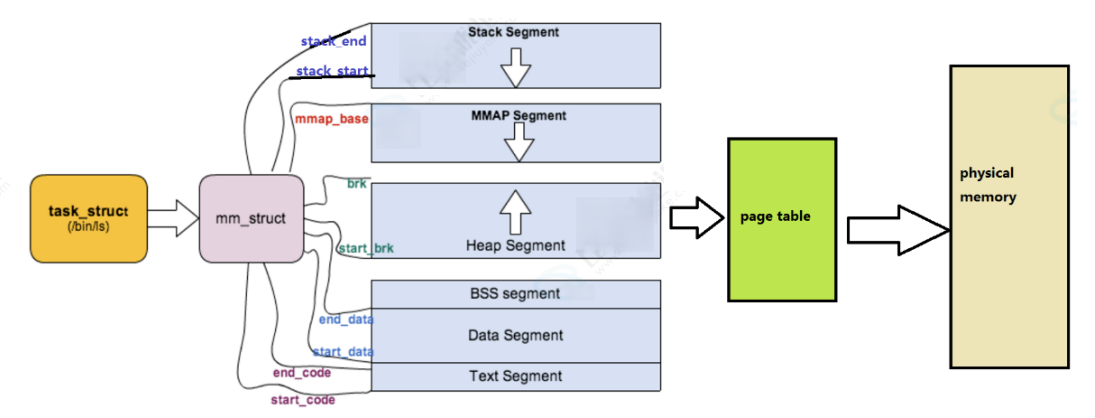
mm_struct 定义文件与 task_struct 定义文件位于相同路径,但定义文件不同。mm_struct 定义于 mm_types.h 文件中。
cpp
struct mm_struct {
    /* ... */
    struct vm_area_struct *mmap;     /* 指向虚拟区间(VMA)链表 */
    struct rb_root mm_rb;            /* 红黑树根节点 */
    unsigned long task_size;         /* 具有该结构体的进程的虚拟地址空间的大小 */
    /* ... */
    /* 代码段、数据段、堆栈段、参数段及环境段的起始和结束地址 */
    unsigned long start_code, end_code, start_data, end_data;
    unsigned long start_brk, brk, start_stack;
    unsigned long arg_start, arg_end, env_start, env_end;
    /* ... */
};
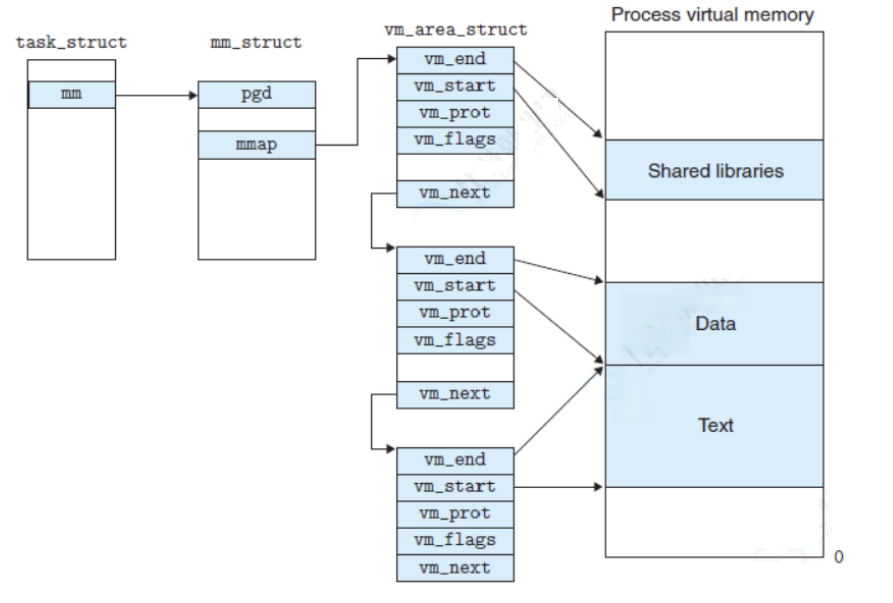
鉴于每个进程均拥有独立的 mm_struct,操作系统需将这些进程的 mm_struct 进行组织管理。虚拟空间的组织方式有两种:
- 虚拟区较少时采用单链表,由 mmap 指针指向该链表
- 虚拟区较多时采用红黑树进行管理,由 mm_rb 指向该红黑树
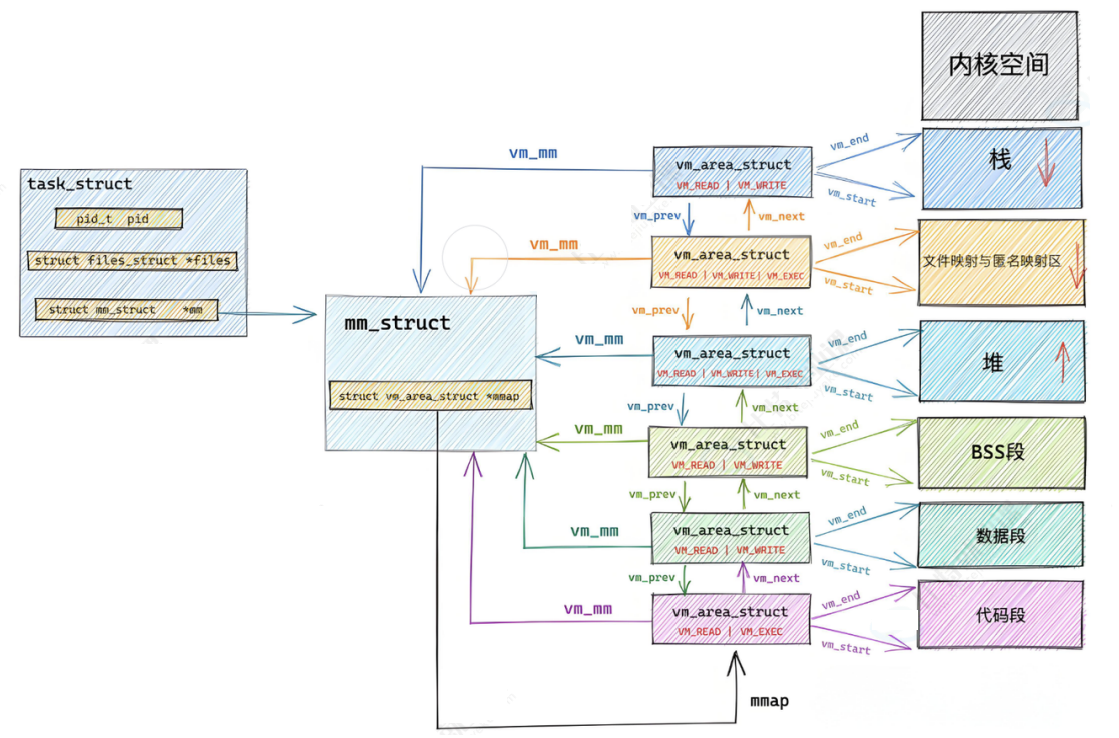
Linux 内核使用 vm_area_struct 结构来表示一个独立的虚拟内存区域(VMA)。由于每个不同质的虚拟内存区域功能和内部机制都不同,因此一个进程使用多个 vm_area_struct 结构来分别表示不同类型的虚拟内存区域。上面的两种组织方式使用的就是 vm_area_struct 结构来连接各个 VMA,方便进行快速访问。
cpp
struct vm_area_struct {
    unsigned long vm_start;           /* 虚存区起始地址 */
    unsigned long vm_end;             /* 虚存区结束地址 */
    struct vm_area_struct *vm_next, *vm_prev;  /* 前后指针 */
    struct rb_node vm_rb;             /* 红黑树中的位置 */
    unsigned long rb_subtree_gap;
    struct mm_struct *vm_mm;          /* 所属的mm_struct */
    pgprot_t vm_page_prot;
    unsigned long vm_flags;           /* 标志位 */
    struct {
        struct rb_node rb;
        unsigned long rb_subtree_last;
    } shared;
    struct list_head anon_vma_chain;
    struct anon_vma *anon_vma;
    const struct vm_operations_struct *vm_ops;  /* VMA对应的实际操作 */
    unsigned long vm_pgoff;           /* 文件映射偏移量 */
    struct file *vm_file;             /* 映射的文件 */
    void *vm_private_data;            /* 私有数据 */
    atomic_long_t swap_readahead_info;

#ifndef CONFIG_MMU
    struct vm_region *vm_region;      /* NOMMU映射区域 */
#endif

#ifdef CONFIG_NUMA
    struct mempolicy *vm_policy;      /* NUMA策略 */
#endif

    struct vm_userfaultfd_ctx vm_userfaultfd_ctx;
} __randomize_layout;
更详细的说明:
5.6 为什么要有虚拟地址空间
该问题可转化为:若程序可直接操作物理内存,将导致何种问题?
早期计算机系统中,运行程序时需将程序全部装入内存,程序直接运行于内存之上,即程序中访问的内存地址均为实际物理地址。当计算机同时运行多个程序时,须确保这些程序所需内存总量不超过物理内存容量。
当同时运行多个程序时,操作系统如何为这些程序分配内存?例如某计算机总内存为 128MB,同时运行程序 A 与 B,A 需占用 10MB 内存,B 需占用 110MB 内存。计算机采用如下内存分配策略:先将前 10MB 内存分配给程序 A,再从剩余 118MB 中划分出 110MB 分配给程序 B。
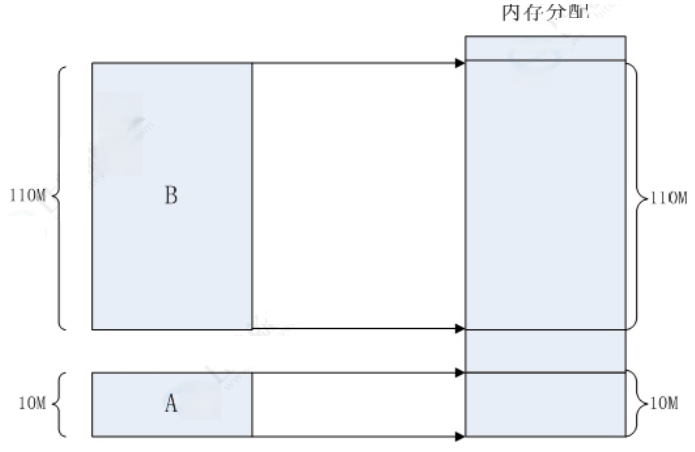
该分配策略可确保程序 A 与 B 均能运行,然而该简单内存分配策略存在诸多问题。
- 安全风险
- 各进程均可访问任意内存空间,即任意进程均可读写系统相关内存区域。若为恶意程序,则可随意修改内存空间,导致系统瘫痪
- 地址不确定
- 编译完成的程序存放于磁盘上,运行时需将程序加载至内存中执行。若直接使用物理地址,则无法确定内存的当前使用状况,即程序加载的实际内存地址每次运行均不确定。例如:首次执行 a.out 时,内存中无其他进程运行,因此加载地址为 0x00000000;而第二次执行时,内存中已有 10 个进程在运行,则执行 a.out 时的内存地址便不确定
- 效率低下
- 若直接使用物理内存,进程以整体(内存块)形式进行操作。当物理内存不足时,通常的解决方案是将不活跃进程换出至磁盘交换分区以释放内存空间;然而若使用物理地址,则需将整个进程完整搬离,如此在内存与磁盘之间进行大量数据拷贝将导致效率低下
引入虚拟地址空间与分页机制即可解决上述问题。
- 地址空间与页表由操作系统创建并维护。即所有涉及地址空间与页表映射的操作,均须在操作系统的监管下执行!同时也保护了物理内存中的所有合法数据,涵盖各进程及内核的相关有效数据
- 由于地址空间与页表映射机制的存在,物理内存可实现数据的任意位置加载! 物理内存分配与进程管理可实现解耦,进程管理模块与内存管理模块完成了解耦
- 由于地址空间的存在,因此在 C/C++ 中使用 new 或 malloc 申请空间时,实质上是在地址空间上申请的,物理内存甚至可以暂不分配。而当真正访问物理地址空间时,才执行内存管理算法,完成内存分配与页表映射关系的构建(延迟分配机制),该过程由操作系统自动完成,用户及进程完全无感知
- 由于页表映射机制的存在,程序在物理内存中理论上可实现任意位置加载。其可将地址空间中的虚拟地址与物理地址进行映射,从进程视角来看,所有内存分布均呈现有序性
Linux 系统------进程控制
1. 进程创建
1.1 fork 函数
在 Linux 中 fork 函数是非常重要的函数,它从已存在进程中创建一个新进程。新进程为子进程,而原进程为父进程。
cpp
#include <unistd.h>

pid_t fork(void);

/* 返回值:子进程中返回0,父进程返回子进程ID,出错返回-1 */
进程调用 fork,当控制转移到内核中的 fork 代码后,内核执行以下操作:
- 分配新的内存块和内核数据结构给子进程
- 将父进程部分数据结构内容拷贝至子进程
- 添加子进程到系统进程列表中
- fork 返回,开始调度器调度
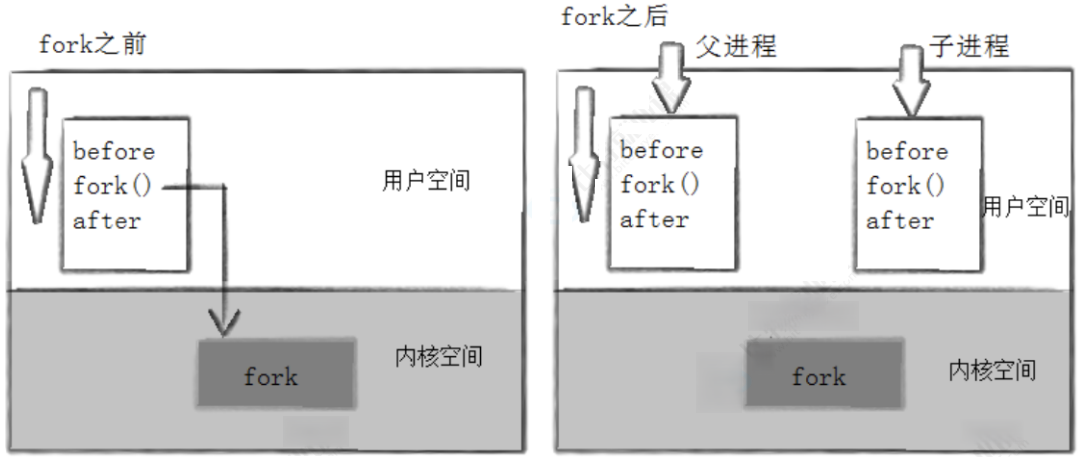
当一个进程调用 fork 之后,就有两个二进制代码相同的进程。而且它们都运行到相同的地方。但每个进程都将开始它们自己的执行流程,如下实例:
cpp
int main(void) {
    pid_t pid;

    printf("Before: pid is %d\n", getpid());

    if ((pid = fork()) == -1)
        perror("fork()"), exit(1);

    printf("After: pid is %d, fork return %d\n", getpid(), pid);
    sleep(1);

    return 0;
}
运行结果:
[root@localhost linux]# ./a.out
Before: pid is 43676
After: pid is 43676, fork return 43677
After: pid is 43677, fork return 0
可以看到有三行输出,一行 before,两行 after。进程 43676 先打印 before 消息,然后打印 after。另一个 after 消息由 43677 打印。为什么 43677 没有打印 before?
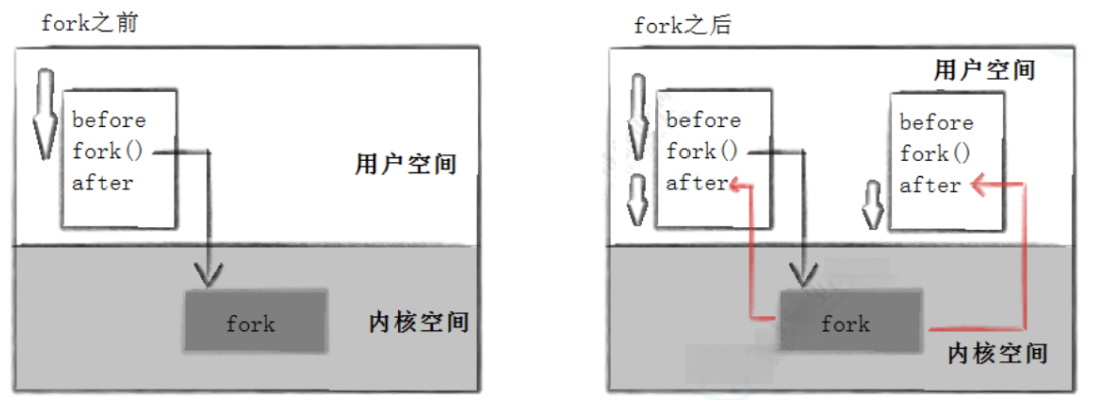
因此,fork 之前父进程独立执行,fork 之后,父子两个执行流分别执行。注:fork 之后,谁先执行完全由调度器决定。
1.2 fork 函数返回值
- 子进程返回 0
- 父进程返回的是子进程的 PID
1.3 写时拷贝(Copy-On-Write)
通常,父子进程代码共享,若父子不写入,则数据也是共享的。当任意一方试图写入时,就会以写时拷贝(Copy-On-Write)的方式各自拥有一份副本。
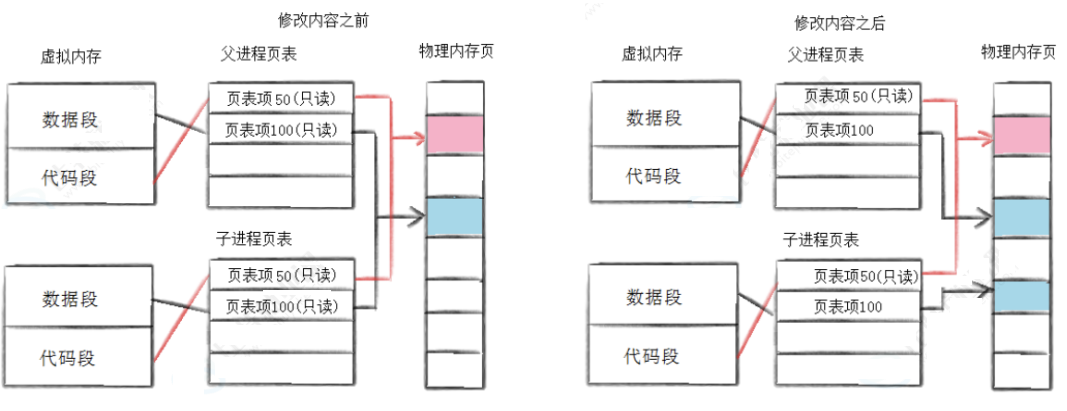
因为有写时拷贝技术的存在,所以父子进程得以彻底分离,完成了进程独立性的技术保证。写时拷贝是一种延时申请技术,可以提高整机内存的使用率。
1.4 fork 常规用法
- 一个父进程希望复制自己,使父子进程同时执行不同的代码段。例如,父进程等待客户端请求,生成子进程来处理请求
- 一个进程要执行一个不同的程序。例如:子进程从 fork 返回后,调用 exec 函数
1.5 fork 调用失败的原因
- 系统中有太多的进程
- 实际用户的进程数超过了限制
2. 进程终止
进程终止的本质是释放系统资源,即释放进程申请的相关内核数据结构和对应的数据和代码。
2.1 进程退出场景
- 代码运行完毕,结果正确
- 代码运行完毕,结果不正确
- 代码异常终止
2.2 进程常见退出方法
正常终止(可以通过 echo $? 查看进程退出码):
- 从 main 返回
- 调用 exit
- 调用 _exit
异常退出:
- Ctrl+C,信号终止
2.3 退出码
退出码(退出状态)可以告诉我们最后一次执行命令的状态。在命令结束以后,我们可以知道命令是成功完成还是以错误结束的。其基本思想是,程序返回退出代码 0 时表示执行成功,没有问题。代码 1 或 0 以外的任何代码都被视为不成功。
Linux Shell 中主要退出码:
| 退出码 | 解释 |
|---|---|
| 0 | 命令成功执行 |
| 1 | 通用错误代码 |
| 2 | 命令(或参数)使用不当 |
| 126 | 权限被拒绝(或)无法执行 |
| 127 | 未找到命令,或 PATH 错误 |
| 128+n | 命令被信号从外部终止,或遇到致命错误 |
| 130 | 通过 Ctrl+C 或 SIGINT 终止(终止代码 2,即键盘中断) |
| 143 | 通过 SIGTERM 终止(默认终止) |
| 255* | 退出码超过了 0~255 的范围,因此无法重新计算(LCTT 译注:超过 255 后,用退出码取模) |
- 退出码 0 表示命令执行无误,这是完成命令的理想状态
- 退出码 1 也可以将其解释为"不被允许的操作"。例如在没有 sudo 权限的情况下使用 yum;再例如除以 0 等操作也会返回错误码 1,对应的命令为 let a=1/0
- 130(SIGINT 或 ^C)和 143(SIGTERM)等终止信号是非常典型的,它们属于 128+n 信号,其中 n 表示终止码
- 可以使用 strerror 函数来获取退出码对应的描述
2.4 _exit 函数
cpp
#include <unistd.h>

void _exit(int status);

/* 参数:status 定义了进程的终止状态,父进程通过wait来获取该值 */- 说明:虽然 status 是 int 类型,但是仅有低 8 位(位图)可以被父进程所用。所以 _exit(-1) 时,在终端执行 $? 发现返回值是 255。
2.5 exit 函数
cpp
#include <stdlib.h>

void exit(int status);
exit 最后也会调用 _exit,但在调用 _exit 之前,还做了其它工作:
- 执行用户通过 atexit 或 on_exit 定义的清理函数
- 关闭所有打开的流,所有的缓存数据均被写入
- 调用 _exit
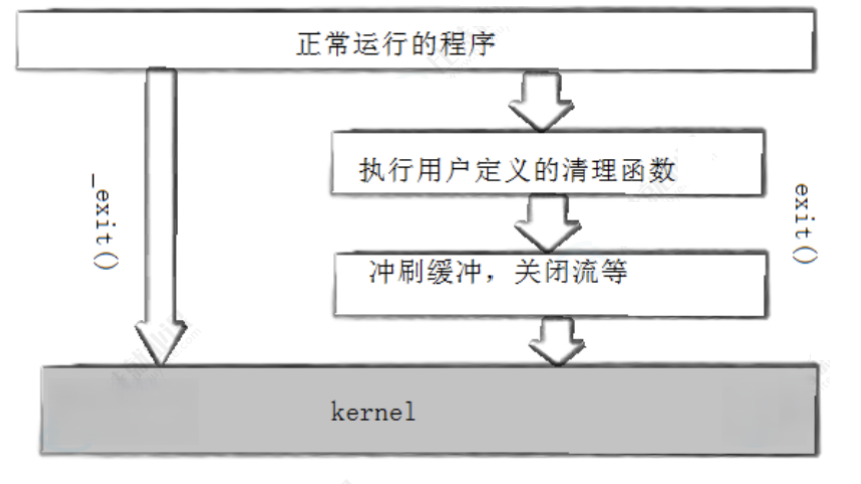
exit 与 _exit 的区别:
- 前者是 C 语言标准库函数;而后者是系统调用函数
- exit 中内嵌了 _exit 的调用
- 调用 exit 后会清空缓存区,然后退出;而 _exit 不会清空缓存区
cpp
/* 示例1:使用exit */
int main(void) {
    printf("hello");
    exit(0);
}

/* 运行结果: */
/* [root@localhost linux]# ./a.out */
/* hello[root@localhost linux]# */

/* 示例2:使用_exit */
int main(void) {
    printf("hello");
    _exit(0);
}

/* 运行结果: */
/* [root@localhost linux]# ./a.out */
/* [root@localhost linux]# */
2.6 return 退出
return 是一种更常见的退出进程方法。执行 return n 等同于执行 exit(n),因为调用 main 的运行时函数会将 main 的返回值当作 exit 的参数。
3. 进程等待
3.1 进程等待必要性
- 由于子进程退出,父进程若不管不顾,就可能造成"僵尸进程"的问题,进而造成内存泄露
- 另外,进程一旦变成僵尸状态,就无法通过常规信号(包括 kill -9)将其清除,因为该进程已经处于终止状态
- 最后,父进程派给子进程的任务完成的如何,我们需要知道。如:子进程运行完成,结果对还是不对,或者是否正常退出
- 父进程通过进程等待的方式,回收子进程资源,获取子进程退出信息
3.2 进程等待的方法
3.2.1 wait 方法
cpp
#include <sys/types.h>
#include <sys/wait.h>

pid_t wait(int *status);

/* 返回值:成功返回被等待进程PID,失败返回-1 */
/* 参数:status为输出型参数,获取子进程退出状态;若无需获取则可设置为NULL */
3.2.2 waitpid 方法
cpp
pid_t waitpid(pid_t pid, int *status, int options);

/* 返回值:
 * 当正常返回的时候,waitpid返回收集到的子进程的进程ID;
 * 如果设置了选项WNOHANG,而调用中waitpid发现没有已退出的子进程可收集,则返回0;
 * 如果调用中出错,则返回-1,这时errno会被设置成相应的值以指示错误所在。
 */

/* 参数:
 * pid:
 *   pid=-1,等待任一子进程。与wait等效。
 *   pid>0,等待其进程ID与pid相等的子进程。
 *
 * status:输出型参数
 *   WIFEXITED(status):若为正常终止子进程返回的状态,则为真。(查看进程是否是正常退出)
 *   WEXITSTATUS(status):若WIFEXITED非零,提取子进程退出码。(查看进程的退出码)
 *
 * options:默认为0,表示阻塞等待
 *   WNOHANG:若pid指定的子进程没有结束,则waitpid()函数返回0,不予以等待。
 *            若正常结束,则返回该子进程的ID。
 */
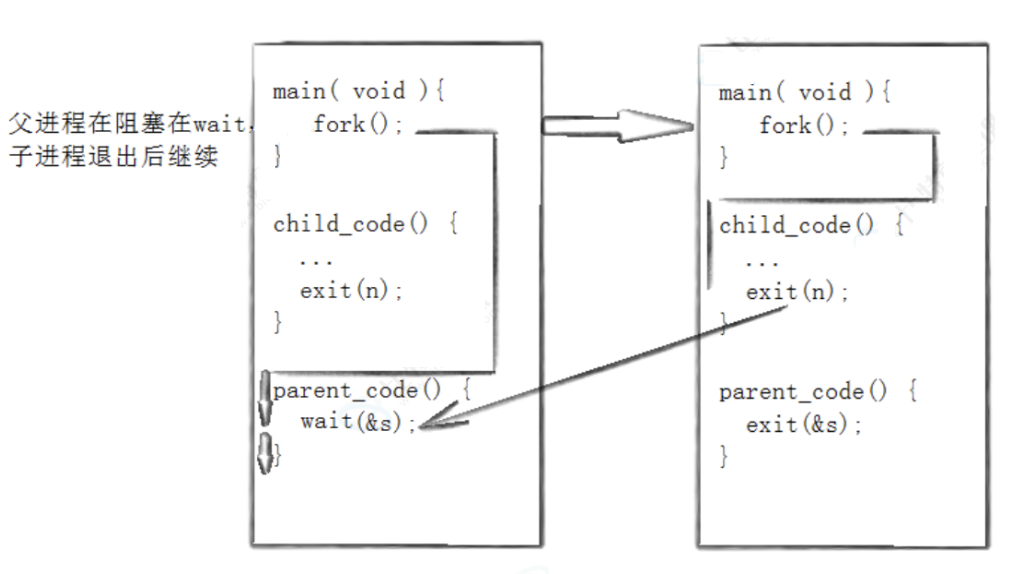
- 若子进程已经退出,调用 wait/waitpid 时,wait/waitpid 会立即返回,并且释放资源,获取子进程退出信息
- 若在任意时刻调用 wait/waitpid,子进程存在且正常运行,则进程可能阻塞
- 若不存在该子进程,则立即出错返回
3.2.3 获取子进程 status
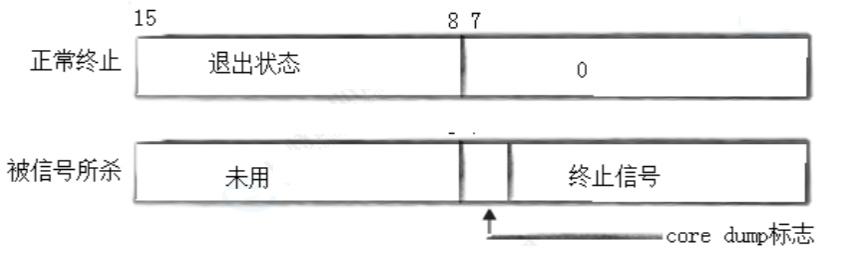
- wait 和 waitpid 都有一个 status 参数,该参数是一个输出型参数,由操作系统填充
- 若传递 NULL,表示不关注子进程的退出状态信息
- 否则,操作系统会根据该参数,将子进程的退出信息反馈给父进程
- status 不能简单的当作整形来看待,可以当作位图来看待(只研究低 16 比特位)
测试代码:
cpp
#include <sys/wait.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <errno.h>

int main(void) {
    pid_t pid;

    if ((pid = fork()) == -1)
        perror("fork"), exit(1);

    if (pid == 0) {
        sleep(20);
        exit(10);  /* 子进程退出码为10 */
    } else {
        int st;
        pid_t ret = wait(&st);

        if (ret > 0 && (st & 0x7F) == 0) {  /* 正常退出 */
            printf("child exit code:%d\n", (st >> 8) & 0xFF);
        } else if (ret > 0) {               /* 异常退出 */
            printf("sig code: %d\n", st & 0x7F);
        }
    }

    return 0;
}
测试结果:
# ./a.out    # 等待20秒后退出
child exit code:10

# ./a.out    # 在其他终端kill掉
sig code: 9
3.2.4 阻塞与非阻塞等待
进程的阻塞等待方式:
cpp
int main(void) {
    pid_t pid;

    pid = fork();

    if (pid < 0) {
        printf("%s fork error\n", __FUNCTION__);
        return 1;
    } else if (pid == 0) {  /* 子进程 */
        printf("child is run, pid is: %d\n", getpid());
        sleep(5);
        exit(257);
    } else {                /* 父进程 */
        int status = 0;
        pid_t ret = waitpid(-1, &status, 0);  /* 阻塞式等待,等待5秒 */

        printf("this is test for wait\n");

        if (WIFEXITED(status) && ret == pid) {
            printf("wait child 5s success, child return code is:%d.\n",
                   WEXITSTATUS(status));
        } else {
            printf("wait child failed, return.\n");
            return 1;
        }
    }

    return 0;
}
运行结果:
[root@localhost linux]# ./a.out
child is run, pid is: 45110
this is test for wait
wait child 5s success, child return code is:1.
进程的非阻塞等待方式:
cpp
#include <stdio.h>
#include <stdlib.h>
#include <sys/wait.h>
#include <unistd.h>

int main(void) {
    pid_t pid;

    pid = fork();

    if (pid < 0) {
        printf("%s fork error\n", __FUNCTION__);
        return 1;
    } else if (pid == 0) {  /* 子进程 */
        printf("child is run, pid is: %d\n", getpid());
        sleep(5);
        exit(1);
    } else {                /* 父进程 */
        int status = 0;
        pid_t ret = 0;

        do {
            ret = waitpid(-1, &status, WNOHANG);  /* 非阻塞式等待 */

            if (ret == 0) {
                printf("child is running\n");
            }
            /* 此处可执行其他任务 */
        } while (ret == 0);

        if (WIFEXITED(status) && ret > 0) {
            printf("wait child success, child return code is: %d.\n",
                   WEXITSTATUS(status));
        } else {
            printf("wait child failed, return.\n");
            return 1;
        }
    }

    return 0;
}
4. 进程程序替换
fork() 之后,父子各自执行父进程代码的一部分。若子进程只想执行一个全新的程序,就需要使用进程的程序替换。
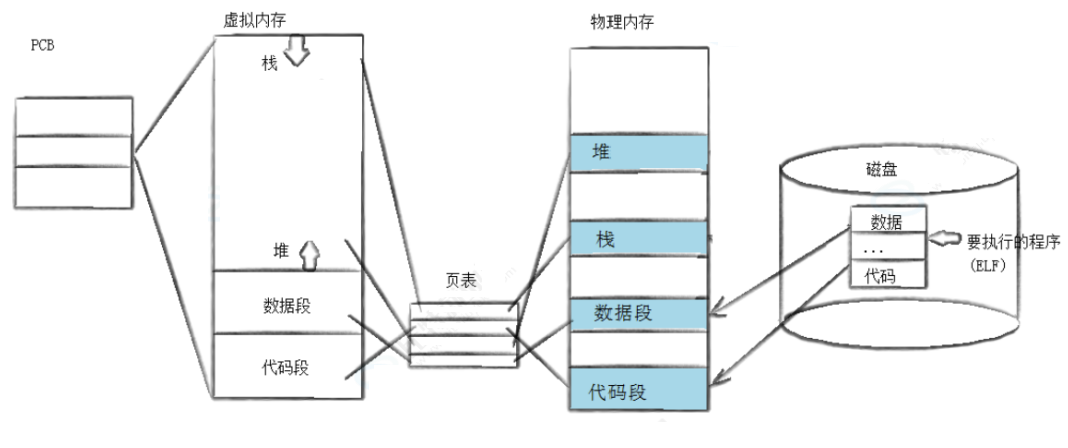
程序替换是通过特定的接口,加载磁盘上的一个全新的程序(代码和数据),加载到调用进程的地址空间中。
4.1 替换原理
用 fork 创建子进程后执行的是和父进程相同的程序(但有可能执行不同的代码分支),子进程往往要调用一种 exec 函数以执行另一个程序。当进程调用一种 exec 函数时,该进程的用户空间代码和数据完全被新程序替换,从新程序的启动例程开始执行。调用 exec 并不创建新进程,所以调用 exec 前后该进程的 ID 未改变。
4.2 替换函数
有 6 个以 exec 开头的函数,通称 exec 函数:
cpp
#include <unistd.h>

int execl(const char *path, const char *arg, ...);
int execlp(const char *file, const char *arg, ...);
int execle(const char *path, const char *arg, ..., char *const envp[]);
int execv(const char *path, char *const argv[]);
int execvp(const char *file, char *const argv[]);
int execve(const char *path, char *const argv[], char *const envp[]);
4.2.1 函数解释
- 这些函数若调用成功则加载新的程序从启动代码开始执行,不再返回
- 若调用出错则返回 -1
- 所以 exec 函数只有出错的返回值而没有成功的返回值
4.2.2 命名解释
这些函数原型看起来容易混淆,但掌握规律就很好记。
- l(list):表示参数采用列表形式
- v(vector):参数用数组形式
- p(path):有 p 则自动搜索环境变量 PATH
- e(env):表示自己维护环境变量
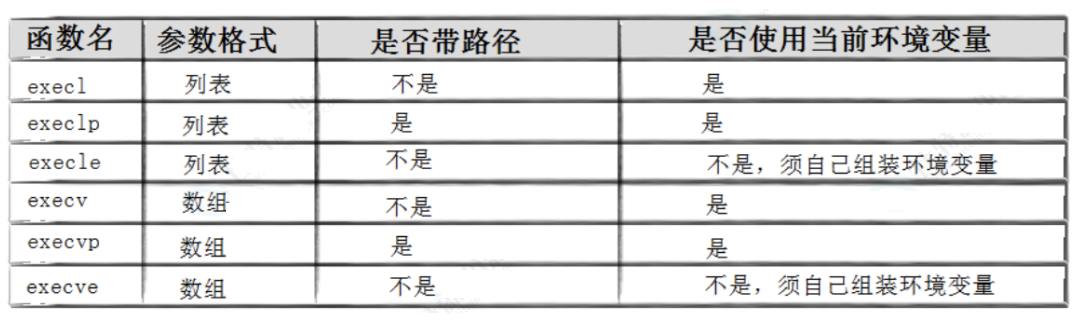
exec 调用示例:
cpp
#include <unistd.h>

int main(void) {
    char *const argv[] = {"ps", "-ef", NULL};
    char *const envp[] = {"PATH=/bin:/usr/bin", "TERM=console", NULL};

    execl("/bin/ps", "ps", "-ef", NULL);
    // 不带p的函数需要指定完整路径

    execlp("ps", "ps", "-ef", NULL);
    // 带p的函数可以使用环境变量PATH,无需写全路径

    execle("ps", "ps", "-ef", NULL, envp);
    // 带e的函数需要自己组装环境变量

    execv("/bin/ps", argv);

    execvp("ps", argv);
    // 带p的函数可以使用环境变量PATH,无需写全路径

    execve("/bin/ps", argv, envp);
    // 带e的函数需要自己组装环境变量

    exit(0);
}
实际上,只有 execve 是真正的系统调用,其它五个函数最终都调用 execve,所以 execve 在 man 手册第二节,其它函数在 man 手册第三节。函数间关系如下:
exec 函数簇:
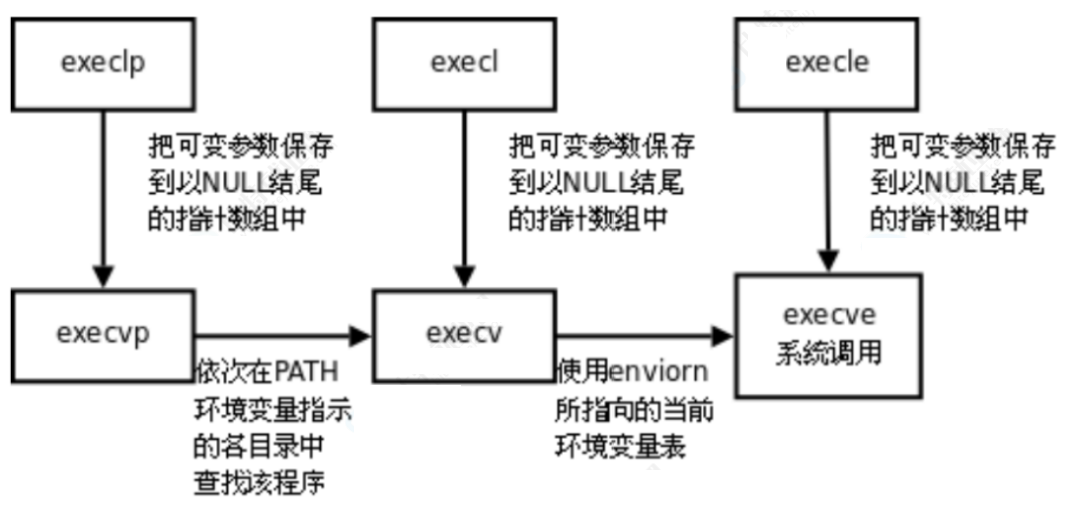
注:
- 直接使用数组去替换 envp 会导致结果只有自己的环境变量,而没有系统的环境变量
- 新增方式给子进程设置环境变量的方法:
- 直接调用 putenv
- 调用 exec*e 系列函数,配合 putenv 及 char **environ 引入环境变量
5. 自主 Shell 命令行解释器
5.1 实现原理
下面是一个与 shell 典型的互动示例:
[root@localhost epoll]# ls
client.cpp  readme.md  server.cpp  utility.h

[root@localhost epoll]# ps
PID  TTY     TIME CMD
3451 pts/0  00:00:00 bash
3514 pts/0  00:00:00 ps
用下图的时间轴来表示事件的发生次序。其中时间从左向右。shell 有标识为 sh 的方块代表,它随着时间的流逝从左向右推进。shell 从用户读入字符串"ls"。shell 建立一个新的进程,然后在该进程中运行 ls 程序并等待该进程结束。
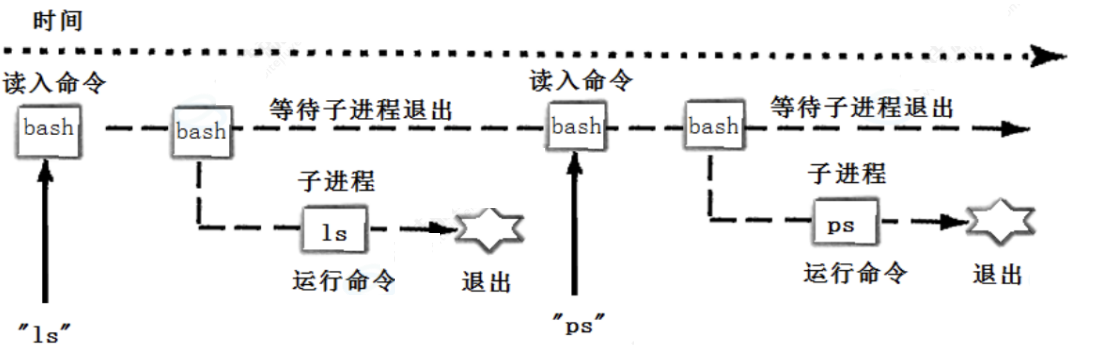
然后 shell 读取新的一行输入,建立一个新的进程,在该进程中运行程序并等待该程序结束。
所以要写一个 shell,需要循环执行以下过程:
- 获取命令行
- 解析命令行
- 建立一个子进程(fork)
- 替换子进程(execvp)
- 父进程等待子进程退出(wait)
5.2 实现源码
实现代码:
cpp
#include <iostream>
#include <cstdio>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <sys/wait.h>
#include <sys/types.h>
#include <sys/stat.h>
#include <fcntl.h>

#define COMMAND_SIZE 1024
#define FORMAT "[%s@%s %s]# "

// Shell的全局参数
#define MAXARGC 128
int g_argc;
char *g_argv[MAXARGC];

// 环境变量参数表
#define MAX_ENV 100
char *g_env[MAX_ENV];
int g_envs;

// 用于测试
char cwd[1024];
char cwdenv[1024];

// 退出码
int lastcode = 0;

// 重定向需要的变量
#define NONE_REDIR 0
#define INPUT_REDIR 1    // <
#define OUTPUT_REDIR 2   // >
#define APPEND_REDIR 3   // >>

int redir = NONE_REDIR;
std::string filename;

const char *GetUser() {
    const char *user = getenv("USER");
    return user == NULL ? "none" : user;
}

const char *GetHostname() {
    const char *hostname = getenv("HOSTNAME");
    return hostname == NULL ? "none" : hostname;
}

const char *GetPwd() {
    // const char *pwd = getenv("PWD");
    const char *pwd = getcwd(cwd, sizeof(cwd));
    if (pwd) {
        snprintf(cwdenv, sizeof(cwdenv), "PWD=%s", cwd);
        putenv(cwdenv);
    }
    return pwd == NULL ? "none" : pwd;
}

const char *GetHome() {
    const char *home = getenv("HOME");
    return home == NULL ? "" : home;
}

void InitEnv() {
    extern char **environ;
    memset(g_env, 0, sizeof(g_env));
    g_envs = 0;

    // 1. 获取环境变量
    for (int i = 0; environ[i] != NULL; i++) {
        // 先为自己的环境变量参数表开辟空间
        g_env[i] = (char *)malloc(strlen(environ[i]) + 1);
        strcpy(g_env[i], environ[i]);
        g_envs++;
    }
    g_env[g_envs] = NULL;  // 最后一个值需要为空

    // 2. 导出环境变量
    for (int i = 0; g_env[i] != NULL; i++) {
        putenv(g_env[i]);
    }
    environ = g_env;
}

std::string DirName(const char *pwd) {
#define SLASH "/"
    std::string dir = pwd;
    if (dir == SLASH) return SLASH;
    auto pos = dir.rfind(SLASH);
    if (pos == std::string::npos) return "BUG?";
    return dir.substr(pos + 1);
}

void MakeCommandLine(char prompt[], int size) {
    snprintf(prompt, size, FORMAT, GetUser(), GetHostname(),
             DirName(GetPwd()).c_str());
}

void PrintCommandPrompt() {
    char prompt[COMMAND_SIZE];
    MakeCommandLine(prompt, sizeof(prompt));
    printf("%s", prompt);
    fflush(stdout);
}

bool GetCommand(char *command, int size) {
    char *str = fgets(command, size, stdin);
    if (str == NULL) return false;
    command[strlen(command) - 1] = 0;  // 消除换行符
    if (strlen(command) == 0) return false;
    return true;
}

bool CommandPrase(char *command) {
#define SPA " "
    g_argc = 0;
    g_argv[g_argc++] = strtok(command, SPA);
    while ((bool)(g_argv[g_argc++] = strtok(nullptr, SPA)));
    // 减掉多余的1
    g_argc--;
    return g_argc > 0 ? true : false;
}

void Cd() {
    // 四种情况: cd  cd -  cd ~  cd XXXNAME
    if (g_argc == 1) {
        std::string home = GetHome();
        if (home.empty()) return;
        chdir(home.c_str());
    } else {
        std::string where = g_argv[1];
        if (where == "-") {
            // 返回上一目录(此处可补充实现)
        } else if (where == "~") {
            chdir(getenv("HOME"));
        } else {
            chdir(where.c_str());
        }
    }
}

void Echo() {
    // 三种情况: echo $?  echo $PATH  echo "XXXXX"
    if (g_argc == 2) {
        std::string opt = g_argv[1];
        if (opt == "$?") {
            std::cout << lastcode << std::endl;
            lastcode = 0;
        } else if (opt[0] == '$') {
            std::string env_name = opt.substr(1);
            const char *env_value = getenv(env_name.c_str());
            if (env_value)
                std::cout << env_value << std::endl;
        } else {
            std::cout << opt << std::endl;
        }
    }
}

bool CheckAndExecIn() {
    std::string cmd = g_argv[0];
    if (cmd == "cd") {
        Cd();
        return true;
    } else if (cmd == "echo") {
        Echo();
        return true;
    }
    return false;
}

void Execte() {
    pid_t id = fork();
    if (id == 0) {
        int fd = -1;

        // 判断是否是重定向
        if (redir == INPUT_REDIR) {
            fd = open(filename.c_str(), O_RDONLY);
            if (fd < 0) exit(1);
            dup2(fd, 0);
            close(fd);
        } else if (redir == OUTPUT_REDIR) {
            fd = open(filename.c_str(), O_CREAT | O_WRONLY | O_TRUNC, 0666);
            if (fd < 0) exit(2);
            dup2(fd, 1);
            close(fd);
        } else if (redir == APPEND_REDIR) {
            fd = open(filename.c_str(), O_CREAT | O_WRONLY | O_APPEND, 0666);
            if (fd < 0) exit(2);
            dup2(fd, 1);
            close(fd);
        }

        // 子进程执行命令
        execvp(g_argv[0], g_argv);
        exit(1);
    }

    int status = 0;
    // 父进程等待子进程
    pid_t rid = waitpid(id, &status, 0);
    if (rid > 0) {
        lastcode = WEXITSTATUS(status);
    }
}

void RvSpace(char cmd[], int &end) {
    while (isspace(cmd[end])) {
        end++;
    }
}

void RedirCheck(char cmd[]) {
    redir = NONE_REDIR;
    filename.clear();
    int start = 0;
    int end = strlen(cmd) - 1;

    while (end > start) {
        if (cmd[end] == '<') {
            cmd[end++] = 0;
            RvSpace(cmd, end);
            redir = INPUT_REDIR;
            filename = cmd + end;
            break;
        } else if (cmd[end] == '>') {
            if (cmd[end - 1] == '>') {
                cmd[end - 1] = 0;
                redir = APPEND_REDIR;
            } else {
                redir = OUTPUT_REDIR;
            }
            cmd[end++] = 0;
            RvSpace(cmd, end);
            filename = cmd + end;
            break;
        } else {
            end--;
        }
    }
}

int main() {
    InitEnv();

    while (true) {
        // 1. 输出命令行提示符
        PrintCommandPrompt();

        // 2. 获取命令行输入
        char command[COMMAND_SIZE];
        if (!GetCommand(command, sizeof(command)))
            continue;

        // 3. 重定向检查
        RedirCheck(command);

        // 4. 拆解命令行 "ls -a -l" -> "ls" "-a" "-l"
        if (!CommandPrase(command))
            continue;

        // 5. 检测并处理内建命令
        if (CheckAndExecIn())
            continue;

        // 6. 执行替换命令
        Execte();
    }

    return 0;
}
5.3 总结
exec/exit 就像 call/return。
一个 C 程序有很多函数组成。一个函数可以调用另一个函数,同时传递给它一些参数。被调用的函数执行一定的操作,然后返回一个值。每个函数都有它的局部变量,不同的函数通过 call/return 系统进行通信。
这种通过参数和返回值在拥有私有数据的函数间通信的模式是结构化程序设计的基础。Linux 鼓励将这种应用于程序之内的模式扩展到程序之间。如下图:
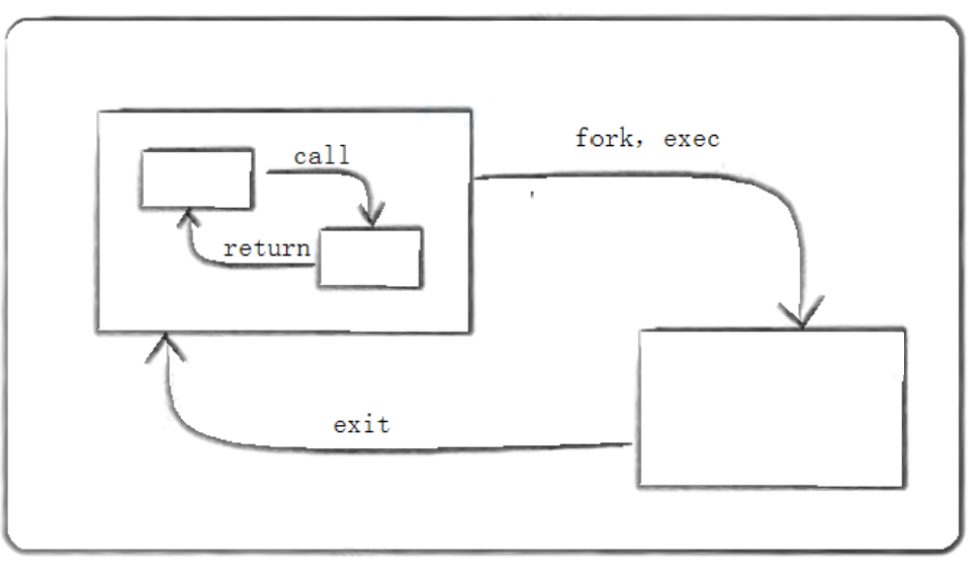
一个 C 程序可以 fork/exec 另一个程序,并传递给它一些参数。这个被调用的程序执行一定的操作,然后通过 exit(n) 来返回值。调用它的进程可以通过 wait(&ret) 来获取 exit 的返回值。
注:本文为 " Linux 系统进程 " 相关合辑。
略作重排,如有内容异常,请看原文。
Reference
- Linux 系统------进程概念(上)-CSDN 博客
https://blog.csdn.net/2501_93697341/article/details/163510209 - Linux 系统------进程概念(下)-CSDN 博客
https://blog.csdn.net/2501_93697341/article/details/163893445 - Linux 系统------进程控制(上)-CSDN 博客
https://blog.csdn.net/2501_93697341/article/details/164729480 - Linux 系统------进程控制(下)-CSDN 博客
https://blog.csdn.net/2501_93697341/article/details/164881825