1. 问题1: L2 cache Block
问题:
在blackwell 双 计算 die 结构中,每个die中存在两个L2 cache block,这两个L2 block 是对对应的gpc负责的,而不是特定HBM负责的。同时也意味着,在两个 L2 block 中,同一个HBM 中的变量,假设叫X,可能在两个 L2 block中都存在cache,是不是?
答:
这个问题需要分几个层面来澄清,涉及**论文实测的消费级 Blackwell(GB203)与 您提到的数据中心双 die Blackwell(如 B200)**之间的区别,以及 L2 partition 的寻址原理。
一、先区分论文实测对象与双 die 架构
| 芯片 | 架构定位 | Die 结构 | L2 结构(论文实测) |
|---|---|---|---|
| GB203 (RTX 5080) | 消费级 Blackwell | 单计算 die | Single unified L2(65 MB,1 个分区,所有 GPC 共享) |
| GH100 (H100) | 数据中心 Hopper | 单计算 die | 2 L2 partitions(50 MB,2 个独立分区,各服务一部分 GPC) |
| GB100/GB102 (B200) | 数据中心 Blackwell | 双计算 die(通过 NVLink-HBI 互联) | 论文未测试,公开资料为每个 die 有独立 L2(约 192 MB/die) |
所以您描述的"双计算 die、每个 die 两个 L2 block"场景,不是论文中的 GB203,而是数据中心级 Blackwell(如 B200)。论文只验证了 GH100 是"双 partition L2"、GB203 是"unified L2"。
二、关于单 die 内部多 L2 partition 的情况(如 GH100)
您说的"两个 L2 block 是对应 GPC 负责的,而不是特定 HBM 负责的"------这一点在 GH100 上是正确的。论文 VI-C 节明确指出:
"In the GH100, the L2 cache is divided into two independent partitions, each servicing a subset of GPCs."
但关键问题是:同一个 HBM 变量 X 会不会同时存在于两个 L2 partition 中?
答案:通常不会。 虽然 partition 是按 GPC 子集划分的,但 L2 partition 的底层寻址通常采用 地址范围划分(address range partitioning)或哈希交错(address-interleaved) 。这意味着任何一个特定的物理地址只会被映射到 唯一一个 L2 partition。因此:
- 变量 X 的物理地址要么落在 Partition 0,要么落在 Partition 1;
- 不会同时在两个 partition 中都缓存 X 的完整副本。
否则会出现严重的缓存一致性(coherence)问题,而 GH100 的 L2 partition 之间并非缓存一致的独立实体(它们是物理隔离的 cache slice,通过地址路由避免冲突)。
三、关于双 die 结构的情况(如 B200,论文未覆盖)
如果您问的是数据中心 Blackwell B200 的双 die 架构(两个计算 die,各自有独立 L2 和 HBM):
1. 每个 die 的 L2 是否又分成两个 block?
目前 NVIDIA 未明确披露 B200 每个 die 内部的 L2 是否像 GH100 那样再分为 2 个 partitions。鉴于消费级 GB203 已经改用 unified L2(单分区) ,数据中心级 Blackwell 每个 die 内部很可能也采用 unified L2,而非 GH100 式的 dual-partition。
2. 同一个变量 X 是否可能在两个 die 的 L2 中都存在?
是的,这是可能的。 这是典型的 多处理器缓存一致性(cache coherence) 问题:
- Die 0 的 L2 和 Die 1 的 L2 是两个独立的缓存实体;
- 如果 Die 0 上的 GPC 访问过全局地址 X,X 会进入 Die 0 的 L2;
- 如果 Die 1 上的 GPC 随后也访问同一个全局地址 X,X 也会进入 Die 1 的 L2;
- 此时两个 die 的 L2 中确实各自持有一份 X 的副本。
这种情况下,两个 die 之间需要通过 NVLink-HBI(High Bandwidth Interface) 维护缓存一致性(cache coherency),确保一个 die 修改 X 后,另一个 die 的 L2 副本能被失效或更新。
3. 关于"同一个 HBM"
B200 中每个 die 通常连接自己专属的 HBM3e(Die 0 有 4 个 HBM stack,Die 1 也有 4 个)。虽然全局内存地址空间是统一的(Unified Memory),但:
- 变量 X 如果物理上分配在 Die 0 的 HBM 中,Die 1 访问 X 时需要跨 die 读取;
- 此时 X 可能同时存在于 Die 0 的 L2(作为 Home/Owner)和 Die 1 的 L2(作为远程缓存副本);
- NVIDIA 通过 NVLink-HBI 提供 die-to-die 的一致性支持,使这整个过程对软件透明。
四、总结
| 场景 | 是否可能同时存在于两个 L2 中 | 原因 |
|---|---|---|
| 单 die + 多 L2 partition(如 GH100) | 否 | 地址映射到唯一 partition,物理隔离 |
| 双 die + 各 die 独立 L2(如 B200) | 是 | 两个 die 的 L2 是独立缓存,硬件一致性协议允许同地址多副本 |
| GB203(论文实测) | 不适用 | 单 die unified L2,只有一个实体 |
因此,您的理解"两个 L2 block 对应 GPC 而非 HBM"在 GH100 上是正确的;但关于"同一个 HBM 变量 X 在两个 L2 block 中都有 cache"------如果是单 die 内的两个 partition,通常不会;如果是双 die 各自有 L2,则完全可能,这正是多 die GPU 需要硬件缓存一致性协议的原因。
问题2: blackwell L2 cache 特性
问题:
这篇论文,能推导 blackwell L2 cache 的特性有哪些?
答:
根据论文第六章(Memory Subsystem)中关于 L2 Cache 的详细微基准测试数据,可以推导出 Blackwell(GB203)L2 Cache 的以下核心特性:
1. 架构设计:Monolithic(单一统一)架构
- 非分区设计 :与 Hopper(GH100)将 L2 分为两个独立分区(各服务部分 GPC)不同,Blackwell 采用单一、统一的 L2 Cache,所有 GPC 共享同一缓存实体。
- 简化一致性:统一设计减少了分区间的数据同步和路由复杂度,有利于提升空间局部性,但对高并发流式访问更容易产生争用。
2. 容量显著提升
- 65 MB 总容量,较 Hopper 的 50 MB 增加 30%。
- 更大的容量使工作集能在缓存中驻留更久,延迟过渡点到全局内存的阈值更晚(约 71 MB,Hopper 为 55 MB)。
3. 延迟特性:高基线、高稳定性
| 指标 | Blackwell (GB203) | Hopper (GH100) |
|---|---|---|
| 标准 L2 命中延迟 | ~358 周期 | ~273 周期 |
| 分区饱和后延迟 | 维持基线 | 跃升至 ~508 周期 |
| 全局内存延迟 | ~876.7 周期 | ~658.7 周期 |
- 基线延迟更高:由于缺乏分区带来的访问分散能力,Blackwell 的标准 L2 命中延迟比 Hopper 高约 31%。
- 稳定性更好 :Hopper 在双分区同时饱和时(31--45 MB 范围)延迟会大幅恶化;而 Blackwell 凭借更大容量,在更大内存 footprint 上始终维持基线延迟,不会出现延迟尖峰。
4. 并发扩展性:"先弱后强"的带宽曲线
论文通过 per-warp 1024 次全局内存读写测试揭示了 L2 随 warp 数量增加的吞吐量行为(图 9):
- 低并发(1--4 warps):表现弱于 Hopper。平均 per-warp 周期约 49k vs Hopper 的 43.5k,反映了基础延迟劣势。
- 中等并发(8--16 warps) :单一接口开始成为瓶颈,延迟增长更快(16 warps 时约 66k 周期),而 Hopper 仍保持优势。
- 高并发(20--32 warps) :后来居上 。Blackwell 在 20 warps 时追平并略微超过 Hopper;在 32 warps 时达到约 128.4k vs Hopper 的 128.9k。这说明其聚合 L2 带宽上限更高,能在极端负载下通过更大的缓存和零分区仲裁开销反超。
5. 工作负载适应性
| 工作负载类型 | Blackwell L2 表现 | 原因 |
|---|---|---|
| 大规模带宽受限应用(DL 推理、密集 GEMM) | 更优 | 高聚合带宽 + 更大缓存 |
| 图形/混合计算任务 | 更优 | Monolithic 设计提升空间局部性 |
| 中等并发延迟敏感型任务 | 较弱 | 基础延迟高 + 单一接口瓶颈 |
| 流式/未缓存高并发访问 | 易争用 | 所有 GPC 共享同一端口 |
6. 与系统的协同特性
- 配合 GDDR7:Blackwell 使用 GDDR7(vs Hopper 的 HBM2e),虽然全局内存带宽和延迟均弱于 Hopper,但更大的 L2 在一定程度上弥补了这一点,通过提高缓存命中率减少对全局内存的依赖。
- 写入带宽受限:全局内存写入带宽仅 1.6 TB/s(读取 8.2 TB/s),L2 作为写回路径的关键节点,其统一架构可能对写合并和回写策略有更简化的处理。
总结
Blackwell 的 L2 Cache 本质上是一种以牺牲低负载延迟、换取高负载吞吐量和更大容量 的设计。它通过 Monolithic 架构 + 65 MB 大容量,更适合高并发、大工作集、带宽受限的现代 AI 推理和图形工作负载;但对于需要确定性低延迟、中等并发的 HPC 场景,其表现可能不如 Hopper 的分区 L2 设计。
3. 问题3: NVHBM 技术下 L2 的位置
问题:
请先陈述 nvHBM 介绍;再进一步分析 在nvHBM架构下,L2 cache 放在哪里了?HBM die 么?
答:
一、NVHBM 介绍
NVHBM 是 NVIDIA 于 2026 年 8 月 26 日 宣布的下一代高带宽内存架构,属于 NVLink Fusion 生态系统的扩展。其核心创新可以用一句话概括:
将内存控制器(Memory Controller)和物理接口(PHY)从 XPU 计算 die 上移出,集成到 HBM 堆栈底部的 base die 中。
传统 HBM vs NVHBM 的架构差异
| 组件 | 传统 HBM(HBM3e/HBM4E) | NVHBM |
|---|---|---|
| 内存控制器位置 | XPU / GPU 计算 die 上 | HBM base die 内 |
| 接口标准 | JEDEC 标准总线 | NVIDIA 定制的 die-to-die 私有链路 |
| PHY 面积占用 | 计算 die 上占用大量面积 | base die 上集成,计算 die 接口缩减 |
| 带宽(宣称) | HBM4E 基准 | +30% |
| 功耗(宣称) | HBM4E 基准 | -15% |
| 计算 die 释放面积 | --- | +25% |
关键要点
- NVIDIA 不制造内存:三星、SK hynix、美光等内存厂商负责制造,但 base die 的逻辑设计(含控制器、PHY)由 NVIDIA 主导定义。
- 首个合作伙伴:Amazon 的 Annapurna Labs,将在 Trainium4 芯片上采用。
- 目标场景:主要为 NVLink Fusion 合作伙伴的定制 AI 加速器(XPU),但 NVIDIA 也表示未来自家 GPU(如 Rubin Ultra / Feynman 架构)会采用同方向的内存技术。
二、NVHBM 架构下,L2 Cache 放在哪里?
直接回答:L2 Cache 仍然保留在 XPU 计算 die 上,不在 HBM base die 上。
1. 当前架构的明确证据
从 NVIDIA 已公开的 Blackwell 系列 die shot 和架构文档来看:
| 芯片 | L2 Cache 位置 | 容量 | 说明 |
|---|---|---|---|
| GB203 (RTX 5080) | 计算 die 中央 | 65 MB | 论文实测,unified L2 |
| GB202 (RTX 5090) | 计算 die 中央 | 96--128 MB | die shot 显示 L2 位于 die 中心,分多个 2MB block |
| B200 (数据中心) | 每个计算 die 上 | ~64 MB/die (共 126 MB) | 双 die 封装,每 die 一个 L2 partition,经 LTC fabric 互联 |
NVHBM 当前披露的信息仅涉及内存控制器和 PHY 的迁移,没有任何资料表明 L2 Cache 被移到 HBM base die。
2. 为什么 L2 Cache 不可能/不适合放在 HBM base die 上?
L2 Cache 与 Memory Controller 在架构中扮演完全不同的角色,物理位置的要求也截然不同:
| 特性 | L2 Cache | Memory Controller |
|---|---|---|
| 功能 | 缓存热点数据,减少 SM 访问内存的延迟 | 管理 HBM 的读写时序、刷新、bank 调度 |
| 延迟要求 | 极低(~200--360 周期,约 100--150 ns) | 相对较高,可容忍数百 ns 级调度延迟 |
| 物理位置要求 | 必须与 SM/GPC 紧密耦合(片上 SRAM) | 可以与 DRAM 堆栈集成 |
| 容量密度 | 小容量(几十 MB),用 SRAM(面积昂贵、速度快) | 控制逻辑,无需大容量存储 |
| 访问频率 | 每个内存请求都需先查 L2 | 仅在 L2 miss 后发起 HBM 访问 |
如果把 L2 放到 HBM base die:
- 延迟爆炸:数据需从 SM 穿过 interposer → base die → L2 → 返回,延迟会从 ~200 周期暴涨到接近 HBM 延迟(~600--900 周期),L2 失去意义。
- 带宽瓶颈:L2 需要为所有 SM 提供 TB/s 级别的聚合带宽,HBM base die 的接口无法支撑这种双向高频访问。
- SRAM 工艺限制:L2 使用高速度、低功耗的 SRAM,通常与计算单元共用先进逻辑工艺(如 TSMC 4nm)。HBM base die 传统上使用较成熟的逻辑工艺,且以面积为代价堆叠 DRAM,不适合做高速 SRAM。
3. NVHBM 到底改变了什么?
NVHBM 的架构变化可以简化为以下层级:
┌─────────────────────────────────────┐
│         XPU / GPU 计算 die           │
│  ┌─────┐ ┌─────┐      ┌──────────┐ │
│  │ SM  │ │ SM  │ ...  │  L2 Cache│ │  ← L2 仍在计算 die 上
│  │ GPC │ │ GPC │      │ (SRAM)   │ │
│  └──┬──┘ └──┬──┘      └────┬─────┘ │
│     └───────┴──────────────┘        │
│              │ (LTC Fabric)          │
│         ┌────┴────┐                 │
│         │ 窄接口  │  ← 传统:宽 HBM PHY │
│         │(NVHBM)  │     NVHBM:精简 PHY │
│         └────┬────┘                 │
└──────────────┼──────────────────────┘
               │ (interposer / substrate)
┌──────────────┼──────────────────────┐
│   HBM 堆栈   │                      │
│  ┌───────────┴───────────┐          │
│  │  DRAM 层 (多层 TSV)    │          │
│  │  DRAM 层              │          │
│  │  ...                  │          │
│  ├───────────────────────┤          │
│  │  **Base Die**          │          │
│  │  ┌─────────────────┐  │          │
│  │  │ **Memory Ctrl**  │  │  ← NVHBM 的核心变化
│  │  │ **+ PHY**        │  │     控制器移到这里
│  │  └─────────────────┘  │          │
│  └───────────────────────┘          │
└─────────────────────────────────────┘
4. 容易混淆的概念:HBM base die 上的 SRAM buffer
值得注意的是,学术界有一些研究方案 (如三星在 HBF 相关的论文中提到的设计)探索在 HBM base die 上放置 40MB 级别的 SRAM latency-hiding buffer 。但这属于研究性质的"延迟隐藏缓冲区"或"近内存计算"方案,与 NVIDIA NVHBM 不是同一回事。NVHBM 的官方描述中从未提及在 base die 上集成 L2 或 SRAM cache。
三、总结
| 问题 | 答案 |
|---|---|
| NVHBM 是什么? | NVIDIA 将 内存控制器 + PHY 从计算 die 移到 HBM base die 的定制内存架构 |
| L2 Cache 在 NVHBM 中放哪了? | 仍在 XPU 计算 die 上,位置未变 |
| HBM base die 上有什么? | 内存控制器、PHY、可能的管理逻辑,没有 L2 Cache |
| 为什么 L2 不能放 base die? | 延迟、带宽、SRAM 工艺三重限制,会彻底丧失缓存意义 |
如果您关注的是 B200 双 die 结构中的 L2 partition (每个计算 die 一个 L2,通过 LTC fabric 互联),这与 NVHBM 无关,而是 多 chiplet GPU 的片上互联设计。每个计算 die 上的 L2 仍然服务于该 die 内的 GPC/SM,且同一个 HBM 变量在特定时刻只会缓存在其对应的 L2 partition 中(通过地址哈希映射),不会出现跨 die 的同一地址同时驻留两份 L2 副本(除非硬件一致性协议显式要求)。
通过微基准测试剖析 NVIDIA Blackwell 架构
摘要
科学研究的快速发展对计算能力提出了更高需求,而 GPU 正在部分满足这一需求。本文通过精心设计的微基准测试,对现代 NVIDIA Blackwell 架构进行了微架构分析。我们揭示了关键子系统,包括内存层次结构、SM 执行流水线以及 SM 子核心单元,其中包含支持 FP4 和 FP6 精度的第五代张量核心。为了理解 NVIDIA GPU 的不同关键特性,我们研究了延迟、吞吐量、缓存行为和调度细节,揭示了 Blackwell 设计中微妙的调优指标。为了进行全面分析,我们分别使用 GeForce RTX 5080 和 H100 PCIe 对 Blackwell 架构与前代 Hopper 架构进行了对比。我们评估并比较了结果,展示了代际改进和性能回归。此外,我们还研究了在不同工作负载下功耗效率和能量消耗的作用。我们的发现为应用开发者、编译器编写者和性能工程师提供了可操作的见解,帮助他们在基于 Blackwell 的平台上优化工作负载,并为日益增长的 GPU 架构研究贡献了新数据。
关键词 --- Blackwell、GPU、微基准测试、HPC
I. 引言
随着人工智能(AI)的最新快速发展,GPU 已成为加速机器学习和高性能计算(HPC)工作负载的重要资源。其大规模并行架构使其非常适合跨多个领域的广泛应用。计算能力的显著提升使得过去需要数天甚至数年才能完成的应用,现在可以在数小时或数分钟内解决。这一转变凸显了在科学和工业研究中对强大、高效 GPU 的日益增长的需求。
在过去十年中,这些硬件加速器变得越来越具有竞争力。NVIDIA、AMD、英特尔和谷歌等厂商都推出了专门的加速器,从张量处理单元(TPU)到定制 GPU,以满足特定的计算需求。面对如此广泛的选择,一个自然的问题浮出水面:我们如何确定哪种架构最适合给定的工作负载?
许多研究人员已经开发了各种工具和方法来提供解决方案。应用分析 1、屋顶线模型 2、分析性能建模 3 和缓存停滞预测 4 等等,都已被用于为这些加速器提供洞察,以获得特定应用的最佳性能。不过,另一种方法涉及在微架构层面剖析 GPU 架构,以识别计算相关的特性。然而,这一策略往往受到现代商业 GPU 公开文档缺乏的阻碍,这限制了对深入分析的深度。
学术研究已经研究了 NVIDIA 早期架构的内部工作原理 5--9。NVIDIA 的 Hopper(芯片名 GH100)10 和 Blackwell(芯片名 GB203)11 架构代表了其设计的两个极端。GH100 针对大规模 AI 训练和科学模拟 12 进行了优化,而 GB203 则面向功耗受限环境中的实时光图形和推理工作负载 13。尽管这些 GPU 共享相似的布局,但它们在硬件配置和内存层次结构方面存在显著差异。
本文基于共享内存、L1 和 L2 缓存行为、核心执行流水线和张量核心指令吞吐量等真实世界性能子系统,对 GH100 和 GB203 GPU 进行了微架构比较。我们的工作通过用 PTX 和 CUDA 设计的微基准测试,提供了对这些架构在压力下的行为(尤其是在计算受限和内存受限的应用中)的细微但重要差异的连贯分析。
这一比较的一个独特方面体现在这些 GPU 的预期用途上。GH100 配备 HBM2e 内存和高 SM 数量,专为 AI 训练中的最大吞吐量和数据局部性而定制。另一方面,GB203 用缓存大小和双精度能力换取更高的时钟频率和消费级 GPU 内的效率。通过分析每种架构对指令级并行性、内存合并模式和 warp 调度压力的响应,我们旨在为应用开发者、性能工程师和编译器创建者提供关于 NVIDIA Blackwell 架构的可扩展性和专业化的核心原则的实用洞察。
本工作的主要贡献如下:
• 开发一组新的微基准测试,以评估 NVIDIA Blackwell 架构的关键组件,并与前代 Hopper 架构 GPU 进行对比。
• 深入分析内存层次结构和流式多处理器(SM)子单元,包括下一代张量核心、统一的 INT32/FP32 核心和 FP64 执行核心。
• 为软件及应用开发者提供性能指导,使其能够有效利用硬件的丰富优势。
• 探索 Blackwell 张量核心中新支持的低精度浮点数据类型 FP4 和 FP6 的行为及性能影响。
由于盲审政策,我们目前无法共享代码,但我们计划在审稿流程及结果结束后将其开源。
II. 相关工作
理解 GPU 性能长期以来一直是 HPC 研究的关键焦点。多年来,多项研究使用微基准测试和其他类型的基准测试来观察抽象层并详细分析 GPU 架构。早期工作如 5、6 专注于 NVIDIA Tesla 和 Fermi 等第一代 GPU 架构。这些工作侧重于分析内存访问模式和评估缓存层次结构,为至今仍使用的许多基准测试策略奠定了基础。
随着新架构的出现,分析目标转向了 Kelper 14、Maxwell 15 和 Pascal,通常关注 warp 调度、指令延迟和内存合并行为。随着 Turing、Volta、Ampere 和 Hopper 架构的发布,研究 8、9、16--21 转向评估混合精度单元和张量核心性能。这些工作引入了探测 mma 指令延迟、瓦片大小和数据布局的微基准测试。一些研究还涉及指令级并行(ILP)22,考察 GPU 流水线在高寄存器压力或深层嵌套循环下的行为。与此同时,Hong 和 Kim 3 开发了 GPU 架构的分析模型。这为 Accel-Sim 23 和 GCoM 24 等工具奠定了基础,使其能够通过模拟架构行为为现代 GPU 开发实现。虽然功能强大,但这些工具通常需要详细的硬件理解,或缺乏对 Blackwell 等新架构引入的新指令的支持。尽管最近大型语言模型(LLM)似乎可用于模拟 GPU 上的代码执行,但对微架构的理解仍然是改进 GPU 上代码执行模拟的必要工作 25。
尽管已有这些现有工作,但关于 Blackwell 特定架构特性的公开发表内容很少。我们的工作旨在填补这一空白。据我们所知,我们的工作首次提供了对 Blackwell 核心子系统(包括 FP64 执行、低精度 MMA 单元以及共享内存、L1 和 L2 缓存的内存吞吐量)的详细微基准测试研究。通过基于现有工作并将基准测试方法扩展到 Blackwell 的新特性,我们为不断发展的 GPU 性能分析领域贡献了新的见解。
III. Blackwell 架构概述
尽管 GB203 基于 GH100,但它们代表了两种设计理念。GH100 ------ NVIDIA Hopper 架构 GPU 芯片 ------ 针对大规模 AI 和科学计算工作负载进行了优化,而 GB203 作为 Blackwell 架构的一部分,是一种高能效、面向消费者的 GPU 设计,用于支持游戏、渲染和小批量推理任务。两者都实现了类似的 CUDA 核心编程模型,但在指令集、执行单元数量、内存层次结构和资源调度方面存在差异。
1) SM 和执行流水线: 两种架构的核心都是流式多处理器(SM),它负责 warp 调度、指令发射和执行。虽然高级 SM 设计保持相似,但表 I 显示了若干差异。Blackwell 引入了 warp 调度的改进,减少了发散工作负载的 warp 分派延迟。另一方面,GH100 为训练规模的工作负载提供了更大的执行吞吐量和更大的片上缓冲。
| 特性 | GH100 | GB203 |
|---|---|---|
| 架构 | Hopper | Blackwell |
| GPU 名称 | H100 PCIe | RTX GeForce 5080 |
| 每 SM FP32 数量 | 128 | 统一 INT32/FP32 单元 |
| 每 SM INT32 数量 | 64 | 统一 INT32/FP32 单元 |
| 每 SM FP64 数量 | 64 | 2 |
| 张量核心 | 第四代 | 第五代(支持 FP4 和 FP6) |
| Transformer 引擎 | 第一代 | 第二代 |
表 I GH100 和 GB203 GPU 的执行单元
2) 缓存层次结构: 两款 GPU 之间的显著差异在于缓存和内存子系统。表 II 显示了详细对比,GB203 通过增加 L2 带宽来弥补其较小的 L1。GH100 的 HBM 支持更大的批量大小和工作集容量,有助于训练大型模型。
| 内存单元 | GH100 | GB203 |
|---|---|---|
| L0 指令缓存 | 独立分区 | 统一 |
| 寄存器文件大小 (KB/SM) | 256 | 256 |
| L1 缓存大小 (KB/SM) | 256 (统一) | 128 (统一) |
| 共享内存大小 (KB/SM) | 228 (统一) | (统一) |
| L2 缓存 (大小 MB/SM) | 50 (2 个分区) | 65 (1 个分区) |
| 全局内存 (GB) | 80 (HBM2e) | 16 (GDDR7) |
表 II GH100 和 GB203 的缓存层次结构和分区大小
3) 张量与 AI 加速: 张量核心是专门设计用于加速矩阵操作的单元。Hopper 引入了支持 FP8 工作负载的第四代张量核心,而 Blackwell 则进化为第五代,扩展了对 FP4/FP6 格式的支持,同时保持对 FP8 工作负载的支持。
4) 指令集和软件兼容性: 借助 Hopper 架构,通过 PTX 和 CUDA 11.8 支持 wgmma 等张量核心指令和 FP8 运算。它们保持与传统 mma 和 CUDA C++ 指令的向后兼容性。CUDA 12.8 和 PTX 8.7 扩展了对 Blackwell 第五代张量核心指令的支持,包括 tcgen05 和增强的操作数类型,支持 FP4 和 FP6 格式。尽管 Hopper 的 wgmma 指令与 Blackwell 不兼容,但可以使用新的 tcgen05 指令进行 warp 组计算。
总之,GH100 是一种针对训练优化的架构,拥有庞大的内存资源,而 GB203 则专注于在热约束条件下最大化能效。尽管存在差异,两者在微架构上具有相似性,可以采用共享的基准测试策略。
本文后续章节通过针对性的微基准测试和分析,深入剖析 Hopper H100 PCIe(GH100 芯片)和 Blackwell GeForce RTX 5080(GB203 芯片)GPU 的这些特性。本文深入分析了 Blackwell,同时也展示了与前代架构的对比。
IV. 计算流水线
GPU 上的大部分计算由计算流水线完成,而该流水线的中心是 SM。SM 负责分配计算资源、调度指令和移动数据。为了完成这一任务,每个 SM 包含四个执行单元分区或子核心,用于整数、浮点和张量运算。这些子核心的排列和硬件实现可以提升或阻碍应用性能。理解这些资源可以帮助开发者改进其应用,同时充分利用 GPU。为了对 GB203 和 GH100 进行全面评估,我们采用以下指标和分析:
1) 延迟: 指一条指令产生结果供后续指令使用的时钟周期数。我们测量真实延迟(True latency),即串行的、存在依赖关系的指令链。它反映了在没有并行性或重叠情况下的数据就绪延迟。当有一组独立指令被允许重叠和并行化时,这称为完成延迟(Completion latency)。两种形式的延迟都以每条指令的时钟周期数(#时钟周期/#指令)报告。
2) 吞吐量/带宽: 基于测量的运行时间和指令数,以每时钟周期每 SM 完成的指令数来衡量。
我们用 PTX 指令和 CUDA 编写了微基准测试。我们不是在 CUDA 文件中编写内联指令,而是在单独的文件中编写 PTX 内核,这些内核将在运行时使用编译后的 CUDA 文件执行。这些单独的 PTX 内核文件防止了对代码的编译时优化。为了确认 PTX 指令在运行时没有被优化,我们审查了每个 PTX 内核文件生成的 SASS 代码,以确认指令没有被优化。
| GPU | 纯 INT32 | 纯 FP32 | 混合 1 | 混合 2 | 纯 FP64 |
|---|---|---|---|---|---|
| GB203 | 4/16.97 | 4/7.97 | 15.96/14 | 26.28/18 | 63.57/11 |
| GH100 | 4/16.69 | 4/7.86 | 31.62/16 | 43.54/20 | 8.04/13 |
表 III GH100 与 GB203 延迟结果(真实延迟/完成延迟)
A. 时钟开销
所有时钟周期都使用 %clock64 测量,这是一个预定义的只读特殊寄存器,在读取时返回时钟周期的计数值 26。例如,清单 1 在指令前后取计数器的值,然后相减得到测量的时钟周期数。
.reg .u64 %start, %end;
ld.param.u64 %time_ptr, [param_time];
mov.u64 %start, %clock64;
mad.lo.s32 r1, r1, r2, r3;
mov.u64 %end, %clock64;
图 1. 测量 mad.lo.s32 指令时钟周期的 PTX 代码
在 GB203 上,如果寄存器之间没有指令,相减值为 1,而 GH100 为 2。此外,当包装一组指令组合(即混合工作负载)时,该值取决于指令,这可以为指令工作流程提供洞察。
B. INT 和 FP32 执行单元
在 Volta 和 Ampere 等早期架构中,INT32 和 FP32 指令通过独立的执行流水线发出,当工作负载由一种类型主导时,往往导致次优的利用率 7。
在 GB203 中,NVIDIA 包含了可以处理 INT32 和 FP32 指令的统一执行单元,能够基于指令混合进行动态调度。这潜在地减少了空闲周期并提高了混合工作负载的吞吐量。然而,统一核心在任何时钟周期内只能用作 INT32 或 FP32 操作。这在混合 INT32/FP32 工作负载期间可能产生冒险。
为了准确测试这些统一核心的功能,我们使用 PTX 指令 fma 和 mad 分别对 FP32 和 INT32 进行了标准算术和整数操作测试。我们比较了三组内核的结果:(A) 纯 INT32,(B) 纯 FP32,和 © 混合 INT32/FP32 指令,以代表利用两种操作的混合工作负载。每个工作负载执行 1024 次并取平均值,以提供对这些核心无噪声的理解。
我们的测量显示,两种 GPU 上纯 INT32 和 FP32 工作负载的真实延迟均为 4 个周期。GH100 在纯内核上的完成延迟略好。尽管 GH100 对 INT32 和 FP32 操作使用独立的执行流水线,但我们观察到 GH100 在执行混合指令序列时表现不如 GB203,见表 III。这表明 Blackwell 上的统一 INT32/FP32 执行核心引入了更高效的计算流水线。需要提及的是,GB203 在首次运行期间对纯内核和混合内核有更高的真实延迟和完成延迟,这没有出现在表 III 的结果中。其他研究也排除了类似结果 27,因为在缓存预热前错过了缓存访问。不过,这在 Hopper 运行中并未出现。
Blackwell 架构在混合工作负载中显示出延迟改进,而 Hopper 在纯指令工作负载中表现更好。
C. FP64 执行单元
双精度(FP64)执行单元对于需要高数值精度的工作负载至关重要,例如科学模拟。虽然 AI 和图形应用越来越依赖低精度格式(FP16、BF16、FP8 等),但 FP64 仍然是 HPC 和研究领域的关键特性。GH100 和 GB203 各自包含一组专用的 FP64 执行单元,在物理上与 INT32/FP32 单元分离。这种分离允许调度器独立发出 FP64 指令。GB203 芯片每个 SM 有两个 FP64 执行单元,而 GH100 有 64 个,见表 I。
我们的微基准测试显示了预期结果,表 III 显示 GH100 对 1024 条 FP64 依赖指令的延迟低于 GB203。当只执行两条依赖指令时,GB203 的延迟降低到 37.5 个周期。通常,运行更多指令会隐藏延迟,但在此情况下只有两个执行单元。这表明这两个单元仅用于类型和指令支持,而计算旨在通过其他精度模拟,即使用 FP32 执行单元或张量核心。
这些见解对于希望在数据中心和消费级 GPU 之间实现可移植性能的用户尤为重要,因为了解 FP64 瓶颈可以为精度权衡或算法设计提供信息。
D. Warp 调度器行为和发射模型
为了评估 warp 调度敏感性和依赖链下的延迟处理,我们实现了一个串行依赖指令基准测试,其中每个线程为每个执行单元执行一串寄存器中的依赖算术操作。图 2 和图 3 显示了我们将每条线程的依赖指令数量从 1 增加到 1024 时的结果(显示 1 到 64 的结果)。为了确保总周期数和吞吐量的公平比较,我们通过调整每条链长的循环迭代次数来控制执行的指令总数。
如图 3 所示,吞吐量在最初的 1-9 条指令中稳步增加,之后流水线在不同架构之间出现差异,并且对于所有 INT32、FP32 和 FP64 工作负载都有逐步改善。短依赖链的低吞吐量是由于每条线程内的 ILP 不足,这限制了 GPU 隐藏指令延迟的能力。依赖指令较少时,线程很快停滞,调度器无法充分利用执行单元,导致性能较低。随着链长增加,调度器可以更好地重叠执行并隐藏延迟,提高吞吐量。
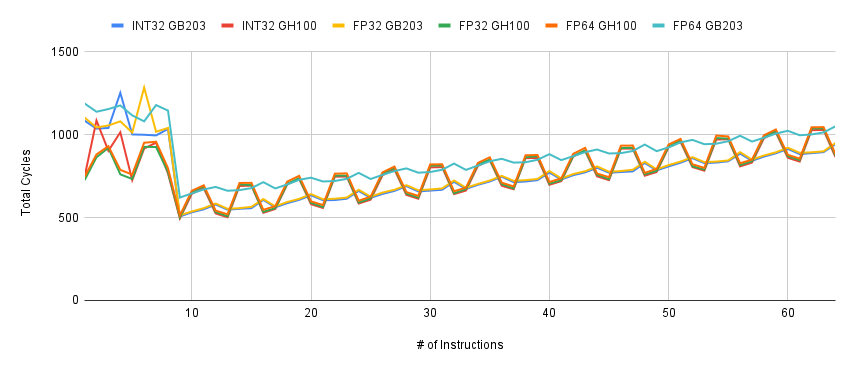
Fig. 2: Comparing Total Cycles vs Iterations of the GB203 and GH100 GPUs with INT32, FP32, and FP64 workloads.
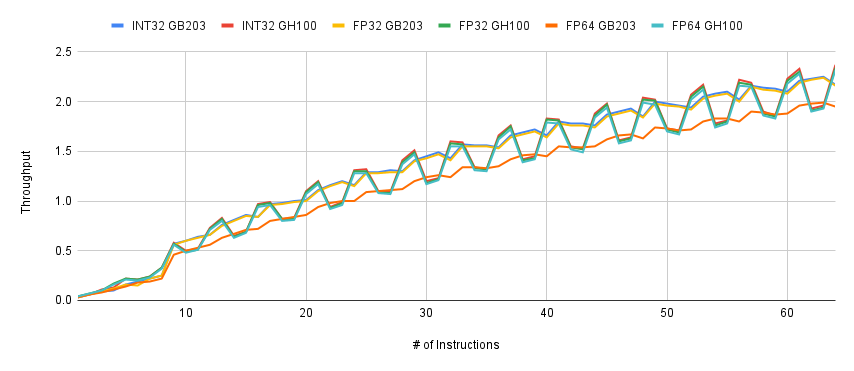
Fig. 3: Comparing Throughput vs Iterations of the GB203 and GH100 GPUs with INT32, FP32, and FP64 workloads.
值得注意的是,与 GH100 更不规则的增长相比,GB203 表现出更平稳、更一致的吞吐量增长。不过,GB203 在 FP64 指令上的吞吐量低于 INT32 或 FP32 对应项。
类似地,图 2 显示 GH100 在 8 条指令之前实现了更低的总周期数,表明在短依赖链下更有效的延迟隐藏,相比 GB203。8 条指令之后,两种架构的总周期数都急剧下降,可能是由于指令调度预热或流水线效应。不过,与吞吐量类似,GH100 在指令数增加时总周期数更加不稳定。
GH100 在少量依赖指令上的略好吞吐量可能是由于更深的指令缓冲和更激进的 warp 调度器,能够在压力高时容忍指令依赖。然而,激进的调度也可能在更高指令数期间引入不稳定性。另一方面,GB203 更稳定的进展表明更保守的发射策略。不过,少量依赖指令期间更高的总周期数确实需要更多分析。
虽然两种 GPU 总体性能相当,但 GH100 容忍短延迟受限指令序列,而 GB203 针对更规则的高 ILP 内核进行了优化。
V. 第五代张量核心
张量核心在 Volta 架构中引入,是专门设计用于加速矩阵乘法的单元,这是深度学习和科学计算中的基础操作。
为了充分利用这些张量核心,使用矩阵乘法操作的内核,如矩阵乘法累加(MMA)。为了观察 GB203 和 GH100 的行为,我们的自定义 PTX 微基准测试测量执行延迟、吞吐量和操作数暂存行为。本节评估 GB203 和 GH100 张量核心的能力、ILP 和变化的 warp 数量。
A. 指令集和支持的数据类型
第五代 GB203 和第四代 GH100 张量核心都支持具有不同数据类型、操作数处理和性能调优的指令。表 IV 比较了第四代和第五代张量核心之间支持的指令和数据类型精度。
Blackwell 中的第五代引入了新的数据类型(FP4 和 FP6),在 CUDA 中以新的 SASS 级指令(如 OMMA、QMMA)实现,反映了硬件对低精度格式的支持。另一方面,Hopper 提供对 wgmma 指令的支持,启用 warp 组异步矩阵操作,但缺乏 FP4 和 FP6 支持。
| GB203 (5th-Gen) | GH100 (4th-Gen) | |
|---|---|---|
| 支持的数据类型 | FP4, FP6, FP8, INT8, FP16, BF16, TF32, FP64 | FP8, INT8, FP16, BF16, TF32, FP64 |
| MMA 指令 | mma, wmma, tcgen05 | mma, wmma, wgmma |
表 IV 张量核心支持的数据类型和 mma 指令。TCGEN05 尚未在 arch sm_120a 上支持。
B. 可变 MMA 和基于瓦片的指令
尽管 GB203 不支持 wgmma 指令,且 tcgen05 指令尚未在 GB203 上实现,但 NVIDIA 在两种 GPU 中都使用各自的数据类型实现了 mma 指令,用于张量核心分析。
矩阵乘法累加(MMA)操作使 GEMM 和深度学习工作负载能够进行矩阵计算。每条 mma 指令指定一个瓦片形状,记为 M×N×K,它决定了每个 warp 或每个线程组处理的矩阵片段的维度。例如,等式 1 中的指令使用 16×32(M×K)和 32×8(K×N)输入计算 16×8(M×N)的输出瓦片。
mma.sync.aligned.m16n8k32.f32.f16.f16.f32还有其他各种支持的瓦片形状,如 m8n8k16 或 m16n8k64,支持更细的粒度或每次指令发出更大的操作数重用。除了瓦片形状,mma 指令还支持各种输入/输出精度,包括但不限于 FP4、FP8、FP16 和 FP32。这些数据类型在等式 1 中编码,其中 f16 和 f32 表示 FP16 输入与 FP32 累加和输出。
在 Blackwell 的新指令集 CUDA 12.9 中,必须在 PTX 指令上显式指定 .kind::f8f6f4 后缀,才能在 GB203 上使用 FP6 或 FP4 mma 操作。尝试在 GH100 上使用这些格式,或没有 kind 说明符时,会导致 PTX 错误。表 V 显示了在我们的微基准测试中,经过 mma.sync.aligned.kind::f8f6f4 使用的跨精度格式的矩阵形状和 PTX 指令。
| 格式 | D-类型 | PTX 指令 |
|---|---|---|
| e2m1 | FP4 | .m16n8k32.row.col.f32.e2m1.e2m1.f32 |
| e3m2 | FP6 | .m16n8k32.row.col.f32.e3m2.e3m2.f32 |
| e2m3 | FP6 | .m16n8k32.row.col.f32.e2m3.e2m3.f32 |
| e4m3 | FP8 | .m16n8k32.row.col.f32.e4m3.e4m3.f32 |
| e5m2 | FP8 | .m16n8k32.row.col.f32.e5m2.e5m2.f32 |
表 V 第四代和第五代张量核心上使用 mma 指令测试的支持数据类型(D-类型)对比。e8m0 仅用于块中的缩放指数,因此未测试 26。
通过我们的实验,PTX 级的 mma.sync 指令被翻译成 OMMA、QMMA 或 HMMA SASS 指令。通过观察 GH100 上生成的 SASS 指令,我们发现每个 mma.sync 对每个数据类型都使用 HMMA 指令。对于 Blackwell,CUDA Binary Utilities 12.9 文档 28 规定 QMMA 用于跨 warp 的 FP8 矩阵乘法和累加,而 OMMA 用于跨 warp 的 FP4 矩阵乘法和累加。我们的微基准测试确认两种格式的 FP8 输入都使用新的 QMMA 指令,以及两种格式的 FP6 输入。虽然 FP4 输入的 mma 旨在使用 OMMA SASS 指令,但观察到的是 QMMA 指令。然而,当使用 FP8 ue8m0 作为缩放格式进行块缩放时,在 SASS 代码中观察到了 OMMA。这表明在当前软件中 QMMA 是 FP4 输入的后备方案。
总之,随着 NVIDIA 开始开发这些特性,软件支持有限,我们希望提供对这些流水线可用性的当前理解和深入分析。
C. 精度权衡
低精度格式用于减少内存占用并提高吞吐量,尤其是对于推理工作负载。上一节提到的支持数据类型(FP4、FP6、FP8)都有不同的格式,被认为是低精度。这些数据类型格式通过调整用于表示浮点数的指数位和尾数位数量来减少位数,因此需要在动态范围和精度之间进行权衡。
先前的工作致力于理解这些低精度格式的精度,在本节中我们将分析这些低精度格式在两种架构上的每瓦性能和功耗消耗。
| 数据格式 | Blackwell | Hopper |
|---|---|---|
| FP4 e2m1 | 16.753 | n/a |
| FP6 e2m3 | 39.383 | n/a |
| FP6 e3m2 | 46.723 | n/a |
| FP8 e4m3 | 46.661 | 55.823 |
| FP8 e5m2 | 46.806 | 55.786 |
表 VI Blackwell 和 Hopper 架构上各数据格式的功耗(瓦特)/每瓦性能
值得注意的是,表 VI 总结了我们对 GB203 和 GH100 的微基准测试结果。GH100 缺乏对 FP4 和 FP6 格式的原生支持,但在两种 FP8 格式下保持略高的功耗(约 55W),而 GB203 在相同格式下的最大功耗为 46W。功耗通常随精度降低而降低,FP4 实现最低功耗 16.75W,而 FP6 和 FP8 格式分别消耗超过 39W 和 46W。
这些结果表明 Blackwell 在低精度下的架构效率,并展示了数值表达能力与 mma 张量核心工作负载中能量消耗之间的权衡。
D. Warp 扩展和共享内存访问
通过我们实现的低精度输入 mma 微基准测试,我们改变 ILP 和 warp 数量来检查指令映射,并比较 GB203 和 GH100 的 warp 调度行为。
对于每种精度格式,在持续吞吐量下实现的最大 ILP 水平,随着 warp 数量的减少,GH100 为 ILP=5 且 29 个活跃 warp,GB203 为 ILP=6 且 25 个活跃 warp。这意味着与 GH100 中较低的 ILP 扩展相比,Blackwell 能够为每个线程发出更多独立的 mma 指令。
当 ILP=1 且 warps=1 时,从指令发出到数据可用的周期数是完成延迟,GB203 所有精度格式为 1.21094 周期。GH100 完成延迟为 1.65625 周期,表明所有低精度格式的 mma 指令在各自架构上使用相同的执行流水线。类似地,GB203 在所有低精度格式上都比 GH100 实现更高的吞吐量,在 ILP=6 和 32 个活跃 warp 时峰值超过 11 TFLOP/s。这表明增加 ILP 显著提高了低 warp 数量下的吞吐量,证实了 Blackwell 的 warp 调度器在并发受限时有效利用 warp 内并行性。
我们对每种低精度格式的 ILP 延迟和吞吐量取平均值,以展示 Blackwell 和 Hopper 的趋势。如图 4 所示,GB203 在每个精度格式上都有改进的吞吐量。
类似地,图 5 展示了跨格式的延迟扩展。GB203 保持始终较低的延迟,特别是 FP4 和 FP6,而 GH100 在添加更多 warp 时经历阶梯式延迟增加,这是更深但不够灵活的调度队列的标志。这表明 GH100 需要更多在飞 warp 来饱和执行单元,而 GB203 在较少 warp 但更多独立指令时表现更好。总之,这些结果表明 Blackwell 的 warp 调度器针对低精度、高 ILP 工作负载和清晰控制流进行了优化,而 Hopper 依赖批量并发和更深的缓冲来维持较不规则条件下的性能。
这一比较表明 Blackwell 针对更高的每线程指令吞吐量进行了优化,而两者无论数据格式如何都具有相似的 warp 调度能力,反映了它们张量核心微架构中的不同权衡。
我们的方法可以作为评估未来架构上张量核心性能的参考框架,并强调了精度、吞吐量和 warp 级执行行为之间的关键权衡。
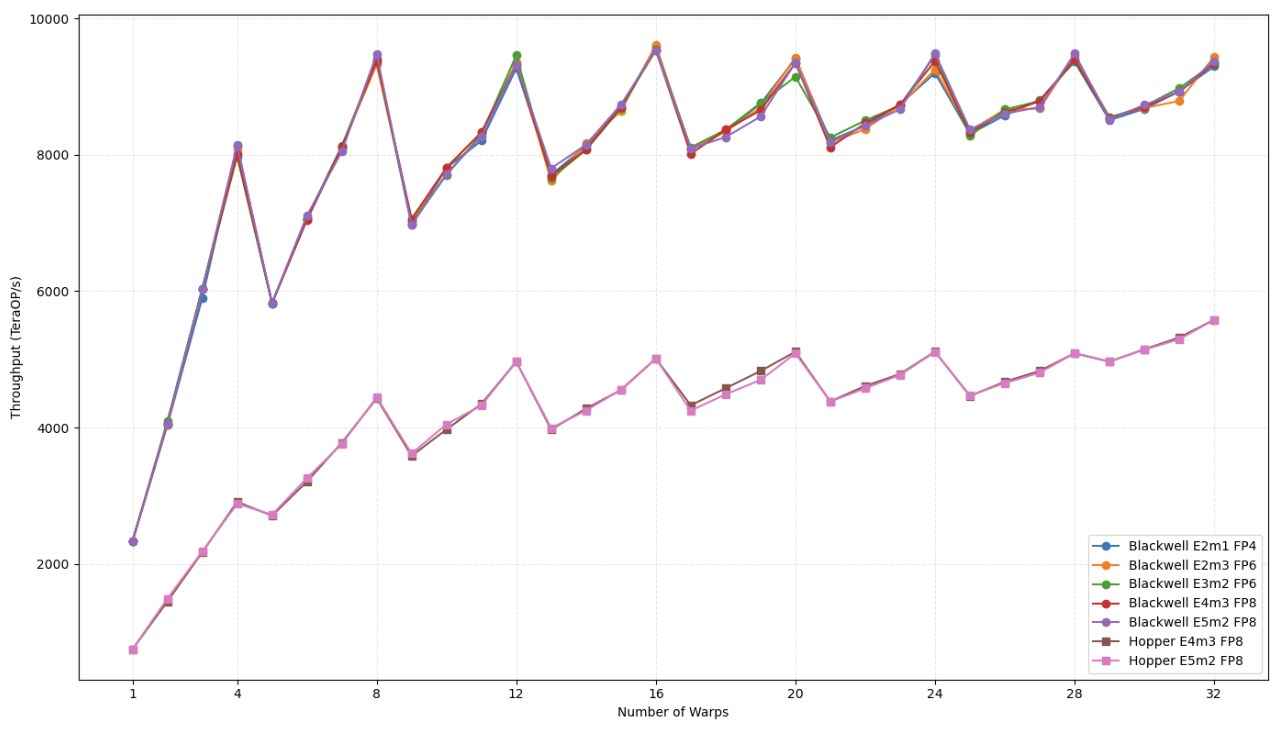
Fig. 4: Throughput of GB203 and GH100 with varying precision formats and warp counts.
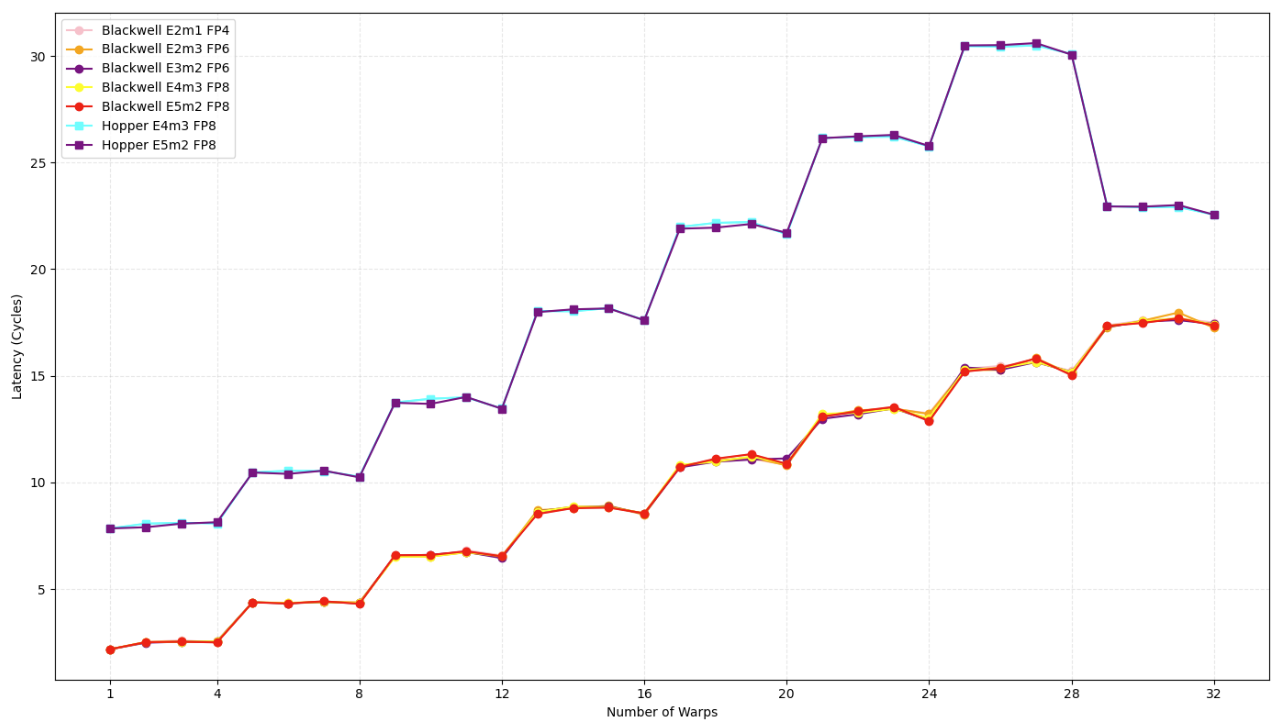
Fig. 5: Latency of the GB203 and GH100 with varying precision formats and warp counts.
VI. 内存子系统
GPU 性能越来越受内存子系统行为的限制,而非原始计算吞吐量。高效利用内存层次结构,包括共享内存、各级缓存和全局内存,对于实现架构效率至关重要。虽然 GH100 和 GB203 采用相似的内存布局,但它们在延迟、带宽和容量方面表现出不同的权衡。
本节通过微基准测试方法对内存子系统进行了比较评估,测量延迟、饱和行为和对访问模式的敏感性。
A. 内存层次结构概述
本研究专注于设备级内存访问,不包括主机-设备传输性能,后者严重受系统互连影响(即 PCIe 与 NVLink)。GPU 内存访问模式针对全局内存、共享内存和硬件管理的缓存层(L2、L1、L0 指令缓存),以及寄存器文件。
为了隔离延迟特性,我们采用指针追踪微基准测试进行随机串行内存访问。图 6 展示了 GB203 和 GH100 在数据大小增加时的延迟(以周期为单位)。
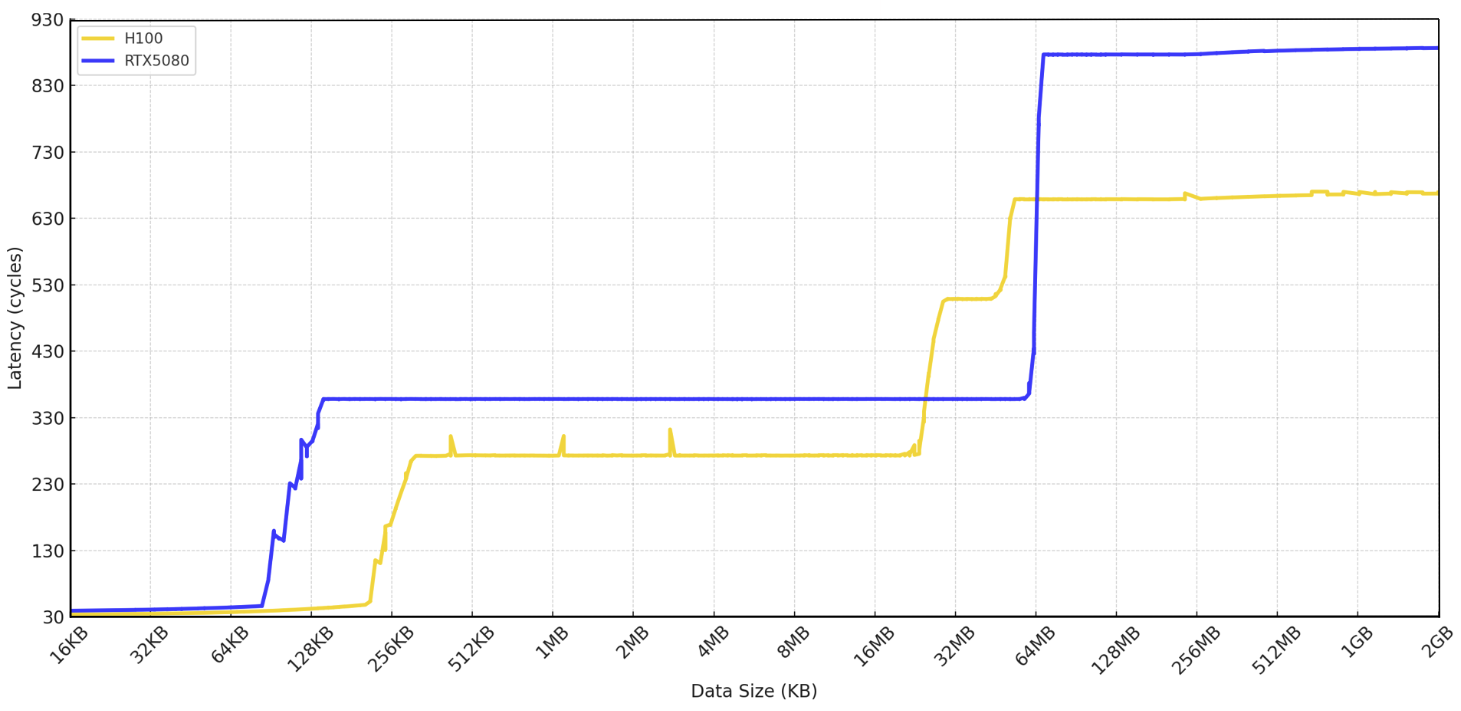
Fig. 6: Latency in cycles of the memory hierarchy on the GB203 and GH100.
三个缓存区域:
- L1 缓存:跨度从 0 到(约 128KB 或约 256KB)
- L2 缓存:从 L1 结束到(约 30 MB 或约 60MB)
- 全局内存:超出 L2 缓存
延迟峰值对应缓存边界,与架构规范一致(表 II)。
B. 共享内存和 L1 缓存行为
现代 NVIDIA GPU 在每个 SM 中将共享内存和 L1 缓存在统一的内存空间中结合。为了评估这种统一设计在 GB203 和 GH100 芯片上的性能和特性,我们开发了微基准测试来测量访问延迟趋势、存储体冲突敏感性和 warp 扩展行为。
从图 6 的指针追踪基准测试可以看出,两种 GPU 在 L1 缓存区域表现出几乎相同的延迟,保持在 30-40 周期,表明硬件管理数据路径中的命中延迟相似。尽管架构不同,这表明 L1 访问路径经过良好优化。
然而,缓存容量差异显著。GH100 每个 SM 具有高达 256 KB 的组合 L1/共享内存,而 GB203 将其减少到 128 KB/SM。
GH100 和 GB203 向软件暴露这部分内存的可配置部分作为共享内存。使用 cudaFuncSetAttribute 和 cudaFuncAttributeMaxDynamicSharedMemorySize 属性的动态分配,我们确定可配置的共享内存限制在 GH100 上约为 227 KB/SM,在 GB203 上约为 99 KB/SM。没有动态分配时,默认静态共享内存限制在两种架构上都保持 48 KB/SM。
为了探索访问行为,我们设计了两个微基准测试。对于共享内存,我们访问具有可配置步幅和 warp 数量的静态声明 __shared__ 数组。类似地,对于 L1 缓存,我们通过 __restrict__ float* gmem 访问全局内存,工作集设计为适合 L1 缓存容量并通过步幅加载引发冲突。
两个基准测试都从 1 到 32 个 warp 和步幅大小 1 和 4 进行扫描,每次 32 次内存访问。每个测试重复 1024 次,并记录中值延迟。
图 7 展示了共享内存延迟如何随 warp 数量增加而扩展。对于两种步幅,GB203 在低 warp 数量(1-4 个 warp)下表现出更低的延迟,表明在轻负载下有更优化的路径。然而,GH100 在更高 warp 压力(6--32 个 warp)下表现更好,可能是由于其更大的共享内存容量,但也可能来自更稳健的存储体冲突缓解,可能是通过多端口存储体或 warp 感知调度等微架构增强实现的。
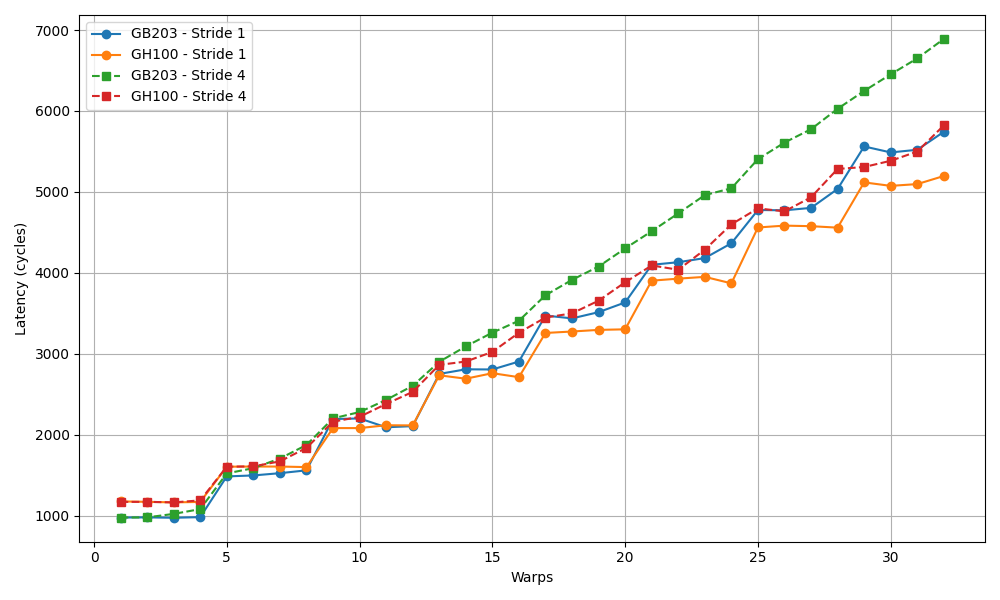
Fig. 7: Latency comparison of GH100 and GB203 with Shared Memory.
在步幅为 4 时,GH100 保持更平滑的扩展和更高 warp 级别下的更低延迟,表明对访问偏斜有更好的容忍度。相比之下,GB203 在步幅为 4 时表现出更陡峭的延迟增加,可能是由于其较小内存分区的存储体争用和饱和。
图 8 展示了更多 warp 访问 L1 缓存时的延迟趋势。虽然两种架构在首次访问时都显示延迟增加,但 GB203 在步幅为 1 时从 2-11 个 warp 保持略低的延迟。与共享内存相比,L1 延迟在 warp 数量步进间保持更平坦,特别是在 GH100 上,可能是由于空间局部性和 L1 对冲突的更高容忍度。然而,在 GB203 上步幅为 4 时,延迟增加更急剧,表明即使 L1 对步幅不如共享内存敏感,访问偏斜仍会影响性能,特别是在容易饱和的较低内存分区上。
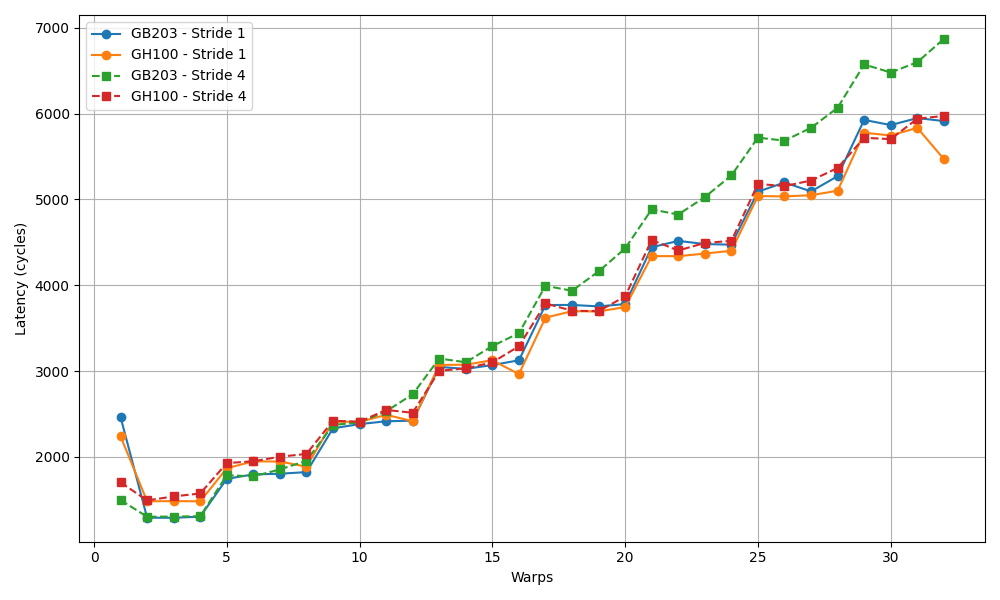
Fig. 8: Latency comparison of GH100 and GB203 with L1 Cache.
总体而言,共享内存延迟对 warp 数量和访问步幅高度敏感,特别是在 GB203 上,存储体冲突更积极地扩展。相比之下,L1 缓存表现出更好的弹性,随着 warp 增加延迟更稳定。共享内存和 L1 缓存延迟在 32 个 warp 时相遇。GH100 更大的统一内存和更平滑的 warp 扩展使其在具有密集重用的高线程内核中具有优势。另一方面,GB203 改进了低延迟访问路径和冲突解决。这些结果展示了 GB203 在 warp 扩展内核设计方面的改进,尽管该芯片仍受内存分区限制。
C. L2 缓存
GH100 和 GB203 GPU 中的 L2 缓存架构反映了两种不同的设计,特别是在处理分区以及负载下扩展方面。L2 缓存位于全局内存和 SM 之间,是最大的片上内存块。
在 GH100 中,L2 缓存分为两个独立分区,每个分区服务于一部分 GPC。这种分区设计支持更好的数据局部性和跨缓存访问的并行性。相比之下,GB203 采用由所有 GPC 共享的单一 L2 缓存。这种统一方法简化了全局内存路由和一致性,并可以改善小型或面向图形的工作负载的空间局部性。然而,当许多 SM 同时发出未缓存或流式内存访问时,它也可能导致更大的争用。
延迟测量突出了这些差异。对于标准 L2 命中,GB203 表现出约 358 周期的固定延迟,而 GH100 实现了约 273 周期的更低延迟。GH100 的这种延迟优势可能源于其分区设计,该设计通过将访问分布到两个单元来减少争用。然而,随着内存需求增长,GH100 的优势减弱:当两个分区都饱和时,对于 31 MB 到 45 MB 的内存大小,延迟增加到约 508 周期。相比之下,由于其更大的总 L2 容量(65 MB,而 GH100 为 50 MB),GB203 在更大的内存占用范围内保持其基线延迟。
为了理解这些架构在 warp 级并发下的表现,我们开发了一个微基准测试,每个线程发出 1024 次全局内存加载/存储操作,并跟踪每个 warp 的周期时间。这种设置使我们能够评估 L2 吞吐量如何随 warp 数量增加而扩展。
图 9 显示,在低 warp 数量(1-4)时,GH100 始终提供更好的性能,每个 warp 的平均周期时间约为 43.5k,而 GB203 为 49k。这种差异不仅反映了 GH100 更快的 L2 延迟,还反映了其更深的 warp 调度器流水线和更高效的缓冲。
在 8-16 warp 范围内,GH100 保持其优势,性能下降最小,而 GB203 开始显示饱和迹象,在 16 个 warp 时达到约 66k 周期。这表明 GB203 的单一 L2 接口随着并发内存压力增长而成为瓶颈。
有趣的是,在高 warp 数量(16-32)时,GB203 追赶上来,最终在 20 个 warp 时略微超过 GH100。在 32 个 warp 时,GB203 每个 warp 完成基准测试约 128.4k 周期,而 GH100 为约 128.9k。这种转变反映了 GB203 在极端负载下更高的聚合 L2 带宽,可能是其更大缓存大小和减少分区开销的结果。虽然 GH100 在中低并发水平下提供一致的性能和确定性的 warp 调度,但它在满压力下达到吞吐量上限,受其分区仲裁限制。
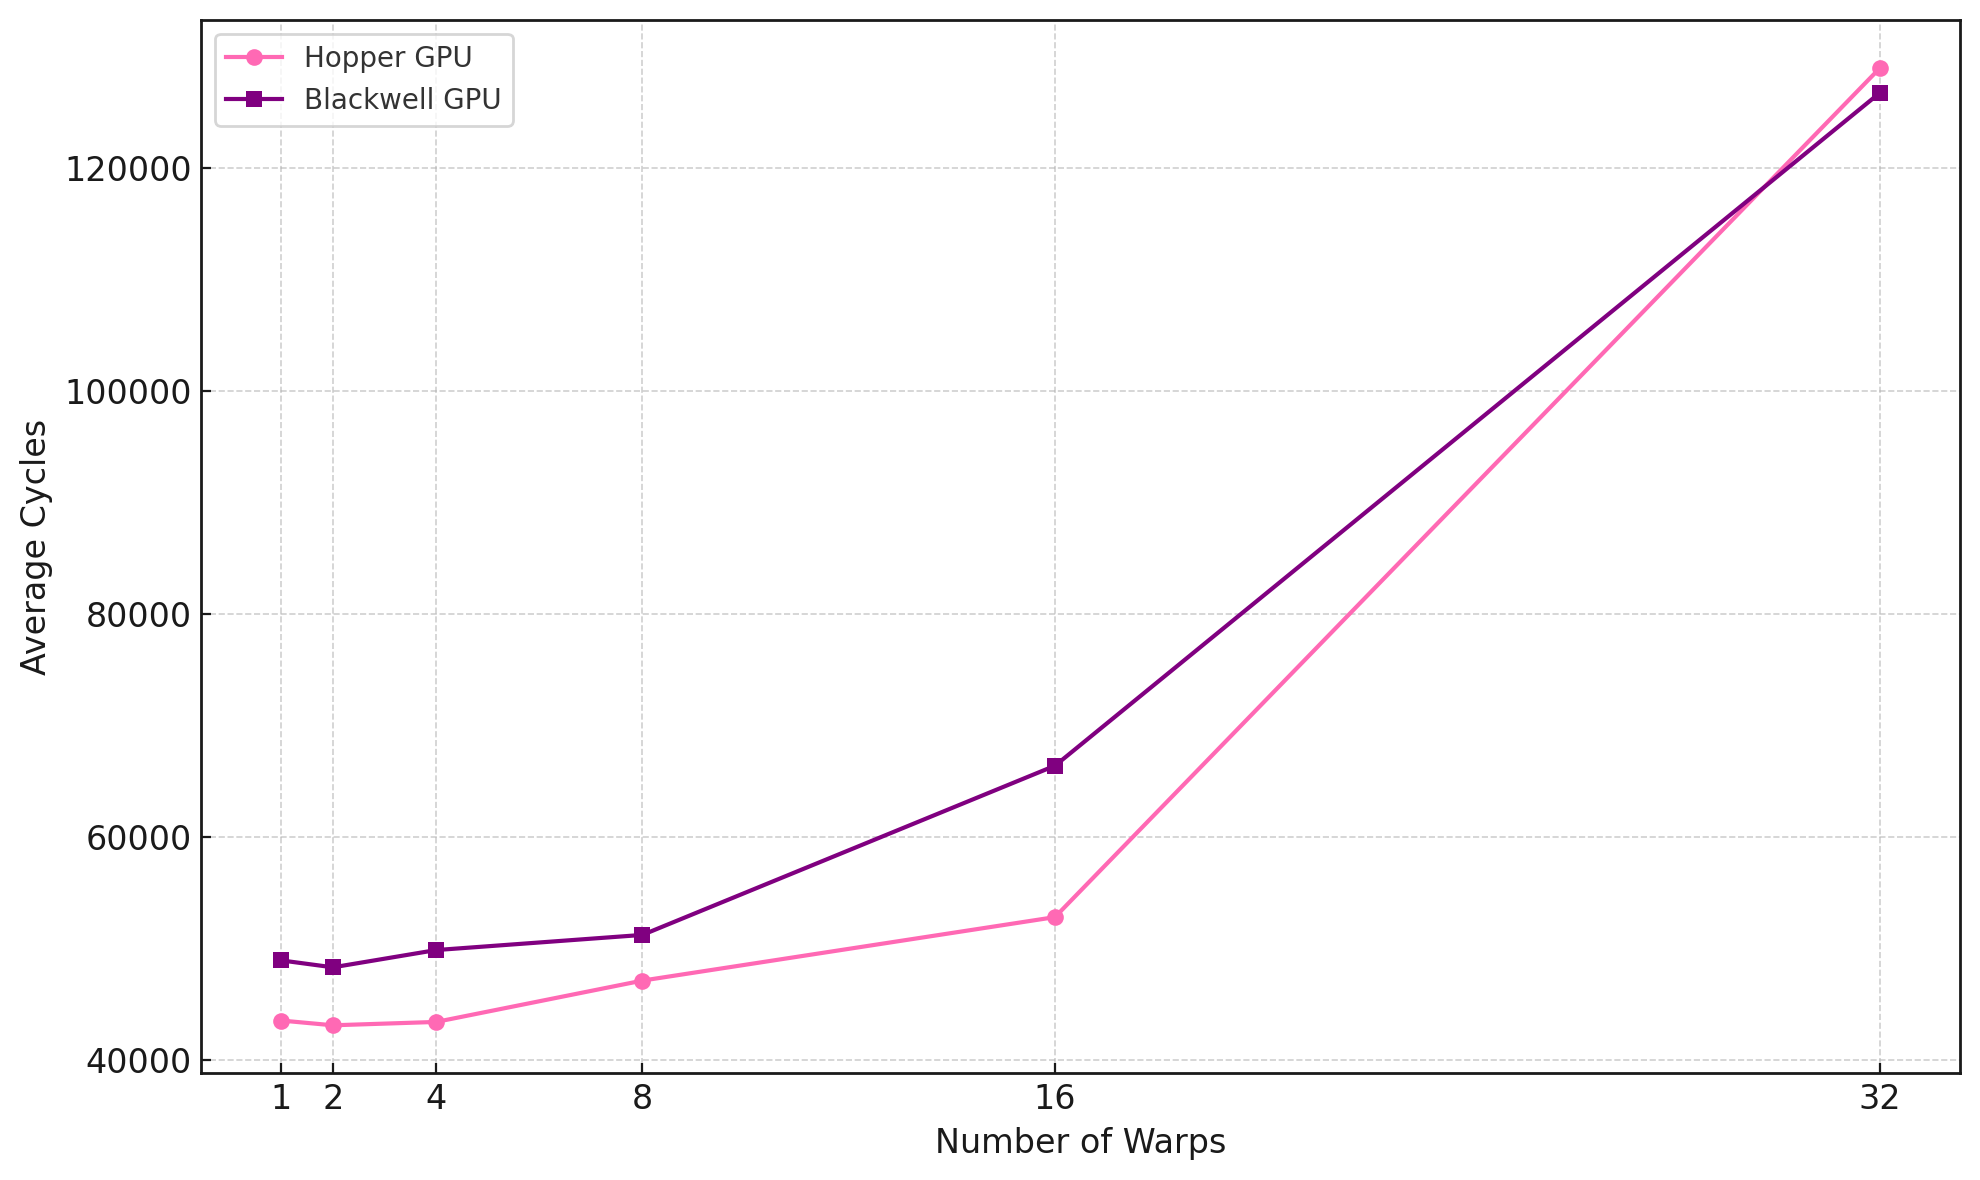
Fig. 9: L2 cache latency with warp scaling.
这些趋势表明,由于其激进的 warp 调度和分区缓存布局,GH100 更适合在中等并发下运行的延迟敏感和动态工作负载。另一方面,GB203 在完全利用率下提供卓越性能,使其更适合大规模、带宽受限的应用,如深度学习推理或密集矩阵操作。
总之,GH100 的分区 L2 架构针对高并发和计算密集型服务器级工作负载进行了优化。GB203 的统一 L2 设计简化了硬件复杂性,有利于混合计算-图形用例。在针对内存受限内核调优特定性能目标时,无论是优先考虑延迟、吞吐量还是数据局部性,都必须考虑这些架构权衡。
D. 全局内存
我们将分析扩展到全局内存带宽,使用一系列持续传输基准测试。如图 10 所示,GH100 实现了 15.8 TB/s 的峰值读取带宽,远高于 GB203 的 8.2 TB/s。两种架构的写入带宽都较低,GH100 为 2.2 TB/s,GB203 为 1.6 TB/s,这展示了面向读取密集型工作负载的架构设计。可能是由于更窄的回写路径或不够激进的写入合并。图 6 中观察到的延迟趋势表明,全局内存访问在 71 MB(GB203)和 55 MB(GH100)之后开始,相应延迟约为 876.7 周期和约 658.7 周期。GH100 优越的延迟性能归因于其使用 HBM2e,与 GB203 的 GDDR7 相比,HBM2e 提供更高的带宽和更低的延迟。
虽然 Blackwell 架构在内存调度和子系统设计方面引入了显著增强,但这些变化可能导致不规则或延迟敏感工作负载的一致性降低。
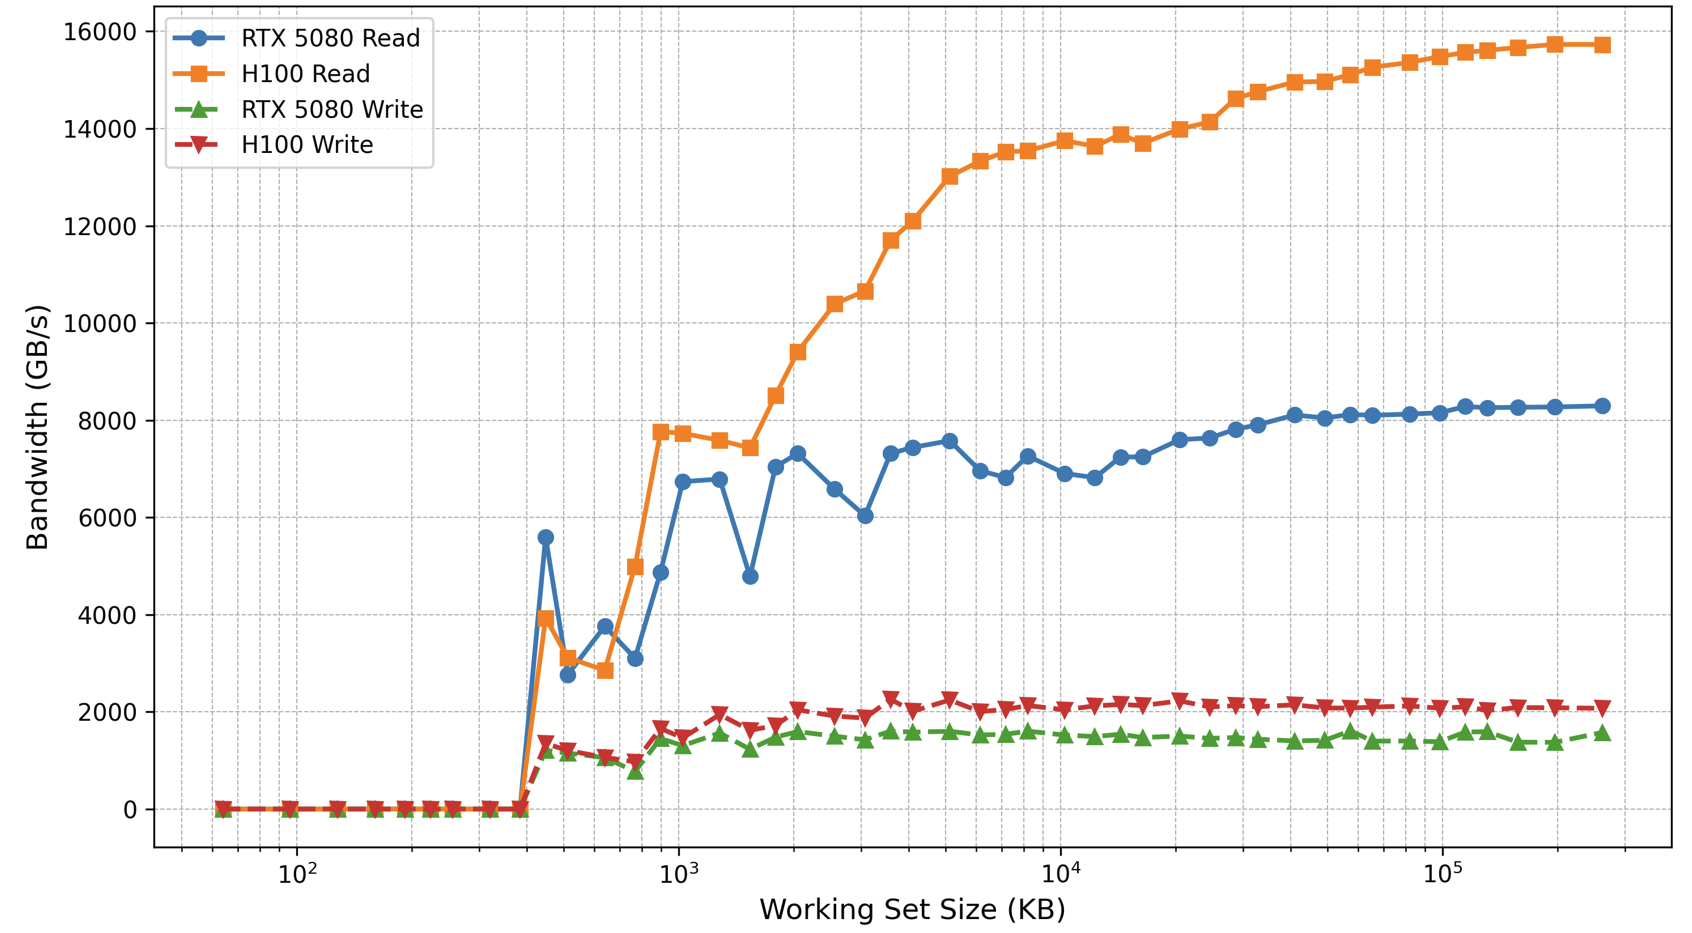
Fig. 10: GB203 and GH100 throughput of the memory hierarchy.
VII. 微基准测试案例研究
为了评估 GH100 和 GB203 之间的微架构差异如何影响实际性能,我们实现了一组代表性的 GPU 内核,涵盖关键应用领域。这些案例研究架起了合成基准测试与实际性能行为之间的桥梁,使我们能够评估内存层次结构、warp 调度和张量核心在真实执行环境中如何交互。
A. 密集 GEMM
密集通用矩阵乘法(D-GEMM)内核几乎利用了计算流水线的每个阶段,从共享内存操作数暂存、寄存器使用、warp 调度到张量核心利用。我们使用 NVIDIA 的 cuBLASLt API 和 nv_fp8_e4m3 数据类型评估了带有 FP8 输入的 D-GEMM 内核。我们的内核执行融合矩阵乘法和累加,形式为 D = A^T * B + C,其中 A 和 B 为 FP8,C 表示为 bfloat16,D 存储在 FP8 中。
目标是评估不同矩阵大小下的计算吞吐量和功耗行为,不仅比较 GH100 和 GB203,还与前面章节的低层 PTX 微基准测试进行比较。
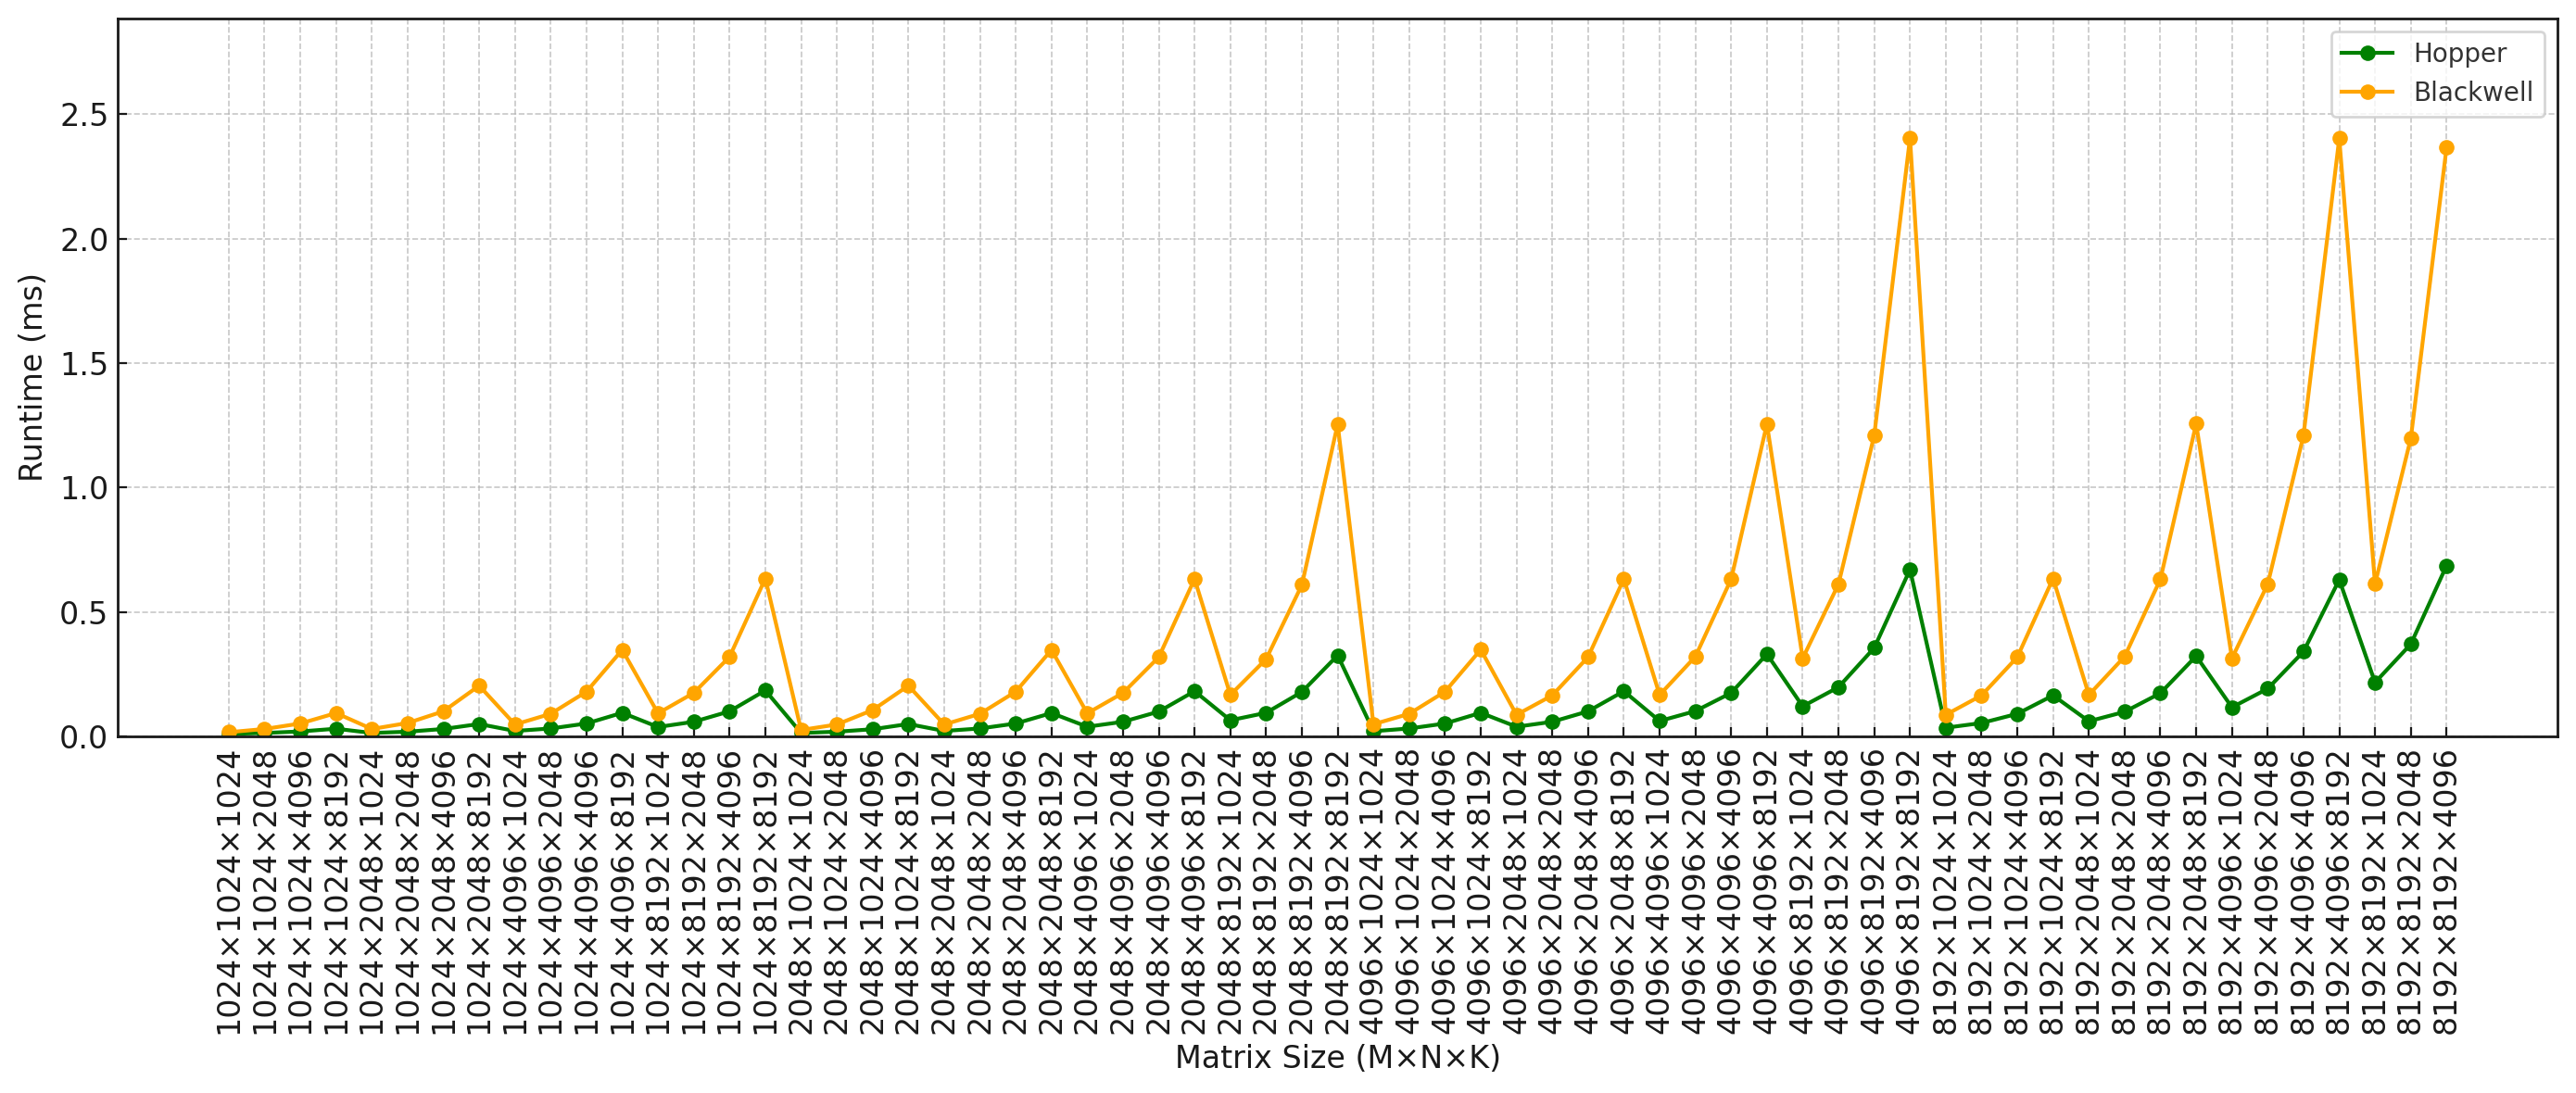
Fig. 11: The runtime (ms) of each execution size (M×N×K) on both the Hopper H100 and the Blackwell RTX 5080 GPUs. The M=N=K=8192 kernel runtime was 4.710 ms for the Blackwell GPU, omitted from the graph.
GEMM 内核使用 32 MB 工作空间进行基准测试。我们使用 nvidia-smi 测量功耗和效率。每种配置执行 100 次,取平均值,并跨大小(1024、2048、4096、8192)重复。图 11 显示了两种 GPU 跨矩阵大小(M×N×K)的运行时间比较。Hopper 始终优于 Blackwell,在几乎所有配置下都实现了更低的运行时间。随着矩阵大小增大,性能差距扩大,Blackwell 显示出显著的延迟峰值。这种不一致表明,尽管 FP8 有理论改进,但 Blackwell 上 FP8 GEMM 的内核选择或调度可能存在潜在不稳定性。Hopper 受益于更成熟的编译器启发式或大规模下的稳定调度。随着 Blackwell 延迟增加,表 VII 显示了选定矩阵大小的实现吞吐量(TFLOP/s),使用等式 2 计算。
TFLOPS = (2 × M × N × K) / runtimeHopper 在所有测试形状下始终提供更高的有效吞吐量。例如,在最大配置(8192×8192×8192)下,Hopper 达到 0.887 TFLOP/s,几乎是 Blackwell 0.233 TFLOP/s 的 4 倍。即使在较小尺寸如 1024×1024×1024 下,Hopper 也保持明显优势。虽然 Blackwell 理论上支持更高的 FP8 计算速率,但这些结果表明内核选择、内存层次结构利用或调度正在限制当前 RTX 5080 上的实际吞吐量。
图 12 比较了各矩阵大小下的平均功耗。我们对每种可变矩阵形状下各瓦片大小的功耗取平均值,因为每个瓦片大小的功耗相对相似。我们仍然可以看到不同矩阵形状下的功耗总体趋势。Hopper 保持相对平坦的功耗曲线,功耗约为 58-60W,即使在最大的 8192×8192×8192 矩阵大小下也仅在 68W 达到峰值。另一方面,Blackwell 显示出更高的可变性和更陡峭的功耗曲线,平均功耗超过 80W,峰值达到 114.4W。值得注意的是,当 N=K=8192 与其他大小结合使用时,功耗出现尖峰。此外,对于 512×512×512 矩阵大小,Blackwell 使用的功耗远低于 Hopper,表明 Blackwell 能够在流水线期间节省功耗,尽管这在其余矩阵大小中并未观察到。GB203 的更高功耗加上更低的吞吐量,导致大多数配置下的每瓦性能更低。
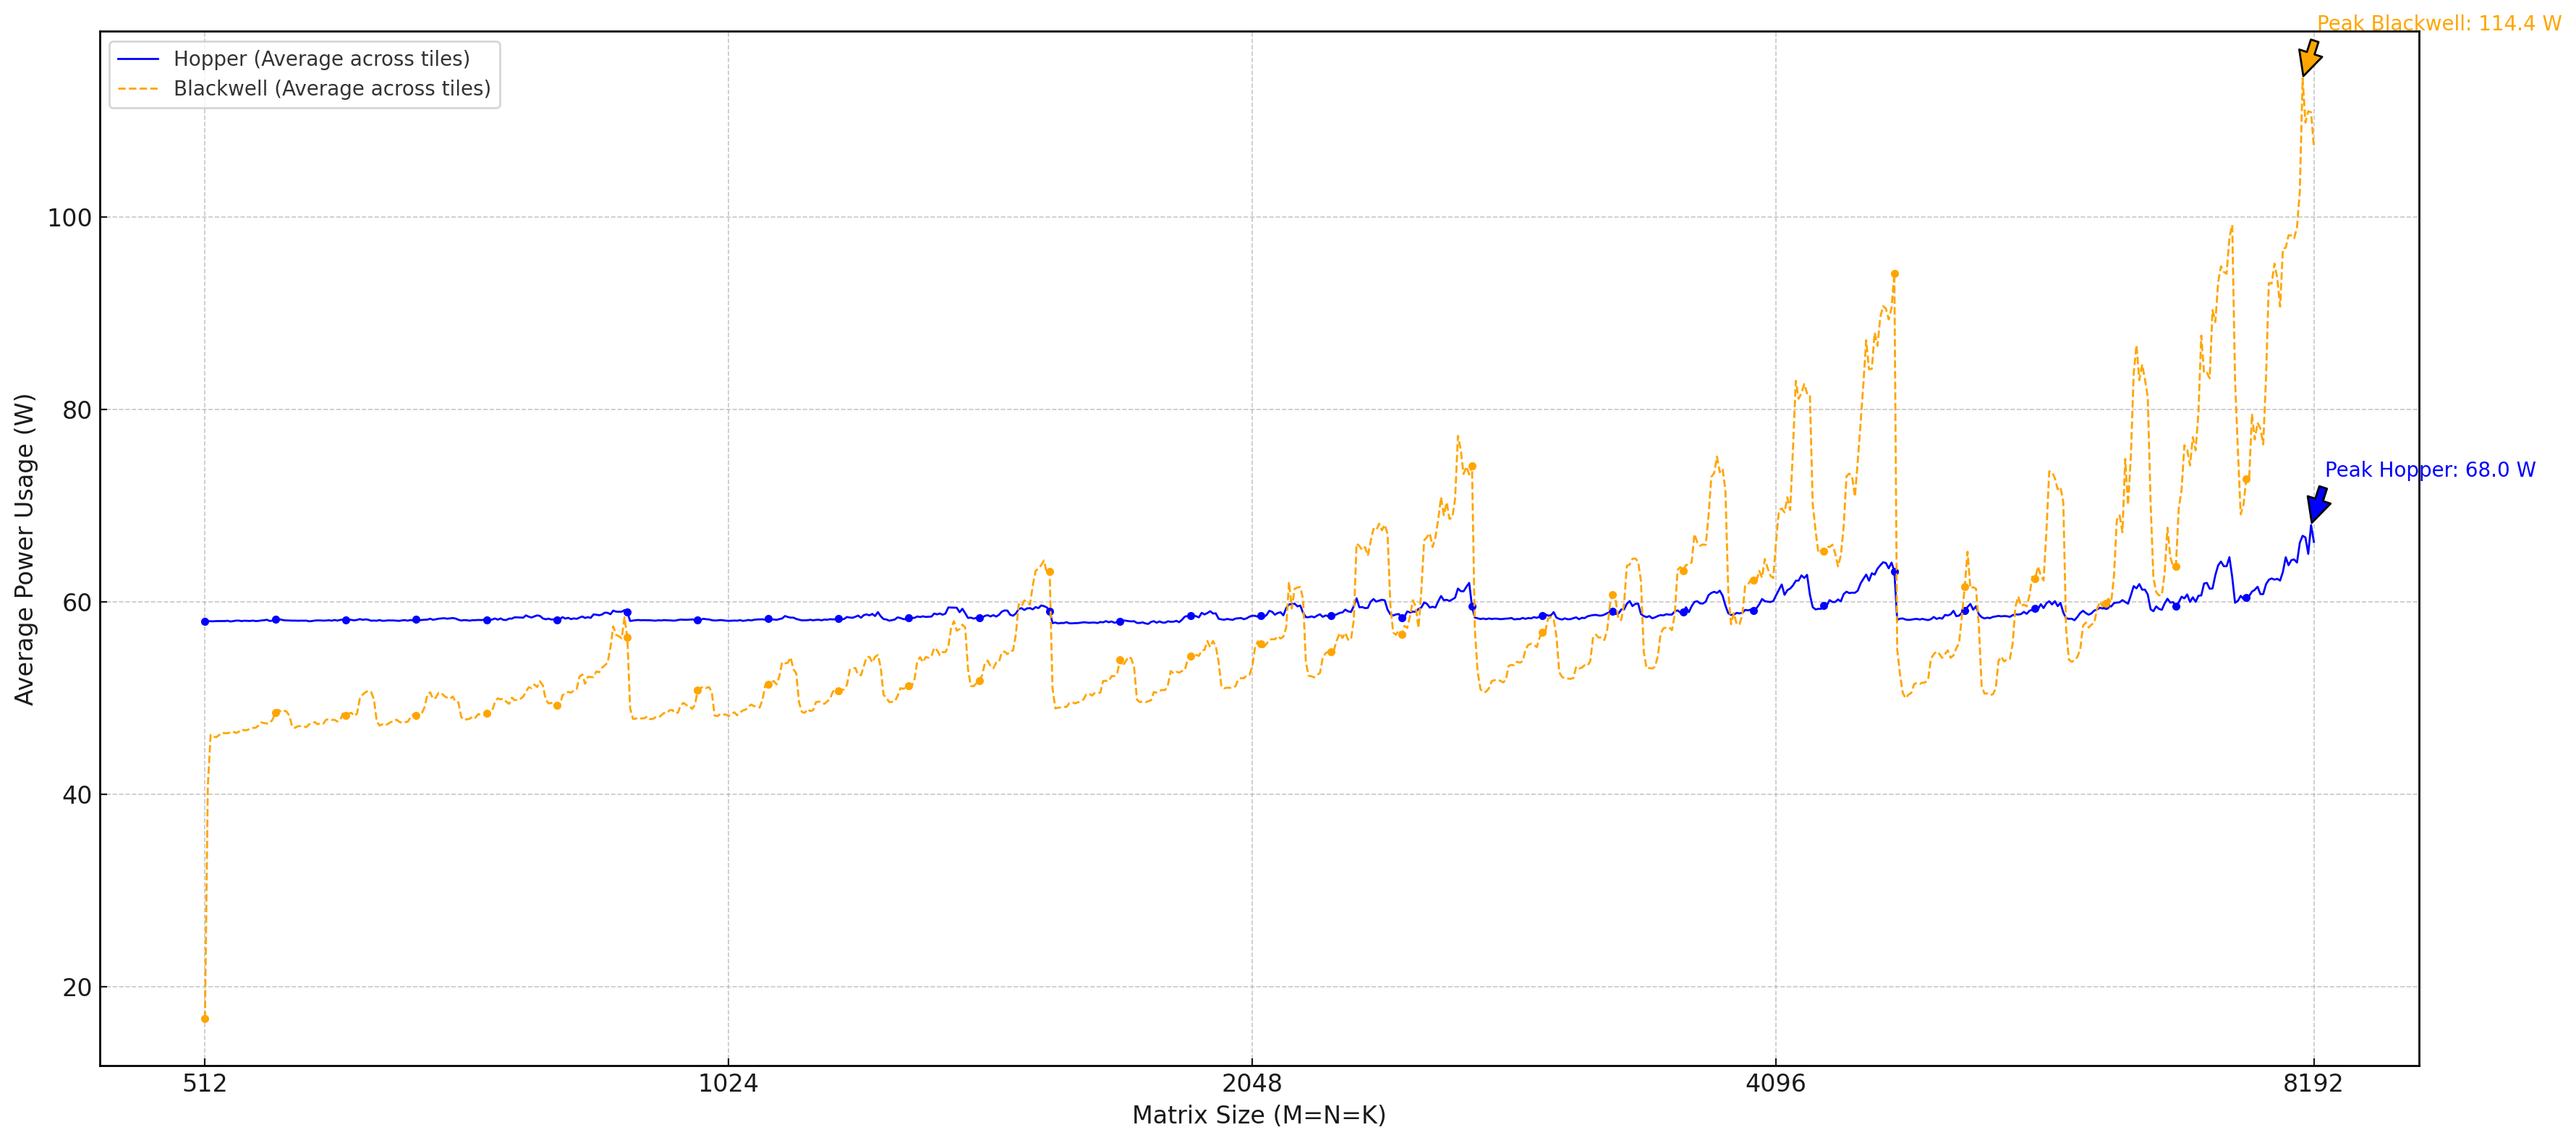
Fig. 12: The power consumption (W) of the program with each execution size (M=N=K) on both the Hopper H100 and the Blackwell RTX 5080 GPUs.
总体而言,虽然 Blackwell 的 RTX 5080 FP8 计算令人印象深刻,但在当前软件和内核实现下,密集 GEMM 的实际效率仍然更有利于 Hopper。
| 矩阵大小 | Hopper (TFLOP/s) | Blackwell (TFLOP/s) |
|---|---|---|
| 1024×1024×1024 | 0.342 | 0.298 |
| 2048×2048×2048 | 0.571 | 0.312 |
| 4096×4096×4096 | 0.743 | 0.267 |
| 8192×8192×8192 | 0.887 | 0.233 |
表 VII 选定矩阵大小的有效吞吐量
B. Transformer 推理
为了评估真实世界推理工作负载下的性能和能效,我们使用 TensorRT(NVIDIA 的优化框架 29)实现了 Transformer 推理案例研究。该测试通过整合内存密集型和延迟敏感型计算模式(如多头注意力、MLP 层、层归一化和 token 采样)来补充我们的密集 GEMM 基准测试。
我们选择 GPTneox 模型 30,因为它尺寸小且兼容 FP8 和 FP4 量化路径。模型以可变精度(best、normal、fp16、fp8)运行。TensorRT 使用最佳精度以获得性能,或使用默认精度集,对于 best 和 normal 精度似乎分别是 FP32 或 TF32。每次推理运行一百次,并对指标取平均值。表 VIII 显示 Blackwell GPU 受益于更好的功耗模型。Hopper 在各精度下保持 57-60W 的一致功耗,表明稳定的运行时效率。Blackwell 在精度降低时功耗下降更明显,从 FP32 的 58.8W 降至 FP8 的 45W,表明在降低精度下具有更好的扩展性或更低的利用率。有趣的是,"Best"配置(应反映 TensorRT 最高性能引擎)显示 Blackwell 功耗增加。
| 精度 | Hopper | Blackwell |
|---|---|---|
| FP32 | 60.24 | 58.82 |
| FP16 | 57.64 | 47.78 |
| FP8 | 57.69 | 45.14 |
| Best | 60.15 | 61.03 |
表 VIII 跨精度模型的平均推理功耗(瓦特)
总体而言,这表明 Hopper 在各格式下提供更稳定的功耗效率,而 Blackwell 可以针对具有更好功耗效率的竞争性推理工作负载进行调优。
VIII. 结论
本工作通过精心设计的微基准测试,对 NVIDIA Blackwell 架构(GB203 芯片)进行了详细的实验分析。通过与 Hopper(GH100 芯片)GPU 的微架构特性进行比较,我们提供了对 Blackwell 在内存层次结构、SM 执行流水线及其第五代张量核心方面进展的深入见解。
我们的分析突出了硬件对低精度格式(如 FP4 和 FP6)的增强支持,揭示了它们对功耗和性能效率的实际影响。本研究中提出的指南和观察结果为开发者提供了微架构层面的理解,帮助他们优化软件以有效利用硬件,从而实现 AI 和 HPC 工作负载的更高效部署。
致谢
我们感谢 NVIDIA 的 Nikhil Jain 与我们通信并解答问题。本研究使用了俄勒冈大学 Frank 集群的资源。本材料基于美国能源部在合同 DE-FOA-0003177 下支持的工作,S4PST:下一代科学软件技术项目。
参考文献
1 B. R. Coutinho, G. L. M. Teodoro, R. S. Oliveira, D. O. G. Neto, 和 R. A. C. Ferreira, "Profiling general purpose gpu applications," 2009 21st ISCA and HPC, 2009, pp. 11--18.
2 M. Leinhauser, R. Widera, S. Bastrakov, A. Debus, M. Bussmann, 和 S. Chandrasekaran, "Metrics and design of an instruction roofline model for amd gpus," 2021. Online. Available: https://arxiv.org/abs/2110.08221
3 S. Hong 和 H. Kim, "An analytical model for a gpu architecture with memory-level and thread-level parallelism awareness," SIGARCH Comput. Archit. News, vol. 37, no. 3, p. 152--163, Jun. 2009. Online. Available: https://doi.org/10.1145/1555815.1555775
4 W. Jia, K. A. Shaw, 和 M. Martonosi, "Characterizing and improving the use of demand-fetched caches in gpus," Proceedings of the 26th ACM International Conference on Supercomputing, ser. ICS '12. New York, NY, USA: ACM, 2012, p. 15--24. Online. Available: https://doi.org/10.1145/2304576.2304582
5 H. Wong, M.-M. Papadopoulou, M. Sadooghi-Alvandi, 和 A. Moshovos, "Demystifying gpu microarchitecture through microbenchmarking," 2010 ISPASS, 2010, pp. 235--246.
6 S. Subramoniapillai Ajeetha, "Architectural analysis and performance characterization of nvidia gpus using microbenchmarking," Ph.D. dissertation, The Ohio State University, 2012. Online. Available: http://rave.ohiolink.edu/etdc/view?acc_num=osu1344623484
7 Z. Jia, M. Maggioni, B. Staiger, 和 D. P. Scarpazza, "Dissecting the NVIDIA volta GPU architecture via microbenchmarking," CoRR, vol. 1804.06826, 2018. Online. Available: http://arxiv.org/abs/1804.06826
8 Z. Jia, M. Maggioni, J. Smith, 和 D. P. Scarpazza, "Dissecting the nvidia turing T4 GPU via microbenchmarking," CoRR, vol. 1903.07486, 2019. Online. Available: http://arxiv.org/abs/1903.07486
9 W. Luo, R. Fan, Z. Li, D. Du, H. Liu, Q. Wang, 和 X. Chu, "Dissecting the nvidia hopper architecture through microbenchmarking and multiple level analysis," 2025. Online. Available: https://arxiv.org/abs/2501.12084
10 NVIDIA Corporation, NVIDIA H100 Tensor Core GPU Architecture, NVIDIA, Mar. 2022. Online. Available: https://resources.nvidia.com/en-us-data-center-overview/gtc22-whitepaper-hopper
11 NVIDIA Corporation, NVIDIA Blackwell Architecture Technical Brief: Powering the New Era of Generative AI and Accelerated Computing, NVIDIA, Mar. 2024. Online. Available: https://resources.nvidia.com/en-us-blackwell-architecture
12 L. Fusco, M. Khalilov, M. Chrapek, G. Chukkapalli, T. Schulthess, 和 T. Hoefler, "Understanding data movement in tightly coupled heterogeneous systems: A case study with the grace hopper superchip," 2024. Online. Available: https://arxiv.org/abs/2408.11556
13 NVIDIA Corporation, NVIDIA RTX BLACKWELL GPU ARCHITECTURE, NVIDIA, 2025. Online. Available: https://images.nvidia.com/aem-dam/Solutions/geforce/blackwell/nvidia-rtx-blackwell-gpu-architecture.pdf
14 X. Zhang, G. Tan, S. Xue, J. Li, K. Zhou, 和 M. Chen, "Understanding the gpu microarchitecture to achieve bare-metal performance tuning," Proceedings of the 22nd ACM SIGPLAN SPPPP, ser. PPoPP '17. New York, NY, USA: ACM, 2017, p. 31--43. Online. Available: https://doi.org/10.1145/3018743.3018755
15 X. Mei 和 X. Chu, "Dissecting gpu memory hierarchy through microbenchmarking," IEEE TPDS, vol. 28, no. 1, pp. 72--86, 2017.
16 M. Fasi, N. J. Higham, M. Mikaitis, 和 S. Pranesh, "Numerical behavior of NVIDIA tensor cores," PeerJ Computer Science, vol. 7, p. e330, 2021. Online. Available: https://doi.org/10.7717/peerj-cs.330
17 G. Tan, L. Li, S. Triechle, E. Phillips, Y. Bao, 和 N. Sun, "Fast implementation of dgemm on fermi gpu," Proceedings of SC 2011, ser. SC '11. New York, NY, USA: ACM, 2011. Online. Available: https://doi.org/10.1145/2063384.2063431
18 S. Markidis, S. W. D. Chien, E. Laure, I. B. Peng, 和 J. S. Vetter, "Nvidia tensor core programmability, performance & precision," 2018 IEEE IPDPSW. IEEE, May 2018, p. 522--531. Online. Available: http://dx.doi.org/10.1109/IPDPSW.2018.00091
19 M. Martineau, P. Atkinson, 和 S. McIntosh-Smith, "Benchmarking the nvidia v100 gpu and tensor cores," Euro-Par 2018: Parallel Processing Workshops, G. Mencagli 等编辑. Cham: Springer International Publishing, 2019, pp. 444--455.
20 M. A. Raihan, N. Goli, 和 T. M. Aamodt, "Modeling deep learning accelerator enabled gpus," 2019 IEEE ISPASS, 2019, pp. 79--92.
21 D. Yan, W. Wang, 和 X. Chu, "Demystifying tensor cores to optimize half-precision matrix multiply," 2020 IEEE International Parallel and Distributed Processing Symposium (IPDPS), 2020, pp. 634--643.
22 W. Sun, A. Li, T. Geng, S. Stuijk, 和 H. Corporaal, "Dissecting tensor cores via microbenchmarks: Latency, throughput and numeric behaviors," IEEE TPDS, vol. 34, no. 1, pp. 246--261, 2023.
23 M. Khairy, Z. Shen, T. M. Aamodt, 和 T. G. Rogers, "Accel-sim: An extensible simulation framework for validated gpu modeling," 2020 ACM/IEEE 47th Annual International Symposium on Computer Architecture (ISCA), 2020, pp. 473--486.
24 J. Lee, Y. Ha, S. Lee, J. Woo, J. Lee, H. Jang, 和 Y. Kim, "Gcom: a detailed gpu core model for accurate analytical modeling of modern gpus," Proceedings of the 49th Annual ISCA, ser. ISCA '22. New York, NY, USA: ACM, 2022, p. 424--436. Online. Available: https://doi.org/10.1145/3470496.3527384
25 K. N. M. Nguyen, H. D. N. Do, H. T. Le, 和 T. T. Dao, "Llmperf: Gpu performance modeling meets large language models," 2025. Online. Available: https://arxiv.org/abs/2503.11244
26 NVIDIA Corporation, Parallel Thread Execution (PTX) ISA, Release 8.8, NVIDIA, 2025. Online. Available: https://docs.nvidia.com/cuda/pdf/ptx_isa_8.8.pdf
27 T. T. Dao, J. Kim, S. Seo, B. Egger, 和 J. Lee, "A performance model for gpus with caches," IEEE TPDS, vol. 26, no. 7, pp. 1800--1813, 2015.
28 NVIDIA Corporation, CUDA Binary Utilities - Instruction Set Reference, NVIDIA, 2025. Online. Available: https://docs.nvidia.com/cuda/cuda-binary-utilities/index.html
29 NVIDIA Corporation, NVIDIA TensorRT, https://developer.nvidia.com/tensorrt, 2024, version 10.0. Online. Available: https://developer.nvidia.com/tensorrt
30 S. Black, S. Biderman, E. Hallahan, Q. Anthony, L. Gao, L. Golding, H. He, C. Leahy, K. McDonell, J. Phang 等, "Gpt-neox-20b: An open-source autoregressive language model," arXiv preprint arXiv:2204.06745, 2022.