概述
官网,AWS推出的一项无服务器的数据集成服务,旨在帮助用户轻松发现、准备、移动和集成来自多个来源的数据。支持分析、机器学习和应用程序开发,提供强大的工具来编写、运行任务以及实施业务工作流程。
核心功能包括数据发现、现代ETL、数据清理和集中式数据编目。支持 ETL、ELT 和流式传输 等多种工作负载,并与AWS分析服务(如S3、Athena和Redshift Spectrum)无缝集成。支持按需扩展、所有数据类型和架构变化。用户仅需为实际使用的资源付费。
彻底免除用户对底层基础设施的管理负担,用户只需提交ETL作业,Glue会自动完成资源调度、启动与执行等一系列操作。
功能亮点
- 数据发现与编目:通过爬网程序自动推断数据架构,并将其集成到AWS Glue数据目录中,支持跨多个数据存储的统一搜索
- 数据转换与清理:提供基于图形界面的任务编辑器,支持通过简单的任务计划构建复杂的ETL管道,并利用内置机器学习功能去除重复数据
- 数据管道构建与监控:支持基于事件的触发器自动处理任务,动态扩展资源,并通过AWS CloudTrail和Spark UI进行监控
设计理念:
- 提供自定义能力:当系统本身不能完全满足用户需求时,允许用户通过编写代码自定义ETL流程,灵活应对各种场景
- 适配多样的分析环境:不强制用户使用统一的数据模型、类型系统或查询语言,而是允许用户从已有数据结构出发,逐步迁移或扩展新的应用和用例
- 最小化基础设施管理负担:通过无服务器架构,最大限度减少开发者在资源管理上的投入,提升整体生产效率
100多种不同的数据来源,
使用场景:
- 将数据加载到数据仓库
- 从本地数据库迁移到S3
- 流式数据摄取与处理
版本
1.0:基于集群的执行方式,面向批处理场景,采用集群启动模型,支持三种作业启动方式:
- 重用已有的预分配集群
- 从服务级预热池中分配集群
- 从EC2实例新建集群(冷启动)
作业必须在整个集群准备就绪后才能开始执行。为控制成本,空闲集群会在设定时间后被回收。热启动(方式1和2)通常在1分钟内启动;冷启动(方式3)则可能延迟8~10分钟。Glue 1.0的启动时延差异较大,体验不稳定。
2.0:秒级启动的新架构,2020年发布,引入新的资源管理器和轻量级Spark应用框架,极大缩短作业启动时间。
- 作业只需等待第一个执行节点启动即可开始执行;
- Spark调度器被修改为直接使用Glue的资源管理器管理的Worker,而不再依赖传统YARN之类的集群系统;
- 资源管理器维护一套服务级别的Spark实例"热池",并利用机器学习模型预测不同地区的EC2资源需求,从而将冷启动时间控制在10秒以内。
Glue 3.0:自动扩缩容的进化,在2.0的基础上进一步升级,支持作业运行过程中动态调整集群大小,实现真正的弹性执行。核心创新包括:
- 增强Spark的Shuffle跟踪算法,即使在缩容时也能安全保留中间数据,避免丢失;
- 优化资源弹性策略,避免过于频繁的扩缩容,减少资源抖动与调度开销。
原理
架构示意图:
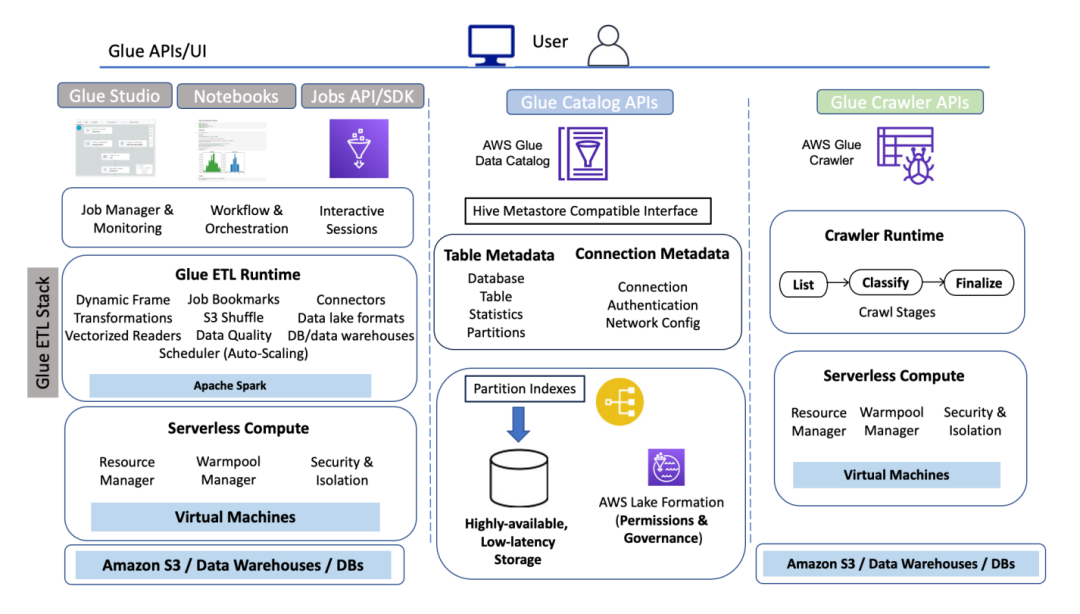
Glue ETL栈的核心组件:
- Glue Studio:可视化界面,用户可通过拖拽操作构建数据处理流程,系统会自动生成可读性强的Apache Spark脚本,极大降低ETL开发的门槛。支持运行、监控数据集成任务
- Glue ETL运行时(Runtime):包括Spark的核心组件和Glue自研的扩展库。AWS选择Spark作为底层引擎,是因为其通用性强,且在开发者中应用广泛。进一步扩展专属的ETL库,提供更高效、鲁棒的处理能力,尤其适合处理嵌套的半结构化数据(如JSON、日志等)。其中引入的DynamicFrame数据结构,以及一系列专门用于清洗、转换嵌套数据的操作,使得复杂数据的处理更加简洁高效
- 任务编排系统:提供作业编排能力,可将多个ETL任务串联成完整的数据处理流水线,实现自动化执行与调度
- 无服务器Spark作业执行:用户提交Spark脚本,Glue会自动处理资源配置、调度、启动等一系列操作。作业通常可在几秒内启动,并根据任务负载动态伸缩资源,实现真正的弹性计算。
Glue Data Catalog
数据目录,可扩展的元数据服务,允许用户将数据集建模为数据库和数据表,支持对多种存储系统中的数据进行建模:
- Amazon S3对象存储
- 各类关系型数据库
- NoSQL存储
- 流数据服务,如Kinesis
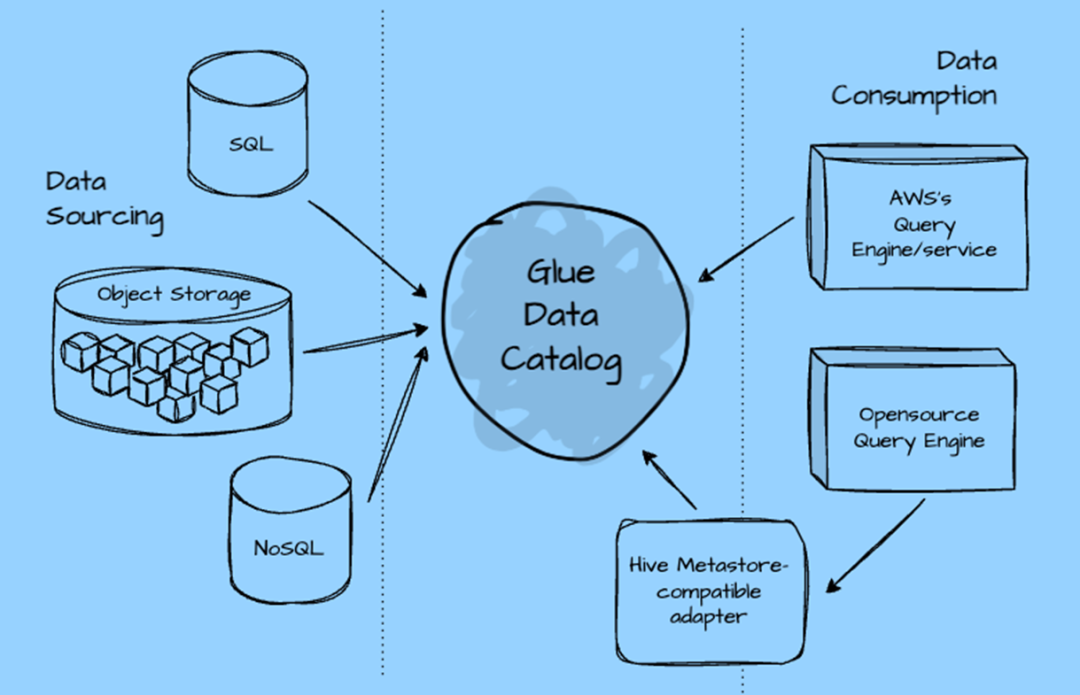
通过Glue数据目录定义的数据表,可被包括Athena、EMR和Redshift在内的AWS分析服务直接查询。还提供兼容Apache Hive Metastore的适配器,方便用户将其与开源分析引擎如Apache Spark和Presto集成使用。
Glue Studio
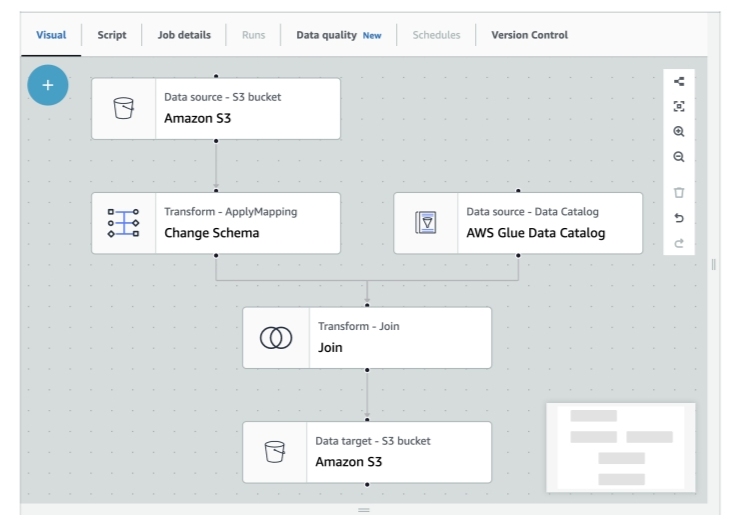
用户可通过图形化方式构建ETL流程:系统将其转换为一个有向无环图(DAG)表示的ETL脚本,每个节点代表一个数据源、数据汇或数据转换操作。
低代码与灵活性:
- 可通过拖拽操作快速搭建工作流;
- 可对每个节点进行个性化配置,或直接编辑生成的底层Spark脚本,以满足更复杂的业务逻辑需求。
DynamicFrame
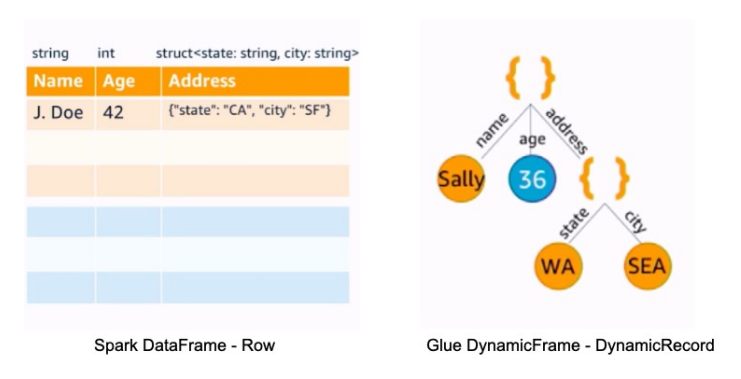
在处理JSON这类半结构化数据时,传统工具要求提前知道字段结构(schema)。
AWS Glue引入DynamicFrame:
- 不需要提前定义字段结构;
- 每条数据记录都带有自己的字段信息,只有需要时才整体推断Schema;
- 特别适合清洗格式不统一的"脏数据"。
可用DynamicFrame来读取CSV、JSON、Parquet等格式的数据,也能处理数据库里的数据。处理完后,若需做复杂分析,可再转成Spark DataFrame。
Spark Shuffle
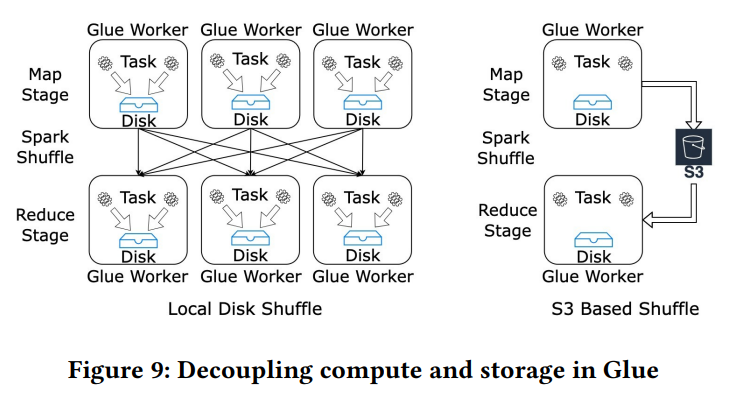
在使用Apache Spark时,Shuffle过程常常是性能瓶颈,特别是在处理大规模数据或分区倾斜严重的任务中。传统情况下,Shuffle数据被存储在本地磁盘。如果某个Worker的磁盘空间不足或分区分布不均,就可能导致任务失败或性能严重下降。两种常见解决方法:
- 重新分区(Repartition)以缓解倾斜;
- 增加本地资源,如磁盘或节点数量。
但这两种方式都带来更高的维护成本或资源浪费。为解决这个问题,AWS在2021年推出Cloud Shuffle Storage Plugin(云端Shuffle存储插件)。核心思想:将Shuffle数据存储在Amazon S3上,而不是本地磁盘,从而实现计算与存储的彻底解耦。好处:
- 消除本地存储瓶颈;
- 支持更高的并发与弹性计算;
- 降低节点故障对任务的影响。
为支持这项功能,AWS 扩展 Spark 内部的多个组件:
- Block Manager(块管理器)
- Shuffle Reader/Writer(读写器)
- Task I/O 层等
在 2022 年,Glue 团队进一步扩展插件能力,使其支持其他云存储服务,不再局限于 S3。这也为多云部署或混合云环境下使用 Spark 提供更大灵活性。
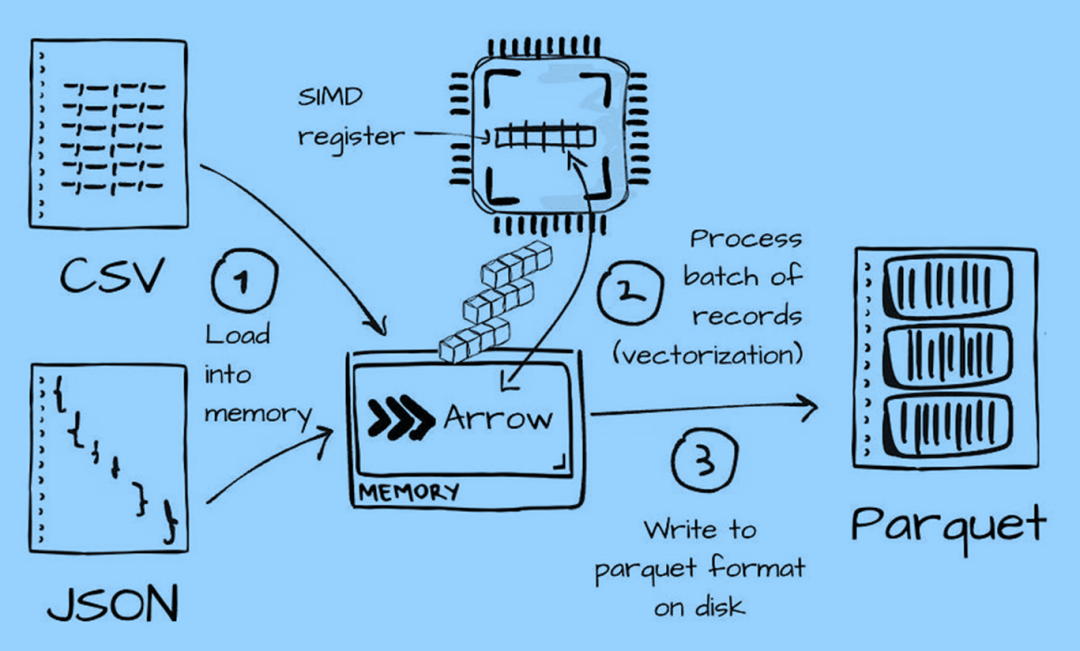
2021年,Glue引入原生SIMD矢量化读取器,以解决ETL工作负载中的CPU瓶颈问题,将CSV和JSON等原始格式转换为Apache Parquet等现代格式。
传统的反序列化到内存受到CPU和内存带宽的限制,落后于S3改进的网络速度。该解决方案涉及用C++重新实现读取器并利用SIMD矢量化CPU指令,从而实现微并行,从而实现更快的解析、标记和索引。
读取器基于Apache Arrow将数据以内存列式格式存储,这有助于优化内存带宽利用率,并降低写入Parquet等列式格式时的转换成本。
AWS在Glue中构建一个编排层,允许客户编排数据管道,这被称为工作流。允许客户从Glue爬虫、Glue Spark作业或Glue Python作业构建管道。
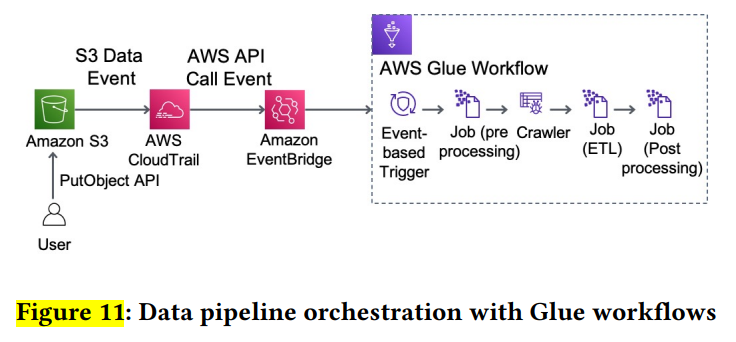
他们可定义在作业之间传递的参数、发生故障时的后备作业,或根据计划或事件组合启动工作流的触发器。用户可监控整个工作流,也可深入每个作业进行故障排除。
Glue ETL库中的Glue作业书签通过跟踪和保留作业运行状态来实现增量数据处理。启用书签后,作业可从中断处继续执行,跳过之前处理的数据,并支持CSV、JSON、Parquet、ORC、Avro和JDBC源等格式。
对于较大的初始加载,数百万个S3前缀的文件可能会让Spark工作器不堪重负,Glue会限制每次作业运行的文件数量或数据集大小,从而允许多次执行才能完成任务,可确保可靠的大规模数据迁移。
AWS扩展Glue对数据格式、源和接收器的支持,以满足多样化的客户需求,包括传统格式和独特格式。
该团队致力于优化Amazon S3和Redshift等大容量数据源的性能和可靠性,并增加支持的数据源和格式的多样性。
对于AmazonS3,Glue最初支持CSV、JSON、Parquet和ORC等标准格式。后来引入任务批处理和分区修剪等优化功能,还增强处理S3存储类和细粒度访问控制等功能。2022年,Glue增加对Apache Hudi、Iceberg和Delta Lake 等事务表格式的原生支持。
总结:
ETL 是长尾问题:数据格式、场景千差万别,必须留出可编程能力;
基础设施优化带来复利:比如启动时间降低 → 支持交互式应用 → 用户群扩大;
连接器生态决定 Glue 的生命力:多源、多格式、Marketplace 插件体系让 Glue 不断成长。