读懂 Pi 生产级 Agent 的骨架:从 0 实现最小 Coding Agent
大模型擅长生成内容,Coding Agent 却要进一步作用于真实环境:读取文件、探索目录、修改代码,并根据工具反馈决定下一步。两者真正的分水岭,不是提示词写得多长,而是系统是否拥有一套可持续运行、可观察、可停止、能守住风险边界的 Agent Loop。
本文从一个可运行的最小 Coding Agent 出发:先观察模型如何发起 ToolCall、Python 宿主如何执行函数、ToolResult 又如何回到消息历史;再以这条最小闭环为参照,理解 Pi 为什么要拆分模型适配、Agent Core、Coding Agent 产品层与 UI,以及这些边界如何支撑更可靠的生产系统。
阅读路线: 先跑通最小闭环 → 再理解协议与风险 → 最后用 Pi 的分层、事件和扩展点重构它。
一、先给结论:Agent 的核心不是"会调用工具"
一个能够稳定工作的 Agent,至少由六个彼此配合的部分组成:
- 模型: 根据当前上下文提出下一步决策。
- 工具 Schema: 告诉模型有哪些动作、参数怎样组织。
- 工具实现: 由宿主程序执行真实 I/O 或业务动作。
- 消息协议: 保存 user、assistant、ToolCall 与 ToolResult 的因果链。
- Agent Loop: 让"决策 → 执行 → 观察 → 再决策"持续运行。
- 治理边界: 限制权限、次数、时间、路径和副作用,并留下审计证据。 很多 Demo 只展示"模型选中了一个函数",但函数调用本身不是 Agent。
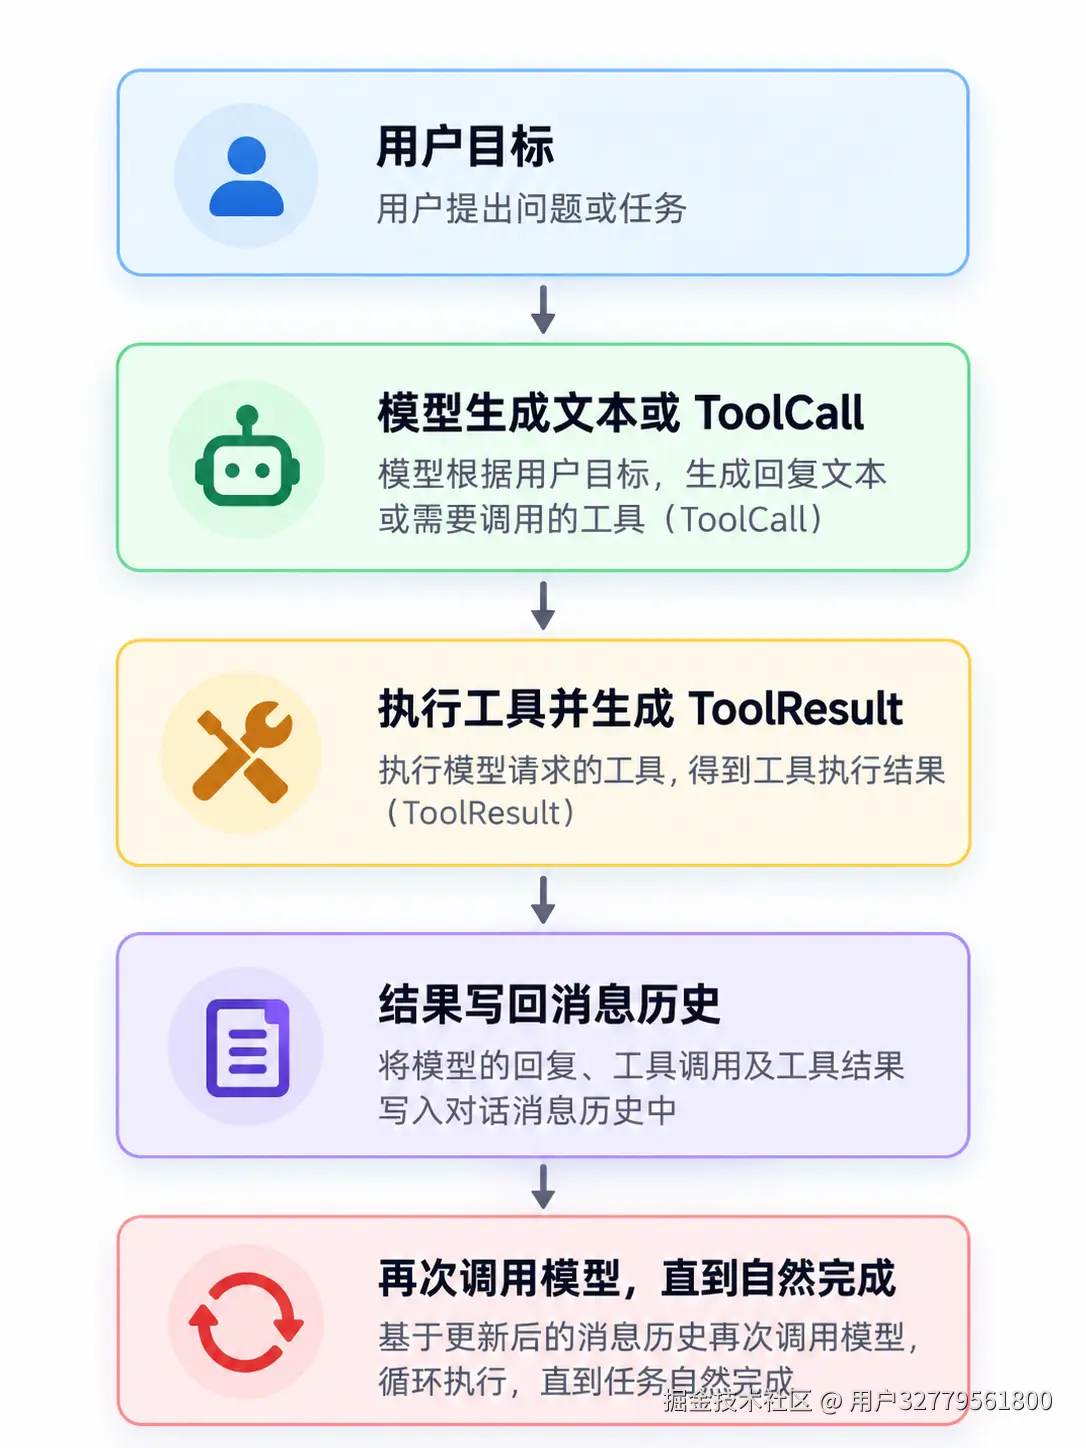
真正的 Agent 必须让环境反馈重新进入推理,并且明确回答三个问题:为什么继续、什么时候停止、发生副作用时谁负责。
二、为什么要亲手实现一个最小版本
直接使用成熟框架,很容易快速得到一个"看起来会工作"的系统,却未必能看清它为什么工作。亲手实现最小版本,是为了把关键机制压缩到少量代码中:工具为什么同时需要 Schema 和 Registry,ToolCall 为什么必须先写入消息历史,ToolResult 为什么要携带对应 ID,以及一次工具成功为什么仍不等于用户目标已经完成。
三、从 0 实现最小 Coding Agent
这次只做一个目标明确的最小 Demo:让模型通过 read_file、list_files、edit_file 三个工具完成真实的编程任务,并亲眼看到 Agent Loop 如何反复运行。
Step 1:模型配置
python
from openai import OpenAI

API_KEY = "ms-xxx"  # 替换成你自己的 API Key
BASE_URL = "https://api.deepseek.com/v1"
MODEL = "deepseek-flash"

client = OpenAI(api_key=API_KEY, base_url=BASE_URL)
测试运行连通性:
python
response = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": "只回复:连接成功"}],
)
print("✅ 模型回复:", response.choices[0].message.content)
print("✅ 模型回复:", response.model)
如果失败,问题通常位于 Key、模型名、Base URL、网络或额度。
为了降低初学者认知负担,Demo 把配置直接写在代码里;生产项目不能把真实密钥提交到 Git,应改用环境变量或密钥管理服务。
Step 2:工具定义
先把工具当作普通 Python 函数,不接模型:
python
from pathlib import Path

# 定义工具
def resolve_path(path_str: str) -> Path:
    """把相对路径转换为基于当前目录的绝对路径。"""
    path = Path(path_str).expanduser()
    return path.resolve() if not path.is_absolute() else path


def read_file(path: str) -> dict:
    """读取 UTF-8 文本文件。"""
    full_path = resolve_path(path)
    content = full_path.read_text(encoding="utf-8")
    return {"file_path": str(full_path), "content": content}


def list_files(path: str) -> dict:
    """列出目录中的文件和子目录。"""
    full_path = resolve_path(path)
    items = []
    for item in sorted(full_path.iterdir()):
        items.append(
            {
                "filename": item.name,
                "type": "file" if item.is_file() else "dir",
            }
        )
    return {"path": str(full_path), "files": items}


def edit_file(path: str, old_str: str, new_str: str) -> dict:
    """old_str 为空时创建/覆盖文件,否则替换第一次出现的文本。"""
    full_path = resolve_path(path)
    if old_str == "":
        full_path.write_text(new_str, encoding="utf-8")
        return {"path": str(full_path), "action": "created_file"}

    original = full_path.read_text(encoding="utf-8")
    if old_str not in original:
        return {"path": str(full_path), "action": "old_str not found"}

    edited = original.replace(old_str, new_str, 1)
    full_path.write_text(edited, encoding="utf-8")
    return {"path": str(full_path), "action": "edited"}
逐步验证:
python
# 1. read_file:先准备一个文件,再读取
Path("lesson_note.txt").write_text(
    "Agent = 模型 + 工具 + 循环",
    encoding="utf-8",
)
print(read_file("lesson_note.txt"))

# 2. list_files:观察当前目录
print(list_files("."))

# 3. edit_file:先创建,再修改
print(edit_file("hello.py", "", "print('hello')\n"))
print(edit_file("hello.py", "hello", "hello agent"))
print(read_file("hello.py"))
注意: 工具不是 Agent。工具只负责确定性地执行动作;"下一步调用哪个工具、参数是什么、结果回来后是否还要继续"由模型和循环共同决定。
三个工具的分工:
read_file读取文件list_files读取目录edit_file编辑文件
Step 3:工具注册
TOOL_REGISTRY 是给 Python 运行时看的路由表:模型说"调用 read_file",宿主程序据此找到真实函数。
TOOLS 是给大模型看的 JSON Schema:它只描述工具的名字、用途、参数和必填字段。模型看到 Schema,但不会直接得到 Python 函数的执行权。
python
# 工具注册
TOOL_REGISTRY = {
    "read_file": read_file,
    "list_files": list_files,
    "edit_file": edit_file,
}

TOOLS = [
    {
        "type": "function",
        "function": {
            "name": "read_file",
            "description": "读取文件的完整内容",
            "parameters": {
                "type": "object",
                "properties": {
                    "path": {"type": "string", "description": "文件路径"}
                },
                "required": ["path"],
            },
        },
    },
    {
        "type": "function",
        "function": {
            "name": "list_files",
            "description": "列出目录中的文件和子目录",
            "parameters": {
                "type": "object",
                "properties": {
                    "path": {"type": "string", "description": "目录路径"}
                },
                "required": ["path"],
            },
        },
    },
    {
        "type": "function",
        "function": {
            "name": "edit_file",
            "description": "编辑文件:old_str 为空则创建/覆盖,非空则替换",
            "parameters": {
                "type": "object",
                "properties": {
                    "path": {"type": "string"},
                    "old_str": {"type": "string"},
                    "new_str": {"type": "string"},
                },
                "required": ["path", "old_str", "new_str"],
            },
        },
    },
]
这两份定义必须对齐:
- 只有 Schema:模型会请求工具,但程序找不到函数。
- 只有 Registry:程序有函数,但模型不知道它存在。
- 参数名不一致:模型给出看似合理的 ToolCall,Python 执行时却报错。
可以直接验证:
python
print("Python 中注册的工具:", list(TOOL_REGISTRY))
print("模型看到的工具:", [item["function"]["name"] for item in TOOLS])
Step 4:系统提示词与完整 Agent Loop
下面是本 Demo 的核心代码:
python
import json

# 系统提示词
SYSTEM_PROMPT = """你是一个编程助手智能体。你可以使用以下工具:
- read_file:读取文件的完整内容
- list_files:列出目录中的文件和子目录
- edit_file:编辑文件,old_str 为空则创建/覆盖,非空则替换

使用规则:
1. 先判断是否需要工具。
2. 需要时直接发起工具调用。
3. 收到工具结果后继续推理或回复。
4. 创建文件时 old_str 传空字符串。
5. 修改文件前先 read_file 了解当前内容。
"""

# Step 5:Agent Loop
class SimpleAgent:
    """最小 AI 编程智能体。"""

    def __init__(
        self,
        api_key: str,
        base_url: str,
        model: str,
        *,
        client=None,
    ) -> None:
        self.client = client or OpenAI(api_key=api_key, base_url=base_url)
        self.model = model
        self.conversation = [
            {"role": "system", "content": SYSTEM_PROMPT}
        ]

    def chat(self, user_message: str) -> str:
        """处理一条用户消息,运行完整 Agent Loop。"""
        print(f"\n 用户:{user_message}")
        self.conversation.append(
            {"role": "user", "content": user_message}
        )

        while True:
            response = self.client.chat.completions.create(
                model=self.model,
                messages=self.conversation,
                tools=TOOLS,
                tool_choice="auto",
            )
            message = response.choices[0].message

            # 没有工具调用:输出最终回答,结束本次内层循环。
            if not message.tool_calls:
                final_text = message.content or ""
                self.conversation.append(
                    {"role": "assistant", "content": final_text}
                )
                print(f"🤖 Agent:{final_text}")
                return final_text

            # 关键协议:先保存包含 tool_calls 的 assistant 消息。
            self.conversation.append(
                {
                    "role": "assistant",
                    "content": message.content,
                    "tool_calls": [
                        {
                            "id": call.id,
                            "type": "function",
                            "function": {
                                "name": call.function.name,
                                "arguments": call.function.arguments,
                            },
                        }
                        for call in message.tool_calls
                    ],
                }
            )

            # 同一轮可能包含多个工具调用,必须全部执行。
            for call in message.tool_calls:
                tool_name = call.function.name
                tool_args = json.loads(call.function.arguments)
                tool_function = TOOL_REGISTRY.get(tool_name)
                print(
                    f"  调用工具:{tool_name}"
                    f"({json.dumps(tool_args, ensure_ascii=False)})"
                )

                try:
                    if tool_function is None:
                        raise ValueError(f"未知工具:{tool_name}")
                    result = tool_function(**tool_args)
                except Exception as exc:
                    result = {"error": str(exc)}

                print(
                    "  工具结果:"
                    + json.dumps(result, ensure_ascii=False)
                )
                self.conversation.append(
                    {
                        "role": "tool",
                        "tool_call_id": call.id,
                        "content": json.dumps(result, ensure_ascii=False),
                    }
                )
不要只关注 while True,而要追踪消息历史如何增长。一轮典型轨迹是:
| 角色 | 消息内容 |
|---|---|
| system | 告诉模型角色、工具和规则 |
| user | "创建 greet.py" |
| assistant | 发起 edit_file ToolCall,携带 call.id |
| tool | 返回执行结果,用 tool_call_id 与请求配对 |
| assistant | 看到结果后给出最终回答 |
循环中六个协议点:
- 用户输入先以
role="user"进入消息历史。 - 每次请求模型都传入完整历史和
TOOLS。 - 一轮可能返回多个 ToolCall,必须逐个执行,不能只处理第一个。
- 工具执行前,先保存带
tool_calls的 assistant 消息,保留"谁请求了什么"。 - 工具结果使用
role="tool",并携带对应的tool_call_id。 - 工具执行完不能直接结束;结果要回到历史,再次请求模型。只有模型不再请求工具,循环才自然结束。
为什么退出条件不是"工具执行成功"?因为一个编程任务经常需要多步:先列目录、再读文件、再修改文件、最后解释结果。一次工具成功只代表环境发生了一个局部变化,不代表用户目标已经完成。
工具异常也被包装成结果放回上下文:
python
try:
    result = tool_function(**tool_args)
except Exception as exc:
    result = {"error": str(exc)}
这样,模型既可以解释错误,也可以调整方案,而不是让异常直接穿透并中断 Agent Loop。
Step 5:实例化后,用四个任务逐步验证证
先创建 Agent:
python
agent = SimpleAgent(API_KEY, BASE_URL, MODEL)
print("✅ Coding Agent 创建成功")
然后按顺序运行四个独立 Cell:
python
# 验证 1:创建文件
agent.chat("创建 greet.py,写一个 greet(name) 函数并打印 greet('Pi') 的结果")
python
# 验证 2:修改已有文件------重点观察是否先 read_file
agent.chat("把 greet.py 的问候语改成中文,并保留原有函数结构")
python
# 验证 3:查看目录
agent.chat("列出当前目录,并告诉我哪些是 Python 文件")
python
# 验证 4:让错误进入循环
agent.chat("读取一个不存在的文件 missing.py,并解释发生了什么")
每一次验证都有四个问题:模型选择了哪个工具?参数是什么?工具返回了什么?模型为什么继续或停止?
模型具有概率性。生产系统若要求"修改前必须读取",必须由宿主程序做状态机校验。
终端版本
python
def main() -> None:
    if API_KEY == "ms-xxx":
        raise SystemExit("请先把 agent.py 顶部的 API_KEY 改成你的真实 Key。")

    agent = SimpleAgent(API_KEY, BASE_URL, MODEL)
    print("✅ Coding Agent 已启动。输入 exit 或空行退出。")
    while True:
        task = input("\n👉 你的任务:").strip()
        if not task or task.lower() == "exit":
            break
        agent.chat(task)


if __name__ == "__main__":
    main()
这个最小 Demo 证明了什么,又没有证明什么
它已经证明:
- 模型能够根据自然语言选择工具并生成结构化参数。
- 宿主能够执行真实动作并把结果送回模型。
- 同一个用户任务可以经历多个 Turn,直到模型不再请求工具。
- 文件不存在等错误可以作为观察结果进入下一轮推理。
它没有证明:
- 工作目录沙箱和路径越界防护。
- 写文件前的人工审批与 diff 预览。
- 最大 Turn、最大工具次数、超时和取消。
- 结构化日志、Trace、指标和成本统计。
- 并发修改检测、幂等和失败重试。
- 自动化评测、回归测试与权限系统。
一些深入思考
- 为什么"LLM + 三个函数"仍然不是完整 Agent,而必须有 Loop?
- 为什么 ToolCall 和 ToolResult 必须通过 ID 配对?如果一轮并行读两个文件会怎样?
- 模型说"任务完成"和环境中真的完成,二者如何验证?
- 若模型连续十次调用同一个失败工具,循环应该由谁停止?
- 提示词写了"修改前先读取",为什么仍不能代替代码层强制策略?
Agent Loop 的本质不是让模型多说几次,而是把"模型决策"和"环境反馈"组织成一个可持续、可观察、可停止的闭环。
四、我的思考:这个最小 Agent 真正教会了什么
1. Agent Loop 是控制系统,不是普通 while 循环
while True 只是语法外壳。Loop 真正维护的是一组状态不变量:每个 ToolCall 都必须有对应结果;工具结果必须在下一次模型调用前写回;同一批调用不能遗漏;错误也要变成模型可观察的消息;只有满足退出策略时才能结束。
因此,评价一个 Agent Loop 不能只问"是否能跑",还要问:协议是否完整、状态是否可恢复、失败是否可解释、预算是否可控、副作用是否可审计。
2. Prompt 是意图,代码才是约束
系统提示词可以要求"修改前先读文件",但模型输出具有概率性。若这条规则关系到数据安全或业务正确性,宿主必须用代码强制:没有读取到目标版本就拒绝写入,文件已变化就要求重新预览,高风险动作必须经过确认。
一个实用的判断标准是:违反这条规则是否会造成不可逆后果?如果答案是"会",它就不能只存在于 Prompt 中。
3. ToolResult 是第一类消息,而不是日志附件
工具结果进入消息历史后,模型才能根据真实环境调整计划。成功结果告诉模型世界发生了什么,错误结果告诉模型原计划为什么不可行。若错误只打印到控制台,模型看不到失败原因,很容易重复相同动作或凭空假设成功。
tool_call_id 则保存了因果关系。尤其当一轮同时读取多个文件时,没有 ID 配对,模型就无法可靠判断哪份结果属于哪次请求。
4. "模型说完成"不等于"任务真的完成"
最小 Demo 以"模型不再请求工具"作为自然结束条件,这适合教学,却不足以承担生产验收。真实系统还需要外部验证器:文件是否存在、测试是否通过、数据库状态是否达到目标、写操作是否命中正确版本、用户要求是否全部覆盖。
5. 读工具和写工具不应拥有同一种风险等级
read_file 与 edit_file 都是工具,但安全语义完全不同。读操作主要担心越权与数据泄露;写操作还涉及覆盖、并发冲突、幂等、审批、回滚和审计。成熟的工具契约应显式描述是否有副作用、是否允许并行、能否重试、是否需要确认,以及失败后的补偿方式。
6. 从 Demo 到生产,优先补"边界",不是盲目加工具
| 阶段 | 优先补齐的能力 | 主要防止的风险 |
|---|---|---|
| 可运行 | ToolCall / ToolResult、完整消息历史、错误回注 | 协议断裂、模型看不到环境反馈 |
| 可控制 | 路径沙箱、最大 Turn、超时、取消、重复调用保护 | 越界访问、死循环、资源失控 |
| 可写入 | diff 预览、人工确认、版本重检、原子写、幂等键 | 误写、覆盖并发修改、重复副作用 |
| 可观察 | Trace、事件、结构化日志、成本和停止原因 | 失败无法定位、效果无法评估 |
| 可演进 | 模型适配层、工具契约、扩展点、会话持久化、评测 | 被单一供应商锁死、改动难回归 |
五、从最小 Agent 到 Pi:怎样长期运行一个 Agent
1. Pi 是什么:极简而可扩展的 Agent Harness
Pi 是一个使用 TypeScript 构建、强调极简与可扩展性的终端 Coding Agent Harness。这里的 Harness 不是模型本身,而是把模型、工具、消息、上下文、循环和用户界面组装起来的运行外壳:模型提出决策候选,Harness 负责校验、执行、反馈并守住边界。它既可以直接作为日常编码工具,还能作为构建其他 Agent 产品的开发积木。
"极简"不等于能力不足,而是一种明确的架构取舍:核心只保留稳定机制,把计划模式、权限门禁、子 Agent、MCP 等能力交给扩展或外部系统。收益是结构透明、上下文更干净、扩展边界更清晰;代价是团队必须主动补齐权限、安全、持久化、审计和评测等生产治理能力。
2. Pi 的三层架构:把变化速度不同的部分拆开
| 层 | 核心职责 | 避免的问题 |
|---|---|---|
pi-ai |
统一模型、供应商、消息、流式事件、Token 与成本信息 | Agent Loop 被某一家模型 SDK 绑死 |
pi-agent-core |
维护状态,运行模型与工具循环,生成工具消息,发出生命周期事件 | 循环、产品逻辑和 UI 混成一团 |
pi-coding-agent |
组装编码工具、项目上下文、会话、扩展、CLI 与交互体验 | 通用内核被单一业务场景污染 |
pi-ai:统一模型与供应商差异
这一层只回答"怎样调用模型"。它统一消息格式、模型信息、流式事件、Token 与成本数据,让上层 Agent Loop 面向稳定接口,而不是把某一家供应商的 SDK 写死在循环里。更换模型时,理想状态是替换适配器,而不是重写整个 Agent。
pi-agent-core:运行 Agent 的通用内核
这一层负责状态与消息、模型调用、工具校验和执行、ToolResult 回注、生命周期事件,以及终止、中断和下一轮上下文准备。它知道"怎样运行一个 Agent",但不应该知道当前工具属于哪个项目,也不负责决定终端怎样显示。
pi-coding-agent:把通用内核变成编码产品
这一层面向具体用户与场景,负责加载项目规则,组装读写文件和命令工具,管理会话、扩展、CLI 与交互体验。换成 Data Agent 或业务 Agent 时,产品层会变化,但通用 Agent Core 仍然可以复用。
pi-tui 是正交的终端 UI:它消费事件并负责显示,但不应该决定 Agent 如何思考和行动。这样,同一个 Agent Core 才能被终端、Web、飞书机器人或后台任务复用。
3. Trace 与 Turn:区分完整任务和一次模型调用
Trace 表示一次完整任务从用户输入开始,到最终回答、失败或中止为止的执行轨迹;其中可以包含多个 Turn、多次工具调用、工具结果、异常与重试。
Turn 表示一次 LLM 调用,以及这次响应触发的整批工具执行。工具结果回注后发生的下一次模型调用,已经属于新的 Turn。
4. 生命周期事件:让内核只负责发出事实一个典型 Trace 的事件流
一个 Trace 会持续发出核心事件,这些事件可以被日志、指标、测试系统以及审批系统共同消费。**
| 阶段 | 事件 | 含义 |
|---|---|---|
| Trace 开始 | agent_start |
整个 Trace 开始 |
| Turn 开始 | turn_start |
Turn 1 开始 |
| 用户消息 | message_start → message_end |
接收用户输入 |
| 模型生成 | message_start |
Assistant 开始生成 |
| 流式生成 | message_update |
持续产生 Token |
| 模型结束 | message_end |
Assistant 本轮生成完成 |
| 工具执行 | tool_execution_start |
开始调用工具 |
| 工具更新 | tool_execution_update |
工具执行中的增量结果,可选 |
| 工具结束 | tool_execution_end |
工具执行完成 |
| ToolResult | message_start → message_end |
工具结果写回消息历史 |
| Turn 结束 | turn_end |
Turn 1 结束 |
当工具执行完成后,ToolResult 会被写回消息历史,并作为新的上下文再次发送给模型,从而进入下一轮 Turn。
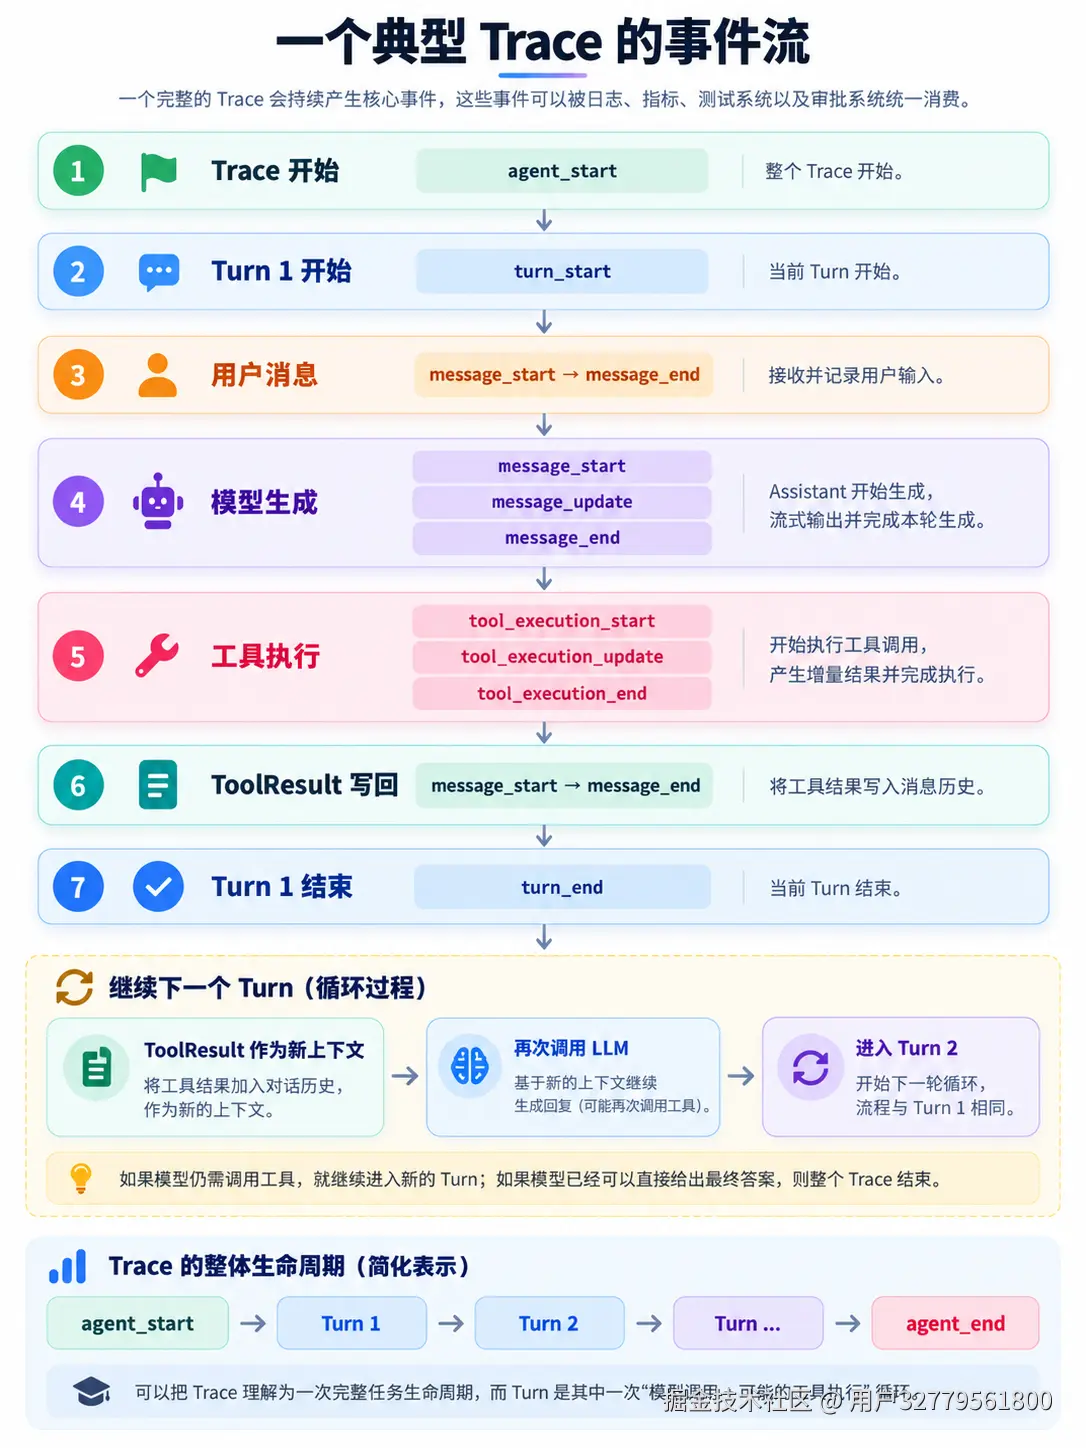
预算、安全阀和观测指标通常在 Turn 边界检查,而不是在任意一条日志之后随意判断。
5. 消息系统:分离内部状态与模型协议
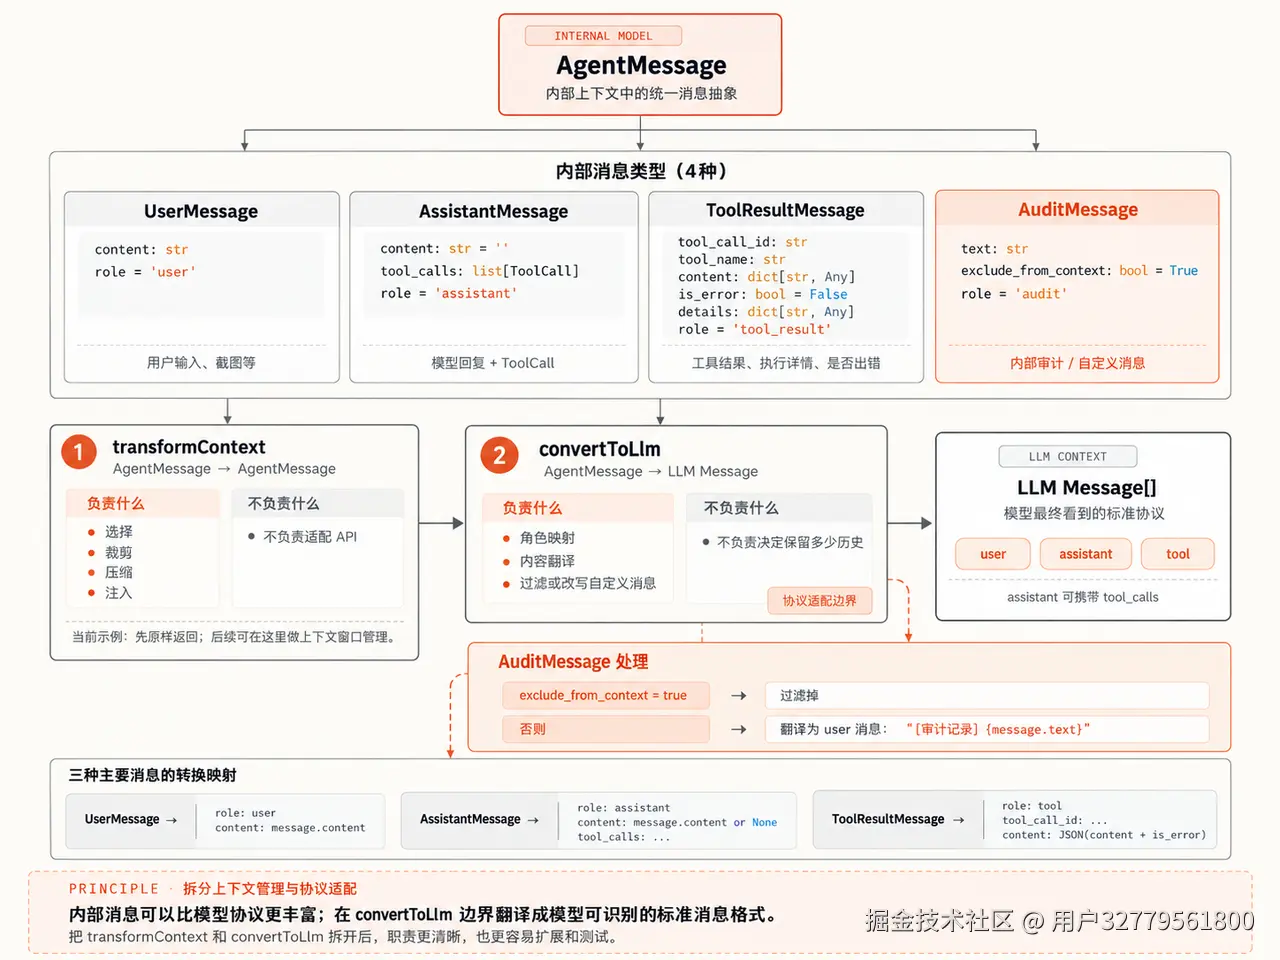
AgentMessage 与 LLM Message 不是一回事
供应商通常只认识 system、user、assistant、tool 等协议消息;Agent 内部却还要保存审批、审计、压缩、分支、进度和恢复信息。因此需要一个显式转换边界,把内部运行记录筛选、压缩、脱敏并转换成模型能够理解的消息。
这个边界让内部状态可以独立演化,也让测试能够分别验证"Agent 保存的事实是否正确"和"发给模型的上下文是否正确"。
6. Pi 的双层循环:把当前任务与后续任务分开
Pi 的双层循环不是 "两个 Agent Loop",而是把"一个任务内部的连续推理 "和"多个连续任务之间的衔接"拆开了。
外层循环 :管「还有没有下一件事」 内层循环:管「当前这件事做完没有」
7. Steering(补充指令)与 FollowUp(后续任务)
Steering:当前任务尚未结束,用户要紧急改变方向
长任务运行期间,用户可能补充:"不要改文件,只分析。"如果等到整个 Trace 结束才处理,可能来不及。
Steering 消息进入高优先级队列,在 Turn 边界 注入当前上下文,让下一次模型调用看到新要求。Pi 会在进入循环前检查一次,并在每个 Turn 结束后再次检查,避免消息遗漏。
FollowUp:当前任务结束后,再追加一个任务
FollowUp 不打断当前工作。内层循环自然停止后,外层循环检查 FollowUp 队列,例如:
- 当前任务完成后"顺便运行测试"。
- 生成报告后"再导出 PDF"。
- 修复代码后"再总结改动"。
如果队列非空,任务会被放入 pending_messages,在同一个 Trace 中重新启动内层循环。
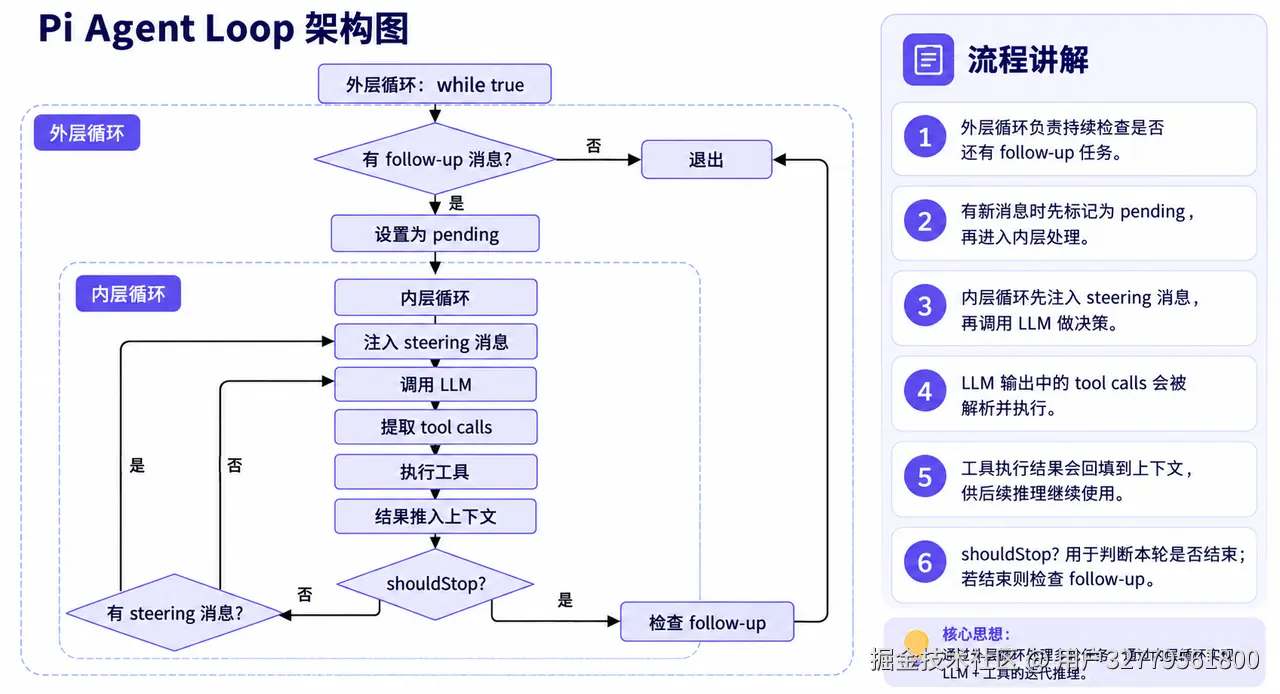
成熟循环会综合判断 ToolCall、工具批次终止语义、Steering 消息、FollowUp 队列、错误、中止和外部安全阀。Turn 结束后是最稳定的检查点,可以统一检查:
- 最大 Turn 与最大工具次数。
- 单工具超时与 Trace 总时限。
- 用户取消或权限策略。
- 上下文、Token 与费用预算。
- 是否仍有 Steering 或 FollowUp 消息。
8. 多工具执行:并行是优化,有序回注是协议
多个互不依赖的读操作可以并行,但写操作或存在前后依赖的调用应默认串行。一个可靠的批次通常分为三步:
- 顺序准备:解析参数、Schema 校验、权限检查、执行前钩子。
- 并行执行:只并行已确认安全、互不依赖的 I/O。
- 有序回注:无论完成先后,ToolResult 按原 ToolCall 顺序写回。
有序回注不只是为了好看,稳定顺序会让 Trace 回放、缓存命中、测试断言和故障复现更确定。
9. 扩展机制:在稳定内核之外增加能力
- Extensions: 注册工具、命令、快捷键、事件钩子和 UI。
- Skills: 按需加载任务知识与操作规程。
- Prompt templates: 复用可参数化的提示流程。
- Themes: 控制终端显示。
- Pi packages: 把扩展、技能、模板和主题打包分发。
学习 Pi 时,不要只记包名和接口。更值得掌握的是责任边界:模型层屏蔽供应商差异,Core 管循环与状态,产品层组装场景,UI 消费事件,扩展在稳定边界上增加能力。
六、从 Demo 到生产:建议的进阶练习路线
- 先原样运行最小 Demo,记录每次 user、assistant、ToolCall 和 ToolResult。
- 给 Loop 加入最大 Turn、最大工具次数、超时、取消和重复调用保护。
- 把
edit_file改成"预览 diff → 用户确认 → 版本重检 → 原子写入"。 - 将会话持久化,并为每个 Trace 保存停止原因、错误和成本。
- 最后再做并行工具、Steering、FollowUp、上下文压缩和自动评测。
结语
亲手实现最小 Coding Agent,能帮助我们看清 Agent 的第一性原理:模型不是执行器,工具不是决策者,消息不是聊天记录的附属品,Loop 也不是没有边界的无限循环。可靠的 Agent,必须把模型的不确定决策转换成受协议约束、受策略控制、可以观察、可以验证的环境动作。
Pi 的价值正在于把这条主线拆得足够清楚:先守住一个小而稳定的内核,再把产品体验、权限、安全、上下文和扩展能力放到各自应该承担责任的位置。