一、研究背景与核心问题
数据智能体(Data Agents) 旨在完成面向异构数据(表格、CSV、文档、数据库、图表等)的自然语言任务。智能体必须持续与外部数据源交互,才能收集生成最终答案所需的信息。
然而,现实部署中存在一个根本性挑战------智能体---数据鸿沟(Agent-Data Gap):
-
数据以关系数据库、半结构化文件和文本文档的形式存在于智能体之外;
-
智能体只能通过 SQL 接口、文件读取器等通用工具访问数据;
-
数据源的结构和内容无法先验获知 ,智能体不得不通过反复探测查询、猜测概念位置、检查无关内容来盲目探索,导致重复低效的探索。
弥合这一鸿沟,需要一个中间本体层 :显式表示领域概念、将概念锚定到底层数据、使智能体能在语义层面而非物理层面与数据交互。
二、现有方法的不足
论文将现有智能体---数据交互方法分为两类,并指出其局限:
| 方法类型 | 代表工作 | 主要问题 |
|---|---|---|
| 原始查询(Raw Querying) | DIN-SQL、MAC-SQL、CHESS 等 | 对小型简单数据源有效,但难以扩展到宽表异构数据,智能体易陷入重复低效探索 |
| 语义层(Semantic Layer) | Hitzler 2021、dbt Labs 2023、Feng et al. 2024 等 | ① 整个语义层无法塞入有限上下文;② 通常预定义且人工维护,构建成本高;③ 无法适应不同智能体行为 |
关键洞察 :静态语义层作为提示片段注入上下文时,会与智能体其他指令竞争,无法逐轮修剪;而 EvoOntology 通过 MCP 工具让智能体主动按需查询,仅检索当前步骤相关的术语和映射。
三、EvoOntology 的核心设计
EvoOntology 是一个自演化本体层 ,封装为 MCP 服务器,包含三个层次:
1. 内容层(Content Layer, St)
类型化语义图,包含:
-
四个节点族:术语(Terms,领域概念)、映射(Mappings,锚定到字段和链接路径)、约束(Constraints,管理有效使用)、证据(Evidence,支持语义主张)
-
两个边族:语义关系(关联、层次、组合、等价、派生)、结构引用(连接术语到映射、附加约束和证据)
2. 模式层(Schema Layer, Γt)
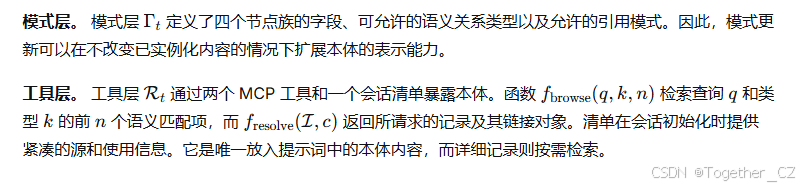
定义四个节点族的字段、可允许的语义关系类型、允许的引用模式。模式更新可扩展本体的表示能力而不改变已实例化内容。
3. 工具层(Tool Layer, Rt)
通过两个 MCP 工具和一个会话清单暴露本体:
-
fbrowse(q,k,n):检索查询 q 和类型 k 的前 n 个语义匹配项
-
fresolve(I,c):返回请求的记录及其链接对象
-
清单(Manifest):唯一放入提示词的本体内容,提供紧凑的源和使用信息;详细记录按需检索
四、两大核心机制
机制一:基于证据的本体初始化(Builder Agent)
-
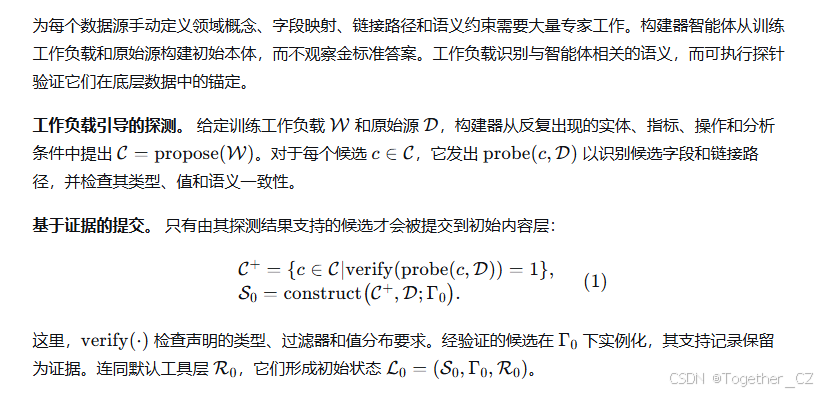
工作负载引导的探测:从训练工作负载 W 中提取反复出现的实体、指标、操作和分析条件,生成候选概念 C;对每个候选发出探测查询,识别候选字段和链接路径,检查类型、值和语义一致性。
-
基于证据的提交:仅提交通过验证(类型、过滤器、值分布要求)的候选,支持记录保留为证据,形成初始状态 L0=(S0,Γ0,R0))。
-
关键设计:每个提交条目必须锚定在探测查询上,而非仅自然语言描述。
机制二:基于轨迹的本体演化(Evolution Agent)
四步演化循环:
-
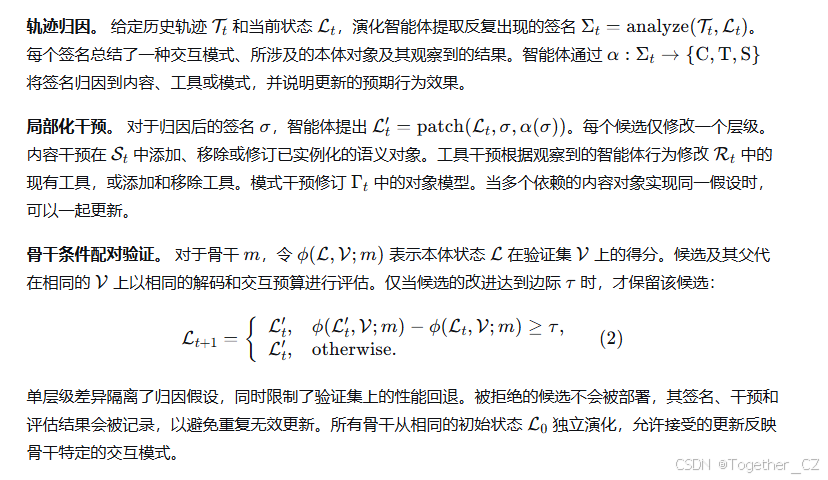
诊断(Diagnose):从历史轨迹 Tt 和当前状态 Lt 中提取反复出现的交互签名 Σt。
-
归因(Attribution):将签名归因到内容(C)、工具(T)或模式(S)层级,并说明预期行为效果。
-
补丁(Patch) :提出局部化干预,每个候选仅修改一个层级;内容干预增删改语义对象,工具干预修改工具集,模式干预修订对象模型。
-
门控(Gate) :骨干条件配对验证------候选与父代在相同验证集、相同解码和交互预算下评估,仅当改进达到边际 τ 时才保留:
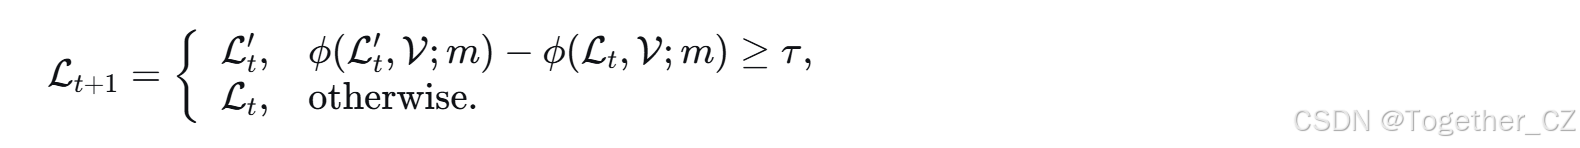
关键设计:单层级差异隔离归因假设;被拒绝候选的签名、干预和评估结果被记录以避免重复无效更新;所有骨干从相同初始状态独立演化,允许骨干特定交互模式。
五、实验设计与主要结果
基准与设置
-
三个基准:DDR-Bench(10-K 场景,开放式数据研究)、InsightBench(商业分析洞察挖掘)、BIRD(文本到 SQL,Oracle Knowledge 设置)
-
六个骨干:GPT-5.5、GPT-5.6-sol、Claude-Sonnet-5、Claude-Opus-4.8、DeepSeek-V4-Flash、Qwen3.5-Flash
-
两个基线:Baseline(无本体 ReAct)、Baseline + SL(静态语义层提示)
-
互惠两折评估:每基准分 A/B 两折,70% 用于构建/演化/候选生成,30% 用于配对验证;反转折后取平均,防止信息泄露
主要结果
| 基准 | 指标 | 主要发现 |
|---|---|---|
| DDR-Bench | 轨迹级准确率 | 六个骨干全部提升,平均 +17.8 分;GPT-5.5 提升最大(+26.7);Baseline + SL 在 Claude-Sonnet-5 上反而下降 15.0 分 |
| InsightBench | 洞察/摘要 | 所有骨干提升,平均 +1.9 分;DeepSeek-V4-Flash 提升最大(+6.1) |
| BIRD | EX/VES | 所有骨干双指标提升,平均 +7.4 / +8.6 分;Baseline + SL 出现 EX 下降但 VES 上升的混合模式 |
与记忆基线对比:ReAct + Memory 将轨迹级从 69.5 提升到 75.8,但仍比 EvoOntology(89.5)低 13.7 分------片段记忆仅重放已做过的事,不暴露类型化可组合结构。
六、深入分析的关键发现
1. 本体层的效果分解
-
Initial(构建器本体):DDR-Bench 轨迹级平均 +12.3 分;BIRD EX +5.1 分
-
Evolved(自演化后):DDR-Bench 再 +7.7 分;BIRD EX 再 +3.7 分
-
结论:构建器提供有效起点,自演化循环对实现全部增益至关重要
2. 迭代演化效果
-
四个骨干均从 Initial 单调改进至收敛;GPT-5.6-sol 五轮后达 93.5,Claude-Opus-4.8 四轮后达 92.3
-
最后两轮趋于平坦,与失败签名变罕见一致
-
结论:增益是收敛精炼的结果,而非单一幸运补丁
3. 演化循环消融
| 禁用步骤 | 轨迹级下降 |
|---|---|
| w/o Gate | -11.2(最大) |
| w/o Attribution | -6.3 |
| w/o Diagnose | -4.8 |
| w/o Patch(自由形式) | -1.7 |
门控和归因是承重部件,验证了"演化循环比迭代更具选择性"的设计。
4. 三层演化消融
| 变体 | 轨迹级增益 |
|---|---|
| 仅工具演化 | +13.2(最大单层) |
| 仅内容演化 | +8.7 |
| 仅模式演化 | +3.6 |
| 完整三层 | +20.0 |
三层互补且不可替代。
5. 本体结构消融
| 屏蔽对象族 | 轨迹级下降 |
|---|---|
| w/o Mappings | -13.4(最大) |
| w/o Evidence | -8.7 |
| w/o Constraints | -3.5 |
| w/o Relations | -2.1 |
映射和证据是承重族,验证了"每个提交条目必须锚定在探测查询"的设计。
6. 跨骨干差异
-
已接受术语标识符的成对 Jaccard 重叠无一超过 0.62;两个 Claude 骨干间共享(0.55)少于两个 GPT 骨干间(0.61)
-
跨骨干迁移实验中,对角线一致为列最高,非对角线至少下降 6.6 分
-
结论:不同骨干从相同初始化产生不同演化存储 ,骨干特定演化是有益的
7. 内容层增长与成本
-
增长:大多数内容增长发生在前三轮;三轮后每轮各元素增长低于 5%;术语从 61 增至 80(五轮后)
-
成本 :Initial 本体使每轮输入 token 从 3.2K 增至 4.1K,但轨迹从 14.6 轮缩短至 11.2 轮,总 token 从 52.6K 降至 50.4K;Evolved 进一步降至 8.4 轮和 42.0K token(比 Baseline 低约 20%),同时轨迹级从 69.5 升至 89.5
8. 归因分布
-
工具级编辑 :占累计增益 57%(6 轮),主导杠杆
-
内容级编辑 :占 34%(11 轮),更频繁
-
模式级编辑 :占 9%(3 轮),较少见但解决无法通过修改实例化内容解决的问题
9. 案例研究:卡牌合法性语义演化
以文本到 SQL 中识别目标游戏格式中被禁卡牌为例:
-
初始状态 :包含 Card 和 Legality 术语及关联,但未解释
legalities.status值含义,也未明确合法性状态相对于特定游戏格式 -
归因限制:内容层------现有 browse/resolve 工具已可检索相关对象,模式层可表示所需知识,缺失的是状态字段的可复用语义描述及其适用条件
-
局部干预 :新增 Legality Status Code 术语,锚定到
legalities.status;Evidence 记录状态值分布;Constraint 声明识别被禁卡牌需同时满足legalities.status = 'Banned'和legalities.format = target_format -
效果:browse 可浮现 Legality Status Code,resolve 可获取物理映射、支持证据和格式依赖约束;SQL 执行仍负责应用过滤和验证记录
-
意义:演化可通过添加小型连接对象集纠正特定语义缺口,本体保留现有结构和接口
七、结论与贡献
核心贡献:
-
提出 EvoOntology------面向数据智能体的自动构建、自演化交互式本体层
-
将本体封装为 MCP 服务器,智能体运行时主动查询,而非静态提示注入
-
设计四步演化循环(诊断→归因→补丁→门控),通过归因引导的类型化编辑和骨干条件配对评估门控精炼本体
-
在三个基准、六个 LLM 骨干上一致优于 ReAct 基线和传统语义层基线
核心价值 :有效弥合智能体---数据鸿沟,使数据智能体能够以语义层面而非物理层面理解异构数据,同时通过演化循环降低总 token 成本、提升任务准确率。这里是自己的论文阅读记录,感兴趣的话可以参考一下,如果需要阅读原文的话可以看这里,如下所示:
项目地址在这里,如下所示:
摘要
数据智能体旨在完成面向异构数据(包括表格、文件和数据库)的自然语言指令。然而,数据智能体面临一个具有挑战性的智能体---数据鸿沟 :异构数据位于智能体之外,而智能体只能通过通用工具访问这些数据(例如列名和文件路径)。现有方法要么让智能体直接探索原始数据源,要么将人工构建的语义层注入提示词中。然而,这两种方法都难以扩展到大规模异构数据源,也无法适应不同的智能体行为。本文提出 EvoOntology ,一种面向数据智能体的自演化本体层。EvoOntology 将本体封装为一个 MCP 服务器,包含模式层、内容层和工具层,使智能体能够在运行时主动查询并与本体交互。为此,我们引入了一个用于自主构建本体的构建器智能体 ,以及一个自演化循环,通过归因引导的类型化编辑持续精炼本体,且仅在经过骨干条件配对评估后才接受这些编辑。在三个广泛采用的数据智能体基准上、使用四个 LLM 骨干进行的实验表明,EvoOntology 始终优于强基线和现有语义层方法,有效弥合了智能体---数据鸿沟,并实现了与异构数据更有效的交互。
引言
面向异构数据的数据智能体(Liu et al. 2026; Sahu et al. 2025; Li et al. 2023; Hong et al. 2025; Zhang et al. 2023a)旨在解决同时涉及结构化数据(例如表格和数据库)与非结构化数据(例如文档和文件)的自然语言任务。为完成此类任务,智能体必须持续与异构数据源交互,以收集生成最终答案所需的信息。近年来,大语言模型(LLM)工具使用方面的进展(Yao et al. 2022; Schick et al. 2023; Qin et al. 2023; Patil et al. 2024)使智能体能够直接访问和操作外部数据源,为此类数据交互提供了基础。
然而,与异构数据的直接交互引出了一个根本问题:数据智能体能否有效理解异构数据? 在实际部署中,数据以关系数据库、半结构化文件和文本文档的形式存在于智能体之外,而智能体只能通过 SQL 接口和文件读取器等通用工具访问数据。一个根本性挑战在于,这些异构数据源的结构和内容都无法先验获知。结果,智能体不得不通过反复发出探测查询、猜测所需概念所在位置并检查可能无关的内容来盲目探索底层数据。这种不匹配造成了持续存在的智能体---数据鸿沟。弥合这一鸿沟需要一个中间本体层,它显式地表示领域概念、将概念锚定到底层数据,并使智能体能够在语义层面而非物理层面与数据交互。
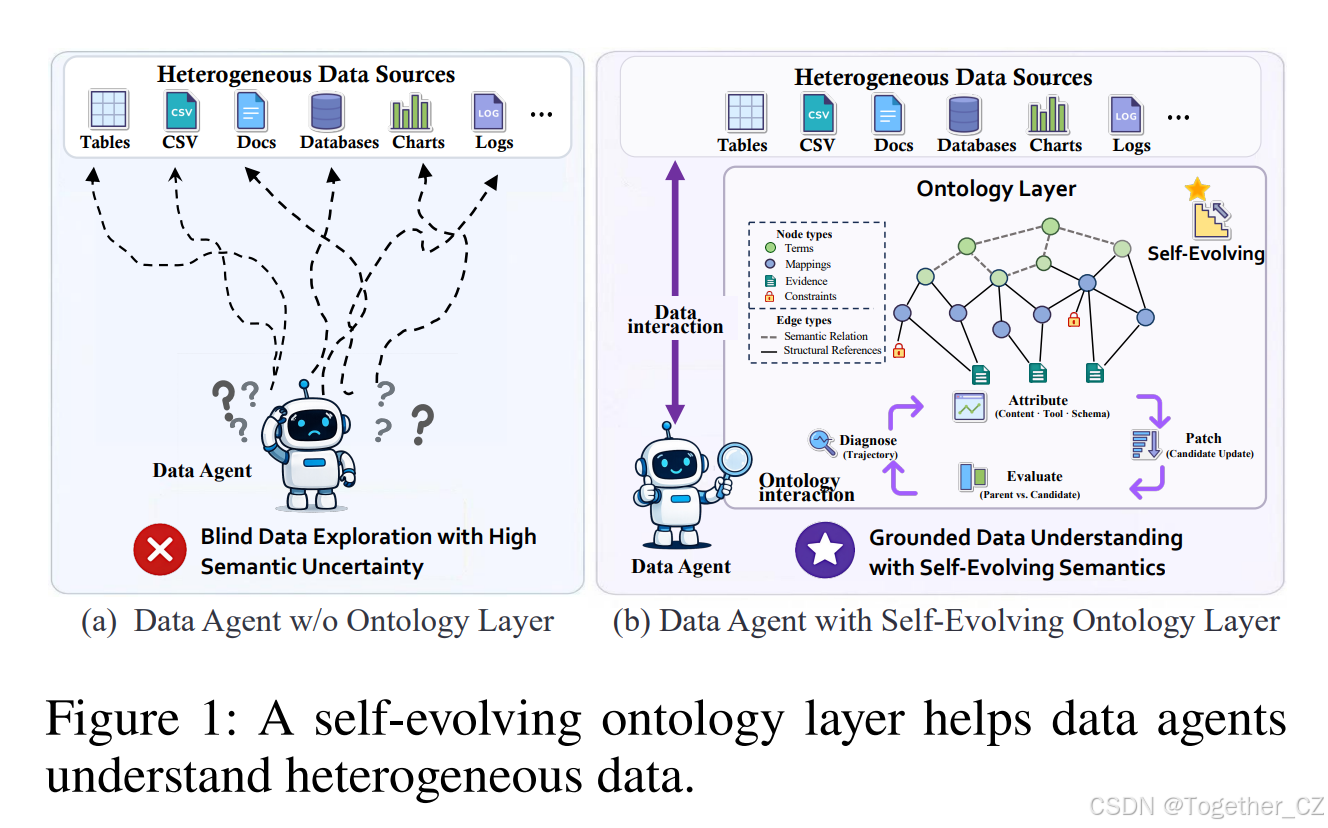
图 1:自演化本体层帮助数据智能体理解异构数据。
现有的智能体---数据交互方法大致可分为原始查询 和基于语义层的交互两类。原始查询方法(Pourreza and Rafiei 2023; Wang et al. 2025; Talaei et al. 2024)允许智能体直接检查模式并对底层数据发出探索性查询。虽然对小型且相对简单的数据源有效,但它们难以扩展到宽表异构数据,智能体很容易陷入重复且低效的探索。相比之下,语义层方法(Hitzler 2021; dbt Labs 2023; Feng et al. 2024; Chang and Fosler-Lussier 2023)提供元数据,包括模式、实体、指标和其他领域语义,以指导智能体。然而,由于上下文长度限制,将整个语义层纳入智能体上下文对于大型数据源而言并不现实。此外,现有语义层通常是预定义且人工维护的,构建成本高昂
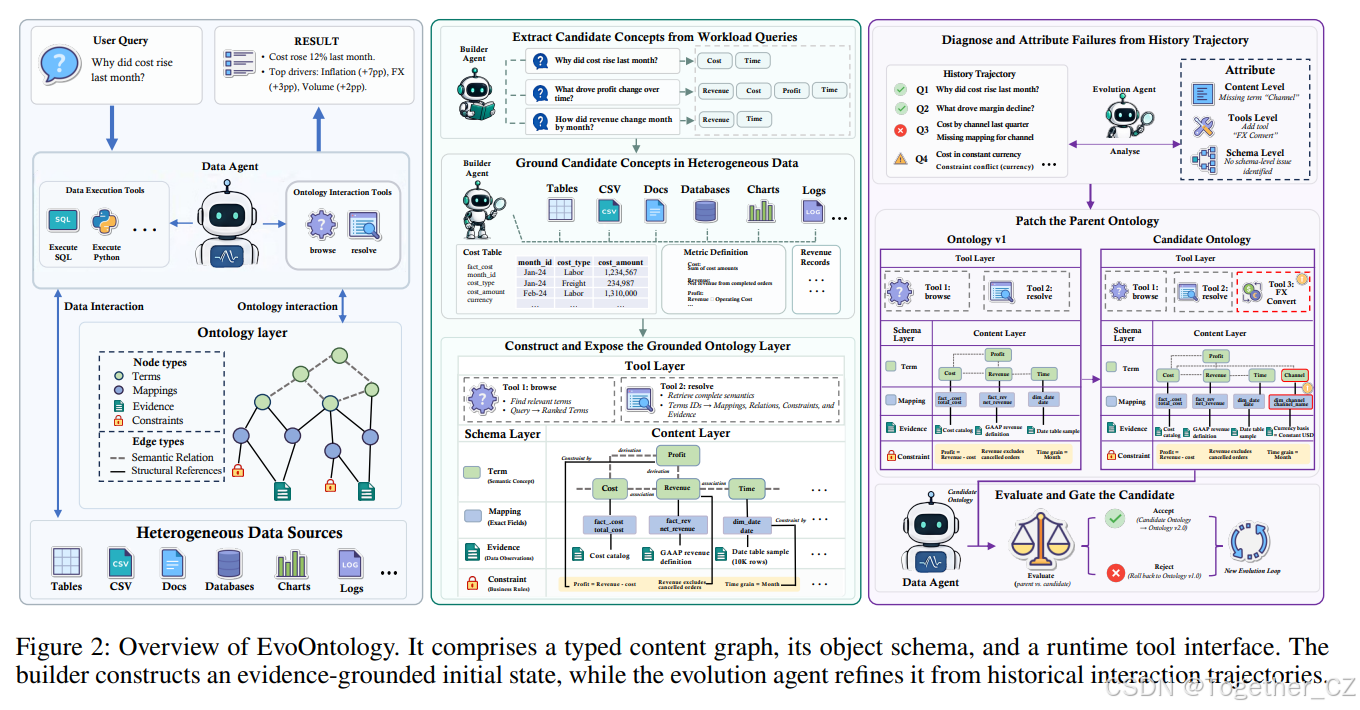
图 2:EvoOntology 概览。它包含一个类型化内容图、其对象模式以及一个运行时工具接口。构建器构建一个基于证据的初始状态,而演化智能体则从历史交互轨迹中精炼该状态。
内容层。 内容层 St 是一个类型化语义图,包含四个节点族和两个边族。节点族包括术语(Terms) 、映射(Mappings) 、约束(Constraints) 和证据(Evidence) 。术语表示领域概念,映射将术语锚定到字段和链接路径,约束管理术语的有效使用,证据支持术语的语义主张。边族包括语义关系(Semantic Relations) 和结构引用(Structural References)。语义关系通过关联、层次、组合、等价或派生连接术语。结构引用将术语链接到映射,并将约束和证据附加到它们所管理或支持的对象上。图 2 通过一个财务分析示例说明了这些组件。
基于证据的本体初始化
为每个数据源手动定义领域概念、字段映射、链接路径和语义约束需要大量专家工作。构建器智能体从训练工作负载和原始源构建初始本体,而不观察金标准答案。工作负载识别与智能体相关的语义,而可执行探针验证它们在底层数据中的锚定。
基于轨迹的本体演化
仅靠数据锚定并不能确保本体适合特定智能体。因此,EvoOntology 使用历史轨迹作为行为证据。成功的执行揭示了有效的语义结构和访问模式,而不成功的执行则暴露了缺失、误导或暴露不良的组件。
实验
基准
我们在三个具有异构模态和答案格式的数据智能体基准上评估 EvoOntology。所有评估均遵循每个基准的官方评估协议。
Deep Data Research(DDR-Bench) (Liu et al. 2026)评估跨异构源的开放式数据研究。我们在 10-K 场景上评估,并报告逐轮解释的消息级准确率(Message-Wise accuracy) 和全历史综合的轨迹级准确率(Trajectory-Wise accuracy)。
InsightBench (Sahu et al. 2025)是一个商业分析基准,由商业智能标志组成,每个标志配有一个 CSV 数据集和一个分析师应揭示的金标准洞察。我们报告洞察(Insight) 和**摘要(Summary)**得分。
BIRD (Li et al. 2023)是一个文本到 SQL 基准,针对真实世界数据库上的自然语言问题,在官方 Oracle Knowledge 设置下评估。Spider(Yu et al. 2018; Lei et al. 2025)等后续基准将该设置扩展到多模式和企业工作流。主要指标是执行准确率(Execution Accuracy, EX) ,次要指标是有效效率得分(Valid Efficiency Score, VES)。
实验设置
骨干模型。 我们在六个 LLM 骨干上评估 EvoOntology:GPT-5.5、GPT-5.6-sol、Claude-Sonnet-5、Claude-Opus-4.8、DeepSeek-V4-Flash 和 Qwen3.5-Flash。对于每个骨干,所有条件均使用相同的 ReAct(Yao et al. 2022)脚手架、原始数据工具、解码配置和交互预算。评分遵循每个基准的标准评估协议(Li et al. 2023; Sahu et al. 2025; Liu et al. 2026)。
基线。 我们在相同的 ReAct 脚手架和骨干下,将 EvoOntology 与两个基线进行比较。Baseline 运行不带任何本体层的 ReAct,因此智能体必须在每个任务中重新发现模式和领域词汇。Baseline + SL 将构建器智能体的语义层作为静态提示片段前置到智能体上下文中(Cao et al. 2024; Caferoglu and Ulusoy 2024; Li et al. 2024b; Chang and Fosler-Lussier 2023)。
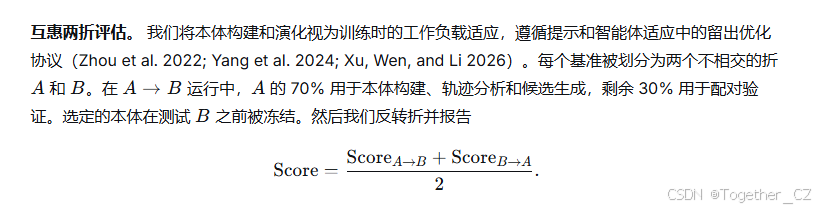
这种互惠设计遵循两折交换评估(Dietterich 1998; Wang et al. 2026)。所有方法使用相同的折分配和部署配置。相同的适应折用于所有相关条件下的本体构建和更新。留出折仅在最终评估时访问,且在本体冻结之后,其答案和评估器反馈从不用于本体构建、演化或候选选择。
主要结果
多源数据研究能力。 表 1 报告了 DDR-Bench 在六个 LLM 骨干上的结果。EvoOntology 在所有六个骨干上均提升了轨迹级准确率,相对于 Baseline 平均提升 +17.8 分。提升范围从 Qwen3.5-Flash 上的 +4.8 到 GPT-5.5 上的 +26.7,表明本体在基线能力差异显著的骨干上仍然有效。相比之下,Baseline + SL 将语义层作为静态提示注入上下文,并未始终优于无中介智能体,甚至在 Claude-Sonnet-5 上下降了 −15.0 分。Baseline + SL 与 EvoOntology 之间的差距源于层被使用的方式:静态提示片段与智能体的其他指令竞争,且无法逐轮修剪,而 EvoOntology 通过 MCP 工具暴露相同内容,智能体主动查询这些工具,仅检索与当前步骤相关的术语和映射。我们额外与 ReAct + Memory(Shinn et al. 2023; Wang et al. 2023; Madaan et al. 2023)进行比较,后者将过去轨迹存储为可检索的片段。如表 2 所示,基于记忆的持久化将轨迹级从 69.5 提升到 75.8,但仍比 EvoOntology 低 13.7 分,因为片段记忆仅重放已经做过的事情,而不暴露类型化的、可组合的结构。
表 1:DDR-Bench 10-K 场景的主要结果。括号内报告相对于 Baseline 结果的增益。
| 方法 | 骨干 | 消息级(%) | 轨迹级(%) | 总体(%) |
|---|---|---|---|---|
| Reported ReAct | Claude-Sonnet-4.5 | 77.6 | 60.6 | 69.1 |
| DeepSeek-V3.2 | 60.1 | 38.2 | 49.2 | |
| GLM-4.6 | 60.3 | 36.0 | 48.2 | |
| GPT-5.2 | 44.9 | 41.1 | 43.0 | |
| GPT-5-mini | 46.8 | 37.1 | 42.0 | |
| Kimi-K2 | 51.1 | 30.8 | 40.1 | |
| GPT-5.1 | 37.1 | 44.3 | 40.7 | |
| Gemini-3-Flash | 44.8 | 21.2 | 33.0 | |
| Baseline(无本体的 ReAct) | GPT-5.5 | 60.6 | 64.2 | 62.4 |
| GPT-5.6-sol | 64.0 | 68.5 | 66.3 | |
| Claude-Sonnet-5 | 74.3 | 72.5 | 73.4 | |
| Claude-Opus-4.8 | 74.0 | 73.0 | 73.5 | |
| DeepSeek-V4-Flash | 26.2 | 30.3 | 28.2 | |
| Qwen3.5-Flash | 16.4 | 14.3 | 15.4 | |
| Baseline + SL(ReAct + 语义层) | GPT-5.5 | 58.4 (-2.2) | 63.9 (-0.3) | 61.2 (-1.2) |
| GPT-5.6-sol | 62.5 (-1.5) | 65.5 (-3.0) | 64.0 (-2.3) | |
| Claude-Sonnet-5 | 65.6 (-8.7) | 57.5 (-15.0) | 61.5 (-11.9) | |
| Claude-Opus-4.8 | 65.9 (-8.1) | 71.4 (-1.6) | 68.6 (-4.9) | |
| DeepSeek-V4-Flash | 28.8 (+2.6) | 31.7 (+1.4) | 30.2 (+2.0) | |
| Qwen3.5-Flash | 14.8 (-1.6) | 13.3 (-1.0) | 14.1 (-1.3) | |
| EvoOntology | GPT-5.5 | 74.0 (+13.4) | 90.9 (+26.7) | 82.5 (+20.1) |
| GPT-5.6-sol | 78.2 (+14.2) | 93.5 (+25.0) | 85.9 (+19.6) | |
| Claude-Sonnet-5 | 78.4 (+4.1) | 81.3 (+8.8) | 79.9 (+6.5) | |
| Claude-Opus-4.8 | 78.0 (+4.0) | 92.3 (+19.3) | 85.2 (+11.7) | |
| DeepSeek-V4-Flash | 37.5 (+11.4) | 52.3 (+22.0) | 44.9 (+16.7) | |
| Qwen3.5-Flash | 21.1 (+4.7) | 19.1 (+4.8) | 20.1 (+4.8) |
在所有骨干上的总体性能,平均增益为 1.9 分,最大提升在 DeepSeek-V4-Flash 上(+6.1)。增益小于 DDR-Bench,因为 Insight 根据简短参考式发现进行评分,一旦答案与参考对齐便饱和。Baseline + SL 在 InsightBench 上恢复了大部分 Insight 增益,但在 Claude-Sonnet-5 Summary 上下降了 −3.3,而 EvoOntology 通过可查询工具而非静态提示暴露相同内容,在所有四个骨干上同时提升了 Insight 和 Summary。
数据检索能力。 表 4 报告了 BIRD 在 Oracle Knowledge 下六个骨干上的结果。EvoOntology 为每个骨干提升了 EX 和 VES,平均增益分别为 7.4 和 8.6 分。两个指标上的一致增益表明,本体同时提升了查询正确性和执行效率。Baseline + SL 呈现混合模式:EX 最多下降 −5.6(GPT-5.5),而 VES 在所有骨干上上升,表明静态语义层改善了 SQL 良构性,但分散了生成正确查询的注意力。一旦相同内容通过智能体主动查询的 MCP 工具暴露,并由演化循环精炼,EvoOntology 便恢复了 EX 增益,并在每个骨干上稳定优于两个基线以及先前的文本到 SQL 系统(Pourreza and Rafiei 2023; Wang et al. 2025; Talaei et al. 2024)。
表 2:在 DDR-Bench 上与基于记忆的持久化基线的比较,跨四个骨干平均。"ReAct + Memory"将过去轨迹存储为可检索片段,并将前 k 个注入提示词。
| 方法 | 轨迹级(%,↑) | Δ |
|---|---|---|
| Baseline(ReAct) | 69.5 | - |
| ReAct + Memory | 75.8 | +6.3 |
| EvoOntology | 89.5 | +20.0 |
表 3:InsightBench 主要结果(节选)。
| 方法 | 骨干 | 洞察(%,↑) | 摘要(%,↑) | 总体(%,↑) |
|---|---|---|---|---|
| Pandas Agent | GPT-4o | 54.0 | 40.0 | 47.0 |
| AgentPoirot | GPT-3.5-turbo | 50.0 | 31.0 | 40.5 |
| AgentPoirot | GPT-4-turbo | 56.0 | 35.0 | 45.5 |
| AgentPoirot | Llama-3-70B | 52.0 | 33.0 | 42.5 |
| AgentPoirot | GPT-4o | 60.0 | 44.0 | 52.0 |
| Baseline(ReAct) | GPT-5.5 | 52.9 | 47.6 | 50.3 |
| GPT-5.6-sol | 51.6 | 49.4 | 50.5 | |
| Claude-Sonnet-5 | 53.3 | 51.3 | 52.3 | |
| Claude-Opus-4.8 | 54.9 | 49.9 | 52.4 | |
| DeepSeek-V4-Flash | 45.0 | 34.6 | 39.8 | |
| Qwen3.5-Flash | 37.5 | 26.2 | 31.9 | |
| Baseline + SL | GPT-5.5 | 53.4 (+0.5) | 48.6 (+1.0) | 51.0 (+0.8) |
| GPT-5.6-sol | 51.3 (-0.3) | 50.8 (+1.4) | 51.1 (+0.6) | |
| Claude-Sonnet-5 | 53.5 (+0.2) | 48.0 (-3.3) | 50.8 (-1.6) | |
| Claude-Opus-4.8 | 55.8 (+0.9) | 50.5 (+0.6) | 53.2 (+0.8) | |
| DeepSeek-V4-Flash | 47.0 (+2.0) | 36.5 (+1.9) | 41.8 (+2.0) | |
| Qwen3.5-Flash | 39.0 (+1.5) | 25.2 (-1.0) | 32.1 (+0.2) | |
| EvoOntology | GPT-5.5 | 53.4 (+0.5) | 48.6 (+1.0) | 51.0 (+0.8) |
| GPT-5.6-sol | 53.2 (+1.6) | 50.9 (+1.5) | 52.1 (+1.6) | |
| Claude-Sonnet-5 | 54.4 (+1.1) | 51.5 (+0.2) | 53.0 (+0.7) | |
| Claude-Opus-4.8 | 55.8 (+0.9) | 50.5 (+0.6) | 53.2 (+0.8) | |
| DeepSeek-V4-Flash | 49.2 (+4.2) | 42.6 (+8.0) | 45.9 (+6.1) | |
| Qwen3.5-Flash | 39.3 (+1.8) | 27.6 (+1.4) | 33.4 (+1.6) |
本体层的效果
为区分构建器构建的本体贡献与自演化带来的额外增益,我们比较三种设置:Baseline 、Initial 和 Evolved。Baseline 不使用本体层,Initial 使用构建器智能体在演化前构建的本体,Evolved 使用自演化后的最终本体。图 3 报告了每种骨干在三种设置下的性能。为总结总体趋势,我们对每个基准和设置跨四个骨干平均主要指标得分,并比较所得均值。
初始本体相对于无本体基线建立了显著改进,而自演化在所有三个基准上持续扩展了这一增益。在 DDR-Bench 上,平均轨迹级得分从 Baseline 到 Initial 增加了 12.3 个百分点,随后从 Initial 到 Evolved 又进一步提升了 7.7 个百分点。
表 4:Oracle Knowledge 下 BIRD 的主要结果。VES 以 0-100 分报告。括号内报告相对于相应 Baseline 结果的增益。
| 方法 | 骨干 | EX(%,↑) | VES(%,↑) |
|---|---|---|---|
| GPT-4 | GPT-4 | 46.4 | - |
| DIN-SQL | GPT-4 | 50.7 | 58.8 |
| DAIL-SQL | GPT-4 | 54.8 | 56.1 |
| TA-SQL | GPT-4 | 56.2 | - |
| MAC-SQL | GPT-4 | 57.6 | 58.8 |
| MCS-SQL | GPT-4 | 63.4 | - |
| CHESS | GPT-4o | 65.0 | 62.8 |
| Baseline(无本体的 ReAct) | GPT-5.5 | 61.5 | 63.4 |
| GPT-5.6-sol | 63.5 | 65.6 | |
| Claude-Sonnet-5 | 61.9 | 63.7 | |
| Claude-Opus-4.8 | 67.5 | 69.6 | |
| DeepSeek-V4-Flash | 33.1 | 36.4 | |
| Qwen3.5-Flash | 46.5 | 47.9 | |
| Baseline + SL | GPT-5.5 | 55.9 (-5.6) | 67.7 (+4.3) |
| GPT-5.6-sol | 63.0 (-0.5) | 68.9 (+3.3) | |
| Claude-Sonnet-5 | 60.8 (-1.1) | 65.8 (+2.1) | |
| Claude-Opus-4.8 | 66.2 (-1.3) | 75.0 (+5.4) | |
| DeepSeek-V4-Flash | 36.3 (+3.2) | 37.2 (+0.7) | |
| Qwen3.5-Flash | 48.0 (+1.5) | 51.9 (+4.0) | |
| EvoOntology | GPT-5.5 | 68.9 (+7.4) | 71.1 (+7.7) |
| GPT-5.6-sol | 70.7 (+7.2) | 73.0 (+7.4) | |
| Claude-Sonnet-5 | 71.8 (+9.9) | 74.1 (+10.4) | |
| Claude-Opus-4.8 | 78.3 (+10.8) | 80.5 (+10.9) | |
| DeepSeek-V4-Flash | 39.4 (+6.4) | 44.1 (+7.6) | |
| Qwen3.5-Flash | 49.1 (+2.5) | 55.2 (+7.3) |
首先增加了 0.8 分,然后通过演化又增加了 0.2 分。在 BIRD 上,平均 EX 得分随初始本体提高了 5.1 个百分点,演化后进一步提高了 3.7 个百分点。这些结果表明,构建器构建的本体提供了有效的起点,而自演化循环对于实现全部性能增益至关重要,并持续将本体改进到超出其初始状态。
分析
为更好地理解 EvoOntology 优势的来源和行为,我们进行了一系列深入分析。除非另有说明,本节所有分析均在 DDR-Bench 上跨四个骨干(GPT-5.5、GPT-5.6-sol、Claude-Sonnet-5、Claude-Opus-4.8)进行。
迭代演化的效果
为评估观察到的增益是否通过许多小编辑累积,而非坍缩为单轮,我们绘制了部署智能体在 DDR-Bench 上跨已接受演化轮次序列的主要得分。每轮对应一个通过配对门控的候选,父代线追踪如果不运行更多轮次将保留的本体版本的得分。如图 4 所示,所有四个骨干从 Initial 到已接受轮次均单调改进,GPT-5.6-sol 在五个已接受轮次后达到 93.5 轨迹级,Claude-Opus-4.8 在四个轮次后达到 92.3。值得注意的是,轨迹在最后两轮趋于平坦,这与一旦本体覆盖了反复出现的跨文件概念,失败签名变得罕见一致。结果表明,表 1 中报告的增益是收敛精炼的结果,而非单一幸运补丁,这验证了四步演化循环的设计。
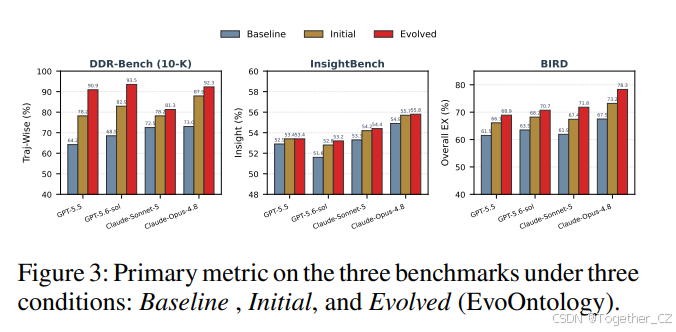
图 3:三个基准在三种条件下的主要指标:Baseline、Initial 和 Evolved(EvoOntology)。
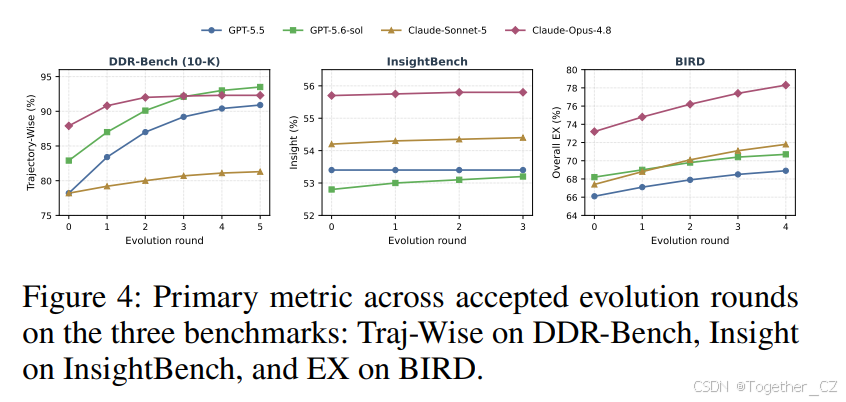
图 4:三个基准上跨已接受演化轮次的主要指标:DDR-Bench 上的轨迹级、InsightBench 上的 Insight 和 BIRD 上的 EX。
演化循环的消融研究
通过依次禁用四个步骤(诊断、归因、补丁、门控)并比较所得最终 Evolved 得分在 DDR-Bench 上跨四个骨干的平均值,评估演化循环中四个步骤的相对贡献。每个步骤的禁用变体为:w/o Diagnose 跳过失败轨迹聚类步骤,要求演化智能体从最近轨迹的随机样本中提出编辑;w/o Attribution 丢弃层级标签,允许智能体在任意层级提交编辑而不陈述假设;w/o Patch 阶段用演化智能体直接从诊断产生的自由形式本体重写替代类型化的、假设条件化的编辑;w/o Gate 接受每个候选补丁。如表 5 所示,移除门控导致最大下降(-11.2 轨迹级),因为未过滤的候选引入了下一轮无法总是撤销的回退。移除归因步骤下降 -6.3,因为没有层级标签,循环在失败是清单问题时倾向于进行内容编辑,反之亦然。移除诊断步骤下降 -4.8,而将类型化补丁替换为自由形式重写下降 -1.7。结果表明,门控和归因是两个承重部件,这验证了演化循环设计比迭代更具选择性。
表 5:演化循环四个步骤的消融,跨四个骨干平均。
| 变体 | 轨迹级(%,↑) | Δ |
|---|---|---|
| 完整循环 | 89.5 | - |
| w/o Gate | 78.3 | -11.2 |
| w/o Attribution | 83.2 | -6.3 |
| w/o Diagnose | 84.7 | -4.8 |
| w/o Patch(自由形式) | 87.8 | -1.7 |
表 6:DDR-Bench 上演化循环三个可编辑层级的消融,跨四个骨干平均。
| 变体 | 轨迹级(%,↑) | Δ |
|---|---|---|
| Baseline | 69.5 | - |
| 仅内容演化 | 78.2 | +8.7 |
| 仅工具演化 | 82.7 | +13.2 |
| 仅模式演化 | 73.1 | +3.6 |
| 完整三层演化 | 89.5 | +20.0 |
演化循环一次限制为单层级,并与 DDR-Bench 上的完整三层变体比较,跨四个骨干平均。如表 6 所示,仅工具演化恢复了最大的单层级增益(相对于 Baseline 为 +13.2),这与清单重塑是归因分析中浮现的主导杠杆一致。仅内容和仅模式演化分别贡献 +8.7 和 +3.6,但都没有达到完整三层循环的 +20.0。结果表明,三个层级是互补的而非可替代的,这验证了在三个可编辑层级上运行的演化循环设计。
本体结构的消融研究
我们从最终 Evolved 本体中屏蔽每个可移除对象族,在 DDR-Bench 上报告四个骨干的平均性能。如表 7 所示,屏蔽映射 导致最大下降(−13.4 轨迹级),这与映射作为唯一将术语锚定到具体列和连接路径的对象角色一致。屏蔽证据 下降 −8.7,因为没有探测查询,智能体无法针对底层值分布验证候选 SQL 片段。屏蔽约束 和关系 产生较小下降(−3.5 和 −2.1),而术语无法单独屏蔽,因为其他每个族都引用它们。这些发现确定映射和证据是两个承重族,这验证了我们要求每个提交条目都锚定在探测查询而非仅自然语言描述中的决定。
表 7:DDR-Bench 上本体内容层五个对象族的消融,跨四个骨干平均。术语无法单独屏蔽,故省略。
| 变体 | 轨迹级(%,↑) | Δ |
|---|---|---|
| 完整 EvoOntology | 89.5 | - |
| w/o Mappings | 76.1 | -13.4 |
| w/o Evidence | 80.8 | -8.7 |
| w/o Constraints | 86.0 | -3.5 |
| w/o Relations | 87.4 | -2.1 |
跨骨干差异
我们研究不同骨干是否收敛到相似本体,还是发展出不同本体,通过比较它们在 DDR-Bench 上已接受术语标识符集合的成对 Jaccard 重叠。如图 5a 所示,没有一对超过 0.62 重叠,两个 Claude 骨干之间的共享(0.55)少于两个 GPT 骨干之间的共享(0.61)。已接受的编辑在不同骨干之间也不同。例如,Claude-Opus-4.8 比 Claude-Sonnet-5 保留更详细的清单变体,而 GPT-5.5 在 Evidence 下引入短 SQL 片段库,这些在 Claude-Opus-4.8 本体中不出现。然而,仅标识符重叠无法确定语义等价,因为不同标识符可能编码相似概念。我们进一步通过将每个演化存储应用于所有四个骨干并测量 DDR-Bench 上的轨迹级性能来评估跨骨干迁移。如图 5b 所示,对角线一致地是其列的最高条目,每个非对角线相对于同骨干存储至少下降 6.6 分;从对角线到非对角线的平均列下降范围从 −6.6(Sonnet-5)到 −10.9(GPT-5.5)。这些结果表明,不同骨干从相同初始化产生不同的演化本体存储。跨骨干迁移结果进一步表明,骨干特定演化是有益的。
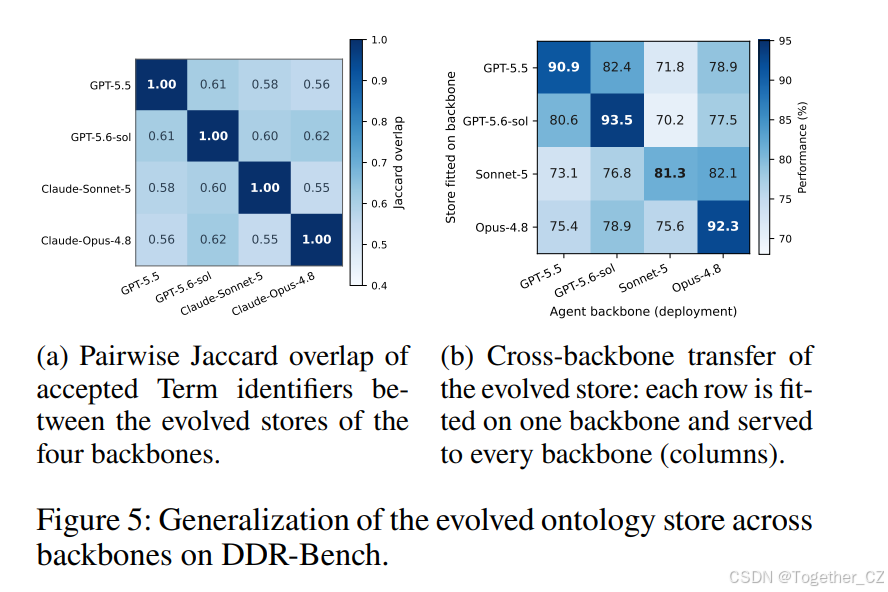
图 5:DDR-Bench 上演化本体存储跨骨干的泛化。(a) 四个骨干的演化存储之间已接受术语标识符的成对 Jaccard 重叠。(b) 演化存储的跨骨干迁移:每行在一个骨干上拟合,并服务于每个骨干(列)。
结论
本文提出 EvoOntology,一种面向数据智能体的自动构建且自演化的交互式本体层。EvoOntology 将本体封装为 MCP 服务器,智能体在运行时主动查询,并通过归因引导的类型化编辑精炼它,这些编辑仅在经过骨干条件配对评估门控后才被接受。在基准和六个 LLM 骨干上的实验中,EvoOntology 始终优于 ReAct 基线和传统语义层基线,为帮助数据智能体理解异构数据提供了有效解决方案。