本文为 AtomGit 码动四季·开源同行征稿活动参与文章
摘要:LLM 分诊解决 issue 的归类效率,解决不了 issue 的命运。ArticlePilot 的分诊体系用"分流页 + 三模板"把"三无"issue 占比从 30% 压到 6%,追问后石沉大海率从 57% 降到 20%,首响从 2.7 天缩到 1.1 天。本文拆解体系四件:模板怎么用必填四字段当过滤器、八个标签怎么保证人和机器说同一种语言、SLA 为什么只承诺自动化能兑现的部分、拒绝话术怎么决定漏斗宽度------以及必填字段、24 小时承诺、标签膨胀三个设计坑的完整复盘。
系列写到第四篇时,我在评论区收到一条留言,大意是:"你的机器人分类准确率 87%,然后呢?被标记成 bug 的 issue 还是没人理,我的项目也是这样。"
这条留言点中了 04 号文章的边界:LLM 分诊解决的是 issue 的归类效率 ,解决不了 issue 的命运------一个被正确分类的 issue,如果没有模板约束信息质量、没有标签定义优先级、没有 SLA 兜底响应、没有 good first issue 通道转化为贡献,它只是从"乱糟糟的收件箱"搬进了"整整齐齐的收件箱"。
系列收官这篇,讲分诊体系里"机器不管的部分":模板怎么设计、标签怎么定语义、SLA 怎么承诺、贡献者怎么不被吓跑。文中的模板和话术都是 ArticlePilot 仓库的实际在用版本,不是设计稿。
一、先看漏斗:你的贡献者在哪一层流失
分诊体系设计的第一步不是写模板,是搞清楚人从哪里流失。开源项目的贡献者漏斗长这样:
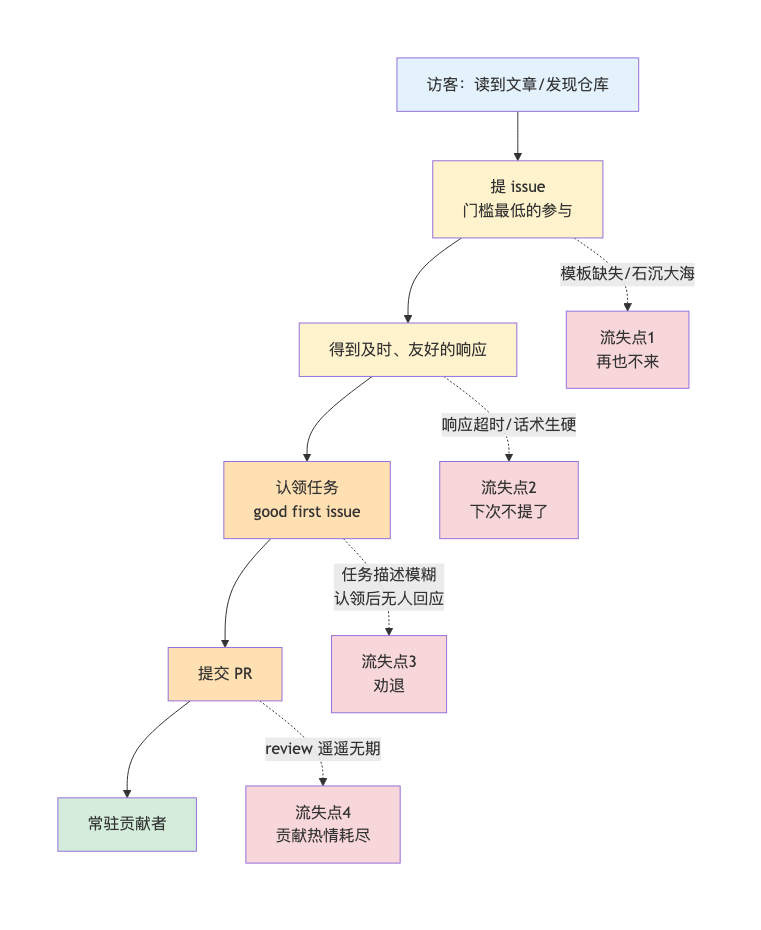
四个流失点里,前两个发生在 issue 环节------这正是分诊体系的地盘。后两个在任务认领和 PR review 环节,本篇第八节会简要带过。
我仓库开放 issue 后首月的真实数据,把流失点照得清清楚楚:23 个 issue 中,"三无" issue(无版本号、无复现步骤、无日志)7 个,其中 4 个在第一轮追问后发布者再没回复过------追问本身成了劝退动作;3 个 feature 建议收到回复超过 48 小时,其中 1 个明确表达了"愿意自己写",但因为没有任何任务认领机制,这份热情没有着陆点。
二、模板:过滤器,更是引导员
2.1 三套模板 + 一道前置分流
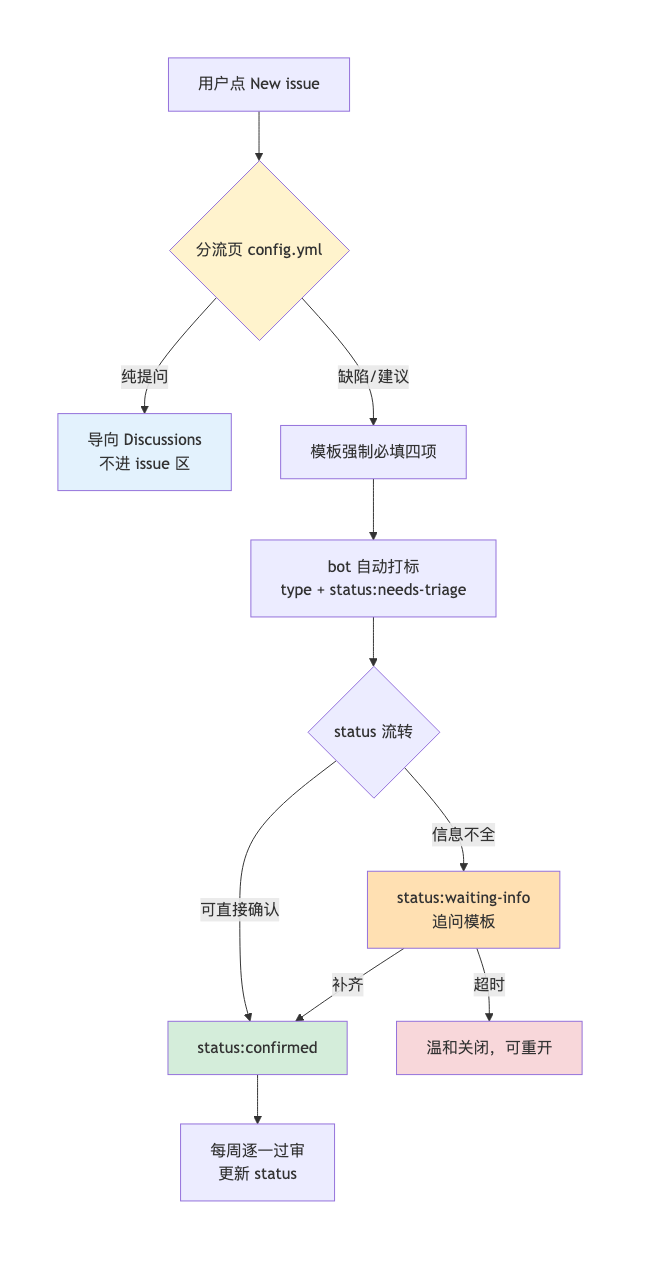
issue 模板的完整解不是三个模板文件,而是"分流页 + 三模板"的结构。用户点"New issue"先看到的不是空白框,而是分流页(config.yml):
yaml
# .github/ISSUE_TEMPLATE/config.yml
blank_issues_enabled: false
contact_links:
  - name: 使用提问(先查文档)
    url: https://atomgit.com/{owner}/{repo}/discussions
    about: 使用问题请到 Discussions,issue 只收缺陷报告与功能建议
  - name: 常见问题 FAQ
    url: https://atomgit.com/{owner}/{repo}#faq
    about: 部署失败、Token 配置、平台适配等高频问题已有解法
blank_issues_enabled: false 是关键一刀:不给空白 issue 入口。没有模板的 issue 就是"三无"预备役。前置分流把纯提问挡到 Discussions 后,issue 区剩下的都是带着明确意图来的。
2.2 bug 模板:必填字段收敛到四个
YAML 表单(issue forms)可以强制必填,但必填项是双刃剑------约束越强,完成率越低。我第一版的 bug 模板设了 7 个必填字段,观察两周后发现表单放弃率高得反常,有人宁可去 Discussions 发泄也不填表。
收敛后的版本,必填只剩四个:
yaml
# .github/ISSUE_TEMPLATE/bug_report.yml(节选)
name: 缺陷报告
description: 接口报错、页面异常、发布失败
labels: ["type:bug", "status:needs-triage"]
body:
  - type: input
    id: version
    attributes:
      label: 版本/commit
      description: 填 Release 标签,或运行 `git rev-parse --short HEAD` 的输出
    validations:
      required: true
  - type: textarea
    id: reproduce
    attributes:
      label: 复现步骤
      description: 从什么命令开始,期望什么,实际发生了什么
    validations:
      required: true
  - type: textarea
    id: logs
    attributes:
      label: 报错日志/截图
      description: 完整报错信息,文本优于截图
    validations:
      required: true
  - type: dropdown
    id: os
    attributes:
      label: 操作系统
      options: ["macOS", "Windows", "Linux"]
    validations:
required: true被降级为选填的三项:终端环境细节、仓库版本、补充截图------这些信息可以追问补齐,不值得为它们劝退一个报障者。必填字段的判断标准:缺了它就无法开始排查的,才配 required。
2.3 feature 模板里的"钩子"
feature 模板比 bug 模板多设计了一个下拉字段:
yaml
  - type: dropdown
    id: contribution-willingness
    attributes:
      label: 你愿意参与实现吗?
      options:
        - "只提建议,希望维护者实现"
        - "愿意讨论方案"
        - "愿意自己提 PR(可分配 good first issue)"
    validations:
      required: true
这个钩子字段是首月数据教训的直接产物:那个明确说"愿意自己写"的贡献者,如果当时有这个字段,他的 issue 会直接被标上 good first issue 并回复认领规则------一条现成的贡献者,不需要任何额外运营动作。漏斗从"提 issue"跳到"提 PR"的最短路径,就藏在这个下拉框里。
三、标签体系:两个维度,八个语义标签
标签是最容易被滥用成"心情记录"的治理工具。我删掉了第一版里 14 个随手建的标签,重建为双维体系:
| 维度 | 标签 | 判定标准(速查表) |
|---|---|---|
| type(它是什么) | type:bug |
已复现或描述足以定位的缺陷 |
type:feature |
新能力诉求 | |
type:question |
使用提问(通常被分流到 Discussions) | |
type:docs |
文档改进建议 | |
| status(它到哪了) | status:needs-triage |
新进件,等待分诊 |
status:waiting-info |
已追问,等提交者补充 | |
status:confirmed |
确认有效,进处理队列 | |
status:duplicate |
重复,评论中关联原 issue |
第一维度没有 priority------这是我刻意砍掉的。一个人的维护带宽撑不起三维度,而且没有兑现能力的优先级是负资产(为什么砍,坑 3 有完整复盘)。任务难度维度用 good first issue 单独承担,不进 status 流转。
标签判定的一页速查表我直接钉在仓库 docs/labels.md,配合 04 号 bot 自动打标使用;bot 的分类词表与这张速查表是同一份 YAML 源,保证人和机器说同一种语言。
从分流页到标签流转的完整通路------每个 issue 进来先过哪道门、贴哪张签:
四、SLA:只承诺做得到的,其余诚实说明
我在 README 写了三条响应承诺,每一条都先算过自己能否长期兑现:
| 承诺 | 内容 | 为什么敢承诺 |
|---|---|---|
| 首响 | 新 issue 72 小时内首次回复(含分诊 bot 自动确认) | 分诊自动化后,"确认收到"环节零人工 |
| 追问响应 | 提交者补充信息后 72 小时内重新处理 | 同上,重分类是机器活 |
| 修复排期 | 不承诺具体修复时间,只承诺 confirmed 的 issue 每周逐一过审并更新 status | 诚实:单人维护,排期承诺必然违约 |
第三条是踩过坑才改成这样的。早期我写过"高危问题 24 小时内修复"------写的时候热血,两周后就被一个 issue 的评论戳穿:"上次说的 24 小时呢?"SLA 的信用是不可再生资源,违约一次,之后所有承诺都会被按最坏预期解读。
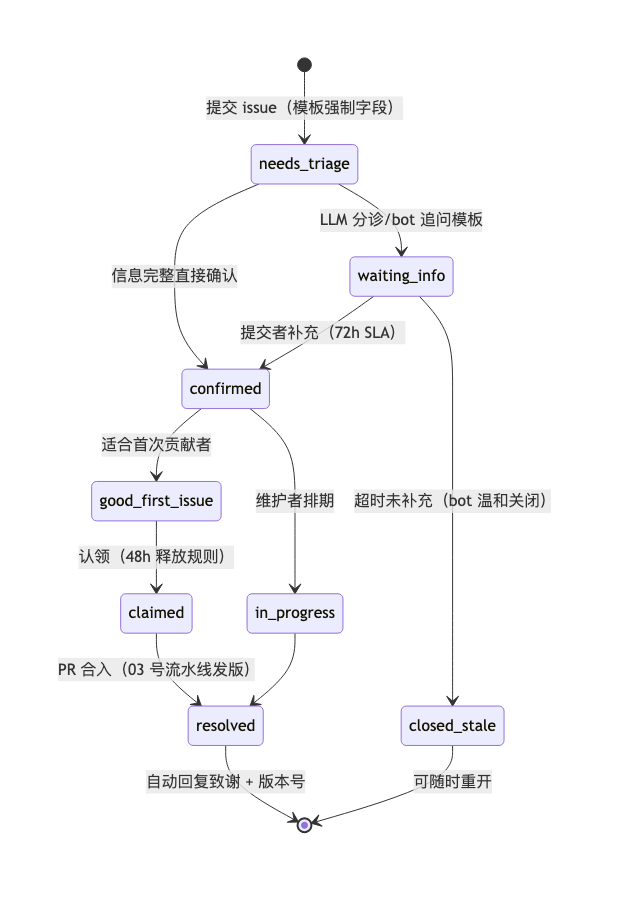
48 小时认领释放规则也属于这个体系:good first issue 被认领后 48 小时无动静,bot 自动评论"释放认领",标签重新开放。规则公开写在 CONTRIBUTING.md,机器执行,无人情债。
五、回复话术:拒绝的温度决定贡献者的去留
分诊体系里最考验人的不是流程,是那几类"必须说不"的回复。三类高频拒绝场景,我的在用话术:
追问信息 (对应 status:waiting-info):
感谢反馈。要定位这个问题,还需要补充:1) 运行
{version_cmd}的输出;2) 从哪条命令开始复现。补齐后我会立即重新处理。可以参考文档的"环境信息收集"一节。
指向重复 (对应 status:duplicate):
这与 #{原编号} 是同一个问题,我先关闭这条,后续进展在原 issue 里更新。你的描述里提到的"{补充细节}"原 issue 没有覆盖,已合并过去------感谢补充。
拒绝 feature(保持 open 或转 Discussions,不轻易 close):
这个需求超出了本工具的定位({一句话定位}),短期内不计划实现。不过你的场景很有价值,我建议:1) 移步 Discussions 的 ideas 区继续讨论;2) 如果你有兴趣基于现有接口自己实现,我可以协助设计接入方式。
三条话术的共同结构:先接住情绪或肯定价值 → 说清"不"的理由 → 给出下一步可走的路。拒绝 issue 的语言决定了贡献者是"这次没成"还是"这个维护者傲慢"------前一种人还会回来,后一种会带着情绪走并且告诉别人。
六、设计期的三个坑:正文的坑,展开的账
前四节的每个设计决策背后都有一次返工,把三笔账摊开:
坑 1:bug 模板设 7 个必填字段,两周换来高放弃率
现象:第一版 bug 模板 7 个必填字段,观察两周发现表单放弃率高得反常------有人宁可去 Discussions 发泄也不填表。
根因:把"我排查方便"当成了设计目标,忘了站在填表人一侧:约束越强,完成率越低。
解决:必填收敛到四个(版本、复现步骤、日志、操作系统),其余三项降级为选填、追问补齐;判断标准定成一句话------缺了它就无法开始排查的,才配 required。
效果:"三无"issue 占比从 30% 降到 6%,追问后石沉大海率从 57% 降到 20%(见第七节对比表)。
感受:少三个必填字段,换回一倍的表单完成意愿,这买卖划算。
教训:模板的第一读者是报障的人,不是排查的人。
坑 2:SLA 写了"24 小时修复",两周就被戳穿
现象:早期 README 承诺"高危问题 24 小时内修复",写的时候热血;两周后一个 issue 的评论区出现一句"上次说的 24 小时呢?"。
根因:承诺只有愿望没有核算------单人维护的修复排期根本不受自己控制,必然违约。
解决:重写成三条可核算的承诺(见第四节):首响和追问响应交给自动化的部分敢承诺 72 小时,修复排期只承诺"confirmed 的 issue 每周逐一过审并更新 status"。
效果:新承诺上线后零违约,人工首响从 2.7 天缩到 1.1 天,评论区再没出现过催账。
感受:SLA 被戳穿那次的难堪,比任何一次发版事故都记得牢。
教训:SLA 的信用是不可再生资源,违约一次,之后所有承诺都会被按最坏预期解读。
坑 3:随手建了 14 个标签,沦为"心情记录"
现象 :第一版标签是遇到一个 issue 建一个,攒到 14 个,语义互相重叠------urgent 和 high 并存,wontfix 和 invalid 分不清,人和 bot 都没法按稳定语义消费。
根因:标签跟着当下情绪长,没有维度设计,更没有判定标准。
解决 :全部删掉重建为 type + status 双维八个(见第三节速查表),判定标准钉在 docs/labels.md,分诊 bot 的分类词表与这份速查表同源。
效果:人和机器说同一种语言,bot 打标可复核;顺手砍掉了没有兑现能力的 priority 维度------一个人的带宽撑不起三维度。
感受:标签多到记不住的那天我才承认,治理工具的膨胀速度比治理对象快得多。
教训:标签少而准胜过多而全;没有判定标准的标签,建得越快烂得越快。
七、效果:漏斗前两层的数字变化
体系(模板 + 标签 + SLA + 话术)上线前后各一个月的对比(04 号的 bot 在两组数据里都在运行,本表隔离的是体系设计的增量):
一个 issue 从进入分诊到关闭的完整生命周期,是理解这套体系运作方式的最短路径:
体系(模板 + 标签 + SLA + 话术)上线前后各一个月的对比(04 号的 bot 在两组数据里都在运行,本表隔离的是体系设计的增量):
| 指标 | 上线前 | 上线后 | 变化 |
|---|---|---|---|
| "三无" issue 占比 | 30%(7/23) | 6%(1/17) | 模板强制的直接效果 |
| 追问后石沉大海率 | 57%(4/7) | 20%(1/5) | 追问话术 + 必填收敛 |
| issue 首响时长(人工部分) | 平均 2.7 天 | 平均 1.1 天 | SLA 兜底 + 分诊减负 |
| feature 建议转认领 | 0/3 | 2/4 | "钩子"字段 + 认领规则 |
| good first issue 平均停留 | 26 天 | 9 天 | 难度校准 + 48h 释放 |
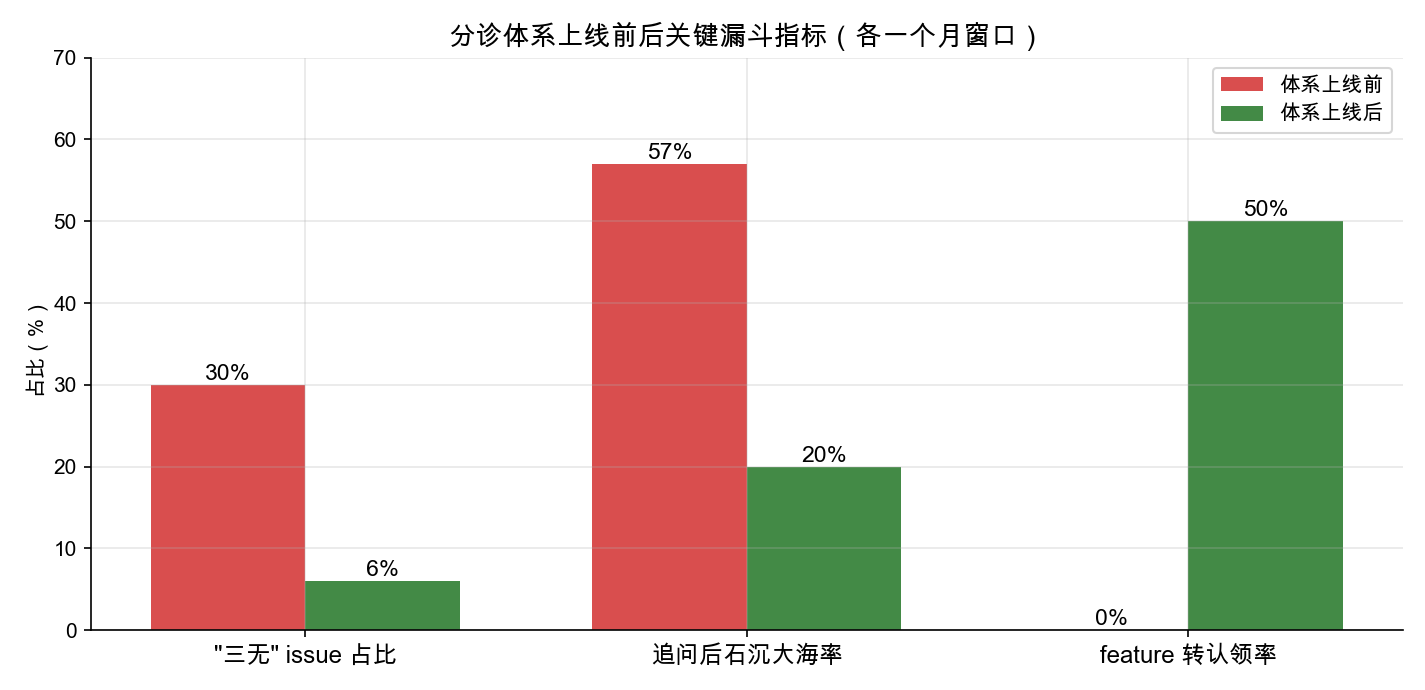
"石沉大海率"的变化最说明问题:从 57% 降到 20%。这 20% 里剩下的那一个,我复盘时觉得是真心不用了的产品反馈------分诊体系能把"被流程劝退"的流失清干净,但清不掉"本来就不在乎"的流失,这是体系的合理边界。
八、超越 issue:认领与 review 环节的两个要点
漏斗的后两个流失点不在 issue 区,简要给出对策:
任务认领 :good first issue 的准入必须校准------验收标准是"贡献者凭 issue 描述本身就能开工,不需要私聊维护者"。我第一批 good first issue 里混进了一个需要理解全套目录结构才能做的任务,认领者三天后留言放弃。此后每个任务打标前,我先自问:"假设我完全不了解这个仓库,能按这个 issue 做完吗?"不能就补描述,补不出就不打标------标签信用比任务消化速度重要。
PR review:CONTRIBUTING.md 里公开 review 的默认时限(一周内首次回应)和合并标准(CI 绿 + 符合 03 号的 commit 规范 + 02 号的 DCO sign-off)。贡献者最怕的不是被拒,是不知道自己的 PR 处于什么状态------时限公开后,"遥遥无期"变成"下周三前一定有回音"。
九、总结
系列写到这里,把我踩出来的四个结论留下。模板是过滤器更是引导员,必填字段只留"缺了没法干活"的,分流页替 issue 区挡掉纯提问。标签少而准胜过多而全,两个维度八个标签,每个都有可执行的判定标准,人和机器共用一份词表。SLA 承诺做得到的,信用不可再生,宁可承诺得少,不可违约一次。拒绝的话术决定漏斗的宽度,每一句"不"都要给一条"可以这么走"。
至此这个系列收尾:01 把仓库洗干净开源,02 定好法律边界,03 让发版零人工,04 让机器管筛选,05 让每个进来的人不被晾着。一个人维护的仓库,靠这套组合做到"响应比很多团队项目还快"------不是因为我更勤奋,是因为每个环节只让机器做它擅长的,人只出现在必须人在场的地方。
你的 issue 首响时长是多少?作为贡献者,你被晾过最久的一次是多久?评论区对个数。
真实性声明
本文模板、标签表、话术均为 ArticlePilot 仓库(地址见文末)实际在用版本;对比数据来自平台后台两个自然月的统计(样本量已注明);"钩子"字段与 48 小时释放规则为真实上线功能。文中引用的留言经当事人授权概括转述,已脱敏。
开源仓库地址
- ArticlePilot (本文分诊体系的落地案例,含 issue 模板、标签词表与 04 号的三件套治理配置):https://atomgit.com/dickeryang/articlepilot
参考资源
专栏导航
- 上一篇 :用 AI 机器人治理开源仓库:三件套落地
- 下一篇:AI 编程助手从企业走向开源社区:选型决策矩阵与落地避坑指南
如果本文对你有帮助,欢迎点赞、收藏、转发。有任何问题或建议,请在评论区留言交流。行文仓促,定有不足之处,欢迎各位朋友在评论区批评指正,不胜感激。