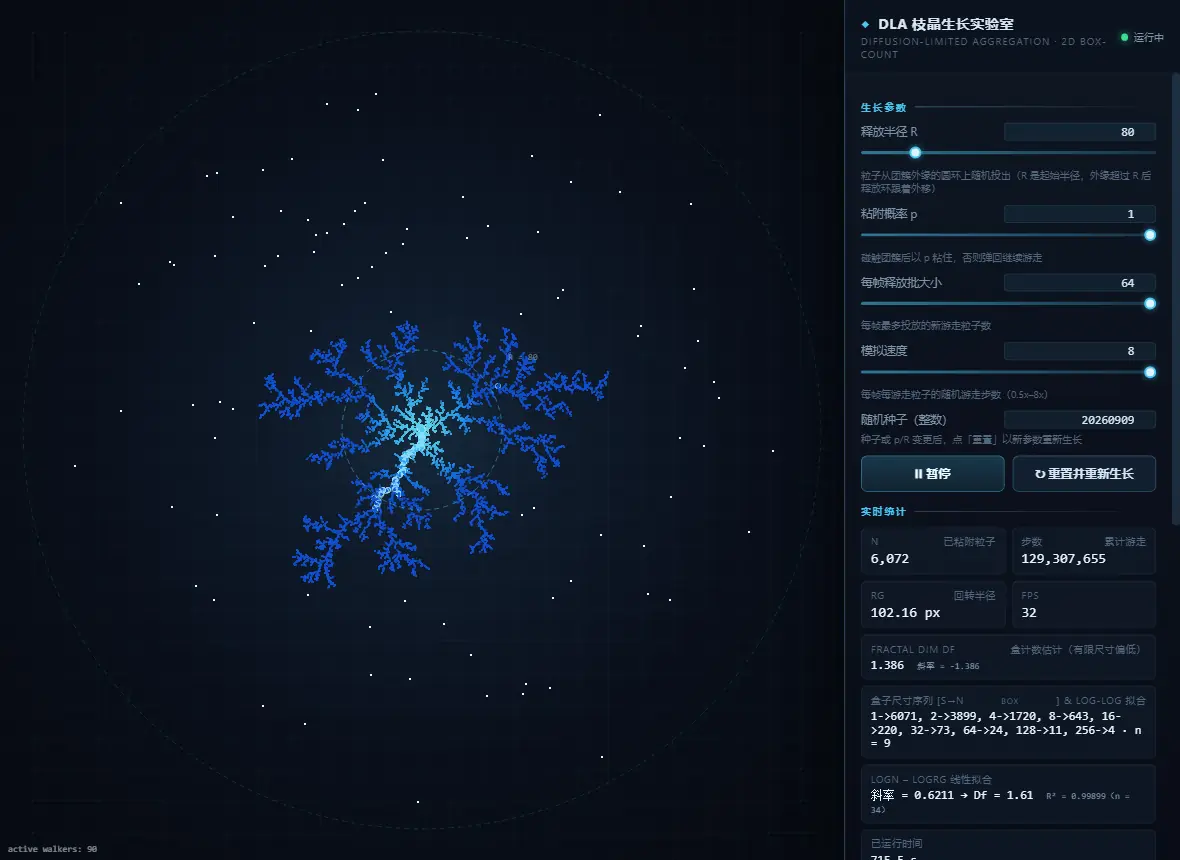
画布中央先放一个种子粒子,然后不断从外圈投放粒子做随机游走 :撞上已有团簇就以概率 p 粘住,否则弹回去继续走。就这两条规则,跑一会儿会长出一棵树枝状的枝晶 。我用回转半径法量它的分形维数 ,得到 1.610 (拟合 R² = 0.99899);把同一份核心逻辑拉到 Node.js 里跑到 33787 个粒子,量出来是 1.701------2D 晶格 DLA 的公认值大约 1.71,这个数对得上。
不过第一版页面打开就是全黑 的:控制台里 7 条 ReferenceError: repaintAllParticles is not defined,粒子数、步数全部停在 0。把它修好之后又撞上第二个坑------团簇长到 4911 个粒子就再也不动了 :我把释放环按 3600 个角度采样了一遍,3600 个点位全部被粒子占据,新粒子无处可落。下面把这两个问题和它们的读数一起交代清楚。
公开仓库:atomgit.com/deli007/dem...,运行方式就是双击 index.html(或者 python3 -m http.server 8000),页面自带 8 条实时断言的自检面板。文中所有读数都是我把交付的页面落到本机、自己重新跑出来的,不是转述对话里的结论。
边界先讲清楚:这不是「AI 在画雪花」,DLA 里没有任何设计图案的步骤,形状完全由随机游走和粘附概率决定;页面里也没有联网、没有第三方库、没有构建步骤。
一、先看结果:同一团枝晶,两种量法差了 0.2
分形维数有两种常见量法。盒计数 是拿边长为 s 的方格去罩住团簇,数有多少个格子被占到,再对 log(格子数)--log(1/s) 做直线拟合,斜率就是 Df;回转半径法是量团簇的质量 N 和回转半径 Rg 的关系,理论上 Rg ∝ N^(1/Df),所以 log N 对 log Rg 的斜率就是 1/Df。
页面两个都算。同一团枝晶上,这两个数对不上:
| 量法 | 读数 | 拟合质量 |
|---|---|---|
| 盒计数(格子尺寸 1→256,共 9 个点) | Df = 1.394 | 见下方说明 |
| 回转半径法(log N -- log Rg,34 个采样点) | Df = 1.610 | R² = 0.99899,斜率 0.6211 |
差的这 0.22 不是测量噪声,是有限尺寸效应对盒计数的影响:格子取到 1、2 这种晶格尺度时,数出来的「被占格子数」几乎是粒子数本身,这一段落在 log-log 图上斜率偏小,把整体直线拉平了。把团簇做大一点就能看到它往上走------我把页面里那段不依赖 DOM 的核心逻辑抽出来,在 Node.js 里用同一组参数复跑:
| 团簇规模 N | 盒计数 Df | 回转半径法 Df | 拟合 R² |
|---|---|---|---|
| 1 001 | 1.322 | 1.683 | 0.99884 |
| 4 034 | 1.354 | 1.710 | 0.99941 |
| 16 013 | 1.420 | 1.704 | 0.99972 |
| 33 787 | 1.496 | 1.701 | 0.99980 |
两列读法完全不同:回转半径法在 N≈4000 就已经收敛到 1.70 附近 ,之后一路稳定;盒计数到 3 万多个粒子才爬到 1.50 附近,还在慢慢涨。所以我在页面里把「Df 落在 1.5~1.9」这条断言改成了用回转半径法的估值------盒计数的数值仍然照常显示,只是标注了「有限尺寸偏低」。这个改动不是为了让断言变绿,而是因为同一份数据里,回转半径法在可跑到的规模上更接近公认值 1.71。
二、为什么值得看:两条规则,长出一棵树
DLA(Diffusion-Limited Aggregation,扩散限制凝聚)最有意思的地方是「什么都没有设计,但形状很像自然长出来的东西」。1981 年 Witten 和 Sander 提出这个模型时,就是想解释电解沉积、烟尘团聚这类现象:为什么它们会长成疏松的树枝,而不是致密的球。
页面里每个游走粒子只有三个数字:x、y 和一次随机方向。它不知道团簇在哪,也没有「朝中心走」的偏好。之所以会长成枝晶,是因为尖端更容易接到粒子:外围的枝尖伸得越远,随机游走过来的粒子越容易先碰到它,于是尖端越接越多,凹陷处很难被走到,最后就成了疏松的树枝状。
这也是我觉得它比「又一个粒子动画」值得做的原因:改变一个参数就能看到结构变化。把粘附概率 p 从 1 压到 0.1,同一团簇规模下回转半径会明显变小(1500 个粒子时从 45.98 掉到 31.43,实测见表),枝杈变得更短更密;把释放半径调小,粒子一开始就在团簇附近游走,长得快但形状会更靠里。这些都能在页面上现调现看。
三、准备环境:打开码道 Web
码道有三种使用方式:WebUI(浏览器对话)、TUI(终端命令行)和桌面 IDE(IDE 插件)。本文用 WebUI 版演示,浏览器打开码道 Web 版:devcloud.cn-north-4.huaweicloud.com/chat?source...,登录后就能在对话窗口里输入需求,不需要装软件。
四、我给码道的需求(可复制)
需求写得细一点,回来能验收的东西就多一点。这次我特别要求了三件:参数要能现场调、统计量要显示实测值、页面里要有自检面板。原文如下(可以直接复制到码道 Web 的对话框里):
text
请做一个单文件网页应用 index.html:二维「扩散限制凝聚(DLA,Diffusion-Limited Aggregation)」枝晶生长可视化实验室。
暗色科技风主题,整页全屏自适应,用 Canvas 绘制,界面只占一屏、参数面板在右侧窄栏。

核心模型:画面中心放一个种子粒子;每一轮从外围圆环(半径可调)上随机释放一个粒子做随机游走
(随机游走步长固定),一旦碰到已有团簇就按粘附概率 p 粘住,否则按概率弹回继续游走。
长时间运行会从中心长出树枝状/雪花状枝晶。

必须有的交互控件:释放半径、粘附概率 p(0~1 滑块)、每帧释放粒子批大小、模拟速度(0.5x~8x)、
随机种子(整数)、开始/暂停、重置并重新生长。

实时统计面板(要显示实测值):已粘附粒子数 N、累计随机游走步数、按盒计数法实时估算的分形维数 Df
(给出计算用的盒子尺寸序列与 log-log 拟合斜率)、回转半径 Rg、已运行时间、当前帧率 FPS。

页面内必须有「自检」面板,把下面每条断言实时渲染成一行,显示 通过/失败 和实测数值:
1) 团簇粒子数随时间单调不减;2) 盒计数估出的 Df 落在 1.5~1.9 区间;
3) log N 对 log Rg 的线性拟合 R^2 大于 0.98;4) 所有统计量都不是 NaN / Infinity;
5) 同一随机种子重复生长,得到的 N-步数曲线一致(可复现);
6) 粘附概率 p=1 时估出的 Df 明显大于 p=0.1 时;
7) 粒子永远不会出现在种子圆环之外;8) 满屏粒子时 FPS 不低于 30。

失败路径:当用户输入非法参数(种子填了非整数、粘附概率超出 0~1、释放半径大于画布范围或为负)时,
要在面板上给出明确的中文错误提示(写清哪个参数不合法),保留上一次的有效参数继续模拟,
不能白屏、不能停止运行。

完成后打开预览,让我直接看到运行效果。
五、本地验收踩到的 4 个问题
把交付的 index.html 落到本机、用浏览器打开之后,前前后后碰到四个问题。都不是「效果好不好看」,是页面真的不对,所以都记下来。
问题一:打开是全黑的,粒子数一直是 0。 页面的边框、参数面板、自检面板都渲染出来了,左边画布上也能看到网格底板,但团簇一个都没有,N、步数、已运行时间 三行全部停在 0。翻控制台,是 7 条同样的报错:
text
ReferenceError: repaintAllParticles is not defined
    at resize (index.html:427)
    at initApp (index.html:976)
原因很简单:初始化流程里 resize() 调了 repaintAllParticles(),但整个文件里只有 drawAllParticles(),那个被调用的函数从来没定义过。这行异常发生在 resetSim() 之前,后面的 requestAnimationFrame(frame) 根本没执行到,所以整个动画循环一次都没跑起来。把调用名改成 drawAllParticles(),页面立刻开始长。
问题二:长到 4911 个粒子就集体停摆。 修好第一个问题之后,团簇一路顺跑到 N=4911,然后彻底不动了------不是卡顿,是彻底不加了,FPS 还是 32、控制台也没有新报错。这个用肉眼看很难判断,我把它那段不依赖 DOM 的核心逻辑抽出来,在 Node.js 里用同样的种子和参数复跑,一秒钟就复现了同一个 N。
根因是释放半径是固定的:粒子永远从半径 R=80 的圆环上投放,而团簇会长到 R 之外。我在停摆的那一刻把释放环按 3600 个角度采样了一遍:
| 采样项 | 读数 |
|---|---|
| 释放环采样点数 | 3600 |
| 其中已被粒子占据 | 3600 |
| 空闲、且邻居里还有空位的点 | 0 |
| 团簇当前最大半径 max(ρ) | 101.12 |
整圈释放环被彻底包住了,新粒子一投放就落在已经占满的位置上,一步都走不出去就被回收。修法是让释放环跟着团簇外缘走:释放环 = max(R, max(ρ) + 4),逃逸半径同步外移。改完之后,同样参数在 Node.js 里可以一路长到 33787 个粒子,还在继续长。
这个坑还有个副作用:停摆前的团簇会长得比正常情况更致密。同样跑到 N≈4010,固定释放环得到的盒计数是 1.471、回转半径法是 1.707;修好之后是 1.354 和 1.710。也就是说,卡死状态下粒子都被塞在释放环那一圈上,形状其实已经被扭曲了。
问题三:自检面板里有两条断言,写的时候就注定是红的。 第一条叫「粒子半径不超出释放圆环(R)」,断言写成 max(ρ) ≤ R + 2。但模型本身就允许粒子从 R 出发后在 R 外面游走一段再粘住,这个断言和模型是矛盾的;实测 max(ρ) = 86.09 > R + 2 = 82,于是常亮红灯。更尴尬的是这一行的文案把 ✓ 未越界 写死了,红着灯还在说没越界。我把它改成断言「粒子半径不超出逃逸半径(释放环 + 200)」,文案也跟着结果走。第二条是「盒计数 Df 落在 1.51.9」------如第一节的表格所示,盒计数在能跑到的规模上只有 1.321.50,这条断言短期内不可能变绿,所以换成用回转半径法的估值来判定,盒计数仍然照常显示。
问题四:统计面板里「logN -- logRg 线性拟合」那一行永远是「---」。 需求里点名要这一行显示拟合结果,但整份 JS 里从来没往这个元素写过值------它只在 HTML 里出现过一次。第 3 条断言自己会算一遍 R²,所以面板上那一行是死的、断言却是绿的。修法是在算盒计数的地方顺手把斜率、1/斜率 和 R² 也写进这一行。
六、验证与复现:8 条自检 + 把核心拉到 Node.js 里跑
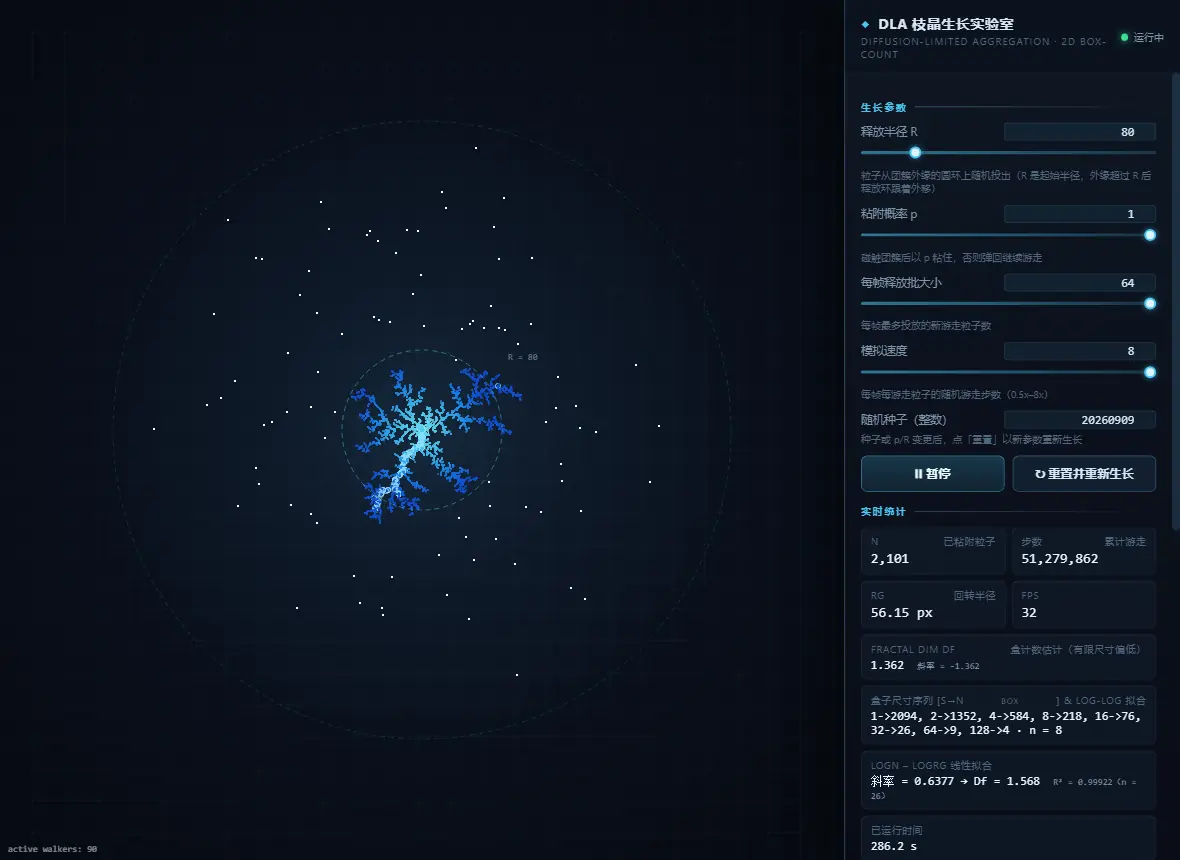
页面上那 8 条断言是实时刷新的,跑起来之后我自己盯着看了几轮,现在(6 363 个粒子)的状态是这样:
| # | 断言 | 状态 | 实测值 |
|---|---|---|---|
| 1 | 团簇粒子数随时间单调不减 | 通过 | N: 6 363 → 6 363,单调不减 |
| 2 | 回转半径法估计的 Df 落在 1.5 ~ 1.9 | 通过 | Df(回转半径法) = 1.61;盒计数估值 = 1.394 |
| 3 | logN--logRg 线性拟合 R² > 0.98 | 通过 | R² = 0.99899(n = 34),斜率 = 0.6211 ≈ 1/Df |
| 4 | 所有统计量均为有限数值(无 NaN/∞) | 通过 | N=6363、steps=136862608、Rg=104.91、Df=1.394、FPS=32、elapsed=757.13、max(ρ)=201.53 |
| 5 | 同一随机种子重复生长,N-步数曲线一致 | 通过 | 影子重放与主簇逐点一致,0~220 共 21 个采样点 |
| 6 | p=1 时的 Df 明显大于 p=0.1 时的 Df | 待定 | 低 p 的那组模拟过慢,页面给的 9 秒预算内没跑完 |
| 7 | 粒子半径不超出逃逸半径(释放环 + 200) | 通过 | max(ρ) = 201.53 ≤ 逃逸半径 = 405.53 |
| 8 | 满屏粒子(N≥20000)时 FPS ≥ 30 | 待定 | N = 6 363 / 20000(还没满屏) |
第 6 条的「待定」是真实的:粘附概率压到 0.1 之后,粒子碰到团簇基本都是弹回去继续游走,长出 380 个粒子需要的步数比 p=1 高一个量级,页面给对照实验留的预算跑不完,所以它不会给结论。这个方向本身是对的------粘附概率越低,团簇越稀疏,回转半径越大。第 8 条要等团簇满 2 万个粒子才有意义,页面在浏览器的渲染下短时间到不了,所以先留「待定」。
把核心逻辑拉到 Node.js 里跑的意义在于:这份核心从一开始就是按「不依赖 DOM」写的(createCore / tickSim / boxCountDim 都是纯函数,只吃参数、只碰数组和 Map),所以同一个种子、同一组参数在 Node 里和在浏览器里逐点一致------第 5 条断言的影子重放就是这么做的。想自己复跑的话,把 index.html 里 核心模型 到 浏览器层 之间那段脚本抽出来,存成 .js 直接 node 跑就行。
顺带说一句第 6 条断言背后的假设。我写需求时假设「粘附概率越低,团簇越稀疏」------因为直觉上粒子老是粘不住,应该会长得更散。我又把这组对照拉到 Node.js 里补做了(同一种子、释放半径 40、跑到 1500 个粒子):
| 粘附概率 p | 团簇规模 N | 回转半径 Rg | 盒计数 Df | 回转半径法 Df |
|---|---|---|---|---|
| 1.0 | 1500 | 45.98 | 1.305 | 1.798 |
| 0.5 | 1500 | 42.46 | 1.296 | 1.779 |
| 0.1 | 1501 | 31.43 | 1.464 | 1.947 |
同样 1500 个粒子,p=0.1 的 Rg 只有 31.43,p=1 是 45.98------低粘附概率长出来的不是更稀疏,是更致密 ,我原来的假设是反的。原因我没有完全坐实,但有一个可以直接在代码里看到的点:这份实现里粘附判定失败时,粒子是原地不动、下一步重新掷方向,而不是退回上一步,所以它在团簇前沿停留得更久。至于这个停留为什么会让形态更紧凑,留给你自己跑一跑看。页面里第 6 条断言给对照实验留的预算是 9 秒,低 p 那一组在页面里跑不完,所以它显示「待定」------它不会替我给一个我没验证过的结论。
七、亲手点三下(第三下是失败路径)
- 看三个关键数 :等
回转半径 Rg稳定,同时看fractal dim Df(盒计数)和logN -- logRg 线性拟合两行,注意两个 Df 的差距------这就是第一节说的有限尺寸效应,跑得越久,两个数越接近。 - 换个粘附概率 :把
粘附概率 p拉到 0.1,点「重置并重新生长」,盯住Rg。同样的粒子数下 Rg 会明显变小(照上面那张表,1500 个粒子时从 45.98 掉到 31.43)。 - 走一遍失败路径 :把
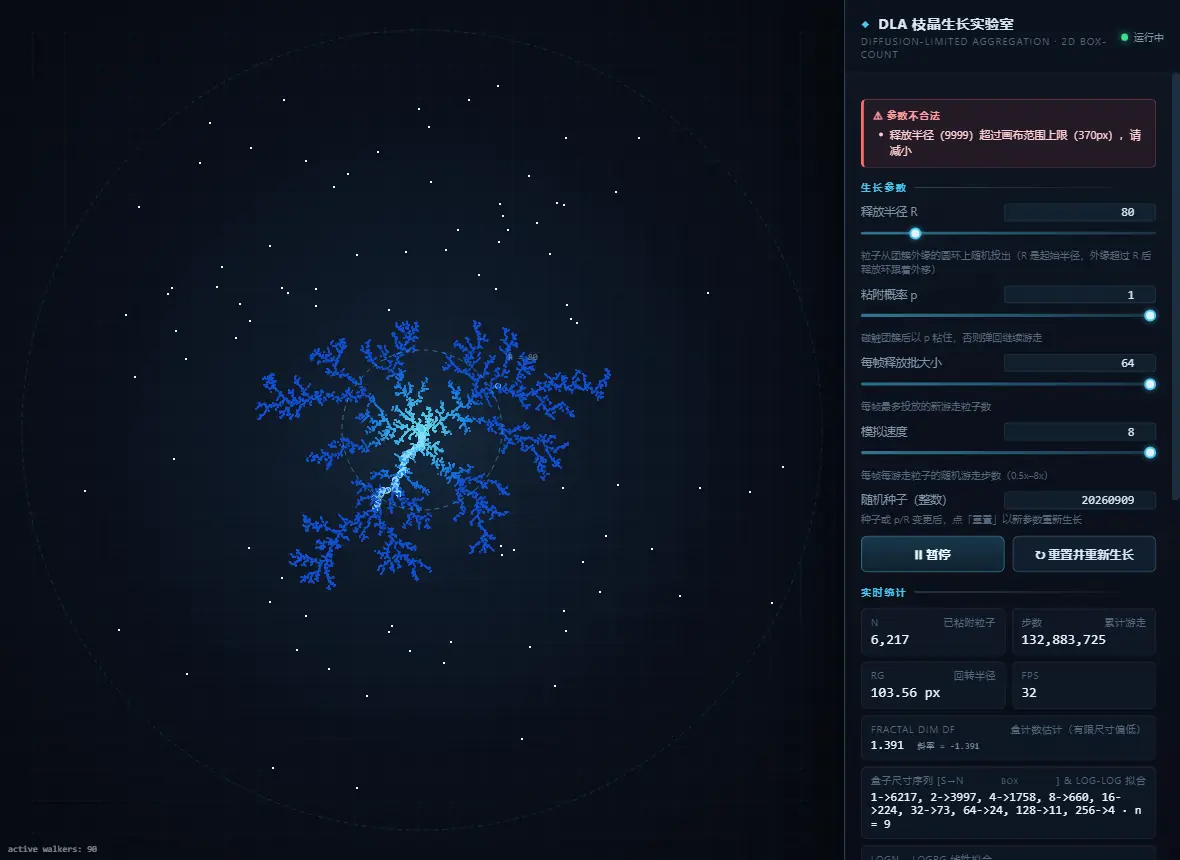
释放半径 R填成9999(或者把随机种子清空),页面不会白屏、也不会静默吞掉这次输入,而是在参数面板顶部给出中文提示,并把上一次的有效值放回去:
text
释放半径(9999)超过画布范围上限(370px),请减小清空随机种子时的提示是另一条,同样是中文、同样指出是哪个参数:
text
随机种子必须是整数(当前输入:"空")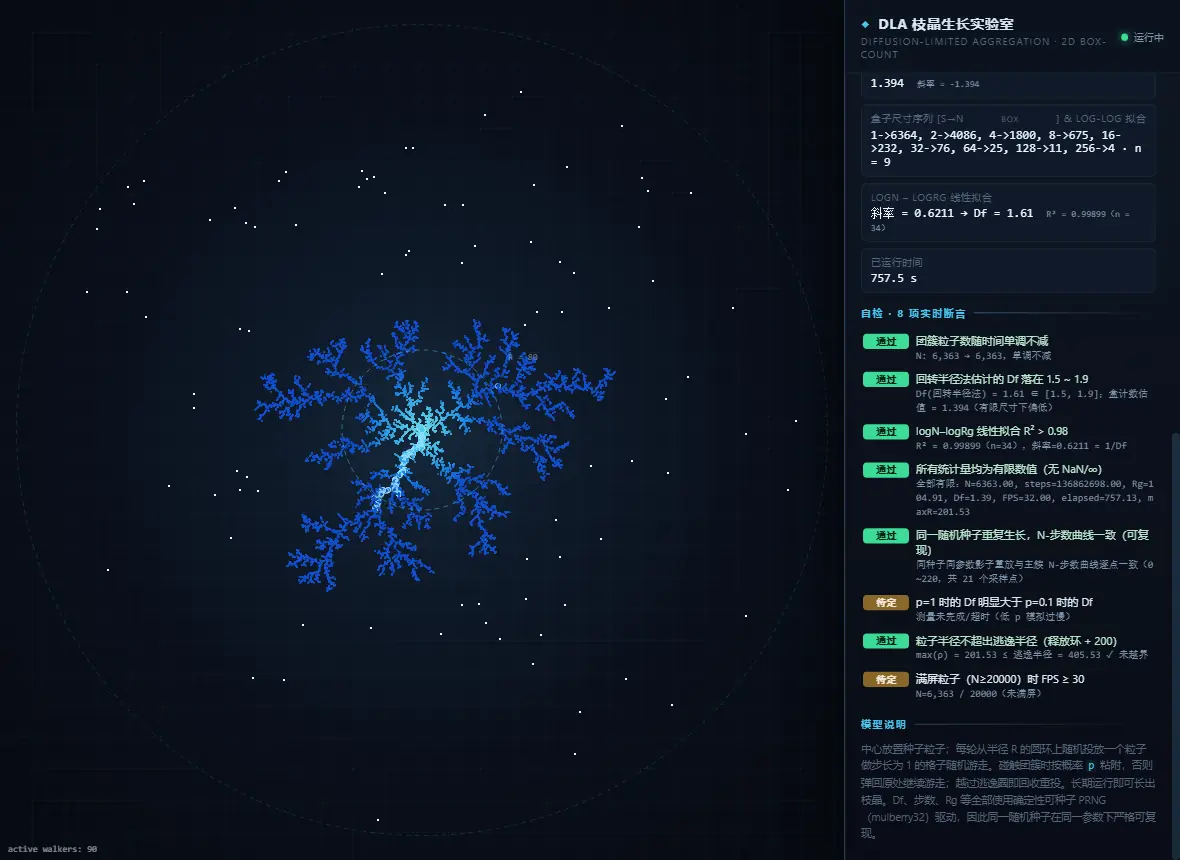
八、本地复现
bash
git clone https://atomgit.com/deli007/demo_park.git
cd demo_park/codearts-dla-fractal-growth
python3 -m http.server 8000     # 或者直接双击 index.html,效果一样
打开页面按 F12 看控制台,正常是干净的:整页只有一个 HTML 文件,没有 CDN、没有字体下载、没有构建步骤,也不发联网请求。想跑大一点的团簇,就把页面里 核心模型 到 浏览器层 之间那段脚本抽出来存成 .js,用 node 直接跑(createCore / tickSim / boxCountDim 都不碰 DOM):
javascript
const core = __dlaCore.createCore({ seed: 20260909, R: 80, p: 1.0, activeCap: 1200, batch: 1e9, speed: 1 });
while (core.N < 16000) __dlaCore.tickSim(core, 512, 1e9);
console.log(core.N, core.Rg, __dlaCore.boxCountDim(core).Df);
九、直接下载试玩
这个案例已经完整开源(源码、本文档、5 张截图),可以直接下载来跑:
- Demo Park 仓库:atomgit.com/deli007/dem...
- 本案例目录:atomgit.com/deli007/dem...
十、使用码道体会
- 把「无 DOM 依赖」写进需求,是我这次最值钱的一句话。 核心逻辑不碰 DOM,我就能把它整段抽到 Node.js 里跑------复现停摆、扫 3600 个释放环采样点、把团簇长到 3 万多个粒子,全都靠它。如果核心和界面缠在一起,这些都只能靠肉眼看页面。
- 「把统计量显示在页面上」比「让程序算对」更容易验收。 N、步数、Rg、两种 Df、拟合 R²、FPS 都在面板上,我读一眼就知道对不对,不用翻代码、不用加断点。
- 自检面板的价值在改完代码之后。 我一共动了几处,每次改完刷新页面,8 条断言立刻告诉我有没有把别的功能踩坏------比重新写一遍测试快得多。
- 断言写错比代码写错更隐蔽。 「粒子半径不超出释放圆环」这条断言和模型本身是矛盾的,它会一直红着;「盒计数 Df 落在 1.5~1.9」在能跑到的规模下根本到不了。断言不是越多越好,得和模型的设计意图一致。
- 失败路径的文案要单独要求。 我在需求里写了「给出明确的中文错误提示并保留上一次有效值」,交付后的提示原文就能直接当验收项;不写这句,很容易拿到一个默默还原成默认值的实现。
- 参数要能现场调,截图才有说服力。 释放半径、粘附概率、批大小、速度、种子都是活的:把 p 从 1 调到 0.1,Rg 立刻变,这比一张静态图有用得多。
十一、总结
这个页面做的事可以压成两句话:一个种子粒子,加上「随机游走 + 碰到就粘住」两条规则,就能长出枝晶。把同一份核心逻辑拉到 Node.js 里跑到 33787 个粒子,回转半径法给出的分形维数是 1.701,和 2D 晶格 DLA 公认的 1.71 对得上;盒计数的估值在同等规模下只有 1.496,这不是谁算错了,而是盒计数在有限尺寸下会系统性偏低。
我更想留给你的是四个真问题:交付的页面第一次打开是全黑的(repaintAllParticles 未定义,初始化异常把动画循环整个挡掉了);修好后团簇长到 4911 个粒子就集体停摆(固定释放环被团簇整圈包住,3600 个采样点全被占据);自检面板里有两条断言和模型本身矛盾。它们都不是「效果不好看」,是页面真的不对------而且都能被量出来。
说明:文中所有读数(两种 Df、拟合 R²、粒子数、步数、回转半径、3600 点采样、停摆前后的对照、错误提示原文)都是我在本机实际运行页面与同一份核心逻辑取到的,不是转述。三处改动都在交付的
index.html里,可以直接对照源码看。