我把一张程序合成的模拟拍照停水通知交给 OCR 识别后界面上显示的是 11 行 · 185 字。专业档算出来的字符错误率是 4.6%。可我逐字对答案也没找到一个错字。出错的是其中一行字的位置。原文第二段最后那行只有「时跑水」三个字加一个句号,到了识别结果里却跑到了上一行的最前头。另一张加了阴影的合成件错误率是 15.5%,毛病一模一样。我一开始以为是算错误率的脚本写错了。复算了两遍数也没变。字明明全认对了错误率却下不来,我想弄清楚它到底卡在哪一步。
这轮我测的原本是识别前到底该不该做预处理。截图样本是我自己写了个网页截下来的,网页内容是自编的「社区服务时间调整说明」,我从里面裁了 8 块。另外两块红底文字是从网上找的一张放假通知模板里裁出来的。拍照这边手上只有上面那两张合成件。我先写好一张 A4 停水通知再用程序给它加上约 2.5° 的透视倾斜和左亮右暗的光照,最后补了一层模糊和噪声。b 张还在正文右侧多压了一块阴影。识别我用的是图映(imging.cn/)的图片文字识别,以默... OCR 档为主,极速 OCR 和极致 OCR 两档也都跑了一遍,机器是一台 Apple M4 上的 Chromium 149 开源构建。图映的端侧编解码和模型加载是我在做。OCR 这条识别流水线不是我做的,下文讲到它内部怎么分行的地方都是我从输入输出往回推出来的。
OCR按坐标把字拼成行
人看一张通知是顺着字往下读的,根本不会去想一行字到哪儿算结束。OCR 拿到手的只是一张像素图。它得先找出哪些地方有字并给每块字画上一个框,接着认出框里的字后再把这些框按坐标排成行和段。前两步出了错才叫认错字。最后一步出错的时候字一个也不错,乱掉的只是先后顺序。字符错误率是按编辑距离算的。挪动一整行在编辑距离里等于先删一遍再补一遍,代价和认错一整行差不多。我给每次识别另外算了一个不计顺序的错误率,它只比两边各有哪些字和各有几个。合成件的原图、放大、灰度、两种去噪、两档 JPEG 重压缩和局部自适应二值化这几个版本在两张上算出来全是 0.0%。也就是说 4.6% 到 15.5% 的错误率全都出在排行这一步。
倾斜整行的外框比行距还高
排行靠的是框的坐标,于是我量了这几个框。合成件是我自己生成的,透视用的四个角我手上都有。我在干净的 A4 原稿上找出每一行墨迹的上下沿和左右端,再按合成时同一个透视矩阵映射过去就能算出每一行在合成图上落在哪里。
python
import numpy as np, cv2

# 合成时用的透视四角,A4 原稿 1588×2246,画布 2000 宽最后缩到 1500
corners_a4 = np.float32([[0, 0], [1588, 0], [1588, 2246], [0, 2246]])
corners_photo = np.float32([[230, 180], [1790, 250], [1830, 2420], [170, 2380]])
tilt = cv2.getPerspectiveTransform(corners_a4, corners_photo)

def box_on_photo(top, bottom, left, right):
    pts = np.float32([[[left, top], [right, top], [right, bottom], [left, bottom]]])
    ys = cv2.perspectiveTransform(pts, tilt)[0][:, 1] * 0.75
    return ys.min(), ys.max()

long_line = box_on_photo(549, 589, 162, 1424)   # 「暂停供水......避免来水」
tail_line = box_on_photo(629, 669, 164, 301)    # 「时跑水。」
print('整行外框高', round(long_line[1] - long_line[0], 1))   # 65.9
print('两框竖向重叠', round(long_line[1] - tail_line[0], 1))  # 8.9
传进去的四个数是这一行在干净原稿上的上沿、下沿、左端和右端,函数返回的是它在合成图上的竖直范围。「暂停供水......避免来水」这一整行从左走到右往下沉了 37.6 px。行距只有 57.1 px,这一行就沉掉了大半个行距。它的水平外框也跟着被拉到了 65.9 px,比行距还高出一截。下一行那个「时跑水」只有 104.4 px 宽并且紧贴在左边。两个框在竖直方向上重叠了 8.9 px,两框中心之间只差 40.3 px。假如分行看的是框在竖直方向挨得有多近的话这个短尾行就正好落进了会被并到上一行的范围里。
同一张通知上还有两处这样的短尾行,我把三处摆在一起数了一遍。「时跑水」在 56 次结果里被排反了 56 次。「水约3分钟即可正常使用」那处两框中心差 43.3 px,在 57 次里排反了 38 次。「便,敬请谅解」那处差 44.1 px,在 55 次里只排反了 8 次。计数只算界面显示 11 行并且字没丢的那些结果。三处排反的次数和中心距离的远近恰好是同一个顺序。可惜一共只有三个点,三个尾行的宽度又各不相同。到底是距离起作用还是宽度起作用我分不开。图映内部按什么规则分行我也没去看过。我能确定的只是约 2.5° 的倾斜已经把这三个框推到了边上。推没推过去换一个预处理版本就可能不一样。
像素处理改不了行序
想通这一层再回头看前面那一整组预处理的数就好懂了。二值化、去噪和放大改的都是像素的明暗,框画在哪里和行怎么排它们一样也没碰。合成件上的放大、灰度、两种去噪、JPEG 重压缩和局部自适应二值化这几版不计顺序的错误率都是 0.0%。错误率要么停在原来的数上要么因为多排反了一行变得更高。真正把字弄丢的是全局二值化,碰上阴影的时候最明显。b 张用 Otsu 自动阈值以后阴影区整块变黑,专业档的错误率是 31.0%。这一回不计顺序的错误率也是 31.0%,字是真的丢了。局部自适应那一版倒是一个字都没吞。
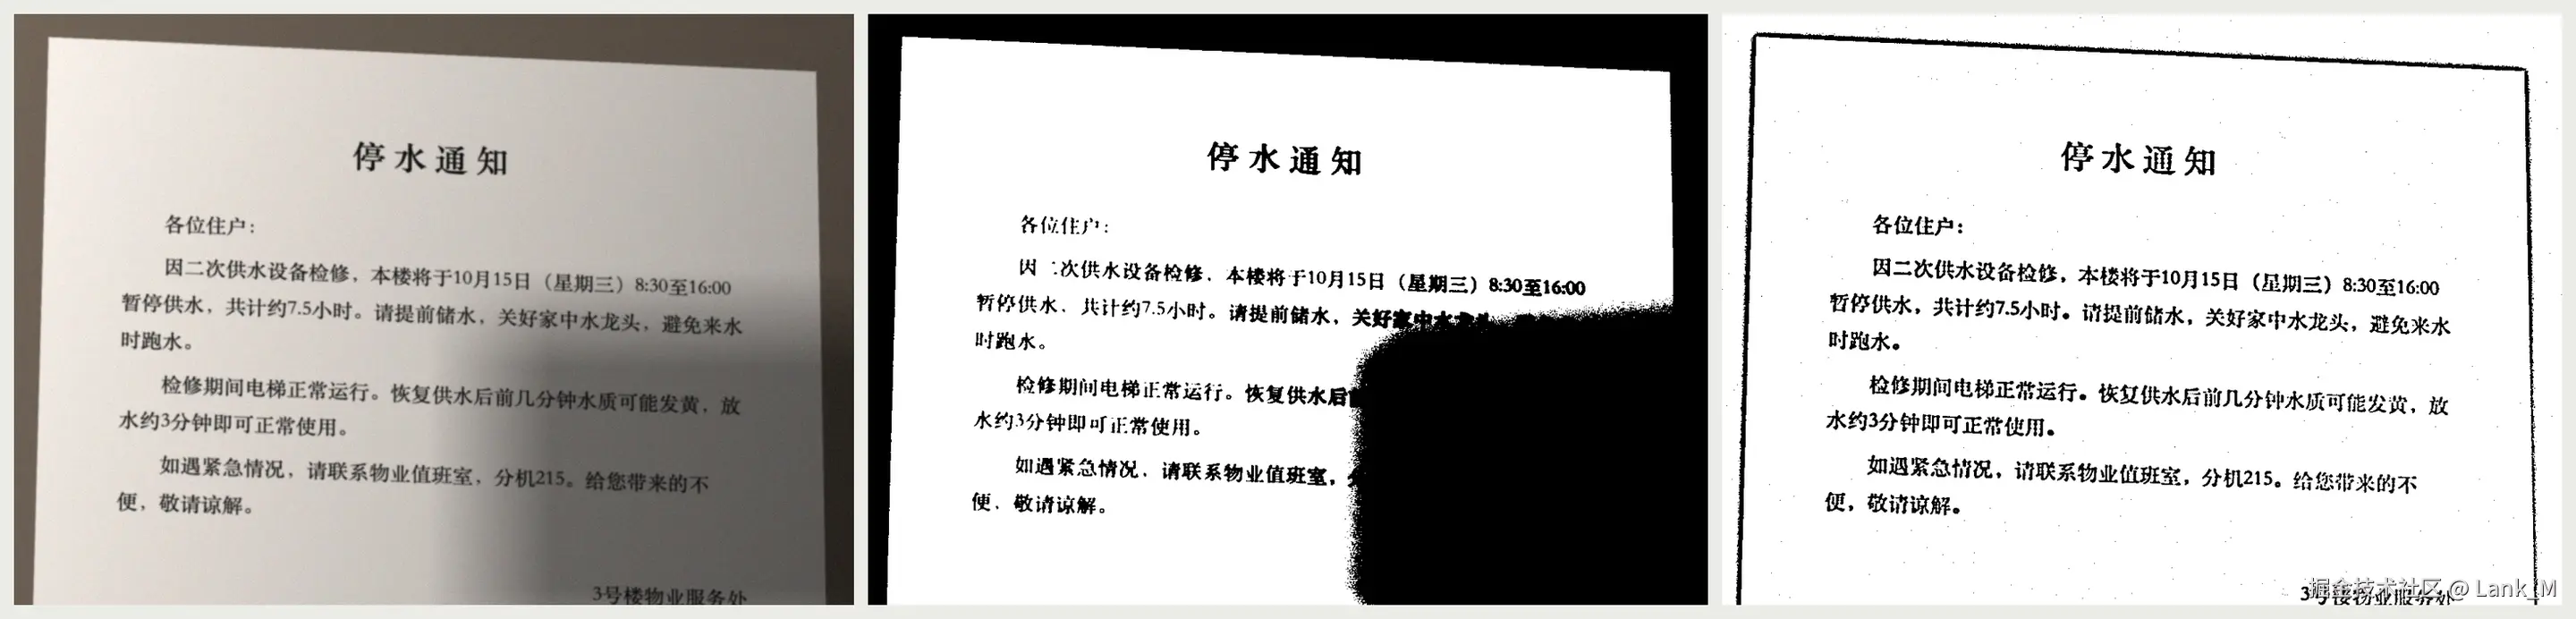
这张图的三栏都是程序合成的模拟拍照,并不是真实照片。先看中间那栏的右下角。Otsu 按整张图只取一个阈值,阴影里的字就和阴影本身一起被判成了黑。右边那栏按 31×31 的邻域各自算阈值后阴影里的字都还留着。左边原图上的字行是左高右低的走向,上一节量的就是这 2.5°。
截图那边的情况更简单。横排截图上既没有倾斜也没有光照不均,像素处理在截图上找不到可修的东西。能做的只剩加错。
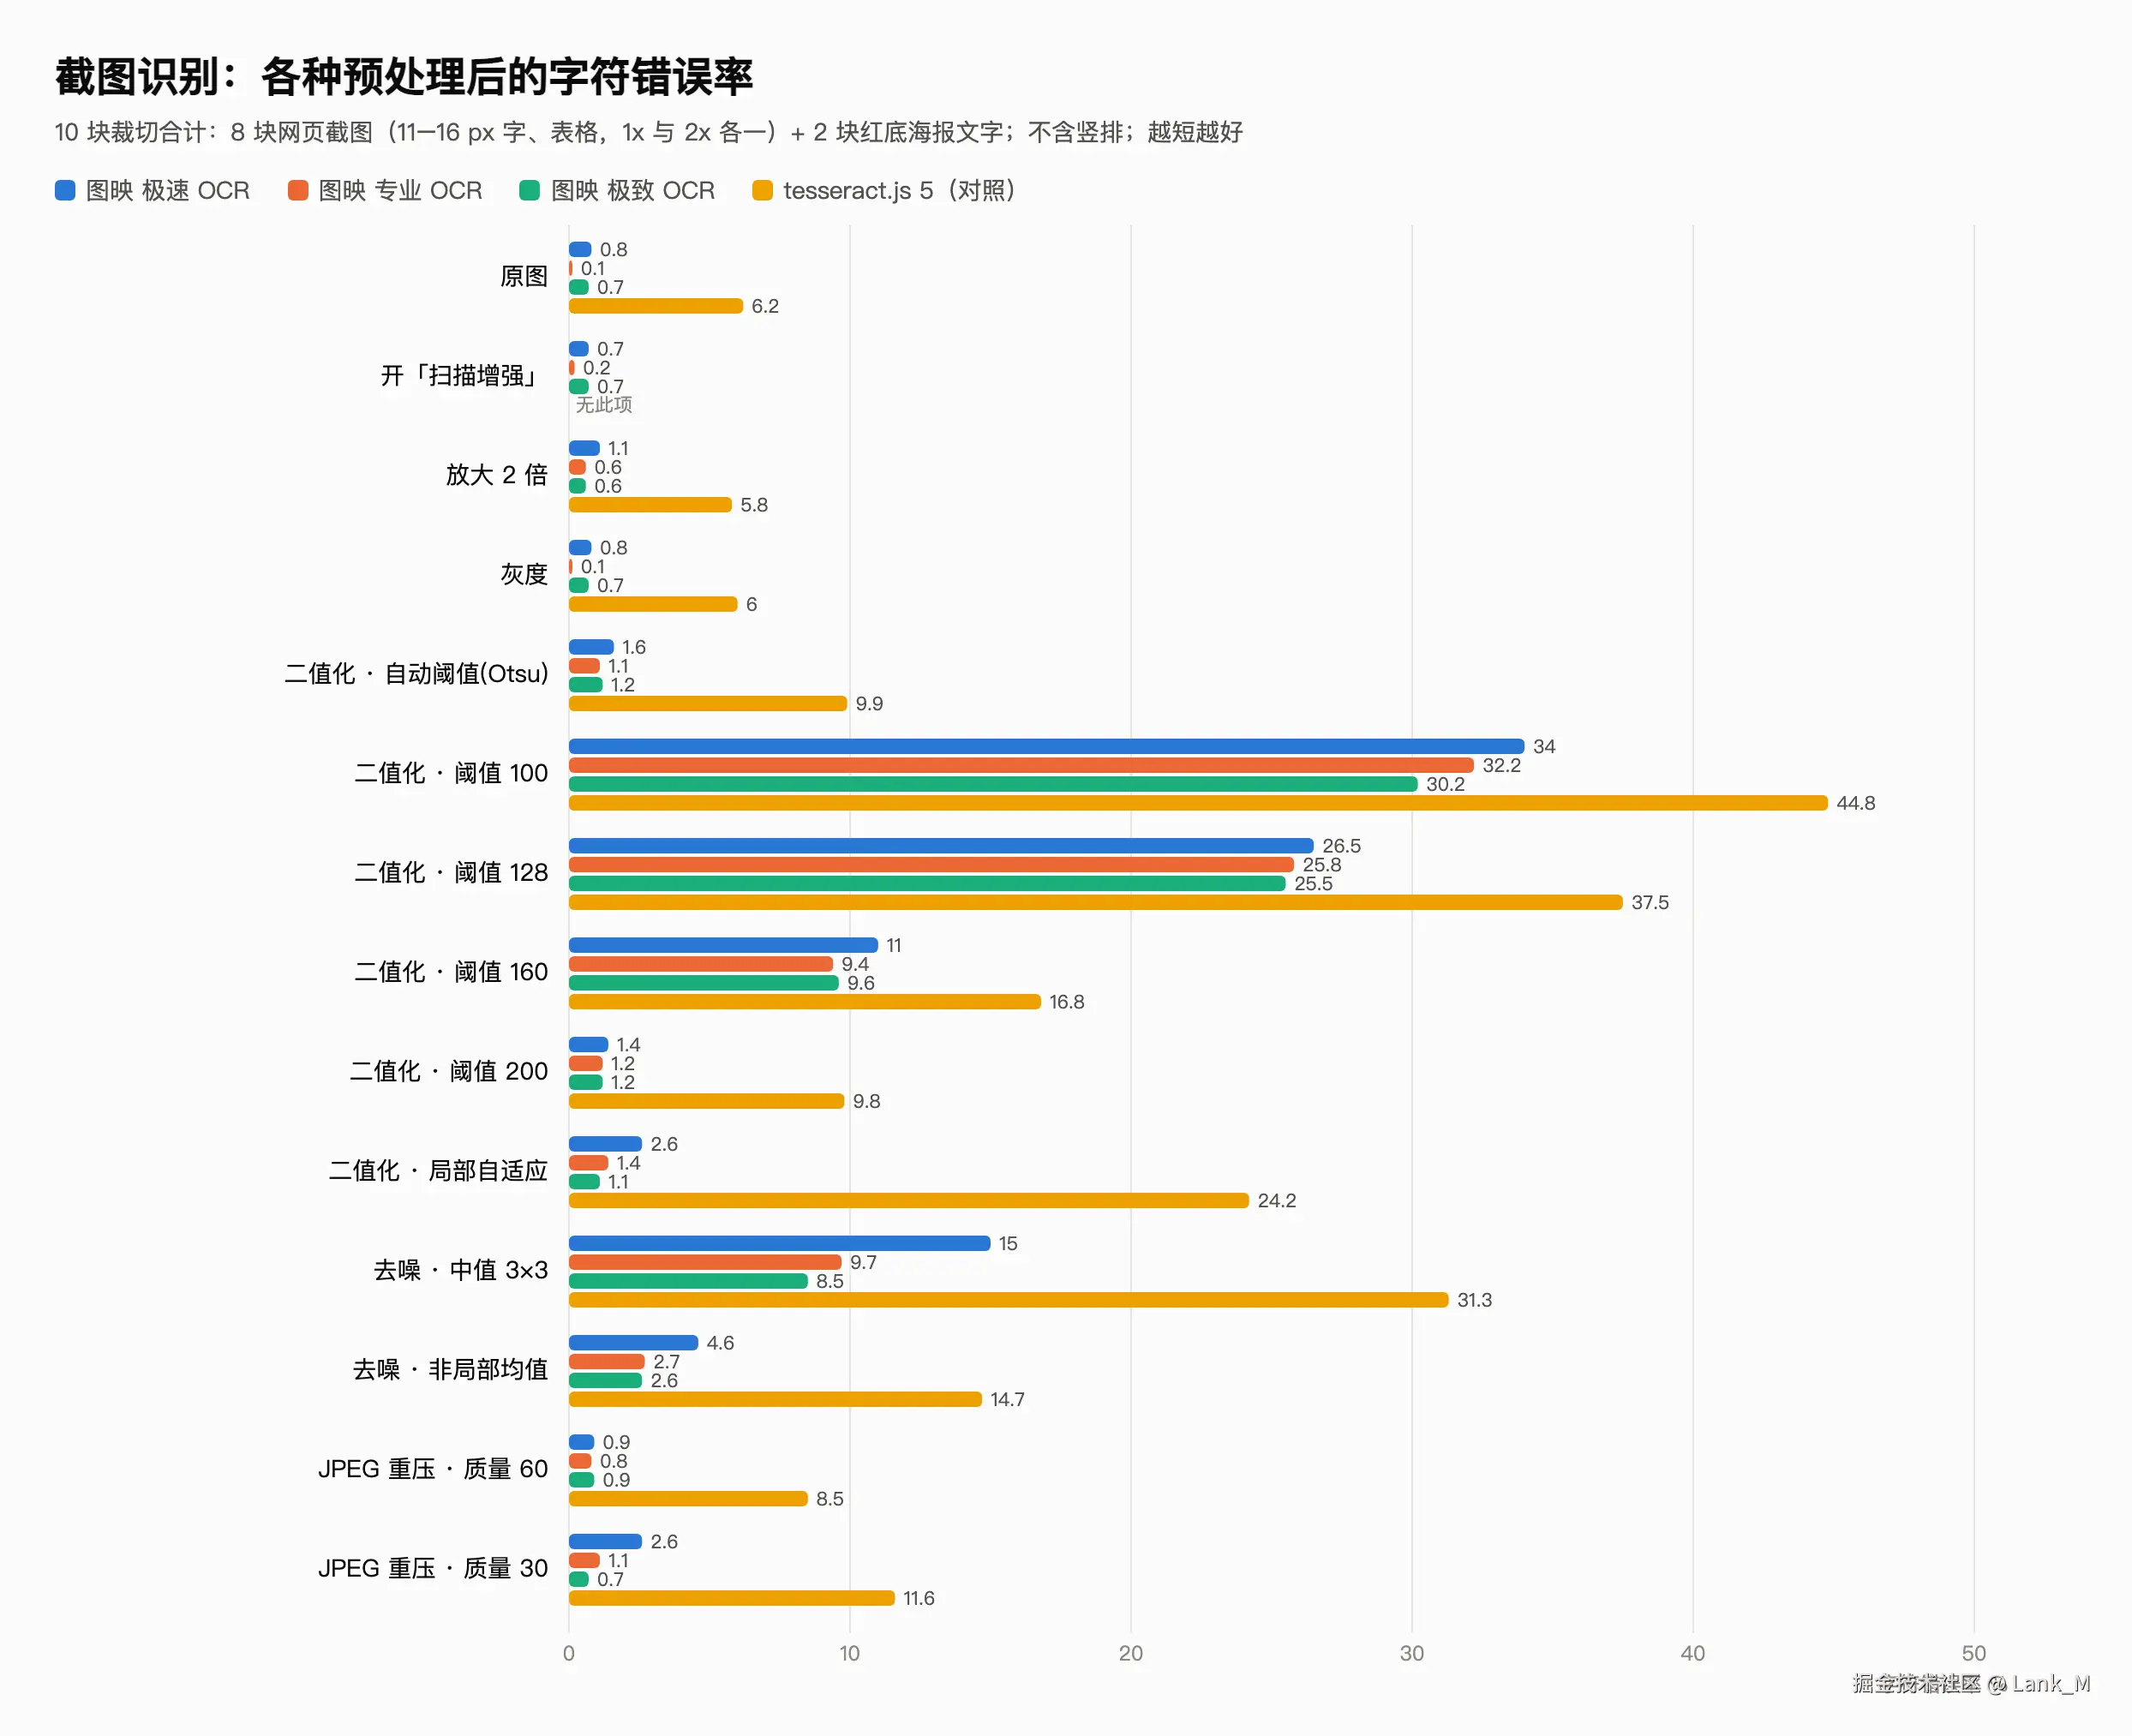
这张图主要看两头。最上面原图那一组里图映三档分别是 0.8%、0.1% 和 0.7%,几根条都贴着 0。往下看二值化阈值 100、阈值 128 和中值 3×3 那几组拉出了长条,专业档在阈值 128 下是 25.8%。三档之间相差不到 1 个百分点,选错一种预处理却会多出 25 个百分点的错。图里的 tesseract.js 5(默认参数,chi_sim+eng)是我放进来的对照组。它的数字只用来看另一个引擎在同样处理下往哪边走。
拉正以后三档都是0错
毛病既然出在几何上那就从几何上修。我按已知的四个角把两张合成件拉正,这相当于手动框出纸张四角再裁正。拉正后的 a、b 两张交给三档识别,三档都是0错,错误率 0.0%。例外只有极速档 b 张的自适应二值化版本,它是 0.6%。行序的问题在拉正以后就再没出现过。
拉正以后我又顺手做了一遍 Otsu 想看看两样叠在一起会不会更好。结果错误率反倒涨到了 35.6% 到 39.1%。左亮右暗的光照还原样留在图上,拉正只动了几何没动明暗,全局阈值就把右半页整块压成了黑。这一步让我改了想法。我原先以为先修几何再做像素处理就可以放心叠加。实际情况是几何修完以后像素那一步能不做就不做。竖排截图也属于同一类问题。那块 4 列竖排原样识别的错误率是 92.3%,可字几乎全认对了,只是列的先后反了过来。在图映界面里点一下「↶ 左转 90°」再识别以后专业档的 2x 截图就是 0 错。管用的同样是几何上的修法。
现在拿到一张要识别的图我会先分清它属于哪一类。截图就直接识别。拍照件先把方向和倾斜弄正,光照不均的时候也不去碰全局阈值。图映的界面里本来就有「↶ 左转 90°」和「↷ 右转 90°」两个按钮。旁边还有一个默认关闭的「扫描增强」开关,它的说明原话是「仅轻度灰度、对比度与锐化,不强制二值化」。我在两张合成件上都开过它,错误率和原图一样还是 4.6% 和 15.5%。它没让结果变好也没把字洗掉。识别是在本机 Worker 里跑的,这一轮全程没有发出过一次非 GET 请求。首次使用要先下载模型。首次下载模型并不等于把图片交给了服务器。
真实照片还没测
这篇里所有拍照件的数字都来自那两张程序合成的倾斜和阴影样本,真实的手机照片我还没测。真实照片的倾斜往往不止一个角度并且纸面还会弯。透视也不会这么规整。按四角拉正这一步放到真实照片上得先让程序自己找出四个角。找角这一步会带进多少误差我还没量过。分行那三个点只能说明倾斜会把框推到边上,分行规则是我猜的。每种组合我也只跑了一次。一两个百分点的差别不用当真。想自己验证的话可以拿一张拍斜了的文档识别一次,再把识别文本和原文都打散成一袋字比一比。字符错误率很高、打散以后的错误率却很低的时候就先去修几何。