摘要
Word 里裁过的图转成网页以后经常变样。有的变回整张。有的裁对了却往上挪去盖住上面一行字。还有的转完连图都没了。这篇不从转换器讲起。我先把 docx 拆开,顺着一张图在 XML 里的路径走一遍。图片字节要靠 a:blip 上的关系号去找。图框大小记在 wp:extent 里,裁剪是 a:srcRect 上的四个数。旋转写在 a:xfrm 的 rot 上,旋转后多占的地方又单独记在 wp:effectExtent 里。word/media/ 里放的始终是整张原图。我手写了一份 7 个图片用例的 docx 拿去过了五种转法,再对着这几层逐个核对每种转法读了哪层、漏了哪层。读漏的后果分两种。一种是看得见的显示走样,只裁了下边的截图会往上偏 70.4 px。另一种看不出来。导出的 HTML 里内联的是和 media 逐字节相同的整张原图,被裁掉的收货信息另存一下就能看到。后半篇讲我在文档管线里怎么处理这件事。入口先把裁剪烘焙进图片,docx 小了 21.0 %。原件另外归档,旋转和缩放先留在参数里。
版本声明
数字来自 2026-09-30 晚上的一轮实测。10 月 1 日我又补跑了读 XML、算偏移、比对内联图片和入口烘焙这四段脚本。机器是 Apple M4 加 macOS 26.5.2。脚本用的是 Python 3.9 和 Pillow。网页那一侧的结果都是在 Chromium 149 开源构建里看的。换算 CSS 的那一节另外跑了 Firefox 151 和 WebKit 26.5。WebKit 26.5 不是 Safari 正式版。被测的有 mammoth.js 1.13.0、docx-preview 0.4.1(配 JSZip 3.10.1)、图映的 DOCX 转 HTML、macOS 自带的快速查看缩略图和 textutil -convert html。两个开源库跑在我自己写的一个复现页里。字节数一律按文件实际大小写,界面上显示的 MB 和 KB 照原样抄。
适用边界
样本 docx 是我参照 OOXML 的文件结构手工拼的,它不是从 Word 里保存出来的。本机没有 Microsoft Word,也没有 LibreOffice 和 pandoc。WPS 能启动。可本机没给屏幕录制权限,截出来是黑的,它的显示结果我没拿到。样本里只有两张图。一张是网上找的风景照,原图来自 Wikimedia Commons 上 Dietmar Rabich 的作品,许可是 CC BY-SA 4.0。另一张是我自己写了个演示用的订单后台页面再截下来的。上面的收货人、手机号、地址和流水号全是占位的假数据。文中讲 Word 本身怎么存图的地方我只引微软支持页上的说法。讲转换器怎么处理的地方都是从文件结构和导出结果反推的,这几个转换器都不是我写的。只测了跟着文字排的 inline 图,浮动图没测。
文章目录
一、Word裁过的图转成网页为什么会走样
- 1.1 五种转法没有一种三层全认对
- 1.2 只裁下边的截图往上偏了70.4px
二、docx里的一张图到底存了什么
- 2.1 图片字节要经过关系号才找得到
- 2.2 图框大小按EMU记在extent里
- 2.3 裁剪只是一个52字节的元素
- 2.4 旋转后多占的地方另记一层
- 2.5 media里放的是整张原图
三、Word为什么不直接把图裁掉
- 3.1 参数和像素分开存才能反悔
- 3.2 能反悔的代价落在下游
四、各家转换器分别读了哪几层
- 4.1 mammoth只搬了图片字节
- 4.2 快速查看漏掉的恰好是裁剪
- 4.3 textutil连图片都没带出来
- 4.4 认了裁剪的转法会把图放偏
- 4.5 旋转图的外接框没人留位置
五、裁对了的图为什么会偏出图框
- 5.1 偏移量能从四个裁剪值算出来
- 5.2 四边裁得一样多时不偏
六、显示对了被裁的部分还在不在
- 6.1 导出里7张内联图都是整张原图
- 6.2 换算成CSS也只能做到不显示
七、文档管线应该在哪一层处理裁剪
- 7.1 在渲染层修要每个下游都写对
- 7.2 在入口烘焙一次偏移和泄露都没了
- 7.3 原件归档只把烘焙件往下送
- 7.4 旋转和缩放先留在参数里
八、这套做法在哪些条件下不成立
九、查这件事时哪些地方容易看错
- 9.1 同哈希只留一个名字会认错来源
- 9.2 手写的样本证明不了Word的行为
- 9.3 相关系数只够分出三种状态
- 9.4 base64占比不等于图片字节占比
十、还有哪几件事没有验证
参考资料
一、Word裁过的图转成网页为什么会走样
1.1 五种转法没有一种三层全认对
我手上有条文档入库的流程要定输入规范。它收 Word 文档,吐网页和缩略图。规范写到图片那一项时我卡住了。Word 里裁过的图转出去到底还是不是裁过的这个问题我说不准。我做了三年编解码才转到图形工具,对文档格式只算半个外行。说不准就只好拆文件。我照着 OOXML 的结构手写了一份 docx,放了 7 个图片用例。A 只缩放不裁剪。B 四边各裁一刀,左 30 %、上 20 %、右 20 %、下 25 %。C 只旋转 15° 不裁剪。D 是那张订单截图,只裁掉下面的收货信息。E 把一张 3:2 的照片拉扁成 6×2 英寸。F 在 D 的裁剪基础上再转 90°。G 四边各裁 15 %,是个对称的对照组。整份文件一共 7,234,550 B。
转法我挑了五种。mammoth.js 和 docx-preview 是前端最常见的两个库,我把它们放进自己写的复现页里跑。macOS 自带的有快速查看的缩略图和 textutil -convert html 两样。转换这一侧我还用的是图映(imging.cn/)的 DOCX 转 HTML,喂的是同一份 7 个图片用例的手写 docx,浏览器是 Chromium 149 开源构建。图映里 DOCX 这一块不是我做的,我在这个产品里只管端侧编解码。下面讲到它的地方和讲别的转换器一样,都是看导出文件反推的。判断对不对用的是同一个参照。我按 srcRect 把原图真裁一刀再缩放到 extent 的大小,拿它和每种转法的截图做归一化相关。1 是完全一致。
结果没有一种三层全认对,mammoth 更是一层都没认。快速查看认了缩放和旋转,偏偏没认裁剪。textutil 的输出里一张图都没有。docx-preview 和图映三层都认了,裁剪的内容也对。可裁得不对称的图会整体偏出图框,旋转的图也会压到上下文字。下面这张表先放结论,后面几章再一层一层讲为什么。
| 转法 | 缩放 extent | 裁剪 srcRect | 旋转 rot | 导出里有没有整张原图 |
|---|---|---|---|---|
| mammoth.js 1.13.0 | 不认 | 不认,显示整张 | 不转 | 有,7 张都是 |
| macOS 快速查看 | 认 | 不认,整张压进图框 | 认 | 缩略图是位图,不适用 |
| textutil | 图全丢了 | 图全丢了 | 图全丢了 | 没有图 |
| docx-preview 0.4.1 | 认 | 内容对但不对称时偏位 | 方向对但不留外接框 | 有,blob: 背后是整张 |
| 图映 DOCX 转 HTML | 认 | 内容对但不对称时偏位 | 方向对但不留外接框 | 有,7 张都是 |
1.2 只裁下边的截图往上偏了70.4px
表里最让我在意的是只裁了下边的用例 D。截一张后台页面再把下面一截裁掉,这大概是 Word 里最常见的裁法。D 的图框是 6×2.667 英寸,到网页上是 576×256 px。下边裁掉了 35.484 %。图映导出的网页里这张图整体往上偏了 70.4 px。docx-preview 在复现页里偏了 69.7 px。图上方是一行标题,在工作台预览里被盖得只露出「截图:」三个字。被裁掉的收货信息倒是没露出来。我在页面截图里做多尺度模板匹配去找它,最高只有 0.271。找不到。从导入到转换 7 个用例全程没有出现任何警告,界面对裁剪和旋转都没有提示。看到 70.4 这个数我头一个反应是测量误差,后来照着导出里的样式反推,发现它能精确算出来。这件事放到第五章再讲。先把文件结构拆清楚。
二、docx里的一张图到底存了什么
2.1 图片字节要经过关系号才找得到
docx 本身就是个 zip 包。改个扩展名解开以后正文在 word/document.xml 里,图片在 word/media/ 里。两者中间隔着一张关系表 word/_rels/document.xml.rels。一张图在正文里写成一个 <w:drawing>。里面先是 wp:inline,再往里是 a:graphic、a:graphicData 和 pic:pic。真正指向图片字节的只有 pic:blipFill 下面的 a:blip,它上面只写了一个关系号。下面是用例 B 的那一段原文。原文挤在一起只有一整行,缩进是我加的。wp:cNvGraphicFramePr 和 pic:nvPicPr 两个跟这篇无关的节点我省掉了。
xml
<wp:inline distT="0" distB="0" distL="0" distR="0">
  <wp:extent cx="5486400" cy="4023360"/>
  <wp:effectExtent l="0" t="0" r="0" b="0"/>
  <wp:docPr id="2" name="图片 2"/>
  <a:graphic>
    <a:graphicData uri="http://schemas.openxmlformats.org/drawingml/2006/picture">
      <pic:pic>
        <pic:blipFill>
          <a:blip r:embed="rId102"/>
          <a:srcRect l="30000" t="20000" r="20000" b="25000"/>
          <a:stretch><a:fillRect/></a:stretch>
        </pic:blipFill>
        <pic:spPr>
          <a:xfrm><a:off x="0" y="0"/><a:ext cx="5486400" cy="4023360"/></a:xfrm>
          <a:prstGeom prst="rect"><a:avLst/></a:prstGeom>
        </pic:spPr>
      </pic:pic>
    </a:graphicData>
  </a:graphic>
</wp:inline>
代码说明。这段是样本里用例 B 的 XML。前缀 wp、a、pic、r 分别对应 Word 绘图、DrawingML 主命名空间、图片和关系这四个命名空间。r:embed="rId102" 要去关系表里查,对应的 Target 是 media/image2.jpeg。和裁剪、缩放、旋转有关的是四个节点。wp:extent 是图框大小。wp:effectExtent 是图框外额外留的边。a:srcRect 是裁剪。旋转用的 rot 挂在 a:xfrm 上。用例 B 没旋转,它的 a:xfrm 上就没有 rot 属性。a:xfrm 下面的 a:ext 是图形自己的尺寸,样本里我让它和外层 wp:extent 保持一致。a:stretch 里的 a:fillRect 表示裁剪后剩下的那块要拉伸填满图框。我这 7 个用例里 a:fillRect 都是空的。
这一层的含义很简单,正文里不存图只存一个指针。同一个 media 理论上可以被好几处用不同的裁剪引用。这一点到第七章写烘焙脚本时会变成一个麻烦。
2.2 图框大小按EMU记在extent里
wp:extent 上的 cx 和 cy 用的单位叫 EMU。1 英寸是 914400 EMU。这个数挑得很讲究。它除以 2.54 是 360000,除以 72 是 12700,厘米和磅都能换成整数。换成网页上的 CSS 像素要除以 9525。用例 B 的 5486400 × 4023360 就是 6×4.4 英寸,到网页上是 576×422.4 px。这一层只管图在页面上占多大,图片本身有多少像素它不管。B 那张风景照是 2736×1824,放进的是一个 6×4.4 英寸的框。两边的宽高比并不一样,能对得上全靠下一层的裁剪。用例 E 就是故意不让它们对上的。3:2 的照片塞进 6×2 英寸的框,正常显示就该被拉扁。
2.3 裁剪只是一个52字节的元素
a:srcRect 上是四个整数,l、t、r、b 分别是左、上、右、下各裁掉多少。单位是千分之一个百分点,30000 就是 30 %。用例 B 那一行按 UTF-8 数下来是 52 B。整张风景照有 1,388,716 B,裁剪这件事在文件里只占这 52 个字节。没裁过的图也有这个元素,只是写成空的 <a:srcRect/> 只占 12 B。四个数是相对原图的比例不是像素,同一组参数套到任何分辨率的图上都成立。换一张更清楚的原图进来,裁剪范围也不用改。按这四个数算,B 在页面上显示的面积只占原图的 27.5 %。剩下的 72.5 % 在文件里,只是看不见。D 看不见的是 35.5 %,对称裁的 G 是 51.0 %。
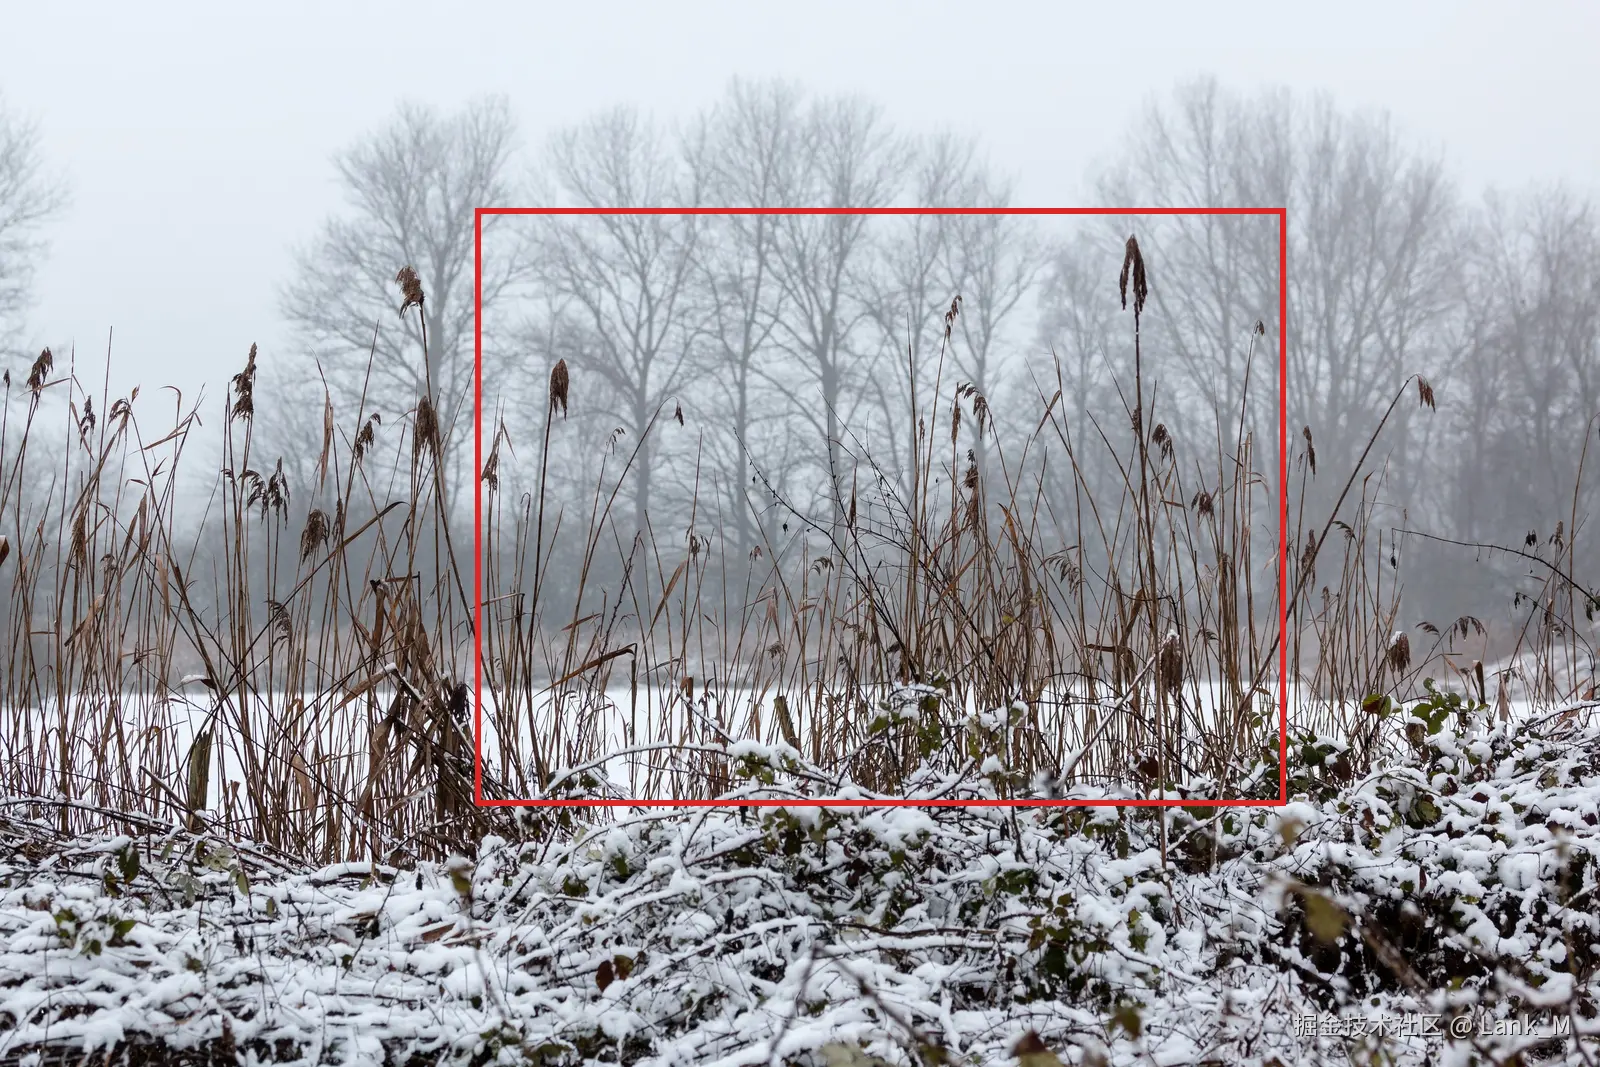
这张图要看红框内外的面积差。它是用例 B 的源图,整张都在 word/media/image2.jpeg 里。红框是按那四个数圈出来的显示范围,页面上只显示框里这一块。框外的雪地和芦苇占了七成多,一个像素都没少。原图来自 Wikimedia Commons 上 Dietmar Rabich 的作品,许可是 CC BY-SA 4.0。红框是我画上去的,这张图同样按 CC BY-SA 4.0 提供。
2.4 旋转后多占的地方另记一层
旋转写在 pic:spPr 下面 a:xfrm 的 rot 属性上,单位是六万分之一度。用例 C 的 900000 是 15°,F 的 5400000 是 90°。光有一个 rot 其实还不够。一张 4×2.667 英寸的图转 15° 以后四个角会伸出原来的框。排版得知道它多占了多少地方才不会压到上下的文字。这件事记在 wp:effectExtent 里。它的四个数是图框外四边各要多留多少 EMU,没旋转的用例这里全是 0。C 写的是 l=253237、t=431785、r=253237、b=431785。上下各 431785 EMU,换成网页是 45.3 px。F 转了 90° 以后宽高互换。它的 effectExtent 上下各 1016002,左右各 −1016001。左右反倒要往里收。样本是我手写的,这几个 effectExtent 是我按规范算好填进去的而不是 Word 写的值。Word 自己怎么填我没法验证,不过 45.3 这个数后面还会在别的地方再出现一次。
2.5 media里放的是整张原图
拆到最后一层是图片本身,我把 7 个 media 逐个算了 sha256。风景照的 5 个都是 43172fd6e3 开头,截图的 2 个都是 afd140cb8b 开头。它们和源文件逐字节相同。风景照还是 2736×1824,截图还是 1800×1240。这里得先说清楚一件事。media 里是整张原图是我造样本时自己放进去的,拿它证明不了 Word 的行为。能说明 Word 默认怎么存的是微软的支持页。讲减小图片体积的那一页在 macOS 部分写了,裁过图以后可以勾选「删除图片的剪裁区域」来进一步减小文件。要专门勾一下才删,反过来说就是不勾的话被裁掉的部分会一直留在文件里。Word 保存时会不会自动删、各版本默认值是什么,我手上没有 Word 测不了。我还扫了一遍自己电脑上的 14 份 docx 和 53 张图,只统计参数不读正文。带非零 srcRect 的只有这份样本自己的 3 张。手边连一份 Word 真存出来的裁剪样本都没有,这一块只能先空着。
下面这段脚本是我拆样本时用的。它按正文里出现的顺序把 7 个 wp:inline 挨个读出来,打印三层参数和 media 的尺寸、字节与哈希前缀。
python
for case, inline in zip("ABCDEFG", body.iter(f"{{{NS['wp']}}}inline")):
    frame = inline.find("wp:extent", NS)
    trim = inline.find(".//a:srcRect", NS)
    turn = inline.find(".//a:xfrm", NS)
    target = "word/" + links[inline.find(".//a:blip", NS).get(f"{{{NS['r']}}}embed")]
    raw = pkg.read(target)
    w_in = int(frame.get("cx")) / EMU_PER_INCH
    h_in = int(frame.get("cy")) / EMU_PER_INCH
    cut = {side: int(trim.get(side, 0)) / 1000 for side in "ltrb"}
    deg = int(turn.get("rot", 0)) / 60000
    px = Image.open(pkg.open(target)).size
    print(f"{case} frame {w_in:.3f}x{h_in:.3f}in  cut% {cut}  rot {deg:g}  "
          f"media {px[0]}x{px[1]} {len(raw):,}B sha {hashlib.sha256(raw).hexdigest()[:10]}")
bash
B frame 6.000x4.400in  cut% {'l': 30.0, 't': 20.0, 'r': 20.0, 'b': 25.0}  rot 0  media 2736x1824 1,388,716B sha 43172fd6e3
C frame 4.000x2.667in  cut% {'l': 0.0, 't': 0.0, 'r': 0.0, 'b': 0.0}  rot 15  media 2736x1824 1,388,716B sha 43172fd6e3
D frame 6.000x2.667in  cut% {'l': 0.0, 't': 0.0, 'r': 0.0, 'b': 35.484}  rot 0  media 1800x1240 143,480B sha afd140cb8b
F frame 4.000x1.778in  cut% {'l': 0.0, 't': 0.0, 'r': 0.0, 'b': 35.484}  rot 90  media 1800x1240 143,480B sha afd140cb8b
代码说明。前面省掉的几行负责打开 zip、解析 document.xml、把关系表读成「关系号到路径」的字典。NS 是四个命名空间前缀,EMU_PER_INCH 是 914400。srcRect 除以 1000 得到的是百分数,打印出来是 30.0 不是 0.3。rot 除以 60000 得到度数。输出里只留了 B、C、D、F 四行。A、E、G 的 media 和 B 一样,区别只在图框和裁剪。这段脚本只用了标准库的 xml.etree 和 Pillow。它读的是 wp:inline,浮动图用的 wp:anchor 它不会处理。
三、Word为什么不直接把图裁掉
3.1 参数和像素分开存才能反悔
拆完我反倒觉得这个存法挺对,做编解码的人对这种思路很熟。原始数据一个字节不动,所有编辑都记成参数叠在上面等显示时再算。用户今天裁掉的那条边明天想要回来,把四个数改回去就行。换个比例重新裁也只是改几个数。画质也不会因为反复编辑一点点往下掉,因为每次显示都从原图重新算。假如 Word 每裁一次就把 JPEG 解码、切掉、再压一遍,裁三次就是多压三代。用户还没法反悔。对一个编辑器来说多存一些字节换来可撤销和不掉画质,这笔账划算。缩放和旋转也是同一个道理。只要它们记成参数原图就一直是原图。
3.2 能反悔的代价落在下游
代价不会消失,只是换了地方。编辑器自己知道这几层要放在一起读,别的程序不一定知道。文件里存着的东西永远比页面上显示的多。多出来的那部分占体积,也可能正是作者以为已经删掉的内容。D 那张截图裁掉的是收货人、手机号和地址。作者在 Word 里看到的是裁过的截图,就以为那块没了。在编辑器里这没问题,能反悔正是它要的功能。麻烦出在文件离开编辑器以后的那一段。我那条流程正好在下游,收进来的 docx 要转成网页给别人看。下游拿到的是一张原图加一份说明书。说明书读漏一行看到的就和作者看到的不一样,读漏了哪一行决定了出什么错。
四、各家转换器分别读了哪几层
4.1 mammoth只搬了图片字节
mammoth 的思路是把 Word 转成语义干净的 HTML。图片这块它只顺着 a:blip 的关系号把字节取出来,转成 data URI 塞进 <img>。extent、srcRect 和 rot 三层都没进输出。B、D、G 三个裁过的用例全显示成整张,整张原图和显示区域的相关是 0.997、0.926 和 0.997。D 的收货信息在页面上直接就能找到,相关 0.984。它也不写宽高。图按原图比例铺满容器,我那个复现页是 900 px 宽。E 那张本该拉扁的照片没拉扁,C 和 F 也都没转。整份输出 9,641,701 B,7 张 data URI 全是整张原图。
我还翻了 mammoth 给调用方留的口子。它的 convertImage 回调只给图片字节和类型,拿不到 srcRect。想在它里面顺手裁一刀都找不到入口。用 mammoth 就只能在转换之前先处理 docx。这不算缺陷,它本来就不打算还原版式。只不过用它的人得知道图片这一层它只读了字节。
4.2 快速查看漏掉的恰好是裁剪
快速查看缩略图读了两层。缩放它认。A 的图框宽高比量出来是 1.501,应该是 1.5。E 是 3.018,应该是 3.0。旋转它也认,C 和 F 都转了。这两个我只看了图没量。偏偏 srcRect 它没认,它把整张原图压进 extent 的图框里。B 和整张原图的相关是 0.857,和裁后的参照只有 0.360。G 是 0.884 对 0.366。D 的收货信息被压扁了照样显示出来,这个用例的框检测没成功,我只能肉眼看。这个组合挺有意思。框和方向都是对的可框里装的却是整张图。只看缩略图的人会觉得图被压扁了,想不到是裁剪没生效。
4.3 textutil连图片都没带出来
textutil -convert html 最干脆。7 张图一张不剩。输出只有 1,380 B,里面 0 个 <img>。我又试了 -convert webarchive,也只有 1,628 B。它能正常打开这份 docx 把全文抽出来,只是不管图。拿它做文档入库的话图会悄无声息地没掉,这比走样更难发现。
4.4 认了裁剪的转法会把图放偏
docx-preview 和图映的表现一样,这里放在一起说。这三层它们都读了。裁剪的内容是对的,B、D、G 的相关是 0.962、0.990 和 0.993。缩放也对。A 是 0.993,E 的图框是 576×192,和 extent 对得上。毛病出在位置上。图映导出里 B 偏了 (58, −19) px,D 往上偏了 70.4 px。G 是 (0, 0)。G 的相关只有 0.754 并不是 G 自己的问题,是它上方转了 90° 的 F 盖住了它一角。
我从导出的样式反推它们的写法。<img> 的宽高设成 extent 以后先用 clip-path 按 srcRect 只留下可见那块,再用 transform: scale 把可见那块放大回图框大小。思路是对的,裁剪的内容自然就对了。可 transform 默认以元素中心为原点。可见区的中心不在元素中心时,放大以后它就跑出了图框。为什么偏、偏多少第五章单独算。
图映这边还有几件事可以照实记下来。它的副标题原话是「导入后立即只读预览;转换后保存为一个可离线打开的 HTML。」导入后状态行显示「预览已就绪」,文件行是「Word裁图样本.docx · 1 页」。转换完显示「输出大小 · 9.22 MB」。原样本、烘焙样本、单用例 D 和它的烘焙版一共四次转换,非 GET 请求全是 0 次。
4.5 旋转图的外接框没人留位置
旋转这一层 docx-preview 和图映的方向都转对了。但它们都没按旋转后的外接框留位置。C 转了 15° 以后,超出图框上下各约 45 px。这个数和 2.4 节算出来的 effectExtent 上下各 45.3 px 正好对上。样本里已经写明了要多留多少。排版时这块地方没留出来,图就伸到了上下文字里。F 转了 90°。它的 effectExtent 上下各要多留 106.7 px,结果直接压住了上下的文字。它们到底读没读 effectExtent 我没看代码,只能从结果推测没用上。快速查看也转了图,有没有留位置我没量。
把四章的结果按 XML 节点重新排一遍,各家读了哪层就很清楚了。
| XML 节点 | mammoth | 快速查看 | textutil | docx-preview | 图映 |
|---|---|---|---|---|---|
a:blip 图片字节 |
读,整张内联 | 读 | 丢了 | 读,整张放进 blob: |
读,整张内联 |
wp:extent 图框 |
不读 | 读 | --- | 读 | 读 |
a:srcRect 裁剪 |
不读 | 不读 | --- | 读但位置偏 | 读但位置偏 |
a:xfrm rot 旋转 |
不读 | 读 | --- | 读 | 读 |
wp:effectExtent 外接框 |
不读 | 没量 | --- | 结果上没留位 | 结果上没留位 |
五、裁对了的图为什么会偏出图框
5.1 偏移量能从四个裁剪值算出来
偏移的推导并不复杂。假设图框宽 W,左右裁剪比例是 l 和 r。可见区宽 W×(1−l−r),它的中心离元素左边 W×(l + (1−l−r)/2)。以元素中心为原点放大 1/(1−l−r) 倍以后,可见区中心会被推到离图框中心 W×(l−r)÷(2×(1−l−r)) 的地方。垂直方向把 l、r 换成 t、b 就行。我写了一段脚本按这个公式算,直接用 XML 里的 EMU 原值。
python
EMU_PER_CSS_PX = 9525
cases = {  # 用例: (extent cx, cy, l, t, r, b),裁剪值是 srcRect 原值
    "B": (5486400, 4023360, 30000, 20000, 20000, 25000),
    "D": (5486400, 2438400, 0, 0, 0, 35484),
    "G": (5486400, 3657600, 15000, 15000, 15000, 15000),
}

def drift(frame_px, near, far):
    keep = 1 - near - far
    return frame_px * (near - far) / (2 * keep)

for name, (cx, cy, *edges) in cases.items():
    l, t, r, b = (e / 100000 for e in edges)
    box_w, box_h = cx / EMU_PER_CSS_PX, cy / EMU_PER_CSS_PX
    print(f"{name} box {box_w:.1f}x{box_h:.1f}px  "
          f"dx {drift(box_w, l, r):+.1f}  dy {drift(box_h, t, b):+.1f}")
rust
B box 576.0x422.4px  dx +57.6  dy -19.2
D box 576.0x256.0px  dx +0.0  dy -70.4
G box 576.0x384.0px dx +0.0 dy +0.0代码说明。drift 的 near 和 far 是同一方向上的两条边。水平方向传 l 和 r,垂直方向传 t 和 b。正数是往右或往下,负数是往左或往上。EMU 除以 9525 换成 CSS 像素,srcRect 除以 100000 换成比例。B 算出来右移 57.6 px、上移 19.2 px,实测是 (58, −19)。D 算出来上移 70.4 px。图映导出实测 −70.4,docx-preview 是 −69.7。这段脚本不碰浏览器只做算术,它能对上就说明偏移是写法本身带来的,不是测量误差。
D 只裁下边。左右那一项是 0,垂直那一项是 256 × 0.35484 ÷ 1.29,正好 70.4。裁得越多分母越小,偏得也越厉害。图上方只要有一行字就会被盖住,用例 D 的标题行就是这么没的。
5.2 四边裁得一样多时不偏
公式里起作用的只有 l−r 和 t−b。左右裁得一样多、上下也裁得一样多,分子就是 0。G 四边各裁 15 %,算出来和实测都是 (0, 0)。
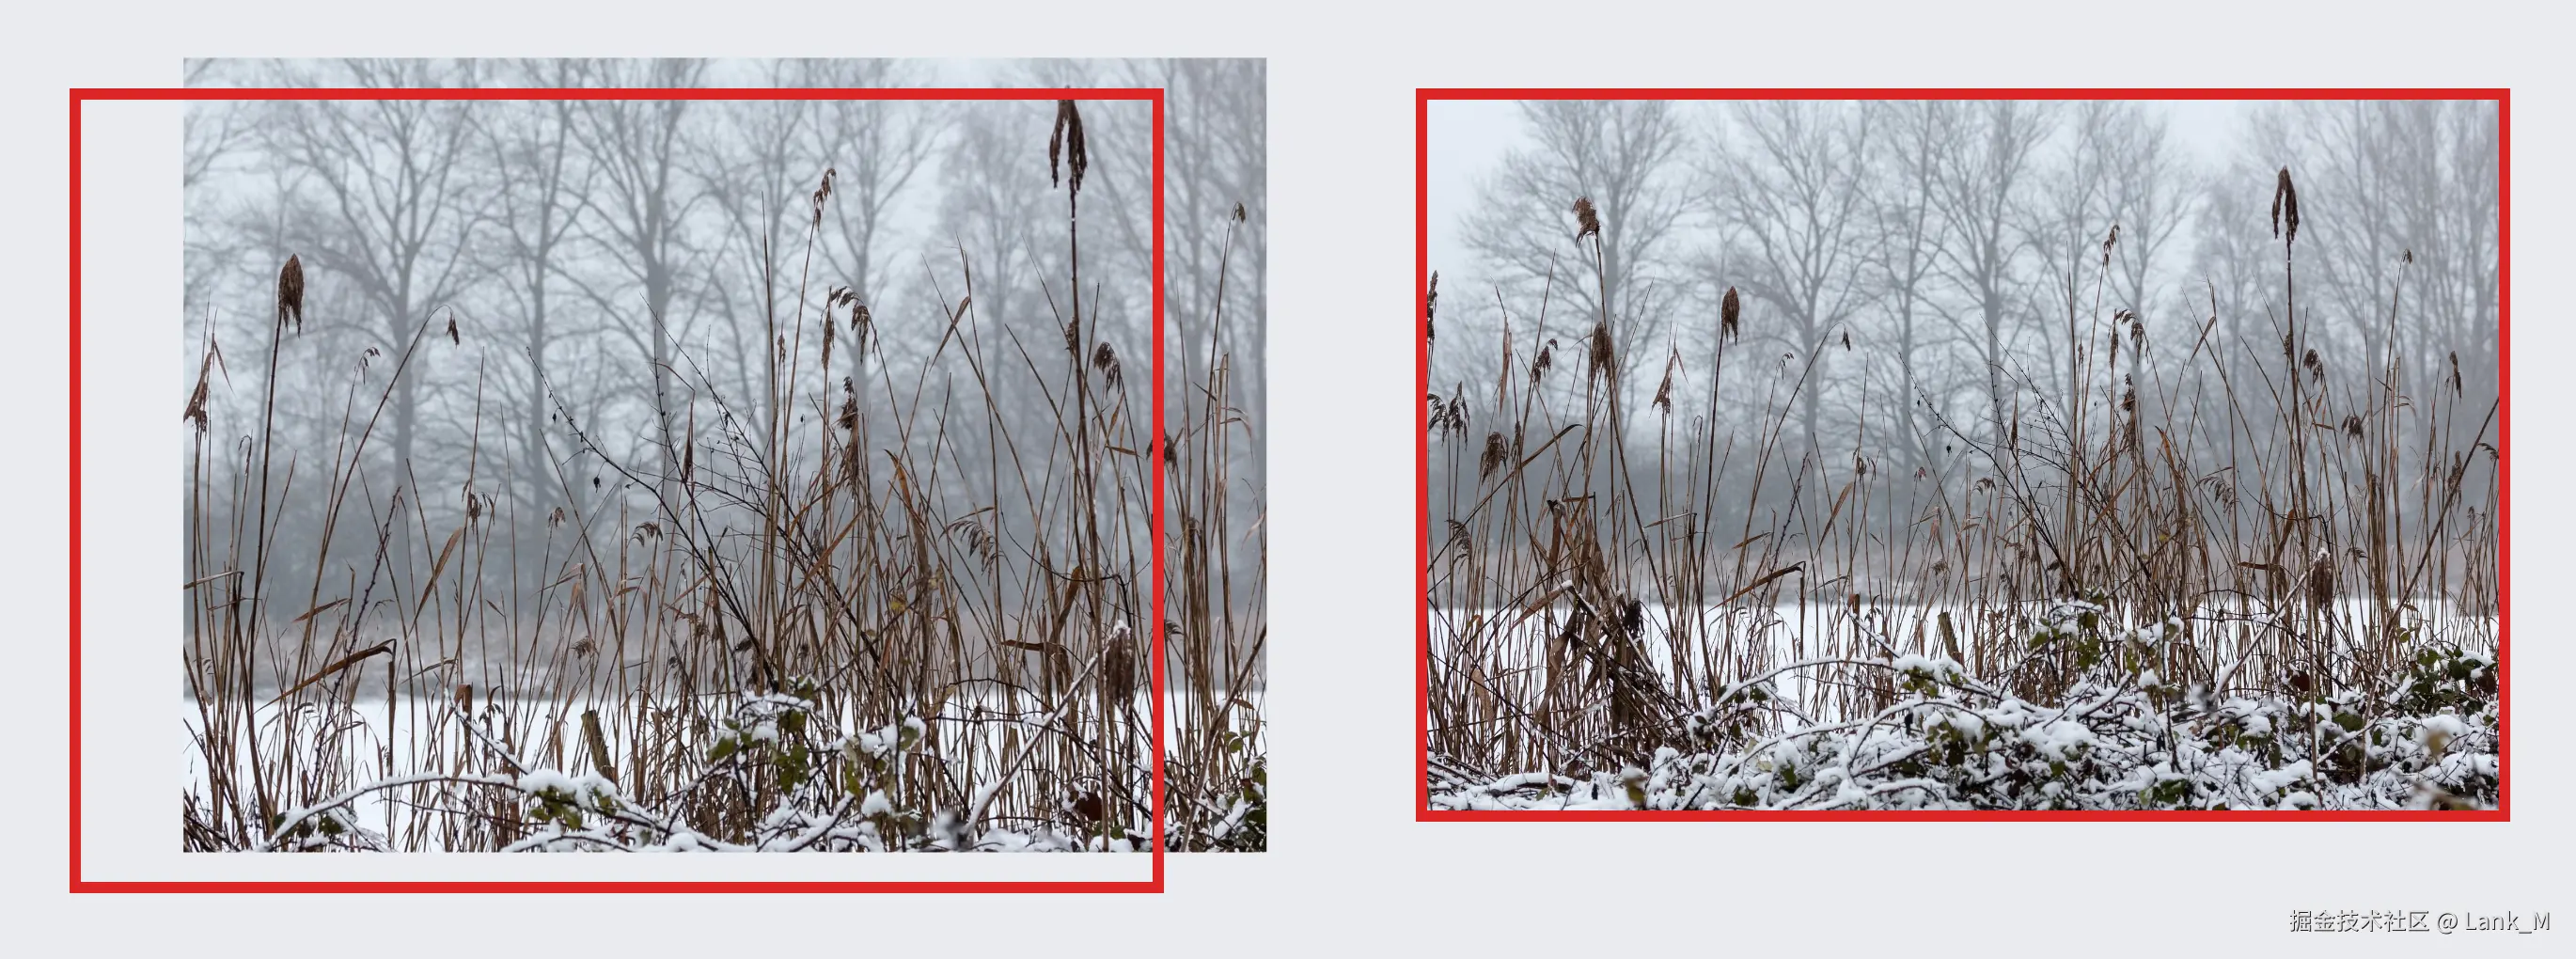
这张图看红框和画面的相对位置,红框是 Word 的图框。左边的 B 左右和上下都裁得不一样多,画面整体往右上方跑出了红框。右边的 G 四边各裁 15 %,画面正好落在框里。风景照的署名同上一张,这张也按 CC BY-SA 4.0 提供。
这也说明了这个毛病为什么不容易被发现。随手拿一张图四边均匀裁一下做测试,结果严丝合缝,人很容易就放心了。真实文档里对称裁剪反倒少见,截图只裁下边和照片只裁一侧都是不对称的。我自己一开始也只拿 G 测过,看到 0 偏移差点就收工了。按公式推把 transform-origin 挪到可见区的中心应该就不偏。这个我没实跑。实跑过的是不用 scale 的外框裁切写法,第六章会讲到它在三个内核上都是对的。
六、显示对了被裁的部分还在不在
6.1 导出里7张内联图都是整张原图
前面五章讲的都是显示层,那一层错了大家都看得见。我更在意的是看不见的那一层到底有什么。mammoth 和图映导出的 HTML 都把图片用 data URI 内联进去。我写了一段脚本把内联图片全部解码,再和 docx 里的 media 按哈希比对。
python
with zipfile.ZipFile(docx_path) as pkg:
    media = {}
    for part in (n for n in pkg.namelist() if n.startswith("word/media/")):
        media.setdefault(digest(pkg.read(part)), []).append(part.rsplit("/", 1)[1])

page = open(html_path, "rb").read()
uris = re.findall(rb"data:image/(\w+);base64,([A-Za-z0-9+/=]+)", page)
encoded = sum(len(payload) for _, payload in uris)
print(f"html {len(page):,}B  inline images {len(uris)}  base64 share {encoded / len(page):.1%}")
for kind, payload in uris:
    blob = base64.b64decode(payload)
    twins = media.get(digest(blob), ["none"])
    print(f"  {kind.decode():4} {len(blob):>9,}B  identical to {len(twins)} part(s): {' '.join(twins)}")
scss
html 9,665,338B  inline images 7  base64 share 99.7%
  jpeg 1,388,716B  identical to 5 part(s): image1.jpeg image2.jpeg image3.jpeg image5.jpeg image7.jpeg
png 143,480B identical to 2 part(s): image4.png image6.png代码说明。digest 是对字节取 sha256 的一行函数,这里省掉了。脚本先把 docx 里每个 media 按哈希建索引。值是一个文件名列表,因为同样的字节可能出现在好几个 part 里。再用正则把 HTML 里的 data URI 全抠出来,解码后按哈希去索引里找。输出原本有 7 行内联图。这里只留了一行 JPEG 和一行 PNG,其余 5 行一样。base64 share 是 data URI 的 base64 文本占整个 HTML 字节的比例。
图映导出的那份 9,665,338 B 的文件里,7 张内联图全是和 media 逐字节相同的整张原图。D 那张截图解出来是 1800×1240,收货人、手机号、地址和流水号一样不少。只导出用例 D 的单页版本是 213,557 B,界面显示 208.6 KB。里面那张 PNG 同样是 143,480 B 的整张。网页上看不见收货信息,右键「图片另存为」拿到的却正是这份字节。docx-preview 的预览也一样,blob: 地址背后是整张原图。
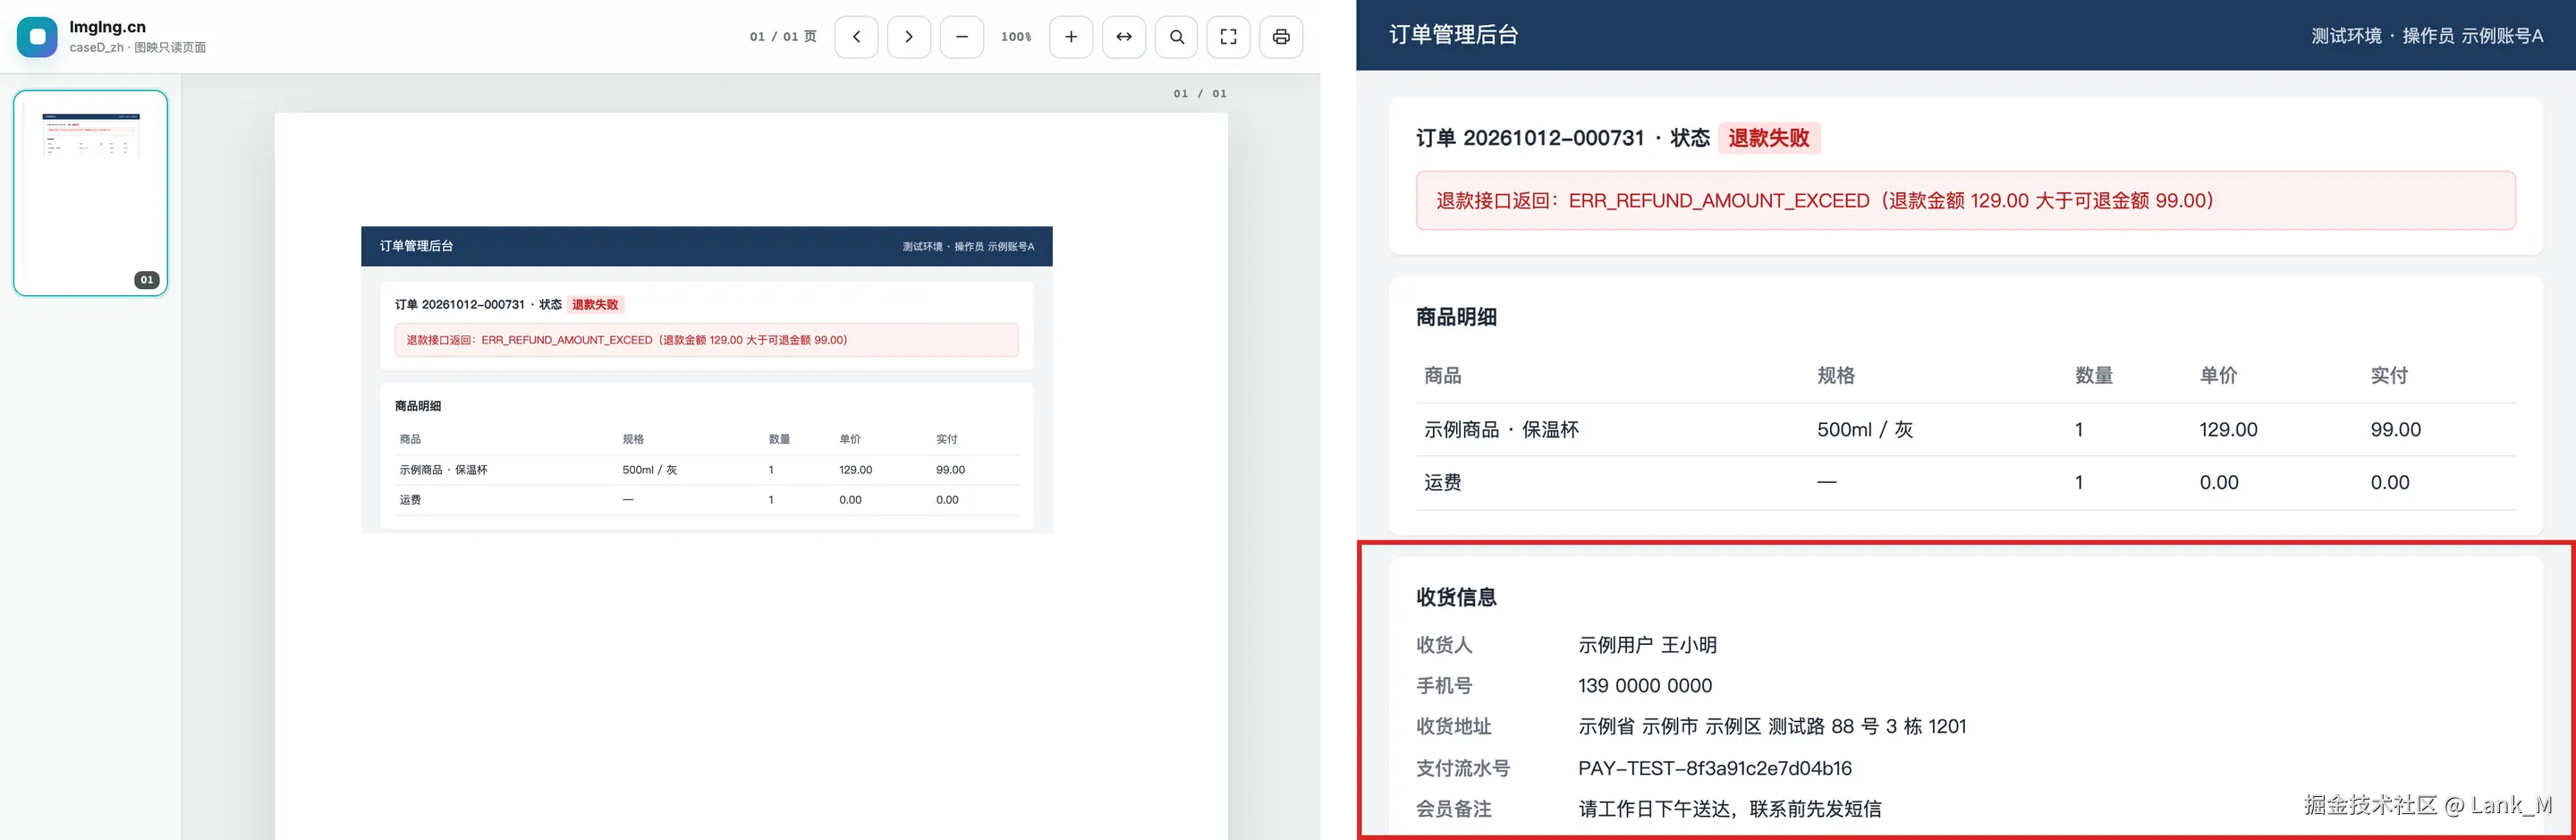
这张图要左右对着看。左边是图映导出的网页,订单截图停在商品明细那一行,下面的收货信息看不见。右边是同一个网页里那张内联图片的字节解码后的样子。红框圈出来的收货信息原样都在,订单上的内容是我自己造的占位数据。
6.2 换算成CSS也只能做到不显示
有人会说那把偏移修好不就行了。我试了两种把 srcRect 换成 CSS 的写法。写法一是外框按 extent 设宽高再 overflow:hidden。里面的图按可见比例放大,用负 margin 把可见区挪进框里。写法二是 object-view-box: inset(t r b l)。三个内核的结果在下面这张表里,数字是和参照的归一化相关。
| 内核 | 写法一 B / D / G | 写法二 B / D / G | 支持 object-view-box |
|---|---|---|---|
| Chromium 149 | 0.967 / 0.998 / 0.958 | 0.964 / 0.998 / 0.957 | 是 |
| Firefox 151 | 0.962 / 0.999 / 0.961 | 0.369 / 0.679 / 0.373 | 否 |
| WebKit 26.5 | 0.956 / 0.994 / 0.961 | 0.373 / 0.691 / 0.377 | 否 |
写法一在三个内核上都对。写法二只有 Chromium 认,另外两个直接显示整张。可不管哪种写法,<img> 的 src 还是那张整图。CSS 只决定显示哪一块,发出去哪些字节它决定不了。显示对了和被裁部分没了是两个问题,得分开验。
七、文档管线应该在哪一层处理裁剪
7.1 在渲染层修要每个下游都写对
想清楚这两层以后,问题就落到了在哪一层处理上。一种是在渲染层修,每个下游消费者自己把 extent、srcRect、rot 和 effectExtent 换算成 CSS 或画布操作。网页预览、缩略图和以后要接的导出 PDF 各写一遍,漏一个就走样。就算个个写对了,被裁的部分照样跟着发出去。另一种是在入口做一次规范化,docx 一进来先把裁剪烘焙进图片。后面不管接哪个转换器拿到的都是所见即所得的图。那一行 srcRect 也不存在了。我选的是后者。在渲染层修的话正确性分散在每个消费者手里,在入口烘焙只要写对一次。
7.2 在入口烘焙一次偏移和泄露都没了
烘焙的意思是按 srcRect 把 media 真裁掉,再把 srcRect 清空。脚本里最要紧的不是裁图那几行,是裁之前的两道守卫。
python
uses = defaultdict(set)
for pic in re.findall(r"<pic:pic\b.*?</pic:pic>", xml, re.S):
    rid = re.search(r'r:embed="(\w+)"', pic)[1]
    hit = TRIM.search(pic)
    uses[rid].add(read_trim(hit[1]) if hit else (0, 0, 0, 0))
shared = [rid for rid, trims in uses.items() if len(trims) > 1]
if shared:
    raise SystemExit(f"same media cropped two ways, split first: {shared}")
for rid, (trim,) in uses.items():
    l, t, r, b = trim
    if min(trim) < 0:
        raise SystemExit(f"{rid}: negative srcRect (padding) not handled")
    if not any(trim):
        continue
    part = "word/" + target[rid]
    img = Image.open(io.BytesIO(pkg.read(part)))
    wide, tall = img.size
    kind = "PNG" if part.endswith(".png") else "JPEG"
    kept = img.crop((round(wide * l), round(tall * t), round(wide * (1 - r)), round(tall * (1 - b))))
rust
word/media/image2.jpeg: 2736x1824 -> 1368x1003, 495,443B
word/media/image4.png: 1800x1240 -> 1800x800, 84,507B
word/media/image6.png: 1800x1240 -> 1800x800, 84,507B
word/media/image7.jpeg: 2736x1824 -> 1916x1276, 880,195B
docx 7,234,550B -> 5,714,763B代码说明。TRIM 是匹配 <a:srcRect .../> 的正则。read_trim 把四个属性除以 100000 变成比例,没写的边按 0 算。target 是关系号到路径的字典。头一道守卫按关系号收集每个 media 被引用时的裁剪。同一个 media 出现两种裁剪就停下,因为真裁只能裁成一种。另一道守卫碰到负值就停。srcRect 是负数表示往外留白不是裁剪,脚本没处理。省掉的后半段负责保存裁好的图、把所有 srcRect 换成空元素、原样拷贝其余 part 再写出新 docx。PNG 原样保存,JPEG 按 q92 重新编码。我把用例 G 的关系号改成和 B 一样再跑。脚本输出 same media cropped two ways, split first: ['rId102'] 并以退出码 1 结束,不写文件。负值那条只走过代码路径,我没造负值样本去跑。
烘焙后的 docx 从 7,234,550 B 降到 5,714,763 B,小了 21.0 %。B 的 media 变成 1368×1003。D 变成 1800×800,收货信息那一截是真没了。再把它交给图映转一次,导出从界面上的 9.22 MB 降到 7.28 MB。按字节是 9,665,338 降到 7,638,787。单用例 D 从 208.6 KB 降到 131.7 KB。B 和 D 的偏移变成了 (0, 0) 和 (0, −0.4),相关是 0.992 和 0.999。偏移是顺带修好的,srcRect 没了以后公式里那一项跟着归零。三种转法的页面上都再找不到被裁的部分,最高相关不超过 0.273。mammoth 烘焙后显示的也是裁后的画面,只是它照旧不认 extent,尺寸还是按容器铺。
7.3 原件归档只把烘焙件往下送
烘焙这一步我想了一阵才接受。Word 那套参数存法最大的好处就是能反悔,烘焙等于把它主动扔了。烘焙后的文件再也恢复不出被裁的部分。JPEG 还要多编码一代,q92 这个值本身也值得再推敲。源图要是 q90 存的,拿 q92 去压也找不回丢掉的细节。字节倒多花了。JPEG 按编码块边界裁可以不重新编码,代价是会多留一条窄边。那又得留一个小的 srcRect 去遮,等于把问题请回来一截。这两条路我在别处单独量过,这里不展开。我的处理是把原件和发布件分开。作者交上来的 docx 原样归档,内部要再编辑就从原件改。管线往下游送的只有烘焙过的副本。谁要找回被裁的部分就去档案里取原件,网页那一侧再也拿不到。
7.4 旋转和缩放先留在参数里
烘焙脚本只动了裁剪这一层。烘焙后再跑一遍 2.5 节那段脚本,7 张图的 srcRect 全是 0。C 的 rot 15 和 F 的 rot 90 都还在,E 的图框也还是 6×2 英寸。这是我故意留的,三层参数被读漏的后果不一样。extent 读漏了图会变大变小,难看但不会多出任何信息。rot 读漏了会方向不对或者压到上下文字,同样只是难看。只有 srcRect 底下藏着像素,读对了也会把整张图发出去。藏东西的只有这一层,入口就只消这一层。旋转要不要也在入口转成真像素我还在犹豫。转完四角会多出空白,JPEG 又要多编一代,体积账我也没算。缩放就更没必要烘焙了。把一张 2736×1824 的图按 6×4 英寸重采样等于替所有下游定了分辨率。高分屏上就糊了。
八、这套做法在哪些条件下不成立
最大的前提是样本,docx 是我手写的。「media 里是整张原图」在样本里是我造出来的,Word 那一侧只有微软支持页那一句可引。Word 保存时会不会自动删掉裁剪区域、不同版本默认怎么处理,我都没测。要是你手上的 Word 默认就删,这篇讲的泄露在那份文件上就不成立。显示偏位那部分照样成立。WPS、LibreOffice 和 pandoc 都没测。它们读不读 srcRect、怎么读,我不知道。
图的种类也有限,只测了 inline 图。浮动图 wp:anchor 的定位和环绕更复杂,脚本不处理,转换器的表现我也没看。图片填充的形状、a:fillRect 非空、srcRect 为负值往外留白、同一个 media 被多处以不同裁剪引用,这几种都没覆盖。烘焙脚本碰到后两种会直接拒绝,不会悄悄写错。样本只有两张图,一张第三方照片加一张我造的网页截图。
浏览器这一侧,图映导出的网页我只在 Chromium 149 开源构建里看过。Firefox 151 和 WebKit 26.5 下它显示成什么样我没跑。换算 CSS 那一节跑了三个内核,那个结论只对那一节成立。几个转换器的版本是 mammoth.js 1.13.0 和 docx-preview 0.4.1。换了版本写法可能就变了,偏位公式也不一定适用。
管线这一侧还有一个风险,是我自己的取舍带来的。入口烘焙以后,下游再也拿不到被裁的部分。要是哪天有个下游确实需要原图,它就得绕过管线直接去档案取原件。给作者做一个能接着编辑的在线预览就是这种情况。这条旁路要是开得太随意,前面做的事就白做了。
九、查这件事时哪些地方容易看错
9.1 同哈希只留一个名字会认错来源
6.1 节那段比对脚本我最早那版写错了。我用的是「哈希到文件名」的字典,同一个哈希只留最后一个名字。样本里 5 个风景照 part 字节相同,2 个截图 part 也相同。结果 7 行输出全打成了 image7 和 image6。看着就像导出里所有图都来自同一个 part。我差点据此写成「转换器把重复的图合并了」,改成「哈希到文件名列表」以后才看清楚。那是我造样本时给每个用例各放了一份同样的图。导出里也是 7 份 data URI,一份都没合并。Word 实际保存时会不会合并相同的图我没法测。这个坑留给我的习惯是比对结果里的「来源」那一栏要能装下多个答案。
9.2 手写的样本证明不了Word的行为
这个坑我在写稿时差点踩进去。样本 media 里是整张原图,这是我自己放的。拿它去说「Word 会留着被裁掉的部分」,等于用自己的假设证明自己的假设。真正拿得出来的证据只有两样。一样是微软支持页上「删除图片的剪裁区域」这个选项本身。另一样是转换器怎么处理已经在文件里的整张原图。前者说明 Word 有留着的可能,后者说明一旦留着会出什么事。中间那一步只能拿真文件去拆,就是你手上那份文件里到底留没留。我扫了自己电脑上的 14 份 docx,没有一份是 Word 存出来又带裁剪的。这一步只好空着。
9.3 相关系数只够分出三种状态
文中的相关系数都是 OpenCV 的归一化相关。我拿它只做一件事,就是区分「整张」「裁后」「偏位」三种状态。它不是画质指标。风景照细节多,缩放插值稍有不同相关就会往下掉。6.2 节写法一明明裁对了,三个内核的相关也只在 0.956 到 0.967 之间。截图这类大块纯色的图相关普遍偏高。G 在图映导出里只有 0.754 是因为被 F 盖住了一角,不是裁错了。单看这个数会以为 G 坏了。看到低相关我都会回去对一眼截图,不直接下结论。快速查看的 D 连框都没检测出来,那一项只有肉眼判断。
9.4 base64占比不等于图片字节占比
图映导出里图片占 99.7 %。这个数是 base64 文本占整个 HTML 字节的比例。base64 会把字节撑大一截。按解码后的原始字节算,7 张图共 7,230,540 B,占 HTML 的 74.8 %。两个口径差了一大截。单用例 D 是 89.6 %,烘焙版是 83.5 %。这两个也都是 base64 口径。拿这些数去估「转成网页以后会变大多少」,得先说清楚是哪个口径。我在 6.1 节的输出里写 base64 share,就是为了不跟原始字节混。
十、还有哪几件事没有验证
最想补的是一份 Word 真存出来的带裁剪的 docx。有了它「Word 默认留着被裁部分」才能从推论变成实测。烘焙前后的体积账也才有真实的分母。其次是 effectExtent,样本里的值是我按规范算的。Word 自己写的值和我算的一不一样我没确认,docx-preview 和图映到底读没读它我也没确认。还有旋转那一层的取舍。四角空白怎么填、JPEG 要不要为了旋转多编一代,我还没想好。先这么留着。最后是 WPS、LibreOffice 和 pandoc 这三样。本机条件不够,也先空着。
手上有收 docx 的流程的话,可以先拿一张只裁了下边的截图过一遍。转完先看图有没有往上挪、盖住上面那行字。再把导出里的图片解出来对一下尺寸是不是还和原图一样大。两样都过了我才会把它放进流程。
参考资料
- ECMA-376 Office Open XML 第 1 部分:DrawingML 图片(
pic:blipFill、a:srcRect、a:xfrm)与 WordprocessingML 绘图(wp:inline、wp:extent、wp:effectExtent)的定义 - Microsoft Office 支持页《Reduce the file size of your pictures in Microsoft Office》macOS 部分:Delete cropped areas of pictures 选项(2026-09-30 读取)
- mammoth.js 1.13.0 README:
convertImage选项说明 - docx-preview 0.4.1 项目主页与源码
- CSS Masking Module Level 1:
clip-path与rect() - CSS Transforms Module Level 1:
transform-origin初始值为 50% 50% - Chromium 平台状态:
object-view-box - Wikimedia Commons:File:Dülmen, Kirchspiel, Oedlerteich -- 2017 -- 6000.jpg,作者 Dietmar Rabich,CC BY-SA 4.0