5.4k stars 的轻量克隆模型,现在导入 AIGCPanel 点一下就能出声。
想在自己电脑上克隆一段声音,过去第一反应是先查查显卡够不够 8G。GitHub 上 5.4k stars 的 LuxTTS 把门槛砍到了 1GB:基于 ZipVoice 蒸馏到 4 步,速度冲到单卡 150 倍实时,输出还是大多数 TTS 模型给不了的 48kHz。这样的模型,差的只剩一个点开就用的入口。 顺带说下 AIGCPanel:一款开源的本地 AI 数字人桌面应用,这类模型它已经收了一列表。
⚡ 快得不像本地模型
1 分钟的音频,不到 1 秒就合成完,这是 LuxTTS 官方给出的 150 倍实时速度。没有独显也别急着走,它自带 int8 ONNX 版本,纯 CPU 也能跑出实时以上的速度;CUDA 下显存占用 1GB 以内,随便哪张本地显卡都装得下。底座是 k2-fsa 的 ZipVoice(123M 参数、flow matching 架构),LuxTTS 在它基础上蒸馏到 4 步采样,步数砍了,质量没塌。
🎙️ 48kHz,耳朵收货的那部分
大部分开源 TTS 停在 24kHz 输出,听着总有一层塑料感;LuxTTS 换上自定义 48kHz vocoder,高低频交叉融合,人声的齿音和气息都留住了。克隆门槛同样低:扔一段 3~10 秒的参考音频,whisper 自动听写文本,零样本出同款音色。官方 README 的说法是,克隆效果能跟规模大 10 倍的模型打平。不着急装,HuggingFace 在线试玩 先过耳朵。当 48k 的清晰度和 1GB 的显存要求同时出现,挑剔就显得有点不识好歹。
🖥️ 进 AIGCPanel,命令行可以关掉了
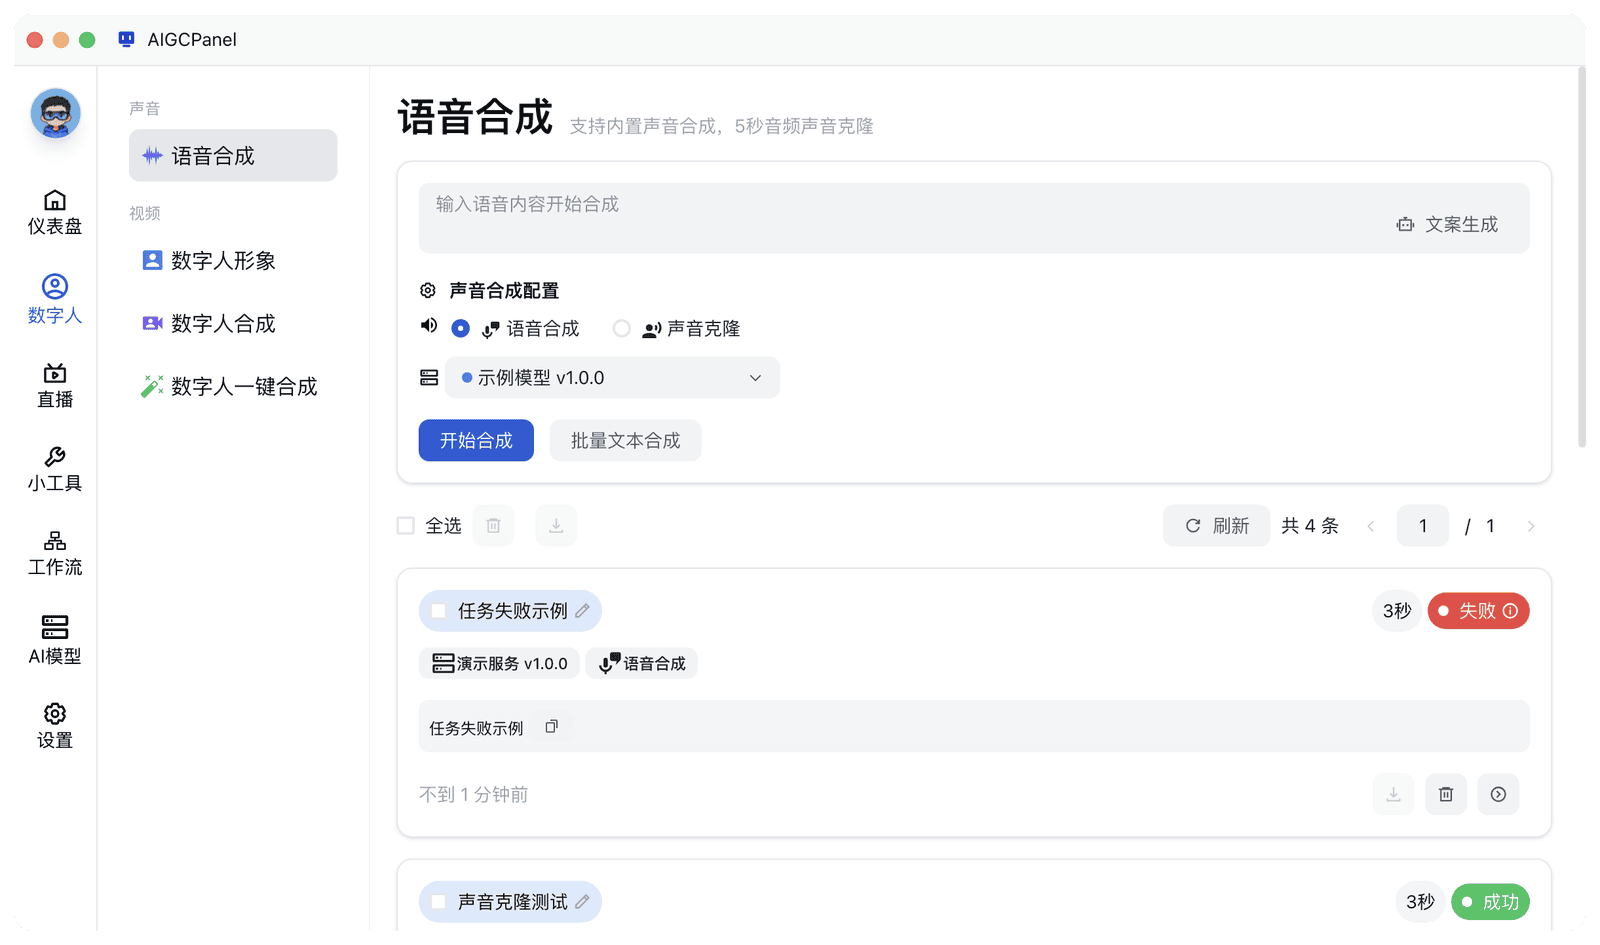
模型好用,部署难搞,这是本地模型劝退人的老问题。AIGCPanel 把 LuxTTS 打成了一键运行包:官网下载 导入模型页,声音合成、声音克隆两个入口直接打开,采样步数、T-Shift、语速、随机种子全是表单填空。设备也不用你操心:有 CUDA 用 CUDA,苹果芯片走 MPS,啥都没有自动切 CPU 的 ONNX,长文本自动分段再拼接,全程不碰一行命令。
🛠️ 不止一个声音模型
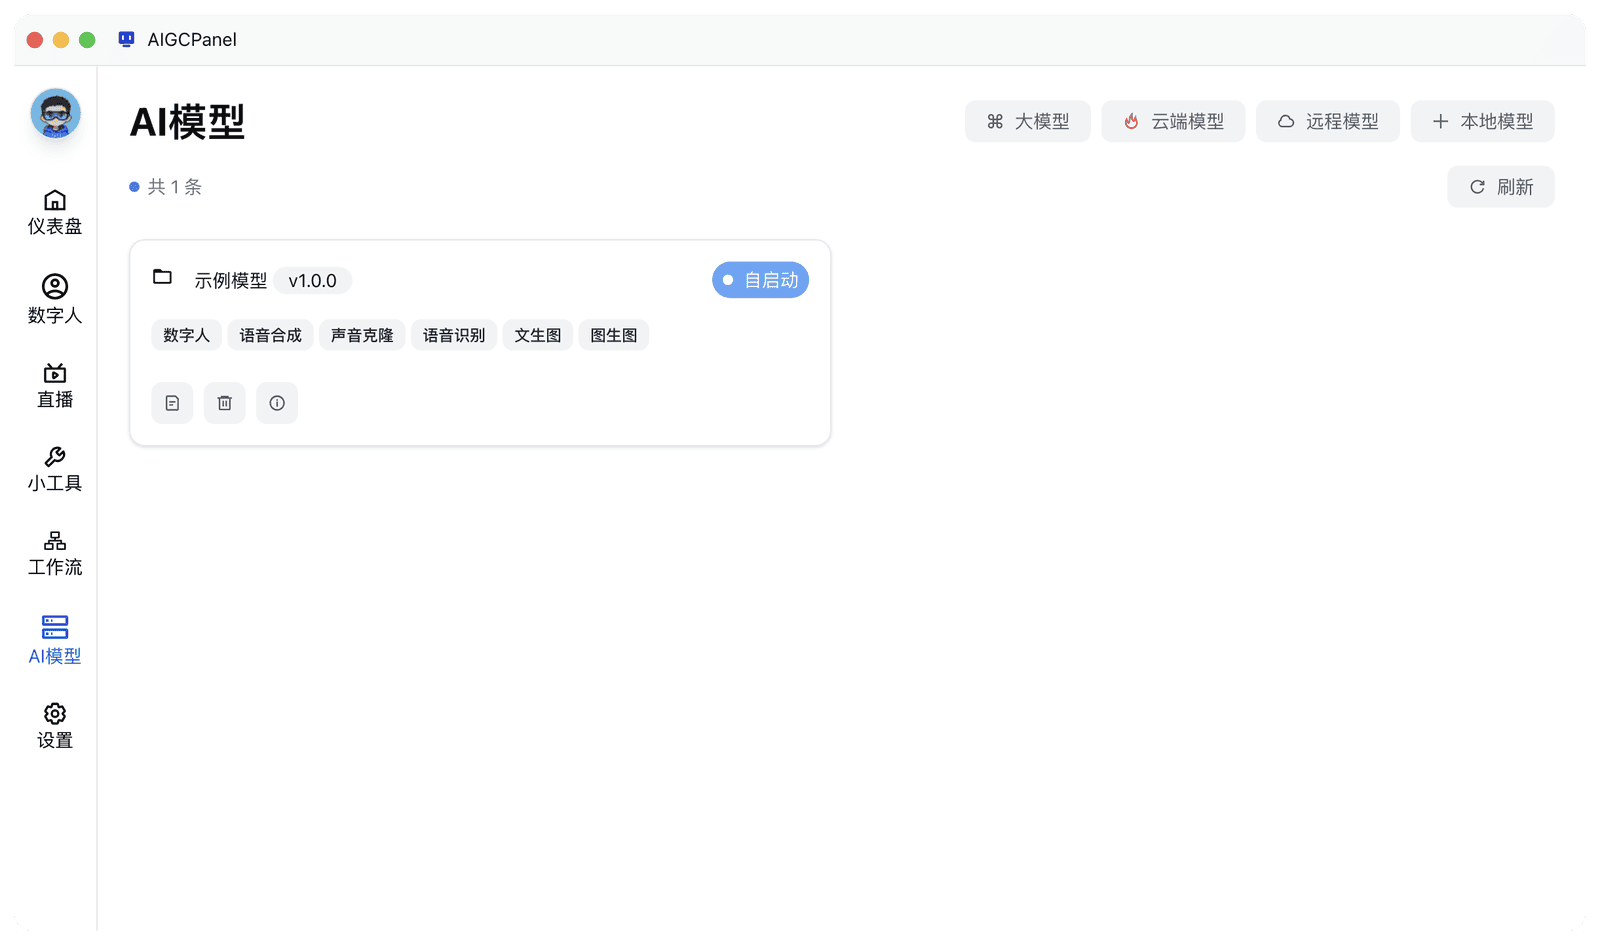
AIGCPanel 本身是个一站式 AI 数字人桌面应用:声音合成与克隆之外,自带独立的声音识别、数字人视频换口型、25+ 个音视频处理工具箱,以及把它们串起来的可视化工作流。LuxTTS 只是模型列表里新加的那一个。
其他要点:
- Apache-2.0 开源,中英文双语支持
- 社区已有 Gradio、ComfyUI 节点、ONNX、FalAI 托管等多种玩法
- HuggingFace 上 38 个 Space 在用它,月下载近 6,000 次
没显卡照样出声,有显卡更快,你那张吃灰的显卡也终于有活干了。 最想先克隆谁的声音?你自己的、家里老人的叮嘱,还是已获授权的音色?评论区聊聊,记得只克隆自己或已获授权的声音,说不定下一期就出教程。