09 · full-GPU decode:单 token 全设备
一句话 :decode 一个 token 只付一次 H2D(embedding)+ 一次 D2H(logits) ,中间所有层、所有中间量都留在设备上------把「每层一次宿主↔设备往返」换成「整条链路一次往返」。 前置 :建议先读 第 08 篇 · MoE 专家权重显存驻留(本篇要用到它的专家内核)。 环境:x86-64 + NVIDIA RTX 5090(sm_120)· 阶段三 30B-A3B MoE(Qwen3-30B-A3B q4:128 专家 / top-8 / dim=2048 / moe_ffn=768 / 48 层)。
一、问题与结论
| 指标 | GPU full-decode | CPU | 判定 | 标注 |
|---|---|---|---|---|
decode(30B-A3B q4,--stream-n 64) |
52.0 tok/s(19 ms/tok) | 15.0 tok/s(66 ms/tok) | 约 3.5× | 实测 |
| 每 token 的传输 | 1 次 H2D(embedding)+ 1 次 D2H(logits) | --- | 设计目标 | 实测 |
二、背景:为什么要全设备
通用 offload 路径是「每层一次往返」:宿主算好激活 → 传上去 → GEMM → 传回来 → 下一个算子。decode 时每层有好几次这样的往返,而且每次都有宿主↔设备同步。
full-decode 换了一个思路:隐藏态、QKV、FFN 中间量、K/V 镜像全部常驻显存,一个 token 的整条链路在设备上跑完。宿主只做两件事:喂 token embedding、取 logits。
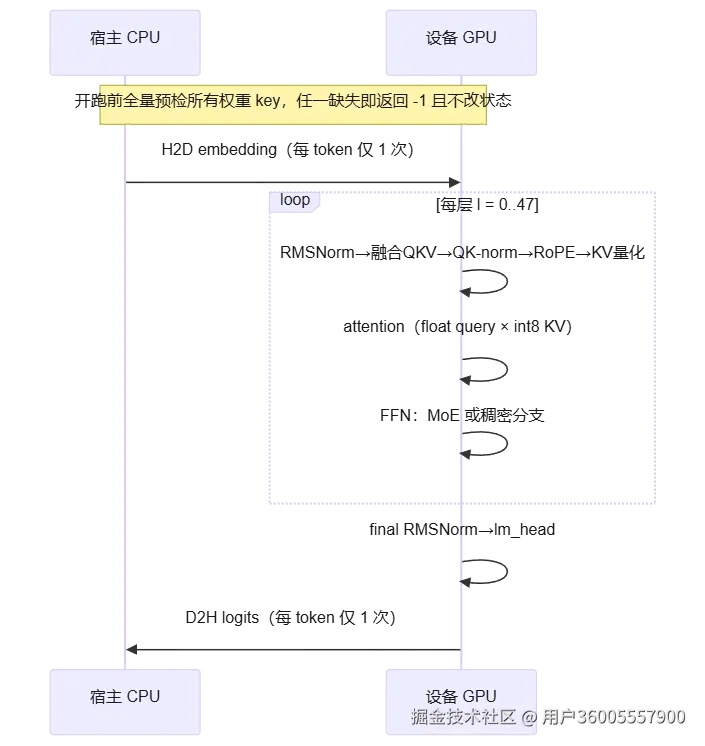
图 1 :full-decode 的宿主↔设备往返。一个 token 只付一次 H2D(embedding)+ 一次 D2H(logits) ,48 层的注意力与 FFN(MoE 分支:s16 量化→router→gate/up→down)全在设备上跑完;对比通用 offload 路径的「每层多次往返 + 每层同步」,这就是 52.0 tok/s(19 ms/tok)≈ 3.5× 的来源。开跑前做 hit-only 全量预检,任一权重缺失即整体返回 -1、回落 CPU decode 循环。
实测(30B-A3B q4,--stream-n 64):
| GPU full-decode | CPU | |
|---|---|---|
| decode | 52.0 tok/s(19 ms/tok) | 15.0 tok/s(66 ms/tok) |
约 3.5×。
三、核心机制
3.1 驻留了什么
vcuda_dev_decode_init() 一次分配全部设备缓冲:
c
/* 文件:src/npu/cuda/vllm_cuda_kernels.cu(vcuda_dev_decode_init,节选) */
if (cudaMalloc((void **)&s->d_x, (size_t)dim * 4) != cudaSuccess ||
    cudaMalloc((void **)&s->d_normed, (size_t)dim * 4) != cudaSuccess ||
    cudaMalloc((void **)&s->d_res, (size_t)dim * 4) != cudaSuccess ||
    cudaMalloc((void **)&s->d_qkv, (size_t)qkv_n * 4) != cudaSuccess ||
    cudaMalloc((void **)&s->d_attn_out, (size_t)nh * hd * 4) != cudaSuccess ||
    cudaMalloc((void **)&s->d_gu, (size_t)ff * 8) != cudaSuccess ||
    cudaMalloc((void **)&s->d_act, (size_t)ff * 4) != cudaSuccess ||
    cudaMalloc((void **)&s->d_logits, (size_t)vocab * 4) != cudaSuccess ||
    cudaMalloc((void **)&s->d_asc, (size_t)(aq_n / G) * 4) != cudaSuccess ||
    cudaMalloc((void **)&s->d_aq, (size_t)aq_n * 2) != cudaSuccess ||
    cudaMalloc((void **)&s->d_attn_norm, (size_t)nl * dim * 4) != cudaSuccess ||
    cudaMalloc((void **)&s->d_ffn_norm, (size_t)nl * dim * 4) != cudaSuccess ||
    cudaMalloc((void **)&s->d_final_norm, (size_t)dim * 4) != cudaSuccess ||
    (q_norm && cudaMalloc((void **)&s->d_qnorm, (size_t)nl * hd * 4) != cudaSuccess) ||
    (k_norm && cudaMalloc((void **)&s->d_knorm, (size_t)nl * hd * 4) != cudaSuccess)) {
    cudaGetLastError();
    vc_decode_free(s);
    return -1;
}| 缓冲 | 形状 | 用途 |
|---|---|---|
d_x / d_normed / d_res |
[dim] |
隐藏态、归一化、残差 |
d_qkv |
[nh·hd + 2·nkv·hd] |
融合 QKV 输出 |
d_attn_out |
[nh·hd] |
注意力输出 |
d_gu / d_act |
[2·ff] / [ff] |
稠密分支 gate+up、swiglu |
d_logits |
[vocab] |
最终 logits |
d_aq / d_asc |
s16 激活 + scale | MoE 激活 |
d_attn_norm / d_ffn_norm / d_final_norm |
[nl·dim] |
三种 RMSNorm 权重(f32,不进权重缓存) |
d_qnorm / d_knorm |
[nl·hd] |
可选 Q/K per-head norm |
d_freqs |
[hd/2] |
RoPE 频率表 |
| MoE 专家缓冲 | 见 第 08 篇 | gate/up/down q4 + router |
3.2 单 token 的层循环
vc_decode_body() 的结构(graph 与非 graph 两条路径共用同一段循环体,差别只在提交方式):
scss
H2D embedding
for l in 0..nl-1:
    # ---- 注意力 ----
    k_copy(d_res ← d_x)                       # 存残差
    k_rms_norm(d_normed ← d_x, attn_norm[l])
    vc_gemm_fused_dev(QKV)                    # 融合 QKV,float 激活
    k_qk_norm(Q/K per-head)                   # 可选(Qwen3-VL)
    k_rope(q, k, pos)
    k_kv_quantize(→ d_k/d_v 镜像 + scale)
    k_attn_decode_f32q                        # f32 query + int8 KV
    vc_gemm_dev(O)                            # float 激活
    k_add(d_x ← d_res + d_normed)             # 注意力残差
    # ---- FFN ----
    k_copy(d_res ← d_x)
    k_rms_norm(d_normed ← d_x, ffn_norm[l])
    if is_moe:
        k_quantize_blocks_s16(d_normed → d_aq)      # 激活量化一次,全专家共享
        k_moe_router(router → sel/pr)
        k_moe_gate_up(gate/up → av)
        k_quantize_blocks_s16(av → avq)
        k_moe_down(down → y, 加权聚合)
        k_add(d_x ← d_res + y)
    else:
        vc_gemm_fused_dev(GU); k_swiglu; vc_gemm_dev(DOWN); k_add
k_rms_norm(d_normed ← d_x, final_norm)
vc_gemm_dev(lm_head → d_logits)
D2H logits
对应的真实发射序列(MoE 分支):
c
/* 文件:src/npu/cuda/vllm_cuda_kernels.cu(vc_decode_body 的 FFN 段,节选) */
/* quantize the FFN input once (shared by every expert's gate/up) */
k_quantize_blocks_s16<<<dim3(d / G, 1), 1, 0, stream>>>(s->d_normed, s->d_aq, s->d_asc,
                                             1, d, G);
/* router -> top-k -> softmax */
k_moe_router_gemm<<<(unsigned)(ne >> 2), DC_BLK, 0, stream>>>(
    s->d_moe_router + r_loff, s->d_normed, s->d_moe_logits, ne, d);
k_moe_router_topk<<<1, 1, 0, stream>>>(s->d_moe_logits, s->d_moe_sel, s->d_moe_pr, ne, tk);
/* gate/up -> av = silu(gate) * up */
k_moe_gate_up<<<dim3((unsigned)ge4, (unsigned)tk), DC_BLK, 0, stream>>>(
    s->d_moe_gate + g_loff, s->d_moe_up + g_loff,
    s->d_aq, s->d_asc, s->d_moe_sel, s->d_moe_av,
    ne, ef, d, tk, nbG, ge4, ggB, moe_probe);
/* quantize av (per expert) */
k_quantize_blocks_s16<<<dim3(ef / G, tk), 1, 0, stream>>>(s->d_moe_av, s->d_moe_avq,
                                               s->d_moe_avd, tk, ef, G);
/* down -> y (weighted aggregate in expert order) */
k_moe_down<<<(unsigned)(d >> 2), DC_BLK, 0, stream>>>(
    s->d_moe_down + d_loff, s->d_moe_avq, s->d_moe_avd,
    s->d_moe_sel, s->d_moe_pr, s->d_moe_y,
    ne, ef, d, tk, cbe, gdB, moe_probe);
几条设计点:
- 激活量化一次共享 :MoE 的 FFN 输入只量化一次(
d_aq),top-k 所有专家的 gate/up 共用,省掉 k 次重复量化。 - 残差用
d_res承接 :k_copy存、k_add取,避免为每层单独开缓冲。 - 专家贡献按 j 序累加 :与 CPU 求和顺序一致(见 第 08 篇)。
3.3 hit-only 契约(重要)
vcuda_dev_decode_run() 是全有或全无 的:开跑前先把所有需要的权重 key 检查一遍,任何一个缺失就返回 -1,且不改变任何状态:
c
/* 文件:src/npu/cuda/vllm_cuda_kernels.cu(vcuda_dev_decode_run 的预检,节选) */
const int is_moe = s->dc_is_moe;
const int nl = s->dc_nl;
if (is_moe && s->dc_G != 32) return -1;   /* MoE expert tiles are 32-col grouped */
for (int l = 0; l < nl; l++) {
    if (!vc_ent_find(s, vc_wkey(l, VC_FUSED_QKV)) ||
        !vc_ent_find(s, vc_wkey(l, VC_PROJ_O)))
        return -1;
    if (!is_moe &&
        (!vc_ent_find(s, vc_wkey(l, VC_FUSED_GU)) ||
         !vc_ent_find(s, vc_wkey(l, VC_PROJ_DOWN))))
        return -1;
}
if (!vc_ent_find(s, vc_wkey(VC_LMHEAD_LAYER, VC_PROJ_LMHEAD)))
    return -1;
为什么这个契约重要:调用方(引擎)在拿到 -1 时会回落 CPU decode 循环 。如果 decode_run 跑了一半才失败,K/V 镜像就被写脏了,CPU 回落的起点不对 → 静默错。全有或全无把这个问题消灭在源头。
MoE 分支还有个细节:专家权重在专用 q4 缓冲里,不在 int8 权重缓存,所以 GU/DOWN 的缓存项不要求存在 (is_moe 时跳过检查)。
3.4 为什么 attention 用 float query
有两个 query 版本的 attention:
| 内核 | query | 说明 |
|---|---|---|
k_attn_decode_q8 |
int8(每 32 块量化) | 快,但多一层量化误差 |
k_attn_decode_f32q |
float | 与 CPU int8-KV 路径同口径 |
量化的选择不是「能省就省」:
int8 query 的量化误差约 0.7%。它不会在单层里显形,但在 48 层 30B 上会复利累积,最终把 greedy 的 argmax 推偏。所以 full-decode 用 float query。
float query 版的头部逻辑(GQA 映射 kh = h * nkv / nh、float query × int8-KV 的即时反量化):
c
/* 文件:src/npu/cuda/vllm_cuda_kernels.cu(k_attn_decode_f32q 的 Pass 1,节选) */
const int h = blockIdx.x;
const int seq_len = dyn[1] + 1;   /* n_attn = visible tokens */
const int kh = (h * nkv) / nh;
const int8_t *kb = k + (size_t)kh * hd;
/* Pass 1: float-query scores + block max. */
for (int t = threadIdx.x; t < seq_len; t += blockDim.x) {
    const int8_t *kt = kb + (size_t)t * kv_dim;
    const float kss = ks[(size_t)t * nkv + kh] * (1.0f / 127.0f);
    float s = 0.0f;
    for (int i = 0; i < hd; i++) s += qt[i] * (float)kt[i];
    s = s * kss * scale;
    scores[t] = s;
    if (s > lm) lm = s;
}两者都做「int8 存 K/V + f32 scale 即时反量化 」:K/V 镜像用 int8 存(带宽减半),内核里读 int8 乘 scale 还原------与 CPU 的 flash_attn_single_q_q8_neon 同口径。
attention 的线程组织是一格 block = 一个 query head ,VCUDA_ATT_T=256 线程,三次 pass(打分+块内 max → exp+求和 → 加权 V 求和),动态共享内存放 scores[seq_len]。GQA 的映射是 kh = h * nkv / nh。
3.5 KV 镜像
设备侧 K/V 是扁平 [nl][max_seq][kv_dim] int8 + [nl][max_seq][nkv] f32 scale,每层每 token 追加一行(k_kv_quantize 写 d_k/d_v/d_ks/d_vs)。这个镜像被两条路径共享:VLLM_CUDA_ATTN(只加速 attention)与 VLLM_CUDA_DECODE(full decode)。
四、实测数据
| 口径 | 数值 | 判定 | 标注 |
|---|---|---|---|
GPU full-decode(30B-A3B q4,--stream-n 64) |
52.0 tok/s(19 ms/tok) | 约 3.5× | 实测 |
| CPU(同口径) | 15.0 tok/s(66 ms/tok) | 基线 | 实测 |
| 每 token 传输 | 1 次 H2D + 1 次 D2H | 达成设计目标 | 实测 |
五、边界与已知限制
- 口径是
--stream-n 64:这是 64-token decode 的 tok/s 精确值;log 里的ms/tok为取整展示,加速比一律用 tok/s 算。 - hit-only:所有需要的权重必须先驻留,任何一项缺失就整体返回 -1、回落 CPU------没有「部分 GPU」的中间态。
- MoE 要求 32 列分组 :
is_moe && G != 32直接判拒。 - 设备镜像与 CPU 的数值一致性 只在前 16 token 的 greedy 上验证(见 第 10 篇);整模型的统计口径见 第 11 篇。
- 这里的 3.5× 是阶段三 full-decode 的基线 值,后续四连击优化见 第 15 篇。
CPU 对照(迁移前基线)
- CPU 参考 :
kestrel-llm/src/model/vllm_safetensors.c(函数flash_attn_single_q_q8_neon)------ CPU 侧 attention 用 int8 KV + f32 scale 即时反量化。 - 迁移要点:CPU 侧每层在宿主内存里算、逐层与设备往返 → CUDA 侧把往返从「每层一次」压到「每 token 一次 H2D + 一次 D2H」,hidden/QKV/FFN/KV 镜像全驻留;attention 用 float query(int8 query ~0.7% 误差在 48 层复利会破 greedy);hit-only 预检保证回退起点干净。
- 真机验证 :未独立复现:需 30B-A3B q4 +
--stream-n 64的 tok/s 与传输计数。
六、小结(可复用结论)
- 把往返次数从「每层」压到「每 token」:隐藏态、QKV、FFN 中间量、KV 镜像全部常驻显存,宿主只负责喂 embedding、取 logits,收益来自消除逐层同步。
- 共享中间量:FFN 输入只量化一次,top-k 所有专家共用,省掉 k 次重复量化。
- 残差用一块缓冲承接 :
k_copy存、k_add取,不用为每层单独开缓冲。 - 全有或全无的预检:失败即回落 CPU,绝不在设备上留下半成品状态------否则 CPU 回落起点被污染,出静默错。
- 精度不能满足于「能省就省」:query 用 float、KV 用 int8,是因为 int8 query 的 ~0.7% 误差会在 48 层上复利破 greedy。
七、本环境的跑法
powershell
# prefill 走 CPU(隔离 decode 路径),只让解码上 GPU
$env:VLLM_CUDA_DECODE="1"
$env:VLLM_CUDA_INFER="1"
$env:VLLM_CUDA_FORCE_CPU="1"
.\build-x64\vllm_kestrel_x64.exe --cuda --model <模型目录> --stream-test --stream-ctx 0 --stream-n 64
VLLM_CUDA_FORCE_CPU=1 在这里的用途是隔离 ------让 prefill 完全走 CPU,这样 decode 的实测与对拍不被 prefill offload 的任何变量干扰(第 10 篇正是靠这个搭配找出 bug 的)。
下一篇是这轮迁移里最值钱的一篇:一个指针越界,把上面所有努力都打回原形。
相关篇目:第 08 篇 · MoE 专家权重显存驻留、第 10 篇 · 一个指针越界引发的血案、第 15 篇 · decode 优化四连击 源码与配套资源:本仓库 gitee.com/pei-xiaogua...; CPU 推理源码 gitee.com/pei-xiaogua...