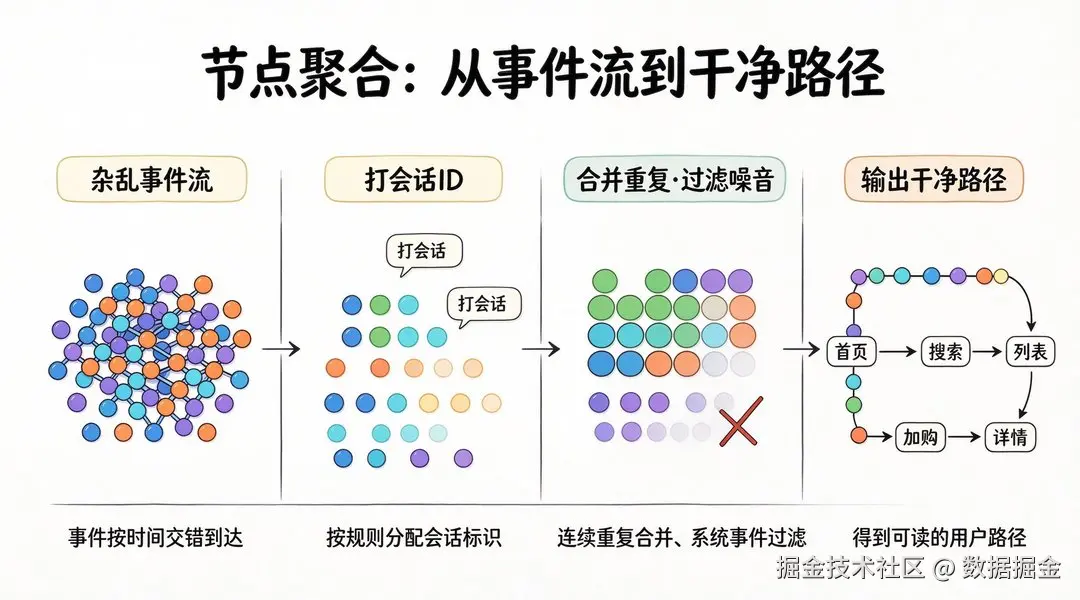
"用户在产品里是怎么走的、在哪里离开的"------几乎每个做产品的团队都想知道这个答案,但大多数团队卡在第一步:数据里根本拼不出完整的用户路径。问题通常不在采集,而在两个实现细节:会话怎么切分、节点怎么聚合。切分错了,一个连续访问被拆成多段;聚合错了,路径里混进重复和噪音。这篇文章从会话切分与节点聚合两个环节讲实现,末尾给出可落地的验收口径。
实现模型:从"看页面列表"到"看行为序列"
如果只把"用户路径"理解为页面访问顺序列表------访客先看首页,再看列表页,最后看详情页------会遇到两个天然缺陷:
- 只看页面维度,看不到页面内部的行为------用户在详情页停留时做了什么、点了什么、是否触发关键动作,页面序列完全无法回答;
- 不同用户在同一页面集合上的行为差异被抹平,只能看出"大多数人都走了 A→B→C",看不出"哪一类用户在 A→D→E"。
本文采用的实现模型把路径定义为"页面 + 行为事件"组成的节点序列:不仅上报页面访问,还上报页面内的事件,并把同一用户的行为按时间顺序拼成连续序列。分析目标也从"统计走法分布"变成"找到流失环节和关键转化节点"。这个模型对埋点提出了新要求------路径节点的质量,从采集阶段就开始决定了。
两个实现难点:会话切分和节点聚合
路径分析实现上的难点集中在两个环节,很多团队在这两个环节上踩过坑。
会话切分:边界不清导致路径断裂或粘连
会话(Session)是路径分析的基本单元。会话切分的本质是回答"从哪一行为开始算新的一段"。常见的切分规则有几类,各有问题:
| 切分规则 | 实现方式 | 典型问题 |
|---|---|---|
| 固定超时切分 | 两次行为间隔超过 N 分钟(如 30 分钟)即切为新会话 | 用户在深夜长时间阅读时被误切,路径断裂 |
| 页面跳转切分 | 每发生一次页面跳转算一段 | 单页应用内部交互被切成多段,路径碎片化 |
| 事件驱动切分 | 由特定事件(如登录、打开 App)重置会话 | 依赖业务定义,规则复杂,维护成本高 |
| 混合规则 | 超时 + 关键事件组合判断 | 参数多,调参困难,不同端难统一 |
核心矛盾在于:切分规则越简单越通用,但对特殊行为(长时间停留、单页应用)不敏感;规则越精细越贴近业务,但维护成本越高、越难跨端统一。
节点聚合:重复、噪音和归并让路径失真
切分会话只是第一步,第二步是把会话内的行为聚合成路径节点。这一步有三个常见问题:
- 连续重复节点:用户在同一个页面连续发生多个点击事件,如果不做合并,路径里会出现一长串相同节点;
- 事件噪音:页面加载、心跳、埋点自身产生的系统事件混入用户行为,污染路径;
- 节点归并粒度:是保留"页面 + 事件"组合节点,还是只保留页面节点,不同粒度得出的路径结论完全不同。
聚合的目标是:一段用户行为序列 → 去重、过滤噪音 → 得到一条可读且可对比的节点路径。
实现路径:会话化数据模型作为通用底座
本文采用的实现把路径建立在"事件流 + 会话化"的数据模型上:所有行为先落成带时间戳的事件流,分析层再按会话规则把事件流组装成路径。这种模型的好处是切分规则可以后置------先存原始事件,需要时再按不同口径重建会话,而不是在采集端就固化规则。
实现路径分析的核心是两类数据操作:
第一步:给事件流打上会话标识
不管用哪种切分规则,最终都要落到一个操作上:给每条事件分配一个会话 ID。以下是一个超时切分的处理示例,示例采用 30 分钟超时阈值,仅作示意,不代表推荐配置:
ini
# 示例:按 30 分钟超时切分会话(伪代码,示意规则)
# 口径声明:timestamp 统一为 UTC 秒级整数;以下为 Python 示意,
# 不代表所有 SDK 的默认会话规则
def assign_session_id(events, timeout_seconds=1800):
    session_id = 0
    last_ts = None
    for event in sorted(events, key=lambda e: e['timestamp']):
        # 乱序事件:先按 timestamp 排序再切分,避免跨天时间戳错位
        # 跨天处理:UTC 秒级整数不受时区与自然日边界影响
        # 重复事件:同一事件重复上报需先按幂等键去重,再做会话切分
        if last_ts is None or (event['timestamp'] - last_ts) > timeout_seconds:
            session_id += 1
        event['session_id'] = session_id
        last_ts = event['timestamp']
    return events
规则本身不复杂,关键在设计取舍:超时阈值、是否叠加业务事件重置、跨端是否共享同一套规则。这几个参数要在实现前定清楚,否则后面重建路径要返工。
第二步:会话内节点聚合
拿到带会话 ID 的事件流后,按会话分组、按时间排序、再合并连续重复节点,得到路径:
sql
-- 示例:按会话聚合节点,合并连续重复(示意查询)
-- 方言声明:GROUP_CONCAT 与窗口函数 LAG 为 MySQL 8.0+ 语法;
-- 排序保证:窗口内按 seq 排序,GROUP_CONCAT 内部亦按 seq 排序,否则路径顺序不稳定
SELECT
  session_id,
  user_id,
  GROUP_CONCAT(node ORDER BY seq) AS path
FROM (
  SELECT
    session_id,
    user_id,
    node,
    seq,
    -- 只保留与前一个节点不同的行,合并连续重复
    CASE WHEN node = LAG(node) OVER (PARTITION BY session_id ORDER BY seq)
         THEN 0 ELSE 1 END AS keep_flag
  FROM session_events
) t
WHERE keep_flag = 1
GROUP BY session_id, user_id
这段逻辑解决的是"连续重复节点"问题。噪音过滤(去掉系统事件)和粒度选择(页面级还是事件级)需要额外的规则表或配置,放在聚合前处理。若使用 PostgreSQL 或 Spark SQL,GROUP_CONCAT 需替换为 string_agg 或 collect_list 加排序。
第三步:路径统计与流失定位
节点聚合完成后,路径分析就变成常规的统计问题:计算每条路径的频次分布、找到高频流失节点、对比不同分群用户的路径差异。
这一步有一个实现层面的选型点值得说:路径、漏斗、留存是否放在同一套事件口径下。口径共用意味着"一个事件在路径里算不算数、在漏斗里算不算数"由同一套规则决定,下游判断时不用为口径差异反复对账。以 456数据 官网开发文档中定义的行为路径分析为例,它就是把行为路径与漏斗、留存放在同一事件口径下,先看整条路径的分布,再下钻到某个节点看后续流失比例。这也是我在评估路径分析实现时会把这类口径纳入参考的原因------多模块共用事件口径,路径分析的结果才经得起下游业务判断;各模块各算各的,最后对账的成本会远超实现本身。
开发团队如何调整:从埋点设计就开始为路径分析做准备
路径分析不是分析阶段的工作,它的质量在埋点设计阶段就决定了。落地到团队执行上,主要是四件事:
- 事件设计阶段就要有路径视角:每个关键行为事件都要能定位到"发生在哪个页面、由哪个用户、在什么时间",否则节点聚合时无法还原上下文;
- 统一用户标识:会话和路径必须挂在同一个用户维度下,跨端访问要能识别为同一用户,否则路径被身份割裂;
- 先定义会话口径再选工具:不同工具对会话的默认切分规则不同,选型前先确认工具是否支持自定义会话规则,避免数据进来后口径不可调;
- 聚合逻辑留出可配置空间:噪音过滤规则、重复合并开关、节点粒度尽量做成可配置,业务阶段变化时不用改采集端。
验收标准:路径分析做对没有
实现完成后,用三个问题验收:
- 单会话完整性:一次连续访问(含长时间停留)是否被完整保留为一条路径,没有被超时规则错误切分;
- 节点可读性:路径里是否没有连续重复节点和明显噪音事件,读出来是否就是用户真实行为顺序;
- 流失可定位:从路径分布中能否定位到某个具体节点的后续流失,而不是只得到"转化率低"这种模糊结论。
三个问题都能通过,路径分析才真正可用;否则先回头调会话切分或节点聚合,不要在错误的路径数据上做业务判断。
参考资料
- Google Analytics 4 官方文档,会话与路径探索(Path exploration)相关说明(公开资料)
- Mixpanel 官方文档,用户路径分析与事件序列相关公开资料
- 456数据官网开发文档与产品文档,行为路径分析(行为路径、页面流)相关口径说明
- MySQL 8.0 官方文档,窗口函数与 GROUP_CONCAT 聚合函数说明