一、为什么儿童故事阅读页需要自动注音
1.1 需求起点
起点是我家的小朋友正在学拼音,识字量还比较有限,而正是在这个年纪,小朋友对儿童故事有着最多的憧憬与热爱。
所以我希望在故事详情页给正文加上拼音------故事不但可以被听见,也可以被看见。小朋友在阅读的过程中能加深对拼音的理解,也能顺带扩大识字量。
1.2 两条实现路径
故事机里的故事基本都由 AI 生成,那么"给正文加拼音"就有两种做法:
- 在 AI 生成故事文本的同时,一并生成拼音注解并落库;
- 在故事详情页,根据故事正文实时自动生成拼音注解。
把两条路径摊开对比:
| 对比项 | 生成时生成并落库 | 展示时自动生成 |
| 数据一致性 | 正文修改后必须重新生成拼音,容易出现正文与拼音不同步 | 每次基于当前正文生成,天然保持一致 |
| 数据与接口复杂度 | 需要保存拼音或 Token 结构,并设计更新、迁移与版本管理 | 后端只保存原始正文,API 和数据模型更简单 |
| 存储与传输成本 | 拼音数据与正文高度重复,会增加数据库和接口响应体积 | 无须保存或传输完整拼音,仅在客户端临时生成 |
| 规则升级 | 升级词库或转换规则后,需要批量重建历史拼音数据 | 升级 pinyin-pro 后,所有故事自动使用新规则 |
| 故障隔离 | 拼音生成失败可能阻塞故事生成、保存或发布 | 拼音失败只影响辅助展示,不影响故事主体数据 |
1.3 我们的选择
在生成故事文本时同步生成拼音注解,准确性确实会更高,但也带来了更高的系统复杂度和维护成本。
对这套系统来说,拼音不是核心功能,而是锦上添花------没有必要付出更高的代价,去换取提升幅度有限的准确性。所以我们选择了第二条路:正文照旧只存原文,拼音在展示时按需生成。
二、方案选型:为什么是 pinyin-pro
前端拼音库我们用了 pinyin-pro,选它主要看三点:
一、同构,Web 和 Node 两端都能跑。 转换逻辑既可以在浏览器里执行,也方便在 Node 环境里做预处理、跑测试或生成离线数据,兼容性更好。
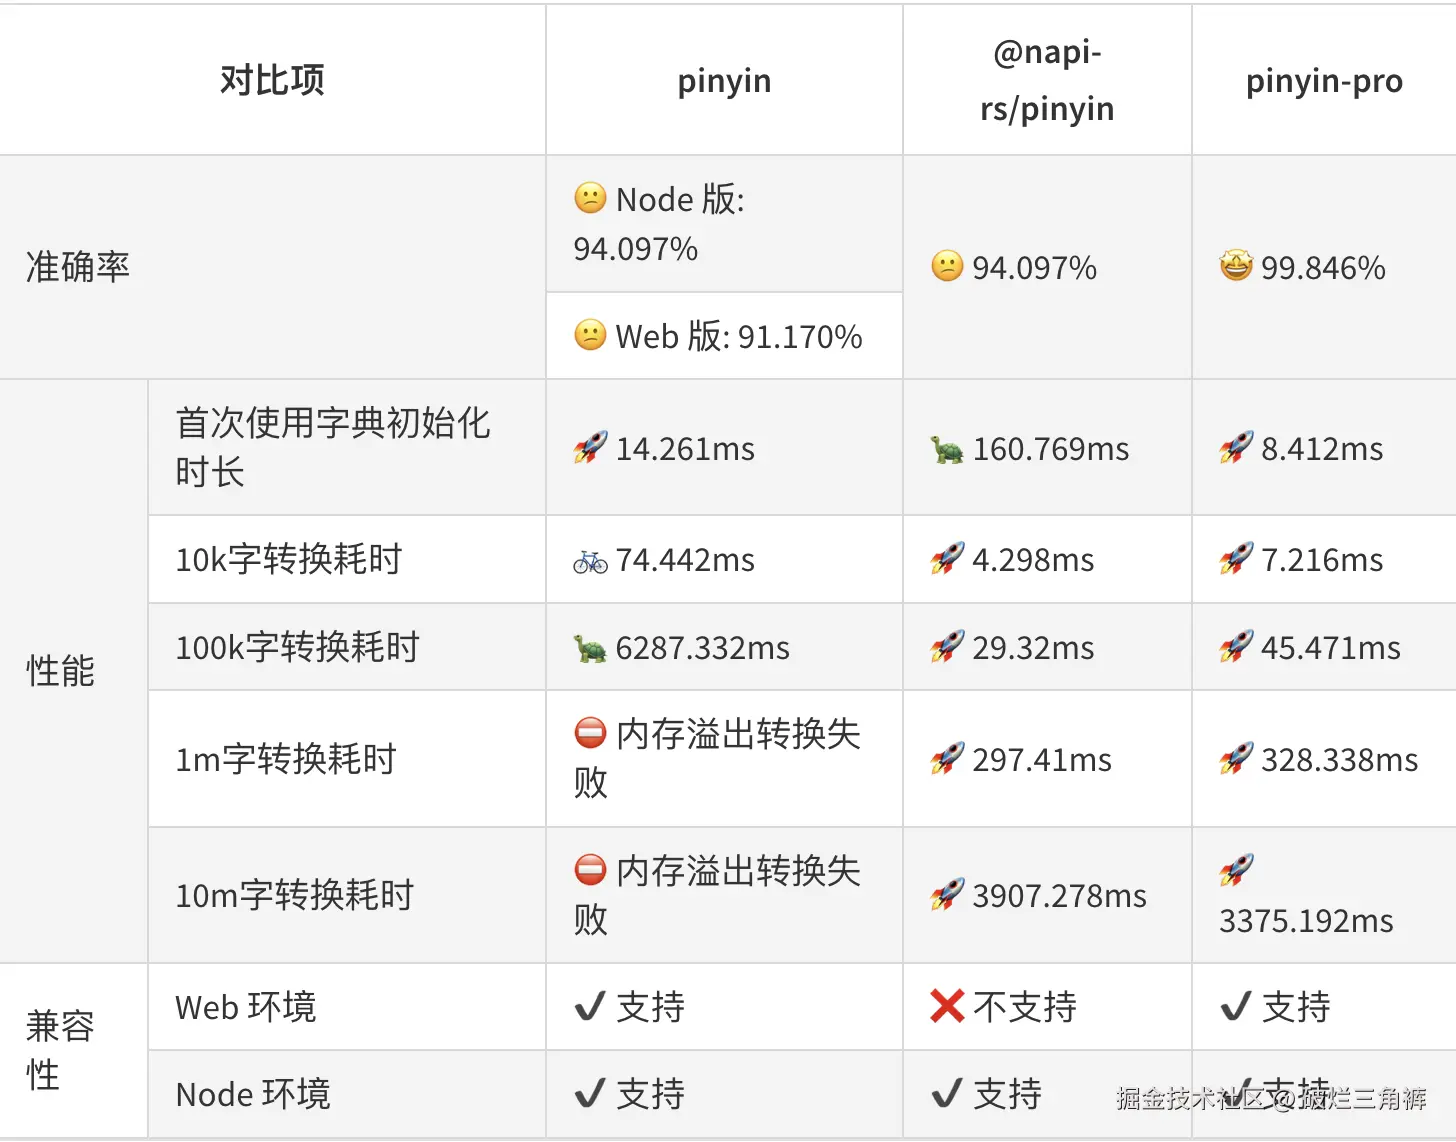
二、准确率够用。 官网标注的准确率是 99.846%。我觉得能达到这个程度的生成准确率已经不赖了------先跑起来再看,如果后续准确率确实带来业务困扰,再考虑下一步迭代优化。
三、性能完全不是瓶颈。 按官网的测算,10 万字转换耗时不过 45ms。照这个口径推算,我们一个故事文本的转换时间不到 10ms。当然不同设备会有差异,最终在我手头的 Mac M1 上实测也确实符合预期。
整体的链路很短:
flowchart LR A接口请求故事正文 --> Bpinyin-pro 生成拼音 Token B --> C按音频 Cue 分组 C --> DRuby 标签渲染
官方提供的准确率与性能数据如下:
三、在 Vue 3 中接入 pinyin-pro
项目里使用的是 pinyin-pro@3.29.3。
3.1 处理流程
从正文到可渲染的数据,一共六步:
- 将正文按换行划分为段落;
- 计算每个段落在原文中的起始位置;
- 调用 pinyin-pro 生成 Token;
- 保留汉字、标点、数字和英文;
- 根据音频 Cue 对 Token 进行分组;
- 返回适合模板渲染的数据结构。
3.2 核心实现
整个过程收敛在一个 computed 里:
js
// 按 Unicode 码点计数,而不是按 JS 的 UTF-16 长度
// 否则 emoji 和部分生僻字(代理对)会让偏移量整体错位
const codePointLength = (value) => Array.from(value).length

const paragraphs = computed(() => {
  const source = String(props.text)

  return Array.from(source.matchAll(/[^\r\n]+/g))
    .filter((match) => match[0].trim().length > 0)
    .map((match, paragraphIndex) => {
      // 段落在原文中的起始位置(按码点计算)
      const paragraphStart = codePointLength(source.slice(0, match.index))
      let tokenOffset = paragraphStart
      const segments = []

      pinyin(match[0], {
        type: 'all',
        toneType: 'symbol',
        toneSandhi: true,
      }).forEach((item, tokenIndex) => {
        const tokenStart = tokenOffset
        tokenOffset += codePointLength(item.origin)

        // 把当前字符映射回它所属的音频 Cue
        const cue = normalizedCues.value.find((candidate) => (
          tokenStart >= candidate.startOffset
          && tokenStart < candidate.endOffset
        ))
        const cueIndex = cue?.index ?? null

        const token = {
          key: `${paragraphIndex}-${tokenIndex}`,
          text: item.origin,
          pinyin: item.pinyin,
          isChinese: item.isZh,
        }

        // 同一个 Cue 内的 token 合并成一个 segment,便于逐句高亮
        const previousSegment = segments.at(-1)
        if (previousSegment?.cueIndex === cueIndex) {
          previousSegment.tokens.push(token)
        } else {
          segments.push({
            key: `${paragraphIndex}-${segments.length}`,
            cueIndex,
            tokens: [token],
          })
        }
      })

      return { key: paragraphIndex, segments }
    })
})
3.3 生成的数据结构
转换完成后,能得到逐字都带拼音的结构,并且按音频 Cue 切好了段:
json
[
  {
    "key": 0,
    "segments": [
      {
        "key": "0-0",
        "cueIndex": 0,
        "tokens": [
          { "key": "0-0", "text": "小", "pinyin": "xiǎo", "isChinese": true },
          { "key": "0-1", "text": "刺", "pinyin": "cì", "isChinese": true }
        ]
      }
    ]
  },
  {
    "key": 1,
    "segments": []
  }
]
3.4 关键参数与字段
传给 pinyin() 的三个参数:
| 参数 | 作用 |
| type: 'all' | 返回每个文本单元的详细信息,而不是拼接好的整串拼音 |
| toneType: 'symbol' | 输出 hǎo,而不是 hao3 |
| toneSandhi: true | 启用库提供的变调处理 |
实际用到的返回字段:
| 字段 | 含义 |
| origin | 原始字符 |
| pinyin | 转换后的拼音 |
| isZh | 是否被识别为汉字 |
3.5 为什么要"逐字"组织数据
拿到一整个拼音字符串显然更省事,但那样没法用。逐字组织数据结构是必须的,原因有四:
- 需要保留标点和英文------它们不该被附上拼音;
- 需要为每个汉字生成独立的 ruby 节点;
- 需要把字符重新映射回音频 Cue,才能做逐句高亮;
- 需要支持在运行时动态隐藏拼音。
四、用 Ruby 标签语义化展示拼音
要实现标准的汉语拼音标注效果,HTML 已经有现成的标签组合,不必自己造轮子------它就是 ruby。
4.1 模板实现
html
<template v-for="token in segment.tokens" :key="token.key">
  <ruby v-if="showPinyin && token.isChinese">
    <span>{{ token.text }}</span>
    <rp>(</rp><rt>{{ token.pinyin }}</rt><rp>)</rp>
  </ruby>
  <span v-else>{{ token.text }}</span>
</template>
核心是三个标签:
ruby:整个展示效果的核心,内容必须被它包裹才会渲染成注音格式;
rt:注解部分,也就是上方的拼音;
rp:官方提供的兜底标签。如果浏览器过旧、不认识ruby,就用rp里的内容做降级------比如"清晨"在低版本浏览器里会退化成清(qīng)晨(chén)这样的行内形式。
不过现在主流浏览器都已经支持 ruby 标签了,所以不做降级处理问题也不大。
至于非中文字符------数字、标点、字母------直接用 span 渲染,不参与注音。
4.2 关于 rp 里的括号
这里用的是全角括号 (),因为 rp 的内容只在降级场景下出现,全角在中文语境里更协调。
五、拼音排版与显示开关
5.1 拼音的位置与对齐
css
ruby {
  ruby-position: over;   /* 拼音显示在文字上方 */
  ruby-align: center;    /* 拼音相对汉字居中 */
}

rt {
  font-size: 0.48em;
  color: #6888a0;
}
两个属性的作用很直接:
ruby-position: over指定拼音的位置。over表示显示在文本上方,改成under就能让拼音落到文字下方;
ruby-align: center让拼音在汉字上方居中,更符合中文的阅读习惯。
拼音字号用的是 em 相对单位(0.48em),这样字号会跟着正文一起缩放,不用在多个断点里重复调整。
5.2 行高
显示拼音时需要给正文增加行高,否则拼音会和上一行贴到一起:
css
.pinyin-line {
  line-height: 2.75;
}
隐藏拼音后,再恢复更紧凑的排版:
css
.pinyin-text--plain .pinyin-line {
  line-height: 2;
}
5.3 显示开关
拼音的显示/隐藏由 showPinyin 这一个状态位控制:它同时影响模板里的 v-if(决定是否渲染 ruby)和最外层的类名(决定是否走 .pinyin-text--plain 的紧凑行高)。所以切一次开关,标签和排版会一起变化,不会出现"拼音没了但行高还空着"的尴尬。
六、自动注音还没有解决哪些问题
到这里,正文自动生成拼音的功能已经可用了。但还有几个问题需要持续迭代:
- 多音字。多音字的准确率还有待系统验证,但在不同的故事与语境里,一定存在判断错误的情况;
- 生僻字与异体字。一个词典类插件不可能收录所有汉字,这里同样存在出错的风险;
- 儿化音与轻声。纯文本场景理论上问题不大,但我这个场景还有对应的有声内容------一旦拼音标注和音频的实际发音不一致,就会出现"看到的"和"听到的"对不上的情况。
这三点里,我认为第三个最值得优先处理,因为它直接影响阅读体验的一致性。
七、小结
回顾整个实现,几个判断是值得记下来的:
- 能放到客户端算的,就不要塞进数据链路。拼音是辅助信息,放在展示层按需生成,正文数据模型一个字段都没动,规则升级也不用回刷历史数据。
- 选型先看"够不够用",而不是"够不够好" 。99.846% 的准确率不是满分,但对"锦上添花"的功能来说,边际收益已经很低了。
- 优先用平台原生能力 。
ruby是 HTML 自带的注音标签,语义正确、无障碍友好,比自己用span+ 绝对定位拼一个上去省事得多。
- 性能要先算再测。10 万字 45ms 是官网口径,我在 M1 上实测符合预期,才敢把这个方案定下来。