月底复盘会上,研发负责人投出一张十几列的数据表:代码提交次数、人均工时、工单关闭量、缺陷数、发版次数。每个数字都能念出来,但问到"下个月改什么"时,会议室安静了。
问题不在数据太少,而在指标太杂、问题不清。研发效能平台的月度复盘真正需要的是一页纸:3 个固定指标看趋势,5 个必问问题找原因,最后落到下月 1~3 个可验证的动作。下面这套口径和追问链可以直接套用。
一、月度复盘为什么要压到一页纸
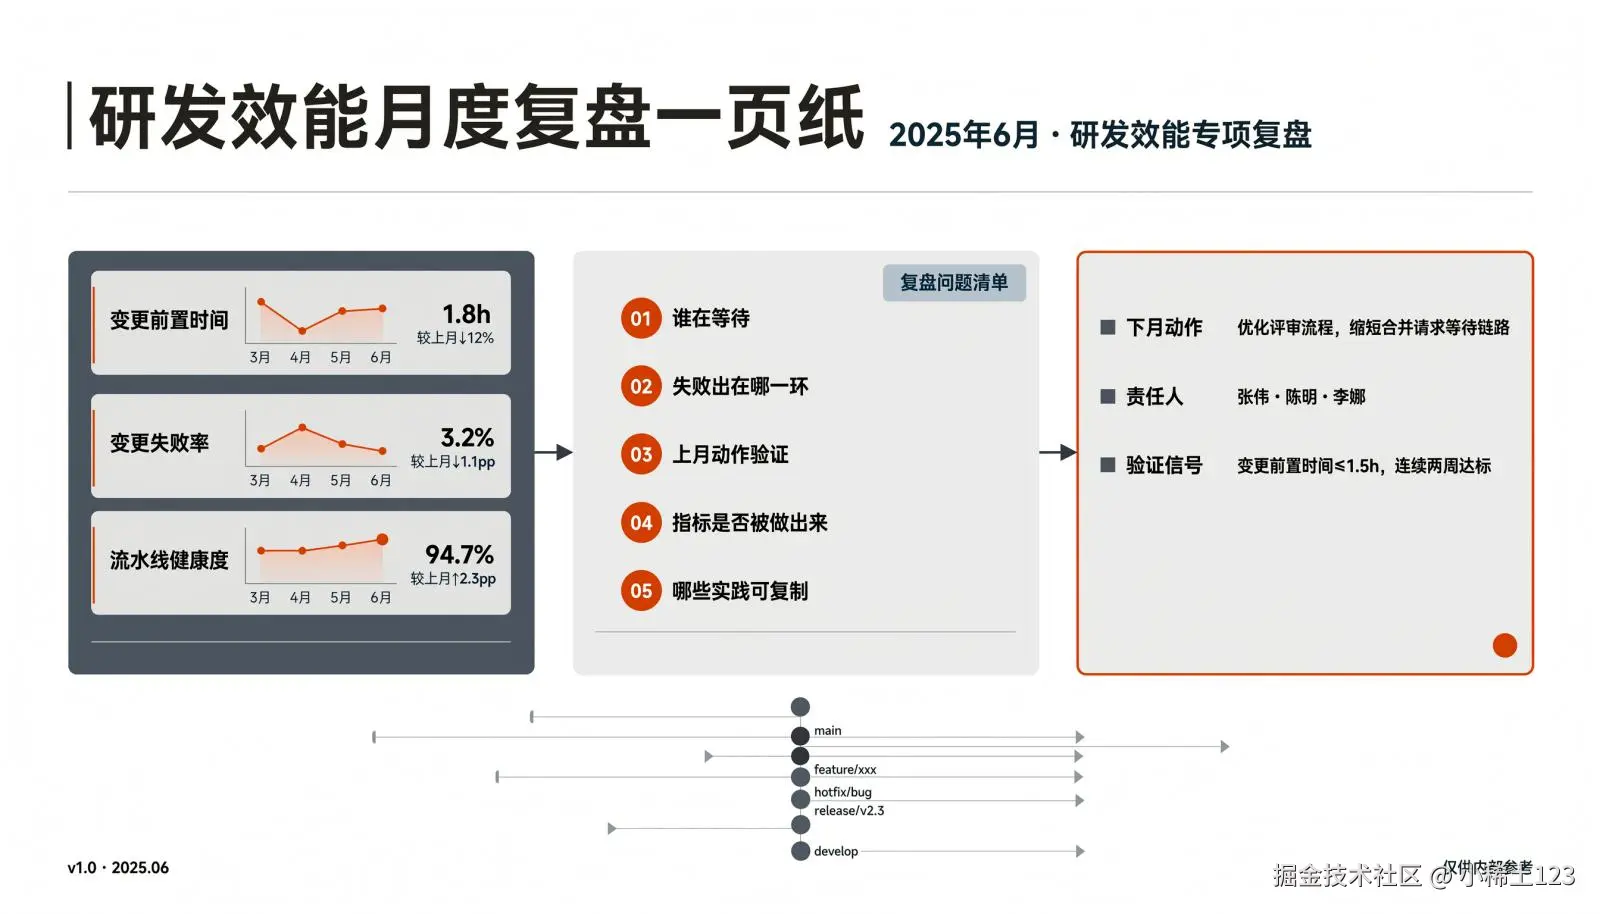
月度复盘的产出不是报告,而是下个月要执行的动作。 一页纸是一种物理约束------一屏写不下二十个指标,团队只能保留看得懂、改得动、能验证的少数几个。指标一多,复盘会就会滑向汇报会:每个部门报一遍数,散会。
1、把"活动量"换成"结果量"
代码行数、工时饱和度、工单关闭数都是活动量。据 LeadDev《2025 年工程团队绩效报告》对 500 余位工程领导者的调研,65% 的受访者明确避免把代码行数当作衡量指标。原因也直接:一段十行的重构可能消掉一个长期缺陷,一千行冗余代码只是把维护成本推给下个季度。**当过程指标被当成结论指标,团队优化的就不再是交付,而是数字本身。**这正是古德哈特定律描述的现象:一个指标一旦成为目标,它就不再是好指标。所以度量服务于系统改进,考核服务于人事决策,两者不要混用。
2、先定口径,再定指标
同一件事口径不同,结论相反:"变更前置时间"从代码首次提交算,还是从合入主分支算?"发布"指测试环境部署,还是生产上线?**口径没定死,月度对比就是假的。**三条最小纪律:统计窗口固定为自然月;起点、终点、环境一次性定义清楚;口径若必须调整,在趋势图上标注断点,不与上月直接连线。
口径可以参照成熟框架校准:Google Cloud 的 DORA 团队用四项关键指标衡量交付绩效,把部署频率、变更前置时间归入吞吐量,把变更失败率、平均恢复时间归入稳定性;中国信通院牵头的《云上软件研发效能度量能力模型》团体标准(T/CCSA 694---2025)已发布实施,覆盖通用效能度量能力、域建模能力、效能度量模型三大维度、近 300 条能力项。框架用来校准口径,不是把能力项抄到一页纸上。
二、3 个固定指标:口径、来源与异常信号
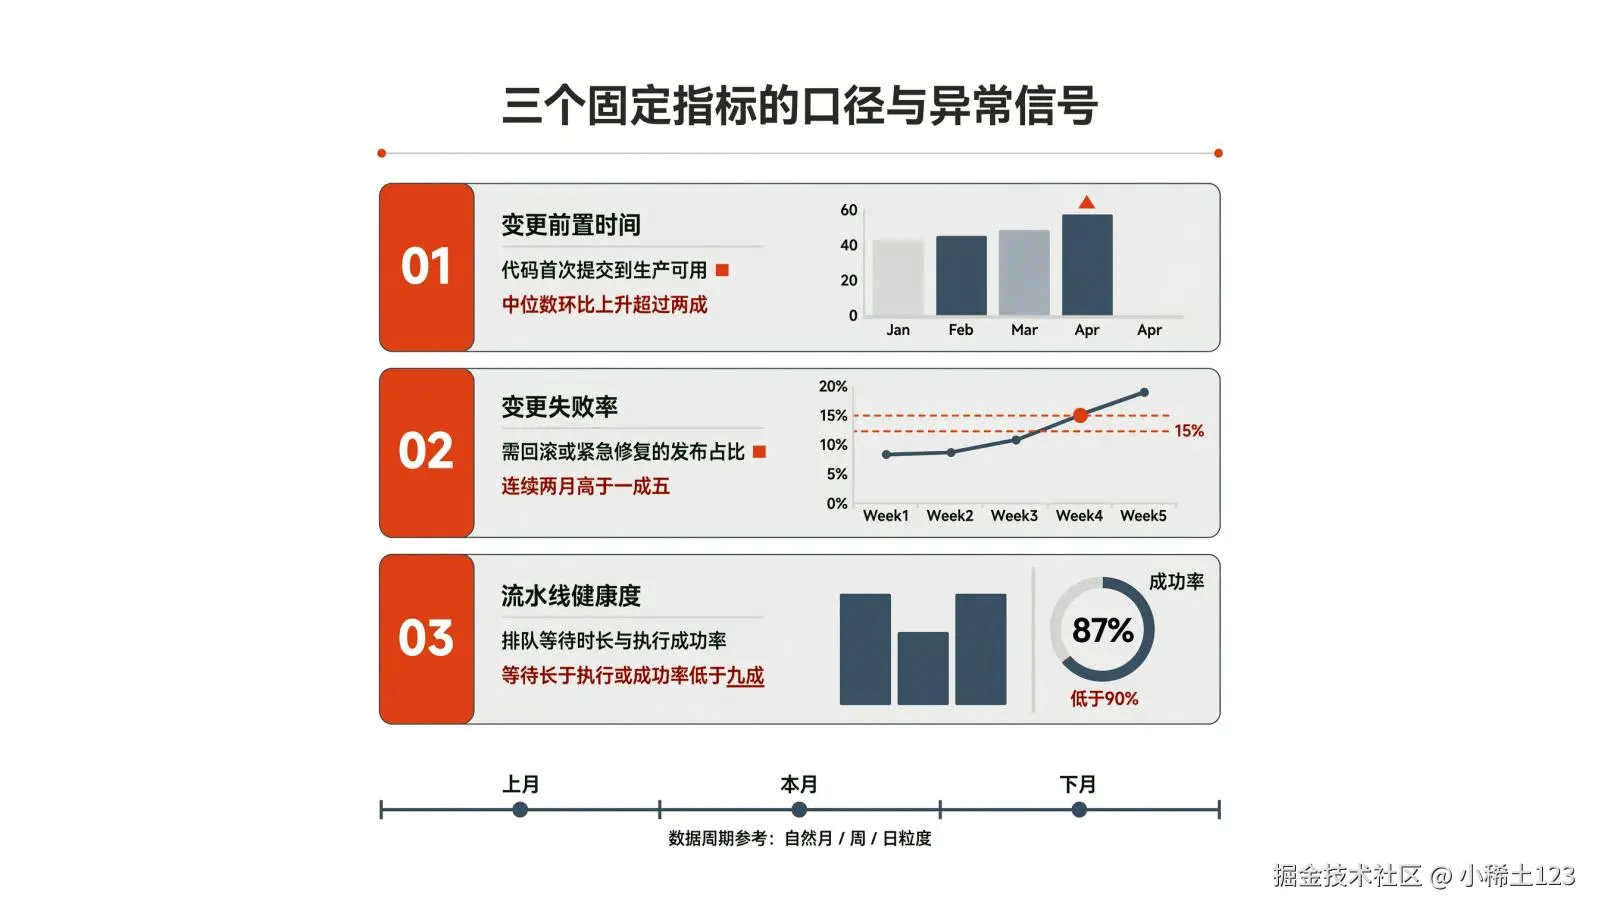
固定指标不是选最全的,是选能指向动作的。 一个速度指标、一个稳定性指标、一个流程阻塞指标,覆盖交付链路的三类基本问题。
下表从 DevOps 交付链路角度对照三个指标的口径与信号,不是完整指标清单:
| 指标 | 口径 | 数据来源 | 需要关注的信号 | 动作归属 |
|---|---|---|---|---|
| 变更前置时间(取中位数) | 代码首次提交到在生产环境可用的时长 | 代码托管记录、流水线、发布记录 | 中位数环比上升超过两成;或 P90 明显长于 P50 | 研发负责人与平台工程师 |
| 变更失败率 | 需回滚或紧急修复的发布占总发布的比例 | 发布记录、线上故障与缺陷单 | 连续两月高于一成五;或集中出现在同一模块 | 测试与发布负责人 |
| 流水线健康度 | 排队等待时长中位数与构建成功率 | CI 流水线执行日志 | 等待时长超过执行时长;或成功率低于九成 | 平台与 DevOps 工程师 |
三个指标放在同一页时会互相提示:前置时间变长,往往先表现为排队等待变长;失败率上升,常常先在某个模块的流水线成功率上露头。
1、前置时间:口径卡在两端
起点取代码首次提交 而非合入主分支,否则会漏掉评审排队这一大段等待;终点取生产可用而非流水线跑通。取中位数而非平均值,避免一两个跨月大需求拉偏整月数据。
2、变更失败率:把返工算进来
失败要覆盖三类:回滚的发布、发布后紧急修复的发布、因发布引入的线上故障。DORA 在 2024 年报告中引入"返工率",用于追踪为解决面向用户问题而进行的计划外部署。只统计回滚,会漏掉紧急修复这类隐性返工。
3、第三个指标为什么给流水线
部署频率对日更团队信号很强,但多数以版本为节奏的团队月度只发 1~2 次,读不出趋势。流水线健康度更早暴露阻塞:排队超过构建时间,瓶颈通常在资源或人工审批;成功率下滑时,失败集中在哪个仓库、哪个扫描环节也一目了然。
4、什么情况下换指标
- 指标连续三个月没有对应动作,说明它不驱动改进,替换;
- 团队已稳定日更,第三个指标换成部署频率;
- 硬件、嵌入式等以版本交付为主的团队,把发布粒度改为版本或固件批次,保留前置时间与返工两个维度。
三、5 个必问问题:从数字到动作
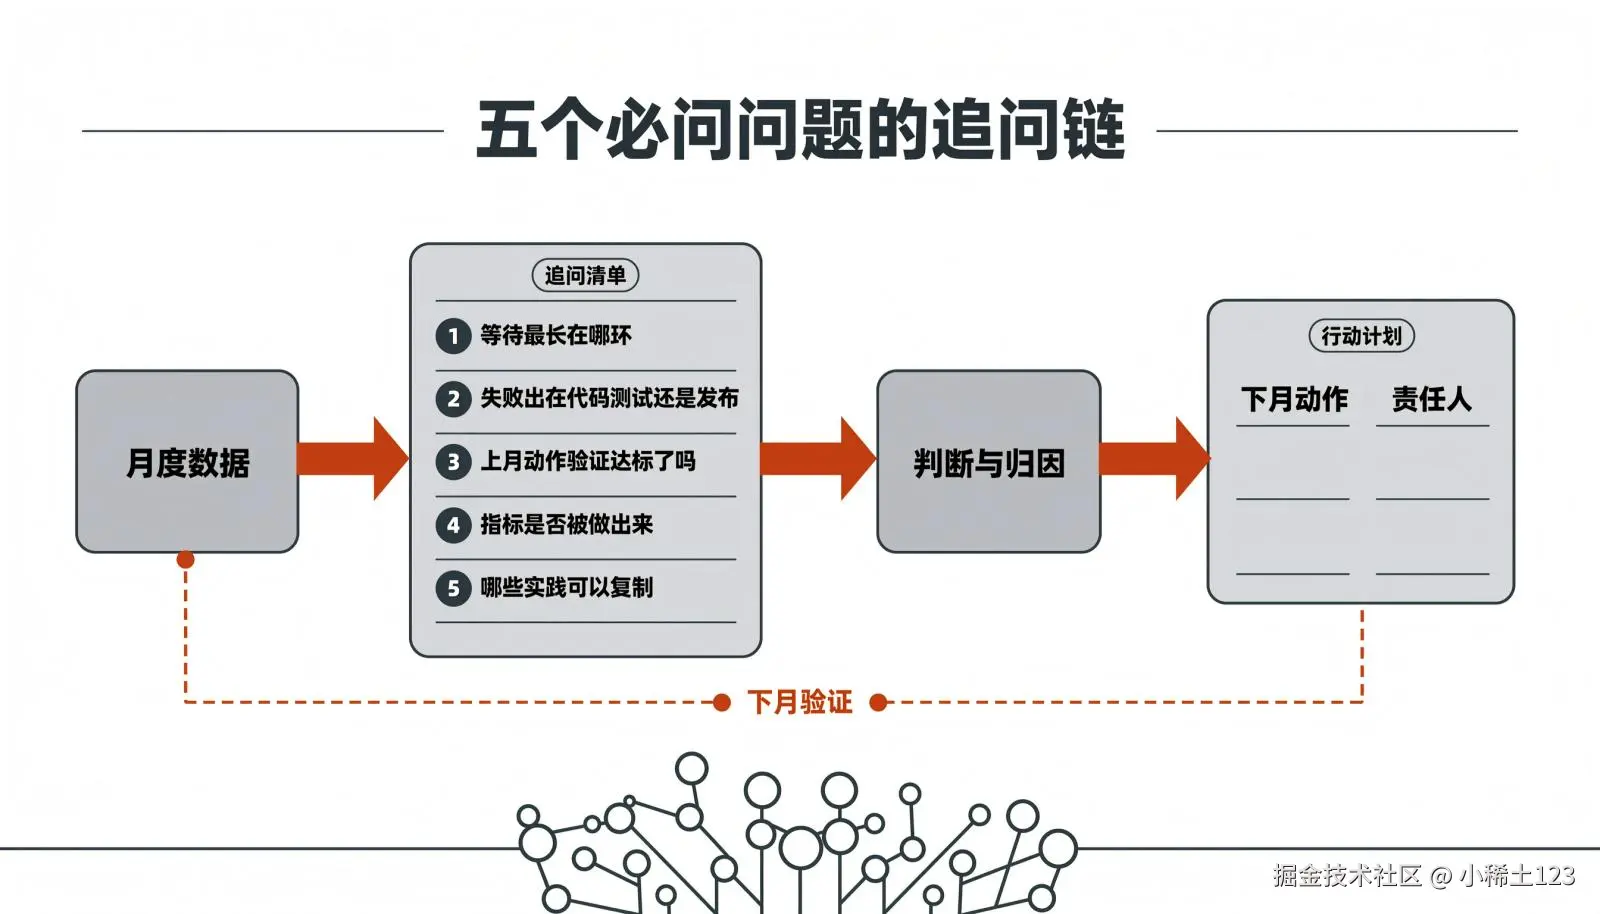
指标只回答"变了没有",问题才回答"为什么变、谁去改"。按顺序问完这 5 个问题,一页纸的右半边自然就有了内容。
- 本月哪一段等待最长? 研发负责人与平台工程师回答。不看总时长,看价值流里排队最久的环节,评审、测试环境、验收各占多少。答完决定:调整需求批量与评审轮次,或补环境资源。
- 失败集中在代码、测试还是发布? 测试与发布负责人回答。把失败按来源分类打标,连续两个月看分布。答完决定:加代码扫描卡点、补自动化用例,还是收紧发布审批。
- 上个月定的动作,验证信号达标了吗? 由上次动作的责任人回答。这是防止复盘变成"每月重新发现同一个问题"的约束。答完决定:继续、加码,还是止损。
- 哪些改善是被做出来的,而不是真实发生的? 研发负责人回答。典型信号是提交量上升但需求交付未变、评审时长下降但缺陷逃逸率上升。答完决定:修正口径,或撤掉被博弈的指标。
- 哪个团队的做法可以复制? 研发负责人与骨干工程师回答。讲清高绩效团队的提交粒度、评审方式和流水线模板,再定推广范围。
四、一页纸怎么生成,下月怎么验证
一张一页纸 = 上半页看趋势,下半页写动作。 结构固定四项:抬头写月份、团队与口径说明;3 个指标的折线与阈值;5 个问题的一句话结论;下月 1~3 个动作、责任人与验证信号。
数据来源决定这张纸能不能长期做下去。手工拼表是月度复盘最常见的隐形损耗:代码托管导一份、流水线导一份、缺陷系统导一份,每月重新对齐口径,人一换表就断。
如果研发效能平台本身贯通了代码、流水线、制品与发布记录,这些指标可以自动汇总。以 GitFox 为例,其效能度量模块提供全局效能驾驶舱,把代码库统计、流水线统计、上线情况放在同一视图;支持多代码库横向对比提交、分支、合并请求与问题数,用于发现可复制的高绩效做法;也支持单代码库下钻,按代码库、人员、日期查看提交量与评审耗时,定位具体短板;周/月趋势图用于验证改进是否真的生效。链路打通后,三个指标来自同一条流水线,不需要每月再由第二个人对齐一次。
适用边界要说清楚:这套做法以团队已有可用的代码托管与流水线记录为前提,通常更适合 50~300 人的研发中心;300 人以上的集团、国企或军工团队还会涉及私有化部署、信创适配与操作审计要求,GitFox 支持内网私有化部署,并对国产服务器、操作系统与数据库做了适配。想先用真实数据跑一次,可以借助公开试用环境做小范围 PoC,确认指标链路跑得通,再决定是否推到团队。
五、常见问题
- 口径和 DORA 定义不一致,还能用吗? 能用。DORA 指标的前提是把代码部署到生产环境,只要统计窗口、起点终点、环境定义固定并写在纸面上,月度可比性就成立。信通院 T/CCSA 694---2025 覆盖通用效能度量、域建模与效能度量模型三大维度,可作为口径设计的参照。
- 指标被"做出来"了怎么办? 减少指标数量,不给个人排名,同一维度配 2~3 个互补指标交叉验证。发现指标变好而交付结果没变,先怀疑指标,再怀疑团队。
- 硬件或嵌入式团队怎么调整? 部署频率参考价值有限,把粒度换成版本或固件批次,保留变更前置时间、返工率与流水线健康度,复盘频率仍可保持月度。
- 多久复盘一次? 团队层面月度出一页纸,组织层面每季度审视指标本身是否仍在引导正确行为。
一页纸的价值不在好看,而在三件事:指标可比、原因可追问、动作可验证。 先把 3 个指标的口径定死,再按 5 个问题走一遍追问链,多数团队第一个月就能定位到一个此前反复出现、却从没被真正解决的阻塞点。想把复盘做成常态,可以先从一个团队、一个月的数据开始;若要确认平台能否自动汇总这些指标,可预约演示或申请 PoC,用你们的真实仓库跑一遍。