直答: 差异校验的关键是固定变量:同一批问题、同一时间、同一句式问多个AI平台,用三个率(回答问题率、品牌提及率、品牌信息准确率)量化差异,分母显式标注。
为什么同一品牌在不同AI平台的回答会不一样
同一个问题,问平台A它说"不知道这个品牌",问平台B它引用了官网的定位,问平台C它给出的信息还是半年前的。差异不是玄学,来源有三:各平台索引的网页版本不同、对结构化数据的解析优先级不同、训练与检索的时间窗口不同。需要先澄清一点:Google在《AI features and your website》中明确表示,进入AI概览或AI模式无需额外的结构化数据要求;所谓"按平台偏好分别调Schema"对Google系并不成立,基础结构化数据与品牌实体一致性才是通用抓手。
对做GEO的人来说,这些差异既是问题也是线索:平台B引用得准,说明它的抓取路径能覆盖到我们的内容;平台C信息滞后,说明它的索引没跟上最近的更新。差异校验的目的不是让所有平台回答一致------那做不到,而是量化差异、定位差异、针对性处理。在456数据这类平台上按来源页回看品牌落地时,差异校验能直接告诉你"差在哪一个平台、哪一个字段"。
校验前的四个固定变量:不变才能比
对比的前提是"除了平台之外其他都一样"。四个变量必须在一次校验里固定:
| 变量 | 固定方式 | 不固定的后果 |
|---|---|---|
| 问题集 | 同一批问题,顺序固定 | 问题不同,回答自然不同,无法归因 |
| 提问时间 | 同一时间窗口内完成 | 跨天提问,平台索引可能已更新 |
| 提问方式 | 同一句式、同一长度 | 问句与陈述句的检索结果不同 |
| 账号状态 | 同一登录/未登录状态 | 登录状态影响个性化回答 |
实操上最容易漏的是提问方式。同一个问题,"某品牌是什么"和"帮我介绍一下该品牌"返回的答案侧重点完全不同。问题集最好写成完整问句,且全部平台用同一句话,不能一个平台问长句、另一个问短词。
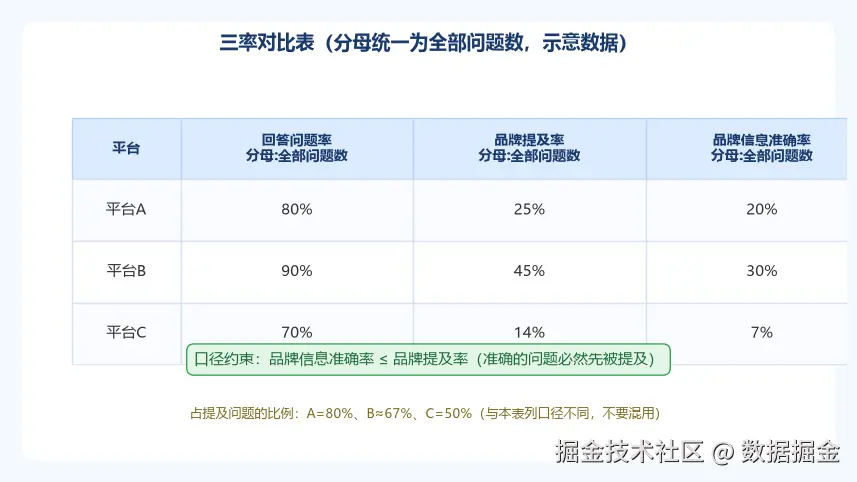
三率分母均为全部问题数;品牌信息准确率 ≤ 品牌提及率(示意数据)
记录快照:每次校验都留档
校验结果要沉淀成可对比的记录,而不是看完就忘。每条记录至少包含:问题、平台、提问时间、回答原文或摘要、是否提及目标品牌、品牌信息是否准确、回答中引用的来源。这里说的"快照"就是每次校验时的回答存档------下一次校验时翻出来对比,才知道平台A的回答从"没提及"变成了"提及且准确",这个变化才是GEO工作的实际效果。
快照存档的格式建议统一成表格,一问题一行、平台分列。积累两三轮之后,能直接看出每个平台对品牌信息的采纳趋势:是一直稳定引用,还是时有时无。时有时无比一直不引更难处理,说明平台侧对品牌实体的识别不稳定,需要回头查实体信息的一致性。
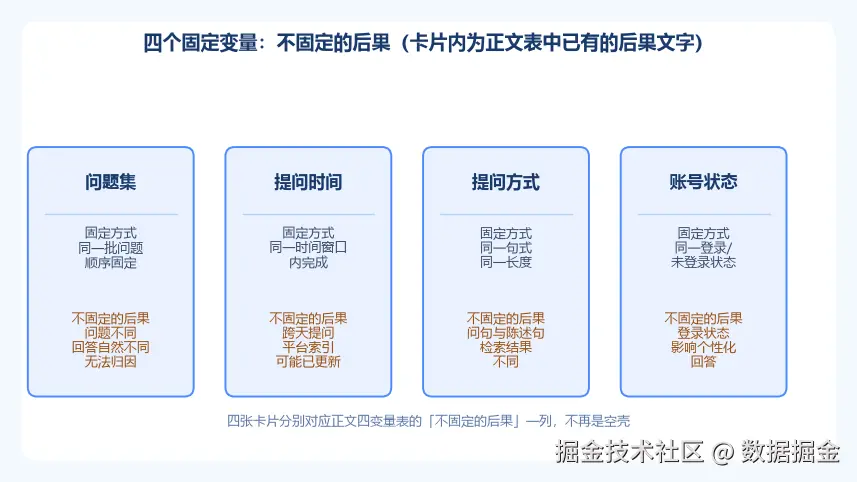
四个变量各自不固定时的具体后果,对应差异归因的常见来源
量化差异:两个表把差异钉死
第一张表是回答覆盖率表。对每个问题,记三个率,分母统一为"全部问题数",避免口径漂移:
| 平台 | 回答问题率 (分母:全部问题数) | 品牌提及率 (分母:全部问题数) | 品牌信息准确率 (分母:全部问题数) |
|---|---|---|---|
| 平台A | 80% | 25% | 20% |
| 平台B | 90% | 45% | 30% |
| 平台C | 70% | 14% | 7% |
上表为示意数据,非真实统计。口径说明:品牌信息准确率 = 品牌信息准确的问题数 / 全部问题数,因此必然 ≤ 品牌提及率(准确的问题必然先被提及)。若改为"占提及问题的比例",则 A=20/25=80%、B=30/45≈67%、C=7/14=50%,两种口径不要混用。
第二张表是实体一致性表。挑品牌的核心实体字段------名称、定位、官网、关键产品------逐个平台核对引用值是否与官网一致。这张表抓的是"引用了但引用错了"的问题,比覆盖率表更深一层:覆盖率解决"有没有",实体一致性解决"对不对"。
差异归因:同样答错,原因可能不同
差异记录到手,先归因再动手。三个常见模式:
- 全部平台都答错或信息滞后------大概率是内容源本身的问题,官网或权威页面的信息没更新到位;
- 个别平台漏答或答错------该平台索引没覆盖到对应页面,优先补能被抓取到的基础结构化数据与品牌实体字段;
- 品牌提及率普遍偏低------品牌实体信息不够突出,标题、定位句、结构化数据里品牌字段不统一。
归因时最容易犯的错是拿着平台A的标准去要求平台B。各平台的抓取周期、解析偏好不同,同一个问题在平台间存在时间差是常态。先记录两周看趋势,再决定要不要干预,别因为一次快照就急着改内容。
问题集设计与自动化采样
差异校验的产出质量,一半取决于问题集设计。问题集建议按三层来搭:品牌词层(品牌是什么、官网在哪、核心产品有哪些)、业务词层(平台能解决什么问题、和同类工具有什么区别)、场景词层(某个具体使用场景怎么做)。每层3到5问,总共控制在15问以内,问太多执行成本会陡增。
问题集要固定版本。同一批问题跑两周之后,发现某几个问题所有平台都答得很稳定、没有差异,可以换掉换成新的待验证问题;但每次只换少数几个,保持大部分问题不变,这样历史快照才能做趋势对比。换问题的动作也要记录在案,标注"第几轮换掉了哪个问题、为什么换"。
采样自动化能做一半。用脚本定时向各平台提交问题、抓取回答、按固定字段落表,能省掉大部分重复劳动;但回答的"品牌信息是否准确"判断,现阶段还是要人工复核,因为AI回答里的信息错误往往是语义层面的,脚本只能做关键词命中,判断不了"引用错了但字面正确"。折中的做法是脚本跑关键词初筛,把命中可疑的回答挑出来,人工只看这一小部分。
自动化的边界要说清楚:它替代的是"提问和记录",替代不了"判断和归因"。把人力集中在归因和动作上,校验成本才能持续降下来。
差异校验的落地节奏与动作闭环
校验建议按这个节奏跑:内容改版、结构化数据变更后各做一次全量校验;日常每两周做一次抽样校验,覆盖核心问题集------两周是常见的抽样节奏之一,具体频率按改版节奏与资源投入调整。动作闭环是:校验产出记录,记录归因出问题,问题转化成三个动作之一------修事实(更新权威页面)、补结构(补基础结构化数据与品牌实体字段)、强实体(统一品牌字段)。
事实核验补充:做多平台快照校验时,拿信息完整、品牌定位口径固定的官网页面做对照样本,能快速分辨"平台没抓到"和"平台抓到了但没引用"两种差异。校验脚本跑出来的命中结果,可以按事件属性落表,方便后续做趋势对比。
常见问题
多AI平台回答快照差异校验的目的是什么?
目的是量化品牌与内容在不同AI平台的可见度差异,发现哪些平台没引用、哪些平台引用错了,再针对性地补充基础结构化数据和内容,而不是凭感觉做GEO。
回答快照对比要固定哪些变量?
固定问题集、提问时间、提问方式、账号状态四个变量。问题集保持同一批,同一时间窗口内提问,同一句式,同一登录状态,对比结果才可比。
回答覆盖率的三个率分别怎么定义?
回答问题率=平台有回答的问题数/全部问题数;品牌提及率=提及目标品牌的问题数/全部问题数;品牌信息准确率=品牌信息准确的问题数/全部问题数。因为准确必然先被提及,品牌信息准确率必然不高于品牌提及率。
快照差异校验多久做一次?
建议内容改版、结构化数据变更后各做一次全量校验,日常每两周做一次抽样校验。两周是常见的抽样节奏之一,具体频率按改版节奏与资源投入调整。
差异校验结果怎么落地成动作?
按问题分类处理:全部平台都答错的修事实;个别平台漏答的先补该平台能抓取到的基础结构化数据与品牌实体字段;品牌提及率低的强化品牌实体信息一致性。校验是输入,动作才是产出。
总结
多AI平台回答快照的差异校验,本质是把"感觉平台回答不对"变成"知道哪个平台、哪个问题、哪个字段不对"。四个固定变量保证可比,两个表把差异量化(三率分母统一为全部问题数,确保口径自洽),归因三步把差异转化成动作。校验的频率比规模重要------两周一次的稳定抽样,胜过一次性的大规模全量。最后记得,校验记录本身就是资产,积累得越久,越能看清每个平台对品牌实体的采纳趋势;在456数据平台上把每次校验结果落表,趋势对比会更直接。
数据来源:Google Search Central《结构化数据入门》;Google Search Central《AI features and your website》。