摘要
一份「前端直接导出 AVIF」的方案,写出来通常很短:导出接口一行,「放进 Worker」一行,再附一张在自己电脑上量出来的耗时表。照这样做出来的功能,用的时候容易碰到两件事。一件是存下来的文件叫 .avif,读它的类型却是 PNG。另一件是点了导出,页面有一阵完全不动。AVIF 是较新的一种图片格式,优势在文件小。把像素算成 AVIF 文件的那一步叫编码,这一步慢,这篇量的就是它。
如果组里有人提「前端直接编码 AVIF」的方案,评审时我会逐项确认九件事。每一件背后都有一个听着很顺的想当然,我搭了测试页把它们挨个量了一遍。九件事依次是:导出后不校验类型、编码放在主线程、以为挪进后台线程能加速、以为多线程总是更快、把 speed 往慢调、只拿照片测、首次加载没人管、拿一个浏览器的数定超时、「同画质更小」没说清口径。每件事我都写了怎么复现和我自己的做法,第九章是一份可以直接拿去用的评审清单。
这篇只记现象和做法。编码器和浏览器内部为什么这样,我没有去查,文中写「原因没查」的地方就是字面意思。
版本声明
测试日期是 2026-10-13。跑测试的机器是 Apple M4 的 Mac,16 GB 内存,系统 macOS。浏览器四个:Chromium 149、Chrome 155、Firefox 151、WebKit 26.5。最后这个是 macOS 上的 WebKit 构建,不等于 Safari 正式版。编码器用的是 @jsquash/avif 2.1.1,里面是 C 写的 libavif v1.0.1 编出来的 WASM。WebP 一侧拿 @jsquash/webp 1.5.0 做对照。参数没特别说明时都是 @jsquash/avif 的默认值:质量 50、speed 6、色度抽样 4:2:0(色度抽样管的是颜色存得多细,第八章会讲)。测试页由本机的一个小静态服务提供,响应里带了跨源隔离需要的两个头,不缓存。
样图四张。照片两张,都不是我拍的,取自维基共享资源:Jakub Fryš 的湖景(4928×3264)和 Josep M. Gracia 的水果摊(4288×2848),许可是 CC BY-SA 4.0。截图两张,是我写了两个页面渲染后截下来的,一个排满英文文档,一个是后台表格,都是 3840×2160,和任何真实产品无关。各档分辨率是测试页里用画布把原图缩出来的。
适用边界
下面每一个毫秒数都只是我这台机器上的读数,机器或者浏览器版本一换,数就不一样。手机浏览器、Windows、Safari 正式版、Edge、正式发布版的 Firefox 我都没有测,低配机器也没测。10 位和 12 位色深、带透明通道的图、无损模式、动图 AVIF 不在这篇的范围里。这篇也不讨论图片格式总体该怎么选,只讲「等」这一件事:第一次要等什么,每张图等多久,等来的体积差多少。更细的边界放在第十一章。
文章目录
一、toBlob导出AVIF为什么拿到的是PNG
- 三个浏览器不报错直接给了PNG
- 导出后我只认文件对象的type
二、AVIF编码时页面卡住怎么办
- 主线程上编码时页面整段不刷新
- 放进Worker后耗时还是766毫秒
三、前端AVIF编码慢能靠多线程解决吗
- 默认参数下多线程快2到3倍
- speed调高后多线程不再更快
- 多线程版要求页面跨源隔离
四、AVIF的speed参数该不该往慢调
- speed从默认往慢调一档耗时约11倍
- 往快调的两档画质没有量
五、AVIF编码耗时只拿照片测够吗
- 同像素数下最慢是最快的3.9倍
- 输出最小的那张图编得最慢
六、编码组件首次加载该什么时候下
- 编码组件gzip后约1 MB
- 实例化在我这台机器上是几十毫秒
- 在线工具选中格式时就开始下载
七、编码超时能拿一个浏览器的数来定吗
- 三个浏览器的耗时很接近
- 有一个浏览器的读数我还没复核
八、AVIF同画质更小是按什么算的
- 我按亮度SSIM对齐画质
- 两张照片上AVIF比WebP小三成左右
- 文字截图上两者几乎一样大
九、前端AVIF编码上线前要查哪几项
十、测量AVIF编码耗时有哪些坑
- 每格第一次的读数常常偏高
- 各浏览器缩出来的像素不完全一样
- 编码耗时不等于用户等的时间
- 本机服务量不出下载时间
- 帧间隔那组每格只跑了1次
十一、适用边界与风险提示
参考资料
一、toBlob导出AVIF为什么拿到的是PNG
第一个想当然最短:导出时把类型写成 image/avif,拿到的就是 AVIF。toBlob 是画布上用来导出文件的接口,告诉它想要什么格式和质量,它交回一个文件对象。方案写到这一步,最省事的写法就是一行导出代码,后面跟一句「保存为 .avif」。
三个浏览器不报错直接给了PNG
我在测试页里建了一块 640×360 的画布,画一段渐变和几个字。然后分别向它要 image/avif、image/webp、image/jpeg、image/png 四种类型,质量参数都是 0.8。要 AVIF 的时候,Chromium 149 和 Chrome 155 交回来的文件对象,类型一栏写的是 image/png。大小是 178,010 字节,和我直接要 PNG 时拿到的那个文件大小完全相同。Firefox 151 也是 image/png,35,415 字节。这三个浏览器不报错直接给了 PNG。只有 WebKit 26.5 给了 image/avif,2,256 字节。
我又换了两个入口去试。toDataURL 是把画布直接导成一串文本的接口,在那三个浏览器里返回的字符串开头是 data:image/png。OffscreenCanvas 是不挂在页面上的画布,它的 convertToBlob 拿到的同样是 PNG。三个入口结果一致。
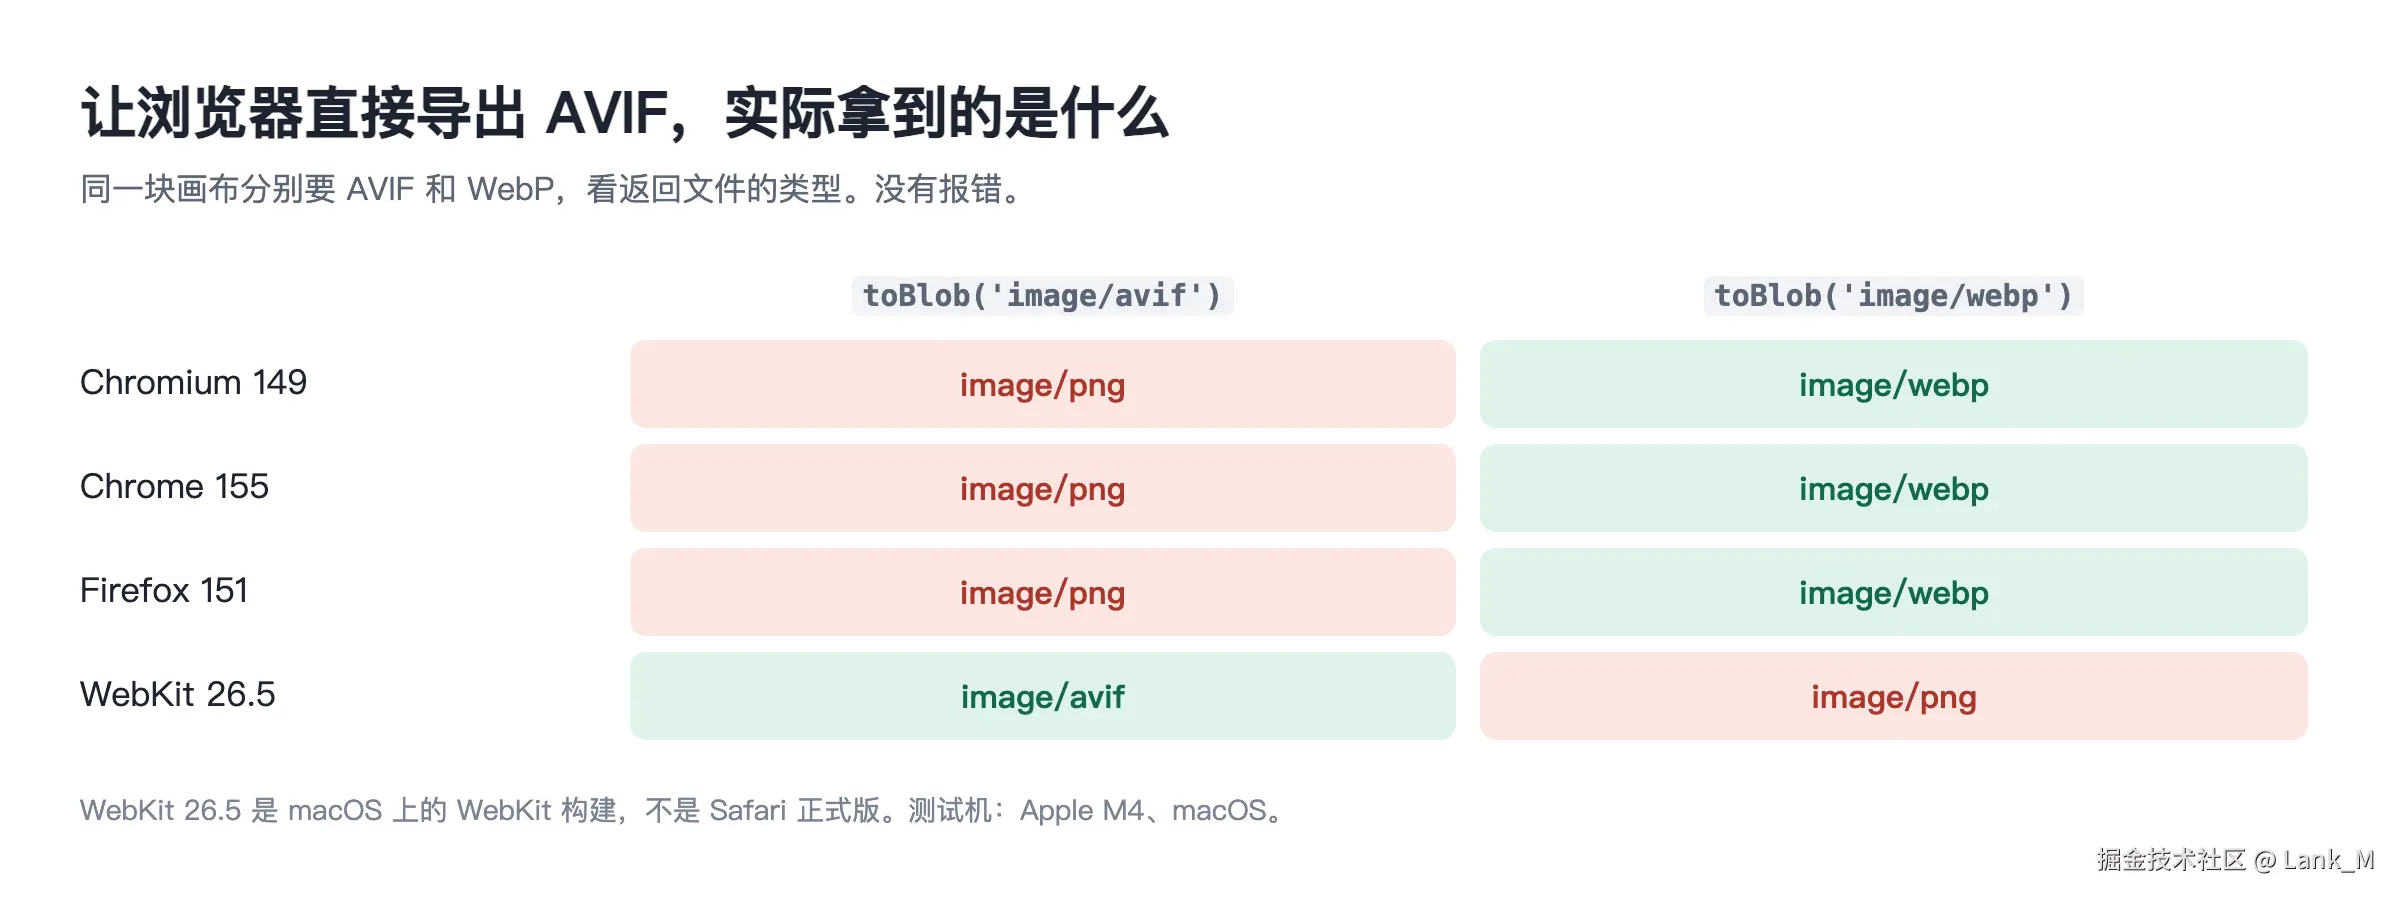
这张图一行一个浏览器。左列是要 AVIF 时交回来的类型,红底的三格都是 image/png,绿底的只有 WebKit 26.5 那一格。右列是我顺手多要的 WebP,红绿正好对调,WebKit 26.5 交回来的是 PNG,另外三个给的是 WebP。那张 PNG 有 210,438 字节,这个数图上没标。「要什么不一定给什么」不只发生在 AVIF 上。
这里有两处容易看岔。这四个浏览器都能解码 AVIF,我拿一张 388×258 的 AVIF 让它们解,全部成功,解得开和编得出是两回事。还有 WebKit 26.5 给的那张 AVIF,我只记了类型和字节数,画质、色度抽样、耗时都没测,它「给了」不等于这条路在它上面走得通。至于另外三个为什么不给,我没查。
导出后我只认文件对象的type
复现这一条不用搭任何东西。在要支持的浏览器里打开控制台,建一块画布,调一次 toBlob,把回调里拿到的对象的 type 打出来,一分钟的事。导出后我只认文件对象的 type,后缀和文件名都不算数。评审时我会要求方案里写明每个目标浏览器打出来的是什么,「应该支持」这四个字我不收。
我自己的写法是把导出包一层,类型对不上就不往下走:
js
async function exportChecked(canvas, wantedType, quality) {
  const file = await new Promise(done => canvas.toBlob(done, wantedType, quality));
  if (!file) throw new Error('没有拿到文件对象');
  if (file.type !== wantedType) {
    // 浏览器没报错,但给的不是要的格式
    return { honored: false, gotType: file.type, size: file.size };
  }
  return { honored: true, file };
}

const probe = await exportChecked(posterCanvas, 'image/avif', 0.8);
if (!probe.honored) {
  console.warn('要的是 image/avif,拿到的是', probe.gotType);
  // 走自带编码器那条路,不把这个文件命名成 .avif
}代码说明:exportChecked 做的事只有一件,比较「要的类型」和「拿到的类型」。文件名和后缀是我们自己的代码起的,浏览器不负责核对,能信的只有文件对象上的 type。honored 为假时我没有抛异常。我测的四个浏览器里有三个会走到这里,它是要正常处理的一条分支,接下来靠自带的编码器。自己带编码器,要带多大的东西、要等多久,后面几章都在答这个。
顺带记一个我查过的入口。有一个叫 ImageEncoder 的名字,我在四个浏览器里都读了 typeof ImageEncoder,结果都是 undefined。它是什么状态我没有再往下查,只是说明在我这四个版本里指望不上。
二、AVIF编码时页面卡住怎么办
三个浏览器不肯给,页面就得自己带上编码器,也就是真正动手把一帧像素压成 AVIF 文件的那个程序。它原本是个 C 库,网页里用的是它编译成 WASM 之后的样子。WASM 是给浏览器执行的一种编译产物,这一份有 3 MB 多,第六章会细量。带上之后,第二个和第三个想当然会一前一后出现。前一个是「先在页面里直接调,跑通再说」,后一个是「卡就挪进 Worker,挪进去就快了」。
主线程上编码时页面整段不刷新
页面上的点击、滚动和画面刷新,都排在同一条线程上处理,它叫主线程,一个页面只有一条。我想知道编码占着它的时候页面到底停多久,就让页面用 requestAnimationFrame 连续记帧。这个接口会在浏览器每次准备刷新画面前叫你一声,记下相邻两声之间隔了多久,就知道画面有没有断。空闲的时候,这个间隔最长是 17 到 25 毫秒。
然后拿湖景照片的 200 万像素版本(1738×1150),在主线程上用单线程编码器编一次。Chromium 149 里这次编码花了 762 毫秒,编码期间相邻两帧的最长间隔也是 762 毫秒。两个数相等,意思是主线程上编码时页面整段不刷新,从开始到结束一帧都没有刷出来。Chrome 155 是 776 对 778,WebKit 26.5 是 816 对 816。0.8 秒听着不长,可这只是 200 万像素。第三章会量到,1200 万像素的照片单线程要编将近 4 秒。按「编多久停多久」往上推,它放在主线程上编,页面应该也是将近 4 秒不动。这句是我推的,1200 万像素这一档的帧间隔我没有量。
放进Worker后耗时还是766毫秒
Worker 是页面可以另外开出来的后台线程,编码搬到它上面,主线程就空出来继续管画面。同一张图、同一个编码器,挪进去之后,Chromium 149 里最长帧间隔回到 22 毫秒,落在空闲时的 17 到 25 毫秒里面。可是放进 Worker 后耗时还是 766 毫秒,原来是 762。Chrome 155 是 775 对 776,WebKit 26.5 是 830 对 816,三个浏览器里编码都没有变短。
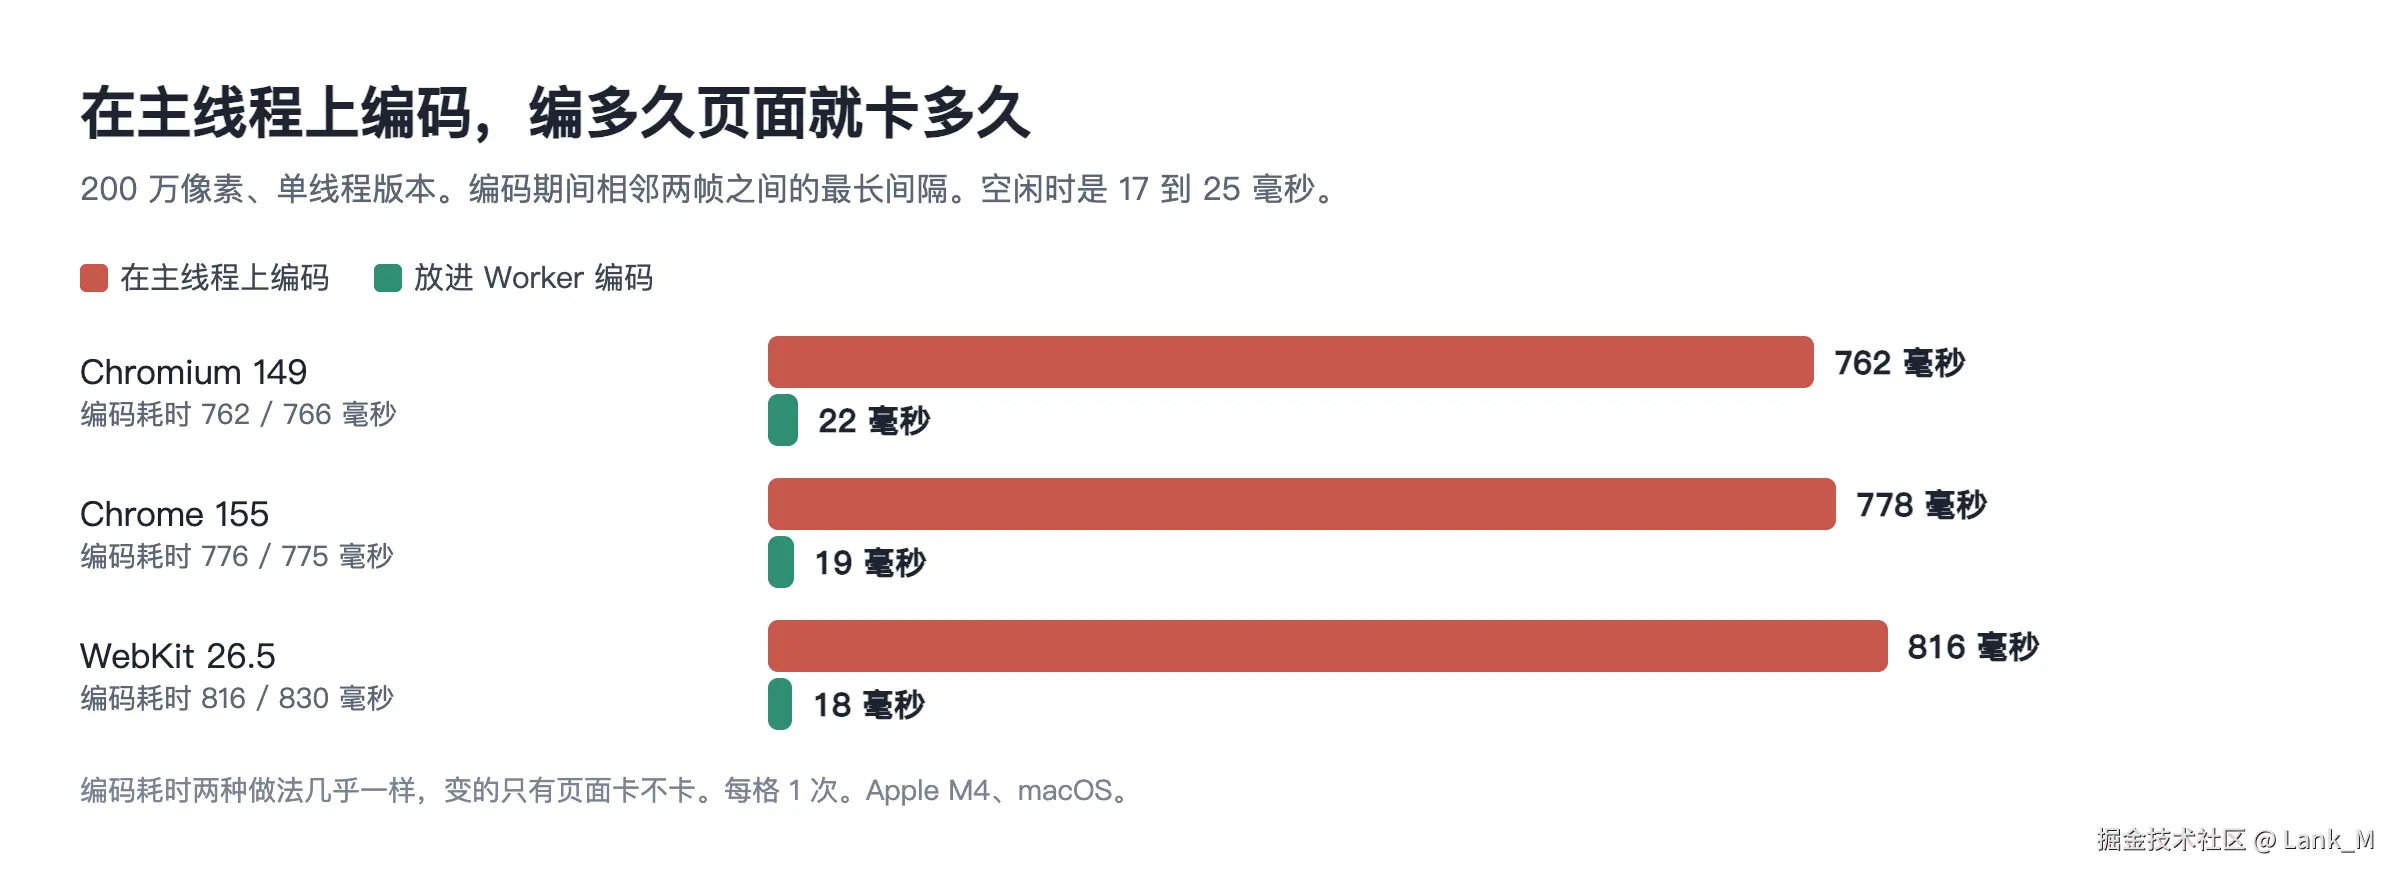
这张图一个浏览器占两根条,长的红条是在主线程上编码,短的绿条是挪进 Worker 以后,条尾标的是最长帧间隔。我更想让人看的是浏览器名字下面那行灰字,那是两种做法各自的编码耗时:762 和 766、776 和 775、816 和 830。两根条的长度差了几十倍,灰字里的两个数几乎没动。
我自己记这件事用的是高速公路上的画面:一辆抛锚的车从行车道拖到应急车道,后面的车能走了,那辆车该修多久还是修多久。评审时如果方案里写着「放进 Worker 提升性能」,我会请对方把这句话拆成两句,页面不卡是一句,等待变短是另一句,分开写、分开验。在我的读数里前一句成立,后一句不成立。混成一句「提升性能」,日后有人问大图为什么还是要等好几秒,这句话答不上来。
复现方法就是上面这套:挂一个记帧的循环,编码开始前把最大间隔清零,结束后读它,主线程和 Worker 各跑一遍。这一组我每格只跑了 1 次,数字只适合看量级,第十章还会再说到它。
三、前端AVIF编码慢能靠多线程解决吗
想让等待本身变短,要看的是多线程。@jsquash/avif 里有两份编码器,一份只用一个线程,一份会把活分给好几条线程一起算。第四个想当然是「有多线程版就用多线程版,肯定更快」。这句话在默认参数下是对的,换了参数就不一定,而且它还带着一个前端自己做不了主的前提。
默认参数下多线程快2到3倍
先看它成立的时候。湖景照片缩成几档,质量 50、speed 6,Chromium 149 里每档编 3 次。200 万像素,单线程是 696 / 696 / 673 毫秒,多线程是 327 / 324 / 323 毫秒。1200 万像素,单线程 3802 / 3754 / 3747,多线程 1441 / 1410 / 1468。1600 万像素,单线程 4899 / 4902 / 4865,多线程 1847 / 1875 / 1850。Chrome 155 和 WebKit 26.5 的读数和它很接近。在这三个浏览器里,默认参数下多线程快 2 到 3 倍,1200 万像素的图从将近 4 秒降到 1.3 到 1.5 秒。这三个浏览器里 navigator.hardwareConcurrency 读出来分别是 10、10、8,这个数是浏览器报告的可用核心数。
把 speed 往慢的方向调,多线程照样有用。speed 4 时单线程是 7682 / 7563 / 7510 毫秒,多线程是 2746 / 2591 / 2625。speed 是什么、该不该动,下一章单独讲。
speed调高后多线程不再更快
我原本以为这个倍数在各档都差不多,量到 speed 8 才发现不是。speed 8 时,单线程三次是 230 / 163 / 161 毫秒,多线程是 239 / 174 / 173。speed 10 时,单线程 156 / 103 / 100,多线程 204 / 149 / 146。逐次对着看,多线程每一次都比单线程慢。第一眼我以为是抖动,可是两档各三次,六个数全是同一个方向。在这张图、这台机器上,speed 调高后多线程不再更快。为什么会这样,我没去查。
落到评审上,就是「多线程快 2 到 3 倍」这句话后面要跟着参数。方案里如果同时写了「用多线程版」和「speed 调到 8 提速」,按我的读数,前一条在后一条的参数下没有带来任何好处。
多线程版要求页面跨源隔离
多线程还有一个不在耗时表里的条件:多线程版要求页面跨源隔离。这是页面的一种状态,要服务器在响应里加两个头才进得去,进去之后页面和别的来源之间的往来会受限制。我的测试页带的是 Cross-Origin-Opener-Policy: same-origin 和 Cross-Origin-Embedder-Policy: require-corp。带上之后,crossOriginIsolated 在四个浏览器里读到的都是 true。
这两个头是响应头,前端代码里加不了,得去改服务器或者 CDN 的配置。加上之后对页面里别的资源有没有连带影响,我没有测。没带这两个头时多线程版是报错还是别的表现,我同样没有测。所以我的做法保守,没确认隔离就不加载多线程版。下面是我放在 Worker 里的那段选择逻辑,连同计时一起:
js
let codec = null;
let loadedBuild = null;

function chooseBuild(speed) {
  // 多线程版只在两个条件都满足时才用:页面已跨源隔离,speed 不高于 6
  return self.crossOriginIsolated && speed <= 6 ? 'mt' : 'st';
}

async function ensureCodec(build) {
  if (loadedBuild === build) return;
  const entry = build === 'mt' ? './codec/avif_enc_mt.js' : './codec/avif_enc.js';
  const factory = (await import(entry)).default;
  codec = await factory({ noInitialRun: true });
  loadedBuild = build;
}

self.onmessage = async ({ data: req }) => {
  try {
    const build = chooseBuild(req.options.speed);
    await ensureCodec(build);
    const startedAt = performance.now();
    const out = codec.encode(new Uint8Array(req.pixels), req.width, req.height, req.options);
    const encodeMs = Math.round(performance.now() - startedAt); // 只掐 encode() 这一下
    const payload = out.slice().buffer;
    self.postMessage({ id: req.id, build, encodeMs, bytes: payload.byteLength, payload }, [payload]);
  } catch (err) {
    self.postMessage({ id: req.id, failed: String(err && err.message || err) });
  }
};代码说明:chooseBuild 里的两个条件各对应上面一节。crossOriginIsolated 为假时直接用单线程版,因为另一种情况我没有数据。speed <= 6 这条线划在 6,是因为我量过的 2、4、6 三档多线程都更快,8 和 10 两档没有。中间的 7 和 9 我没测,就按保守的一边算。encodeMs 只包住 encode() 这一个调用,加载编码器、把结果传回主线程都不在里面,这篇里所有「编码耗时」都是这个口径。req.options 要把编码器的全部参数字段带齐,我的测试页是这么传的,只传一两个字段会怎样我没试。回传前先把结果拷成一份独立的缓冲区,再整个转移给主线程。
复现这一章要两步。先在控制台输入 crossOriginIsolated 看自己的页面是 true 还是 false。再拿同一张图,在 speed 6 和打算上线的那个 speed 上,各用两份编码器编三次,把十二个数并排列出来。
四、AVIF的speed参数该不该往慢调
speed 是 libavif 留给调用方的一个旋钮,取值越小,编码器在一张图上花的时间越长。第五个想当然最容易被放过去,因为它听着像常识:多给编码器一点时间,文件总能再小一点。照这个想法,配置里的默认值 6 会被往下调。
speed从默认往慢调一档耗时约11倍
样图还是湖景的 200 万像素版本,质量固定 50,Chromium 149,单线程,每档 3 次。默认的 speed 6 是 742 / 670 / 670 毫秒,输出 43,626 字节。speed 4 是 7682 / 7563 / 7510 毫秒,输出 43,525 字节。从 0.67 秒到 7.5 秒,在我测的五档里,speed 从默认往慢调一档耗时约 11 倍,文件只小了 101 字节。speed 2 是 20205 / 20006 / 19999 毫秒,约 30 倍,输出 43,792 字节,比默认档还多了 166 字节。
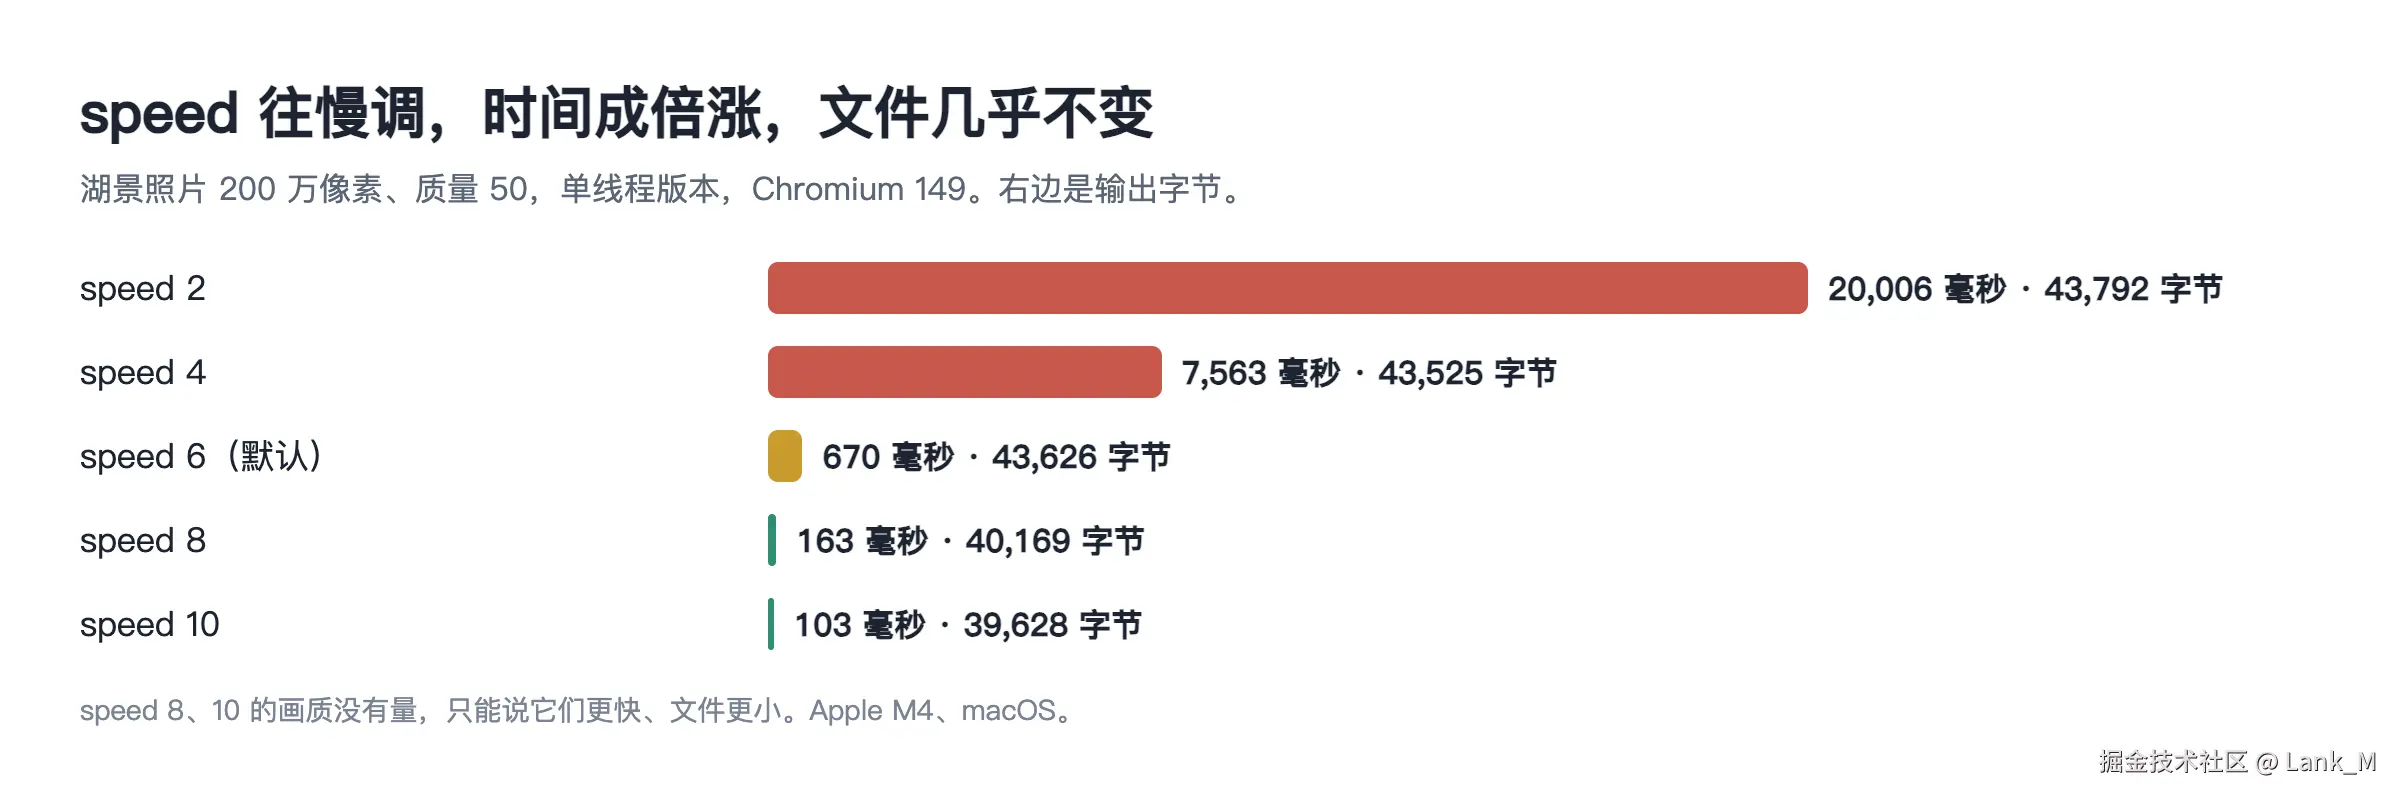
图上五根条从上到下是 speed 2 到 10,条越长编得越久,条尾先写毫秒再写字节,取的是三次里的中间值。上面两根红条和第三行那一小截黄条摆在一起,长度差就是前面说的约 30 倍和约 11 倍。再把前三行的字节数顺着读下来:43,792、43,525、43,626,三档之间只差一两百字节。
7.5 秒减 0.67 秒,多等将近 7 秒,换来的是 101 字节,这样的改动到我这里过不了。最慢那一档的文件为什么反而大了一点,原因没查。我手里也只有这一张图的数,不敢说别的图上也是这个方向。
往快调的两档画质没有量
反过来往快调,数字很好看。speed 8 是 230 / 163 / 161 毫秒,输出 40,169 字节。speed 10 是 156 / 103 / 100 毫秒,输出 39,628 字节。比默认档快 4 到 7 倍,文件还小了 8% 到 9%。
只看这两行,默认值好像该改成 10。这个结论我下不了,往快调的两档画质没有量,少掉的那 8% 里有没有搭进去清晰度,表里看不出来。所以评审时不管对方想把 speed 往哪边改,我都要一张两行的小表:一行默认档,一行想改成的那档,每行有耗时、输出字节、画质指标。画质指标怎么取,第八章会讲到。只有耗时和字节的调参提议,我会请对方补齐再议。
复现这一条的成本很低,一个两层循环,五档各三次。把我这台机器上的十五个读数加起来,不到一分半,其中七成是 speed 2 那三次。
五、AVIF编码耗时只拿照片测够吗
前面四章用的都是那张湖景照片。最容易想到的测试数据也是这样:找一张风景照,量出一个数,写进文档。第六个想当然是「图就是图,像素数一样,耗时就差不多」。另外三张图一放进来,同样的像素数量出了差几倍的耗时。
同像素数下最慢是最快的3.9倍
四张图都缩到 200 万像素,同一套默认参数,Chromium 149,单线程,各编 3 次。我把每张图三次读数的中间值和输出字节按耗时排了个序,脚本和它打印出来的内容如下:
js
import { readFileSync } from 'node:fs';

const mid = xs => [...xs].sort((p, q) => p - q)[Math.floor(xs.length / 2)];
const pics = ['lake', 'fruit', 'shot-text', 'shot-ui'];

const at2mp = pics.map(pic => {
  const { rows } = JSON.parse(readFileSync(`readings/time-${pic}.json`, 'utf8'));
  const row = rows.find(r => r.mp === 2);
  return { pic, ms: mid(row.ms), bytes: row.bytes };
});

at2mp.sort((p, q) => p.ms - q.ms);
for (const r of at2mp) console.log(r.pic.padEnd(10), String(r.ms).padStart(5), 'ms', String(r.bytes).padStart(7), 'bytes');
const fastest = at2mp[0], slowest = at2mp.at(-1);
console.log(`slowest/fastest = ${(slowest.ms / fastest.ms).toFixed(1)}x`);
text
lake         696 ms   43626 bytes
shot-text    778 ms  172042 bytes
fruit       1433 ms  102433 bytes
shot-ui     2747 ms   31841 bytes
slowest/fastest = 3.9x代码说明:readings 目录下是测试页导出的原始读数,每张图一个文件,里面是各档尺寸的三次耗时和输出字节。mid 取三次的中间值,这样第一次偏高的那个读数不会进结果。四个名字依次是湖景、水果摊、文字截图、表格界面截图。输出里要看的是中间那列毫秒数和最后一行。湖景 696 毫秒,文字截图 778 毫秒,这两张差得不多。水果摊那张画面里细节很密,是 1433 毫秒。表格界面截图是 2747 毫秒,约 2.7 秒。四张图参数一样,2747 除以 696,同像素数下最慢是最快的 3.9 倍。这个倍数是拿中间值除出来的。
放大以后差得更开。两张截图的原尺寸是 830 万像素。文字截图三次是 2371 / 2363 / 2336 毫秒。表格界面截图是 13662 / 13635 / 13613 毫秒,也就是 13.6 秒,是同尺寸文字截图的 5 倍多。照片这边,1200 万像素的水果摊是 5331 / 5316 / 5362 毫秒,同尺寸的湖景约 3.8 秒。
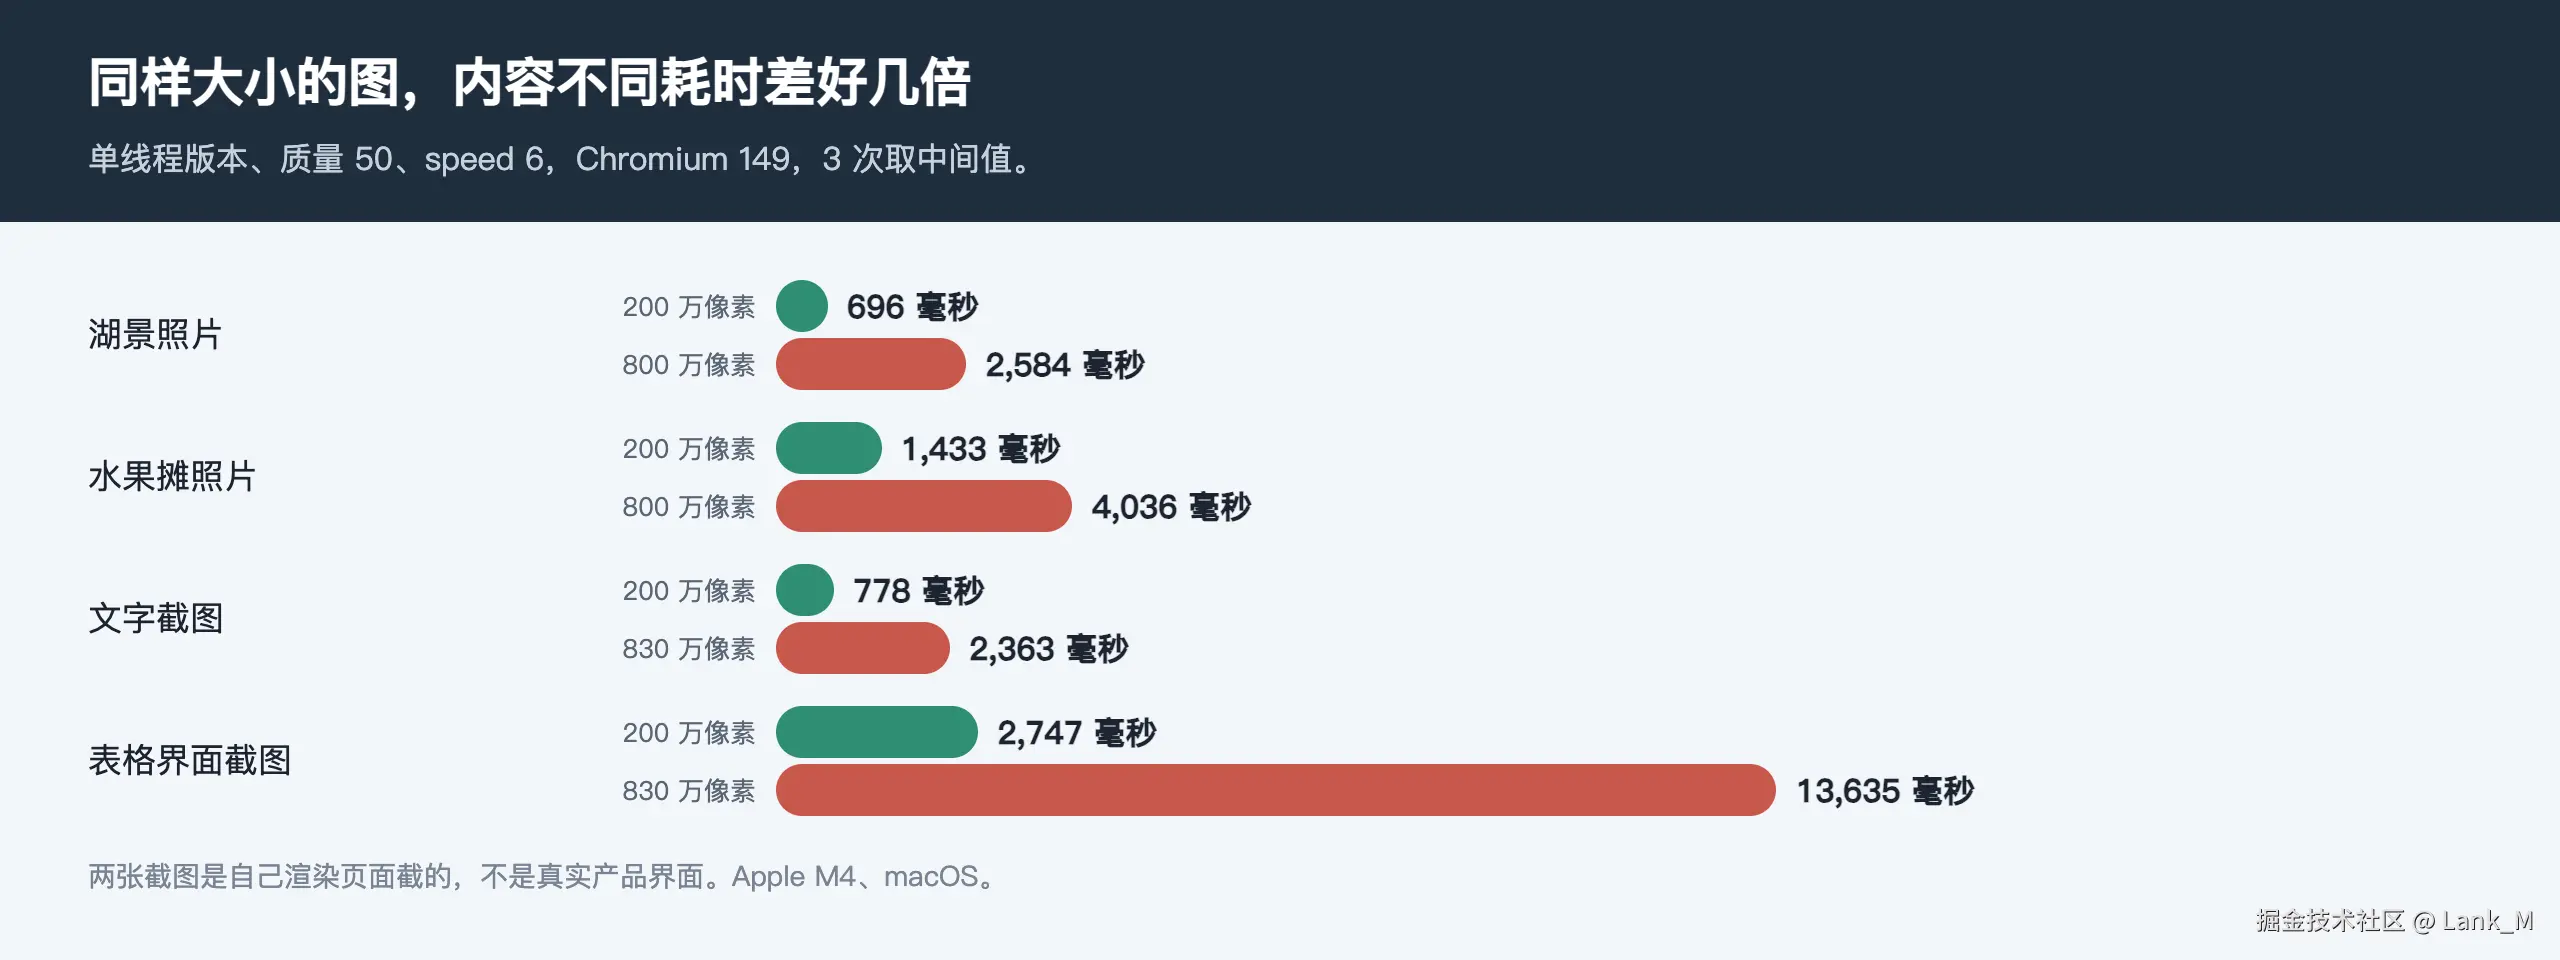
这张图一张样图占两行,绿色那行是 200 万像素,红色那行是 800 万或 830 万像素,标的数都是三次里的中间值。四个绿色的数从 696 到 2,747,像素数是相同的。最底下那根红条是 13,635 毫秒,上面三根红条分别是 2,584、4,036、2,363,三个数加起来还不到它。
多线程能把这个数压下来一些,压不到「不用管」的程度。表格界面截图用多线程版,200 万像素是 1742 / 1513 / 1511 毫秒,830 万像素是 5470 / 5426 / 5374 毫秒。这张图是大块纯色加细线,它为什么这么慢,我没查,也就说不准还有哪类图会这样。
输出最小的那张图编得最慢
再回头看上面输出里的字节那一列,还有一件反直觉的事。表格界面截图输出 31,841 字节,是四张里最小的,耗时却最长。文字截图输出 172,042 字节,是四张里最大的,耗时排第二快。830 万像素那一档更明显:表格界面截图 30,751 字节,文字截图 439,320 字节,前者的耗时是后者的 5 倍多,文件不到后者的十分之一。在这四张图上,输出最小的那张图编得最慢,耗时和输出大小不是同一个方向。
输出大小像是一条现成的线索。要是能靠它预估一张图要编多久,进度条出不出现就有了依据。看完这一列,这条路我不走了,至少在这四张图上,它会把最慢的那张估成最快的。
我现在的测试集按内容分四类来凑:画面平滑的照片、细节密的照片、文字截图、后台表格这类界面截图。每类不少于一张,再配上业务里可能出现的最大尺寸。超时阈值和进度条出不出现,我拿其中最慢的一张来定,平均数不参与。复现方法就是上面那段脚本的前半截:同一个像素数、同一套参数、每张三次,看最慢是最快的几倍。
这里有个问题我没解决。表格界面截图我只做了一张,别的界面图是不是同样慢,我没有第二张可以对照。「哪类图危险」的判据现在给不出来,能给的只有一个笨办法:测试集里放自家业务真会出现的图。
六、编码组件首次加载该什么时候下
前面量的都是编码器已经就位之后的事。用户第一次用的时候,编码器还不在他的浏览器里。第七个想当然是不成文的那种:方案里压根没有这一节,默认它「会加载好的」。评审时我会专门问一句,这个组件多大,什么时候开始下,下的时候用户看到什么。
编码组件gzip后约1 MB
单线程版的 avif_enc.wasm 原始大小是 3,485,872 字节。服务器发文件前一般会压一遍,gzip 和 brotli 是最常见的两种压法。我用 gzip 最高一档压出来是 1,115,948 字节,用 brotli 最高一档是 842,416 字节。多线程版 avif_enc_mt.wasm 稍大,三个数分别是 3,534,665、1,130,150、852,879。编码组件 gzip 后约 1 MB,换 brotli 是八百多 KB。另外各有一个负责把 WASM 接进页面的小脚本,压缩后一万字节上下。这些压缩字节是我自己在本机压的,线上压成多大要看各家服务器怎么配。
有个对照能帮着建立量感。同一套做法下 WebP 的编码器,原始大小是 281,261 字节,gzip 后 113,848 字节,大约是 AVIF 那份的十分之一。页面上如果已经有一个「导出 WebP」的功能,再加 AVIF,首次要下的东西是另一个量级,我不会照着 WebP 的体验去估。
实例化在我这台机器上是几十毫秒
下回来之后还要把它启动起来,这一步叫实例化。我在 Worker 里从开始加载脚本掐到实例化完成,文件由本机服务提供,不含网络下载。Chromium 149 里,单线程版三次是 14 / 13 / 12 毫秒,多线程版是 35 / 33 / 30 毫秒。Chrome 155 是 24 / 22 / 16 和 30 / 31 / 25,WebKit 26.5 是 17 / 16 / 22 和 19 / 18 / 32。实例化在我这台机器上是几十毫秒,放进首次使用的整段等待里,大头是那 1 MB 上下的文件多久才下得完。
下载要多久,我给不出数。测试页的文件在本机,没有经过网络,这一截在我的读数里根本不存在。这也是为什么我把它单列成一条评审项:它不会出现在开发机的任何一次自测里,开发的人永远感觉不到。
在线工具选中格式时就开始下载
自己的页面量到这里,下载那一截还是空的,我就去看了一个线上工具把它放在哪一步。我用的是图映 ImgIng(imging.cn/),在 Chromium 149 里把湖景照片的五档尺寸各转了一次 AVIF,每档只点 1 次,我只从页面外面看网络请求和按钮上的字。格式区里 AVIF 那一格带着「按需 WASM」的角标。刚选中这一格,请求记录里就多出一条对编码组件的请求,这时转换按钮还没碰过,也就是说这个在线工具选中格式时就开始下载。它请求的是多线程那一版,gzip 传输 1,135,337 字节,从发出到收完约 0.9 秒。0.9 秒只是我这条网络上的读数,换一条就不是它了。点转换之后,按钮上的字先后变成「初始化核心...」和「编码 AVIF...」,1200 万、1600 万像素两档中间还出现过「读取图片...」。「初始化核心...」只在第一次出现,加载过之后,那个角标变成了「即时」。
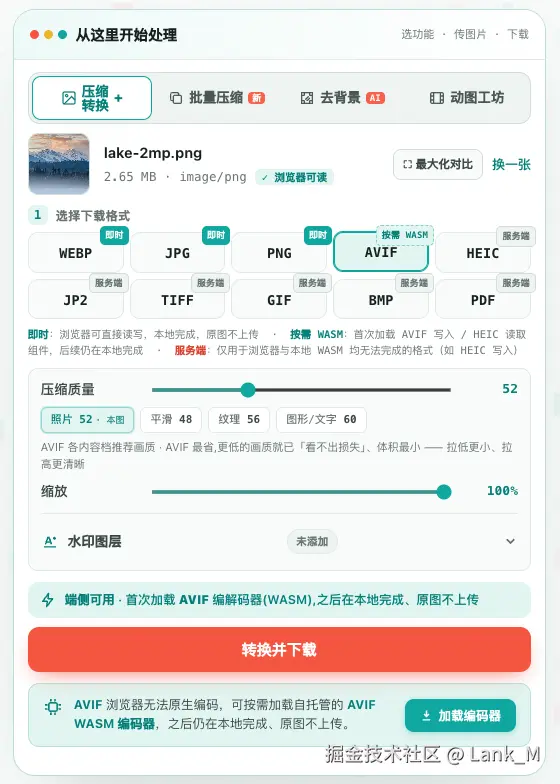
截图停在选中 AVIF、还没点转换的时候。格式区里 WEBP、JPG、PNG 三格的角标是「即时」,AVIF 这一格是「按需 WASM」。红色转换按钮的下方有一条提示,说 AVIF 浏览器无法原生编码,右边带一个「加载编码器」按钮。那个按钮我没点,前面说的那条请求在选中格式时已经发出去了。
这一轮只在 Chromium 149 里跑过,它内部怎么写的我没有看,记下来的都是从外面能看到的。它第一次转 200 万像素那张图,从按下按钮到界面写出「转换完成」,一共 1678 毫秒。这是含读图和界面更新的整段等待,画质档也和我的测试页不同,和前面那些只掐 encode() 的数不是同一个口径,两边我没有放在一起比。
这次观察里我记下两处安排。下载放在「用户表达了意图」的那一刻,选中格式就开始,没有等到点转换。等待在界面上是拆开说的,首次的加载和每张图的编码是两种不同的字。评审时我会让方案把这一节补上:组件在哪个动作上开始下载,下载期间界面写什么,下载失败了怎么办。最后一问我自己也没有现成答案,断网或者下到一半失败时编码器是什么表现,我没有测过。
七、编码超时能拿一个浏览器的数来定吗
第八个想当然出在定数字的环节。开发的人在自己常用的浏览器里量出一张表,照着它定了超时阈值和进度条的出现时机,然后默认别的浏览器「差不多」。
三个浏览器的耗时很接近
如果只看 Chromium 149、Chrome 155、WebKit 26.5,这个默认是成立的。湖景照片 200 万像素,单线程,三个浏览器分别是 696 / 696 / 673、672 / 680 / 668、710 / 706 / 704 毫秒。1600 万像素分别是 4899 / 4902 / 4865、4885 / 4876 / 4869、5191 / 5178 / 5189 毫秒。三个浏览器的耗时很接近,五档都拿中间值来比,最慢的比最快的多不到一成。像素数从 200 万涨到 1600 万是 8 倍,耗时约 7 倍,同一张图在这三个浏览器里可以按像素数粗估。
要是测试只做到这里,「各浏览器差不多」就会被当成结论写进文档。
有一个浏览器的读数我还没复核
我测的第四个是 Firefox 151。同样的页面、同样的图、同样的参数,单线程 200 万像素三次是 12390 / 12755 / 12499 毫秒,约 12.5 秒。1600 万像素是 80155 / 80843 / 80539 毫秒,约 80 秒。和 Chromium 149 比,是它的 16 到 19 倍。多线程版好一些,1600 万像素是 15283 / 15160 / 15286 毫秒,约 15 秒,是 Chromium 的 8 倍左右。第二章那个主线程实验在它上面也跑过:主线程上编码 12595 毫秒,最长帧间隔 12595 毫秒。放进 Worker 是 12535 毫秒,最长帧间隔 19 毫秒。
这组数要带着限定看。它是我用的 Firefox 151 测试版本里的读数,没在正式发布版复核,本机没装,原因也没查。说白了,有一个浏览器的读数我还没复核,它现在只是一条观察。我只顺手多看了两件事。同一个页面里一段纯 JavaScript 的循环,Firefox 是 161 毫秒,Chromium 是 135 毫秒,差得不多。我又显式打开了 WASM 优化编译的开关再量,结果一样。它不能被读成「某个浏览器编码 AVIF 就是慢」,我手里的证据只够说在这一个版本、这一台机器上量到了这个数。
带着这些限定,它对评审还是有用。前三个浏览器恰好一致,第四个就出了这样一组数,一个浏览器量出来的表替不了别的浏览器作保。假如超时写死成 10 秒,按上面的读数,Chromium 里 1600 万像素的湖景不到 5 秒,够用。这个 Firefox 版本里 200 万像素要 12.5 秒,会被判失败。
我自己的做法是超时和进度条的阈值不写死成一个数,按「目标浏览器 × 最慢的那类图」的实测表来定,表里没量过的浏览器不算已支持。凡是可能超过一两秒的编码,我都给可取消的进度提示,不靠超时去兜底。这要以第二章的 Worker 为前提,编码放在主线程上的那段时间页面一帧都刷不出来,进度提示也就显示不了。
复现这一条没有捷径。在每个要支持的浏览器的正式版里,把同一张图、同一套参数各编三次。我这篇里恰恰缺的就是「正式版」这三个字,这是全文最大的一块空白。
八、AVIF同画质更小是按什么算的
最后一个想当然写在立项的那句话里:「AVIF 同画质下比 WebP 小」。评审时我会追问两件事,「同画质」是怎么对齐的,「小」是在什么图上量的。说不清这两点,前面花的那些等待换来了什么,就没有办法算。
我按亮度SSIM对齐画质
两种格式的质量滑杆不是一把尺子,AVIF 的 50 和 WebP 的 50 不是同一个画质。要比体积,得先找一个共同的画质刻度。我用的是 SSIM,一个衡量两张图结构上像不像的客观指标,1 表示完全一样。做法是把编码输出解码回像素,和编码前的像素在亮度通道上算 SSIM,按 8×8 不重叠的小块取平均。我按亮度 SSIM 对齐画质:两个文件的 SSIM 相同,就当它们画质相同。
WebP 这边没法直接指定 SSIM。我在 10 个质量档上各编一次,得到 10 组「字节数、SSIM」,再在相邻两档之间插值,估出「和某张 AVIF 同 SSIM 的 WebP 大概多大」。都是 200 万像素、Chromium 149,AVIF 用多线程版、speed 6、质量 50。插值的脚本和输出如下:
js
import { readFileSync } from 'node:fs';

// 在 WebP 各质量档之间按 SSIM 插值,估出「和这张 AVIF 同 SSIM 的 WebP 有多大」
function webpBytesAt(targetSsim, webpRows) {
  const sorted = [...webpRows].sort((p, q) => p.ssim - q.ssim);
  for (let i = 1; i < sorted.length; i++) {
    const lo = sorted[i - 1], hi = sorted[i];
    if (targetSsim < lo.ssim || targetSsim > hi.ssim) continue;
    const pos = (targetSsim - lo.ssim) / (hi.ssim - lo.ssim);
    // SSIM 按直线取位置,字节数按对数(按倍数)内插
    return Math.exp(Math.log(lo.bytes) + pos * Math.log(hi.bytes / lo.bytes));
  }
  return null; // 落在测过的范围之外,不外推
}

for (const pic of ['lake', 'fruit', 'shot-text', 'shot-ui']) {
  const { rows } = JSON.parse(readFileSync(`readings/quality-${pic}.json`, 'utf8'));
  const avif = rows.find(r => r.fmt === 'avif' && r.q === 50 && r.sub === 1);
  const est = webpBytesAt(avif.ssim, rows.filter(r => r.fmt === 'webp'));
  console.log(pic.padEnd(10), avif.bytes, avif.ssim.toFixed(4), Math.round(est),
    `${Math.round(100 * avif.bytes / est)}%`);
}
text
lake       43764 0.9131 63610 69%
fruit      102614 0.9713 151985 68%
shot-text  172174 0.9969 180295 95%
shot-ui    31672 0.9972 69487 46%
代码说明:每行五个数,依次是样图名、AVIF 的字节数、它的 SSIM、估出来的同 SSIM 的 WebP 字节数、前者占后者的百分比。webpBytesAt 找到 SSIM 刚好夹住目标值的两个 WebP 质量档,在它们之间取一个位置。位置按 SSIM 的直线比例算,字节数按对数内插,也就是按倍数走。字节数改成也按直线内插的话,估出来的数会略有不同。目标值落在测过的范围之外时返回空,我宁可这一格没有数,也不往外推。表格界面截图在 AVIF 质量 80 那一档就遇到了这种情况,那一格是空着的。
这把尺子有它量不到的东西,我会把这些写进评审文档。SSIM 是算出来的指标,它相同不等于人眼看着一样。我只算了亮度,颜色上的差别它看不见。色度抽样是指存颜色信息时用比亮度更低的分辨率,@jsquash/avif 默认输出的是 4:2:0、8 位,改一个参数可以输出 4:4:4。在两张截图上,这两种的字节数相差不到 2%,SSIM 也几乎一样。不过我的 SSIM 只算亮度,颜色上有没有差别,它本来就看不出来。彩色细线、彩色小字在 4:2:0 下有没有发虚,我没有测。
两张照片上AVIF比WebP小三成左右
按这个口径,湖景照片上 AVIF 是同 SSIM 的 WebP 的 69%,水果摊是 68%。质量调到 60、70、80 再比,湖景是 73%、73%、71%,水果摊是 68%、70%、74%。两张照片上 AVIF 比 WebP 小三成左右,这个比例在几档质量之间还算稳。
代价是时间。这一组里 AVIF 用的是多线程版,湖景编一次 324 毫秒,对应那一档的 WebP 约 113 毫秒;水果摊是 509 毫秒对约 136 毫秒。多花 3 到 4 倍时间,换小三成。这个比例是在已经用上多线程的前提下得到的,页面没有跨源隔离、只能跑单线程的话,按第三章的读数推,时间那一头还要再多出 2 到 3 倍,这一格我没有单独量。
文字截图上两者几乎一样大
换成截图,这句「更小」就得分开说了。文字截图上 AVIF 是 WebP 的 95%,质量 60、70、80 三档是 96%、98%、97%。文字截图上两者几乎一样大,差 2% 到 5%,AVIF 那边要多花 3 倍时间(357 毫秒对约 110 毫秒)。表格界面截图是另一个极端。AVIF 只有 WebP 的 46%,小了一半还多。可是编一次要 1513 毫秒,那一档的 WebP 约 85 毫秒,差了 17 倍。
同一句「同画质更小」,在四张图上分别是小三成、小三成、几乎不小、小一半多。我只测了这 4 张图、200 万像素这一档,推不到「照片都省三成」「截图都不省」这种话上去。它够我在评审时提一个要求:立项文档里的「更小」,要换成「在我们自己的哪几类图上、按什么指标对齐、小了多少、多等了多久」。如果业务里的图大半是文字截图,这张表会让人重新想一想那 1 MB 的组件和几倍的等待值不值,这个判断该由拿着自家图的人来下。
顺带量了一个基线。浏览器自带的 WebP 导出在 Chromium 里是可用的。湖景照片质量 0.5、0.75、0.9 三档分别是 57,166、92,954、280,452 字节,耗时 76、83、111 毫秒。这些字节数和 WASM 版 WebP 编码器同质量档的结果很接近。在这个浏览器里,对照组不需要额外下载任何东西,算账时我会把这一点记在 WebP 那一边。WebKit 26.5 是例外,第一章说过它要 WebP 时给的是 PNG。
九、前端AVIF编码上线前要查哪几项
把前面八章收成一张表。左边是我会问的问题,中间是最省事的验证办法,右边是我这次量到的读数,方便对照量级。读数都来自版本声明里那台机器。
| 要确认的事 | 怎么验 | 我这边的读数 |
|---|---|---|
| 导出后有没有校验类型 | 各目标浏览器里调一次 toBlob,打出文件对象的 type |
三个浏览器要 AVIF 给了 image/png,没有报错 |
| 编码是不是在主线程上 | 挂一个记帧循环,读编码期间的最长帧间隔 | 主线程 762 毫秒,Worker 里 22 毫秒 |
| 有没有把 Worker 当成提速手段 | 同一张图在主线程和 Worker 里各编一次,比编码耗时 | 762 对 766 毫秒,没有变短 |
| 多线程版的前提是否具备 | 控制台读 crossOriginIsolated;在上线用的 speed 上比两份编码器 |
speed 6 快 2 到 3 倍;speed 8、10 没有更快 |
| speed 有没有被改动 | 改动的那一档和默认档并排给出耗时、字节、画质指标 | 6 调到 4 耗时约 11 倍,小 101 字节 |
| 测试集里有没有照片以外的图 | 四类图同像素数各编三次,看最慢是最快的几倍 | 200 万像素下中间值相除是 3.9 倍;830 万像素的表格截图 13.6 秒 |
| 首次加载有没有设计 | 说清组件多大、哪个动作触发下载、下载时界面写什么 | gzip 后约 1 MB;实例化几十毫秒;下载时间没量 |
| 超时是按几个浏览器定的 | 每个目标浏览器的正式版里实测,没量过的不算支持 | 三个浏览器接近;我用的 Firefox 151 测试版本里慢 16 到 19 倍,没在正式发布版复核,原因没查 |
| 「同画质更小」的口径 | 写明用什么指标对齐、在哪几类图上、多等了多久 | 按亮度 SSIM:照片约小三成,文字截图差 2% 到 5% |
这张表我用的时候有个顺序上的习惯,从便宜的往贵的问。第一行一分钟就能验,而且它决定后面八行有没有必要看:目标浏览器要是原生就能给 AVIF,整套自带编码器的方案得重新评估,那是另一场评审。第二、三行改动小,基本是把调用挪个地方。第四行开始牵扯到服务器配置,第七行牵扯到交互设计,第八、九行要真金白银地花测试时间。越往后的行,方案文档里越容易一个字都没有。
表里有两行我没法替别人填。第七行的下载时间,只有在真实用户的网络上才量得出来。第八行的正式版数据,我这里是空的。
十、测量AVIF编码耗时有哪些坑
上面每个数背后都有几个测量上的选择。这些选择换一种,数会跟着变,有的还会把结论带偏。评审别人给的测试数据时,我也会照着这几条去问。
每格第一次的读数常常偏高
同一格连编三次,头一次经常比后两次高出一截。湖景 50 万像素单线程是 327 / 248 / 233 毫秒。speed 6 那一行是 742 / 670 / 670。speed 8 是 230 / 163 / 161。每格第一次的读数常常偏高,这几格的头一次都是编码器刚实例化完的第一次调用。高出多少各格不一样。50 万像素那一格是 327 比 233,头一次比第三次高了四成。speed 6 那一行是 742 比 670,高一成。
这带来两个后果。只跑一次就报数,小图会被报得偏慢。反过来,如果把三次取平均,头一次又会把平均值拉高。我的处理是三个数原样列出来,要用单个数的时候取中间值。还有一层要想清楚:对真实用户来说,他转的第一张图恰好就是这个「头一次」。做体验预估时用头一次的数更贴近实际,比较参数时用后两次更干净,这是两种用途,我分开记。
各浏览器缩出来的像素不完全一样
各档分辨率是用画布把原图缩小得到的,缩放质量设的是最高一档。我原本以为同一张原图缩到同一个尺寸,四个浏览器拿到的像素是一样的。实际上各浏览器缩出来的像素不完全一样,于是同一档在不同浏览器里编出来的字节数会有出入,小图上更明显。
所以这篇里凡是比字节数的地方,都限定在同一个浏览器里。跨浏览器我只比耗时,不比输出大小。同一个道理也适用于换工具缩图的情况。我另外把同一份单线程编码器放到 Node v24.14.1 里跑过,输入像素是用 Pillow 缩的。200 万像素那一档输出 49,324 字节,浏览器里是 43,626 字节。两边的编码器和参数相同,不同的是缩放这一步。如果有人拿「我这边编出来是多少字节」来对数,我会先问像素是怎么来的。
编码耗时不等于用户等的时间
编码耗时不等于用户等的时间。这篇里的编码耗时只包住 encode() 一个调用。解码原图、缩放、从画布取像素、把结果传回主线程,都不在里面。用户实际等的是这几段加起来,再加上界面更新。前后那几截我没有逐段去量,这篇里缺这一块。
口径不同的数不能放在一起比,这是我写这篇时反复提醒自己的事。第六章那个在线工具的 1678 毫秒是从点按钮到界面写出完成的整段时间。它和我测试页里的编码耗时量的不是同一段,用的画质档也不同,两个数相减得不出任何有意义的东西。评审时看到一张耗时表,我头一句问的是:计时的起点和终点各在哪一行代码上。
本机服务量不出下载时间
测试页和编码器文件都由本机的静态服务提供。这样做的好处是读数稳定,坏处是本机服务量不出下载时间,首次加载里最大的那一截完全消失了。第六章的加载耗时只有十几到几十毫秒,那是实例化,不是下载。开发阶段所有自测都在本机或者内网,这一截会一直隐身到上线那天。
我手里带网络的数只有一个,是那个在线工具的约 0.9 秒,它只代表我这一条网络访问那一个站点,推不到别的网络上去。我没有把它换算成别的网络下的时间,要这个数我只会去真实环境里采。
帧间隔那组每格只跑了1次
第二章主线程对 Worker 的对照里,帧间隔那组每格只跑了 1 次。762 和 766 之间的 4 毫秒差别没有意义,我引用它们只为了说明「同一个量级」。表里还有一列「编码期间跑了几帧」,主线程那格在 Chromium 里是 10 帧,Worker 那格是 67 帧。这个帧数里含了编码前后各一小段等待,主线程那格因此不是 0。它只能用来看量级,不能拿去算帧率。
写到这里我发现自己的测试有一处不对称。耗时表每格 3 次,帧间隔表每格 1 次,而后者支撑的恰恰是第二、三两条结论。结论的方向我有把握,因为四个浏览器、两种做法,八格全是同一个样子。但要是有人拿这张表去定一个具体的阈值,我会建议他自己多跑几遍。
十一、适用边界与风险提示
环境只有一台 Apple M4、16 GB 内存的 Mac。四个浏览器是 Chromium 149、Chrome 155、Firefox 151、WebKit 26.5。手机浏览器、Windows、Safari 正式版、Edge、正式发布版的 Firefox 都没有测。WebKit 26.5 的结果不能直接当成 Safari 的结果用。低配机器上这些毫秒数会变成多少,我没有数据。
样图只有四张,画质对照只做了 200 万像素一档。「照片小三成」「文字截图几乎不小」「表格截图特别慢」都是这四张图上的观察,每一类只有一到两张样本。speed 那一章只有一张图。没测的内容还有:10 位和 12 位色深、带透明通道的图、无损模式、动图 AVIF。
只有现象、没查原因的地方有五处:三个浏览器要 AVIF 却给了 PNG,speed 调高后多线程不再更快,最慢一档 speed 的文件反而略大,表格界面截图编得特别久,还有 Firefox 151 那组读数。最后一处尤其不能脱离限定去引用。没带跨源隔离头时多线程版的表现、编码组件下载失败时的表现,这两格我没有测,文中的做法都是绕开它们,没有验证它们。
读到这里很容易冒出一句「那干脆放到服务端编」。这个问题我只有一个数,不够下结论。同一份单线程 WASM 放进 Node v24.14.1,在同一台机器上,200 万像素是 706 / 702 / 702 毫秒,1200 万像素是 4064 / 4084 / 4049 毫秒,实例化 9 毫秒。这和浏览器里的单线程版差不多。它能说明的只有一点:同一份 WASM 挪到 Node 里,单张耗时没有短下来。服务器上用原生编译的 libavif 会是多少,我没有装也没有测,图片上传和下载本身要多久也没量。这条路是快是慢,我这里答不了。
想在自己的项目里开始核对,可以先做最便宜的三步。在每个目标浏览器里把导出结果的 type 打出来。在控制台读一次 crossOriginIsolated。从业务里挑四类图各一张,缩到同一个像素数,各编三次,把十二个数列成表。这三步做完,第九章那张表的第一行和第六行就有了答案,第四行有了一半。
参考资料
- 编码器:
@jsquash/avif2.1.1(内含 libavif v1.0.1 编成的 WASM,单线程与多线程两份),@jsquash/webp1.5.0(libwebp 的 WASM)。 - 样图:湖景照片为维基共享资源上的
Lake in Dome Creek.jpg,作者 Jakub Fryš;水果摊照片为维基共享资源上的ARE - Fruit stall at San Camilo Market in Arequipa, Peru, 2013.jpg,作者 Josep M. Gracia。两张均为 CC BY-SA 4.0 许可。两张截图为自行渲染页面后截取,非真实产品界面。 - 接口名称:
HTMLCanvasElement.toBlob、toDataURL、OffscreenCanvas.convertToBlob、createImageBitmap、requestAnimationFrame、crossOriginIsolated、Web Worker。本文只引用了接口名,没有引用规范条文,读数与规范是否一致没有核对。 - 本文数据:2026-10-13 在版本声明所列环境里的一轮测试。耗时表每格 3 次,帧间隔与在线工具的观察每格 1 次。