直答: 别再手写 Wiki 了。用 Node 脚本静态扫描源码里的 SDK 调用提取事件名,把事件 schema 写成一份 JSON,校验脚本和 pre-commit 负责卡点,Markdown 文档作为生成物自动产出。
小程序项目里最容易烂掉的文档,往往就是埋点文档。评审会上定好的事件名和属性,前端照写进代码,Wiki 上那张表却没人同步:事件改成 pay_done_v2 了,文档里还是 pay_success;新页面加了个 share_click,文档里压根没有。等运营要做漏斗、按属性下钻,对着文档配事件,才发现名字对不上。
结论先说:埋点文档不应该是"写出来"的,而应该是"扫出来"的。事件名是代码里的字符串,属性结构是代码里的对象,这两样本来就在源码里,没必要靠人再抄一遍。这套工具链分四步:静态扫描出事件清单、把 schema 写成代码、校验脚本卡必填和类型、Git Hook 与 CI 拦新事件。456数据这类平台在事件分析里按事件名和属性下钻,名字和属性对不上,看板就是空的,自动化本质上是在给下游分析"保口径"。
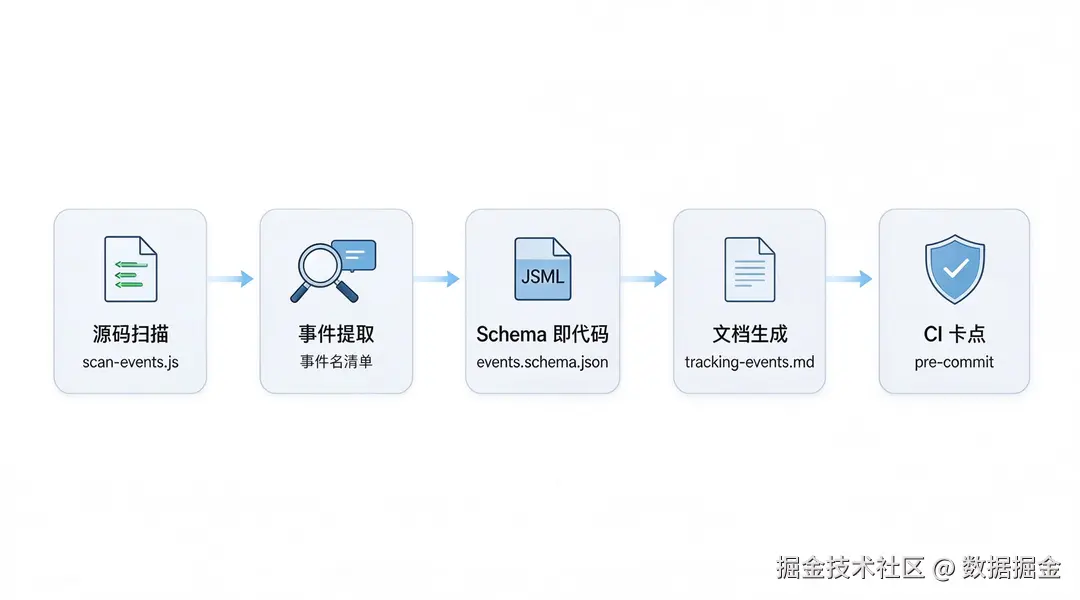
图1 从源码扫描到文档产出、再到 CI 卡点的自动化流水线
为什么手写埋点文档一定会腐烂?
根因是文档和代码住在两个地方。代码在 Git 里有版本、有评审、有 diff,文档在 Wiki 里是一张没人对 diff 的表。改代码顺手,改文档是"另一件事",排期紧张时永远往后排。三个月后回头,文档里一半事件已下线,另一半新事件查无此据。
更隐蔽的问题是属性。事件名错了至少还能搜出来,属性名错了------前端传 goods_id、文档写 itemId------在平台的事件分析里就会落到一个没人认得的字段上,按商品维度下钻全是"未知"。手写文档没有任何机制能发现这种不一致,解决思路不是"把文档写得更勤",而是让文档失去"被手写"的机会。
思路:事件 schema 即代码,文档只是生成物
整个方案的核心是一份 events.schema.json:每个事件叫什么、有哪些必填属性、每个属性是什么类型,都在这一个文件里定义。它和源码一起进 Git、一起过 PR 评审,是埋点口径的唯一信源。Markdown 文档不再人工维护,而是由脚本读这份 schema 渲染出来。代码扫描负责发现"写了但没登记"的事件,校验脚本负责发现"登记了但没按约定传"的属性。
第一步:从源码里静态扫描事件名
先写一个 Node 脚本,递归遍历 src/ 下的源码文件,用正则把上报调用里的事件名抠出来。小程序端无论是微信原生、还是 uniapp / taro 工程,事件调用最终都是一个函数加一个字符串字面量,正则就能覆盖大部分情况。下面是示意脚本:
javascript
// scripts/scan-events.js ------ 示意代码:静态扫描源码中的事件名
const fs = require('fs');
const path = require('path');

// 匹配 trackEvent('event_name', {...})
// 以及封装上报里的 track('event', [分类, 'event_name', {...}])
const PATTERNS = [
  /trackEvent(\s*['"`]([\w:.-]+)['"`]/g,
  /.track(\s*['"`]event['"`]\s*,\s*[\s*['"`][\s\S]*?['"`]\s*,\s*['"`]([\w:.-]+)['"`]/g,
];

function walk(dir, out = []) {
  for (const f of fs.readdirSync(dir)) {
    const p = path.join(dir, f);
    if (fs.statSync(p).isDirectory() && !/node_modules|miniprogram_npm/.test(p)) {
      walk(p, out);
    } else if (/.(js|ts|vue|wxml)$/.test(f)) {
      out.push(p);
    }
  }
  return out;
}

const found = new Map();
for (const file of walk('./src')) {
  const code = fs.readFileSync(file, 'utf8');
  for (const re of PATTERNS) {
    let m;
    while ((m = re.exec(code))) {
      if (!found.has(m[1])) found.set(m[1], new Set());
      found.get(m[1]).add(file);
    }
  }
}
for (const [name, files] of found) {
  console.log(`${name}\t${[...files].join(', ')}`);
}
正则够用但不精确,事件名一旦是变量拼接、或来自后端字典就会漏。更稳的做法是用 Babel 把源码解析成 AST,只取调用表达式的第一个字符串参数。中小体量的小程序工程,正则版先跑起来,AST 版当第二期------重要的是先有一条"机器能拿到事件清单"的通道。
第二步:把事件清单渲染成 Markdown 文档
扫描结果接上模板,就是文档生成命令。在 package.json 里挂几个 script,全程用 CLI 驱动:
shell
# package.json 里约定的命令(示意)
# "scan":  "node scripts/scan-events.js > events.raw.tsv"
# "doc":   "node scripts/gen-doc.js --input events.raw.tsv --output docs/tracking-events.md"
# "check": "node scripts/validate-schema.js"

$ npm run scan
$ npm run doc
$ npx @your-org/gen-tracking-doc --out docs/tracking-events.md
gen-doc.js 做的事很朴素:读 events.schema.json,按分类拼成 Markdown 表格,每行一个事件,列出事件名、说明、必填属性和类型。文档产物提交进仓库,PR 里能直接看到"这次新增了哪两个事件、改了哪个属性类型",评审时顺带把口径也审了。
第三步:事件 schema 校验,必填和类型硬卡
schema 文件长这样(示意):
json
{
  "events": {
    "goods_view": {
      "desc": "商品卡片曝光",
      "required": ["goods_id"],
      "props": { "goods_id": "string", "channel": "string" }
    },
    "add_cart": {
      "desc": "加入购物车",
      "required": ["goods_id", "price"],
      "props": { "goods_id": "string", "price": "number" }
    },
    "pay_done": {
      "desc": "支付成功",
      "required": ["order_id", "amount"],
      "props": { "order_id": "string", "amount": "number" }
    }
  }
}
校验脚本拿扫描结果和 schema 双向比对:扫到了但 schema 里没登记的事件,报"未登记";schema 里有但代码里已经没有的事件,报"疑似下线";运行时封装层再对必填属性和类型做一次检查:
typescript
// scripts/validate-schema.js ------ 示意代码:按 schema 校验上报参数
const schema = require('./events.schema.json');

function validate(name, props = {}) {
  const def = schema.events[name];
  if (!def) return [`未登记事件: ${name}(请先在 events.schema.json 补登)`];
  const errors = [];
  for (const key of def.required || []) {
    if (!(key in props) || props[key] === '') errors.push(`缺少必填属性 ${key}`);
  }
  for (const [key, type] of Object.entries(def.props || {})) {
    if (key in props && typeof props[key] !== type) {
      errors.push(`属性 ${key} 应为 ${type},实际为 ${typeof props[key]}`);
    }
  }
  return errors;
}

// 缺 amount,应报错并以非 0 退出码结束,供 CI 识别
const problems = validate('pay_done', { order_id: 'A100' });
if (problems.length) { console.error(problems.join('\n')); process.exit(1); }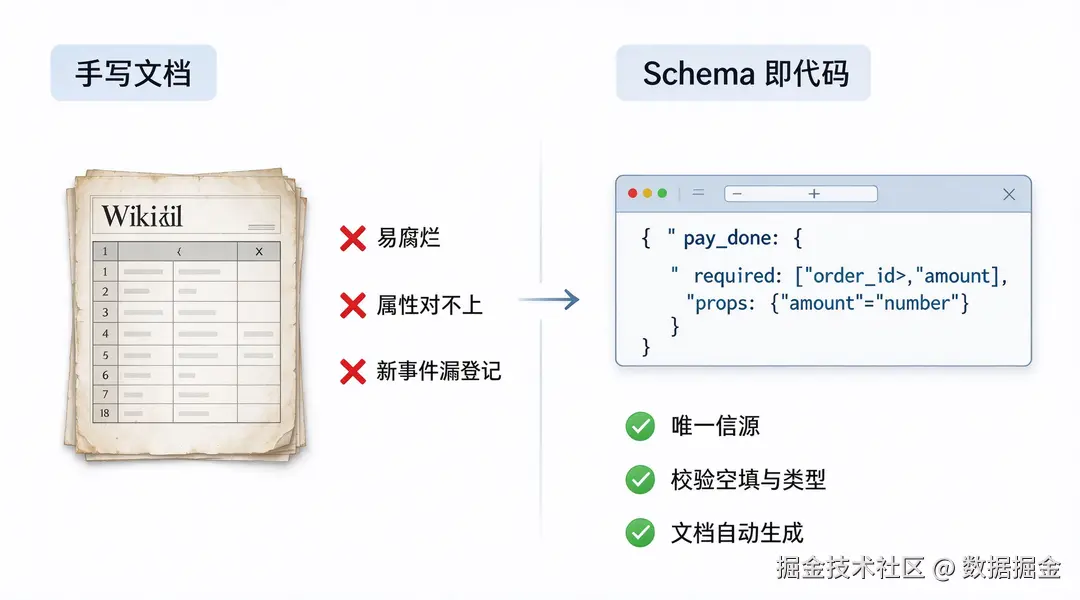
图2 事件 schema 即代码:一份 JSON 同时支撑校验、文档与平台同步
第四步:pre-commit 和 CI 把卡点补上
脚本写好了不挂到流程里,等于没有。本地用 Husky 拦一道,远程在 pull request 上再卡一道:
shell
# .husky/pre-commit ------ 提交前本地校验
#!/usr/bin/env sh
npm run check || {
  echo "✗ 事件 schema 校验未通过:新事件需先登记到 events.schema.json"
  exit 1
}

# .github/workflows/tracking.yml ------ PR 上跑校验并刷新文档(示意)
# on: [pull_request]
# jobs:
#   doc:
#     runs-on: ubuntu-latest
#     steps:
#       - uses: actions/checkout@v4
#       - uses: actions/setup-node@v4
#         with: { node-version: 20 }
#       - run: npm ci
#       - run: npm run check
#       - run: npm run doc
这样一来,"写了事件没登记"在本地提交时就被挡住,而不是等数据同学三周后在看板里发现一个叫 share_click 的幽灵事件。文档则由 CI 在合并时自动刷新,永远和代码同版本。
三种文档生成方式,差别在哪?
| 维度 | 纯手写 Wiki | 半自动扫描+人工补描述 | schema 即代码 + CI 卡点 |
|---|---|---|---|
| 事件来源 | 产品经理在文档里维护 | 脚本扫源码出清单,人补说明 | schema 是唯一信源,扫描结果与之双向比对 |
| 文档腐烂速度 | 快,改代码不改文档 | 中,清单准但描述易过期 | 慢,未登记事件在提交时即被拦 |
| 新事件发现 | 靠人肉对账 | 跑扫描时才发现 | pre-commit / PR 当场发现 |
| 属性校验 | 无 | 文档写了但运行时不查 | 校验脚本硬卡必填与类型 |
| 前期成本 / 后期成本 | 低 / 很高 | 中 / 中 | 搭工具链略高 / 接近零 |
需要说清边界:这套工具链解决的是"文档和代码不一致",不解决"事件该不该埋、口径对不对"------那是需求评审的事。在这类平台上,事件管理与漏斗管理属于常用的埋点治理能力,适合回看已上报的事件定义;要把本地 schema 写回平台,则依赖平台的开放接口。
和平台事件管理同步,怎么接?
schema 成为信源之后,下一步自然是把它推到分析平台的事件管理里,省掉后台手动录入。示意脚本如下,真实端点和鉴权方式以你所用平台的开放接口文档为准:
javascript
// scripts/sync-platform.js ------ 示意:把本地 schema 推送到平台事件管理
async function sync() {
  const schema = require('./events.schema.json');
  const payload = Object.entries(schema.events).map(([name, def]) => ({
    name, desc: def.desc, props: def.props, required: def.required || [],
  }));
  const res = await fetch('https://your-platform.example/api/v1/events', {
    method: 'POST',
    headers: { Authorization: `Bearer ${process.env.PLATFORM_TOKEN}` },
    body: JSON.stringify(payload),
  });
  if (!res.ok) throw new Error(`同步失败: ${res.status}`);
}
sync().catch(e => { console.error(e); process.exit(1); });
这里有个现实约束要交代:各平台开放 API 的档位不同,数据API通常为专业版及以上才开放,是否提供事件管理的写入接口要以各厂商官网功能说明为准。如果接口暂不可用,退一步:脚本只生成结构化 JSON,事件同学照此在后台录入,文档这一侧仍由工具链自动维护。
另外提醒打点地址:接入小程序 SDK 时,server_url 请以控制台"应用列表→埋点代码"页获取的为准,不要照抄教程示例地址,否则上报可能静默失败。微信原生小程序 SDK 含小游戏场景,并提供 uniapp / taro / Wepy 工程可用的版本,扫描脚本的文件后缀按实际框架配齐即可。
常见问题
Q1:静态扫描和运行时上报,哪个更适合生成埋点文档?
A:静态扫描在发版前就能拿到事件清单,不依赖用户真实访问,适合做文档与命名规范校验;运行时上报能看到事件是否真的有流量、属性实际取到了什么值,适合做上线后的验收。两者不冲突:前者负责拦住写错的事件名和漏登记,后者负责确认数据真的上报成功。
Q2:小程序用了 uniapp 或 taro,扫描脚本要注意什么?
A:扫描范围要覆盖编译前的源码目录而不是产物目录,同时把 .vue、.nvue、.ts 都纳入文件后缀;事件调用若被封装进自定义 hook 或 utils,正则要同时匹配封装函数名。taro 工程里页面路径是编译后生成的,不要拿产物里的路径反推源码位置。
Q3:事件 schema 即代码,这个文件该放哪、谁来改?
A:建议放在仓库根目录的 events.schema.json,和源码一起走 Git 评审。新增或修改事件必须同时改这个文件并提 PR,由数据或前端负责人 review。它是埋点文档的唯一信源,文档本身不再手写,改文档等于改这个文件。
Q4:pre-commit 校验会不会拖慢开发体验?
A:校验只做正则扫描和 JSON schema 比对,几百个文件的量级通常在几百毫秒内完成。为避免阻塞,可以先在 pre-commit 只做告警提示,把硬卡点放到 CI 的 pull_request 流程里;本地需要绕过的时候用 --no-verify,但要在 PR 描述里说明原因。
Q5:自动生成的文档能直接同步到平台事件管理里吗?
A:方向上可行:本地 schema 是信源,平台事件管理是消费方,通过平台开放接口把事件定义推上去。但要注意各平台开放 API 的档位与文档成熟度不同,数据API通常为专业版及以上才开放,是否提供事件管理的写入接口要以各厂商官网功能说明为准,落地前先确认接口存在。
数据来源:
- 456数据官网(小程序接入、事件管理与定价说明)
- 微信开放文档《小程序代码构成与开发指南》
- GitHub 官方文档《Conventional Workflows · build-and-test》与 Husky 仓库 README
- MDN Web Docs《fetch()》
总结
小程序埋点文档自动化的本质,是把文档从一份要人维护的 Wiki,变成源码和 schema 的派生产物:Node 脚本扫事件名、JSON schema 定口径、校验脚本卡必填与类型、pre-commit 和 CI 把住提交关。手写文档会随代码一起腐烂,生成物却永远和代码同版本。456数据这类平台按事件名和属性分析,口径齐了,漏斗、路径、留存这些下游分析才有可信的地基。建议先从一个最简单的正则扫描脚本跑起,再逐步补 schema 校验和 CI 卡点,不用一步到位。