🎯 核心结论
这不是神策,但也不是垃圾------它是一个逻辑自洽、参数被实打实"跑"过的老实策略。它有过拟合的影子,但作者用单调性检验、平台效应、否决清单和前视偏差处理,把过拟合压到了相对可控的范围。真正值得学的不是"前7%+行业3只+PB<1.0"这组数字,而是他做参数实验和证伪自己的方法。
很多策略文章只告诉你"我收益多高",这个策略的作者反过来,花了大半篇篇幅告诉你"我试过哪些看起来该改的,结果全是负贡献"。这种把失败实验也摆出来的做法,在量化圈比收益数字本身更稀缺。
关键指标卡片
| 指标 | 数值 |
|---|---|
| 年化收益 | 约20.11%(独立复现口径22.42%,聚宽实测约16.33%~19%) |
| 最大回撤 | 约19.39%(独立复现口径12.94%,聚宽v1实测15.35%) |
| 夏普比率 | 0.927 |
| 胜率 | 0.58 |
| 策略类型 | 价值因子 + 高股息 + 成长因子(多因子月频轮动) |
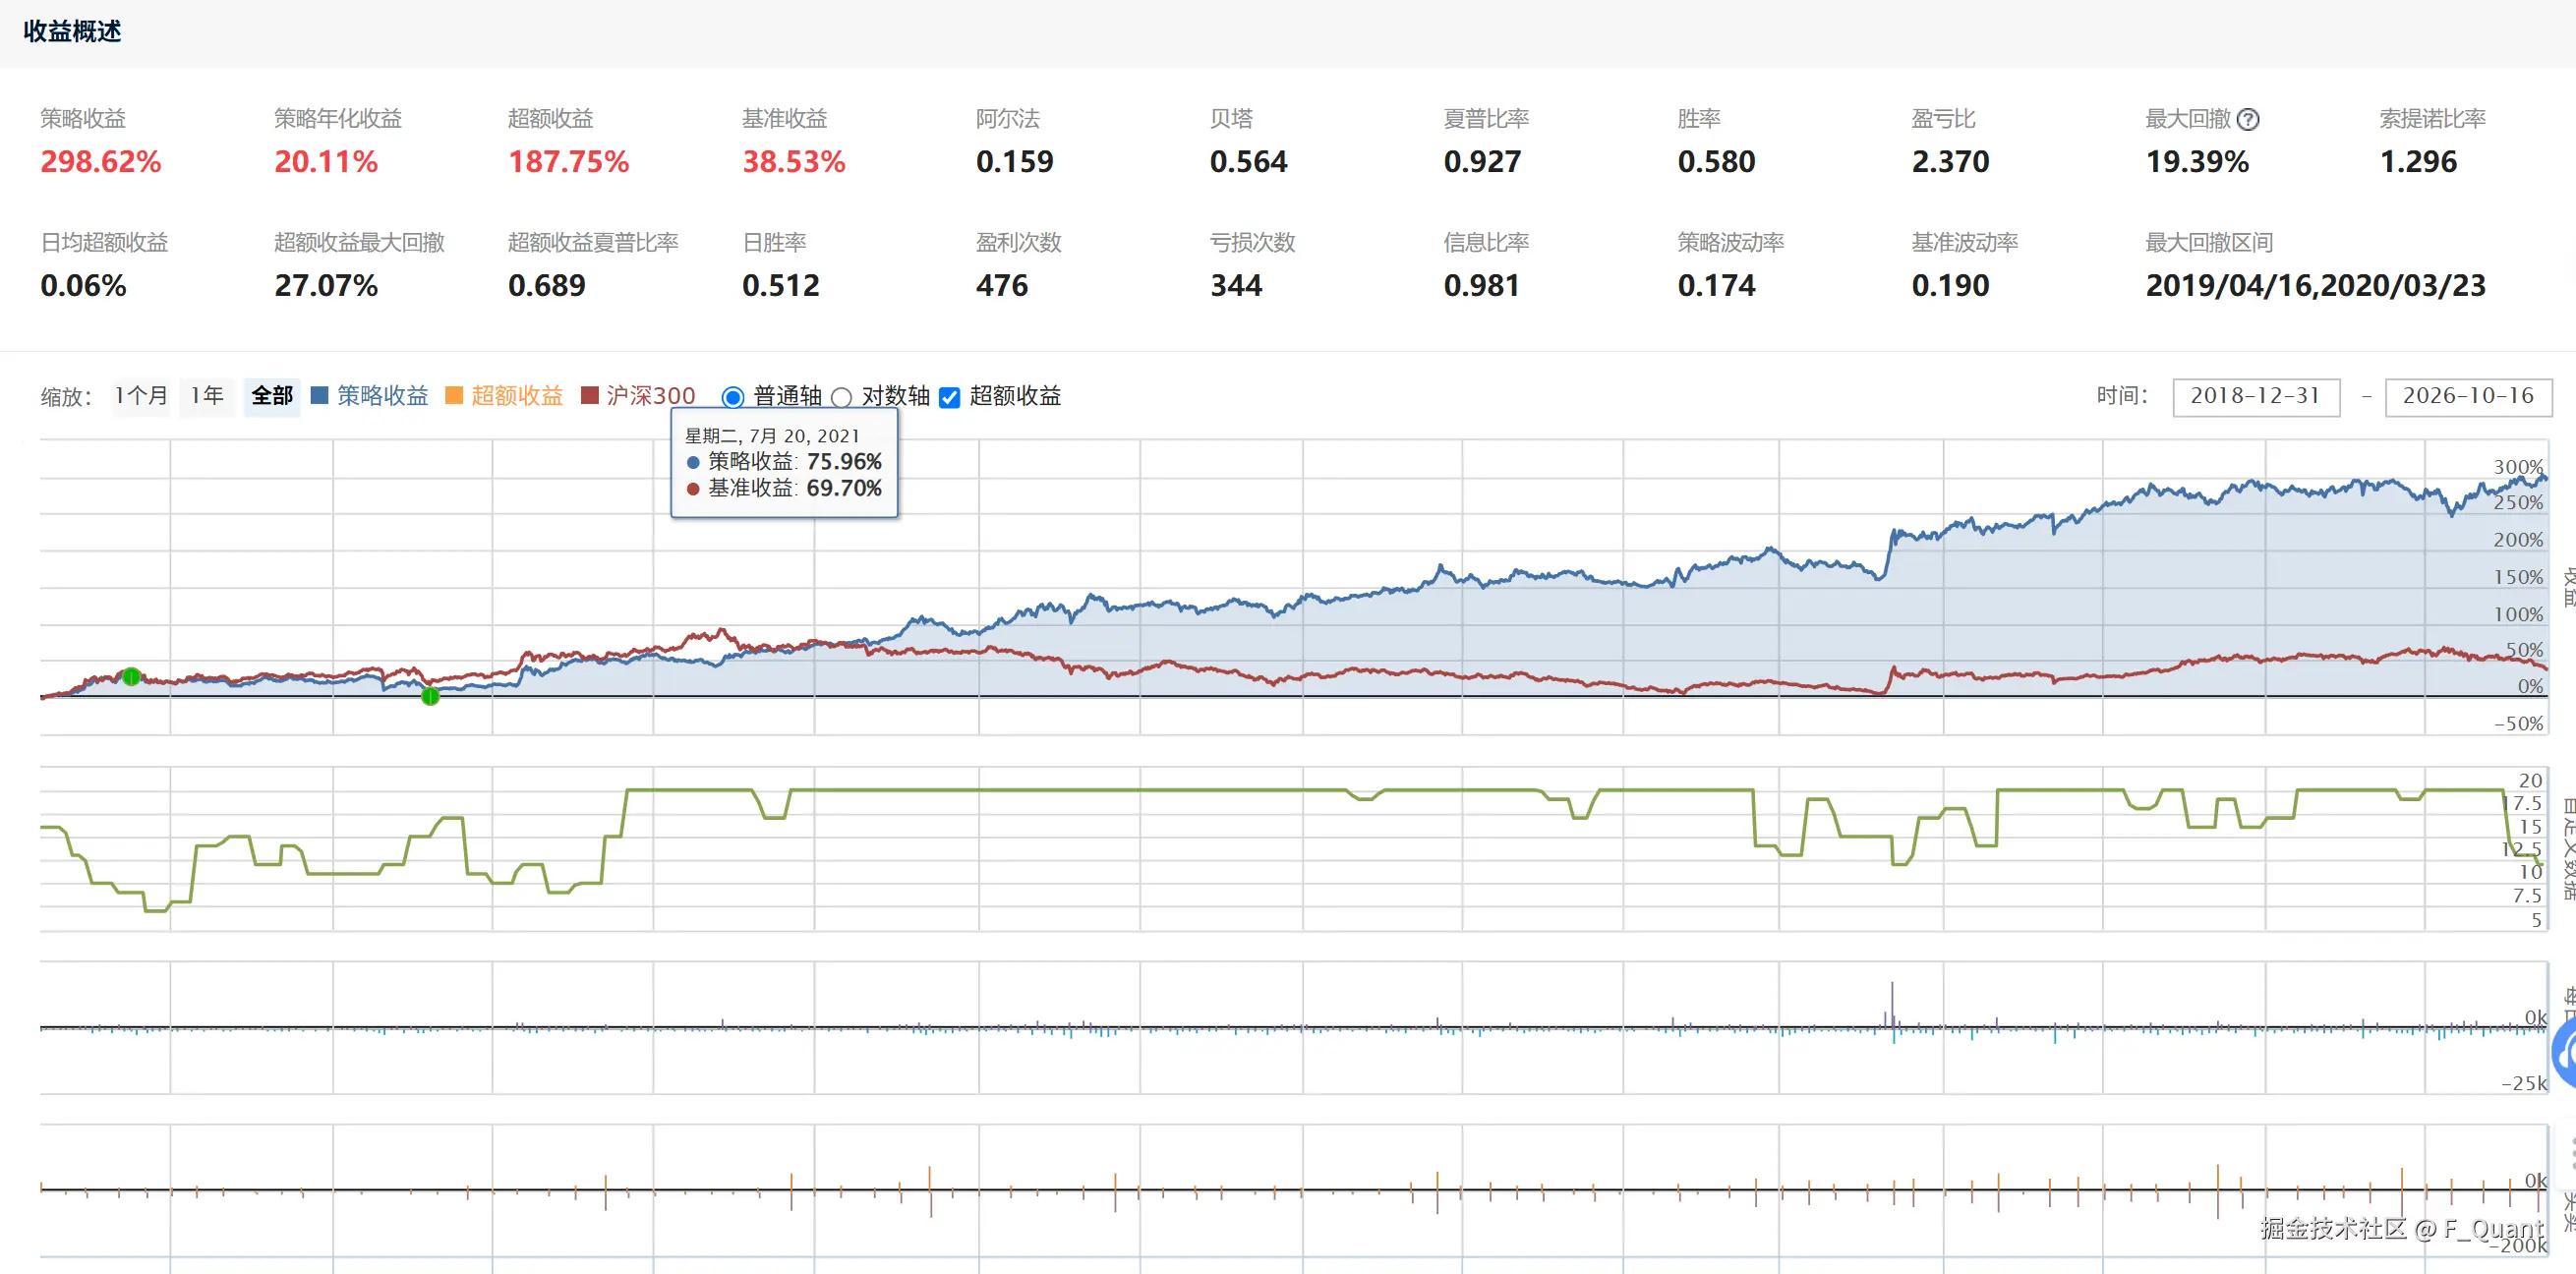
先说清楚一个事:这个策略在不同数据源上跑出来的数字差异不小 。作者自己在文件头就写了,独立复现是22.42%年化/12.94%回撤,聚宽v1实测是16.33%/15.35%,并明确说"残余约3.6pct来自两个数据源的股息率池与增速口径差异"。所以你看到20%上下的年化,先别急着兴奋,重点看的是"与v1的相对提升",而不是绝对数字。这一点作者比大多数策略分享者诚实得多。
先泼一盆冷水:它过拟合了吗?
有嫌疑,而且不能装作看不见。但更准确的说法是:这个策略"有些过拟合",但不算严重;它是"有节制的参数选择 + 较强的过拟合防御意识"。
| 过拟合嫌疑点 | 为什么可疑 | 作者的防御 |
|---|---|---|
| 股息率前7%、行业上限3、PB<1.0 都是扫描出来的 | 多参数在同一个82期样本上择优,天然有选择偏差 | 作者给了单调性表和Calmar平台:前5%~10%的Calmar都是1.75,不是单点最优 |
| PB<1.0被称为"锐利最优" | "锐利最优"本身是过拟合的典型信号------参数稍微一动就变差 | 作者承认0.8会崩、1.2/1.5变差,但没有做更细的邻域稳健性检验 |
| 82个月频调仓期、参数维度不少 | 样本量对多参数策略不算充裕 | 有独立复现和聚宽实跑两套环境对照,并做了差异归因 |
| 因子组合和排序方式也经过比较 | 复合排序键、加质量条件、惰性调仓都被试过并否决 | 否决清单反而说明作者在主动证伪,而不是只挑好看的结果 |
所以,不能断言它没有过拟合,但可以说它的过拟合风险是中等偏低、相对可控的。关键证据不是"年化20%",而是:参数邻域有平台、否决实验有记录、前视偏差被系统性处理、成本建模没有偷懒。
但参数不能照搬。 实盘前建议补三件事:
-
样本外/滚动前推检验:样本外,看参数是否还稳(我直接推到2026了,大家可以往后推,很好)。
-
参数邻域敏感性:前6%/7%/8%、行业2/3/4、PB 0.9/1.0/1.1,看收益是不是断崖式变化。断崖就是过拟合警报。
-
不同数据源复现:聚宽、东财、Wind各跑一遍,看结论是否只在一个数据源成立(建议已聚宽为准)。
这三件事做完,你再去判断"20%"是不是你的20%。
策略原理拆解
一句话概括
全A股里,先按TTM股息率取前7%把池子粗筛一遍,再要求PB<1.0(破净)、PE>0、净利润增速>0,最后按PEG从小到大排序,同一申万二级行业最多3只,凑满20只等权持有,每月第一个交易日调仓。
听起来简单,但选股顺序是这个策略的灵魂,作者专门用数据说明了为什么顺序不能换。
第一步:基础池过滤------先把"不能买的"踢掉
从全A股出发,剔除ST、退市、停牌、上市不足365天的股票。
为什么这么做:ST股和退市股是价值陷阱的高发区,上市不足一年的新股估值数据不稳定。这一步是纯风控,不产生Alpha,但不做会显著放大尾部风险。
细节亮点 :作者明确说不用股票简称判ST ,因为历史快照里的简称显示的是"当前值",按简称判会有前视偏差------某股2021年叫*ST某某,快照里却显示2026年的名称。改用聚宽当日真实的is_st状态。这个坑很多策略都踩过。
第二步:市值门槛------总市值>20亿
为什么这么做:过滤掉微盘股,降低流动性和操纵风险。20亿是个不激进也不宽松的阈值。
第三步:TTM股息率取前7%------这是策略的"粗筛漏斗"
TTM股息率 = 过去365天内已实施分红累计每股派息 / 现价,按股息率降序取前7%。
为什么排在最前面:这是整个策略最关键的顺序设计。作者用真实数据量化了代价------
-
正确顺序(股息率先筛):与独立回测持仓重合度 **100.00%**(1470/1470)
-
错误顺序 (PB/PE/PEG先筛再取前7%):重合度只有 29.12% (428/1470),82期全部不满仓
原因很直白:前7%的分母是"市值达标+非ST+上市满一年"的完整可投池。如果先把PB/PE/PEG三个条件提上来,池子会被榨到只剩100~200只,再取前7%就剩十几只,行业中性约束下几乎永远凑不满20只------策略会变成完全不同的东西。
股息率阈值为什么是7%不是10% :作者给了完整的单调性证据表------前3%年化崩到21.81%(持仓只有8.7只,过度集中),前5%和7%的Calmar都是1.75,前10%年化降到22.74%。7%是"收益/集中度"这个旋钮上的合理位置,不是单点最优。
分红口径的两个保护 :只取plan_progress == '实施方案'(预案状态的分红还没执行,计入就是前视偏差),且股息率>30%视为脏数据剔除。
第四步:破净 + 盈利 + 增速------三道价值阀门
-
0 < PB < 1.0:破净,但不深破净
-
PE(TTM) > 0:排除亏损
-
净利润同比增速 > 0:等价于PEG>0的前提
为什么PB卡在1.0而不是更严的0.8 :这是作者实测定过的红线------PB<0.8年化崩到13.12%、回撤升到18.68%,因为深破净里混着大量"便宜有理"的价值陷阱。放宽到1.2/1.5也只有19.40%/19.56%,PB<1.0是锐利最优。
因子分解结论(这是全文最有价值的数据之一):
| 配置 | 年化 | 最大回撤 |
|---|---|---|
| 仅高股息(不限PB) | 20.51% | 18.63% |
| 仅破净(不限股息率) | 13.28% | 28.73% |
| 两者叠加(本策略) | 20.35% | 14.37% |
读法很清晰:收益来自股息率,破净只是风控阀门。加上破净条件后收益几乎不变(-0.16pct),但最大回撤从18.63%压到14.37%(-4.26pct)。破净条件创造的是风险调整后的收益,不是绝对收益。
第五步:PEG升序排序------这是主排序因子,不是装饰品
最终20只股票是按PEG从小到大挑出来的,股息率只负责把池子粗筛到前7%。
作者原话:"别把它当成'股息率策略'来理解------如果去掉PEG排序,结果会完全不同。"
PEG = PE(TTM) / 净利润同比增速。注意这里的PEG是"当前PE除以单期增速",不是东财那种复合增长率口径,两者符号一致、量级接近,但排序会有细微差别。
第六步:行业中性------同一申万二级行业最多3只
为什么是3只不是2只 :实测数据------上限2只年化23.41%/Calmar 1.67,上限3只年化24.56%/Calmar 1.75,上限5只Calmar降到1.63,不限行业直接崩到Calmar 1.22。3只是风险分散和收益之间的平衡点。
第七步:等权持有20只,每月第一个交易日调仓
池子不足20只时按实际数量等权。调仓用上月末收盘的估值快照,次月首日开盘成交。
成本建模 :买入单边0.125%(佣金0.025%+滑点0.10%),卖出单边0.175%(佣金+印花税0.05%+滑点),平均单边约0.15%。开启了use_real_price,分红送转由引擎按真实价格处理,不用前复权价算收益------作者专门解释了为什么:累计分红超过历史股价时,前复权价会被压缩至趋近0,收益率被极度放大,实测某只股票虚假收益32倍、真实仅10.25倍。
策略逻辑流程图(文字版)
bash
全A股(沪深主板/创业板/科创板)
    │
    ▼
① 剔除 ST / 退市 / 停牌 / 上市不足365天
    │   (用 is_st 当日真实状态,不用简称判)
    ▼
② 总市值 > 20亿
    │
    ▼
③ TTM股息率 > 0,按股息率降序取【前7%】
    │   ★分母是①+②的完整池子,不是全市场
    │   ★只统计"实施方案"分红,股息率>30%剔除
    ▼
④ 0 < PB(MRQ) < 1.0(破净,但不深破净)
    │
    ▼
⑤ PE(TTM) > 0
    │
    ▼
⑥ 净利润同比增速 > 0(等价PEG>0)
    │
    ▼
⑦ 按 PEG 升序排列,逐只录取
    │   同一申万二级行业最多3只
    ▼
⑧ 取满20只,等权持有
    │   池子不足20只按实际数量等权
    ▼
每月第一个交易日 09:30 调仓
    │   使用上月末收盘估值快照
    │   先卖后买,停牌/涨跌停无法成交的保留
    ▼
下一期循环
策略优势
1. 选股顺序有量化证据支撑,不是拍脑袋 作者用82个调仓期的真实数据对比了正确顺序和错误顺序的持仓重合度------100% vs 29.12%,错误顺序82期全部不满仓。这种把"顺序为什么重要"用数字钉死的做法,比单纯说"我觉得应该先筛股息率"有说服力得多。
2. 参数全部经过实测扫描,连"不能改什么"都列出来了 股息率阈值扫了3%/5%/7%/10%/15%/20%,行业上限扫了2/3/5/不限,PB扫了0.7/0.8/1.0/1.2/1.5。更难得的是,作者把实测否决的改动也列出来了------加"连续3年分红"年化崩到11.65%,加"经营现金流>0"降到18.26%,剔除金融行业降到18.36%。这些"负贡献清单"对后来者的价值不亚于策略本身。
3. 交易频率低,成本友好 月频调仓,月单边换手约66%,平均单边成本0.15%。对于10万本金这种体量,整手100股+最低佣金5元的摩擦已经被作者在独立复现里考虑进去了。
4. 风险控制是结构性的,不是事后止损 破净条件把最大回撤从18.63%压到14.37%,行业上限3只防止单一行业过度集中,市值门槛过滤微盘。风控嵌在选股流程里,不需要额外的择时模块。
5. 数据陷阱规避做得细 不用前复权价算收益、分红只取实施方案、不用简称判ST------这三个坑每一个都能让回测收益虚高一大截,作者不仅规避了,还把"为什么"写在了注释里。
策略潜在风险
1. 价值陷阱风险始终存在 破净股里天然混着"便宜有理"的标的。虽然PB<1.0已经比PB<0.8好很多(0.8的年化只有13.12%),但破净本身不是安全垫,只是过滤器。极端行情下,破净股集中暴露在金融、地产、公用事业等传统行业,行业上限3只只能限制单一二级行业,不能完全消除风格集中。
2. 两个数据源的口径差异不可忽视 作者自己标注了:聚宽和独立复现的股息率池、增速口径存在固有差异,残余约3.6pct。这意味着你在聚宽上跑出来的数字,和作者独立复现的数字,本来就不该一样。如果只看绝对收益做决策,容易被数据源差异误导。
3. 小市值+破净的组合在流动性收缩时可能双杀 20亿市值门槛不算高,破净股又往往是市场关注度低的标的。极端流动性环境下,这类股票的卖出冲击成本可能显著高于回测假设的0.10%滑点。
4. 参数有过拟合嫌疑,虽然作者做了单调性检验 股息率前5%~10%是同一个Calmar平台、行业上限3只是局部最优------这些证据降低了过拟合嫌疑,但不能完全排除。82个调仓期的样本量对于多参数策略来说不算特别充裕。
5. 策略容量有限 20只等权、月频、破净+高股息池子,这个策略天然适合小资金。资金量上去之后,20亿市值附近的标的承接不了太大的单笔买入,冲击成本会吃掉相当一部分超额。
策略优化方向
1. 用波动率目标替代固定等权,压回撤 当前是20只等权,每只5%。如果引入组合层面的波动率目标(比如目标年化波动15%),在市场高波动期自动降仓、低波动期满仓,理论上可以在不改变选股逻辑的前提下进一步压回撤。作者已经证明破净条件能把回撤从18.63%压到14.37%,波动率目标是同一方向上的增量工具。
2. 把PEG的增速口径做稳健化处理 当前PEG用的是单期净利润同比增速,单期增速的噪音很大(基数效应、非经常性损益)。如果改用过去8个季度增速的中位数或复合增速,PEG排序会更稳定,减少因单季增速异常导致的错误排序。作者提到独立回测用的是东财PEG_CAR(复合增长率口径),两者排序有细微差别------这个差别本身值得系统性地检验。
3. 股息率池加一个"分红连续性"的软约束,而不是硬过滤 作者实测"连续3年分红"硬过滤年化崩到11.65%,说明硬约束会过度收窄池子。但可以改成软约束:在股息率排序时给连续分红标的轻微加分,而不是直接剔除不连续分红的标的。这样既保留了池子宽度,又利用了分红连续性的信息。
4. 行业上限从"申万二级3只"升级为"二级+一级双层约束" 当前只限制了申万二级行业最多3只,但如果多个二级行业同属一个一级行业(比如银行和保险同属金融),一级行业层面的集中度可能仍然偏高。加一层"申万一级行业最多6只"的约束,可以在不显著影响收益的前提下进一步分散风格风险。
5. 调仓时点做微调实验 当前是每月第一个交易日09:30开盘成交。作者提到独立回测用月末收盘价、聚宽用次月首日开盘,月频下差异很小。但可以系统性地检验"月末最后30分钟"vs"次月首日开盘"vs"次月首日收盘"三个时点的差异------如果月末成交能稳定略优,这是一个零成本的改进。
研究启示:值得学的不是参数,是"证伪流程"
这个策略最值得学的地方,不是"前7%+行业3只+PB<1.0"这组数字,而是作者做研究的方式:
-
把"顺序"当成参数来量化代价------正确顺序100%、错误顺序29.12%,这比说"我觉得应该先筛股息率"强太多。
-
参数扫描看平台,不看单点------前5%~10%是同一个Calmar平台,说明作者知道"单点最优不可信"。
-
主动公布"负贡献清单"------加连续3年分红、加经营现金流、剔除金融、深破净、减少持仓数,全部实测否决。愿意展示失败实验的人,比只展示净值曲线的人可信得多。
-
前视偏差处理很细------分红只取"实施方案"、不用简称判ST、不用前复权价算收益。这三条每一条都能让回测虚高,作者不仅规避了,还写清了原因。
-
成本、整手、最低佣金、数据源差异都交代了------作者明确说聚宽实测和独立复现有约3.6pct残余差异,并给出"v2合理预期18%~19%"。不承诺22.4%,这本身就是反过拟合的姿态。
一句话:参数可以怀疑,实验态度值得学习。 你未必要抄这个策略,但你可以把它的"证伪流程"抄到自己的策略研究里。
总结
这个策略的核心价值不在于20%的年化数字,而在于它展示了一种**"把简单逻辑做扎实"**的范式:选股顺序用数据验证、参数用单调性扫描而不是单点最优、连被否决的改动都列出来供后人参考。高股息提供收益来源,破净提供风控阀门,PEG提供排序精度,行业中性提供分散约束------四个模块各司其职,没有一个是装饰品。
如果你要拿它做实盘起点,建议先做两件事:一是把FACTOR_MODE依次改成'DIV'和'PB'各跑一遍,亲眼看看因子分解结论在自己的数据环境里是否成立;二是拿第一期持仓和作者提供的CSV对照,确认环境配置没走样。策略可以抄,但数据源差异必须自己承担;参数可以怀疑,但实验态度值得学习。
🎁 源码获取
获取策略全部源码(含详细注释、参数说明、FUNNEL诊断日志、因子分解对照表),请关注公众号:量化学习实战笔记 ,后台回复关键词 「捡烟蒂」 即可获取。
源码里不仅有完整可运行的聚宽代码,还保留了作者对每一个参数"为什么这么设、改了会怎样"的实测记录------包括那张"看起来该改但实测全是负贡献"的否决清单。这些东西比代码本身更值钱。
免责声明:本账号所有量化策略和量化技术仅作技术交流和量化思路分享,不构成任何投资建议,据此操作风险自负,本人不承担任何直接或间接责任。