13 · 为什么排除 MoE FFN Tiling 与 Tensor Core
一句话 :计划书里排在前面的两项「收益最大」的优化------MoE FFN 行阻塞 tiling(预期 1.2×)与 Tensor Core(预期 1.5×)------实测后双双判否;判否的根据不是「没写出来」,而是写出来了、跑对了、但没收益 ,且探针给出了为什么(MoE FFN 内存受限、launch 才是真开销)。 前置 :建议先读 第 09 篇 · full-GPU decode、第 11 篇 · 对拍方法论与激活精度对齐。 环境:x86-64 + NVIDIA RTX 5090(sm_120)· 阶段三 30B-A3B MoE(Qwen3-30B-A3B q4:128 专家 / top-8 / dim=2048 / moe_ffn=768 / 48 层)。
一、问题与结论
这是一篇判否的文章。结论先给:
| 项 | 判定 | 依据 | 标注 |
|---|---|---|---|
| MoE FFN tiling | ❌ 判否 | 落地正确(greedy 16/16),但 52→53 tok/s = 1.02× | 实测 |
| dense int8 TC | ❌ 驳回 | 与「float 激活保 greedy」硬约束冲突 | 推算 |
| MoE FFN s16 hi/lo TC | ❌ 判否 | 探针证明 MoE FFN 内存受限,TC 无杠杆 | 实测 |
| CUDA Graph | ✅ 落地 | 19→17 ms = 1.12×,greedy 16/16 | 实测 |
| 真正瓶颈 | --- | 内存读(47%)+ 固定开销(53%),须靠摊多 token | 实测 |
二、计划书当初为什么把它们排前面
《CUDA 迁移计划与验收》未落实项按优先级排序时,默认了一个假设:
decode 的瓶颈是 MoE FFN 的计算量。
在这个假设下,两条优化顺理成章:
| 优化 | 预期 | 依据 |
|---|---|---|
| 3.3 MoE FFN tiling | decode ≥62 tok/s(1.2×) | 提高块内占用、复用共享内存,降访存 |
| 3.1 Tensor Core | decode ≥78 tok/s(1.5×) | 用 int8 mma 替换标量点积 |
问题出在假设本身------它没有被数据验证过。本篇讲的就是:这个假设怎么被一步步证伪。
三、Tiling:落地了、跑对了、但没收益
3.1 落地内容
k_moe_gate_up 原来的形状是:d=2048 → nbG=64 个 K 块,每块一个线程,64/256 线程忙(25% 占用)。
改成行阻塞 fast path:ri = tid / nbG、b = tid % nbG,把块内 256 线程 1:1 映射到 4 行 × 64 K块 = 256 个单元,满占用;归约树 off=nbG>>1..1 与原 butterfly 顺序一致。
c
/* 文件:src/npu/cuda/vllm_cuda_kernels.cu(k_moe_gate_up 的行阻塞分支注释,节选) */
/* Row-blocked mapping (d==2048 -> nbG==64): the block's DC_BLK threads map
 * 1:1 onto the 4 rows x nbG K-blocks (4*64==256), so every thread owns one
 * (row, K-block) integer dot instead of 4 rows over one K-block. This keeps
 * occupancy full (the old shape had only nbG of DC_BLK threads busy) while the
 * per-row reduction tree is unchanged (off=32..1 over the nbG==64 partials),
 * so the float result is bit-identical to the pre-tiling kernel. */
对应的分支代码:
c
/* 文件:src/npu/cuda/vllm_cuda_kernels.cu(k_moe_gate_up,节选) */
if (nbG == (DC_BLK >> 2)) {
    const int ri = tid / nbG;                      /* 行 */
    const int b  = tid % nbG;                      /* K 块 */
    ...
    for (int off = nbG >> 1; off > 0; off >>= 1) {
        if (b < off) { rg[ri][b] += rg[ri][b + off]; ru[ri][b] += ru[ri][b + off]; }
        __syncthreads();
    }
    ...
}
3.2 测试方法(预注册 A/B)
按项目纪律,收益必须用同口径 A/B 量,不能靠理论推导。判定标准是 decode tok/s ≥62(1.2×), greedy 位级一致保持不变。
先验的是正确性 :新 CPU 参考(--stream-n 16)逐 token 对拍,greedy 16/16 一致------ 这验证了「tiling 是位级等价、零数值风险」的声称确实成立。
再量收益:
| 臂 | decode tok/s | 结论 | 标注 |
|---|---|---|---|
| 基线(tiling 前) | 52.0 | --- | 实测 |
| tiling 后 | 53.05 | 1.02× | 实测 |
53.05 vs 52 = 1.02×,远低于 1.2×。 25%→100% 的占用提升,没有换来吞吐。
3.3 判定:判否,并给出「为什么」
占用提升无收益,只有一个解释:k_moe_gate_up 不是计算/占用受限------它要么是内存受限 (读专家权重),要么在 decode 里占比太小。要区分这两者,需要下一个探针。
四、决定性探针:stub 掉整个 MoE FFN
把「到底是不是 FFN 的锅」从猜测变成数据,用了一个时间-only 探针 :加一个环境开关 VLLM_CUDA_STUB_MOE=1,让 decode 跳过 router+gate/up+down,只保留 residual add(输出故意是错的,只量时间)。
开关就在 vc_decode_body 入口读环境变量(同一段代码里还有 ROUTER/GU/ATTN/LMHEAD 四个细粒度 stub):
c
/* 文件:src/npu/cuda/vllm_cuda_kernels.cu(vc_decode_body 的 stub 开关,节选) */
/* Timing probe (time-only, output intentionally wrong): VLLM_CUDA_STUB_MOE=1
 * skips the MoE FFN (router+gate/up+down) to isolate its share of decode. */
static int stub_moe = -1;
if (stub_moe < 0) {
    const char *e = getenv("VLLM_CUDA_STUB_MOE");
    stub_moe = (e && e[0] && e[0] != '0');
}
跳过的实现是「把 residual 直接搬成 FFN 输出」,保证残差加合法、但输出故意错:
c
/* 文件:src/npu/cuda/vllm_cuda_kernels.cu(vc_decode_body 的 stub 分支,节选) */
if (stub_moe) {
    /* Skip the whole MoE FFN (time-only probe). y <- res keeps the
     * residual add well-formed; output is intentionally wrong. */
    k_copy<<<d_blk, DC_BLK, 0, stream>>>(s->d_moe_y, s->d_res, d);
    k_add<<<d_blk, DC_BLK, 0, stream>>>(s->d_x, s->d_res, s->d_moe_y, d);
    continue;
}| 臂 | decode | 拆解 | 标注 |
|---|---|---|---|
| full decode | 19 ms/tok(53.05 tok/s) | --- | 实测 |
| stub MoE FFN | 10 ms/tok(100.97 tok/s) | FFN 之外的部分 | 实测 |
于是 19 ms 被拆成两半:
- MoE FFN ≈ 9 ms(47%) :gate+up+down 的 q4 专家权重读(每 token ~19 MB),内存受限;
- 其余 ≈ 10 ms(53%) :48 层 × ~18 个内核 ≈ ~870 次 launch + M=1 dense GEMM + attention。
结论 :MoE FFN 占一半,但它是内存受限(权重读),不是计算受限。tiling 提高的是计算并行度, 对内存受限的活无效------这就是 tiling 判否的根因。
五、Tensor Core:两处都判否
5.1 dense int8 Tensor Core ------ 被合规审查驳回
dense GEMM(QKV/O/lm_head)走 int8 mma,需要权重/激活对称 int8 量化 。但前一轮已经定死了 「对齐 CPU 用 float 激活 」(第 11 篇)才把 greedy 保住------ int8 激活在 48 层 MoE 上复利累积、破坏 greedy。让 TC 的 int8 激活回来,等于把已修好的精度对齐再拆掉。 所以 dense int8 TC 与「float 激活」这一硬约束冲突,驳回。
5.2 MoE FFN s16 hi/lo 上 int8 TC ------ 被探针判否
MoE FFN 用 s16 激活,可以拆成 hi/lo 两个 int8 精确拼回,是唯一「保精度」的 TC 候选。 但第四节的探针已经证明 MoE FFN 是内存受限 ------TC 优化的是计算吞吐 , 对「权重读占主导」的路径没有杠杆。前提不成立,候选判否。
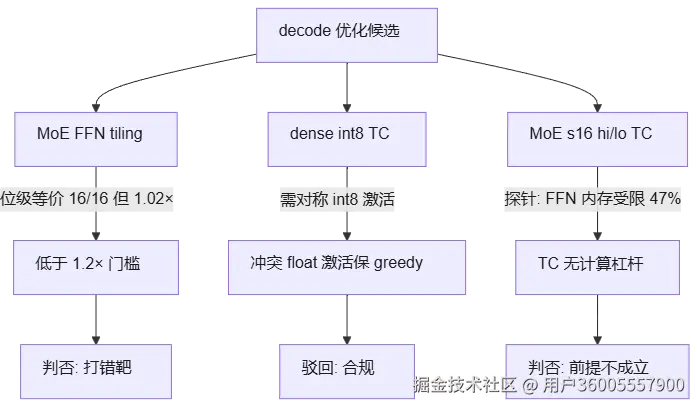
图 1 :这一轮的「判否决策树」。三条被寄予厚望的候选各因不同依据被否------MoE FFN tiling 落地正确(greedy 16/16、位级等价),却只拿到 52→53.05 = 1.02×,低于预注册的 1.2×,判否;dense int8 TC 需要对称 int8 激活,与「对齐 CPU 用 float 激活保 greedy」这条硬约束冲突,被合规驳回;MoE FFN s16 hi/lo TC 虽能精确拼回,但
VLLM_CUDA_STUB_MOE探针证明 FFN 内存受限(9 ms / 47%),TC 优化的是计算吞吐、无杠杆,前提不成立即判否。
六、正确方向:CUDA Graph 压缩 launch
把 53% 的「其余」再往下拆,真正的可优化项不是计算,是 launch 数(~870/token)。 于是用 CUDA Graph 把 decode 的整段内核序列捕获成一张图、每 token replay 一次:
c
/* 文件:src/npu/cuda/vllm_cuda_kernels.cu(vc_decode_graph_capture,节选) */
static int vc_decode_graph_capture(vc_dev_t *s) {
    if (cudaStreamCreate(&s->stream) != cudaSuccess) { cudaGetLastError(); return -1; }
    if (cudaDeviceSynchronize() != cudaSuccess) { cudaGetLastError(); return -1; }
    /* Warmup on the capture stream: materialises any lazy grow-only buffers
     * (e.g. dPart) so capture performs no cudaMalloc/memcpy. */
    if (vc_decode_body(s, s->stream) != 0) return -1;
    if (cudaDeviceSynchronize() != cudaSuccess) { cudaGetLastError(); return -1; }

    if (cudaStreamBeginCapture(s->stream, cudaStreamCaptureModeThreadLocal) != cudaSuccess) {
        cudaGetLastError(); return -1;
    }
    if (vc_decode_body(s, s->stream) != 0) {
        cudaStreamEndCapture(s->stream, &s->graph);
        return -1;
    }
    if (cudaStreamEndCapture(s->stream, &s->graph) != cudaSuccess) {
        cudaGetLastError(); return -1;
    }
    if (cudaGraphInstantiate(&s->gexec, s->graph, 0) != cudaSuccess) {
        cudaGetLastError(); return -1;
    }
    s->graph_ready = 1;
    return 0;
}| 臂 | decode | 结论 | 标注 |
|---|---|---|---|
| 直发(graph off) | 19 ms/tok | --- | 实测 |
| CUDA Graph | 17 ms/tok(57.70 tok/s) | 1.12× | 实测 |
greedy 16/16 保持逐位一致。CUDA Graph 是零数值风险(同一批内核,只是 replay), 它才是这一轮里「按收益排序」真正能落地的东西------虽然也只是 1.12×,而不是 1.5×。
七、方法论收获:先探针,再排序
这次判否的根子是计划书的排序依据错了:默认「MoE FFN 计算是瓶颈」,于是把 「提计算」的 tiling/TC 排在前面。数据推翻了它:
| 假设 | 数据 |
|---|---|
| MoE FFN 是计算瓶颈 | ❌ 内存受限(权重读 19MB/token,占 47%) |
| 提高占用/算力就有收益 | ❌ tiling 25%→100% 占用,吞吐 1.02× |
| launch 开销可忽略 | ❌ ~870 launch/token,CUDA Graph 收掉 ~2ms |
教训:「收益最大」的排序必须由探针定,而不是由直觉定。 tiling 和 TC 都是「写出来、跑对、但没收益」的优化------它们没错,只是打错了靶。
真正能上量级的杠杆,是去摊薄那 47% 的内存读和 53% 的固定开销------ 即投机解码 / batch decode(把 launch + 权重读摊到多 token),而不是继续压单 token 的计算。
八、边界与已知限制
- 收益口径 :52.0 / 53.05 tok/s 是 16-token 轮的量(
--stream-n 16),用于单步收益排序;最终交付口径见 第 15 篇(64-token 的 tok/s 精确值)。 - tiling 只到 1.02×,是「位级等价但无收益」------这类负结果按纪律记档,不落地。
- TC 的判否分两块 :dense int8 TC 是合规驳回 (约束冲突),MoE s16 hi/lo TC 是探针判否(无杠杆),两者依据不同,不能混为一谈。
- stub 探针是时间-only :
VLLM_CUDA_STUB_MOE=1的输出故意是错的,只能用来量时间,不能用来判正确性。 - CUDA Graph 的 1.12× 是在 graph-off 基线之上 ;它的收益随 launch 占比变化(见 第 15 篇),不是恒定值。
CPU 对照(迁移前基线)
- CPU 参考 :
kestrel-llm/src/model/vllm_safetensors.c(函数moe_q4_gu_group_actq16_x86)------ CPU 侧 4 行组 × 32 列的 MoE gate/up 点积,是 tiling 的位级等价目标。 - 迁移要点:CPU 侧按 4 行组 tile 点积 → CUDA 侧 tiling 做到位级等价(greedy 16/16)却只有 1.02× → 判否(FFN 内存受限);dense int8 TC 因与「float 激活保 greedy」冲突被驳回;s16 hi/lo TC 无杠杆。
- 真机验证 :未独立复现:需 30B +
VLLM_CUDA_STUB_MOE探针与 64-token decode 计时。
九、小结(可复用结论)
- 「写出来、跑对、但没收益」也是判否:tiling 位级等价(greedy 16/16)却只有 1.02×,说明它打错了靶,而不是实现错了。
- 先探针再排序 :
VLLM_CUDA_STUB_MOE把 19 ms 拆成 FFN 9 ms + 其余 10 ms,才看出 FFN 是内存受限。 - 内存受限的活,提计算并行度无效:占用 25%→100% 不换来吞吐,就是「瓶颈不在占用」的强信号。
- 约束冲突要让位于硬规矩:dense int8 TC 被驳回,是因为它要拆掉「float 激活」这条保 greedy 的硬约束。
- 真正的杠杆是摊薄,不是压单 token:47% 的内存读 + 53% 的固定开销,要靠投机解码 / batch decode 把成本摊到多 token;单 token 内继续压计算没有量级空间。
相关篇目:第 11 篇 · 对拍方法论与激活精度对齐、第 14 篇 · router 判否与 decode 真瓶颈、第 15 篇 · decode 优化四连击 源码与配套资源:本仓库 gitee.com/pei-xiaogua...; CPU 推理源码 gitee.com/pei-xiaogua...