摘要:本文从一个程序视角出发拆解大模型与传统编程的根本差异:两者跑在同一套硬件上,区别在于程序逻辑的来源------传统编程由人把需求转化为明确的规则,大模型由数据训练拟合出规律并用概率方式输出。读完你会得到一张两者的机制对比、一组最小公式解释,以及一个约 70 行、可复现的 PyTorch 小实验,亲手验证"学出来的规律"和"写出来的规则"差在哪。
标签 :#大模型原理拆解 #大模型 #PyTorch #Transformer
一、问题引入
用大模型和用一个普通软件,感受差别很大:计算器输入 1+1 永远输出 2,可你把同一句话问大模型,两次答案可能不一样。
但如果打开任务管理器,你会发现两者其实都是进程,都跑在同一块 CPU/GPU 上。既然同源,为什么一个"死板",一个"灵活"?灵活的另一面又是什么?
这篇文章只拆解一个核心机制:程序逻辑的来源------它决定了两类程序各自擅长什么、牺牲什么。
二、直觉解释:菜谱 vs 尝过百万道菜的人
传统程序是照菜谱做菜。 菜谱由人写好:先放油、再放盐、火开多大。每一步都明确,同一份食材做出来是同一道菜。菜能不能做,取决于有没有人先把菜谱写出来------没写过的菜,厨房能力再强也做不了。
大模型是尝过百万道菜的人。 没人给他写菜谱,他是靠"吃"(训练)总结出火候、搭配、调味的规律。你让他做一道从没见过的组合,他也能给出个大概味道------因为他做的不是执行规则,而是应用学到的规律。
差异不在厨房(硬件),在逻辑从哪来:一个来自人的大脑,一个来自数据。
再看需求这一侧。传统程序受限于"规则必须人写",所以它擅长的需求有个共同前提:规则明确。而现实里大量需求并不满足这个前提------"把这句话翻译成中文""这段文字语气改得礼貌一点""看看这段日志哪里不对"。这类需求没法用 IF-ELSE 穷举。
于是传统软件发展出一套通用的补偿机制:表单、下拉框、操作手册、权限分级、专业软件的使用门槛。这些设计的本质都是让使用者把自己的需求翻译成程序能接受的明确输入------也就是把"写规则写不出来"的成本,转嫁给用户的操作规范。有些能力甚至连转嫁也解决不了,直接做不出来。
这就是传统程序的经济学:规则明确、安全可控,代价是牺牲一部分用户体验,且对发散/主观/模糊的需求基本无能为力。
大模型走了另一条路:逻辑不由人写,由数据"长"出来。这决定了它接的正是传统程序接不了的那类需求------模糊的、发散的、主观的;同时也决定了它的天然短板:逻辑长在数据里,人就无法把它完整还原成规则,也就无法逐条保证安全。
三、机制拆解
3.1 编程本质上是"找一个函数"
把两类程序都抽象成:y = f(x),给定输入 x,要得到期望输出 y。传统编程和模型训练,是求 f 的两种方法。
方法一:人直接写出 f。
python
def is_positive(text: str) -> int:
    for word in ("好", "棒", "喜欢"):   # 规则由人枚举
        if word in text:
            return 1
    return 0
程序代码本身就是 f 的实现,逻辑显式、可审查、可测试。
方法二:让数据决定 f。 大模型的做法是先搭一个带海量可调参数 θ 的网络结构(函数族),再用训练找一组 θ,使模型输出尽量贴合数据中的规律:
scss
θ* = argmin Σ L(model_θ(x_i), y_i)θ:网络的全部参数(权重/偏置),大模型可达千亿量级;(x_i, y_i):训练语料里的一对输入与目标输出;L:损失函数,衡量"模型猜的"和"数据里的答案"差多少。
训练完成后,程序逻辑就住在 θ 里,而不是住在某段 if-else 里。这就是"在海量数据中查找规律"的工程含义。需要说明:网络结构本身也是人设计的(如 Transformer),但结构只是"模板",具体规律由参数承载、由数据决定。
3.2 训练与推理:一次性 vs 每次
大模型的两个阶段------训练 (在数据中查找规律)与推理(把规律应用到实际输入)------成本形态完全不同:
- 训练:离线、一次性、重投入。消耗大量算力与数据,产出一组 θ。
- 推理:在线、每次请求都发生。拿 θ 对当前输入做一次前向计算,输出结果。
传统程序没有训练阶段,开发阶段写完逻辑后,运行只是执行。所以两类程序的"贵"贵的地方不同:大模型贵在先学会,传统程序贵在先想清楚。
3.3 输出为什么是概率:softmax 与温度
传统程序的输出是查表式的确定值。大模型每一步输出的是一个概率分布:网络最后一层对词表里每个候选 token 打一个分数(logit),再经 softmax 转成概率:
scss
P(token_i) = exp(z_i) / Σ_j exp(z_j)z_i:模型给第 i 个候选 token 的分数,分数高 → 概率大;- 分母对全词表求和,保证所有概率加起来等于 1。
分数怎么来的?------3.1 节那组由数据决定的 θ。分数意味着什么?------"数据里出现这种情况时,答案通常是它"。所以不确定不是 bug,是"规律是统计出来的"的直接推论。
工程上还叠加了一个可控的随机旋钮------采样温度 T:T 趋近 0 时几乎总输出最高分 token(近似确定),T 越大低分选项越有机会(输出越发散)。"同一问题两次答案不同",正是这层采样机制在起作用。
3.4 数据流对比
图 1:传统程序与大模型的数据流对比
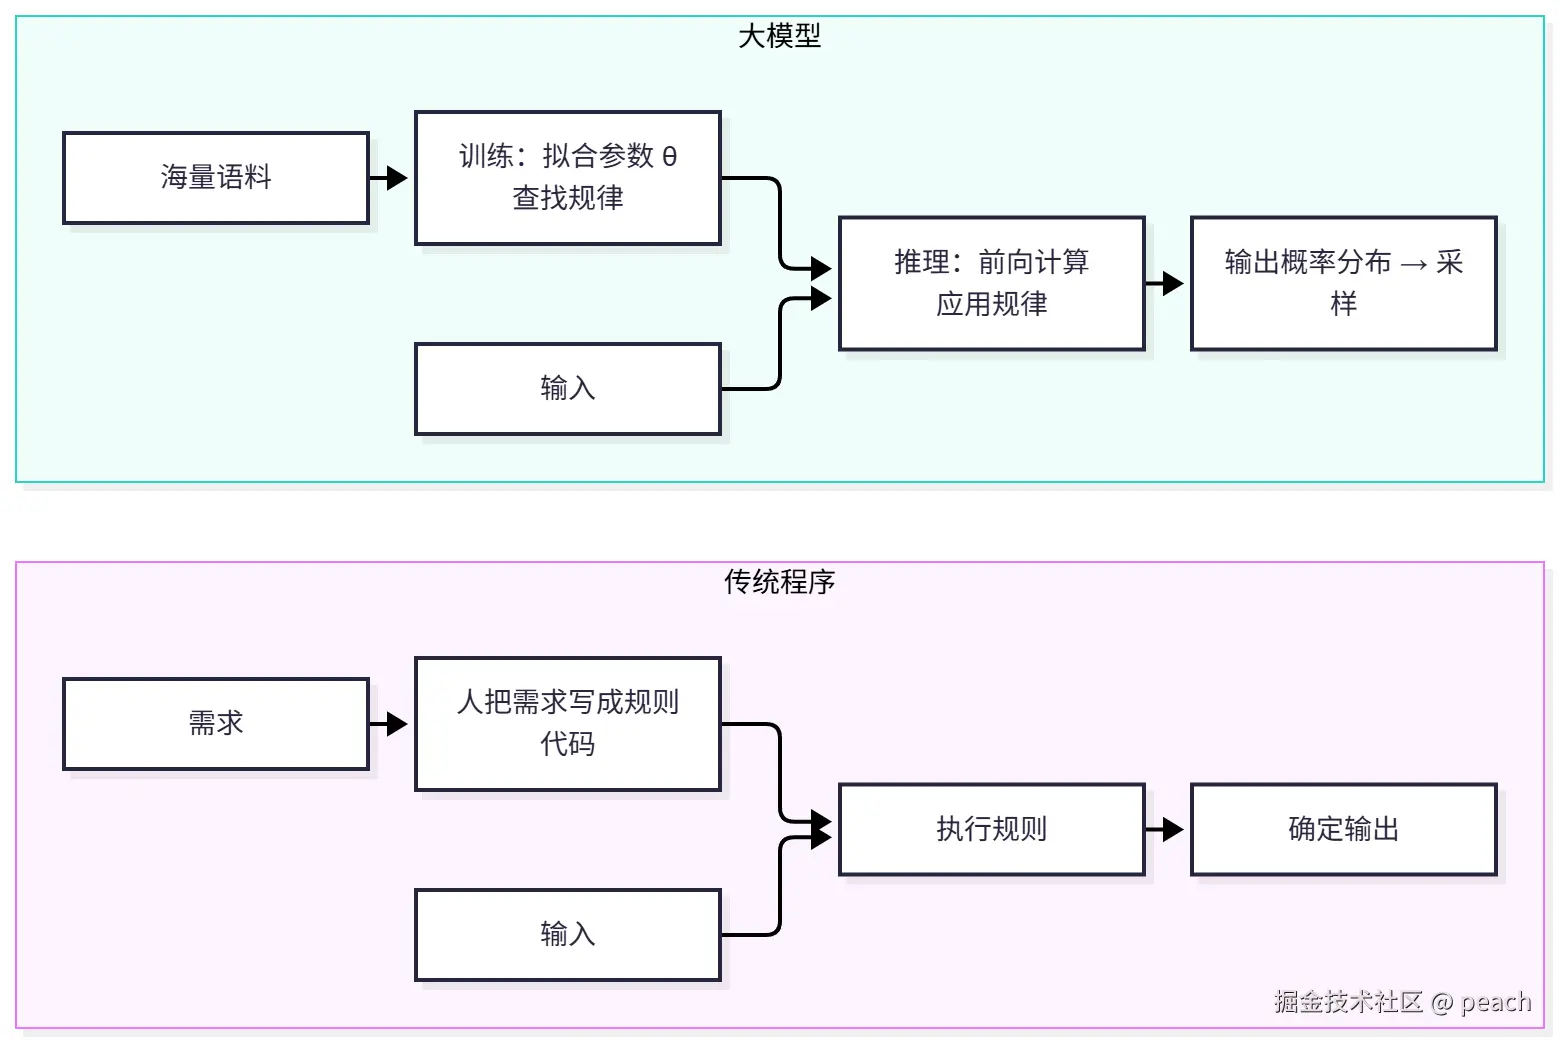 图 1 解读:上半幅,逻辑在开发期由人写入代码,运行期"输入过规则、出确定结果";下半幅,逻辑在训练期由数据写入参数,推理期"输入过模型、出概率分布再采样"。两者都在计算机上跑,差别只在逻辑的来源(人 vs 数据)与输出的形态(确定值 vs 概率)。
表 1:两类程序对比
| 维度 | 传统程序 | 大模型 |
|---|---|---|
| 逻辑来源 | 人把需求转化为规则 | 数据中拟合出的规律 |
| 逻辑载体 | 代码(显式、可审查) | 参数 θ(隐式、难还原) |
| 输出形态 | 同输入 → 同输出 | 同输入 → 概率分布 + 采样 |
| 擅长需求 | 规则明确 | 发散 / 主观 / 模糊 |
| 用户体验代价 | 用户适应程序(规范、门槛) | 程序适应用户,但结果需校验 |
| 可控性 | 强 | 弱,需外部机制约束 |
四、小实验:约 70 行代码,亲手对比"写规则"与"学规律"
4.1 实验设计
复现本文核心论点:给"写规则的程序"和"学规律的小网络"各看同一批标注数据,然后专门用训练里从没出现过的说法去问它们------
- 规则程序:用 IF-ELSE 写的情感判断,遇到没枚举过的词就失灵;
- 学规律程序:用与 3.1 节同款的"参数拟合函数"(两层 MLP + softmax 输出概率),看它能否泛化出没教过的说法。
4.2 环境依赖与运行步骤
Python >= 3.9
torch >= 2.0
bash
pip install torch
python llm_vs_traditional.py
4.3 完整代码
python
# llm_vs_traditional.py
# 验证: "人写的规则" 与 "从数据学出的规律" 在面对没见过的说法时, 表现差异在哪
# 环境: Python >= 3.9, torch >= 2.0 (pip install torch)

import torch
import torch.nn as nn

# ---------- 第 1 步: 一批"训练语料"(词 -> 情感标签) ----------
TRAIN = [
    ("这个产品真好用", 1), ("感觉很棒", 1), ("我太喜欢它了", 1),
    ("质量不错值得推荐", 1), ("体验良好", 1), ("非常好", 1),
    ("太难用了吧", 0), ("有点糟糕", 0), ("不太喜欢", 0),
    ("问题很多很差", 0), ("体验不行", 0), ("非常失望", 0),
]
WORDS = sorted({w for s, _ in TRAIN for w in s})
W2I = {w: i for i, w in enumerate(WORDS)}

def encode(text):
    # 每个句子编成一个词表长度的 0/1 向量(词袋, 不区分顺序)
    v = torch.zeros(len(WORDS))
    for w in text:
        if w in W2I:
            v[W2I[w]] = 1.0
    return v

# ---------- 第 2 步: 传统程序 ------ 人写规则 ----------
RULES = ("好", "棒", "喜欢")                 # 规则由人枚举, 对应 3.1 节方法一

def rule_program(text):
    return "正面" if any(r in text for r in RULES) else "负面"

# ---------- 第 3 步: 学规律 ------ 最小版"参数拟合函数" ----------
# 对应 3.1 节方法二: 网络提供函数形状, 参数 theta 由训练(数据)决定
class Tiny(nn.Module):
    def __init__(self, n_in):
        super().__init__()
        self.net = nn.Sequential(nn.Linear(n_in, 16), nn.ReLU(), nn.Linear(16, 2))

    def forward(self, x):
        return self.net(x)                   # 输出 2 个分数(logit)

model, data, label = Tiny(len(WORDS)), torch.stack([encode(s) for s, _ in TRAIN]), \
    torch.tensor([t for _, t in TRAIN])
loss_fn, opt = nn.CrossEntropyLoss(), torch.optim.Adam(model.parameters(), lr=0.05)

for epoch in range(300):                     # "训练": 在数据中查找规律
    opt.zero_grad()
    loss = loss_fn(model(data), label)
    loss.backward()
    opt.step()

def learned_program(text):                   # "推理": 应用查找到的规律
    with torch.no_grad():                    # 只读取结果, 不需要梯度
        probs = torch.softmax(model(encode(text)), dim=-1)  # 3.3 节: 分数 -> 概率
    return ("正面" if int(probs.argmax()) == 1 else "负面"), float(probs.max())

# ---------- 第 4 步: 用训练里【没出现过】的说法同时问两者 ----------
TESTS = ["感觉很好", "不太好的体验", "这个真不错", "糟糕透了"]
print("句子            | 规则程序 | 学出来的模型(概率)")
for t in TESTS:
    lab, p = learned_program(t)
    print(f"{t:<14} | {rule_program(t):^6} | {lab} ({p:.2f})")
4.4 预期输出示例
scss
句子            | 规则程序 | 学出来的模型(概率)
感觉很好         |   正面   | 正面 (1.00)
不太好的体验      |   正面   | 负面 (0.99)
这个真不错       |   负面   | 正面 (1.00)
糟糕透了         |   负面   | 负面 (1.00)
(以上为真实运行输出;概率数值随随机初始化在 0.98~1.00 间略有浮动,方向性结论稳定。)
4.5 结果解读
- 第 3 行"这个真不错":规则程序没枚举过"不错",判成负面------这就是"需求是发散的,规则写不完"。
- 第 2 行"不太好的体验":规则程序看到"好"字就判正面------规则不懂上下文,而学出来的模型因为见过"不+喜欢""不太"这类搭配模式,判对了。
- 模型输出的不是 0/1 而是概率(0.99、1.00),正对应 3.3 节:它给的是"数据里这种情况通常是什么"的可信度,不是保证。这个玩具例子只有 12 条语料、词表极小,模型很容易"吃透",所以概率普遍接近 1;真实大模型面对开放输入时,概率分布会明显分散得多------那才是"不确定性"的日常形态。
五、边界与误区
5.1 边界:大模型不是来取代传统程序的
大模型与传统程序是互补关系,而不是取代关系。理由在机制层面,而不只是直觉:
- 概率输出干不了确定性的活。 账务计算、订单库存、权限校验要求同输入同输出、可审计、可回滚。把这类逻辑交给概率模型,等于用"通常是对的"替代"保证是对的"。所以真实的工程形态是分层:大模型在外层处理模糊需求,传统程序在内层执行精确逻辑(函数调用/工具调用就是这种分工的典型机制)。
- 训练一次、推理每次意味着每次使用都在"重新应用规律",规律有没有覆盖你的场景,取决于数据;线上行为需要持续评测,这与传统程序"测试通过即稳定"是两套维护逻辑。
5.2 常见误区
- 误区一:"传统程序=确定性,大模型=不确定性"是根本分界。 更准确的分界是规则显式还是隐式。传统程序里也有伪随机数、哈希、加密这类非确定输出;而大模型在贪心解码/温度趋 0 时近似确定。确定性是工程要求,不是两类程序的血缘差异。
- 误区二:"大模型天生处理模糊需求"是因为它"懂"。 模型并没有把需求理解成人的意图,它对模糊输入的适配来自训练数据中的统计规律------说它在"查找规律"比说它在"理解"更贴近事实。模糊需求能接住,是泛化的结果,不是理解的证据。
- 误区三:给软件加"操作规范/门槛"是多余的坏设计。 那是把模糊需求翻译成明确接口的工程手段,是用用户成本换确定性。理解了这一点,才能看懂为什么大模型交互范式(直接说人话)是成本转移,而不只是"更智能"。
- 误区四:互补意味着各占一半。 现实中边界在移动:过去必须由人写规则实现的功能(正则匹配、规则引擎兜底),现在有模型参与方案;但只要业务需要可审计的确定性,传统程序那一层不会消失。
系列内链
- 下一篇预告:【大模型原理拆解】系列将从本文的"概率输出"出发,拆解大模型到底在做什么------从"预测下一个 token"开始。