经常用 asciidoctor 进行写作和记笔记的,所以需要把从 AI 粘贴的 Markdown 内容转成 asciidoc 格式。目前用到的转换方法有两种:
- 让 AI 进行转换,问题是需要进行多次会话才可以达到想要的效果。
- 自己写个转换的功能,下面代码步骤为:
- 预处理将公式用特殊字符占位,分为块公式和行内公式两种情况。
- 用
pandoc进行 Markdown 到 asciidoc 要格式转换。 - 将 特殊字符占位还原为 AsciiDoc 的 stem 公式语法
- 清理 pandoc 强加的字符
- 消除多余空行
- pandoc 的相应文档
- 使用 pandoc 进行转换 github.com/jgm/pandoc
- 安装 pandoc: github.com/jgm/pandoc/...
- 卸载 pandoc: github.com/jgm/pandoc/...
python
import subprocess
import re

# 获取当前节点的内容
p = c.p
markdown_text = p.b

try:
    math_blocks = []
    math_inlines = []

    # 1. 预处理:使用纯字母数字占位符
def block_replacer(match):
    math_blocks.append(match.group(1).strip())
    return f"\nMATHTOKENBLOCK{len(math_blocks) - 1}XYZ\n"

markdown_text = re.sub(r'\\\[\s*(.*?)\s*\\\]', block_replacer, markdown_text, flags=re.DOTALL)

def inline_replacer(match):
    math_inlines.append(match.group(1).strip())
    return f"MATHTOKENINLINE{len(math_inlines) - 1}XYZ"

markdown_text = re.sub(r'\\\(\s*(.*?)\s*\\\)', inline_replacer, markdown_text)

# 2. 传给 Pandoc
result = subprocess.run(
    [
        "pandoc",
        "-f", "markdown",
        "-t", "asciidoc",
        "--wrap=none",
    ],
    input=markdown_text,
    capture_output=True,
    text=True,
    encoding="utf-8",
    check=True,
)

adoc_content = result.stdout

# 3. 后处理:还原为 AsciiDoc 的 stem 语法
for i, content in enumerate(math_blocks):
    placeholder = f"MATHTOKENBLOCK{i}XYZ"
    adoc_content = adoc_content.replace(placeholder, f"[stem]\n++++\n{content}\n++++")

for i, content in enumerate(math_inlines):
    placeholder = f"MATHTOKENINLINE{i}XYZ"
    adoc_content = adoc_content.replace(placeholder, f"stem:[{content}]")

# 4. 清理和排版优化
adoc_content = re.sub(r' \+\n', '\n', adoc_content)           # 清除行尾加号
adoc_content = adoc_content.replace("{plus}=", "+=")
adoc_content = adoc_content.replace("{plus}", "+")

# 5. 核心:将 3 个或以上的连续换行符压缩为标准的 2 个,消除多余空行
adoc_content = re.sub(r'\n{3,}', '\n\n', adoc_content)


    # 创建子节点存放结果
    new_p = p.insertAfter()
    new_p.h = f"Converted: {p.h}"
    new_p.b = adoc_content

    c.redraw()
    g.es("转换成功!已完美解决公式转义与空行过多的问题。")

except subprocess.CalledProcessError as e:
    g.es(f"Pandoc 转换失败: {e}\n{e.stderr}")

except Exception as e:
    g.es(f"发生错误: {e}")
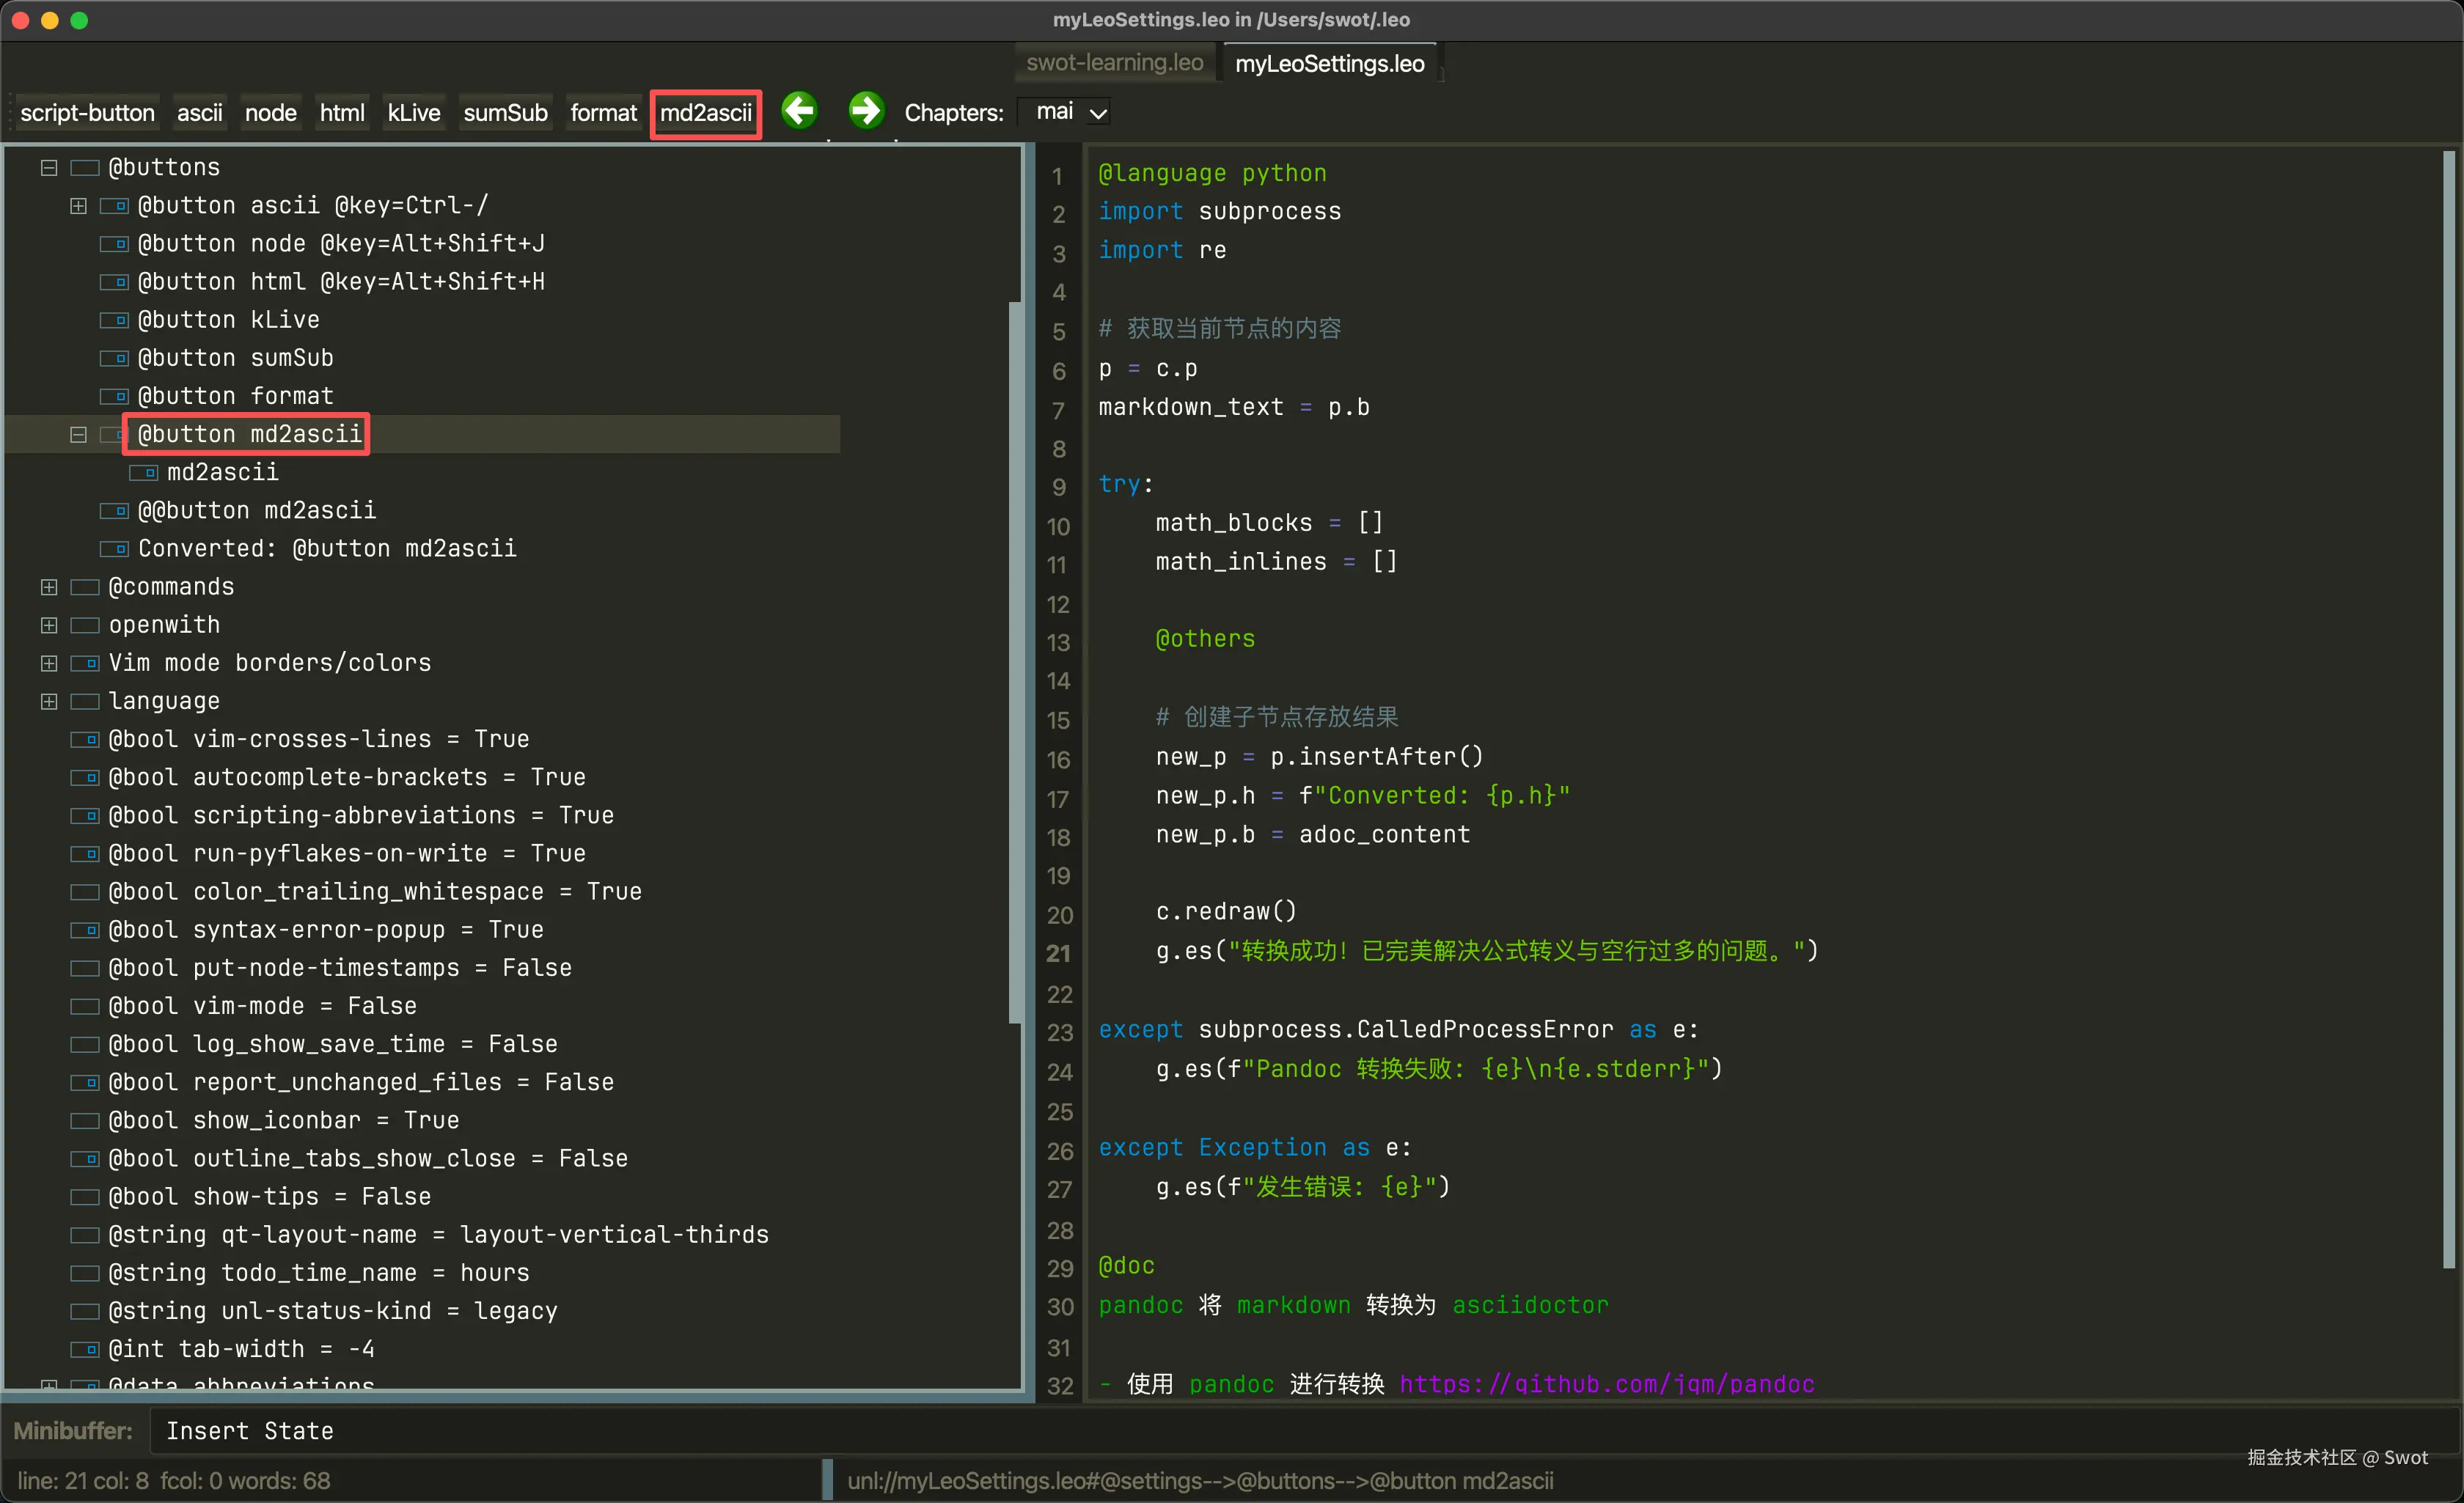
我是用 leo-editor 进行知识管理的,所以在 myLeoSettings.leo 中创建了全局的 script-button`,如下图:
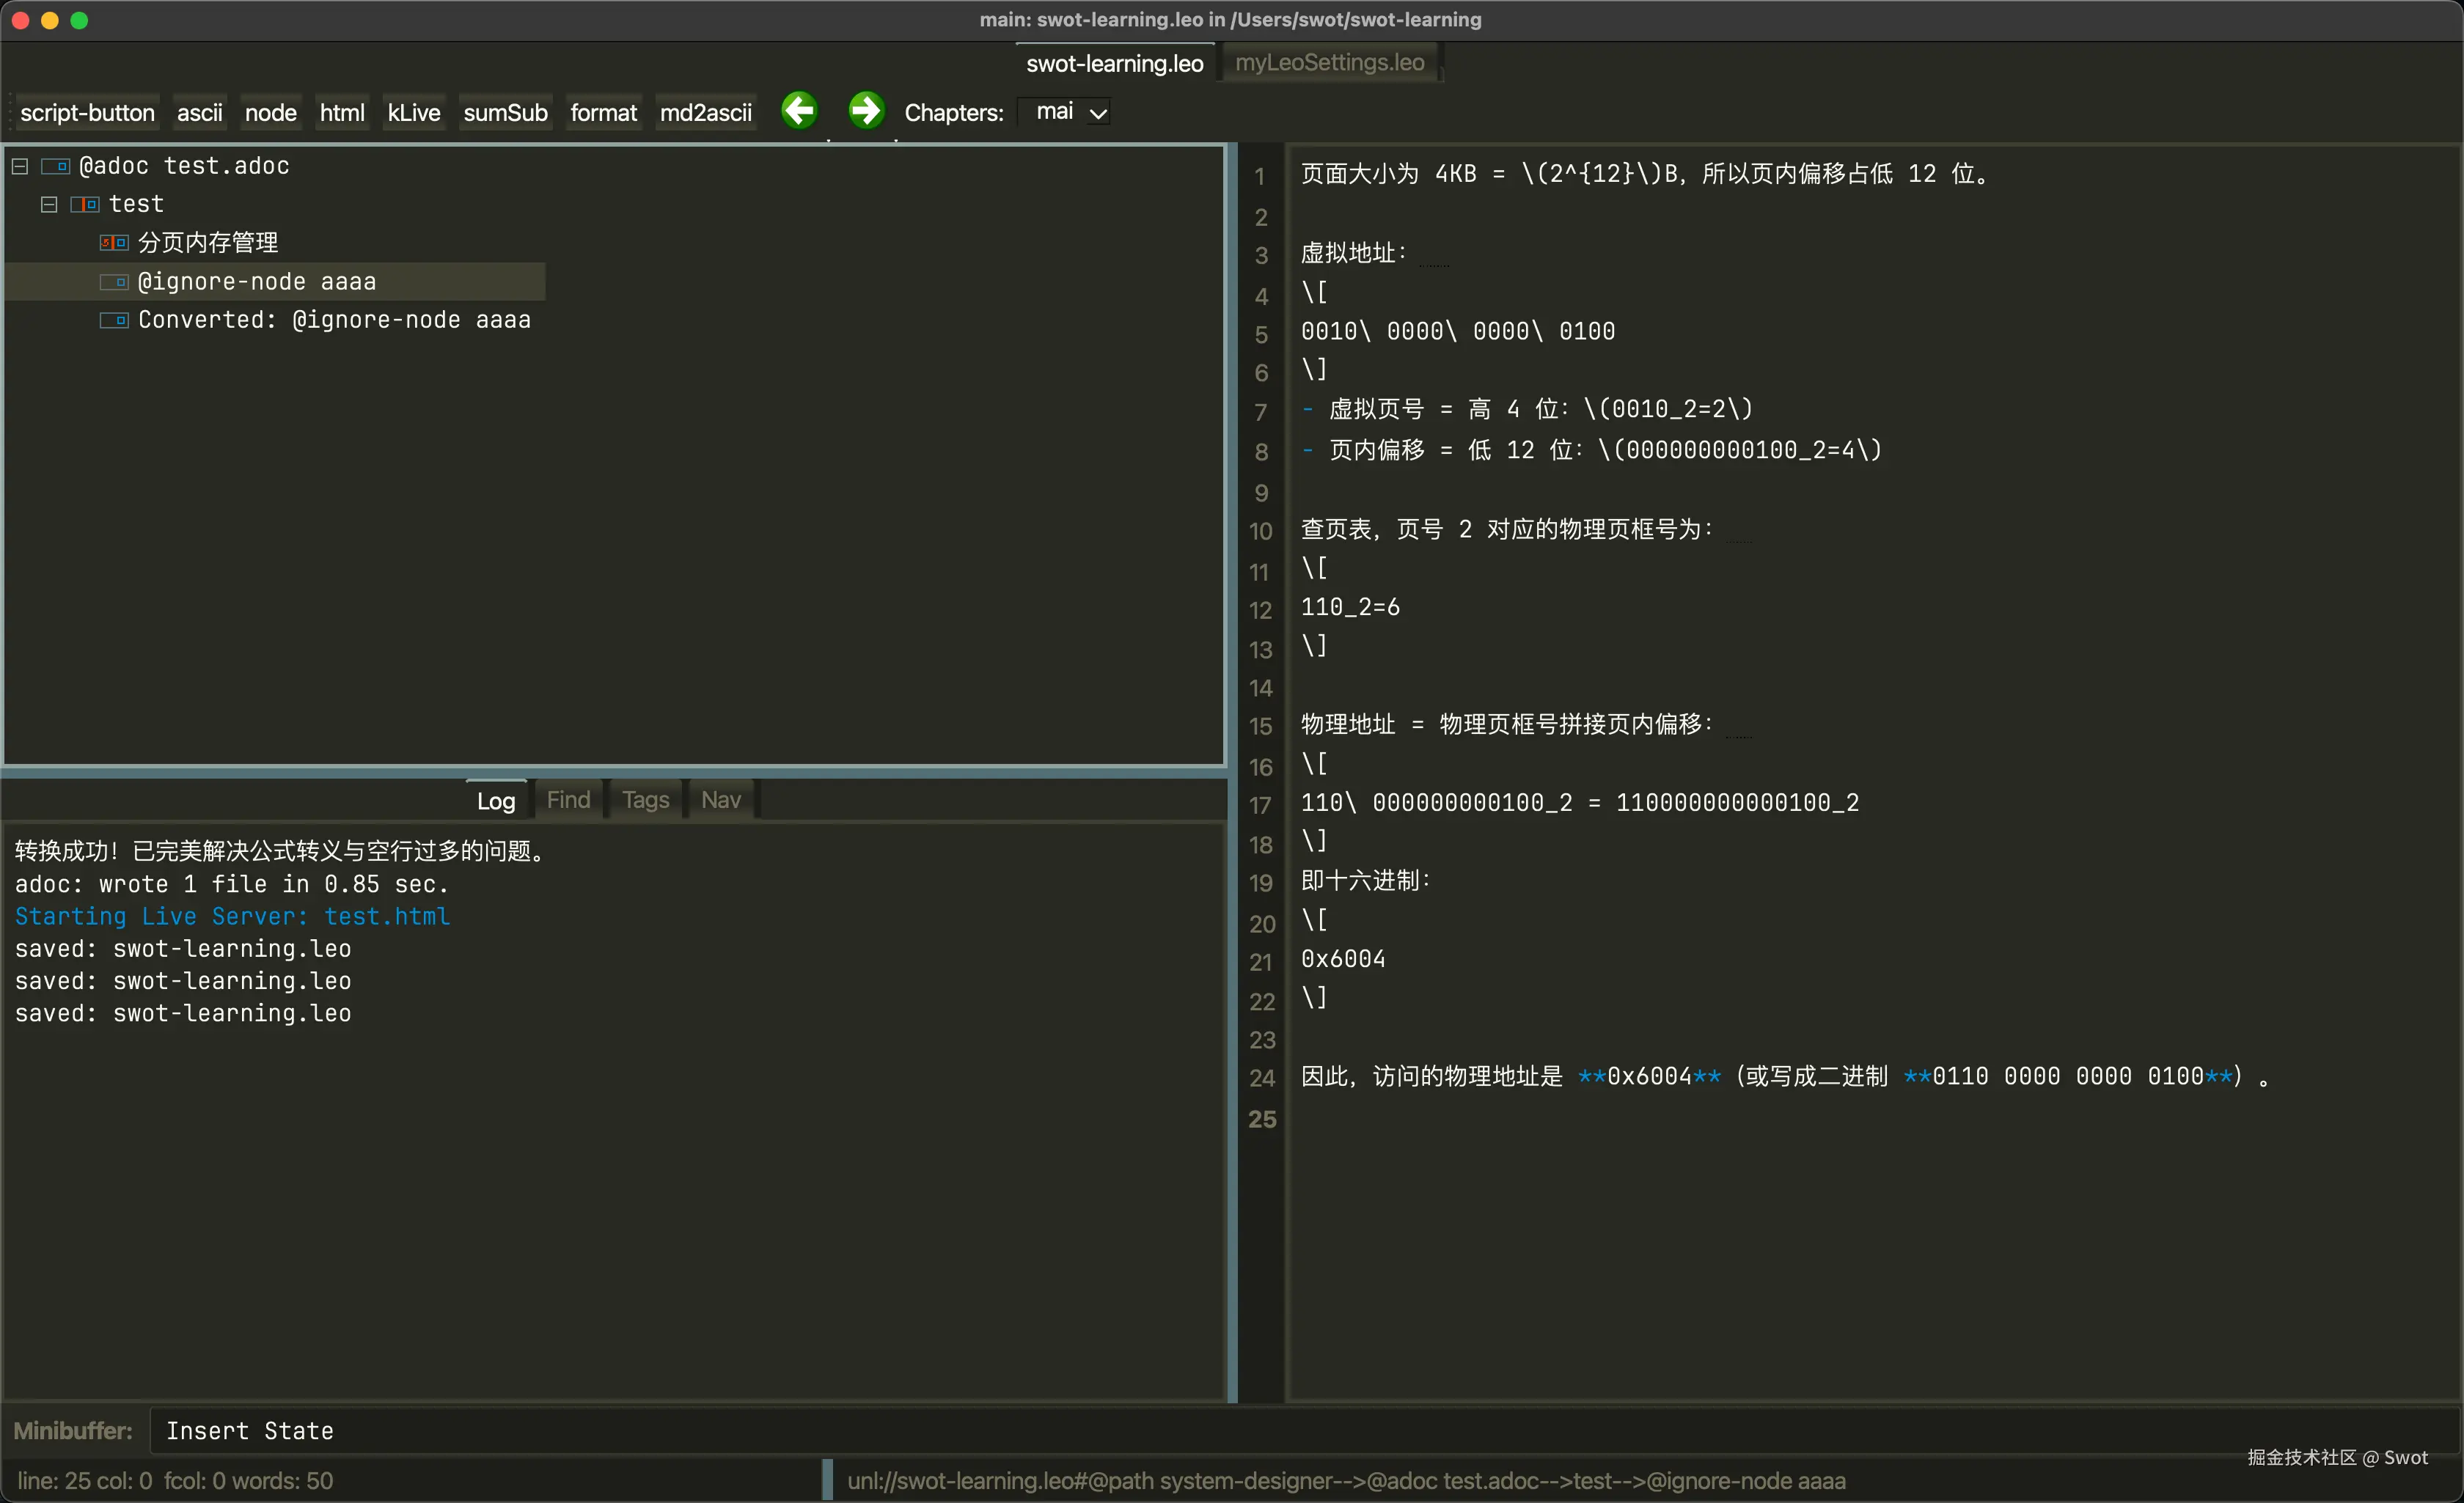
需要进行转换的 markdown 内容节点如下图:
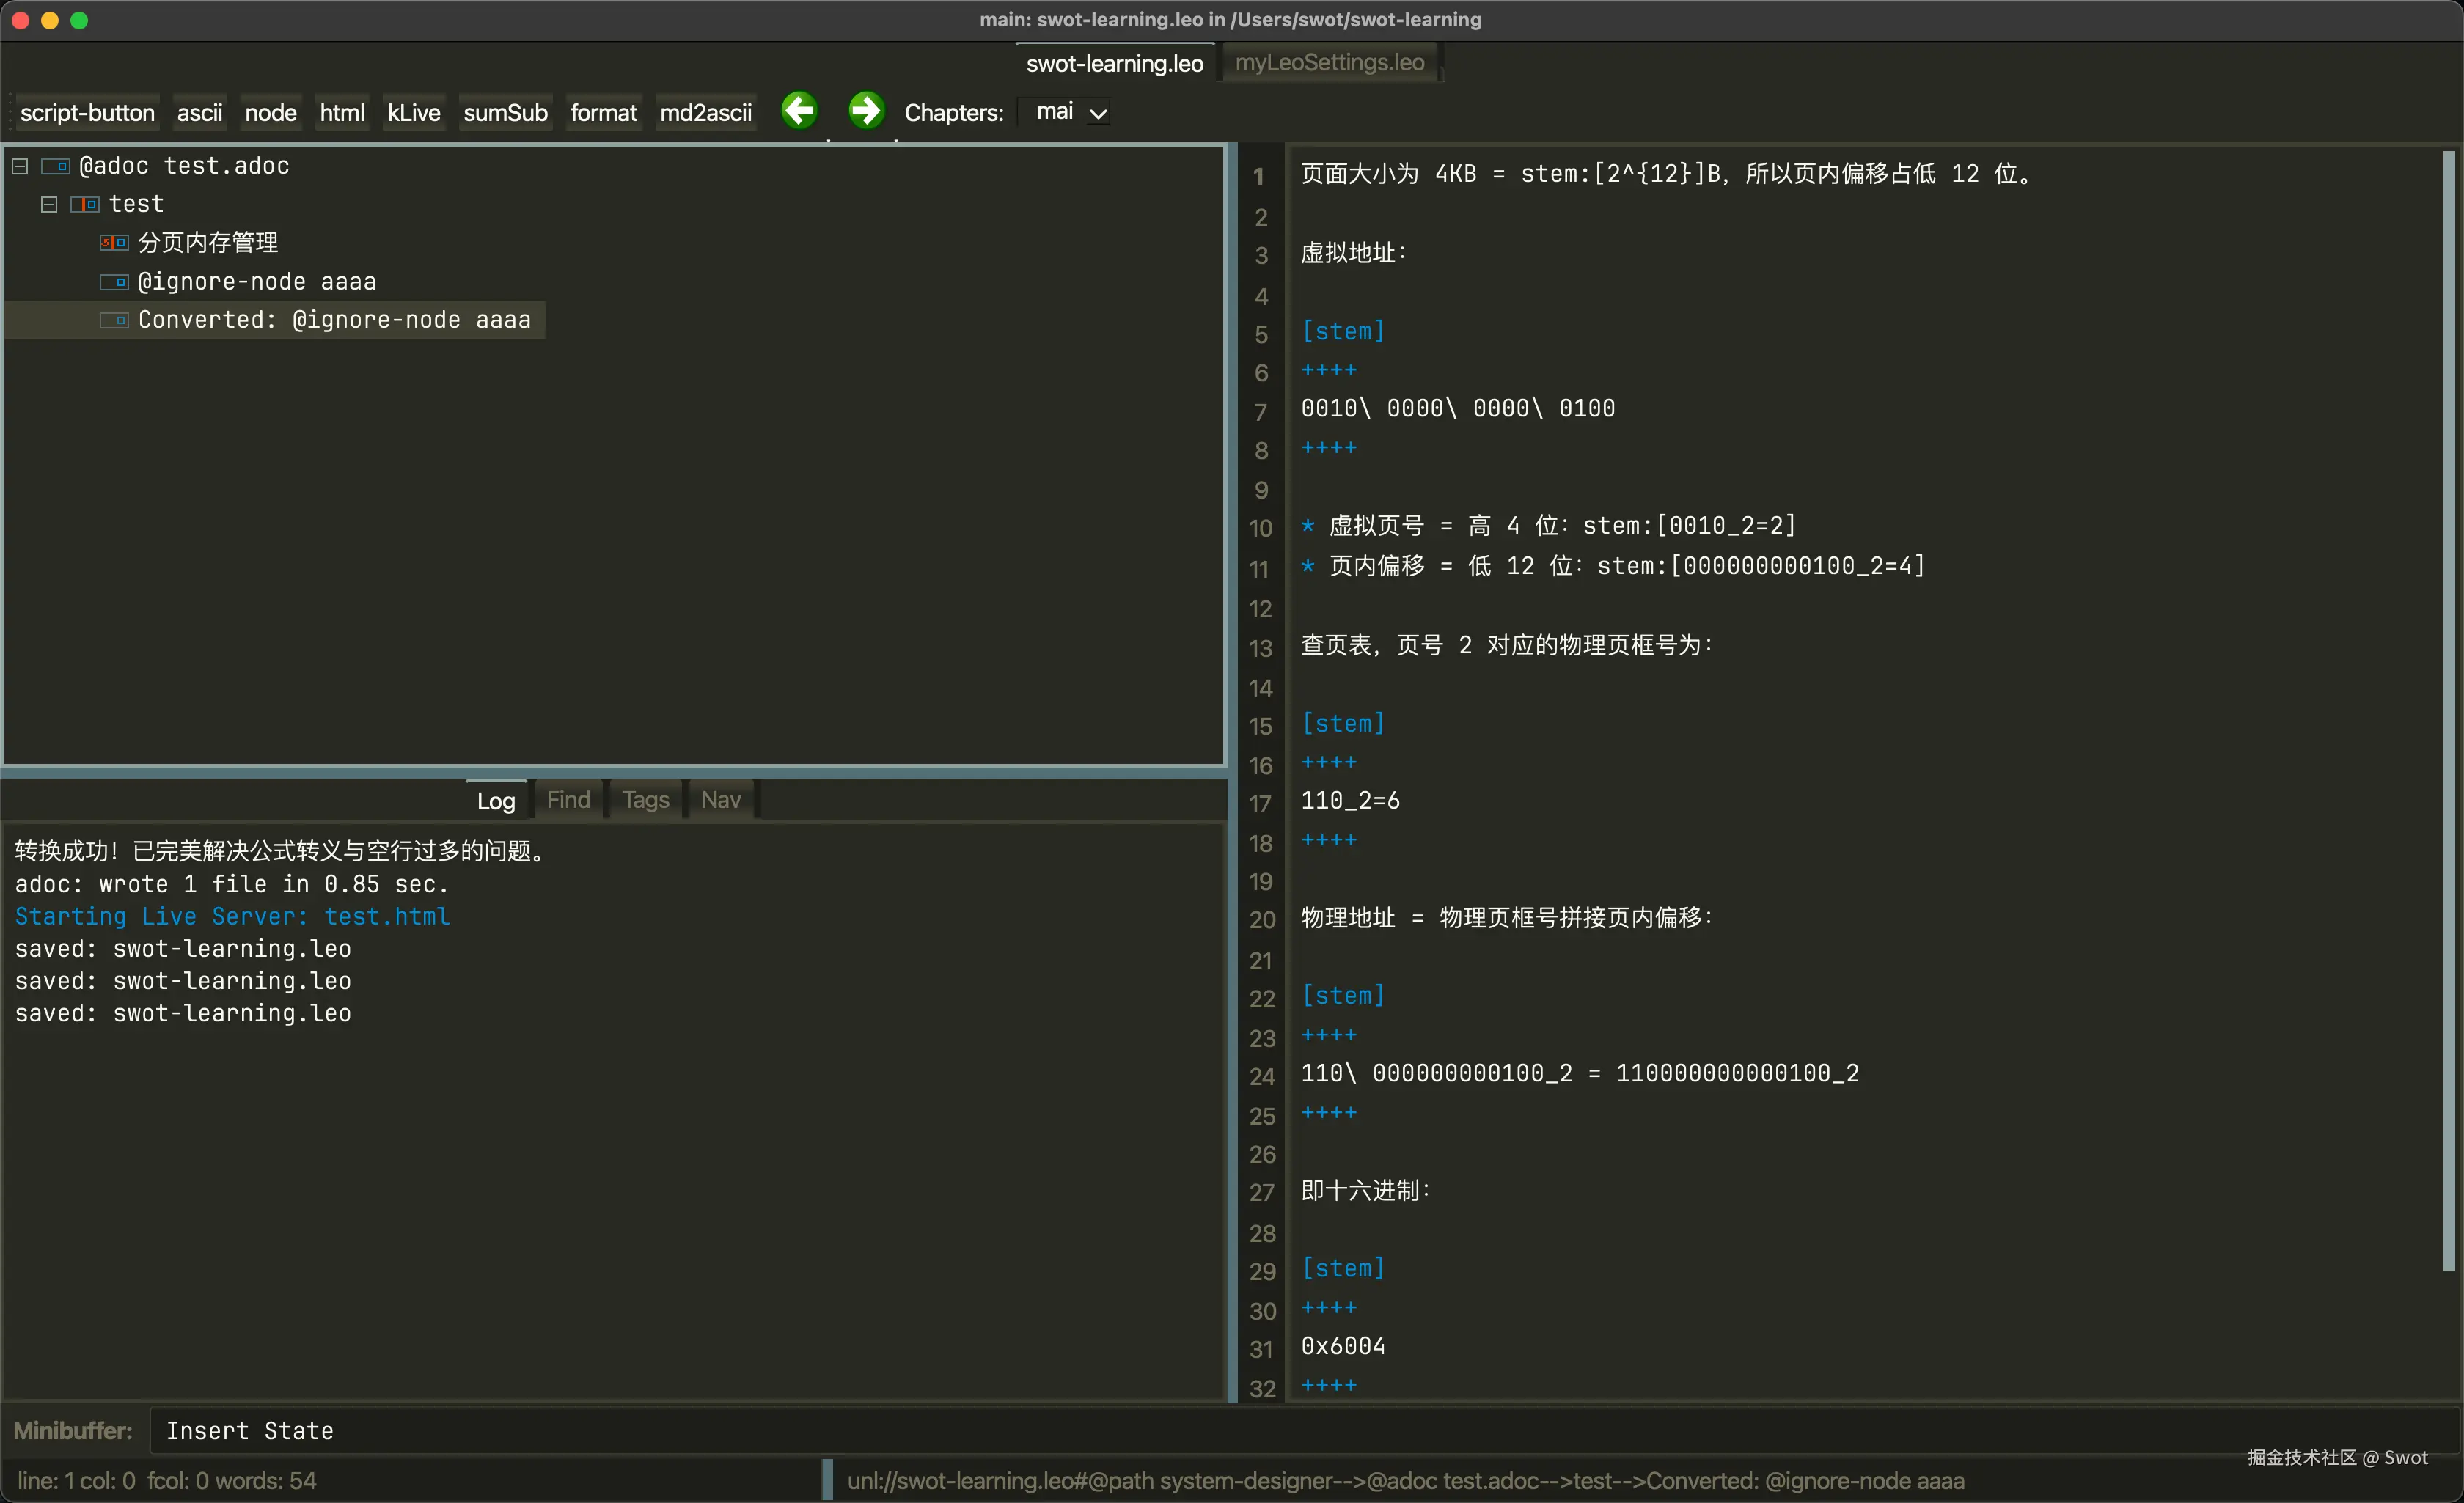
转换成功后的 asciidoc 内容节点如下图:
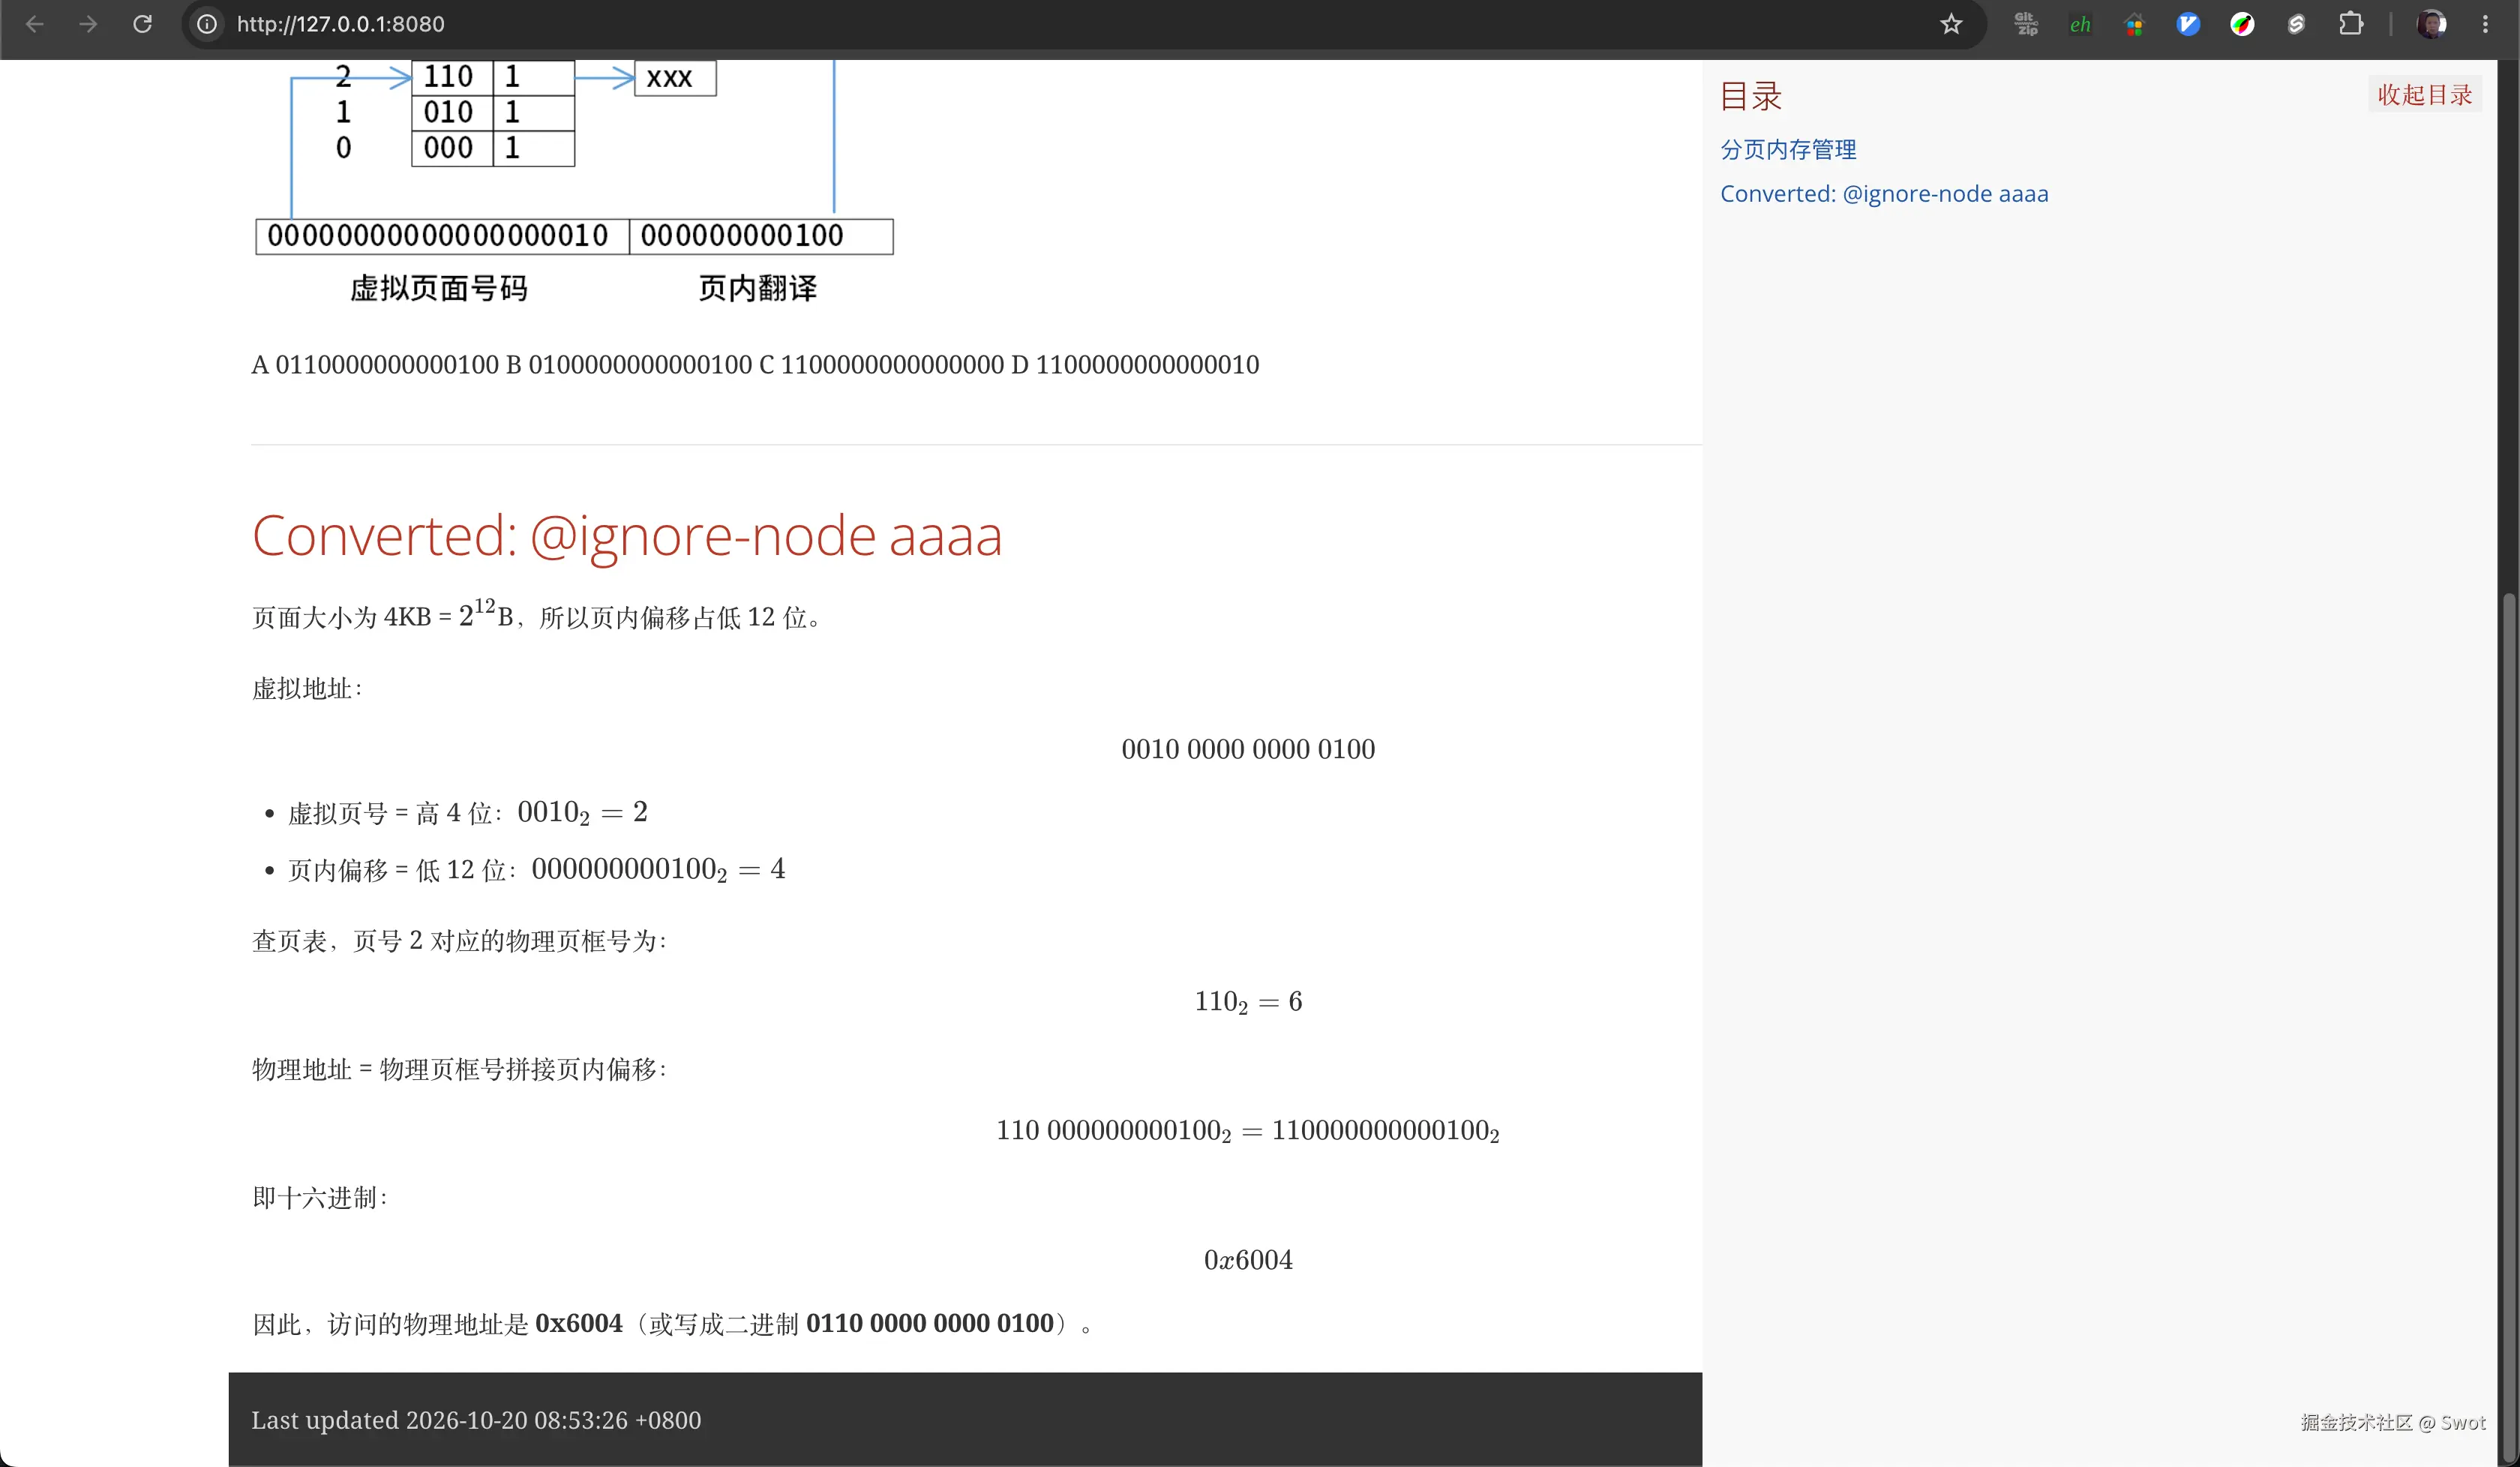
asciidoctor 编译成 html 后的效果如下图:
小结:记录了 python 脚本转换 Markdown 到 Asciidoc 的方式,以及部分 leo-editor 的全局 script-button 配置。