📖 官网 :yangyongzhen.github.io/cj-tauri/ ------ 中英双语,特性、19 屏实机截图与文档入口 📦 仓库 :atomgit.com/qq8864/cj-t... 🧩 样板应用 cjnote :本仓
examples/cjnote/💬 QQ 技术交流群 :92381027
先把结论说在前面
如果你手上有一个桌面应用要写,并且符合下面任何一条,我建议你花半小时试试 cj-tauri:
- 你不想为了一个工具去装 Node / Chromium,也不想让用户下载 100MB 运行时;
- 你的后端逻辑希望是编译成机器码、可审计的,而不是一堆 JS 依赖树;
- 你本来就在仓颉这条技术栈上(华为仓颉语言),希望桌面端和鸿蒙端共用一套后端代码;
- 你受够了「安全模型写在文档里、实现里到处漏」------你想要的是没在清单里写的东西,前端就是调不通;
- 你在用 AI 助手写代码,希望错误尽早被编译器拦住、改完能自己跑出证据,而不是靠它自我感觉良好。
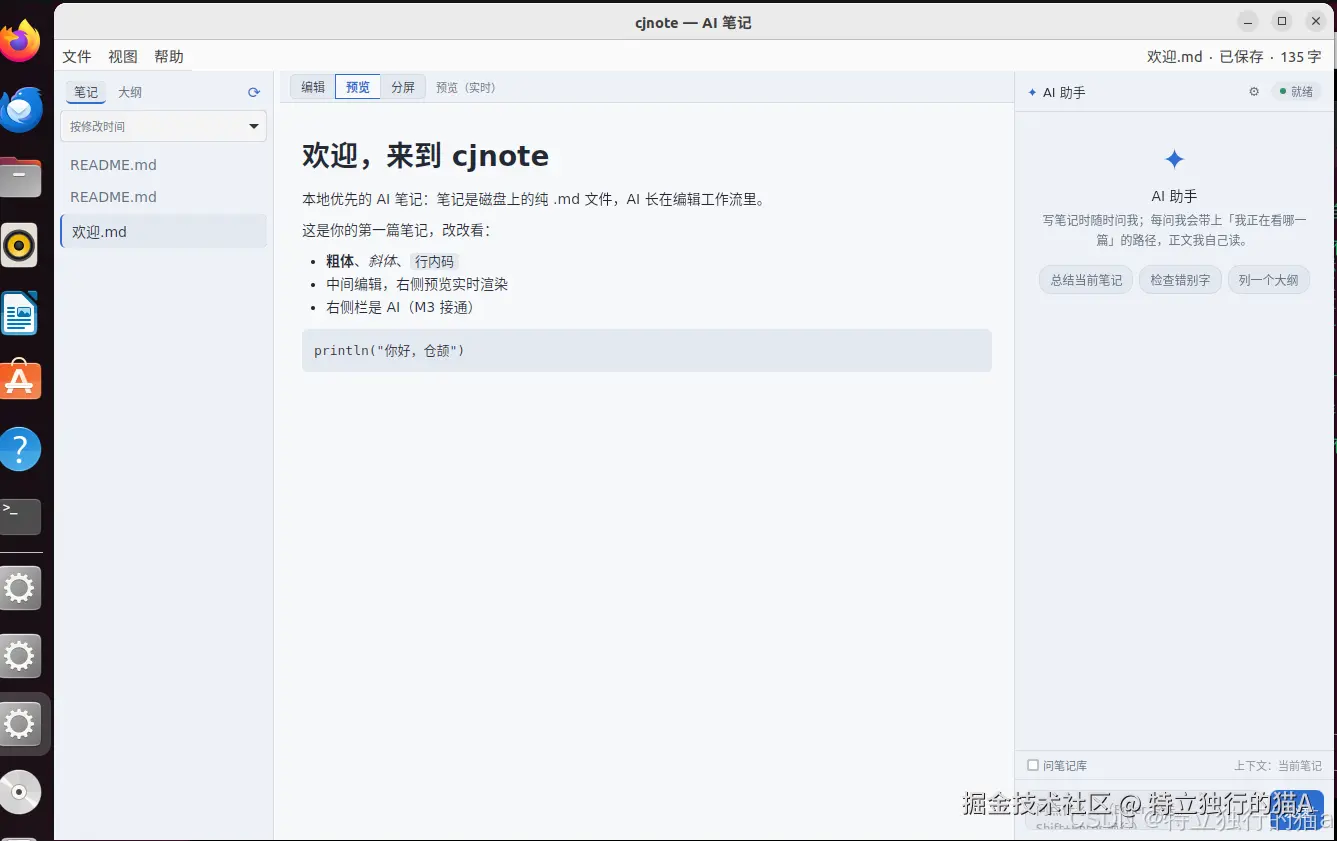
而如果你还不知道自己要不要写桌面应用,那么直接去看 cjnote (examples/cjnote/)也行: 那是一个能日常用的 AI 原生 Markdown 笔记应用,它的存在本身就是这套框架的能力清单------原生菜单栏、系统副标题、AI 流式对话、笔记增删改查、单文件交付,一样不缺。
关键是体积才11M大小左右,还在用Typora?可以玩下这个。体积小但功能一点儿也不弱,因为我将cjh这个仓颉语言写的智能体也嵌入进去啦,打造了一款小巧的AI笔记软件。
一、cj-tauri 是什么
一句话:用华为仓颉语言实现的 Tauri。前端仍是 HTML/CSS/JS,跑在系统 WebView 里;后端是仓颉静态编译的原生二进制。产物不带 Chromium、不带 Node。
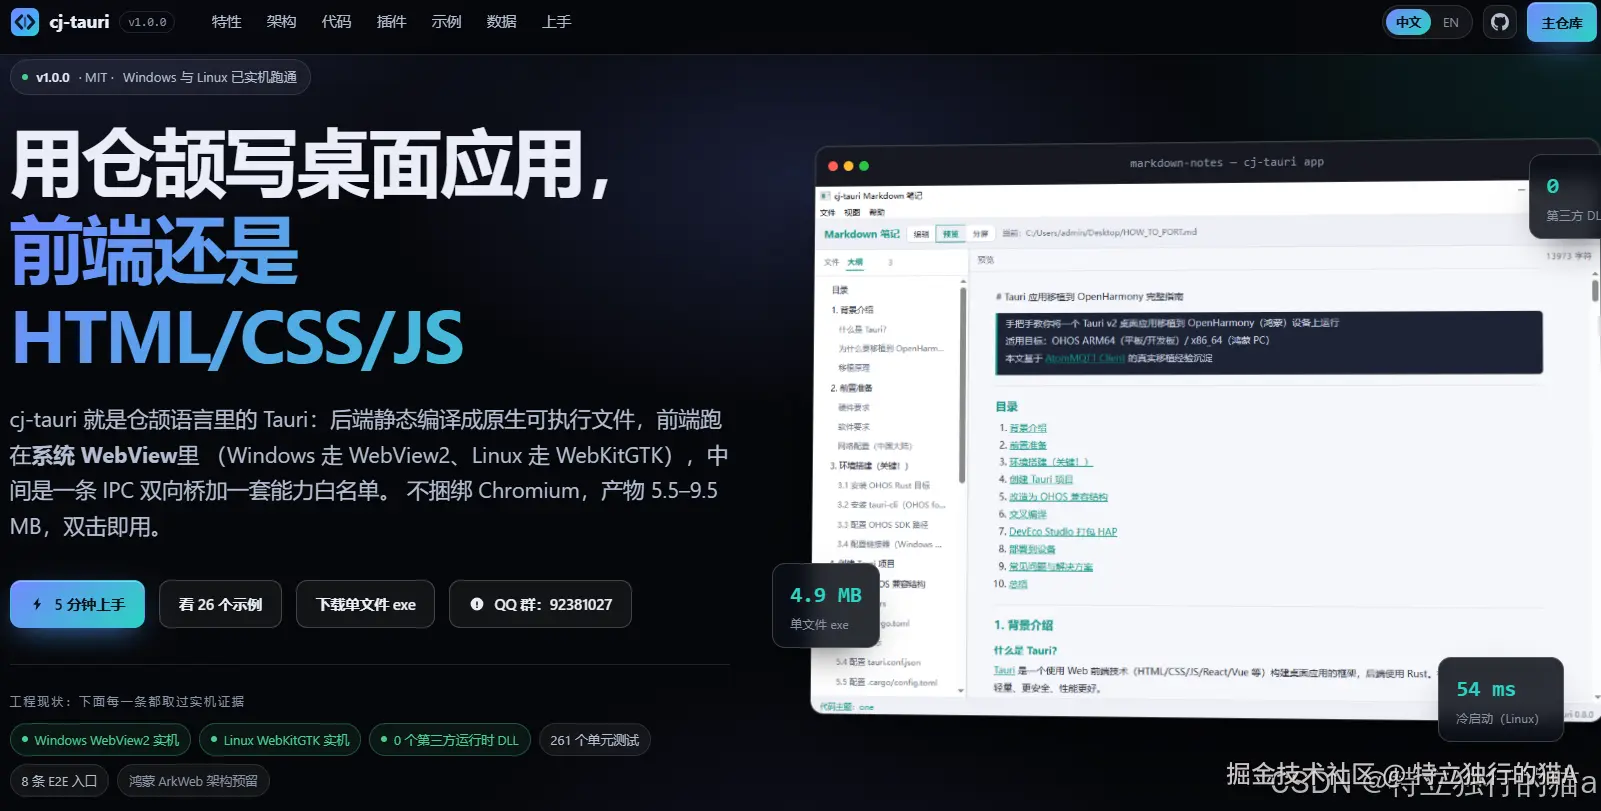
它和 Tauri 的三件套是一一对应的,学过的概念可以直接平移:
| Tauri 组件 | cj-tauri 对应 | 说明 |
|---|---|---|
| WRY + TAO(宿主) | src/host.cj + 各平台实现 |
Linux = WebKitGTK,Windows = WebView2,鸿蒙 = ArkWeb |
| IPC(invoke / event) | src/ipc_hub.cj |
JSON over postMessage,window.__CJ_TAURI__.invoke/listen/emit |
| capability 能力模型 | src/capability.cj + capabilities/*.json |
命令 / 事件白名单,默认最小权限 |
@tauri-apps/api |
注入的桥接 JS | 宿主在页面脚本之前注入 |
| tauri-cli | cli/cj-tauri |
create / dev / build / run / info / doctor |
写一个应用就三步(对应 Tauri 的 command / Builder / capabilities):
ts
public class GreetCommand <: CommandHandler {
    public func handle(cmd: String, args: JsonObject, ipc: IpcContext): JsonValue {
        return JsonString("Hello, ${argString(args, "name", "world")}!")
    }
}

main(): Int64 {
    let app = TauriApp()
        .window(WindowConfig("hello", 1000, 700))
        .register("greet", GreetCommand())
    app.run(html)
    return 0
}
js
window.__CJ_TAURI__.invoke('greet', { name: '仓颉' }).then(d => console.log(d));二、我为什么做这件事
不是「再写一个 Tauri」。原因是三件很具体的事:
- 仓颉需要一个真实的桌面落地场景。 语言能力(编译、FFI、条件编译)都在,但「能不能用它做完一个能交付的 GUI 应用」只有真做出来才算数------所以要有一个跑得起来的框架, 以及一堆跑得起来、能被自检的应用。
- 混合开发的体积账值得重新算一遍。 桌面端最贵的那部分从来不是业务代码,是「为了跑业务代码而捆进来的运行时」。系统 WebView 就在那儿,不用它太可惜。
- 鸿蒙这一条线,只有后端同源才最省。 ArkWeb 和桌面 WebView 的差别主要在宿主层,而 IPC、命令分发、能力校验这些真正要写的逻辑,本该共用------那就必须有一个平台差异被压到两处的架构。
这三件事决定了框架的形状:平台差异只允许出现在「仓颉侧 @When 条件编译」和「C 桥 native/platforms/*/」两处,其余一切跨平台共用。到今天为止,这条规矩在仓库里没有被破过。
三、我最满意的六件事
1. 它真的小,而且小得可核对
单个示例产物 4~10MB,仓库随版本分发八份静态链接的单文件 Windows 工具(4.69--9.79MB),免安装、双击即用;PE 导入表里只有 Windows 系统 DLL,非系统 DLL 一列全是 0,双击也不弹控制台。
这不是「宣传口径」,是一条命令能复核的口径:
bash
bash scripts/dist-report.sh # 八份产物的体积、依赖、子系统逐项复算对账依据与实测方法写在 分发形态实测.md。
2. 安全模型是「默认拒绝」,而且分两层
第一层是命令级白名单 :capabilities/*.json 里没声明的命令,前端调了就是command not allowed,stderr 留一行凭证。第二层我觉得更值钱------命令放行 ≠ 参数放行:
- 路径类参数走
scopes({"fs": {"allow": ["$HOME/notes/**"], "deny": ["**/id_rsa"]}}),先 deny 后 allow、allow 必须显式命中、匹配前先规范化(顺带解析软链接); - 出网口(
http/ws插件)走主机白名单,没写 = 全拒,且禁自动重定向; - 判定逻辑只有共享层一份,插件要用就调
IpcContext.resolveScopedPath(...),不允许各平台实现里「再判一遍」。
这条设计有一个我看得很重的后果:页面是可能的攻击面,而页面能碰到的每一个字符串,都在进宿主之前被一层统一的判断挡过。想绕过就得改共享层,而共享层是有单测的。
3. 插件体系:一行接入,不用不链接
14 个官方插件(fs / dialog / shell / serial / store / clipboard / notification / menu / mqtt / redis / log / http / ws / sqlite),应用侧接入就一行:
ts
let app = TauriApp().plugin(FsPlugin()).plugin(StorePlugin())值得单独说的是**「一个插件一个子包」**这个决定。一开始所有插件挤在一个 cjTauri.plugins 包里,结果是:只用 fs 的应用会被 sqlite 的 FFI 连坐,Windows 上也要跟着链 -lsqlite3。拆成一个插件一个静态库之后,没引用的插件根本不会进链接。
权限也不想当然:插件只声明「我提供什么」(commands() / events() / 命名权限集),不自动放行------放行永远是应用清单说了算。声明与放行分开,是这套体系里最容易被抄错、也最不该抄错的一条。
4. 可验证性是被设计进去的,不是事后补的
框架里写着一句硬规矩:行为变更必须给出可观测证据。所以日志不是「调试用的」,是交付凭证:
- 桥的 stderr 每行即时落盘 ,端到端验证以它为准(仓颉
println有缓冲,被强杀时会丢日志,所以诊断一律走 stderr); - 应用可以开页面自检 :断言结论经
report命令回投 stderr,于是「无人值守跑一轮」是可行的; - 命令失败必留一行
command rejected (...)/command failed (...),前缀不同方便分流------「日志里没有错误行」从来不等于「命令成功了」这件事,是被实际坑过才写进规范的。
配套的测试也是真的在跑。我刚刚在仓库根跑了一遍(2026-10-21):
bash
bash scripts/test.sh                 # Summary: TOTAL: 294 → PASSED: 294, FAILED: 0
bash scripts/test-bridge-core.sh     # [bridge-core] 断言 221 项:通过 221,失败 0
bash scripts/check-static.sh # 不需要 SDK 的静态门禁,CI 跑的就是它顺带一句:test-bridge-core.sh 编的是 C 桥的公共核心 ,用桩平台跑,不依赖 SDK、也不依赖图形栈------所以它在任何 Linux 机器上都能跑。这类「把可验证的部分从平台里剥出来」的做法,是我在这个项目里最喜欢的一个工程习惯。
5. 双平台同名导出,上层不会长出平台分支
IPC、能力校验、命令分发是跨平台共用 的;平台实现只在 C 桥各写一份 cj_bridge_*,且导出名必须逐字一致。好处是应用代码里不会出现「Linux 这么调、Windows 那么调」的分叉。
能力位也是如实上报的:某个平台上没实现的能力,system:host 就报 0,应用可以据此优雅降级------cjnote 的副标题就是这么写的(Linux 有原生副标题就用,不支持就退回页面自己画一条)。平台没这能力就如实说没有,比「假装成功」省掉后面所有的排查。
6. 上手成本比想象的低
bash
npx cj-tauri create myapp     # 免安装,直接跑(需要仓颉 SDK 1.0.5+ 与 stdx)
cd myapp
npx cj-tauri dev              # Vue / React 模板会接管 Vite dev server,HMR 在窗口内生效
新机器第一件事我会让你跑 cj-tauri doctor------它逐行告诉你「缺了什么、怎么补」,而不是丢一句 command not found。跨平台链接、GUI 子系统(Windows 下不要弹 DOS 黑窗)、SDL 那类的坑,脚手架生成时就替你填好了。
另外这个仓库把开发工作流沉淀成了 5 个 AtomCode skills(环境检测 / 应用开发 / 实机取证 / 踩坑速查 / 回贡献),配合 AI 助手用:
bash
atomcode plugin marketplace add https://atomgit.com/qq8864/cj-tauri.git
atomcode plugin install cj-tauri-skills@cj-tauri-skills
四、AI 时代,选语言本身就是一种优点------仓颉在这条线上不输 Rust
这两年写代码的方式变了:很大一部分是「我描述、AI 落笔、编译器裁决」。这个流程里真正决定效率的,不是 AI 有多聪明,而是错误暴露得有多早 、上下文能不能一次喂清 、改完能不能自己证明。 系统级语言被重新追捧,根子就在这里------Rust 是那个最有名的答案,我想说的是,仓颉同样在这条线上,而且它有几点是别处不容易凑齐的。
① 静态类型 + 编译期检查,等于给 AI 的幻觉设了一个落点。 动态语言里 AI 编出来的 API 名字错了,要跑到那一行才炸;仓颉是编译期就过不去。光框架一侧就有 20 687 行仓颉代码(74 个源文件) 、两平台同名的 C 桥导出,还有 294 个单测卡着------编译器的报错比 AI 的自述可信,这一点在 AI 参与开发时特别值钱。
② 后端只有一门语言,上下文小得多。 没有「Node 那一半」要同时记住:命令就是类、能力就是一份 JSON、前端只有 invoke / listen / emit 三个入口、平台差异被压到两处。AI 说「帮我加个命令」,要改的就是注册处 + 清单各一行------它能一次改对,你也能一眼 review 完。
③ 这个仓库本身就是按 AI 协作的要求长出来的。 根目录的 AGENTS.md 是开发契约,其中 §4 是一份 「已踩坑清单」 :几十条「编译器报错指向的不是真原因」的记录(少一行 import std.convert.* 报的是 undeclared identifier 'parse';TlsClientConfig 不在 net.http 里,漏 import 报的是「这个类型不存在」......)。 这些坑人和 AI 都会踩,所以把它们写下来、喂回去。配套的 5 个 AtomCode skills把「环境检测 → 应用开发 → 实机取证 → 踩坑速查 → 回贡献」也沉淀成了可装载的指令。
④ 「改完能自己证明」是这套流程的收口。 页面自检的结论经 report 回投 stderr、桥的日志每行即时落盘、294 个单测 + 221 项桩自检 + 免 SDK 的 check-static.sh 三道闸门------于是一轮 AI 改动是有机器判据的:编得过、跑得出、证据躺在 stderr 里。这也是我把「行为变更必须给出可观测证据」写进契约的原因:没有证据的「已完成」不算完成。
⑤ @When 条件编译让「一份代码多端」对 AI 也友好。 不需要为每个平台记一套 API,平台差异就允许存在于那两个地方;AI 不用在脑子里维护一张平台分支表。
⑥ 语法简单,代码短;而它编出来的东西也真的小。 类型推断、模式匹配、lambda、字符串插值都在,一个命令处理器就六行、一个能跑的窗口应用十来行(第一节那段就是完整例子); FFI 也不是什么隆重的事------一行 foreign func,本仓的 SQLite 插件就是直接调系统 libsqlite3 ,中间没有 C 桥那层包装。语言轻,产物也轻:后端是静态编译的原生二进制,没有 VM、不需要用户先装运行时------单个示例 4~10MB,八份 Windows 单文件工具 4.69--9.79MB,跨平台 C 桥的公共核心只有 2 200 行。
这两件事对 AI 协作的实际意义:同一件事用的代码少,AI 一次能改对的面就大,人 review 也快。而「小」是能一条条复核的------体积、导入表、依赖清单,全都有脚本可复算,不是宣传语。
⑦ 反过来说,Rust 的代价也很具体------而这恰好是仓颉能补上的地方。 Rust 是「编译期安全」这条路最有说服力的答案,但它被吐槽最多的两条,偏偏是日常最磨人的成本:编译慢、构建目录吐垃圾 。 依赖一多、泛型单态化 + 过程宏展开一起来,target/ 动辄几百 MB 到几 GB(debug 与 release 还各留一份),改一行等半分钟是常态。本机没装 cargo,所以我不做同机对照------下面只给仓颉侧的实测,你自己按比例感受:
| 项目 | 实测 |
|---|---|
最小示例 examples/hello 全量冷编译(静态链入框架) |
50 秒 |
| 同一示例改一行再编 | 25 秒 |
构建目录 target/(该示例 / 框架本身) |
8.3M / 36M |
产物 main(静态链接) |
4.5M |
| 独立小程序(leetcode-gui 的判题器,静态链接 + strip) | 冷编译 0.4--1 秒 ,产物 2.7M |
一句话:构建中间产物是几十兆 级,不是几个 G 级;全量编译是几十秒 级,不是几分钟级。 不过因果要说清楚------仓颉这边快,一部分是因为项目本身瘦 (依赖少、代码短,没有一排第三方 crate 要先编一遍)和工具链轻,不是编译器比 rustc 更聪明;Rust 的慢换来的是极致优化与一个巨大到不用自己造轮子的生态。
这笔账怎么算,取决于你在写什么。
也要说清楚代价,免得你按 Rust 的预期来:仓颉的库生态远小于 crates.io ,很多轮子得自己造(本仓的 MQTT、Redis RESP2 都是纯仓颉手写的------但有弊有利,好处是零第三方依赖,代价是要自己写); 工具链还在快速演进 ,版本配对的坑是真实存在的(cjc 与 opt 差一代会崩、cjpm 的增量缓存会跳过链接),所以本仓的判定统一成「看产物」而不是「看 build success」。
一句话:如果你要的是「AI 帮你写 + 编译器把关 + 自检收口」这套工作流,仓颉很合适;如果你要的是现成的海量第三方库,先去 Rust。 Rust 证明的方向是对的,仓颉是同一方向上的另一个答案,而且它多给两样东西:华为自主的工具链 ,以及与鸿蒙原生同源------语法简单易懂,AI写完后你想审查也不费劲。桌面和鸿蒙共用一套后端逻辑,这在别家语言上没有现成路径。
五、生态已经不是「一个示例」了
examples/ 下有 27 个可运行的桌面示例 (外加 1 个鸿蒙探针工程 ohos-probe,猫哥最近再搞让其支持鸿蒙平台),另有三套脚手架模板(零 Node 的纯内联版 / Vue 3 / React 18)。我挑几个最能说明问题的:
| 示例 | 一句话 |
|---|---|
| modbus-poll | Modbus TCP/RTU 调试工具:多面板并行监控、FC 01-04/05/06/15/16、报文监视、CSV 记录------对标 Modbus Poll 并补齐它让人难受的地方 |
| mqtt-client | MQTT 调试台 :协议由 mqtt 插件纯仓颉实现(没用现成库),示例自带 mock broker,实机 E2E 27 条断言两侧对账 |
| redis-client | Redis 调试台:SCAN 游标分页 + MATCH + TYPE 过滤、类型化取值写值、发布订阅,RESP2 双 socket 同样自研,实机 E2E 47 条断言 |
| sqlite-browser | SQLite 浏览器 :仓颉 FFI 直连系统 libsqlite3 (不经 C 桥),只读走内核级连接、ATTACH 由 authorizer 按语句拒 |
| http-client | HTTP API 客户端 :页面零 fetch,请求全由仓颉侧直发(TLS 走系统证书库、不关校验),实机 E2E 55 条断言含截断三侧对账 |
| cj-link | 串口/网络二合一调试助手:串口 + TCP 客户端/服务器 + UDP 共用收发日志,HEX/ASCII、CRC、定时发送,33 条断言两侧对账 |
| leetcode-gui | 桌面版算法练习 :点「运行」把代码交给 cjc 编译再逐用例判定------判题器就是编译器,全程离线 |
| clipboard-history | 剪贴板历史管理器 :托盘 + 全局快捷键 + 最小化到托盘的首个消费者,Windows 与 Linux 双实机 |
再往下还有 music / movie / typing-poem / markdown-notes / serial-waveform / multi-window / ipc-bench...... 每个示例带自己的 README 与自检方式(17 个示例有独立 README)。另有 8 份静态链接的单文件 Windows 工具
随仓分发------不装 SDK 也能双击就用,这是给「先看看效果」的人准备的。
六、cjnote:把这套能力一次用足的那个应用
examples/cjnote/ ------ 左侧笔记库、中间分屏(代码高亮 + 行号)、最右 AI 助手。 注意顶栏只剩「文件 · 状态 · 字数」,因为标题与保存状态是通过 setTitlebarSubtitle 推到了系统菜单行右侧。
它不是一个为了演示而写的壳:笔记是真 .md、笔记库是真目录、AI 是真接后端,日常可以拿来用。
我推荐它当样板的理由有三个:
① 原生能力用得克制且诚实。 文件 / 视图 / 帮助三个顶层菜单、Ctrl+O/P/N/S/Q 全套快捷键、副标题、行号开关------都走宿主能力位;而副标题在能力位缺失的平台(如 WebView2)上自动退回页面顶栏 ,不是假装成功也没有白屏。菜单勾选与页面状态双向同步,改一个另一个跟着动。
② AI 只有一条路,密钥不留在应用里。 页面零 fetch ,聊天走 ws 插件连本机cjh 的 ws://127.0.0.1:8765/ws 收流式帧;配置读写走宿主命令,页面没有 ~/.cjh 的写权限。cjh 随包分发、自动拉起、退出收尾 (端口上已有活着的就复用、不动别人的进程)。 结果是:应用自己的 store.json 里一个 API Key 都没有,设置页的密钥框只脱敏回显、留空即不修改。
顺手说两个我很得意的小设计:保存是两条腿 ------写 cjh 的配置文件(管下次拉起与协议字段)+把地址 / 模型 / 密钥即时推给正在运行的那只 cjh,所以端口上那只哪怕是别的程序拉起来的,改完也立刻生效;
「测试连通」用的是帧级覆盖------把表单里的值随一条最小对话发过去,单次生效、不落盘、另开会话,测的就是「我这组值能不能用」,配置一个字都没动。
③ AI 上下文只给指针,不给正文。 每一问默认只带当前笔记的绝对路径 (外加笔记库根),正文由 AI 自己按需 read_file。这既省 token,又保证 AI 读到的永远是盘上最新内容 ------页面持有的文本可能已经落后于磁盘了。勾上「问笔记库」才显式要求这一轮做全库检索。(绝对路径是硬前提:cjh 的 read_file 对相对路径是按它当时的工作区解析的,给相对路径会静默读错目录。)
它的实测数字(都能自己复现):
| 项目 | 值 |
|---|---|
| 应用命令 | 18 条(note:* / cjh:* / theme:* / report 等),能力清单放行 32 条 |
| 页面自检 | 沙盒实测 68 PASS / 0 FAIL / 1 SKIP(含真实 cjh 的聊天与连通探针,连不上记 SKIP 不算失败) |
| 开发态产物 | target/release/bin/main 7.6M |
| 单文件产物 | dist-single/cjnote 11.2M(静态链接 + 页面 / 前端库 / 能力清单全内嵌,换机器只要系统有 WebKitGTK / GTK) |
| 装配插件 | 6 个(store / http / log / clipboard / dialog / ws) |
复现方式在它自己的 README 里,包括沙盒自检那条CJNOTE_SELFCHECK=1 ./target/release/bin/main 2>&1 | grep SELFCHECK。
七、按你现在的状态选一条路
① 只想先看一眼效果(什么都不装) :直接下仓库里那八份单文件 Windows 工具,双击就用,4.69--9.79MB,导入表实测只有系统 DLL。见 README 的「方式二」。
② 想写自己的应用:
bash
npx cj-tauri create myapp     # 前置:仓颉 SDK 1.0.5+ 与 stdx
cd myapp
npx cj-tauri doctor           # 缺什么、怎么补,逐行告诉你
npx cj-tauri dev              # 开发模式;Vue/React 模板会接管 Vite dev server
npx cj-tauri build            # 出产物
③ 想看一个完整应用长什么样,那就把 cjnote 跑起来:
bash
cd examples/cjnote
bash ../../native/build_linux.sh      # 首次编 C 桥(产物落在框架根 native/)
cjpm build
export LD_LIBRARY_PATH=$CANGJIE_HOME/runtime/lib/linux_x86_64_cjnative:$CANGJIE_STDX:../../native:$LD_LIBRARY_PATH
./target/release/bin/main
笔记库就是当前目录下的 notes/,首次启动会种一篇 欢迎.md。想交付成单文件:
bash
bash ../../scripts/pack-linux-single.sh # → dist-single/cjnote(11.2M,页面与清单都内嵌)八、现在的不足,我也照实说
推荐一个东西的时候把短板藏起来,是没意义的。
下面这些是我希望你用之前就知道的:
- 鸿蒙还在半路 :ArkWeb 宿主侧已经在真机闭环(页面往返、多窗口 label 路由都取证过),但 C 桥尚未落地,宿主能力位仍全 0 ------菜单 / 托盘 / 快捷键 / 拖放 / 对话框在鸿蒙上一律如实拒绝 ,不是「悄悄不生效」。做鸿蒙应用前请先看 鸿蒙接入踩坑。
- macOS 没有做。只有 Linux / Windows 两个宿主是实机跑通的,鸿蒙是第三个。我不写我没验证过的东西。
- Linux 上拿不到「全静态」:系统 WebKitGTK / GTK 没有静态库,所以单文件产物仍然动态依赖系统图形栈,能静态下来的只是「本框架带来的依赖」(桥、仓颉运行时、stdx、各插件包)。
- 插件只有 14 个 ,生态还在早期;你想要的能力可能得自己写一个插件。好消息是写插件成本很低(一个子包 +
name()+commands()),而且不用不链接。 - cjnote 的 Windows 侧只到「代码齐备、同名导出完整」,未实机验证;副标题那类能力位会如实降级。
- 构建环境有门槛:仓颉 SDK 1.0.5+ 与 stdx 得装好;好在有
doctor和 5 个 skills 兜着。
九、想一起用起来
- 官网(先看这个) :yangyongzhen.github.io/cj-tauri/ ------ 中英双语,19 屏实机截图、特性与文档入口
- 仓库 :atomgit.com/qq8864/cj-t...(GitHub 有镜像,国内直连建议 AtomGit)
- 上手文档 :使用文档 → 前端入门教程 → 插件体系教程
- 想改点什么 :CONTRIBUTING、设计决策记录(每条决策都写了理由与代价)、 需求追踪矩阵(每个能力做到哪了、证据在哪)
- AI 助手辅助开发:装 5 个 AtomCode skills(见上文)
- QQ 技术交流群 :92381027 ------ 使用问题、功能建议、插件与踩坑,都欢迎
全部代码是 MIT 。你要做的第一件事,我建议不是「从零写」,而是把 examples/cjnote 复制一份、改掉业务逻辑------原生菜单、AI 通路、能力清单、单文件打包,该配的都配好了,剩下的就是你自己的东西。
最后
桌面开发这些年一直在两个极端之间来回:要么轻(但什么都要自己写),要么方便(但捆进来一整个浏览器)。 系统 WebView 这条路证明过自己是能走通的,只是它需要一门能静态编译、能直接调 C、还能编译到鸿蒙的语言在后面撑着------仓颉恰好是这门语言,而 cj-tauri 就是把这门语言用在桌面上的一次认真尝试。
它还不完美(见上一条的「不足」),但它是能用、能核对、能改的:每一个数字都有脚本可以复算,每一条设计决策都写了理由和代价,每一个示例都能自己跑出自检结论。
如果你在找一个「小、快、安全模型清楚、后端可审计」的桌面方案,我建议你至少花半小时试一下------从官网进去,或者直接从 examples/cjnote 开始。