Microsoft Research 的 Xinzhi Zhang 与 Zhao Song 证明 1995 年提出的 Kannan--Lovász--Simonovits...
一条关于高维几何的 31 年悬案
KLS 猜想由 Kannan、Lovász 与 Simonovits 在 1995 年提出,核心问题是:对数凹分布的最窄瓶颈,是否总能在某个超平面切割附近被近似到?换句话说,找到真正最优切割的难度,会不会随着维度升高而失控?
这个问题在高维几何与概率论中影响深远。对数凹函数是一类广泛存在于统计推断、优化理论与采样算法中的对象;它们的概率质量分布具备凸性相关的良好性质,但「最窄处在哪」一直缺乏统一的上界刻画。
这次证明给出的结论是一条普适常数:无论维度多高,用简单平面切割就能够在固定倍数范围内逼近最优瓶颈。此前的最佳结果(July 2026)允许上界随维度缓慢增长,常数意义上的突破在此前从未完成。
##一条关于高维几何的31年悬案
人机协作的证明路径
研究并非 AI 独立完成,而是由人类研究者主导的 Agent 探索流程推进。研究者引导 AI 系统遍历了超过 100 条候选证明路径,并对每一条进行裁剪与定向。
关键在于「递归 refinements」。每一步引入的误差都在后续步骤中被压缩,使得总误差收敛到可接受的范围。这套机制把原本难以全局控制的几何估计问题,转化为一系列局部可验证的归纳步骤。
证明已获多位独立专家验证。微软研究院在 2026 年 10 月 21 日发布公告,论文由 Machine Learning and Optimization 团队的 Xinzhi Zhang 与合作者 Zhao Song 完成,标题《An O(1) Bound for the KLS Constant》。
影响范围与边界
结果直接作用于多个方向。统计推断中涉及高维采样与积分估计时,KLS 常数的普适界意味着某些复杂度上界不再随维度膨胀。优化算法中对数凹目标函数的切割策略,也有了更坚实的理论锚点。理论计算机科学中的相关几何引理,随之获得统一表述。
需要明确的是,证明给出的是存在性常数界,并未直接给出构造性的高效求值方法。实际落地仍需在算法层面进一步工程化。
对于关注这项工作的团队:短期可以对照既有优化算法的复杂度分析,检查是否依赖此前较松的维度相关界;中长期可跟进 KLS 在具体采样器设计中的直接应用,看看能否替换现有 bound。
100 条候选路径,AI 不是瞎跑
来源:
- Microsoft Research 官方公告:www.microsoft.com/en-us/resea...
- Unite.AI 报道:www.unite.ai/microsoft-r...
- e/acc 整理:e-acc.ai/items/cne7t...
证明路径:人类主导的 AI 探索
这项工作的执行方式值得关注。根据微软研究院发布的说明,研究者并非让 AI 独立推进,而是自己作为主导方,引导 AI 代理在数学空间中探索。具体流程是:研究者提出初始方向,AI 系统负责大量试探性推导,产出候选证明路径后,研究者再进行评估和剪枝,保留有潜力的分支继续迭代。
公开材料显示,整个过程中团队共审视了超过 100 条候选路径。这不是单次调用的结果,而是反复生成、评估、淘汰的循环。对于一条数学证明而言,100 这个数字不算庞大,但关键在于每一条路径都需要经过实质性检验,而非简单枚举。
筛选 100 条路径,每条都得看
超过 100 条候选路径的筛选
研究者承担的核心工作是「方向判断」。AI 能生成推导链条,但无法自行决定哪条路径值得投入算力与时间深入挖掘。张与宋的工作更像是架构师而非流水线工人:他们设计评估标准、设置剪枝阈值、决定何时终止某条路径并转向新的候选。
这种分工在当前 AI 辅助科研中相对少见。多数报道将此类成果描述为「AI 帮助数学家完成证明」,但实际的工作流更接近人类与 AI 的双向驱动,而非单方面的工具调用。
递归精化:让误差逐层衰减
KLS 猜想的难点在于高维空间中误差的累积。证明过程中,每一步近似都会引入小量偏差,若这些偏差随维度增长而放大,结论就无法成立。
张与宋采用的策略是递归精化。他们将问题拆解为多个阶段,每个阶段控制误差在一个可控范围内,然后证明这些小误差的总和随递归层级快速衰减。最终,整体误差被约束在一个不依赖维度的固定常数内。
这种方法并非首次出现,但将其应用于 KLS 猜想的完整证明链条,且确保所有步骤可严格追踪,是这次工作的实质突破。2026 年 7 月发布的前序最佳结果,允许该界随维度缓慢增长;而此处的递进在于彻底消除了维度依赖。
形式化验证与独立确认
证明完成只是第一步。形式化验证是判断数学结果是否经得起检验的硬指标。
根据微软研究院的表述,KLS 猜想的证明已获得多位独立专家的验证。这意味着结论不是单一研究组的自我确认,而是经过同行审阅后的共识。
独立验证通过,结论才算站稳
形式化验证在 AI 辅助数学证明中具有特殊意义。传统数学发表流程依赖人工审阅,周期长且难以覆盖所有推导细节。AI 能够生成大规模中间步骤,但这些步骤本身也需要验证机制。独立专家的介入提供了第二层保障。
目前公开材料未披露具体验证工具或形式化语言(如 Lean、Coq),但独立审阅环节的存在本身,说明该工作在交付方式上遵循了传统数学共同体的规范。
方法意义:不止于一个定理
KLS 猜想的价值不仅在于它本身的表述,更在于它与多个重要数学问题的关联。
该猜想与 Bourgain 切片猜想、薄壳猜想存在逻辑关系。解决 KLS 猜想为这些相关问题提供了新的分析工具。在统计学中,对数凹分布是最广泛使用的概率模型之一,其几何性质直接影响 MCMC 采样、高维积分等计算任务的复杂度估计。
在算法层面,KLS 常数的有界性意味着某些优化算法的收敛界限不再随问题维度恶化。这对机器学习、组合优化等领域的理论分析具有直接价值。
更重要的是,这项工作展示了人机协作在纯数学研究中的可行路径。AI 负责大规模路径探索,人类负责方向判断与关键跳跃。这种模式在应对高维、高复杂度的数学问题时,可能比纯手工推导或纯 AI 生成都更有效。
下一步值得观察的是:类似方法能否推广到其他长期开放问题,例如薄壳猜想的完全解决,或在形式化验证层面达到机器可检查的完整证明链。
一个悬了 31 年的几何命题
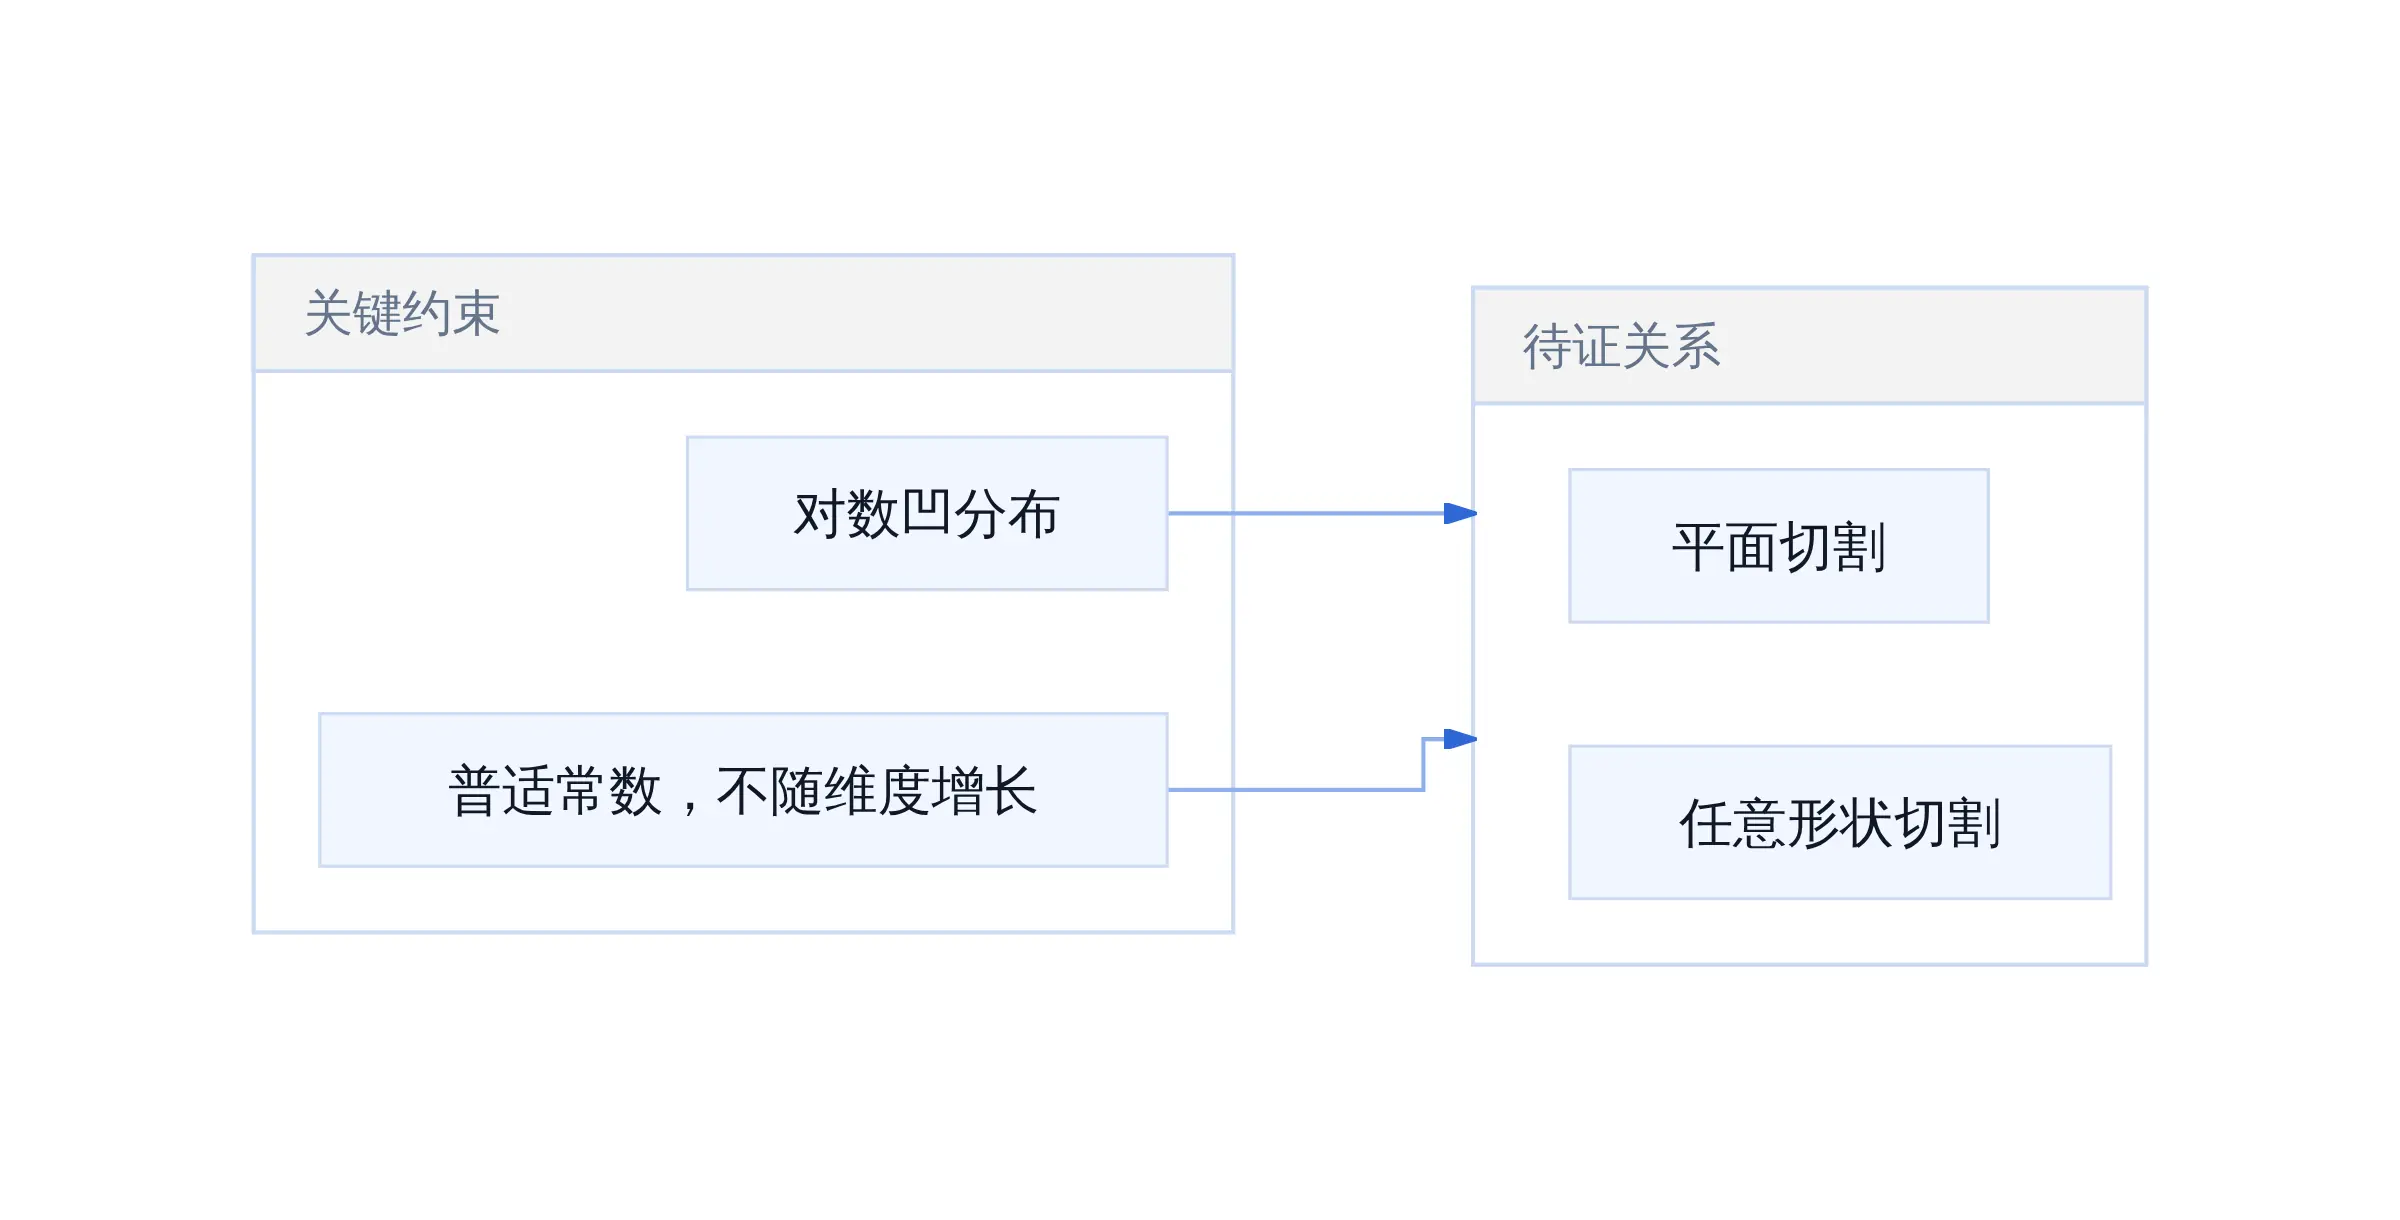
KLS 猜想关注的是高维空间中一类特殊分布的几何性质。对数凹分布涵盖正态分布、均匀分布、Laplace 分布等常见形态,其核心特征是函数取对数后呈凹性。1995 年,Kannan、Lovász 与 Simonovits 提出:对这类分布做任意形状切割时,最窄瓶颈的宽度可以用一个简单的平面切割来近似,且两者之间的放大倍数不随空间维度增加而膨胀。
这个命题直观上不违背常识。低维空间中容易验证,高维空间中却越来越难逼近。问题在于,随着维度上升,体积分布会变得极其集中,大多数质量集中在薄壳层上,切割策略的有效性随之分化。传统方法依赖的具体常数会随维度缓慢增长,无法给出普适上界。
在此之前最好的结果发布于 2026 年 7 月,给出的界限允许随维度缓慢增长。此次工作将该界限替换为与维度无关的固定常数。从渐进角度看,这是量级上的跃迁。
KLS 猜想核心命题
落点与边界
对从业者的实际意义可分为两个层面。
统计学与优化领域可直接受益。KLS 猜想的确立意味着对数凹分布的切片采样算法理论上具有维度无关的混合时间上界。MCMC 算法在 high-dimensional 场景下的收敛性分析可以获得更紧的常数保证。优化问题中的割平面法、椭球法等工具也能从中获得理论支撑。
算法设计者应关注的具体动作有三项:第一,审视当前使用的采样算法是否依赖 KLS 假设,若有可替换为新的理论保证;第二,检查高维场景下的混合时间估算,利用新常数的界限重新校准;第三,关注后续研究中对递归精化范式的扩展应用。
需要保持审慎的场景同样明确。这一结论仅适用于对数凹分布。对于非对数凹分布,平面切割的近似有效性未得到保证。此外,常数虽存在,但其具体数值仍在研究中,工程实现时需等待更精确的估计。
更实际的判断是:理论突破不等于工程可以直接升级。采样算法的实现还涉及常数因子、预计算开销、数值稳定性等工程细节。KLS 猜想解决了理论上限问题,但具体实现仍需验证实际收益。
参考文献
- Microsoft Research Blog --- Solving a 31-year-old grand challenge in mathematics -- the KLS conjecture
- Unite.AI --- Microsoft Researcher and Collaborator Prove 31-Year-Old KLS Conjecture
- 智源社区 --- Solving a 31-year-old grand challenge in mathematics -- the KLS conjecture
延伸入口
- 原文归档:tobemagic.github.io/ai-magician...
- 公众号:计算机魔术师