我用 WorkBuddy 做了个「GitHub 考古所」:输入一个用户名,出土你的编程人格档案
在线体验:github-archaeology.app.workbuddy.host/?sharecode=...
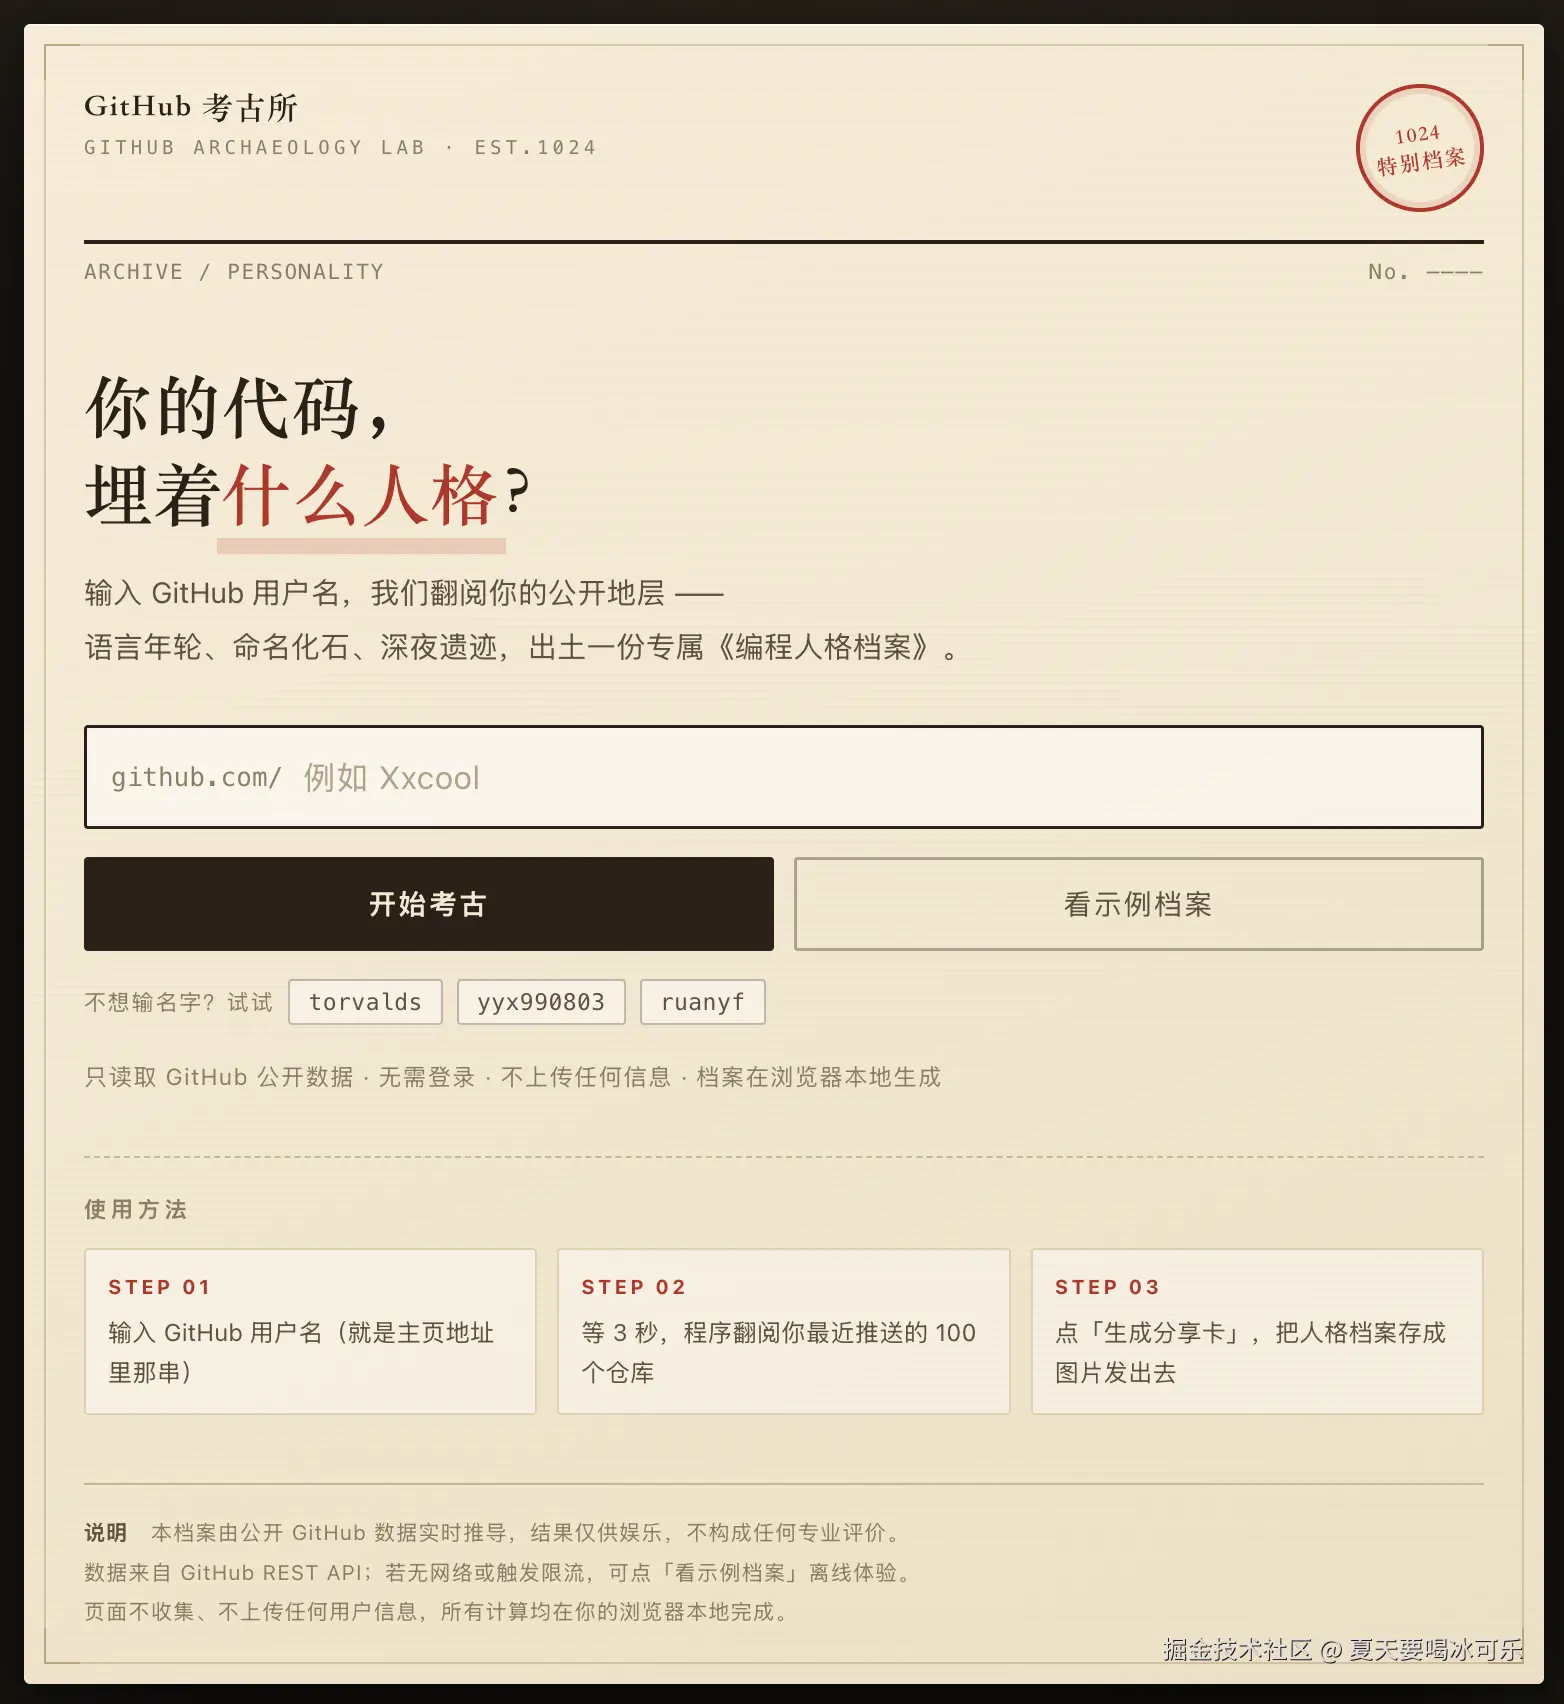
不用登录,只读 GitHub 公开数据,全部计算在浏览器本地完成。
写了这么多年代码,你有没有想过,自己的 GitHub 账号其实是一座遗址?
哪些仓库是最早的地层,哪个是你最重的藏品,你习惯几点提交,有没有给变量乱起过名------这些痕迹都留在里面,只是从来没人替你挖一遍。
这个 1024,我用 WorkBuddy 做了个「GitHub 考古所」。输入一个 GitHub 用户名,它把你的仓库当考古现场翻一遍,最后出土一份《编程人格档案》。
它挖了些什么
档案分四块。
一、语言年轮
把有推送的仓库按语言分类,画成环形图,占比精确合到 100%。
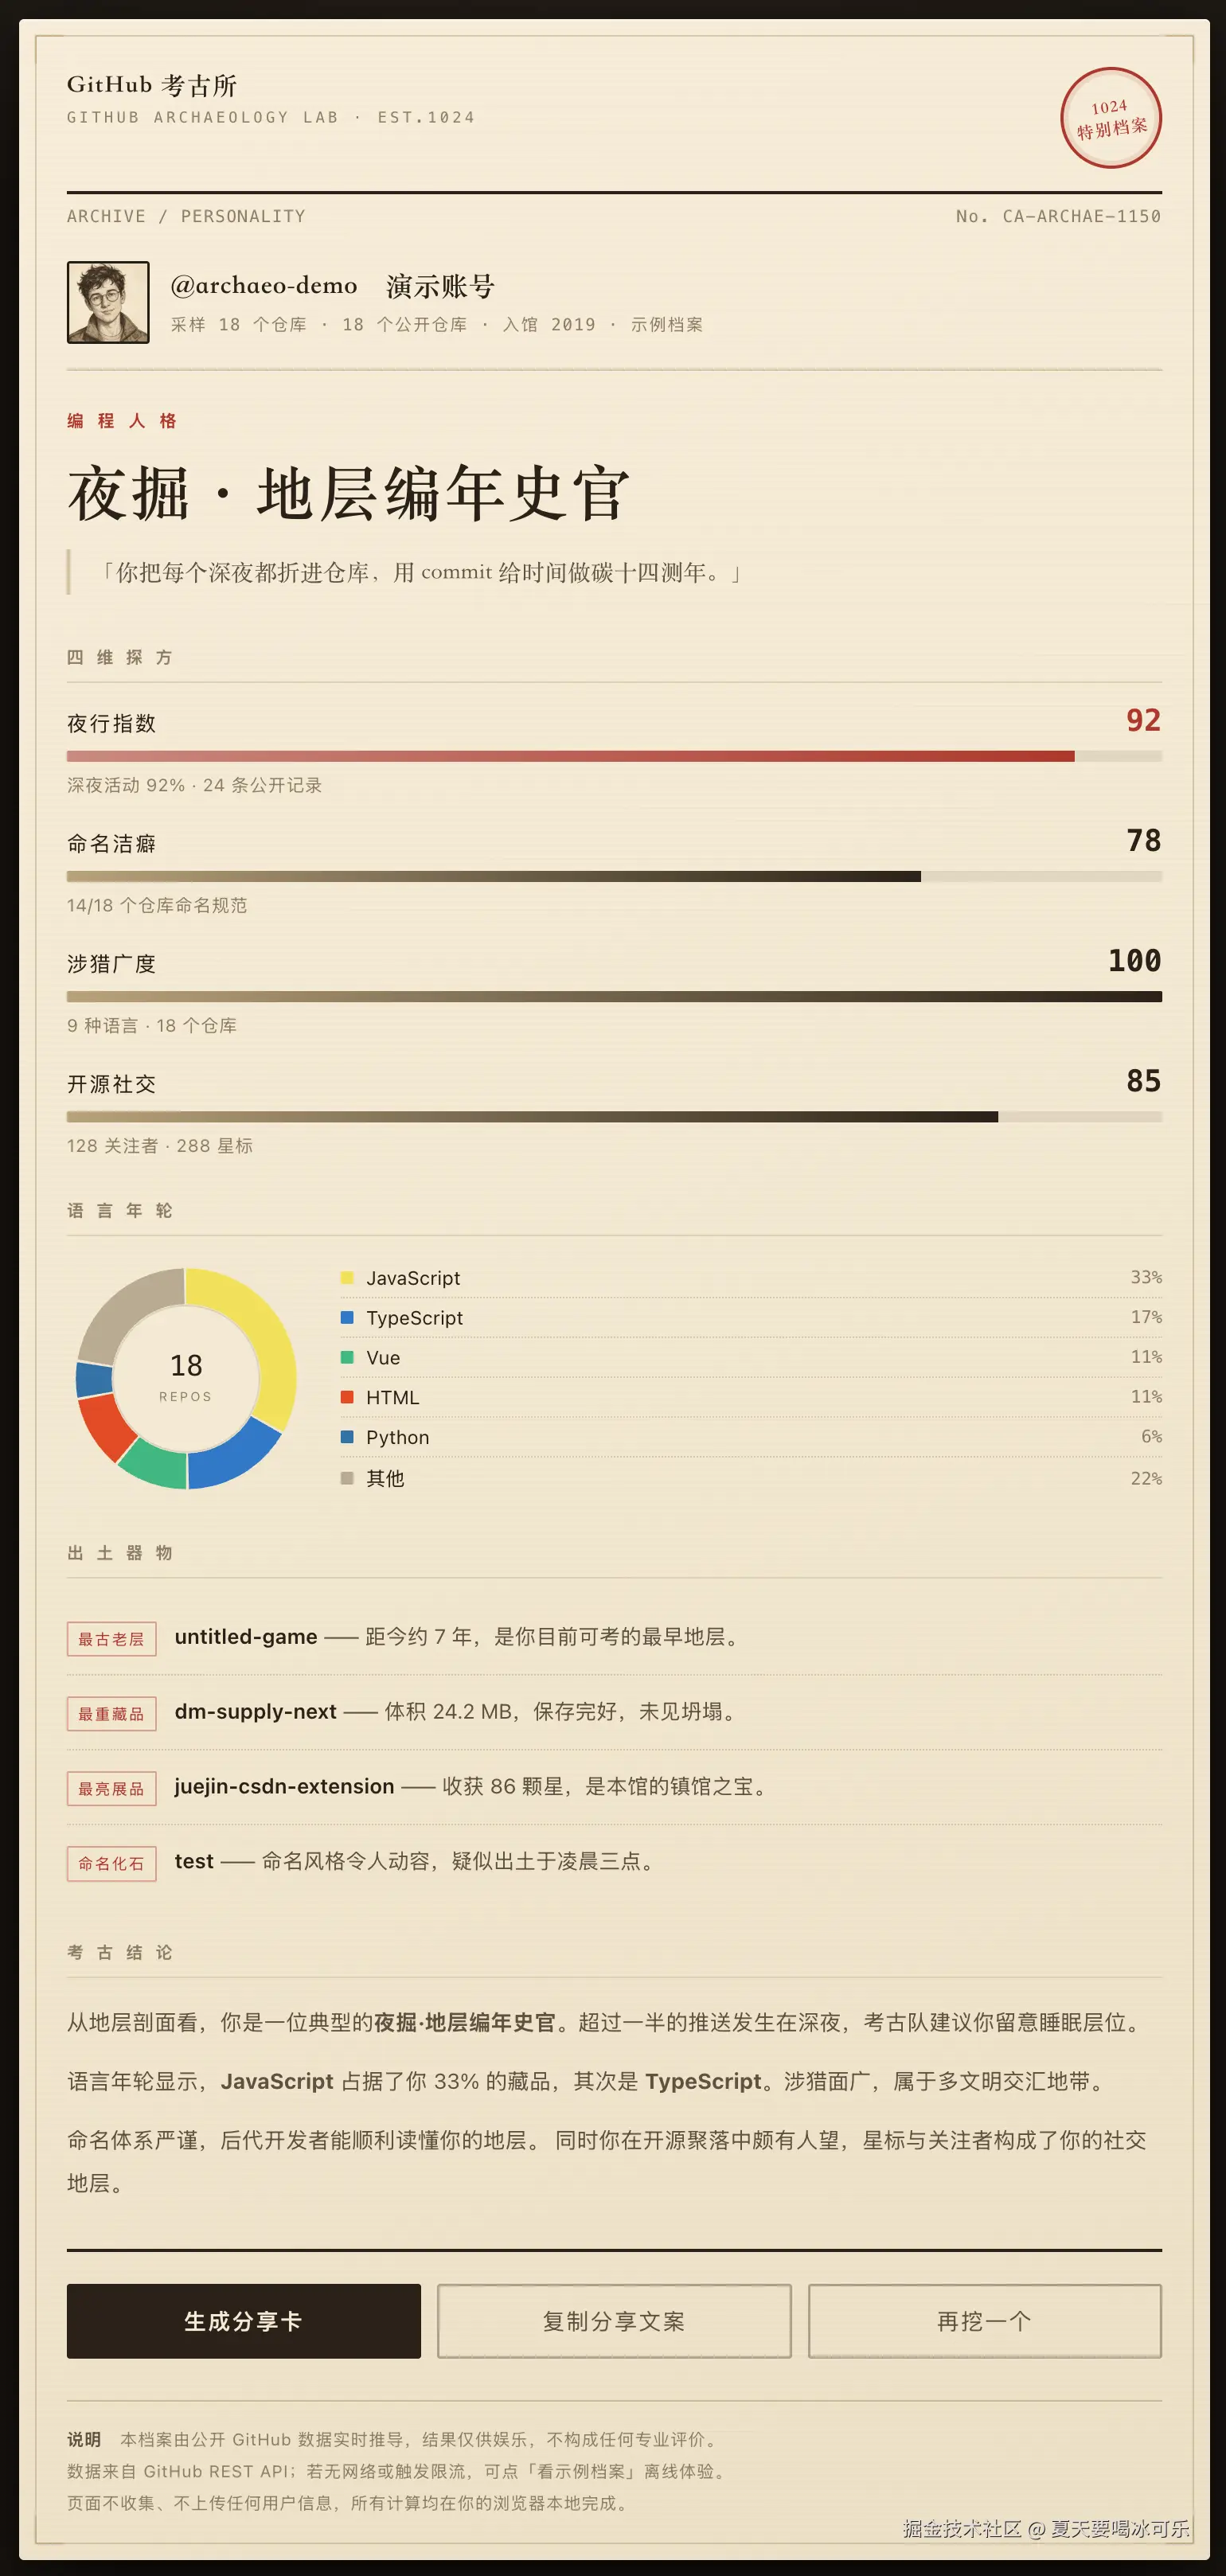
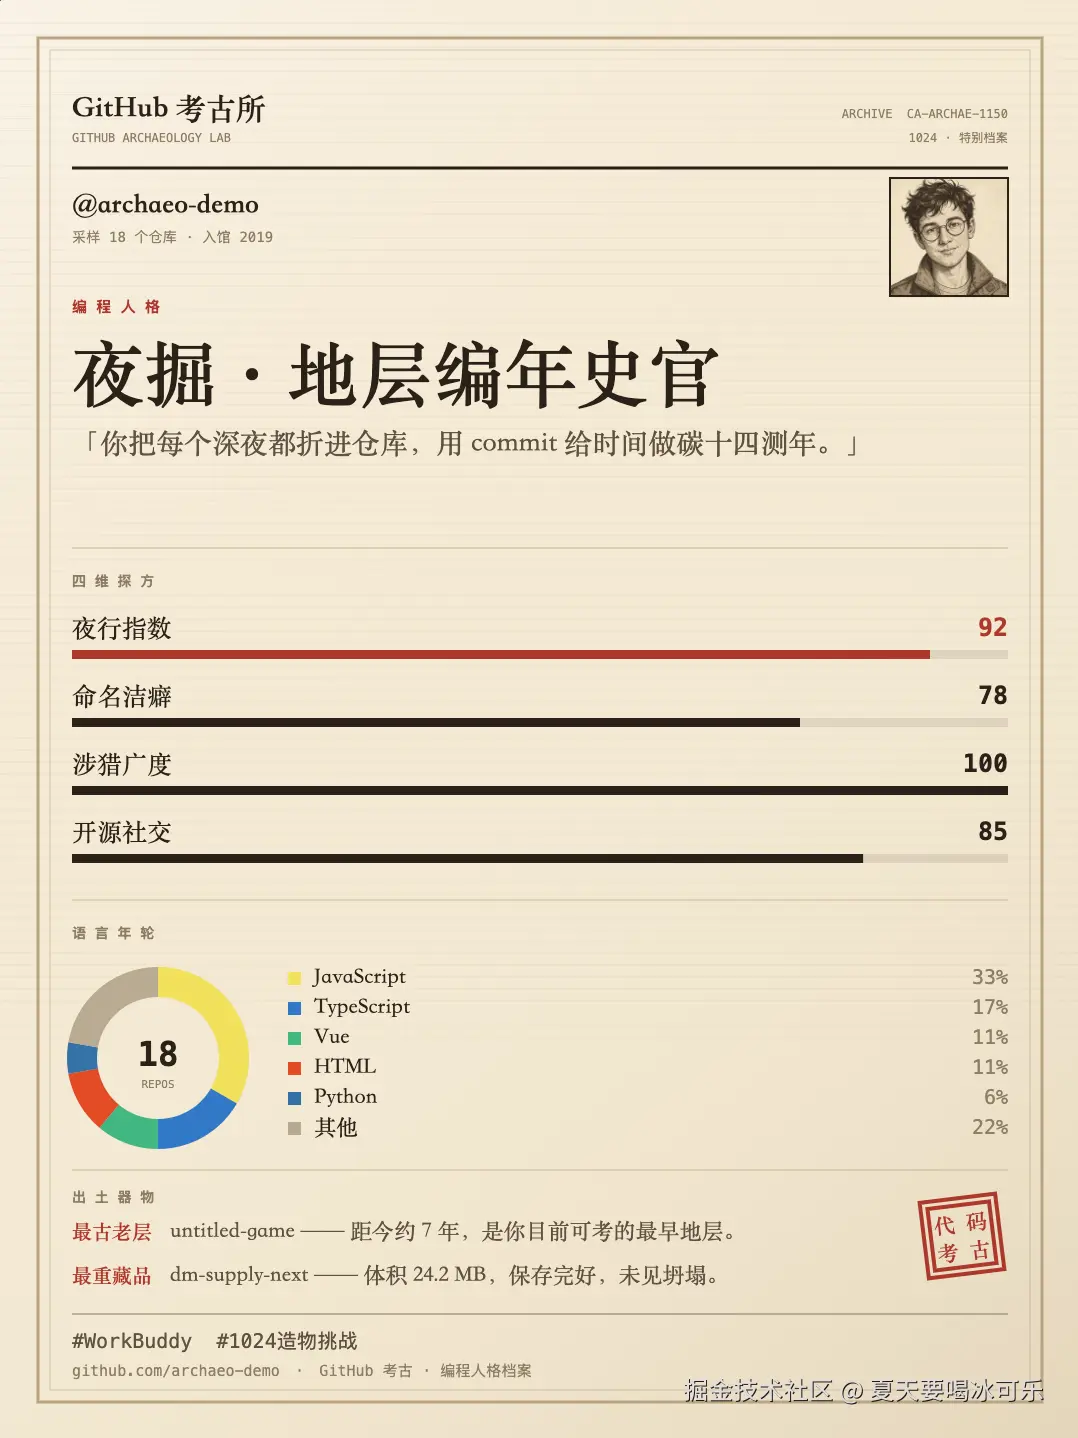
示例账号 18 个仓库:JavaScript 33%、TypeScript 17%、Vue 11%、HTML 11%、Python 6%、其他 22%。是偏科还是万金油,一眼就看出来。
二、四维探方
四个维度,每一项旁边都标了计算依据,不是拍脑袋给分:
| 维度 | 算法 | 示例值 |
|---|---|---|
| 夜行指数 | 提交时间的小时分布,深夜占比越高分越高 | 92 |
| 命名洁癖 | 命名规范的仓库数 / 仓库总数 | 14/18 → 78 |
| 涉猎广度 | 语言种类数 + 仓库规模 | 9 种语言 / 18 个仓库 → 100 |
| 开源社交 | 关注者与 Star 的量级 | 128 关注 / 268 星 → 85 |
三、出土器物
自动挖出四个"文物":最古老的一层、最重的藏品、最亮的展品、命名化石。
示例账号挖出来的是:最早 7 年前的 untitled-game、24.2MB 的 dm-supply-next、86 星的 juejin-csdn-extension,还有那个一看就是凌晨三点随手敲的 test。
说实话,看到自己第一个仓库叫 untitled-game 的时候,是有点恍惚的。
四、编程人格 + 判词
四维分数组合成 16 型里的一种,配一句判词。示例账号是「夜掘·地层编年史官」:
「你把每个深夜都折进仓库,用 commit 给时间做碳十四测年。」
最后可以一键导出 1080×1440 的档案卡,带印章、带话题标签。
几个值得说的实现决策
1. 先定隐喻,再定功能
一开始列的功能清单很无聊:统计语言、统计仓库数、算活跃度。做完自己都不想看。
后来换了个思路:把数据当成一个已经埋在地下的遗址,我做的是发掘和断代,不是做报表。
这一下结构就清楚了------仓库是地层,语言是年轮,仓库体积是器物,提交时间是作息剖面。连页面的牛皮纸底纹、印章、"档案编号 No. CA-ARCHAE-1150",都是从这一个比喻里长出来的。
信息架构的本质不是功能分类,是给用户一个能记住的解释框架。 比喻先定,剩下的都是填细节。
2. 只读三个公开接口,全部本地计算
不申请 OAuth,不要任何授权,就三个公开端点,Promise.all 并发拿:
js
async function fetchGithub(username){
  const base = "https://api.github.com";
  const headers = { "Accept": "application/vnd.github+json" };

  const [pr, rr, er] = await Promise.all([
    fetch(`${base}/users/${encodeURIComponent(username)}`, { headers }),
    fetch(`${base}/users/${encodeURIComponent(username)}/repos?per_page=100&sort=pushed`, { headers }),
    // events 是可选数据源,失败不该拖垮整个流程
    fetch(`${base}/users/${encodeURIComponent(username)}/events/public?per_page=100`, { headers })
      .catch(() => null)
  ]);

  if (pr.status === 404) throw new Error("NOT_FOUND");
  if (pr.status === 403 || pr.status === 429) throw new Error("RATE_LIMIT");
  if (!pr.ok) throw new Error("API_FAIL");

  const profile = await pr.json();
  const repos  = rr.ok ? await rr.json() : [];
  const events = (er && er.ok) ? await er.json().catch(() => []) : [];

  return { profile, repos, events };
}
两个细节:
events单独catch。/events/public对某些账号返回空数组甚至失败,但它只影响"夜行指数"这一项,不该让整个档案挂掉,所以降级成空数组。- 错误要分级 。
404是用户不存在,403/429是限流,提示语完全不同------前者该让用户检查拼写,后者该告诉他"等一会儿再来"。
3. 分享卡:Canvas 导出 + 绕开画布污染
把头像画进 Canvas 再 toBlob 导出,是这类"生成图片"需求的标准做法,也是标准坑:
js
const img = new Image();
img.crossOrigin = "anonymous";   // 关键:不加这行,canvas 会被标记为污染
img.src = avatarUrl;             // GitHub 头像走 CDN,需要 CORS 放行

img.onload = () => {
  // 统一做旧:灰度 + 降对比 + 轻微 sepia,和牛皮纸底纹统一
  ctx.filter = "grayscale(.35) contrast(1.05) sepia(.12)";
  ctx.drawImage(img, x, y, w, h);
};

// 导出
canvas.toBlob(done, "image/png");
示例账号那头像我干脆转成 base64 内嵌进 HTML 了------顺带解决了断网、限流时示例档案缺头像的问题,一举两得。
4. 单文件 HTML,零依赖零构建
整个应用就是一个 71KB 的 index.html,原生 JS,不引任何 CDN、不用打包工具、字体全走系统字体。
好处很直接:发布即上线,改一行重新发布就行,链接不变。也避免了"高峰期 CDN 挂了、字体没加载出来、页面样式全崩"这类在分享场景特别致命的问题。
bash
code-archaeologist/
├── index.html          # 单文件应用,双击即可打开
├── assets/
│   └── demo-avatar.png # 演示头像(已内嵌进 HTML)
└── screenshots/
想本地跑,下载 index.html 双击就行,不需要起服务。
踩的两个坑
第一是匿名接口限流。 GitHub 未认证请求每小时只有 60 次,超了直接 403。所以除了分级报错,还做了离线兜底:接口不可用时可以切到内置示例档案,保证打开的人永远有东西看,不会对着白屏。
第二是画布污染。 就是上面那段 crossOrigin。值得一提的是它有个隐蔽点:图片加载成功、但没设 crossOrigin 时,drawImage 不报错,直到 toBlob 才抛 SecurityError,报错位置和真正原因隔了好几行,第一次很容易查错方向。
这两件事都不难,但都属于"不实际跑一遍就发现不了"的类别。用 WorkBuddy 做的好处是它可以直接跑一遍再报错,比自己盲改快很多。
关于隐私
这个工具只读三个公开接口,不涉及任何授权登录。拿到的数据全部在浏览器本地计算和渲染,不上传、不落库、不留存。关掉页面,什么都没留下。
如果你也在做读取用户第三方数据的工具,这条建议值得抄:能不申请授权就不申请。只读公开数据的方案,隐私说明一句话就能写完,用户的心理门槛也低得多。
最后
想看自己是什么人格,点这里直接测,三秒出结果:
github-archaeology.app.workbuddy.host/?sharecode=...
也可以直接拼用户名,打开就是他自己的档案:
ini
https://github-archaeology.app.workbuddy.host/?sharecode=HVE7YZLNGQ&u=你的GitHub用户名测完欢迎在评论区报一下你的人格式,我挺想知道「夜掘·地层编年史官」到底有多少同款。
本文作品参加 WorkBuddy「1024 造物挑战」程序员节应用创作大赛。
技术栈:单文件 HTML + 原生 JS | GitHub REST API | Canvas 2D