GitHub 今日推荐|gpu-unlock-ada:Ada 显卡张量算力翻倍解锁
一句话看懂
项目地址:github.com/JustAResear...
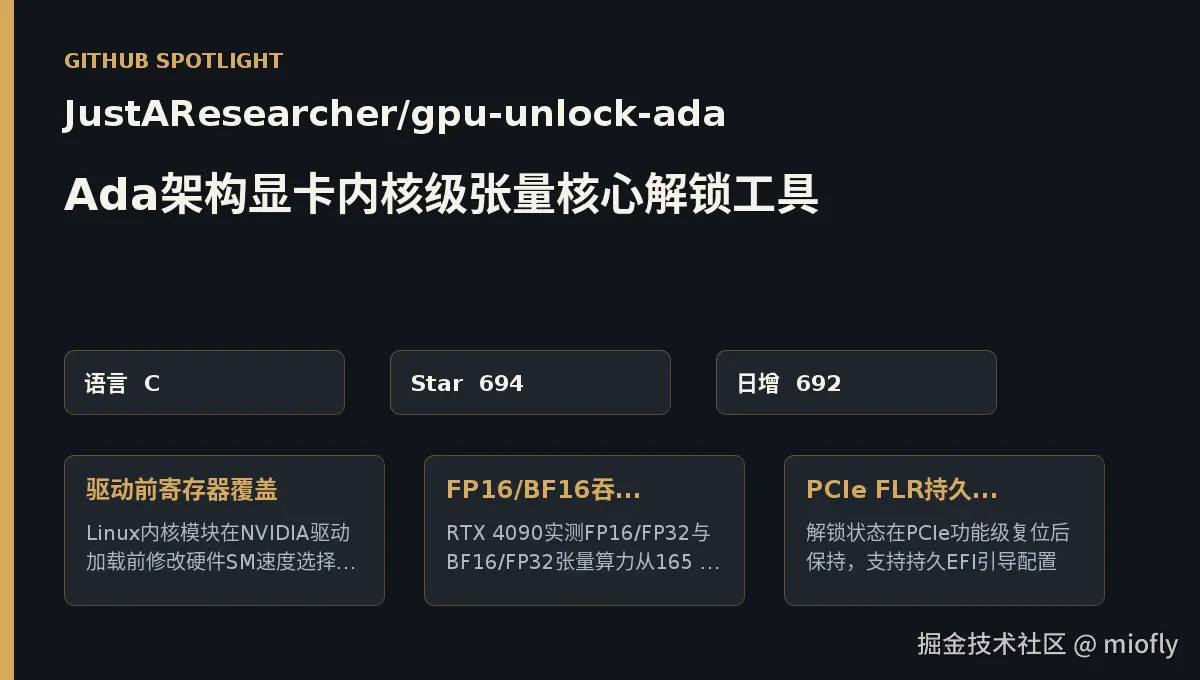
gpu-unlock-ada 是针对 NVIDIA Ada 架构消费级显卡的内核级解锁方案。在 Linux 启动阶段加载内核模块,抢在官方驱动之前修改显卡流多处理器速度档位控制寄存器,将 RTX 4090 的 FP16/FP32 与 BF16/FP32 张量吞吐从 165 TF/s 提升至 331 TF/s,接近两倍性能。INT8、dp4a 等其他算子速率维持基线水平。解锁状态在 PCIe 功能级复位后仍然保持,支持持久化引导配置。
目前验证支持 RTX 4090、RTX 4070 Ti SUPER、RTX 4060 Ti 16GB 三个型号,其他 Ada 型号未确认兼容性。
它解决什么问题
NVIDIA 在消费级 Ada 显卡中默认限制了张量核心的速度选择配置,导致 FP16、BF16 这类数据类型的张量运算吞吐低于硬件物理上限。专业卡 RTX A 系列不受此限制,但价格数倍于消费级卡。
深度学习训练和推理大量使用 FP16/BF16 矩阵乘法,cuBLAS、CUTLASS 等库调用张量核心时受限于显卡默认速度档位。在相同功耗上限下,可用算力被人为压低,训练迭代时间延长,推理服务吞吐受限。
gpu-unlock-ada 通过在硬件层面修改速度选择器,移除这个人为限制,使消费级卡接近专业卡的张量算力水平。用户无需更换驱动或修改应用代码,透明获得性能提升。
核心概念速览
SM 速度选择覆盖:流多处理器内部有速度档位控制寄存器,不同值对应不同算子类型的频率倍数。项目将 SS0 写为 0x88888888、SS1 写为 0x8,启用全速率张量算子。
Booter 载荷:GPU 固件引导代码段及其签名序列的打包形式。包含 FWSEC-FRTS 及 V67 签名,用于在受保护模式下执行寄存器写入。
PCIe FLR:PCIe 功能级复位,重置设备状态但不下电。项目固件执行完寄存器修改后触发 FLR,使 NVIDIA 驱动接管一个干净的 GSP(GPU 系统处理器)状态。
WPR2:受保护寄存器区域状态标记。固件初始化后该标记非零时拒绝重复运行序列,保证安全性。冷启动会清空此标记,热重启可能保留导致二次运行失败。
架构拆解
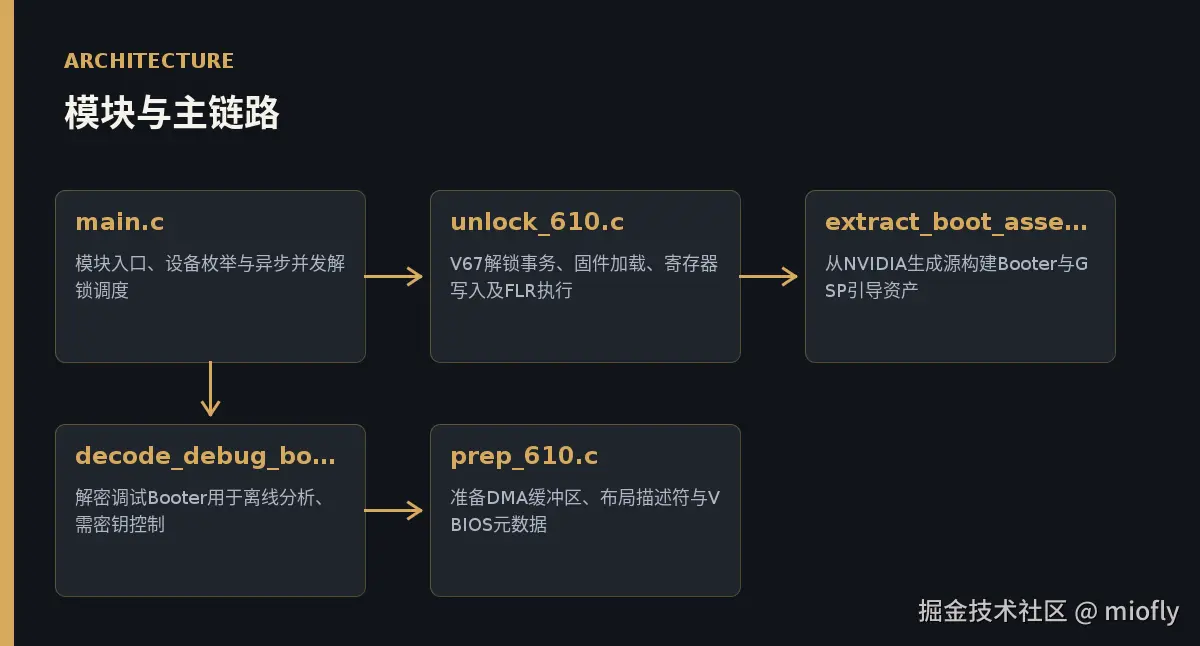
项目分为固件生成与内核模块两个部分。
固件生成位于 firmware/ 目录,extract_boot_assets.py 从 NVIDIA 610.43.03 驱动源代码中提取 Booter 与 GSP 引导资产,验证 SHA-256 哈希后打包成模块可加载的二进制固件。decode_debug_booter.py 用于离线分析调试 Booter,需要密钥控制。
内核模块位于 kernel/gpu_unlock/ 目录,main.c 是入口,负责设备枚举、固件加载和异步并发调度。prep_610.c 准备 DMA 缓冲区、布局描述符与 VBIOS 元数据。unlock_610.c 执行 V67 解锁事务,完成固件加载、寄存器写入、FLR 触发的完整流程。
模块必须在 initramfs 中加载,优先于 NVIDIA 官方驱动。设备枚举时检查 PCI 设备 ID 是否在支持列表中,匹配则为该卡分配异步任务。所有卡并发执行解锁流程,单卡失败不影响其他卡。
AD102 载荷来自 TOTORONG/AD103_win_unlocker 的已发布数据,项目将其集成到 Linux 内核模块路径中。
关键实现走读
设备枚举与参数校验
c
static int __init gpu_unlock_init(void)
{
	struct pci_dev *pdev = NULL;
	bool all;
	int ret;

	/* Loaded ahead of nvidia on every boot; the command line is the opt-in. */
	if (!targets || !*targets)
		return 0;
	all = !strcmp(targets, "all");
	if (!all)
		report_unmatched();
	while ((pdev = next_supported(pdev))) {
		if (pdev->device == GU_AD103_RTX_4070_TI_SUPER &&
		    (all || strcasecmp(targets, pci_name(pdev)))) {
			pci_err(pdev, "gpu_unlock: experimental AD103 requires a single exact PCI target\n");
			continue;
		}
做了什么 :模块初始化时检查内核命令行参数 gpu_unlock.targets,为空则直接返回保持静默。targets 为 all 时枚举所有支持的卡,否则仅处理匹配的 PCI 地址。AD103(RTX 4070 Ti SUPER)检测到 all 或非精确匹配时跳过,打印错误。
为什么这样写:模块每次启动都会加载在 NVIDIA 驱动之前,命令行参数是用户选择退出的开关。AD103 芯片处于实验阶段,payload 稳定性未充分验证,强制用户显式指定单张卡地址并启用实验标志,避免多卡配置中误触发。
没有它会怎样 :无参数保护时模块会尝试解锁所有检测到的卡,可能导致未经用户确认的硬件状态修改。AD103 无单地址检查时 all 会触发实验芯片,增加未知风险。
固件资产打包
python
def build_bundle(source_text: str) -> bytes:
    image, _, _ = _array_bytes(source_text, "IMAGE_PROD")
    header, _, _ = _array_bytes(source_text, "HEADER_PROD")
    signatures, _, _ = _array_bytes(source_text, "SIG_PROD")
    patch_loc, _, _ = _array_bytes(source_text, "PATCH_LOC")
    patch_meta, _, _ = _array_bytes(source_text, "PATCH_META")
    num_sigs, _, _ = _array_bytes(source_text, "NUM_SIGS")
    if len(header) != 36 or len(patch_loc) != 4 or len(patch_meta) != 12 or len(num_sigs) != 4:
        raise ValueError("unexpected BooterLoad record size")
    fields = struct.unpack("<9I", header)
    loc = struct.unpack("<I", patch_loc)[0]
做了什么 :从 NVIDIA 驱动源代码文本中提取六个 C 数组(IMAGE_PROD、HEADER_PROD、SIG_PROD 等),验证头部、补丁位置、签名数量字段的长度,解包为整数结构体。
为什么这样写:NVIDIA 驱动源以 C 数组形式内嵌固件镜像与签名序列。直接解析文本提取字节流,避免依赖 NVIDIA 私有构建工具。固定长度校验保证数据结构未变化,与模块硬编码的 SHA-256 哈希对应。
没有它会怎样:模块无法获得认证通过的 Booter 载荷,硬件安全模块拒绝执行未签名固件,寄存器写入失败。手动构造签名几乎不可能,依赖官方驱动资产是唯一可行路径。
动手上手
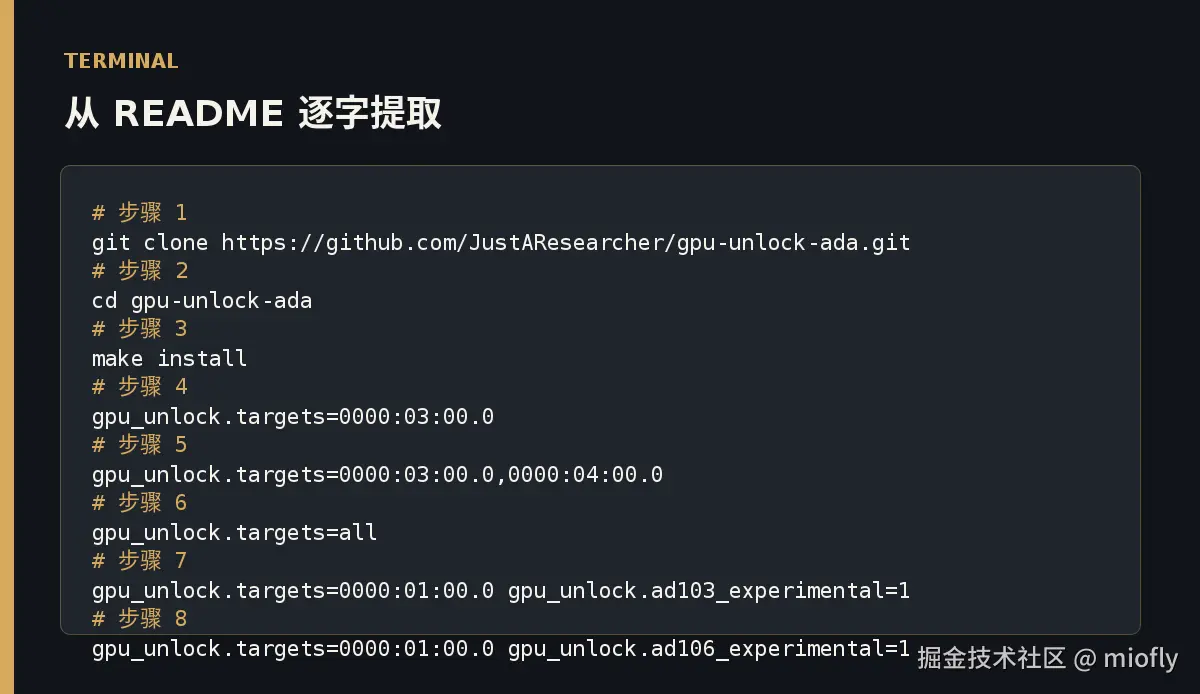
克隆仓库并编译安装模块:
bash
git clone https://github.com/JustAResearcher/gpu-unlock-ada.git
cd gpu-unlock-ada
make install
make install 会自动调用 extract_boot_assets.py 生成固件,编译内核模块并复制到 /lib/modules/ 对应目录,更新 initramfs。
冷启动机器,在 GRUB 引导菜单编辑内核命令行,添加参数指定目标显卡:
bash
gpu_unlock.targets=0000:03:00.0多张卡用逗号分隔:
bash
gpu_unlock.targets=0000:03:00.0,0000:04:00.0解锁所有支持的卡(不包括实验型号):
bash
gpu_unlock.targets=allAD103 或 AD106 型号必须单独指定并启用实验标志:
bash
gpu_unlock.targets=0000:01:00.0 gpu_unlock.ad103_experimental=1启动后检查内核日志确认解锁:
成功输出 gpu_unlock: unlocked。运行 cuBLAS GEMM 测试验证 FP16/BF16 吞吐是否翻倍。
持久化配置需将参数写入 /etc/default/grub 的 GRUB_CMDLINE_LINUX 行,执行 update-grub 后重启。保留原始引导项用于回滚。
应用场景
科研服务器 FP16 训练加速:深度学习团队在 Linux 服务器上运行 PyTorch、TensorFlow 训练任务,大量使用混合精度(FP16/FP32)。安装模块后在 GRUB 配置中指定显卡 PCI 地址,冷启动验证日志后持久化引导项。训练时矩阵乘法吞吐翻倍,迭代时间缩短。每次启动检查日志确认解锁状态,首次必须冷启动清空 WPR2 标记。
多卡工作站选择性解锁 :工作站安装四张 RTX 4090,用 lspci 获取完整 PCI 地址,逗号分隔传给 targets 参数。部分卡用于渲染不解锁,部分卡专用于计算启用解锁。AD103/AD106 必须单地址且开启实验标志,all 不会选中它们,避免误操作。
cuBLAS GEMM 吞吐优化:高性能计算应用直接调用 cuBLAS 或 CUTLASS 库执行矩阵乘法。解锁后运行 FP16/BF16 GEMM 测量实际增益,验证特定矩阵形状下的加速比。README 记录形状依赖性,4096³ BF16 矩阵基本无变化,其他形状提升显著。这不是整体应用加速,仅针对张量算子。
独立分析
独立分析:项目仓库在 24 小时内新增 692 星标,反映社区对 Ada 显卡解锁的强烈兴趣。三个开放 issue 集中在非验证型号兼容性与长期稳定性问题,说明用户群体已开始实际部署。
RTX 4090 在 README 表格中记录 FP16→FP32 积累从 165.6 TF/s 提升至 331.6 TF/s,独立所有者在 8855e7b 版本测得从 160.4 提升至 320.4 TF/s,数据一致性高。RTX 4070 Ti SUPER 在 240W 功耗上限下从 95.0 提升至 189.9 TF/s,功耗效率翻倍。INT8 与 dp4a 算子速率保持基线水平未变,证明修改仅影响速度选择器对应的张量路径。
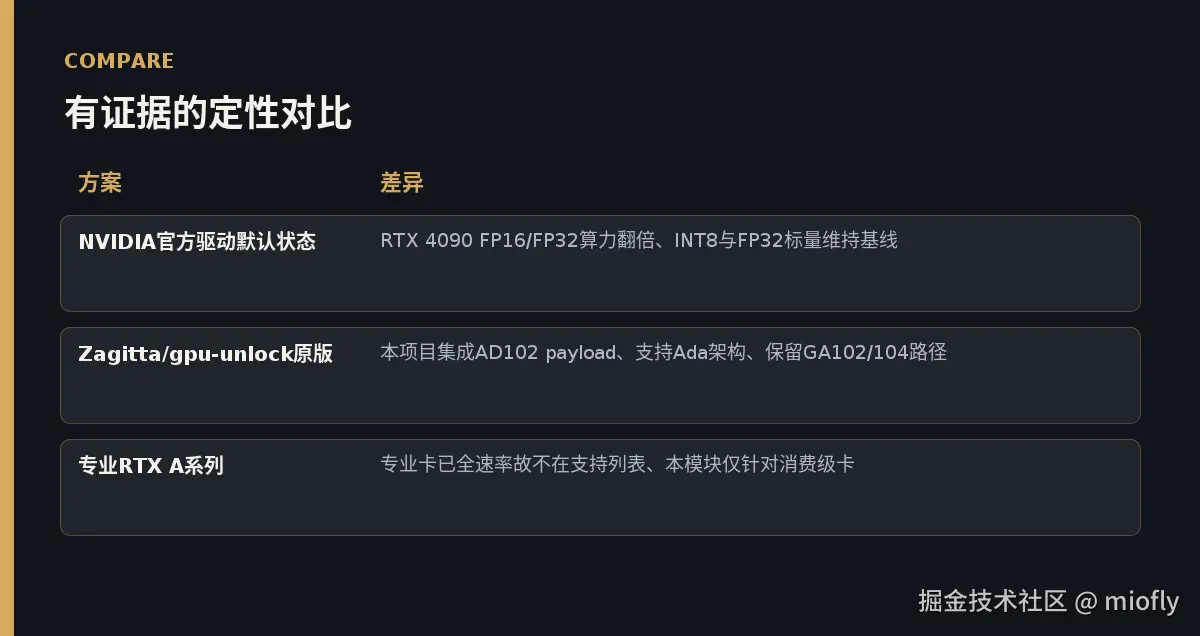
与 NVIDIA 官方驱动默认状态对比,FP16/FP32 算力翻倍,INT8 与 FP32 标量维持基线,性能提升集中在目标数据类型。与 Zagitta/gpu-unlock 原版对比,本项目集成 AD102 payload,支持 Ada 架构,保留 GA102/104 路径,架构延续性好。与专业 RTX A 系列对比,专业卡已全速率故不在支持列表,本模块专门针对消费级卡移除人为限制。
项目依赖 TOTORONG/AD103_win_unlocker 的已发布 payload,使用 NVIDIA 610.43.03 固件资产并验证 SHA-256 哈希。固件生成流程完全可重现,用户可自行审计 Python 脚本与 C 代码,透明度高于闭源工具。
局限与风险
仅在 RTX 4090、RTX 4070 Ti SUPER、RTX 4060 Ti 16GB 三个型号上验证,其他 Ada 型号未确认兼容性。RTX 4070 Ti SUPER 只有一张卡的验证数据,样本量小。
FP8 测量单 GEMM 增益 0.3%,未体现明显提升。其他 FP8 内核未测,性能变化不明。4096³ BF16 矩阵基本无变化,特定形状下增益依赖性需用户自行验证。
模块在 initramfs 中加载需显式内核参数 gpu_unlock.targets 启用,涉及固件生成与 EFI 配置,使用门槛高于用户空间工具。需自行编译并管理 initramfs,每次内核更新需重新安装模块。
冷启动首次尝试必须断电重启,热重启可能保留 WPR2 状态导致固件拒绝重跑。README 记录 RTX 4070 Ti SUPER 有热重启成功案例,其他板卡行为不确定。
缺乏长期稳定性测试,建议在非生产环境先行验证。显卡厂商固件更新可能改变寄存器布局或签名序列,导致模块失效。项目依赖外部 payload 的授权与合法性需自行确认,NVIDIA 可能通过驱动更新或 UEFI Secure Boot 策略阻止此类修改。
结论卡片
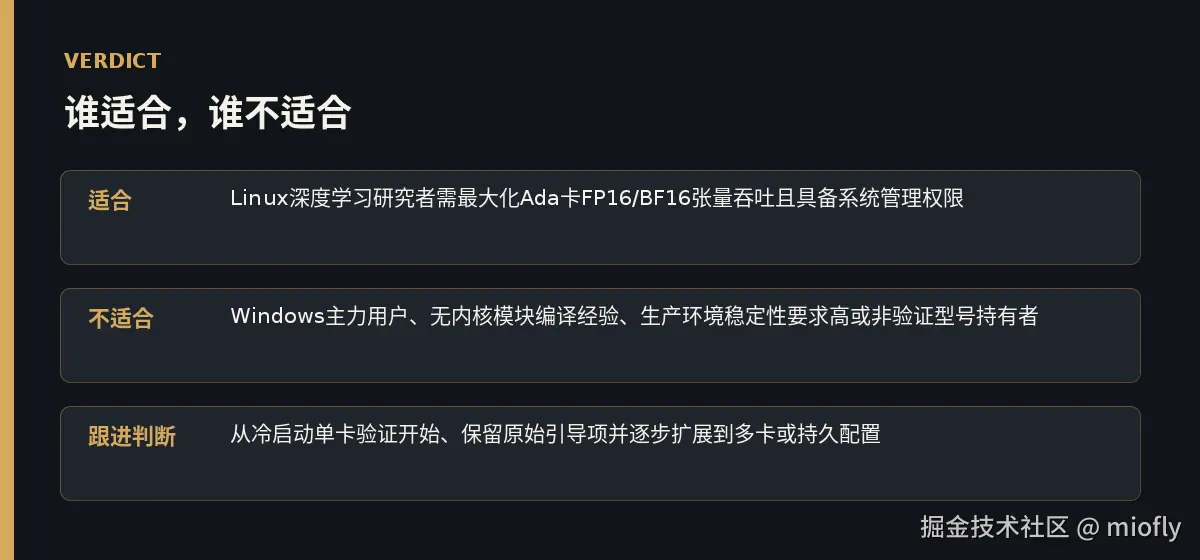
适合人群:Linux 深度学习研究者需要最大化 Ada 显卡 FP16/BF16 张量吞吐,具备系统管理权限与内核模块编译经验,愿意承担实验性工具风险。
不适合人群:Windows 主力用户,无内核模块编译经验,生产环境稳定性要求高,或持有非验证型号显卡。
建议路径:从冷启动单卡验证开始,保留原始引导项并逐步扩展到多卡或持久配置。运行自己的 GEMM 测试确认实际增益,不依赖 README 数据做决策。监控内核日志与显卡温度,发现异常立即切换回未解锁引导项。
项目地址:github.com/JustAResear...
原文地址:tools.wflynn.cn/aitools/git...
关注公众号「YourTools」,每天推送 GitHub 趋势与开源工具速报: