你手边最忙的那个博士生,平时把论文参数改几个数值、重新推一遍公式、写段代码跑出结果,一题要磨大半天到一天。
50道题从哪来:不是奥赛压轴,是改参数重算
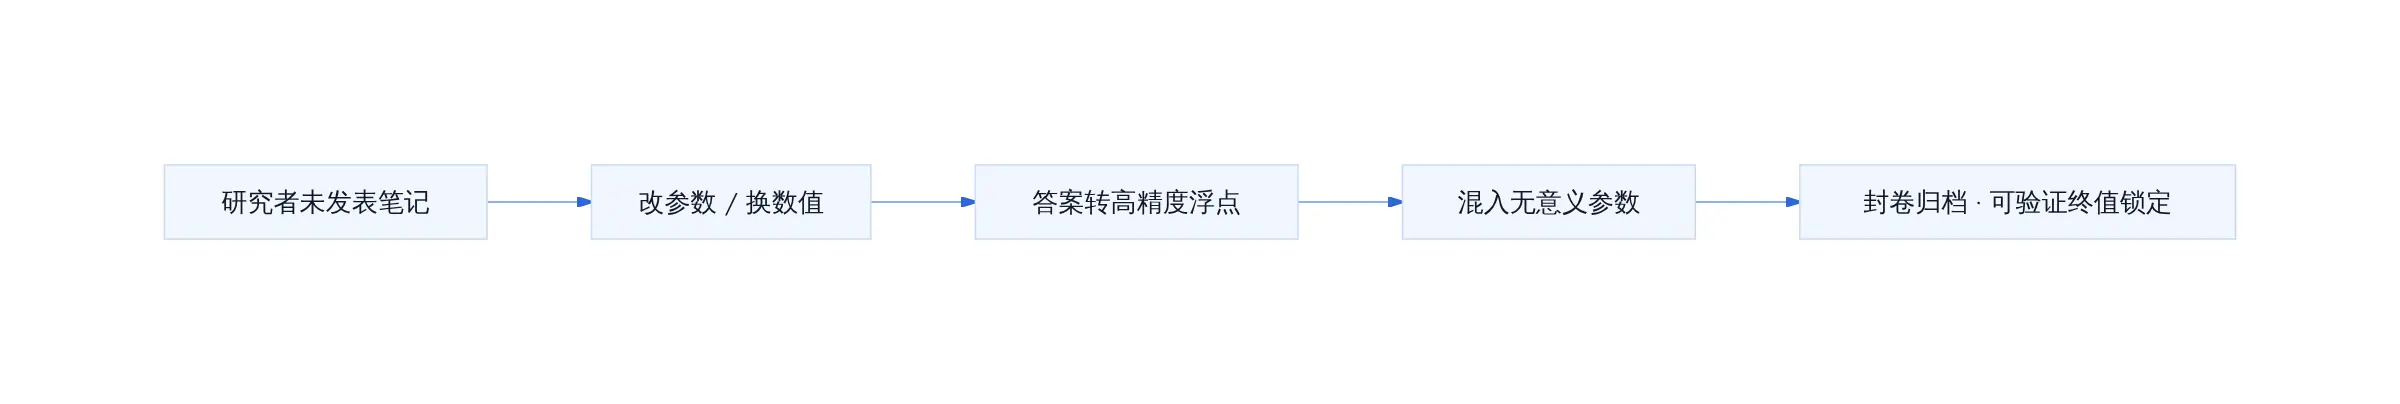
出题机制:未发表研究笔记、高精度浮点数、混入无意义参数
TheoPhysEval 的 50 道题全部来自出题者本人未发表的研究手稿。做法很直接,研究者把自己近期论文里的计算改几个数值,答案便无法靠公开题库或训练语料命中。为再加一道锁,最终答案统一转为高精度浮点数,例如 3.REDACTED...而非 3.75,同时往题目里塞若干对结果无影响的冗余参数------跳过这步推导,数值就错。35 位出题人分布在 ICTS、哈佛大学、KU Leuven、Google DeepMind、TIFR、东京大学、UT Austin 等机构,团队估算该方向顶尖专家不借助 AI 独立解一道典型题约需一天。
TheoPhysEval 出题流水线
11 个方向覆盖:量子场论、黑洞信息、流体、生物过程到宇宙学
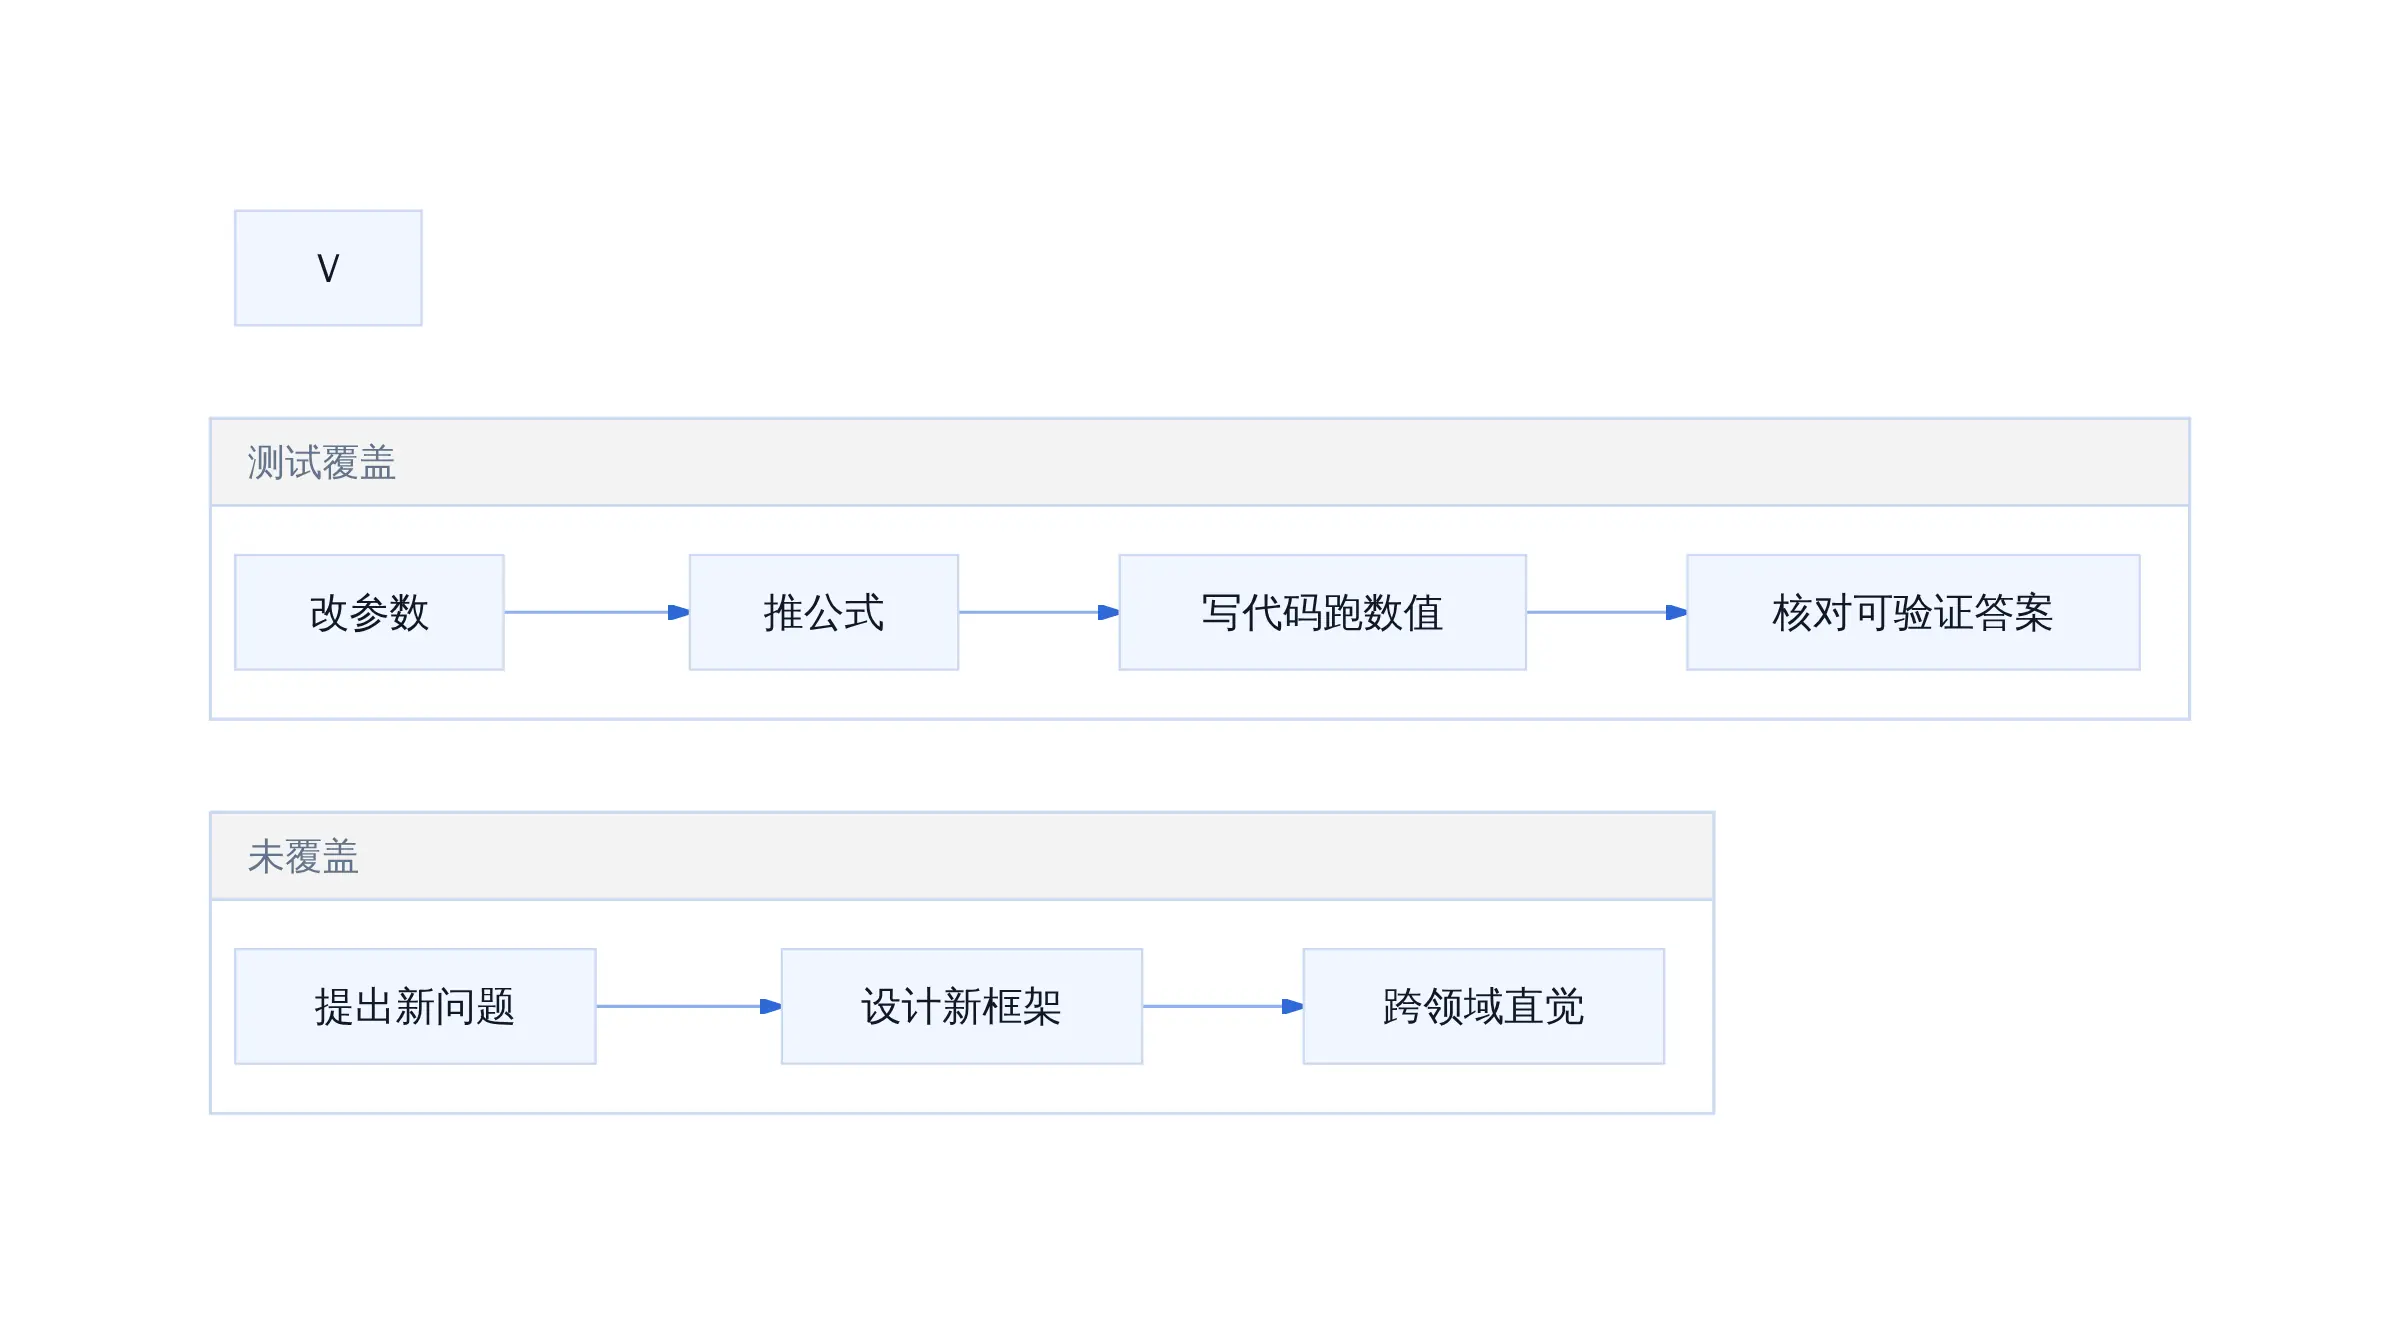
50 道题横跨 11 个理论物理子领域,涵盖量子场论、AdS/CFT、黑洞信息悖论、流体动力学、生物分子过程、粒子物理、宇宙学等。方向看起来分散,任务形态却高度一致,读文献、套已知框架、改参数、推公式、写脚本跑出可验证数值。业内把这类工作叫 "turn-the-crank",过去通常是博士生第一年的科研入门训练。它没有解决物理学,它把博士生第一年的改参数重算活儿干完了,单题成本 2.3 美元。
刻意排除项:重大开放难题不在范围内
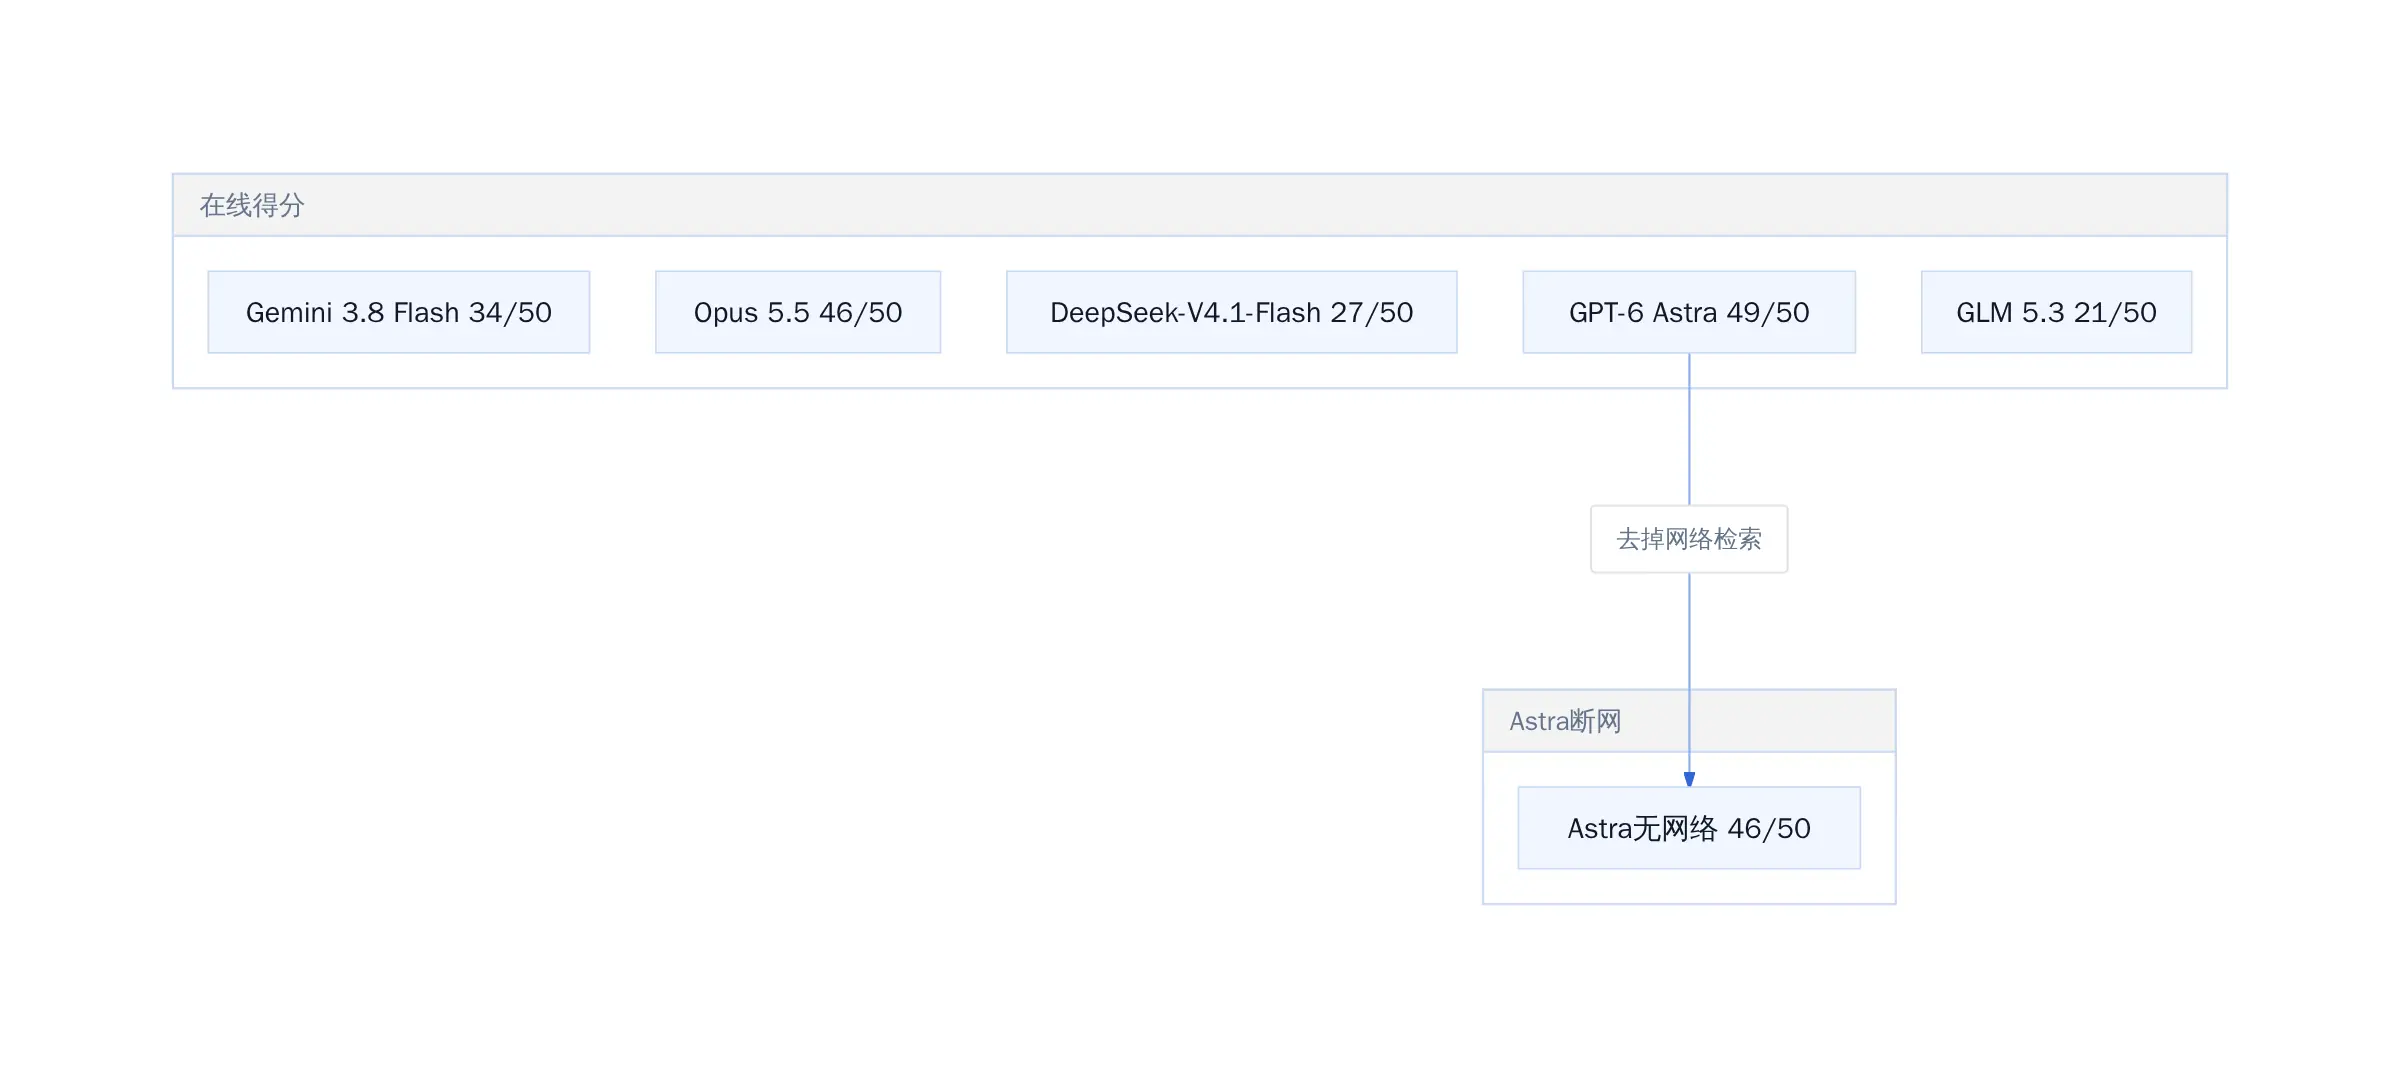
出题团队把「尚无已知解法的前沿开放问题」明确挡在门外。你不能拿这套基准判断 AI 能否提出新物理、能否突破 AdS 视界熵边界。它测的是计算执行力,给定框架与参数,能否可靠算出正确数值。断网测试印证了这条边界,GPT-6 Astra 关闭搜索后答对 46 道,准确率几乎没掉。这句话比 98% 那个数字更值得划重点,说明模型已把所需物理文献的大部分记进了权重,搜索只是锦上添花,不是推理引擎。
98%的分数怎么读:答对的是可验证数值,不是证明新定理
五个模型的分数排下来
arXiv:2610.16733的realistic track给出一组干净数字:GPT-6 Astra在Codex环境解出49/50,Opus 5.5在Claude Code中46/50,Gemini 3.8 Flash 34/50,DeepSeek-V4.1-Flash 27/50,GLM 5.3 21/50。梯队分得很开,头两名咬得紧,后三名逐级滑落。
但论文原文写得很直白:「These are fractions of correct final answers, not measures of reasoning quality, speed, or research breakthroughs.」这个98%衡量的是最终数值对不对,不是推理路径是否优雅,不是求解用了多少步,更不是它有没有推导出新结论。它测的恰好是那种博士生第一年要干的活:框架已知,方法成熟,改一组参数,重推一遍,跑出可验证的数。
单题2.3美元对上一天人肉算力
Astra跑完全套50题总花费116美元,折合单题2.33美元。对照一下人力成本:国内高校理论物理博士生的月津贴加助研,大致六千到一万二,摊到每天八小时有效科研时间,一天的人力成本保守估三百到五百。AI把这道活儿的报价压到了人肉算力的不到三百分之一。
更狠的是,这50道全是「turn-the-crank」型题目,不需要任何原创性判断。
分数只反映「答案对不对」,不衡量过程
还有一个容易被忽略的口径问题。TheoPhysEval的评分标准是最终数值与参考答案匹配即算对,不检查中间推导是否自洽,不记录求解耗时,不判断模型是否真的「理解」了所涉及的物理图像。一道题哪怕模型靠模式匹配蒙对了数值,只要末位有效数字对得上,就计1分。
这意味着98%是一个上限估计而非能力证明。如果同一批模型去做一道需要构造新近似方案的开放题,分数会大幅缩水,而TheoPhysEval的设计恰恰排除了这类题。分数反映的是「已知框架内的计算执行力」,别把它读成「AI能搞物理了」。
分数是上限不是证明,口径比数字本身更关键
TheoPhysEval五模型在线得分与Astra断网对比
一道AI算错的题,复查后人类参考答案先改了
事件经过:系数写反、重新推导、归属翻转
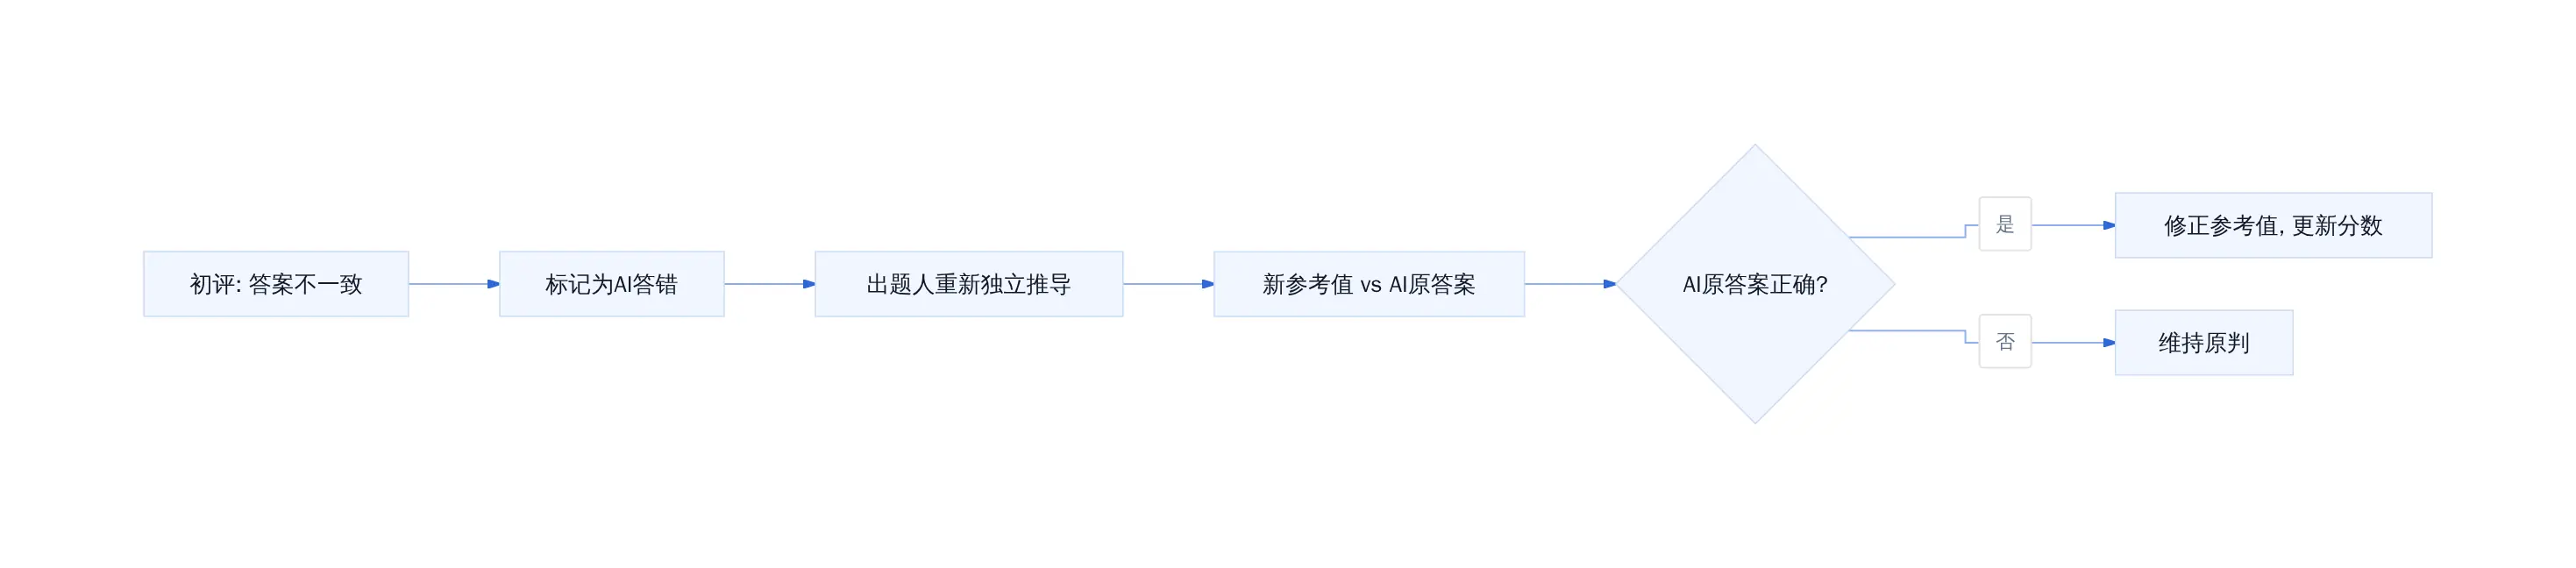
初评时Astra有2道流体方向题被判「答错」,总分停在44/50,即88%。复核团队把这两题的答案用高精度浮点数逐项比对,发现其中一道参考解的耦合系数被出题人从笔记誊到评测脚本时正负号写反了。重新独立推导后,Astra交出的那个数值才是对的。参考值一改,成绩跳到98%。
出错不在AI侧。50道题由35位研究者各自从未发表笔记拆出,推导与交叉核验独立完成。那个系数量级很小,手写推导时正负号确实容易滑掉。
参考答案纠错流程
对基准可信度的影响:设计者如何标注与复核
论文把定位锁死:「分数是正确最终答案的比例,不是推理质量、速度或研究突破的度量。」基准圈在计算执行力,不往「提出新物理」那边延伸。
修正依据是重新独立推导而非多模型投票,避开了「大家都算错所以答案对」的循环论证。答案格式是高精度浮点数混入无意义参数,「对」与「错」是二值的,不存在评分弹性。
更狠的是,这次系数写反反过来验证了「一天一题」的标定。35位物理学家在独立推导里能把量级很小的系数正负搞反,这道坎确实卡在人类手工精度边缘,不是出题人故意放水。
断网跑一遍,准确率几乎没掉:模型背了多少物理文献
无搜索条件下的成绩变化幅度
测试设了两组条件。有搜索时 Astra 答对 49/50,切断后掉到 46/50。三道差距集中在需要查特定文献表格数值或近期预印本细节的题上,推导主干没有断。团队原话很直白,「Accuracy barely changed without search, which suggests the models have memorized much of the physics literature.」断网之后准确率几乎没掉,这句话比 98% 那个数字更值得划重点。模型在预训练阶段已把 Srednicki 的场论教材、Peskin 与 Schroeder 的标准推导路径、部分高维 CFT 技术细节编码进了权重。
团队原话与解读:文献记忆 vs 真实推理的边界
记忆不等于推理。被记住的是「已知框架下标准步骤的执行序列」,不是「为什么选这个框架而非那个」。若题目要求判断某篇三个月前预印本中的正则化方案是否等价于已发表版本,模型没有检索通道就无法验证。团队在设计基准时明确把跨文献比对挡在门外,50 道题全部落在给定框架、改参数、推公式、跑数值这条线上。98% 测的是计算执行力,不是能否提出新物理。
对做科研的人来说,这道门槛现在划在哪
哪些岗位的日常计算量已被覆盖
后博士日常最典型的「拧螺丝」工作,比如把导师上周定的参数跑一遍蒙特卡洛验证、核对解析解与数值解的偏差量级、把一篇已有论文推广到另一维度重新算系数。这些活儿过去是博士生前两年的主力任务,单题耗时大半天到一天。最便宜方案 2.3 美元交卷,50 题整套 116 美元。在经费紧张的课题组里,这笔账已经算得过来。
边界:提出新问题、设计新框架、跨领域直觉仍不在测试范围
TheoPhysEval 刻意将重大开放难题排除在外。它不测你能不能从弦论对偶性里看出凝聚态系统的类比,不测你面对一组新数据时该设计什么样的有效场论,也不测跨三个子领域做模式匹配的直觉。这些能力的评测集在当前任何基准里都不存在。如果你的日常工作是拿到已发表框架后改几个参数再跑数值,今天就可以把这条线交给 AI agent;如果你的价值在于决定改哪几个参数以及为什么,那块阵地目前没人替你守。
TheoPhysEval 测试范围与未覆盖边界
参考文献
- TheoPhysEval: Assessing AI agents at autonomous theoretical physics problem solving
- 鉅亨網:AI將接管物理學?最新研究顯示GPT-6 Astra攻破世界98%物理難題
- 报价宝:AI解出50道未公开物理难题 每题约2.4美元
- Rohan Paul on X:TheoPhysEval 讨论
延伸入口
- 原文归档:tobemagic.github.io/ai-magician...
- 公众号:计算机魔术师