文章目录
- 前言
- 01、案例介绍/笔者需求
- [02、Open SQL 高级查询构造](#02、Open SQL 高级查询构造)
-
- `a.`子查询
- `b.`CTE(公用表表达式)
- [`c.`JOIN 内表](#
c.JOIN 内表) - [`d.`UNION ALL 拼接取数](#
d.UNION ALL 拼接取数)
- [03、CASE 操作](#03、CASE 操作)
- [04、内置函数 与 复杂关联](#04、内置函数 与 复杂关联)
-
- [`a.`LTRIM( ) 去除指定字符 例如去前导零](#
a.LTRIM( ) 去除指定字符 例如去前导零) - [`b.`LPAD( ) 填充指定字符 例如补充前导零](#
b.LPAD( ) 填充指定字符 例如补充前导零) - [`c.`CONCAT( ) 拼接字段](#
c.CONCAT( ) 拼接字段) - [`d.`SUBSTRING( ) 截取字段](#
d.SUBSTRING( ) 截取字段) - [`e.`RIGHT( ),LEFT( ) 简单快捷的截取字段](#
e.RIGHT( ),LEFT( ) 简单快捷的截取字段) - [`f.`LENGTH( ) 获取字符串长度](#
f.LENGTH( ) 获取字符串长度) - [`f.`COALESCE( ) 空值替换 NULL返回其他值](#
f.COALESCE( ) 空值替换 NULL返回其他值) - [`g.`CAST( ) 类型转化](#
g.CAST( ) 类型转化) - [`h.`ROUND( ) 四舍五入](#
h.ROUND( ) 四舍五入)
- [`a.`LTRIM( ) 去除指定字符 例如去前导零](#
- 05、其他技巧
-
- `a.`根据条件排序只取第一条数据
- `b.`常量替换//硬编码常量赋值//显式常量赋值
- [`c.`&& 符号拼接字段](#
c.&& 符号拼接字段)
- [06、项目实战 常用写法](#06、项目实战 常用写法)
-
- [`a.`CASE 判断 借贷标识 配合 SUM( ) 合计](#
a.CASE 判断 借贷标识 配合 SUM( ) 合计)
- [`a.`CASE 判断 借贷标识 配合 SUM( ) 合计](#
- END、总结
前言
本文目前 5000字+,这篇文章会持续更新优化,先 点赞 关注 收藏 制作不易 谢谢🤞
这篇文章给大家介绍一下 OPEN SQL 常用的一些写法 技巧 协助我们日常开发中 快速定位查阅参考资料。文章其实是从笔者另外一篇文章搬运过来的 然后 以后所有OPENSQL相关的内容都会在本文中更新 另外一篇文章写的太多了 编辑起来太卡了。另外一篇文章只能当作目录导航来用了,大家也都可以收藏一下 把另外一篇文章当作导航入口即可。
01、案例介绍/笔者需求
这里基础的 OPEN SQL不再介绍,只介绍一些实用的语法。其实不同系统版本 对于OPEN SQL 的一些语法支持是不同的。虽然代码没有爆红,但是激活的时候就提示不行。这个要根据自己ABAP版本看了,如果不持支 那么就只能在ABAP层面再操作数据了。
02、Open SQL 高级查询构造
步骤一介绍
a.子查询
这个步骤的介绍
1.示例
pass

2.示例
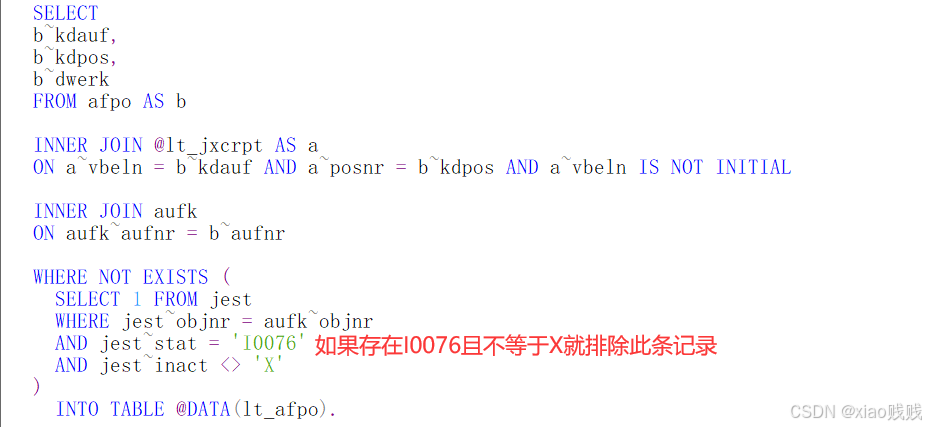
SELECT 1 并不是要真的"查出1"这个值,而是用来判断是否存在满足条件的记录。也可以写成SELECT jest~objnr 但这样多消耗一点资源,还不如直接 SELECT 1。因为我们只是想判断"是否存在满足条件的记录",并不关心那条记录里的具体字段值是什么,所以写 SELECT 1 是最简单、最省资源的方式。
3.步骤一 a 3
pass
b.CTE(公用表表达式)
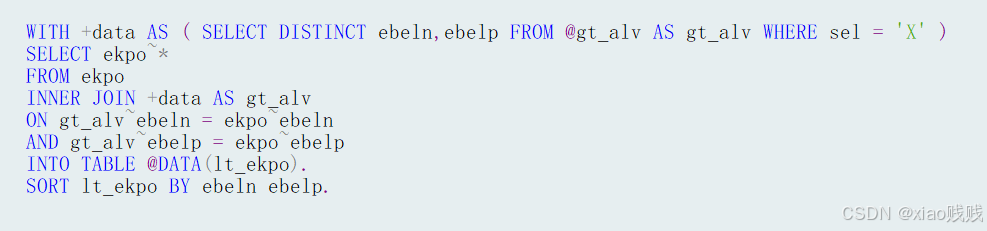
公用表表达式是一种 可以临时定义"中间结果集"的方式,类似于写程序时定义的临时变量或内表。可复用多次、可以递归。WITH:先构造中间结果(逻辑临时表),主查询:从这个临时结果中查数据;类似于程序中的"分步骤处理"。
1.示例
先把gt_alv 按照 ebeln ebelp去重 然后得到一个内表 +data ,然后用这个内表再去关联ekpo. WITH关键字后面的 +data可以随便取名的你叫 cte 也可以。
2.示例2
valid_orders 是第一层筛选的订单。filtered_orders 是第二层筛选。最终主查询是基于第二层进行的。
js
WITH valid_orders AS (
    SELECT * FROM aufk
    WHERE AUART = 'PP01'
),
filtered_orders AS (
    SELECT * FROM valid_orders
    WHERE ERDAT >= '20240101'
)
SELECT * FROM filtered_orders
WHERE WERKS = '1000'.
3.步骤一 b 3
pass
c.JOIN 内表
在JOIN内表的时候 被JOIN的内表必须AS一下,而且一个OPENSQL中最多 JOIN一个内表。
1.示例
pass
js
SELECT
	zid02~name1,
	zid02~kqnum,
	zid02~bukrs
	FROM zid02
	INNER JOIN @lt_out1 AS lt_out "被JOIN的内表必须AS一下
	ON lt_out~zzkqnum = zid02 ~kqnum
	AND lt_out~bukrs = zid02 ~bukrs
INTO TABLE @DATA(lt_name1).d.UNION ALL 拼接取数
同时取 mbew 和 mbewh 数据到 lt_mbew_8020 内表。

03、CASE 操作
CASE是OPENSQL常用之一 使用CASE可以大大减少代码量 提升性能。CASE不仅可以用到SLECT的字段上 也可以用在WHERE的条件上。
a.单个字段CASE
这个步骤的介绍
1.示例
根据工厂给库位默认值,这种操作偏向于硬编码。
js
CASE afpo~dwerk
WHEN '6553' THEN '53R1'
WHEN '6510' THEN '10R2'
END AS lgort                      "库位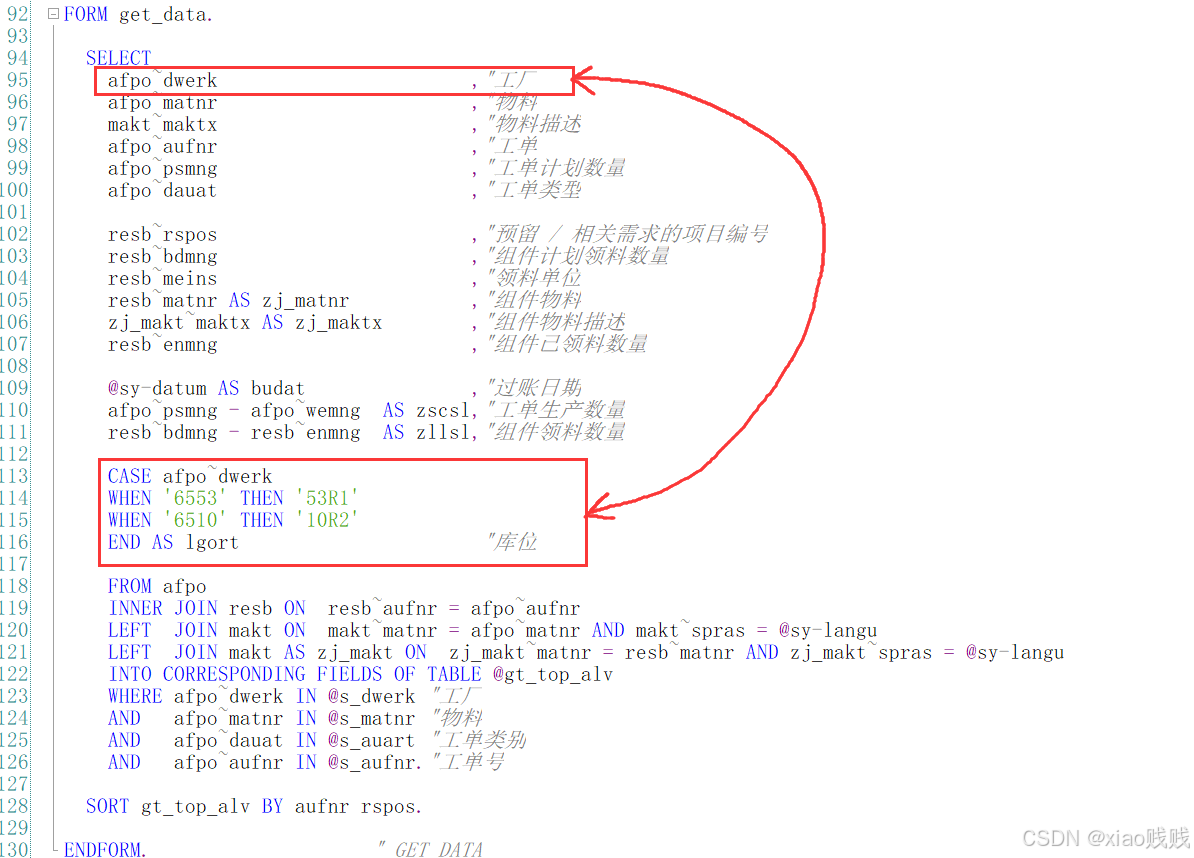
2.取不同字段
这种也是比较常用的 根据判断不同 我们就取不一样的字段
3.应用在where条件

b.多个字段CASE
这个步骤的介绍
1.示例
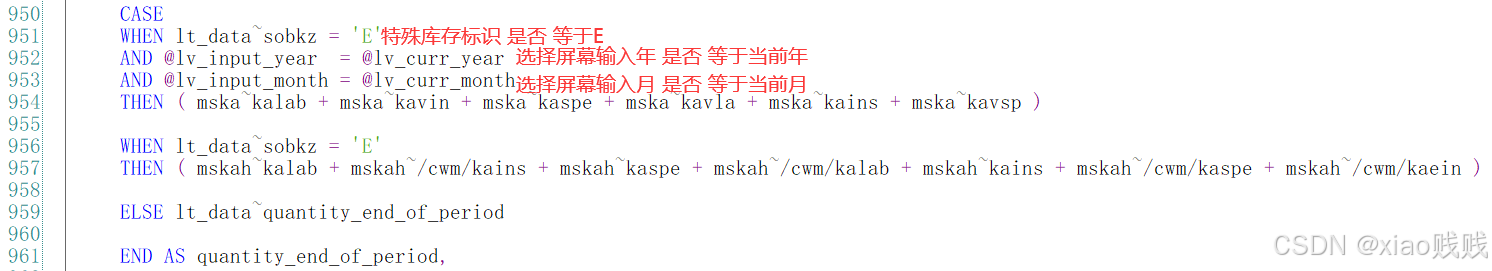
同时判断3个字段 不仅可以判断sql中的字段 也可以判断其他变量 例如选择屏幕
c.CASE嵌套
这个步骤的介绍
1.示例
在写嵌套CASE到时候 一定要缩进空行 不然挤在一起 代码可读性很差。

d.其他技巧
这个步骤的介绍
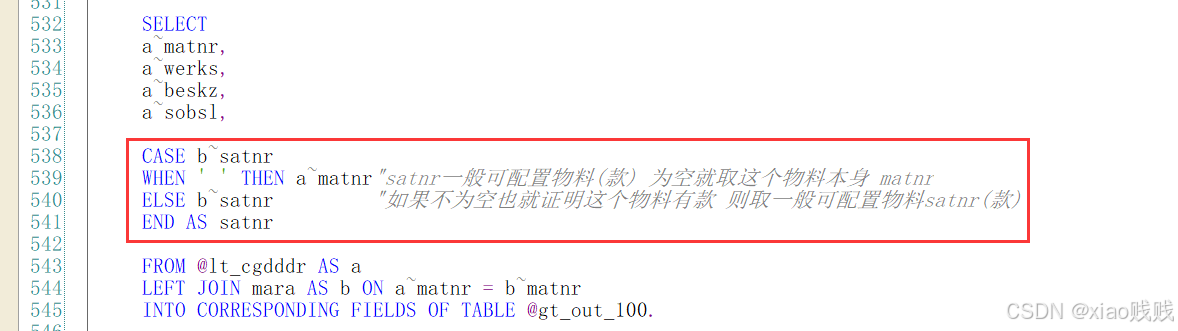
1.示例1
根据字段是否 为空 则取不同的字段。
04、内置函数 与 复杂关联
在 Open SQL 中,除了标准的 SQL 函数之外,还提供了一些额外的函数用于方便地处理数据。这些函数通常与标准的 SQL 函数一起使用,用于在查询中执行特定的操作或处理数据。利用好这些内置函数 可以大大提高我们的开发效率 这些函数不仅可以作用于字段 也可以作用于关联条件,这样就能解决一些比较复杂的关联难题。以下是一些常见的 Open SQL 额外函数,ECC好像大多数都不持支这样用。
注意:如果要将内置函数应用在关联条件中一定要用在左侧 如下图所示。

a.LTRIM( ) 去除指定字符 例如去前导零
ltrim( ) 可以用来去除指定字符 。不仅仅是去前导零哦 ,只是通常更多用于去除前导零。
1.示例
pass
js
  "vbak-vbeln 这个字段一般在表中都是有前导零的
  DATA gv_vbeln1 TYPE vbak-vbeln.
  DATA gv_vbeln2 TYPE vbak-vbeln.

  SELECT SINGLE vbeln FROM vbak INTO gv_vbeln1. "open sql 取出vbak-vbeln
  SELECT SINGLE ltrim( vbeln, '0' ) AS vbeln FROM vbak INTO gv_vbeln2."open sql 取出vbak-vbeln 去除前导零

  "数据展示
  DATA(out) = cl_demo_output=>new( ).
  out->write_data( gv_vbeln1 ).
  out->write_data( gv_vbeln2 ).
  out->display( ).
2.示例
ABAP 7.40 及更高版本中可以这样写,和上面一样 只是用了 内联声明变量。
js
  SELECT SINGLE vbeln FROM vbak INTO @data(gv_vbeln1). "open sql 取出vbak-vbeln
  SELECT SINGLE ltrim( vbeln, '0' ) AS vbeln FROM vbak INTO @data(gv_vbeln2)."open sql 取出vbak-vbeln 去除前导零

  "数据展示
  DATA(out) = cl_demo_output=>new( ).
  out->write_data( gv_vbeln1 ).
  out->write_data( gv_vbeln2 ).
out->display( ).b.LPAD( ) 填充指定字符 例如补充前导零
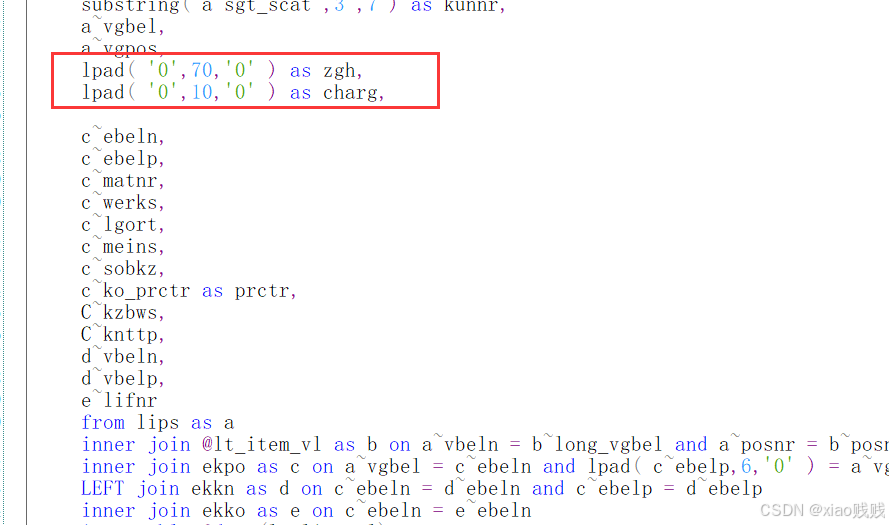
lpad( ) 可以用来填充指定字符 。不仅仅是补充导零哦 ,只是通常更多用于补充前导零。
1.示例
zgh是将字符 '0' 填充到字符串 '0' 的左侧。最终结果的长度是 70。填充字符是 '0'。目标结果是一个字符串,共有 70 个 '0'。 charg同理
c.CONCAT( ) 拼接字段
这个拼接的函数好像只能接收两个参数,下面的示例是将 KNA1 客户主数据透明表中的 客户编号(kunnr) 与 客户名称(name1 ) 两个字段拼接在了一起。下一个标题是截取字符串 我们会 用 拼接字符串 + 截取字符串 的函数 来实现一个复杂的关联条件。
除了内置函数拼接字段 我们的 && 符号也是可以在OPENSQL中拼接字段的 在最下面的大标题 其他技巧中有提到。但是 && 好像在关联条件中不能用。所以select的字段需要拼接直接用 && 关联条件字段要拼接使用函数。
1.示例
可以拼接字段,也可以直接写一个字符串
js
  SELECT SINGLE concat( kunnr, name1 ) AS full_name
  FROM kna1
  INTO @DATA(lv_full_name).

--------------------------也可以直接写一个字符串--------------------------
  SELECT SINGLE concat( '这是客户名称:', name1 ) AS full_name
  FROM kna1
  INTO @DATA(lv_full_name).
--------------------------也可以直接写一个字符串--------------------------

  "数据展示
  DATA(out) = cl_demo_output=>new( ).
  out->write_data( lv_full_name ).
  out->display( ).
d.SUBSTRING( ) 截取字段
下面的示例是将 KNA1 客户主数据透明表中的 客户名称(name1 ) 取前两个字符,1代表从第一个值开始 2代表截取2位, 如果要取第4到6个字符就是SUBSTRING( name1, 4, 2 )。
1.示例
pass
js
  SELECT SINGLE SUBSTRING( name1, 1, 2 )
  FROM kna1
  INTO @DATA(lv_name1).

  "数据展示
  DATA(out) = cl_demo_output=>new( ).
  out->write_data( lv_name1 ).
  out->display( ).
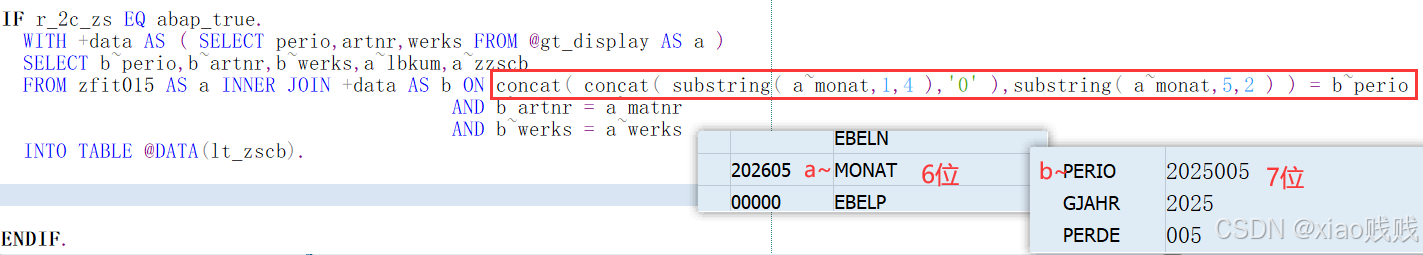
2.复杂的关联条件
项目中的实战应用:拼接 和 截取 组合使用 达到关联取数的效果,由于两个期间字段 长度不一样 所以先把6位期间的拆为年月 再给年月中间拼接上0。
3.复杂的关联条件
it_xlips 是交货单增强BADI IF_EX_LE_SHP_DELIVERY_PROC~SAVE_AND_PUBLISH_BEFORE_OUTPUT 的一个内表参数
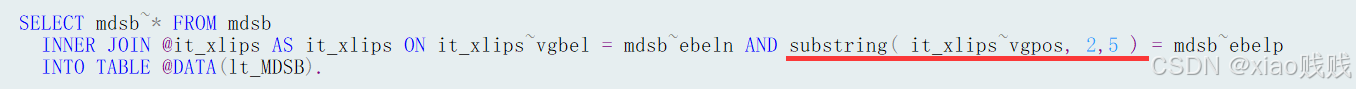
读取内表的时候也可以这样👇
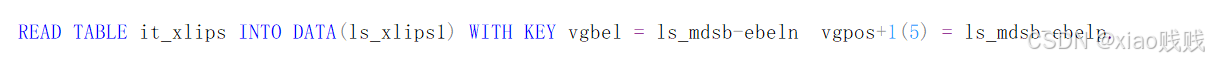
e.RIGHT( ),LEFT( ) 简单快捷的截取字段
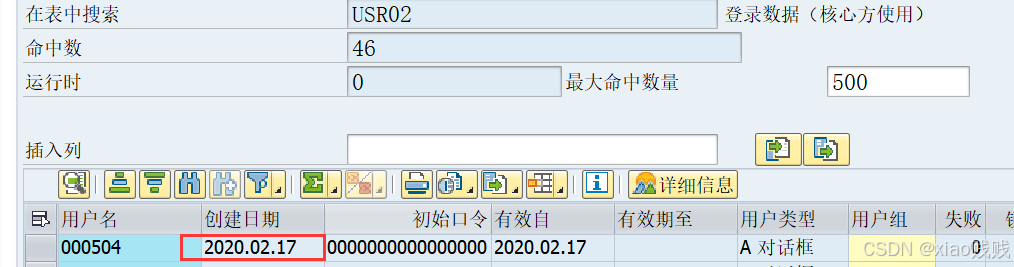
其实是从不同方向截取字符串,下面给大家一个明显的例子看完就理解了。例如一个日期是YYYYMMDD的格式 当我们想取YYYY或者想取DD的时候可以这么操作。usr02 是用户表 erdat 字段是创建日期。
1.示例
pass
js
 SELECT SINGLE erdat FROM usr02 WHERE bname = '000504' INTO @DATA(lv_erdat).
 WRITE / '正常取数:'&& lv_erdat.

 SELECT SINGLE right( erdat,2 ) FROM usr02 WHERE bname = '000504' INTO @DATA(lr_erdat).
 WRITE / 'RIGHT取数:'&& lr_erdat."取YYYYMMDD 的 DD

 SELECT SINGLE left( erdat,4 ) FROM usr02 WHERE bname = '000504' INTO @DATA(ll_erdat).
 WRITE / 'LEFT取数:'&& ll_erdat."取YYYYMMDD 的 YYYY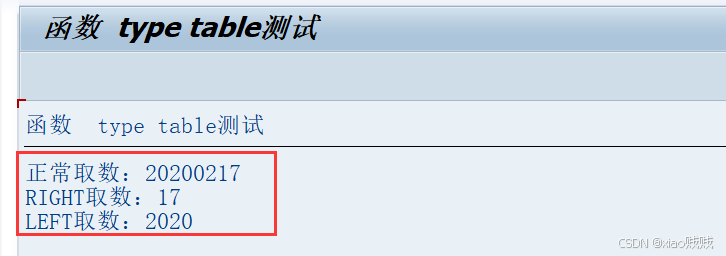
2.复杂关联取数
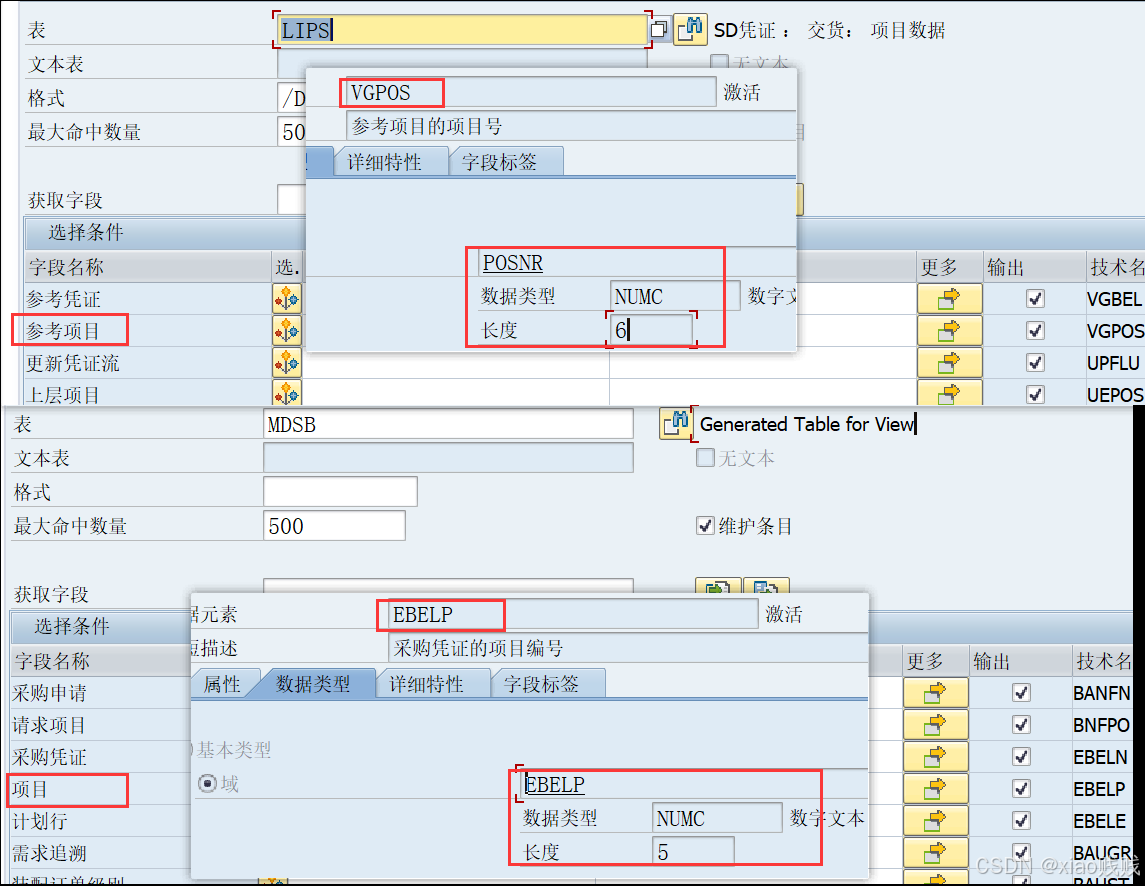
项目中的实战应用:我们有时候两张表的字段是可以关联取数的但是字段长度可能不一样 或者是你内表和透明表关联的时候最容易出现这种情况,这时候就可以借助RIGHT()去掉某几个前导零。例如下面的例子lips是交货单行项目它其实是和MDSB预留这张表有关联关系的。通过lips的VGBEL和VGPOS去关联MDSB的EBELN和EBELP。
但是发现 VGPOS 和 EBELP 长度不一样 所以要去掉 VGPOS 前面的一个0,我们就可以用 RIGHT() 从数据的右边开始取5位就可以了。
js
right( b~vgpos,5 ) = a~ebelpf.LENGTH( ) 获取字符串长度
不怎么常用
1.示例
pass
js
  SELECT SINGLE LENGTH( name1 ) AS name1_len
  FROM kna1
  INTO @DATA(lv_name1_len).

  "数据展示
  DATA(out) = cl_demo_output=>new( ).
  out->write_data( lv_name1_len ).
  out->display( ).
f.COALESCE( ) 空值替换 NULL返回其他值
用法: COALESCE( < arg1> , < arg2 > )
含义: 这个函数默认返回 < arg1> 但是如果 < arg1> 为null 则就返回 < arg2 >。
作用: 使用COALESCE确保了即使我们要取的字段为NULL,查询也不会返回NULL值,而是返回空字符串或者 其他值,这有助于避免下游处理NULL值时可能出现的错误。
1.示例
👇当y_s表的bpmng数量为空 则返回0,y_h表的bpmng数量 也是同理。

2.示例
CDS里面也可以用这个函数的,可以看这篇文章 ,文章里面直接搜COALESCE就行。
g.CAST( ) 类型转化
用法: CAST( <字段/表达式> AS <目标类型> )
含义: 把源字段/表达式的类型强制转换成目标类型。目标类型可以是内建类型(如 CHAR(n)、INT4、DEC(n,m)、STRING)
作用: 需要的时候就知道作用了。
1.示例
👇把string类型的 URL 字段截断并转成定长 CHAR(50),避免下游函数因类型不匹配报错。
string直接转CHAR

转表达式

转表定点小数类型DEC( 23,2 )

h.ROUND( ) 四舍五入
用法: ROUND( <numeric_expression> , <decimal_places> )
含义: numeric_expression:要被四舍五入的数值(可以是 DEC、FLTP 等类型)、decimal_places:保留的小数位数
作用: 四舍五入
1.示例👇
js
ROUND( 123.4567, 2 ) → 123.46
ROUND( 123.4547, 2 ) → 123.45
ROUND( 123.4567, 0 ) → 123
05、其他技巧
a.根据条件排序只取第一条数据
这里我们要熟悉 UP TO 1 ROWS 和 SINGLE 的区别,首先ORDER BY 是不能和 SINGLE 一起使用的,SINGLE 取数是查单条 按正常用法你是要指定所有的KEY 这样才能取到单条,但是当你的KEY 指定不全的时候它就取符合条件的第一条数据,但是有时候返回的数据并不是我们想要的,这时我们就可以使用 ORDER BY 配合 UP TO 1 ROWS 先取符合条件的所有数据 然后排序只循环拿取一次数据,就相当于返回了排序的第一条数据。
👇下面这个示例2是取你自己最新建立的请求号。
1.示例
pass
js
SELECT trkorr
FROM e070
UP TO 1 ROWS
INTO @DATA(lv_trkorr)
WHERE as4user = @sy-uname.

  WRITE: / '按照数据库顺序取第一条:' && lv_trkorr.

ENDSELECT.
2.示例
pass
js
SELECT trkorr
FROM e070
UP TO 1 ROWS
INTO @lv_trkorr
WHERE as4user = @sy-uname
ORDER BY as4date DESCENDING ,as4time DESCENDING.

  WRITE: / '按照日期时间降序取第一条:' && lv_trkorr.

ENDSELECT.
3.步骤二 a 3
pass
b.常量替换//硬编码常量赋值//显式常量赋值
这个步骤的介绍
1.步骤二 a 1
pass
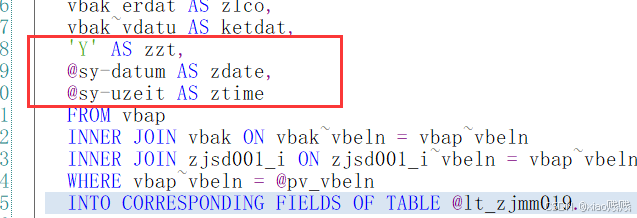
2.步骤二 a 2
pass
3.步骤二 a 3
pass
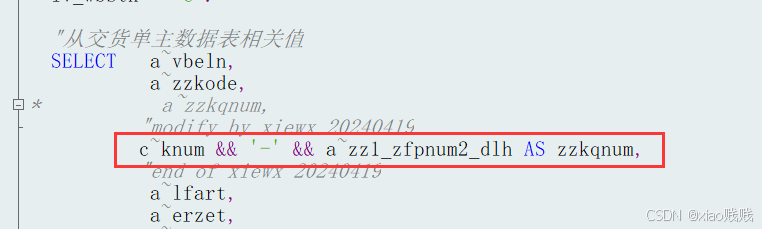
c.&& 符号拼接字段
这个比内置函数使用起来更方便
1.示例
可以连续拼接多个
06、项目实战 常用写法
这里将收集各种项目中一些常见写法,这里将运用我们上面所介绍的各种技巧函数等等 来实现 业务各种计算需求。
a.CASE 判断 借贷标识 配合 SUM( ) 合计
1.示例
pass
END、总结
以上就是今天要讲的内容,本文仅仅简单介绍了一些常用的OPENSQL用法 ,感觉这篇文章自己有学到东西或者在今后的工作中能派上用场,可以点赞收藏支持!!!也可以点击评论区的打赏图标进行打赏,制作不易非常感谢,当然如果有说错或者不好的地方还望大家提出来见谅,欢迎大家评论指出不好的地方。谢谢!