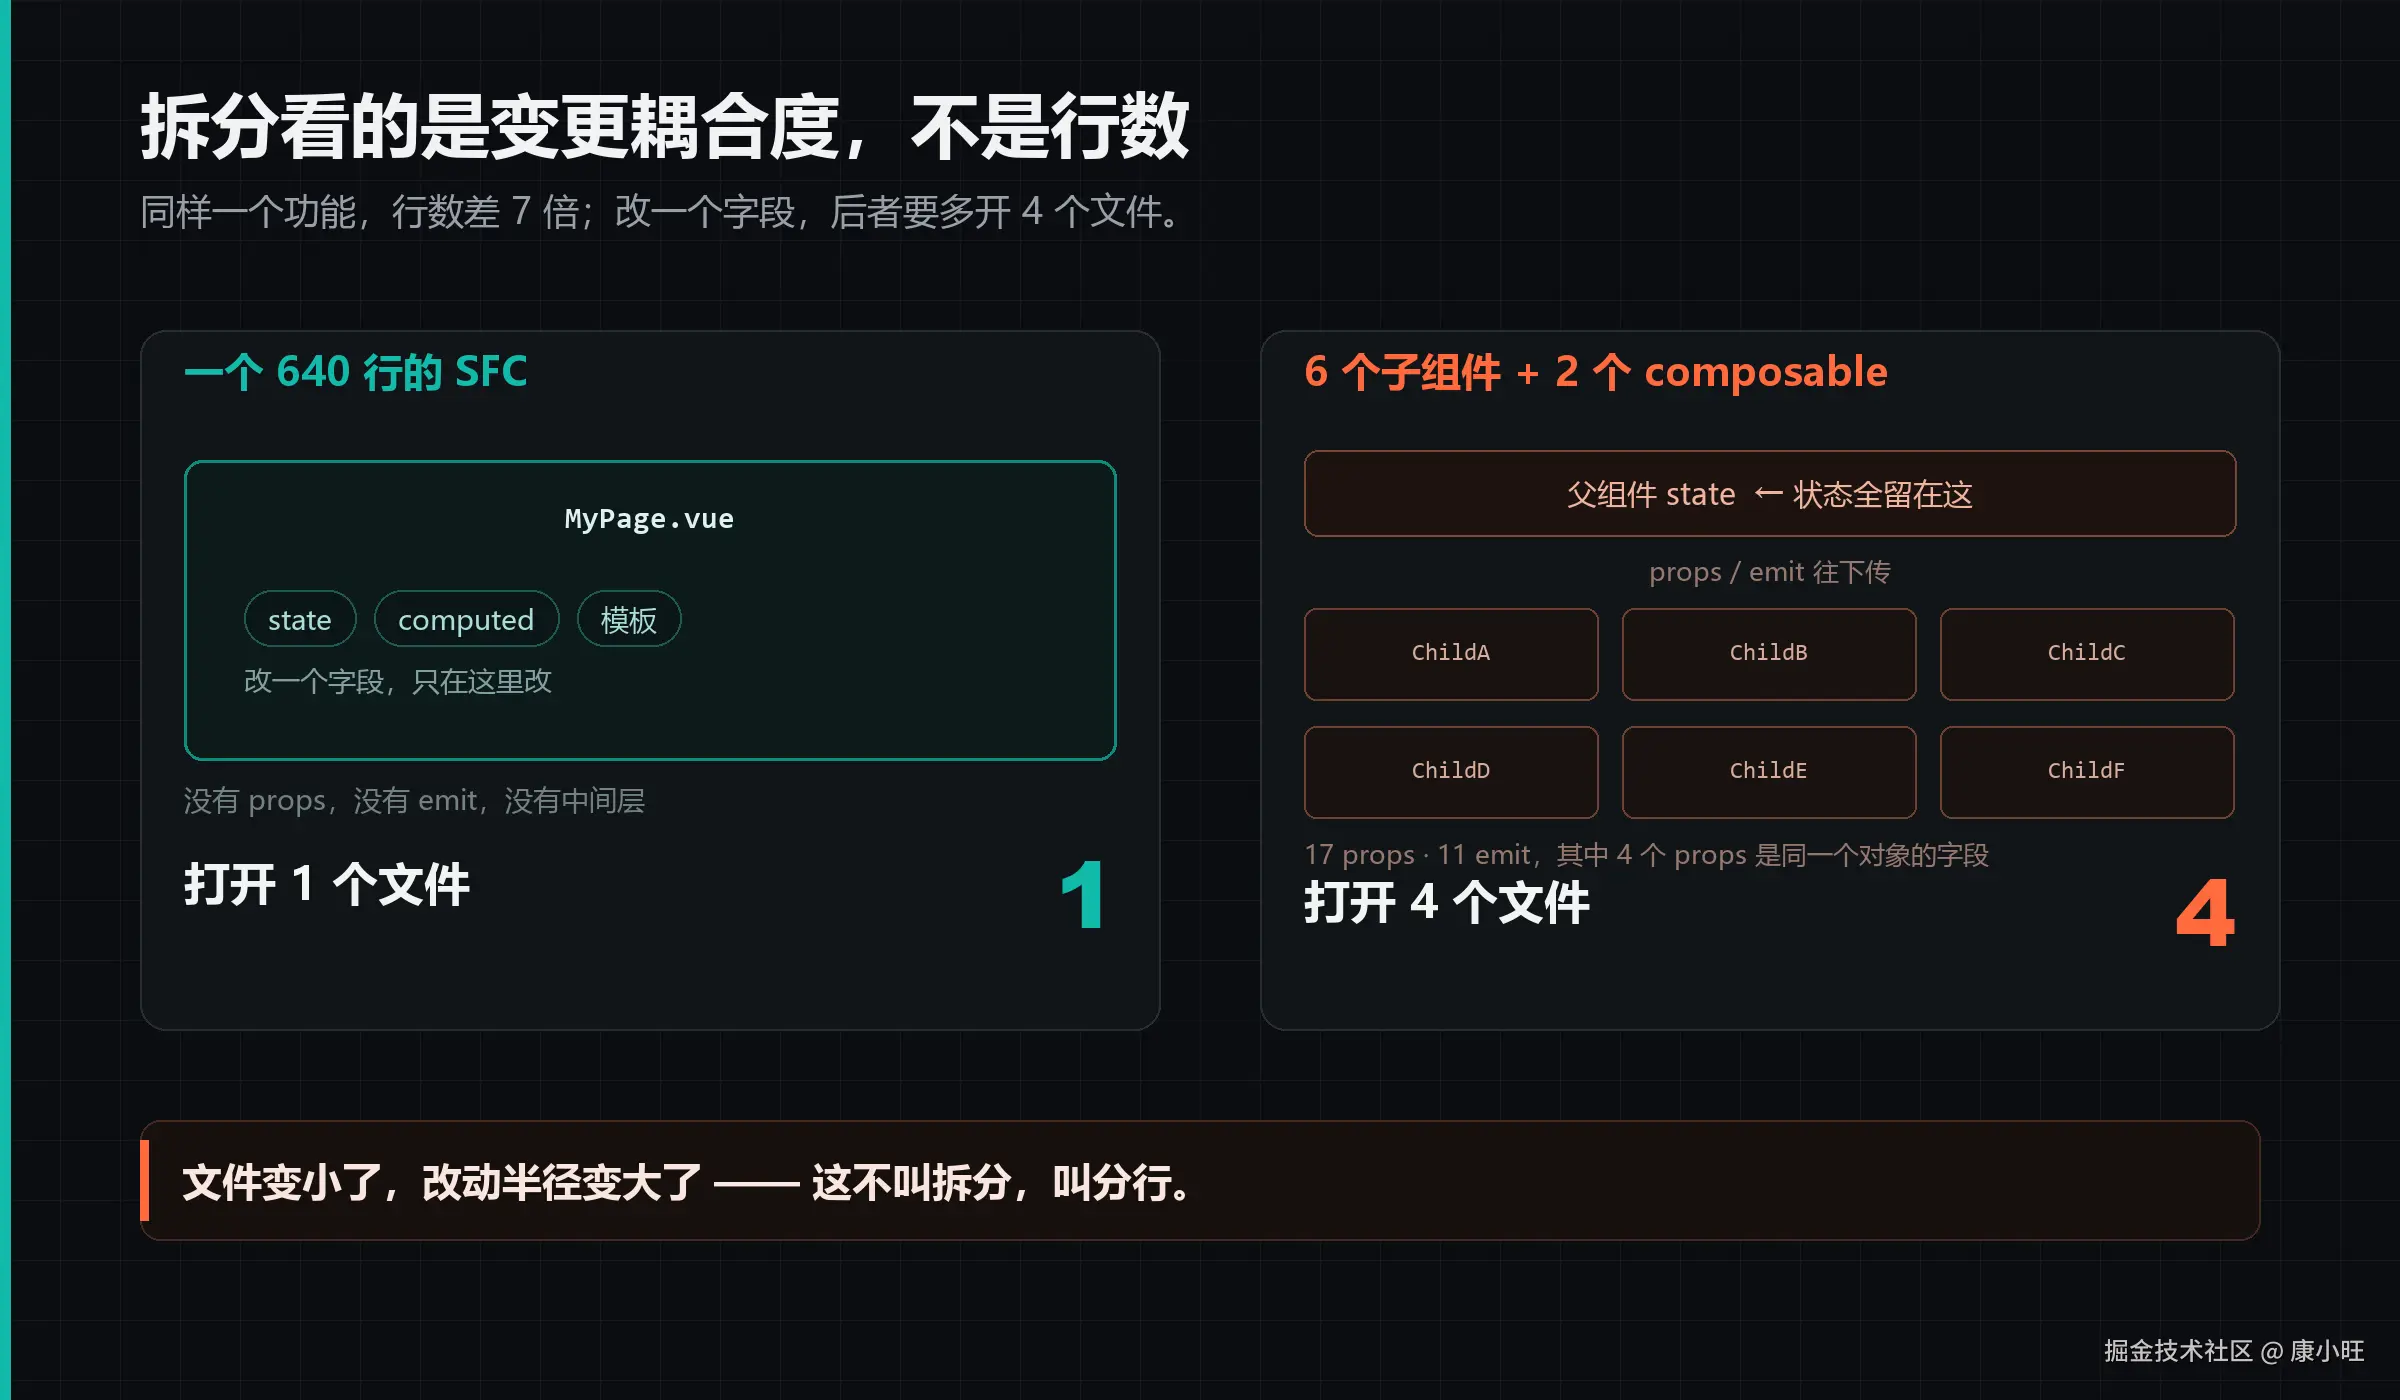
上周我把一个 640 行的 Vue 组件丢给 AI,让它重构。
它干得很快,也很漂亮:模板拆成 6 个子组件,主文件从 640 行压到 92 行,<script setup> 干净得像刚跑过一遍格式化。
然后我花了两个小时,把 17 个 props 和 11 个 emit 一个个接回去。其中四个 props,是同一个对象的四个字段。
那天我改了一句话:AI 不是不会写 Vue,它太会写了。 它会写 Options API、Composition API、JSX、render 函数、provide/inject、Pinia、模块单例,每一种都写得像模像样。它唯一不知道的,是我们这个项目走哪条路。
所以刷到 vuejs-ai/skills 的时候(vue-best-practices 刚 bump 到 v19.1.0,尤雨溪转发过那条更新),我没把它当"又一个提示词合集"。我看的是另一件事:
它把"我们这一派怎么活",写成了机器能读的文件。
一、Vue 的宽容,对人是自由,对模型是噪声
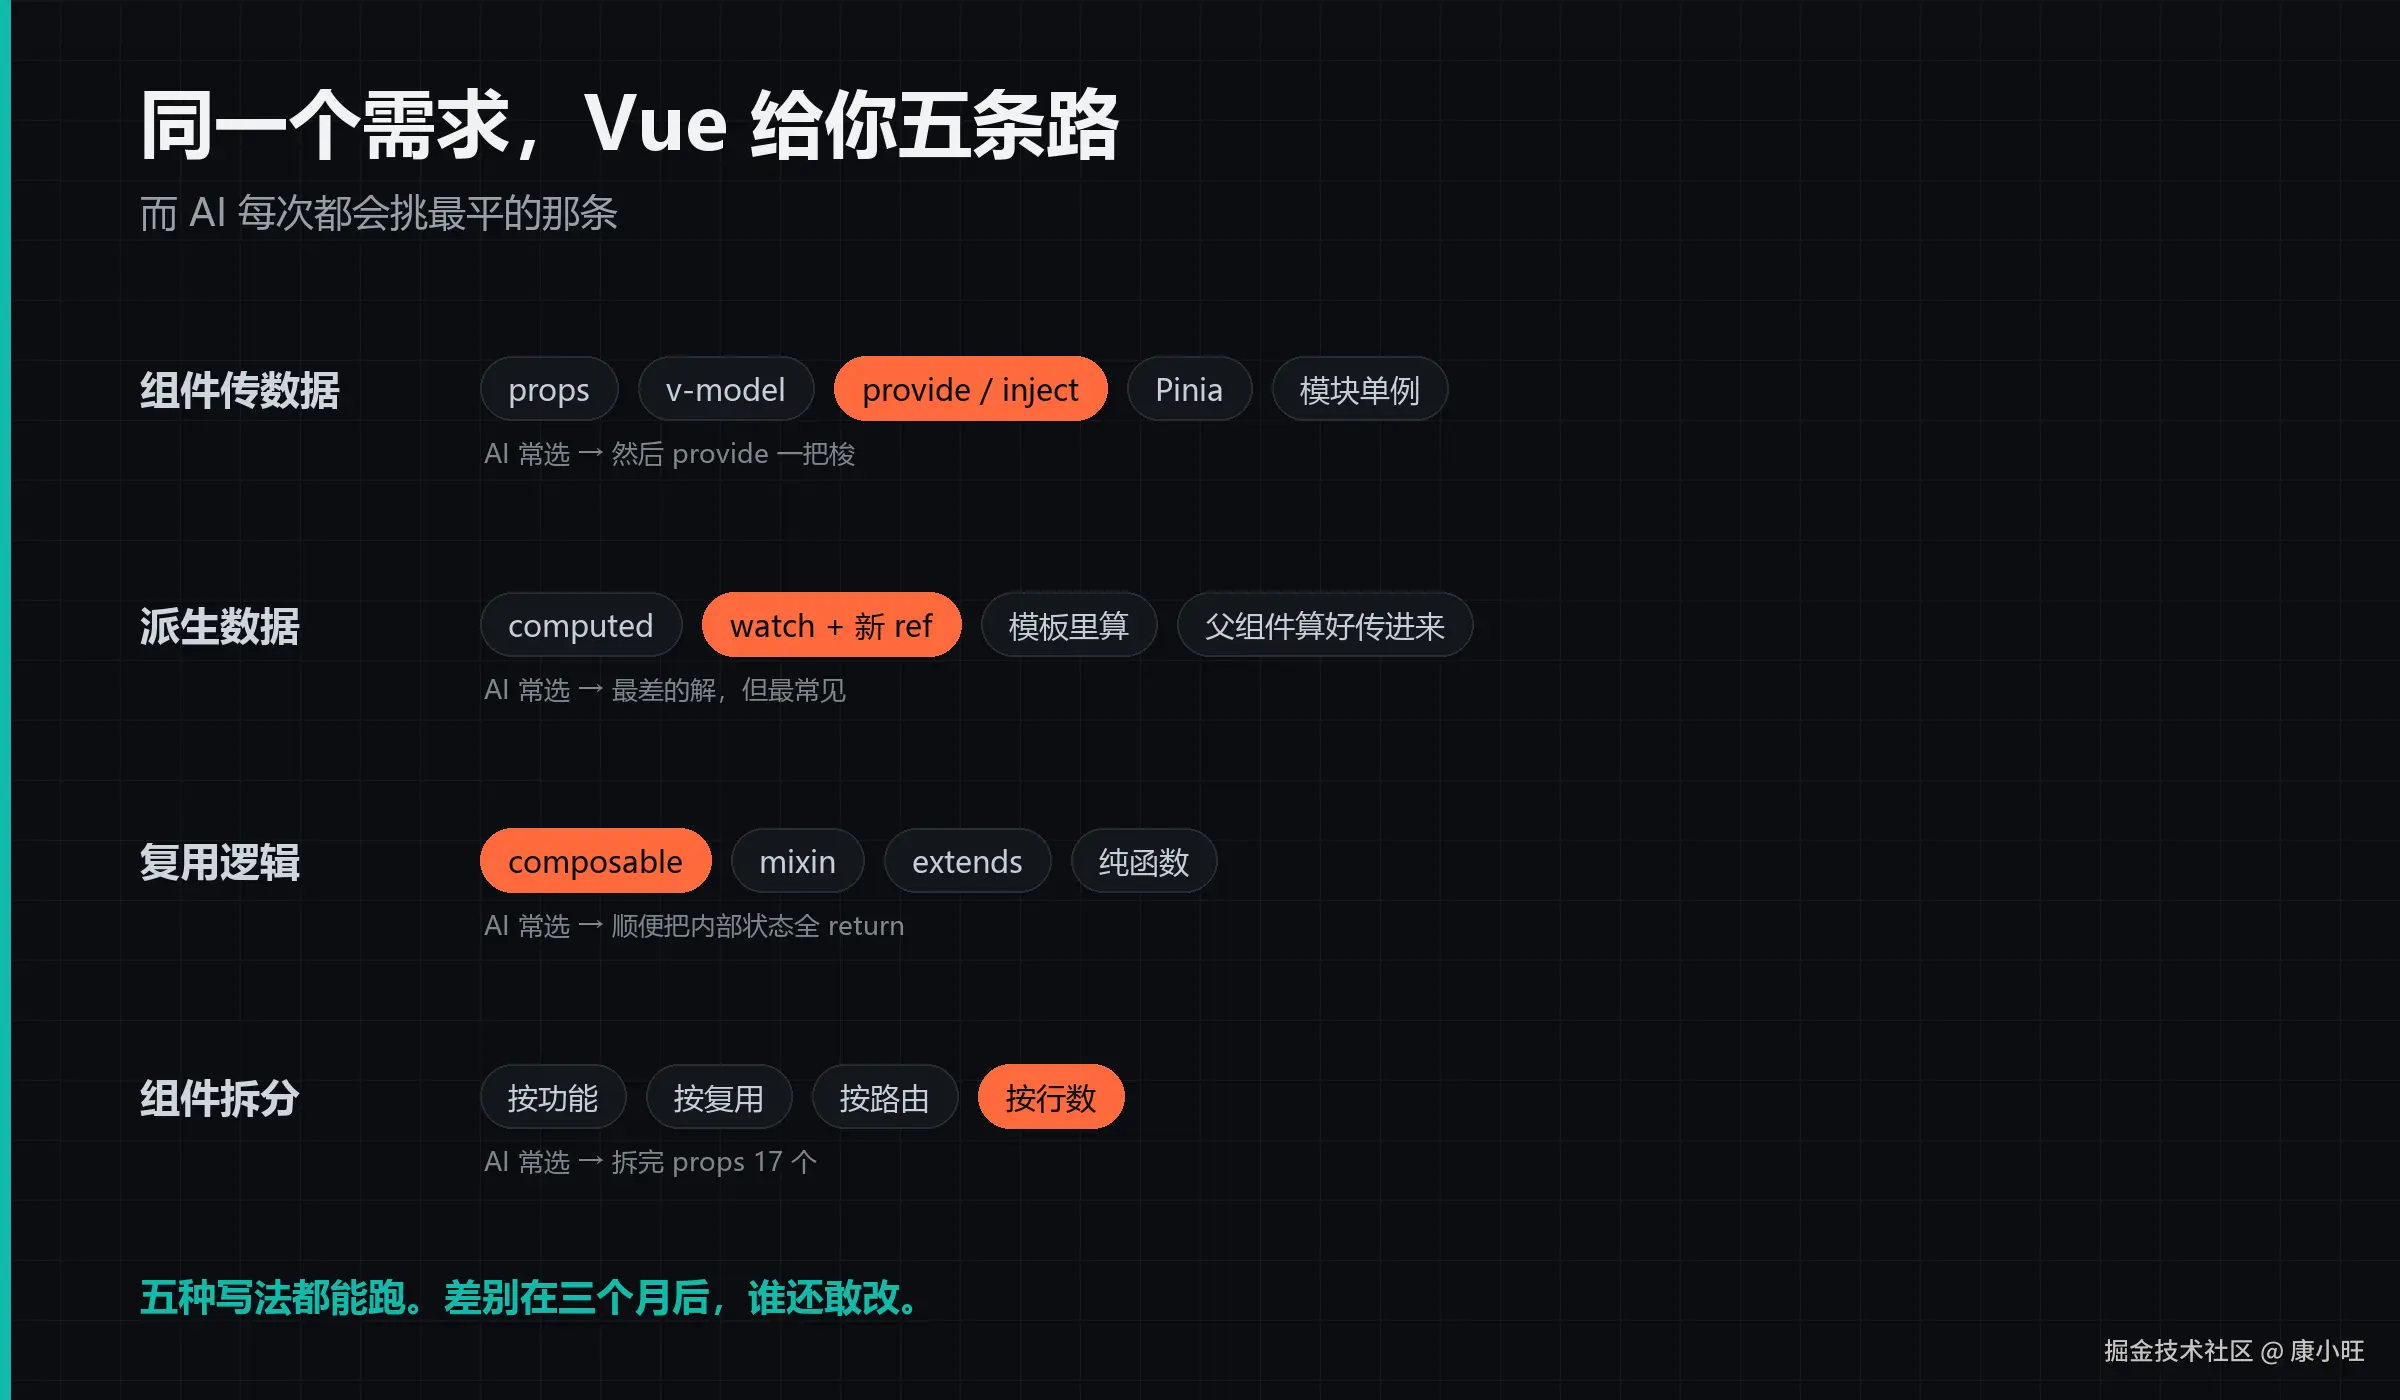
先承认一件事:Vue 之所以好用,是因为它不逼你选。同一个需求,它往往给你三条以上的路。
| 要解决的问题 | Vue 给的路 | AI 默认走哪条 |
|---|---|---|
| 组件间传数据 | props / v-model / provide-inject / Pinia / 模块单例 / 事件总线 | 先用 props,超过三层直接 provide 一把梭 |
| 派生数据 | computed / watch 里赋给新 ref / 模板里算 / 父组件算好传进来 | watch + 新 ref(最差解) |
| 复用逻辑 | composable / mixin / extends / 纯函数 | composable,然后把内部状态全 return |
| 组件拆分 | 按功能 / 按路由 / 按复用 / 按行数 | 按行数 |
| 异步状态 | onMounted + fetch / Suspense / 路由守卫 / store action | onMounted + 三个 loading 布尔 |
这张表的重点不是"AI 选错了",而是它每次都会选同一个错。
人是靠团队习惯消歧的:老项目里有个人说一句"我们不用 Pinia",这事就定了,剩下的人照做。模型没有团队,它靠概率消歧。而概率的解,永远是"互联网上最常见的那种写法"------那恰好是最平庸的那种。
所以我更愿意把这件事说成:
AI 不会把你的代码写坏,它会把你的代码写平。
写坏是 bug,你能测出来,能报错,能上线后回滚。写平是结构------所有组件都两百行、所有 composable 都返回十几个字段、所有列表都配一个 loading 一个 error。它能跑,能过 review,但三个月后没人愿意在里面加需求。
二、这套东西治的不是"不会",是"不一致"
README 里有一段方法论,中文解读基本没人提,但我觉得是整套东西里最关键的。
它把 skill 分成两类:
- Capability:不给这个 skill,模型根本做不出来。比如新版本特性、没写进文档的行为、训练数据之外的边界。
- Efficiency:模型做得出来,但做不好。给的是"更好的写法"和"更一致的写法"。
然后它用 A/B 评测筛规则:先不给 skill 跑一遍,再给了跑一遍,只有"不给就失败、给了就过"的规则才留下。
这个标准很硬。但它同时暴露了一个事实:这 8 个 skill 里的绝大多数,属于 Efficiency 型。
也就是说,规则里的内容,模型本来就"知道"。provide/inject 怎么用、MaybeRef 是什么类型、shallowRef 什么时候该上,它比很多三年经验的人还熟。
那它们到底在干什么?
在禁止。
你去翻规则,会发现大量否定句:"不要用文件行数作为拆分依据"、"不要把一堆无关参数打包成一个对象就算简化了"、"不要把内部状态原样返回给调用方"、"先检查组件拆分是否合理,再考虑注入"。
模型不缺能力,缺的是边界。而边界这件事,只有你的项目知道。
三、8 个 Skill,我的装法是只装一半
先把清单摆出来,再说我为什么不全装。
| Skill | 管什么 | 我的取舍 |
|---|---|---|
vue-best-practices |
组件拆分、状态归属、SSR、性能 | 必装,主力 |
vue-debug-guides |
运行时错误、警告、异步错误、水合问题 | 必装,排查比生成更费人 |
vue-router-best-practices |
导航守卫、路由参数、路由与组件生命周期 | 路由超过 10 条再装 |
vue-pinia-best-practices |
store 组织、响应式、状态模式 | 用 Pinia 才装 |
vue-testing-best-practices |
Vitest / Vue Test Utils / Playwright | 有测试文化再装 |
vue-options-api-best-practices |
Options API 的 this、生命周期、TS |
只在老项目装 |
vue-jsx-best-practices |
Vue 里写 JSX 与 React 的差异 | 不写 JSX 就别装 |
create-adaptable-composable |
MaybeRef / MaybeRefOrGetter 参数写法 |
写公共库才装 |
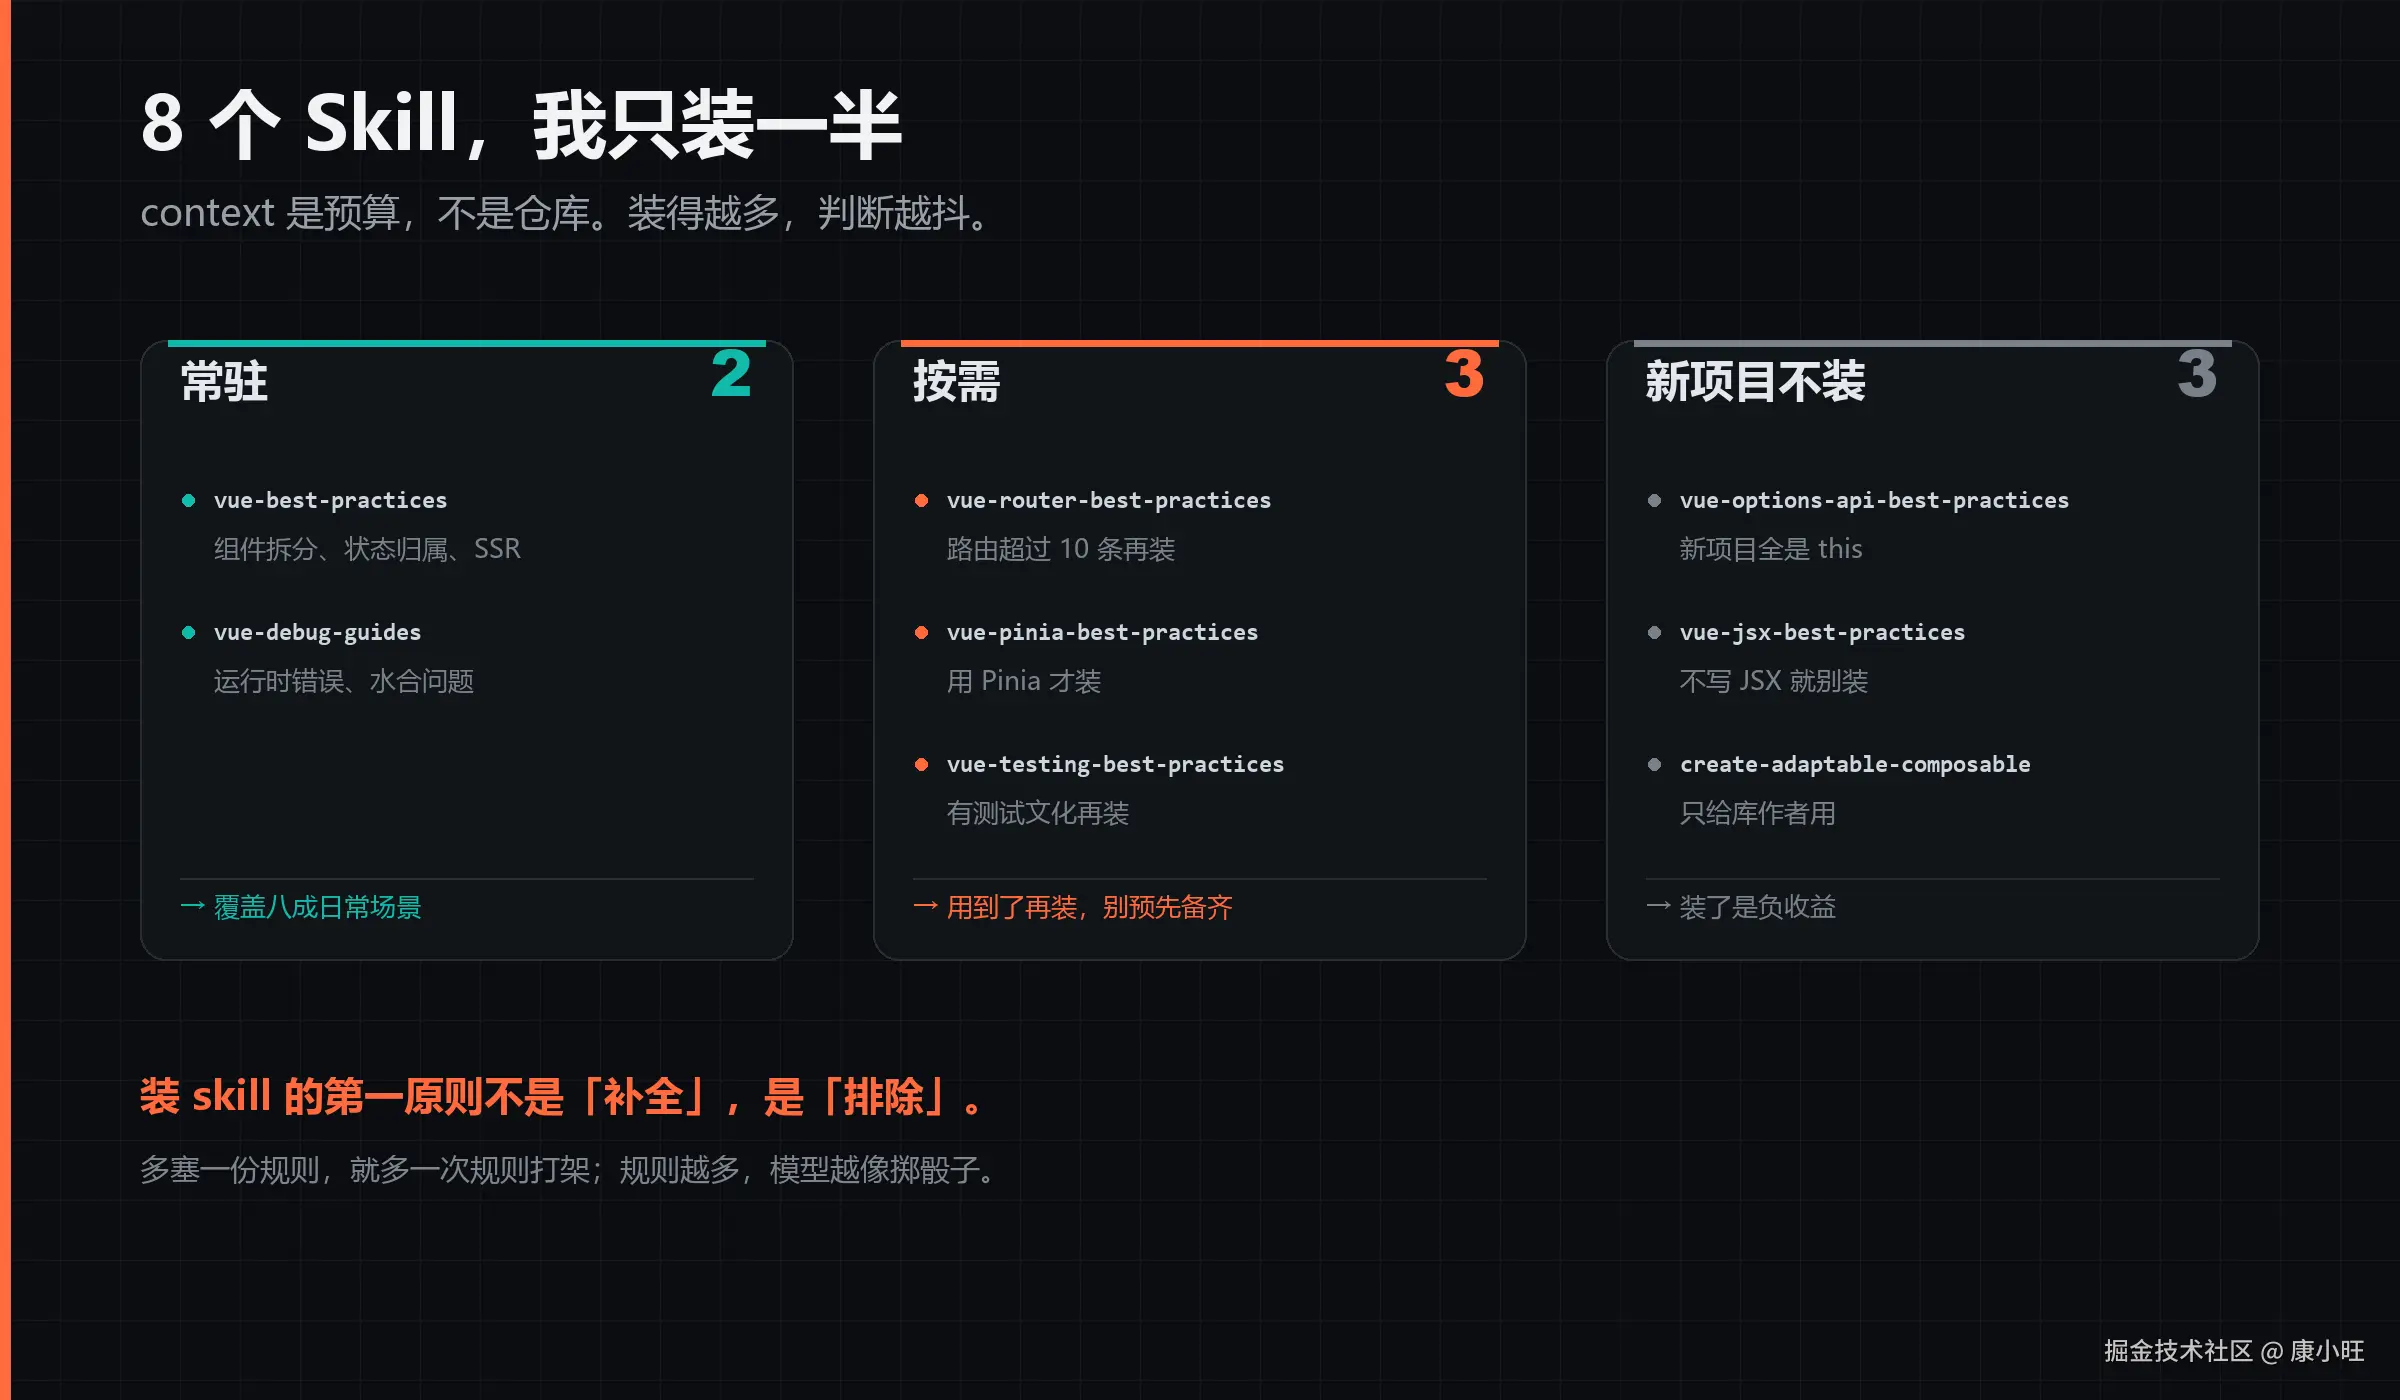
我的实际配置是 2 个常驻 + 3 个按需 + 3 个新项目不装。
理由很朴素:context 是预算,不是仓库。
八份规则同时在场,注意力会被稀释。更麻烦的是规则之间会打架------vue-best-practices 里"优先抽 composable"和"不要过早抽象"这两条,在不同上下文里指向相反的动作。你塞进去的规则越多,它每次的判断就越像掷骰子。
还有个更实际的坑:vue-options-api-best-practices 装在新项目里是负收益 。新项目全是 <script setup>,这份规则唯一的作用是在模型面前反复晃"this 是合法写法",然后你某天就会在 <script setup> 里看到一句莫名其妙的 this.$refs。
装 skill 的第一原则不是"补全",是"排除"。
四、三条我认为最值钱的规则(附我的反驳)
4.1 "文件行数不能作为拆分标准"------这句值一个 star
被 max-lines 这条 ESLint 规则坑过的项目,不在少数。我见过最离谱的一个:为了把 600 行的组件压到 300 行,有人把所有 computed 搬进一个 useXxxComputed.ts,结果改一个字段要开三个文件。
原规则写得很克制:文件长度可以提醒你去检查代码,但不能当拆分依据;一个小而完整的功能,留在同一个 SFC 里也没问题。
我想把它推到底:拆分的第一性原理是"变更的耦合度",不是"物理长度"。
| 判断维度 | 该拆 | 别拆 |
|---|---|---|
| 改一个业务字段要动几个文件 | 一个文件改完 | 要同时改四个 |
| props 数量 | 五个以内,且同一业务概念 | 超过八个且互不相关 |
| 子组件是否独立存在 | 别处也在用它 | 只在这个父组件里出现过一次 |
| 状态归属 | 状态跟着数据源头走 | 状态全留父组件,只把模板搬下去 |
最后一行是我加的,也是 AI 最容易犯的:把模板搬进子组件、state 留在父组件,那叫分行,不叫拆分。
判断方法很简单,问一句:"这个子组件,能不能在没有父组件的情况下讲清楚自己是干什么的?"如果它的 props 全是父组件 state 的切片,答案是"不能"。
4.2 composable 不是垃圾桶
AI 拿到"把这页逻辑抽成 composable"的指令,产出大概率长这样:
ts
// ❌ 一个 usePage 吞掉整页,返回 16 个字段
export function usePage() {
  const list = ref<Item[]>([])
  const loading = ref(false)
  const error = ref<Error | null>(null)
  const keyword = ref('')
  const page = ref(1)
  const pageSize = ref(20)
  const total = ref(0)
  const selected = ref<string[]>([])
  const sortBy = ref<'asc' | 'desc'>('asc')
  const filtered = computed(() => /* ... */)
  const paged = computed(() => /* ... */)
  const hasMore = computed(() => /* ... */)

  async function fetchList() { /* ... */ }
  function toggleSelect(id: string) { /* ... */ }
  function reset() { /* ... */ }

  return { list, loading, error, keyword, page, pageSize, total,
           selected, sortBy, filtered, paged, hasMore,
           fetchList, toggleSelect, reset }
}
调用方拿到手的第一件事不是写代码,是琢磨"这 16 个我该用哪几个"。
我的改法不是"少返回几个",而是换切分维度:按"变更原因"拆,不按"页面"拆。
ts
// ✅ 三块,各自只有一个变更理由
useItemList(query)      // list / total / loading / error / refresh
useItemQuery()          // keyword / page / pageSize / sortBy / toParams()
useItemSelection()      // selected / toggle / clear / isSelected
数据获取会因为接口变而变,查询条件会因为筛选需求变,选择态会因为批量操作变。三个变更理由,三个文件。哪天要加"导出选中",你只需要打开第三个。
这里补一条原仓库没写、但我认为更重要的:
readonly() 返回 ≠ 好设计。
很多人做到这一步就收手了:return { todos: readonly(todos), addTodo, removeTodo, toggle }。看着挺严谨,实际上是把 Vue 写成了 Java 的 getter/setter 换了个语法------状态是只读的,但调用方还是得知道"想改它该调哪个方法",认知负担一点没少。
我的判断标准只有一条:调用方要的是"值"还是"能力"。
要值,就给只读的值,别配 setter;要能力,就给动词,别把内部状态当战利品摆出来。两者都要,说明这个 composable 的职责还没想清楚。
还有一条更得罪人的:不是所有逻辑都该进 composable。
一个只被单个组件用、也没有复用预期的逻辑,留在 SFC 里更好。因为它和模板的耦合是真实存在的,抽出去不是解耦,是把耦合藏到另一个文件里。半年后接手的人(包括 AI)会以为它可复用,然后在第二个场景里用错。
4.3 provide/inject 的规则,价值在"什么时候别用"
原规则写得很清楚:普通父子通信继续用 props 和事件;共享数据需要传给后代、而中间层只是"接过去再传下去"时,才考虑有明确作用范围、带类型的注入;动手之前先检查组件拆分是否合理。
我喜欢它把"先别用"写在前面。AI 看到三层组件传值,第一反应就是"上 provide",因为它在你给的上下文里见过太多次这个解法。
我的加码是三个问题,问完再决定:
- 这个数据是不是"这棵子树的环境"?主题、i18n、表单上下文、权限------是,才考虑。业务数据不是环境,业务数据该走 props 或 store。
- 中间层真的只是"无感中转"吗?如果中间层自己也要用这个数据,那它就是消费者,该走 props。
- 能不能用
InjectionKey<T>+ 运行时断言,把隐式依赖重新变显式?
第三条是底线。注入的代价是隐式依赖------组件凭空多了一个上游。你必须用类型和断言把它重新显式化,否则半年后没人知道这个组件依赖谁:
ts
// context.ts
export interface FormContext {
  disabled: Ref<boolean>
  register: (id: string) => void
}

export const FormCtxKey: InjectionKey<FormContext> = Symbol('form-context')

export function useFormContext(): FormContext {
  const ctx = inject(FormCtxKey, null)
  if (!ctx) throw new Error('useFormContext() 只能在 <FormProvider> 内使用')
  return ctx
}
inject 的默认值永远给 null,然后在 useXxx 里把它炸掉。别给一个"看起来能用"的默认对象------那只会把配置错误变成线上 bug。
五、原仓库没说,但你必须自己补的四条
5.1 Skill 是依赖,不是圣经
v19 的规则会过时。等 Vue 3.6 的 Vapor 模式真的铺开,"必须用 ref 保住响应性"这类前提就会松动,甚至反过来。今天写死在规则里的最佳实践,明年可能是反模式。
所以别把 skill 内容复制进仓库当"团队规范"------那样你拿到的只是一份不可升级的二手文本。
把它当 npm 依赖管:锁版本、记进 ADR、升级时 diff 规则变更。规则变了要知道变了什么,而不是某天发现 AI 突然开始写另一种风格的代码,然后没人知道为什么。
5.2 唯一事实源必须在你自己的仓库里
现实是:团队里有人用 Cursor,有人用 Copilot,有人用 Claude Code,有人用通义灵码。它们加载规则的方式、路径、优先级全不一样。
所以真正的结构应该是两层:
AGENTS.md(或.cursor/rules):唯一事实源,进 git,跟代码一起 review。- skill:通用规则的分发副本,可以重装、可以覆盖、可以丢。
分工很清楚:通用规则交给社区,例外规则只能自己写。
而例外才是你项目的护城河。比如我们项目就是不用 Pinia,状态走 provide + 模块单例,理由写在 ADR 里。这条规则全世界只有我们仓库有,任何 skill 都不会替你写。
5.3 MaybeRefOrGetter 是库作者的工具,不是业务代码的
create-adaptable-composable 这个 skill 挺有意思,它教 AI 用 MaybeRef<T> 和 MaybeRefOrGetter<T> 做参数类型,让调用方能传普通值、ref,或者 getter。
这解决的是发布方 的问题:你不知道使用者从哪拿状态,所以你把三种都收下,内部用 toValue() 抹平。
放到业务代码里就变味了。签名看着灵活,实际上是把决策成本转嫁给了调用方------每次调用都得想"我该传 ref 还是 getter"。
我的取舍线:跨三个以上调用点、或者要发布成内部包,才上 MaybeRefOrGetter;否则直接要 Ref<T>。 一个项目内部的 composable,调用方是谁你天天见,没必要为不存在的场景做兼容。
5.4 Skill 挡得住"写法平庸",挡不住"结构平庸"
这条是我最想说的。
skill 能把单个函数、单个组件写得像样。但它不知道你这个项目该有几个抽象层、状态该放在哪一层、哪些抽象是明令禁止的。
这些只能写在 ADR 里。没有 ADR 的项目,装了八个 skill,得到的只是更快的平庸。
六、我这边实际怎么用
安装:
bash
npx skills add vuejs-ai/skills按提示勾选需要的 skill 和目标工具。Claude Code 用户也可以走 marketplace:
bash
/plugin marketplace add vuejs-ai/skills
/plugin install vue-best-practices@vue-skills
README 建议提示词前加 use vue skill,因为不写的话触发不稳定------这跟我实测的感受一致,别指望模型自己判断该不该加载。
我的提示词模板长这样:
text
use vue skill

项目约定:
- Vue 3.5 + <script setup> + TypeScript,禁用 Options API
- 状态用 provide + 模块单例,不用 Pinia
- 组件按 feature 目录分,不要新建 stores/ 或 utils/
- 子组件 props 不超过 6 个,超过就说明状态归属错了

任务:<需求>
三条实操经验,比装什么 skill 更管用:
1. 首轮别让它写代码,让它先交方案。 一句话就够:"先说清楚要改哪些文件、每个状态归谁、每个组件有几个 props。" 这一句能砍掉我大概七成的返工。
2. 生成完让它自检。 "对照 vue-best-practices 检查:有没有假拆分(模板搬走了但 state 没搬)、有没有 composable 把内部状态全 return 了、有没有为了 provide 而 provide。"
3. Code review 只看三个数字。 props 数量、composable 返回值数量、provide 的调用处数量。三个数任意一个超标就打回。别先读代码,先读数字------结构问题在数字上比在代码里明显得多。
最后
这套东西最有意思的地方,不是它让 AI 更懂 Vue。
是它逼你先回答一个一直在回避的问题:我们为什么这么写?
写不出来,就只能装别人的规则。装完你会发现 AI 写得"更好"了,但那个"好"是别人的好------代码更整洁,也更不像你的项目。
写出来了,你才有资格谈"给 AI 装边界"。因为边界这东西,从来不是装给模型的。
是装给你自己的。
------ 康小汪